C#对接工业机器人总出怪问题?调试半年踩过的10个致命细节
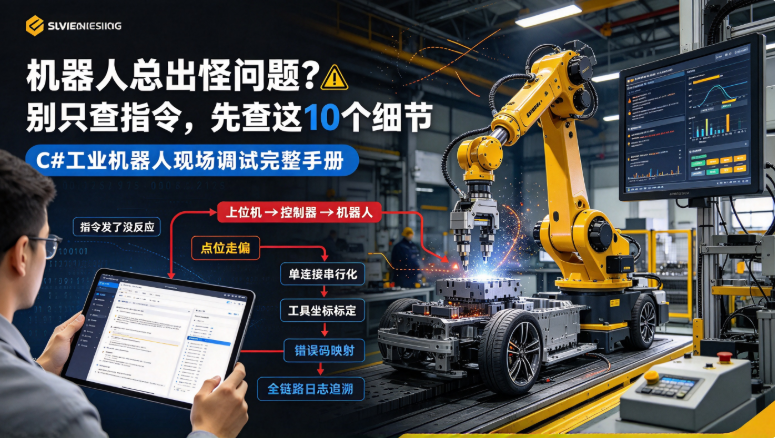
做工业机器人上位机集成的朋友,应该都有过这种经历:Demo的时候好好的,一到现场就各种怪问题。指令发了没反应、点位走不准、状态不同步、莫名其妙报警,有的坑查半天都找不到原因。看起来都是不起眼的小细节,到了生产现场就能让整个工位停摆。
去年做汽车发动机缸体上下料项目,对接4台发那科R-0iB机器人,从通信调试、点位控制到整线联动,前前后后调试了小半年,踩了大大小小二十多个坑。很多问题不是技术多难,是没踩过坑根本想不到。今天就挑出10个最致命、最容易踩的细节,结合实战代码和解决方案全部分享出来,都是现场跑出来的血泪经验。
一、通信不是连上就稳:应用层心跳+半开连接检测
现象:车间网络波动,机器人那边网线松了重插,上位机这边TCP连接显示还是已连接,发指令石沉大海,半天查不出来问题。等查到的时候,工位已经停了十几分钟。
根本原因:TCP的半开连接问题。物理连接断开后,如果没有数据交互,操作系统可能需要几分钟才会检测到连接失效。工业现场粉尘多、接头松动、交换机波动都是常事,靠系统默认检测根本来不及。
解决方案:不要依赖TCP KeepAlive,自己做应用层心跳。用机器人的状态查询指令作为心跳包,定时发送,连续多次无响应就判定连接断开,主动关闭并触发重连。
public class RobotCommunication
{
    private System.Timers.Timer _heartbeatTimer;
    private int _timeoutCount = 0;
    private const int HeartbeatInterval = 2000; // 2秒一次心跳
    private const int MaxTimeoutCount = 3;     // 连续3次失败判定断线

    public void StartHeartbeat()
    {
        _heartbeatTimer = new System.Timers.Timer(HeartbeatInterval);
        _heartbeatTimer.Elapsed += (s, e) =>
        {
            if (!SendHeartbeatQuery())
            {
                _timeoutCount++;
                if (_timeoutCount >= MaxTimeoutCount)
                {
                    // 判定断线,触发重连
                    Reconnect();
                    _timeoutCount = 0;
                }
            }
            else
            {
                _timeoutCount = 0;
            }
        };
        _heartbeatTimer.Start();
    }

    private bool SendHeartbeatQuery()
    {
        // 发送读状态寄存器指令,有正常返回就是连接正常
        try
        {
            var response = SendCommand("READ_STATUS");
            return response != null && response.IsValid;
        }
        catch
        {
            return false;
        }
    }
}
重点提醒:心跳指令要选最轻量的状态查询指令,不要用复杂指令,避免本身占用太多资源。
二、指令别无脑连发:指令队列+忙位互斥
现象:程序里连续发了好几条运动指令,机器人只执行了第一条后面就没反应了,或者直接报缓冲区溢出错误。
根本原因:机器人控制器的指令缓冲区容量非常有限,大多只有几条的深度。上位机一股脑发过去,TCP层面是发成功了,但机器人端缓冲区满了直接丢包。很多新手以为TCP可靠传输就不会丢指令,其实丢的地方在机器人端。
解决方案:做全局指令发送队列,加忙位互斥。机器人正在执行指令的时候,新指令排队等待,等执行完成回执回来,再发下一条。所有指令串行执行,保证不溢出、不混乱。
public class RobotCommandScheduler
{
    private readonly ConcurrentQueue<RobotCommand> _commandQueue = new ConcurrentQueue<RobotCommand>();
    private bool _isBusy = false;

    public void EnqueueCommand(RobotCommand command)
    {
        _commandQueue.Enqueue(command);
        TryProcessNext();
    }

    private void TryProcessNext()
    {
        if (_isBusy) return;
        if (!_commandQueue.TryDequeue(out var command)) return;

        _isBusy = true;

        // 发送指令,注册完成回调
        SendCommandAsync(command).ContinueWith(t =>
        {
            _isBusy = false;
            TryProcessNext(); // 执行完处理下一条
        });
    }
}
关键细节:队列要支持优先级,急停、暂停指令可以插队,优先执行。
三、状态别高频死轮询:分级轮询+事件通知
现象:为了追求状态实时,100ms轮询一次机器人的所有状态寄存器,跑一段时间机器人控制器就卡顿,网络也堵,反而更不实时了。
根本原因:机器人控制器的通信处理能力是有限的,高频大量的轮询请求会占满控制器的通信资源,反而影响正常运动指令的执行。工业场景不是越频繁越好,够用就行。
解决方案:分级轮询策略,不同重要程度的数据用不同的轮询周期。
- 核心状态(运行/停止/报警、当前点位):200ms轮询一次
- 次要状态(通用IO、内部寄存器):1秒轮询一次
- 配置参数、版本信息:10秒轮询一次
有条件的优先用机器人的事件通知功能,状态变化主动上报,比轮询效率高得多,对控制器压力也小。
四、点位别只发坐标:速度+加速度+平滑参数
现象:机器人定位精度没问题,但动作生硬、冲击大,减速机异响,用不了多久精度就下降。
根本原因:默认运动参数都是最大速度、最大加速度,启停冲击大,机械磨损快。很多人对接的时候只传目标坐标,速度、加速度都用默认值,空行程和工作行程一个速度,该慢的地方慢不下来。
解决方案:每个运动指令都带上速度、加速度、平滑半径三个关键参数,根据工艺场景动态调整。
- 空行程:高速、大加速度,提高效率
- 接近工件:降速、小加速度,保证平稳
- 不需要精准到位的过渡点:开平滑半径,动作更流畅,减少机械冲击
public class MoveCommand
{
    public double X { get; set; }
    public double Y { get; set; }
    public double Z { get; set; }

    public int Speed { get; set; }          // 速度百分比
    public int Acceleration { get; set; }   // 加速度等级
    public double SmoothRadius { get; set; } // 平滑半径
}
实战经验:平滑参数用好,不仅能减少机械冲击,还能缩短单周期时间,比全程高速还高效。
五、坐标别直接硬算:工具坐标系+基坐标系校准
现象:仿真里坐标好好的,现场走过去偏了好几厘米;换了个夹具,所有点位全不准了,要重新示教一遍。
根本原因:上位机自己算世界坐标,没考虑工具坐标系偏移,也没做基坐标系标定。机器人的末端坐标是相对于法兰盘的,装了夹具、吸嘴就有偏移,不标定肯定不准。
解决方案:
- 工具坐标系在机器人端示教标定,参数写到控制器里,上位机不参与工具坐标转换。
- 所有点位统一用基坐标系表达,需要视觉引导的,手眼标定之后把偏移量更新到机器人基坐标系。
- 尽量不要在上位机里做复杂的坐标转换,很容易算错,还不好调试。
踩坑提醒:旋转中心偏移是最容易忽略的点,尤其是带旋转轴的夹具,只补偿平移不补偿旋转,角度大了偏差会非常明显。
六、异常别只抛错误码:错误映射+自动恢复逻辑
现象:机器人报警了,上位机只弹出个“错误代码:12345”,运维一脸懵,不知道啥意思,也不知道怎么处理,只能等工程师到现场。
根本原因:只读取了原始错误码,没有做业务层的错误映射,也没有对应的处理逻辑。工业机器人的错误码有几百个,现场运维不可能全记住。
解决方案:
- 做完整的错误码映射表,包含错误描述、严重等级、建议处理方式。
- 常见可恢复异常,做自动恢复逻辑:清错→复位→重试一次,重试失败再升级报警。
- 不可恢复的严重错误,直接触发停机,推送详细错误信息给负责人。
public static class RobotErrorMapper
{
    private static readonly Dictionary<int, RobotError> _errorMap = new Dictionary<int, RobotError>
    {
        { 1001, new RobotError("碰撞检测触发", ErrorLevel.Recoverable, "清除障碍物后复位重试") },
        { 2001, new RobotError("缓冲区溢出", ErrorLevel.Recoverable, "清空队列后重试") },
        { 3001, new RobotError("伺服故障", ErrorLevel.Fatal, "立即停机检查电机驱动器") }
    };

    public static RobotError GetErrorInfo(int errorCode)
    {
        return _errorMap.TryGetValue(errorCode, out var error)
            ? error
            : new RobotError($"未知错误:{errorCode}", ErrorLevel.Fatal, "联系技术人员");
    }
}
七、并发别多线程乱发:单连接串行化+指令原子性
现象:多个业务模块同时发指令,定位模块发运动指令,IO模块发输出指令,机器人动作混乱,有时候还会报指令冲突错误。
根本原因:绝大多数工业机器人的通信协议,不支持并发指令执行。多个线程各自开连接发指令,指令交叉到达,机器人执行顺序乱了,就会出现动作异常、指令冲突。
解决方案:所有指令走同一个通信通道,全局串行队列执行。同一时间只执行一条指令,保证原子性。不同业务模块的指令都发到统一的调度器,按优先级和顺序排队。
红线原则:绝对不要每个业务模块自己开连接、自己发指令。初期省事,后期一定会出并发问题,排查起来非常困难。
八、急停别依赖软件:硬件安全回路独立
现象:紧急情况点上位机的停止按钮,慢半拍才停,有时候程序卡了根本停不下来。
根本原因:软件停止指令要经过操作系统、网络、机器人控制器,层层延迟,极端情况程序崩溃了就完全失效。安全相关的功能,绝对不能只靠软件。
解决方案:
- 正常停止、暂停、复位:用软件指令控制
- 急停、安全围栏、安全光栅:必须走硬件IO回路,直接接入机器人的安全输入端口,完全独立于上位机程序
这是安全红线,没有任何妥协空间。上位机就算死机了,硬件急停必须照样有效。现场调试的时候,一定要先测安全回路,再测功能。
九、日志别只打收发:全链路时序追溯
现象:出了生产事故,查日志只看到“发送了XX指令”,不知道机器人什么时候开始执行、什么时候执行完,中间有没有异常,时序完全对不上,分不清是谁的问题。
根本原因:只记录了上位机的发送动作,没有记录机器人的执行回执、状态变化、异常节点。出了问题各说各的,没有客观时间线。
解决方案:全链路日志体系,每条指令带唯一ID,从发送、执行开始、执行完成到异常,每个节点都记录时间戳,精确到毫秒。
public class CommandLog
{
    public string CommandId { get; set; }
    public string CommandType { get; set; }
    public DateTime SendTime { get; set; }
    public DateTime? StartExecuteTime { get; set; }
    public DateTime? FinishTime { get; set; }
    public bool IsSuccess { get; set; }
    public string ErrorMsg { get; set; }
}
出问题的时候,按时间线一拉,哪个环节出的问题、延迟了多久,一目了然,不用扯皮。
十、版本别只测一款:控制器版本兼容适配
现象:实验室用新机器人调试好好的,现场老款机器人,指令发过去不识别,或者参数格式不对,各种报错。
根本原因:不同年代的机器人控制器,固件版本差异很大,指令集有增减,参数格式也可能变化。只测了一个版本,到现场很容易踩坑。
解决方案:
- 程序启动先读取控制器固件版本,做版本适配。
- 指令集按最低兼容版本来实现,高版本的新功能做兼容分支。
- 不要上来就用最新指令,工业现场很多机器人都是跑了五六年的老版本。
实战经验:优先用通用的基础指令,少用版本专属的高级指令,兼容性最好,出问题也少。
总结
对接工业机器人,本质上是和一个实时性、安全性要求都很高的嵌入式系统交互。很多坑看起来都是细碎的小细节,到了生产现场就是影响产能的大问题。通信的稳定性、指令的有序性、状态的准确性、安全的独立性、日志的可追溯性,每个环节都不能掉链子。
很多人觉得对接机器人就是调用SDK发指令,没什么技术含量。真到现场跑起来才发现,决定系统稳不稳定的,往往都是这些不起眼的细节。前期多考虑一点,现场就少出很多问题,少跑很多趟。
做工业开发久了就会发现,越接近硬件的地方,坑越细碎,也越致命。把这些细节都做好,机器人对接才能真正稳定跑起来。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献33条内容

所有评论(0)