经典 2025|BeyondMimic:从运动跟踪到引导扩散的多功能人形机器人控制【文献解读】
文献:BeyondMimic: From Motion Tracking to Versatile Humanoid Control via Guided Diffusion(中文:BeyondMimic:从运动跟踪到引导扩散的多功能人形机器人控制)
作者:Qiayuan Liao、Takara E. Truong、Xiaoyu Huang、Yuman Gao、Guy Tevet、Koushil Sreenath、C. Karen Liu
论文地址:arXiv 摘要 · 论文 HTML(含原图及补充材料) · 项目主页
官方开源地址:HybridRobotics/whole_body_tracking
1. 核心问题与论文定位
论文讨论的是两个接续但不同的问题。第一,如何从大量人体动作中学出真实人形机器人可执行、自然且高度动态的技能,而不用为每段动作重新设计奖励、增益或随机化设置。第二,学会动作以后,机器人如何在没有针对新任务重新训练的条件下,把已学技能组合起来,完成速度指令、路点到达、动作补全与避障。前者是运动跟踪和仿真到现实迁移问题;后者是利用已学运动先验进行在线规划和控制的问题。论文以 Unitree G1 人形机器人为验证平台,并非四足机器人或视觉语言动作(VLA)模型。其下游任务输入是状态估计、指令、关键帧及几何代价,而不是自然语言与视觉输入。
主要挑战包括:浮动基座与多接触造成的高维非线性动力学;跟踪精度、顺应性与真机冲击安全之间的冲突;人体参考的全局坐标与真实机器人不可避免的漂移;长动作中的难片段难以通过均匀采样学会;直接对高维、尖峰化的关节 PD 指令做扩散建模容易失稳;新任务目标往往作用于未来状态,而普通动作生成策略缺少显式可优化的未来轨迹。
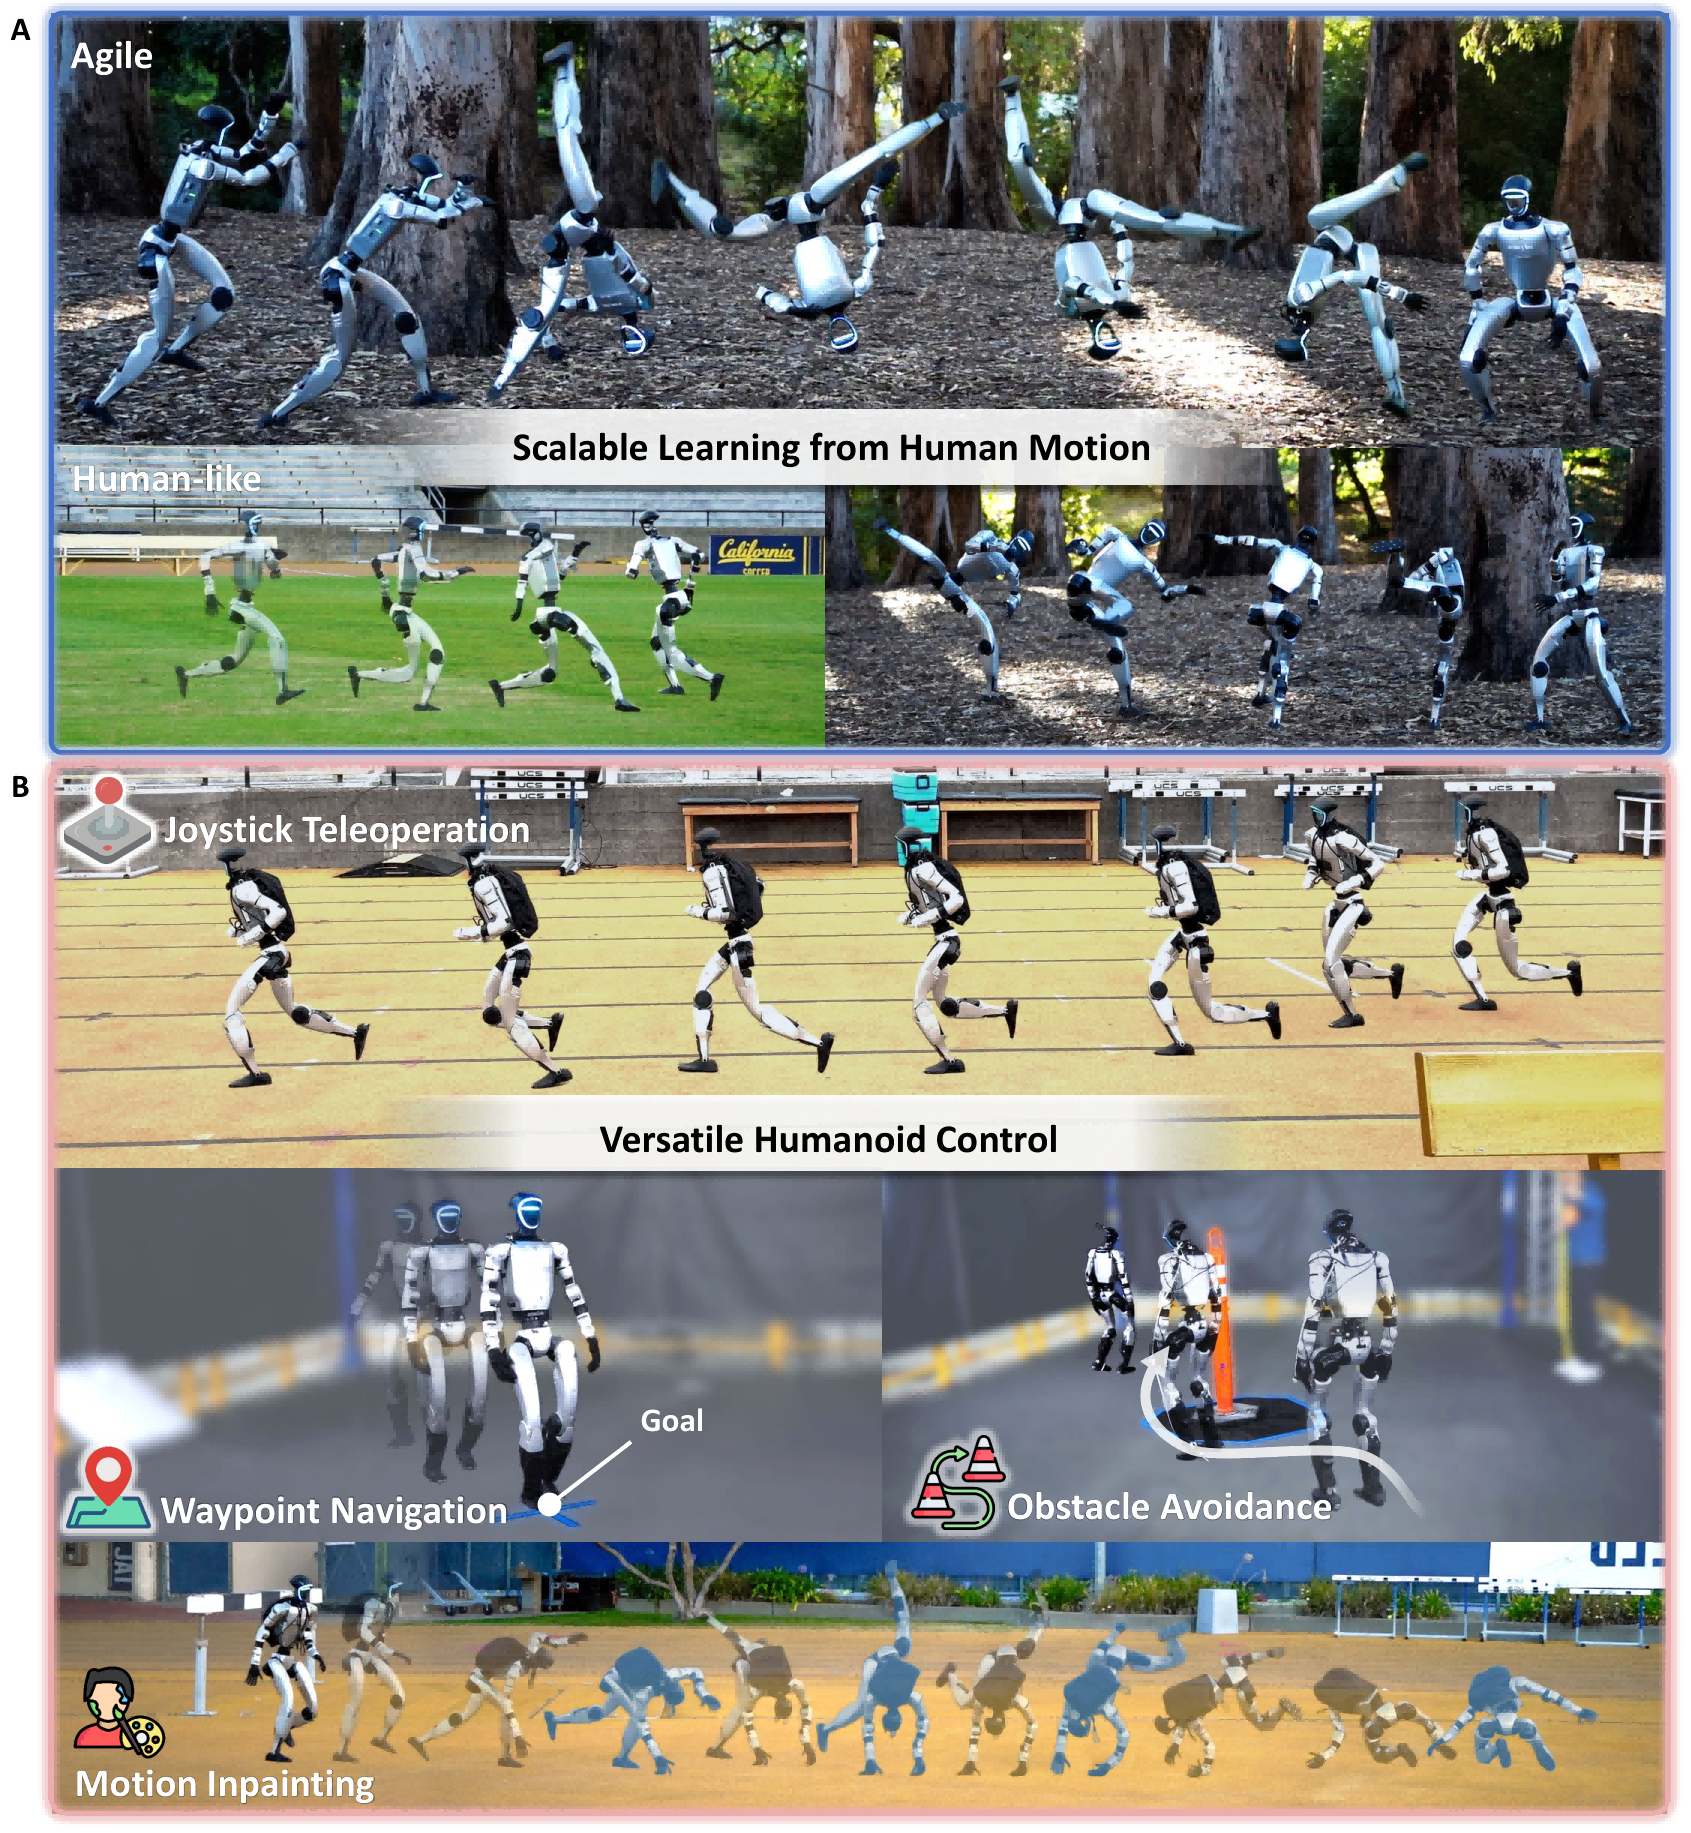
图 1|论文 Figure 1,整体研究目标:A 为从人体动作到可真机执行技能的跟踪,B 为通过引导扩散组合技能完成未见任务。来源:Liao 等,BeyondMimic,Figure 1。
2. 方法总览:先得到可靠技能,再统一建模技能分布
技术路线可概括为:人体动作重定向为机器人参考轨迹 → 用同一套 PPO 运动跟踪配置训练参考动作对应的策略 → 将多个专家策略蒸馏至条件 VAE 的平滑动作潜空间 → 从 VAE 闭环仿真采集状态—潜变量轨迹 → 训练联合轨迹扩散模型 → 推理时通过可微任务代价引导去噪 → 用最新本体状态解码当前动作并循环执行。“统一”指统一的训练配方和后续单个生成模型;并不意味着第一阶段只有一个包揽全部动作的跟踪策略。论文明确说明,各参考动作可有各自的跟踪策略,但共用 MDP 和超参数;一些较长的参考序列同时包含多个技能。
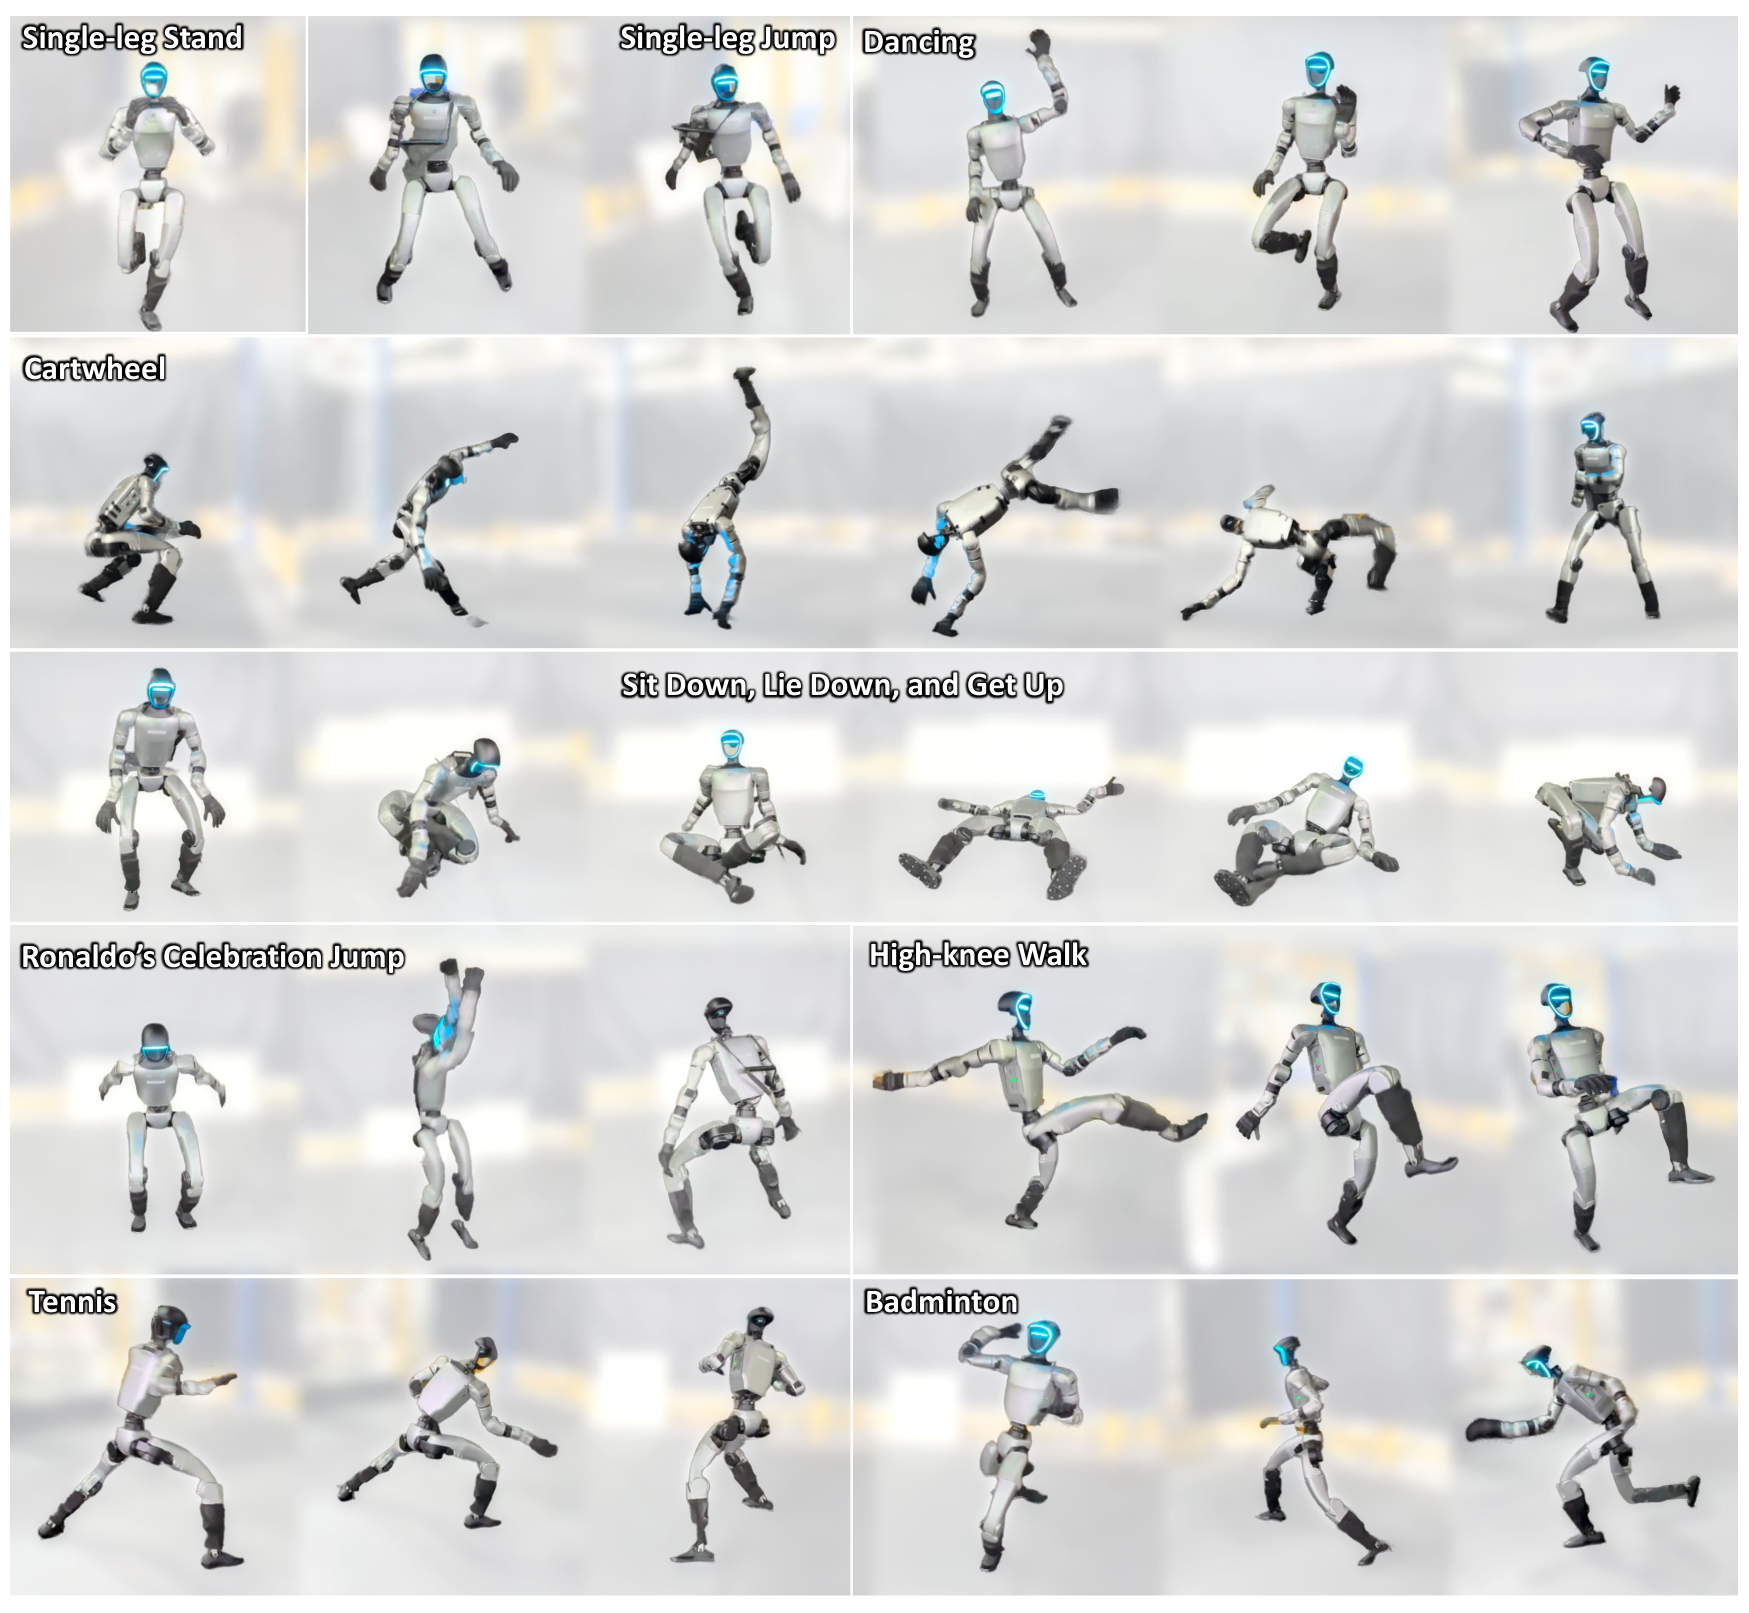
图 2|论文 Figure 2,真机展示的不同运动跟踪策略,包含平衡、动态动作和风格化动作。来源:Liao 等,BeyondMimic,Figure 2。
2.1 第一阶段:以身体任务空间为核心的强化学习跟踪
参考轨迹给出浮动基座位置、姿态和关节位置 q r e f = ( p r e f , R r e f , θ r e f ) \mathbf q^{\mathrm{ref}}=(\mathbf p^{\mathrm{ref}},R^{\mathrm{ref}},\boldsymbol\theta^{\mathrm{ref}}) qref=(pref,Rref,θref),以及相应线速度、角速度和关节速度。通过正向运动学计算躯干、四肢等目标身体的位姿与速度。论文选定锚点身体(通常是根节点或躯干),将其他目标身体的期望位姿重表达到以当前锚点为中心、对齐航向且保留高度的参考系中。这样,策略保持人体动作中的相对姿态和运动风格,同时允许扰动、估计误差造成的有限全局平移与航向漂移;锚点本身仍按照参考量跟踪。此处“允许漂移”不能理解为完全删除平衡或全局信息,因为策略仍有锚点位姿误差输入,部分情形还可以增加锚点全局跟踪项。
对 s ∈ { p , R , v , ω } s\in\{\mathbf p,R,\mathbf v,\boldsymbol\omega\} s∈{p,R,v,ω} 四类误差,在目标身体集合 B t a r g e t \mathcal B_{\mathrm{target}} Btarget 上求平均平方误差 e ˉ s \bar e_s eˉs,并定义统一跟踪回报:
r t a s k = ∑ s ∈ { p , R , v , ω } exp ( − e ˉ s σ s 2 ) . r_{\mathrm{task}}=\sum_{s\in\{\mathbf p,R,\mathbf v,\boldsymbol\omega\}}\exp\!\left(-\frac{\bar e_s}{\sigma_s^2}\right). rtask=s∈{p,R,v,ω}∑exp(−σs2eˉs).
完整回报只额外使用三个正则项:关节软限位、连续动作变化率和非末端身体的自接触惩罚:
r = r t a s k − λ l r l i m i t − λ s r s m o o t h − λ c r c o n t a c t . r=r_{\mathrm{task}}-\lambda_l r_{\mathrm{limit}}-\lambda_s r_{\mathrm{smooth}}-\lambda_c r_{\mathrm{contact}}. r=rtask−λlrlimit−λsrsmooth−λcrcontact.
演员网络的观测为 o = [ ψ , e a n c h o r , V i m u , θ − θ 0 , θ ˙ , a l a s t ] \mathbf o=[\boldsymbol\psi,\mathbf e_{\mathrm{anchor}},\mathcal V_{\mathrm{imu}},\boldsymbol\theta-\boldsymbol\theta^0,\dot{\boldsymbol\theta},\mathbf a_{\mathrm{last}}] o=[ψ,eanchor,Vimu,θ−θ0,θ˙,alast]。其中 ψ = [ θ r e f , θ ˙ r e f ] \boldsymbol\psi=[\boldsymbol\theta^{\mathrm{ref}},\dot{\boldsymbol\theta}^{\mathrm{ref}}] ψ=[θref,θ˙ref] 是参考动作的进度提示,不等于要求逐关节刚性跟踪;锚点误差中的旋转采用连续的 Rot6D 表示。策略输出归一化动作 a \mathbf a a,转换为下层关节位置 PD 的设定值 θ s p = θ 0 + α ⊙ a \boldsymbol\theta^{\mathrm{sp}}=\boldsymbol\theta^0+\boldsymbol\alpha\odot\mathbf a θsp=θ0+α⊙a。该设定值是塑造执行器力矩的控制变量,不应误读为物理上必须精确达到的轨迹点。训练采用 PPO,运动跟踪策略以 50 Hz 执行。
系统建模同样关键:依据厂家参数处理执行器折算到关节轴的转子惯量(armature)与关节增益,避免将高增益位置伺服作为动作自然性的替代品;随机化集中于地面摩擦/恢复系数、默认关节角偏差、躯干质心,并施加速度扰动。论文强调部署代码的实时性和同步性,与奖励公式共同支撑仿真到现实的迁移。
2.2 长序列的失败率自适应采样
把参考动作划成约 1 秒的片段,记第 s s s 段的平滑失败率为 f ˉ s \bar f_s fˉs。每次复位时,对更容易失败的片段赋更高抽样概率,并把失败片段之前的数个片段也纳入关注,以便学习导致失败的先行状态。原文采用指数滑动平均 f ˉ s ← 0.999 f ˉ s + 0.001 f s \bar f_s\leftarrow0.999\bar f_s+0.001f_s fˉs←0.999fˉs+0.001fs、小的均匀概率底数,以及衰减系数 ρ = 0.8 \rho=0.8 ρ=0.8 的前视失败卷积;核心抽样关系可写为
p s ∝ ∑ u = 0 2 ρ u f ˉ s + u , ∑ s p s = 1. p_s\propto\sum_{u=0}^{2}\rho^u\bar f_{s+u},\qquad\sum_s p_s=1. ps∝u=0∑2ρufˉs+u,s∑ps=1.
这一机制会随困难片段逐渐学会而回到较均匀的覆盖。论文报告:没有自适应采样,四个测试动作中有三个在 30k 次训练迭代后仍存在无法完成的困难片段;较容易的动作所需迭代次数也可由约 4k 降为 2k。这里的结论来自论文指定的消融条件,不代表所有动作都能获得相同比例加速。
2.3 第二阶段:DAgger 蒸馏与潜空间扩散
直接扩散低层 PD 设定值会遭遇动作不规则、噪声与推理延迟。论文先训练条件 VAE:编码器从参考进度和锚点误差得到运动意图 z = E ( ψ , e a n c h o r ) \mathbf z=\mathcal E(\boldsymbol\psi,\mathbf e_{\mathrm{anchor}}) z=E(ψ,eanchor);解码器把潜变量与重力方向、IMU 速度、关节状态、上一动作等本体反馈结合,重建专家动作:
a ^ = D ( z , [ g , V i m u , θ , θ ˙ , a l a s t ] ) . \hat{\mathbf a}=\mathcal D\!\left(\mathbf z,[\mathbf g,\mathcal V_{\mathrm{imu}},\boldsymbol\theta,\dot{\boldsymbol\theta},\mathbf a_{\mathrm{last}}]\right). a^=D(z,[g,Vimu,θ,θ˙,alast]).
VAE 用 DAgger 式闭环数据聚合蒸馏跟踪策略,并用动作重建损失和 D K L ( q E ( z ∣ ⋅ ) ∥ N ( 0 , I ) ) D_{\mathrm{KL}}(q_{\mathcal E}(\mathbf z\mid\cdot)\Vert\mathcal N(0,I)) DKL(qE(z∣⋅)∥N(0,I)) 正则潜空间。KL 项在这里服务于 VAE 潜变量分布的正则化;第一阶段 PPO 运动跟踪目标不是用 KL 对齐专家动作分布。
随后让蒸馏后的 VAE 在仿真中运行,采集过去 N N N 步、当前及未来 H H H 步的 τ = ( s t − N , z t − N , … , s t + H , z t + H ) \boldsymbol\tau=(\mathbf s_{t-N},\mathbf z_{t-N},\ldots,\mathbf s_{t+H},\mathbf z_{t+H}) τ=(st−N,zt−N,…,st+H,zt+H)。扩散网络对状态和动作潜变量联合建模;训练轨迹不包含原参考动作标签,且不同时间位置可设置不同的扩散噪声级,以便固定已观测历史或未来关键帧。状态以当前人物航向坐标系和各时刻局部身体坐标系混合表征,消去无关的世界平移/航向变化,同时保留局部全身运动结构。论文用 Transformer 编码器作去噪骨干,训练其从受扰轨迹重建干净轨迹:
L d i f f = E τ , k , ϵ [ ∥ f ϕ ( τ k , k ) − τ ∥ 2 ] . \mathcal L_{\mathrm{diff}}=\mathbb E_{\boldsymbol\tau,\mathbf k,\boldsymbol\epsilon}\!\left[\left\|f_{\phi}(\boldsymbol\tau^{\mathbf k},\mathbf k)-\boldsymbol\tau\right\|^2\right]. Ldiff=Eτ,k,ϵ[ fϕ(τk,k)−τ 2].
为提高闭环偏离参考时的恢复能力,数据采集还对执行动作施加时间相关的 Ornstein–Uhlenbeck 扰动,形成训练时可见的误差带;与每步独立噪声相比,它更容易穿过 PD 系统的低通效应,产生有意义的状态扰动。
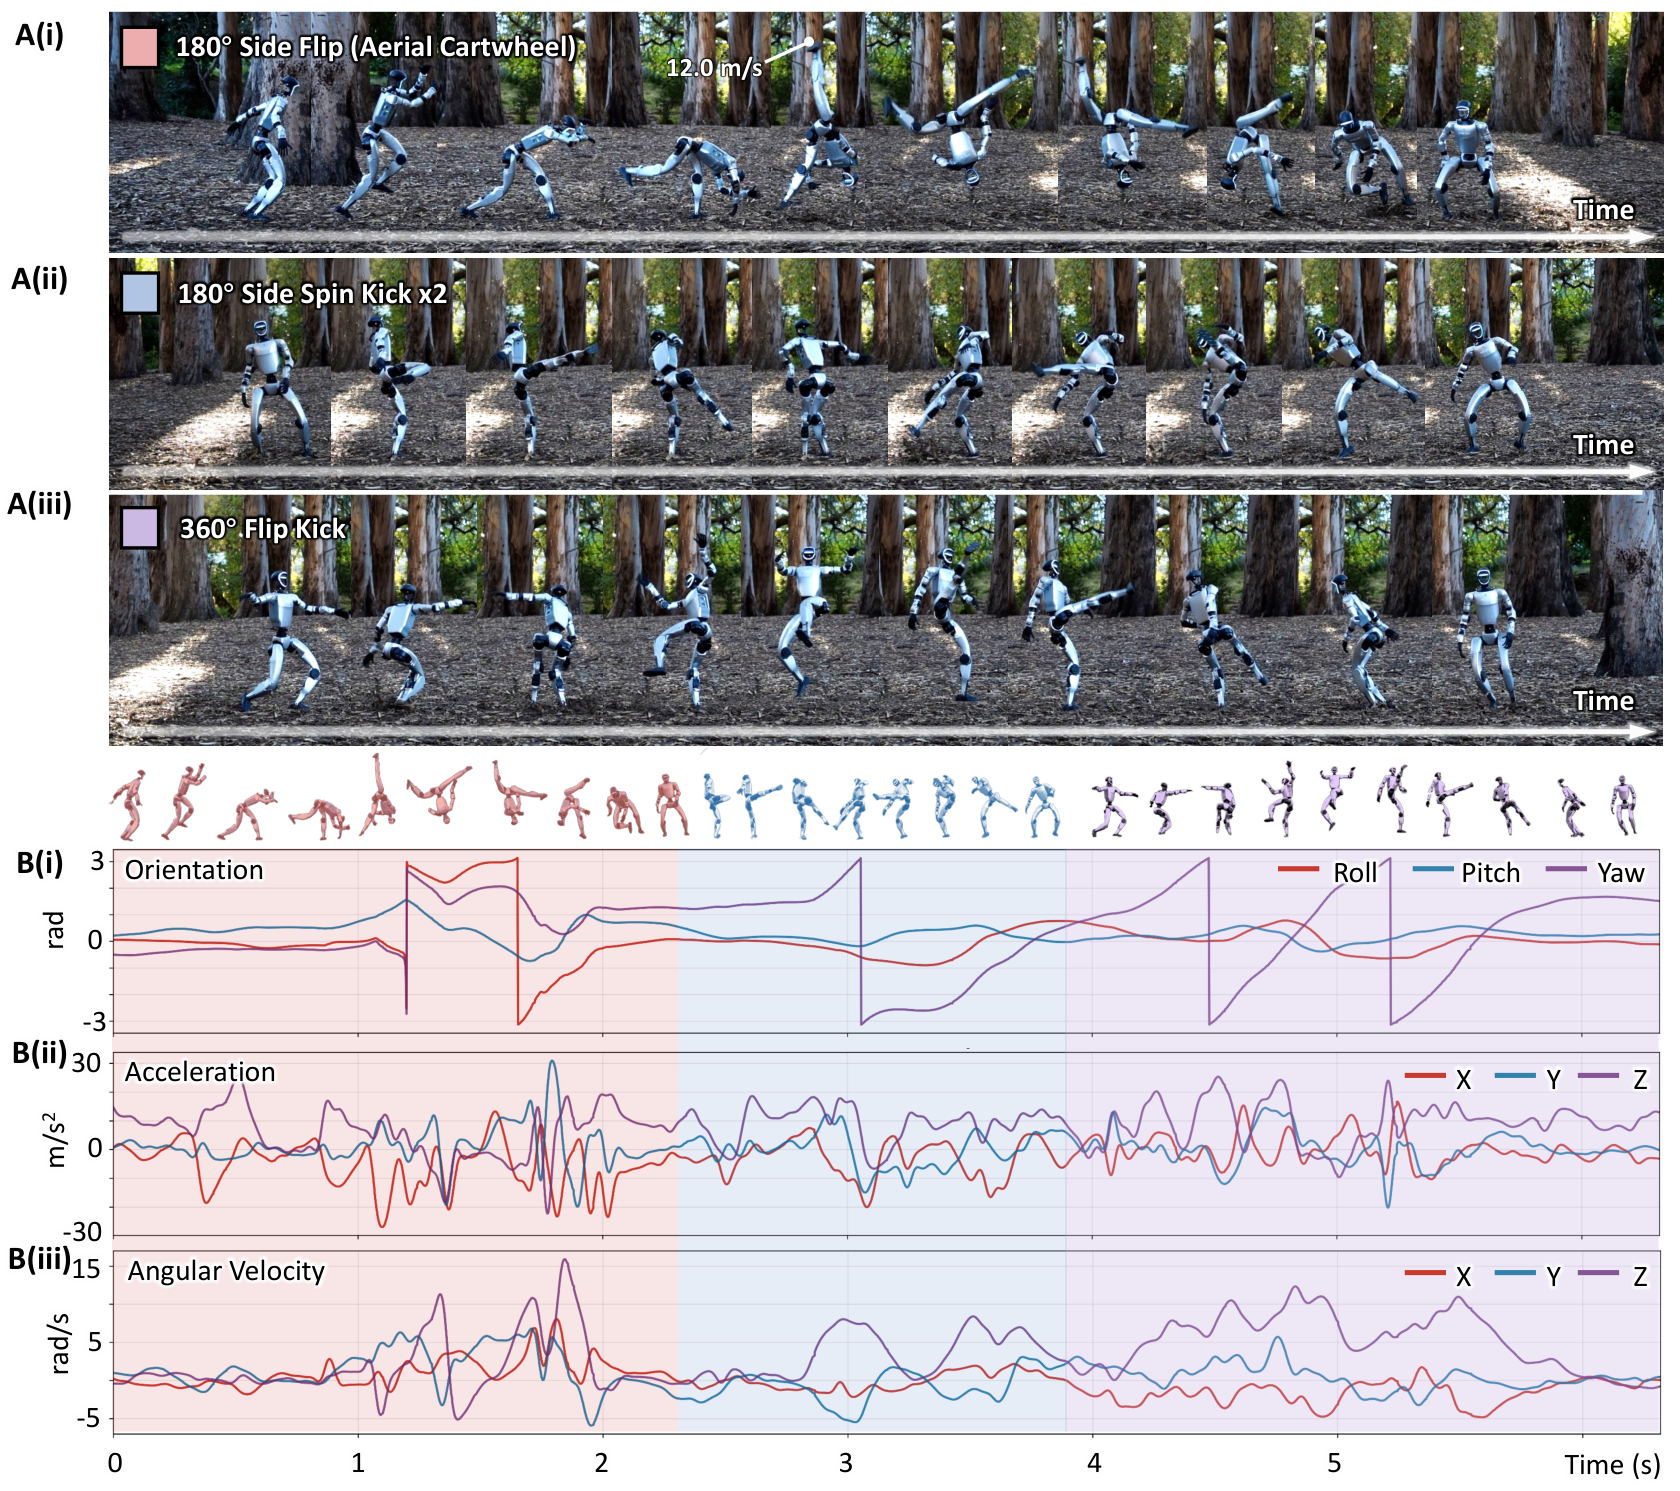
图 3|论文 Figure 3,户外连续空翻、侧旋踢等动作及姿态、加速度、角速度曲线。来源:Liao 等,BeyondMimic,Figure 3。
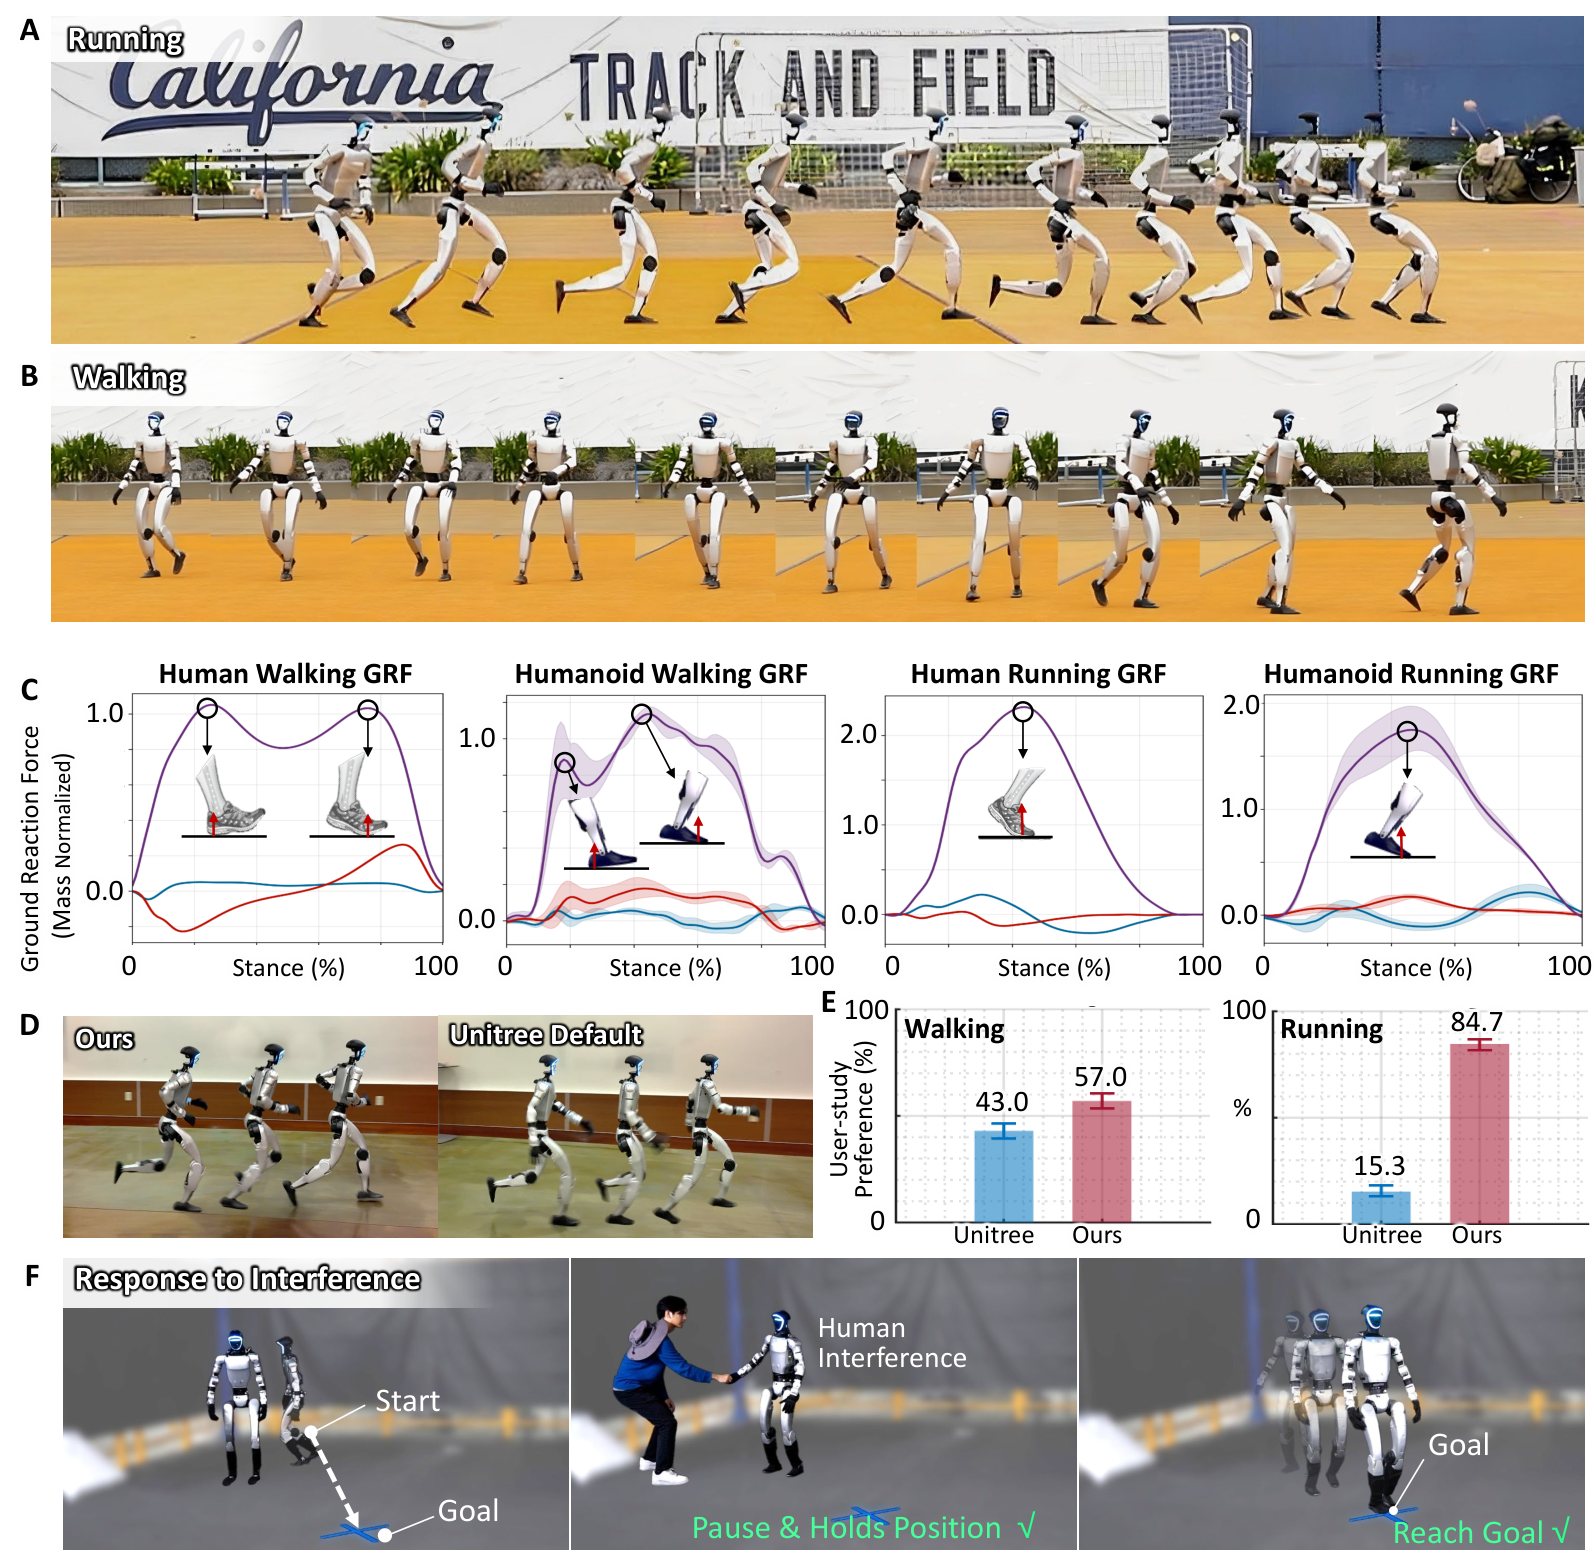
图 4|论文 Figure 4,自然步行和跑步、人机归一化地面反作用力曲线、主观评价与受扰恢复。来源:Liao 等,BeyondMimic,Figure 4。
2.4 推理时的分类器引导:把任务写成轨迹代价
训练好的扩散模型提供可行、自然的人形运动先验。引导的数学依据是条件分布的 score 分解:
∇ τ log p ( τ ∣ τ ∗ ) = ∇ τ log p ( τ ) + ∇ τ log p ( τ ∗ ∣ τ ) . \nabla_{\boldsymbol\tau}\log p(\boldsymbol\tau\mid\boldsymbol\tau^*)=\nabla_{\boldsymbol\tau}\log p(\boldsymbol\tau)+\nabla_{\boldsymbol\tau}\log p(\boldsymbol\tau^*\mid\boldsymbol\tau). ∇τlogp(τ∣τ∗)=∇τlogp(τ)+∇τlogp(τ∗∣τ).
如果把新任务的可微代价写成 p ( τ ∗ ∣ τ ) ∝ exp [ − G ( τ ) ] p(\boldsymbol\tau^*\mid\boldsymbol\tau)\propto\exp[-G(\boldsymbol\tau)] p(τ∗∣τ)∝exp[−G(τ)],那么新增的引导方向就是 − ∇ τ G -\nabla_{\boldsymbol\tau}G −∇τG。在每轮去噪中沿这一方向修正预测轨迹,最后只解码并执行当前时刻的动作,再用新观测更新下一轮规划。这是滚动时域控制;生成的未来状态参与评价,因此能把“向目标走、远离障碍物”这类状态目标变成动作选择的依据。原文称其为 classifier guidance,但实际使用的是可微代价梯度,并不要求另外训练一个图像分类器。
表 1|论文中的新任务代价及实验。 V x y , i V_{xy,i} Vxy,i 为未来第 i i i 步根部的平面速度;具体路点权重与障碍函数见论文补充材料 S3。
| 任务 | 推理期约束或代价 | 对应实验 |
|---|---|---|
| 速度/摇杆跟踪 | 未来平面速度与指定速度的平方误差,例: G j s = 1 2 ∑ i = 0 H ∣ V x y , i − g v ∣ 2 G_{\mathrm{js}}=\tfrac12\sum_{i=0}^{H}|V_{xy,i}-\mathbf g_v|^2 Gjs=21∑i=0H∣Vxy,i−gv∣2 | 走、跑与步态切换 |
| 路点导航 | 越接近目标,越从位置误差转向低速停稳 | 不同起点抵达同一目标 |
| 动作补全 | 固定少量未来关键帧,在其中补全连续状态与动作 | 步行进入侧手翻并恢复 |
| 障碍规避 | 身体点到障碍物的 SDF 配合松弛障碍函数,并与到点代价相加 | 绕过障碍抵达路点 |
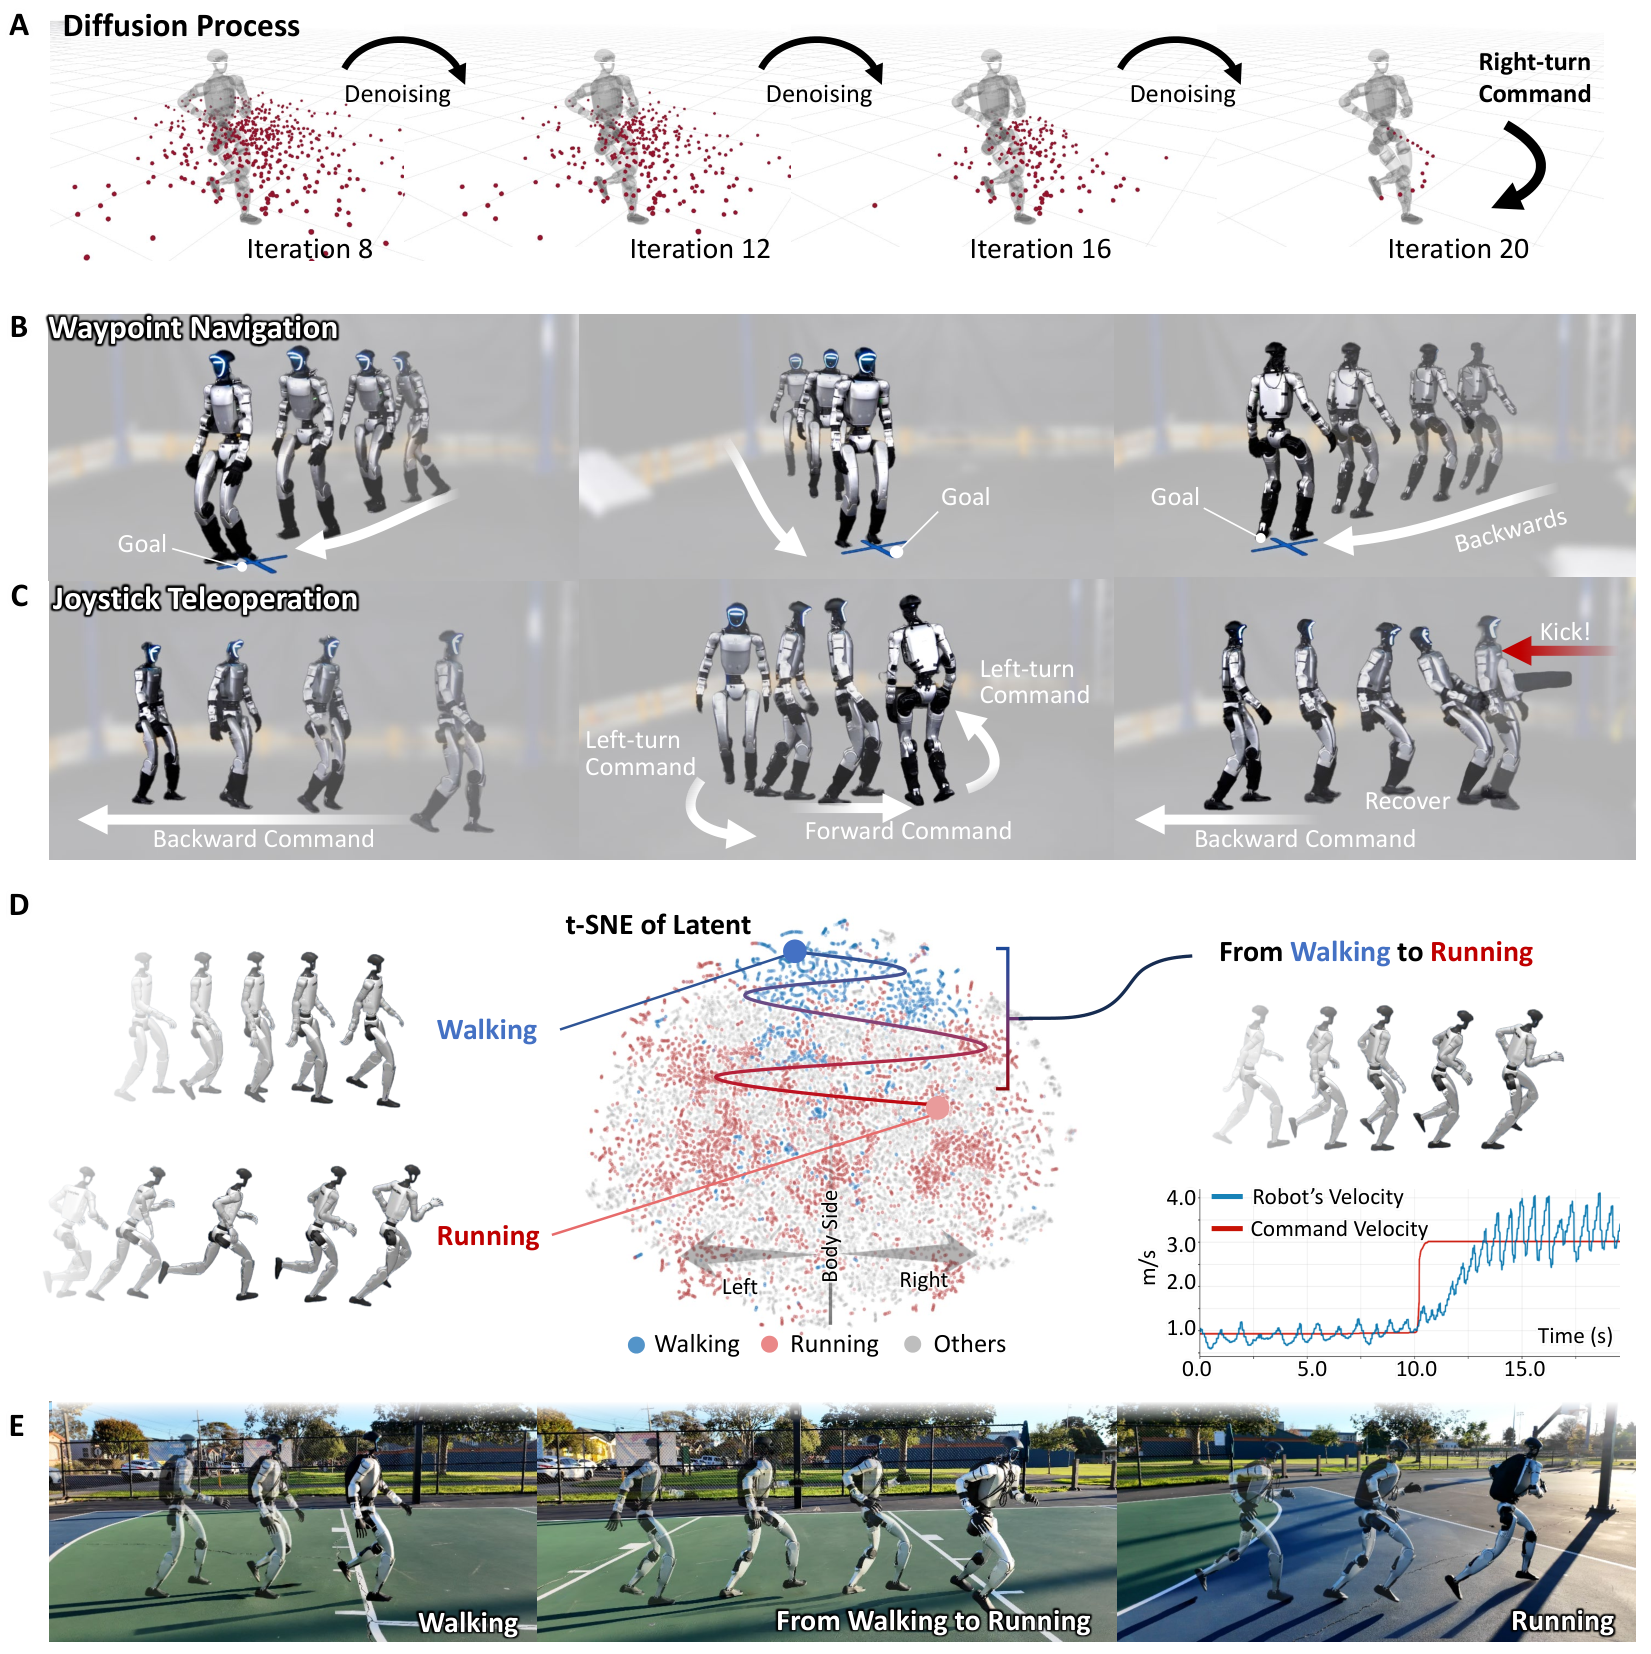
图 5|论文 Figure 5,引导去噪、路点导航、摇杆遥操作以及步行到跑步的连续切换。来源:Liao 等,BeyondMimic,Figure 5。
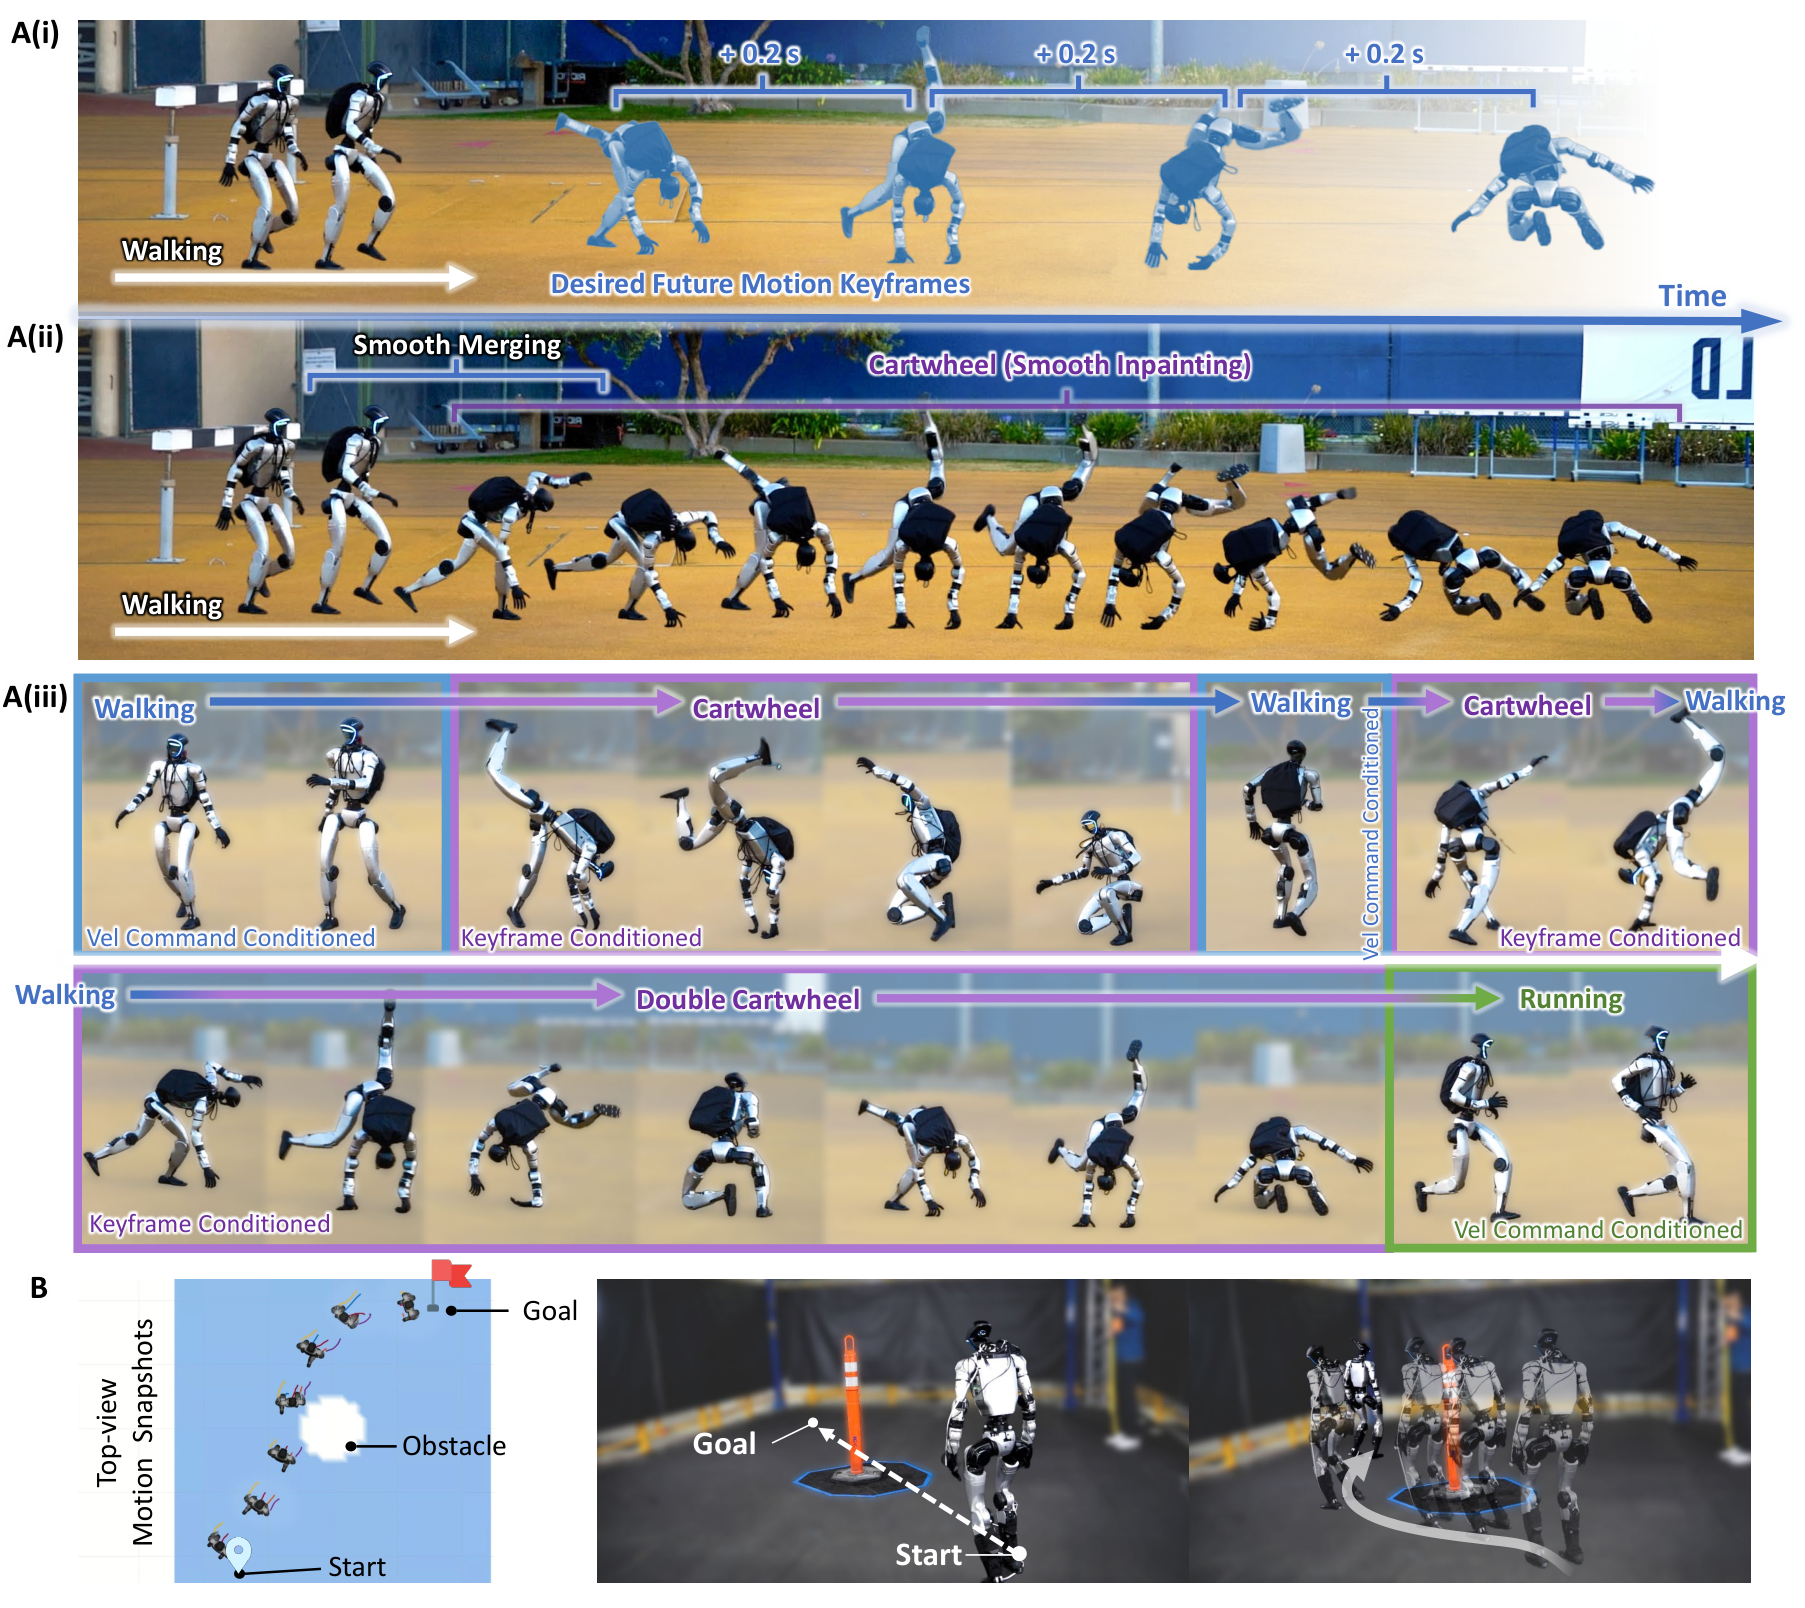
图 6|论文 Figure 6,稀疏未来关键帧驱动的侧手翻补全、多次跨任务切换,以及组合路点和障碍代价的真机绕行。来源:Liao 等,BeyondMimic,Figure 6。
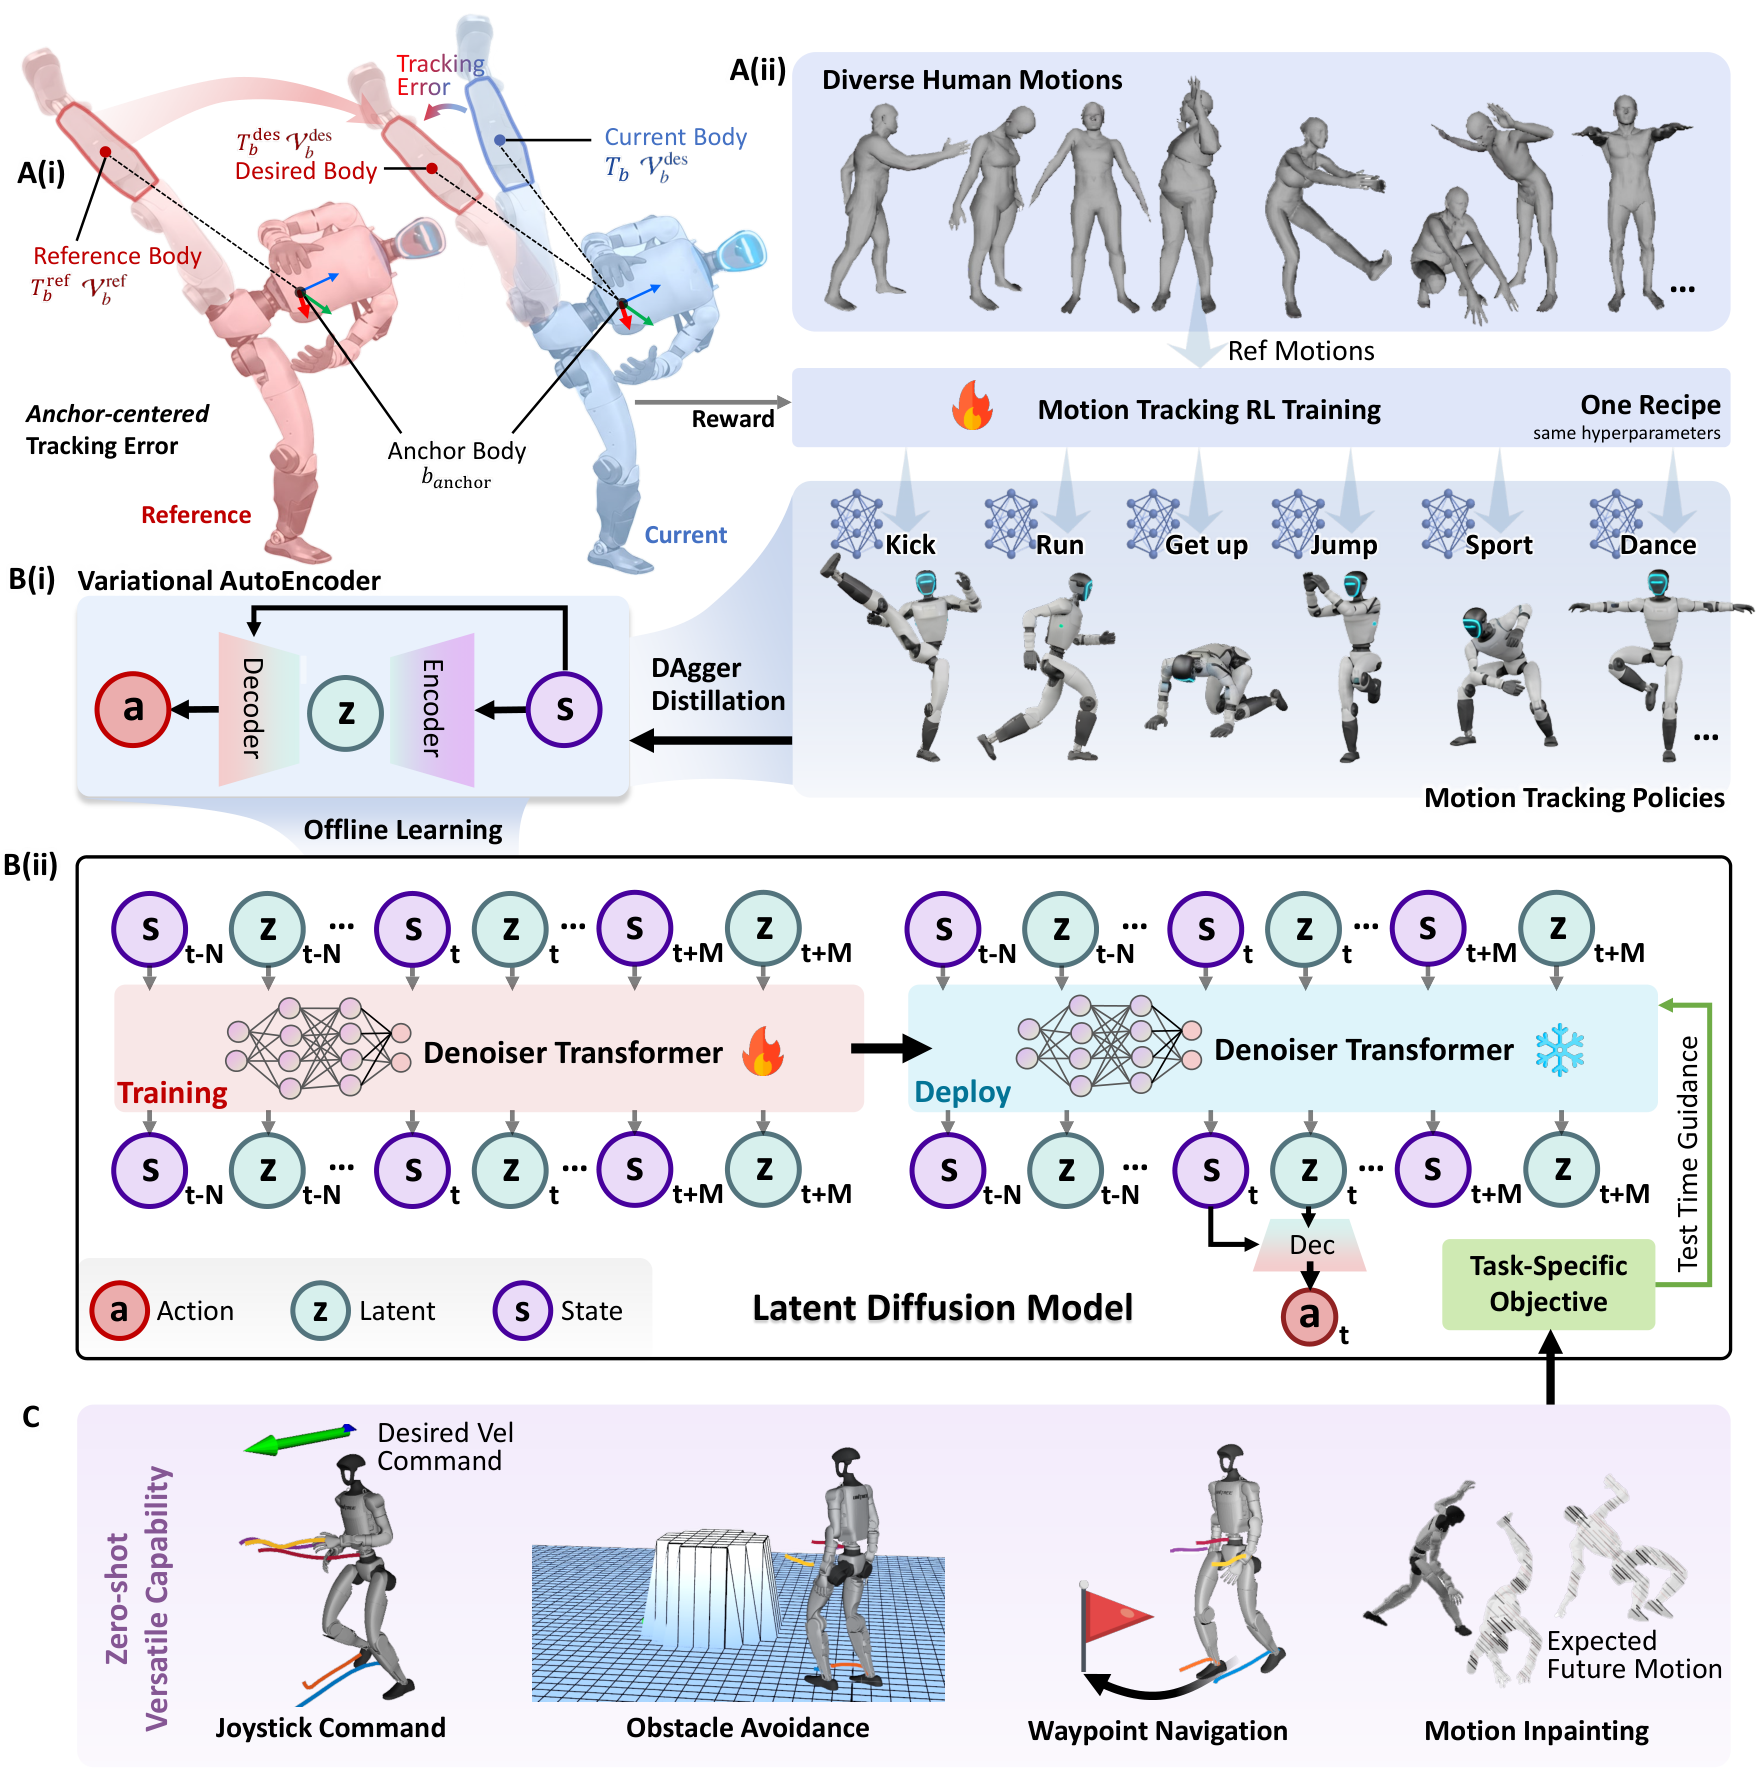
图 7|论文 Figure 7,方法结构原图:A 是运动跟踪及重锚定;B(i) 为 DAgger 蒸馏的 VAE,B(ii) 为联合状态—潜变量轨迹扩散;C 为测试时引导的下游任务。来源:Liao 等,BeyondMimic,Figure 7。
3. 实验设计、关键结果及其边界
实验分为运动跟踪、生成控制与消融三组。运动数据约 2.5 小时,论文称全部参考动作在高保真仿真中验证,选取 30 段、总计约 15 分钟的代表动作进行真机部署。真机测试包含草地、土壤、落叶、不平地面上的平衡、起身、舞蹈、武术、侧翻和跑步等。高动态演示的机体峰值加速度约 31 m/s²、骨盆角速度峰值约 20 rad/s;这些是个别演示的运动学指标,不能直接当作跨所有动作的平均性能。论文在 77 人的成对视频偏好实验中,与宇树原生控制器相比,总体 70.8% 对 29.2% 选择 BeyondMimic 更自然;步行和跑步各有单独统计。地面反作用力形状接近人体,但作者也指出无脚趾关节使步行的冲击峰更尖锐。
生成控制展示速度/路点引导、稀疏关键帧插值和目标加障碍的代价组合。仿真中步行、跑步平均速度跟踪误差分别约 12.14%、13.65%;作者还报告真机跑道上连续跑动超过 50 m。扩散潜空间消融以侧手翻完成率评估:不用潜编码的直接建模基线约 5%,采用潜空间扩散约 95%,这是仿真迁移中的指定任务结果,不应推广为所有下游任务的统一成功率。
真机条件也应分开理解:运动跟踪阶段的姿态估计由机器人板载系统提供,不依赖外部动捕;扩散阶段摇杆控制与动作补全使用本体状态估计,而路点导航和障碍规避演示使用动捕提供环境信息并辅助定位。因此,论文的避障真机结果不能直接解释为板载相机自主感知下的完整导航栈。跟踪网络可用板载 CPU 执行;扩散推理使用移动 RTX 4060 和 TensorRT,20 步去噪约 20 ms,与较轻的 CPU 解码器异步配合;两阶段运行频率也不同(跟踪典型为 50 Hz;扩散相关跟踪配置为 25 Hz)。
消融检验了观测旋转表示、观测历史长度、armature 参数、执行延迟以及自适应复位采样。Rot6D 优于实验中的四元数/轴角替代;在该配置中增加历史观测反而损害真机跟踪;机械惯量不准会增加超调和碰撞;额外 2 ms 延迟已经加大速度误差,5 ms 的三次试验中失败一次,10 ms 失败两次。故性能并非仅来自学习算法,模型参数和实时工程实现同样是方法条件。
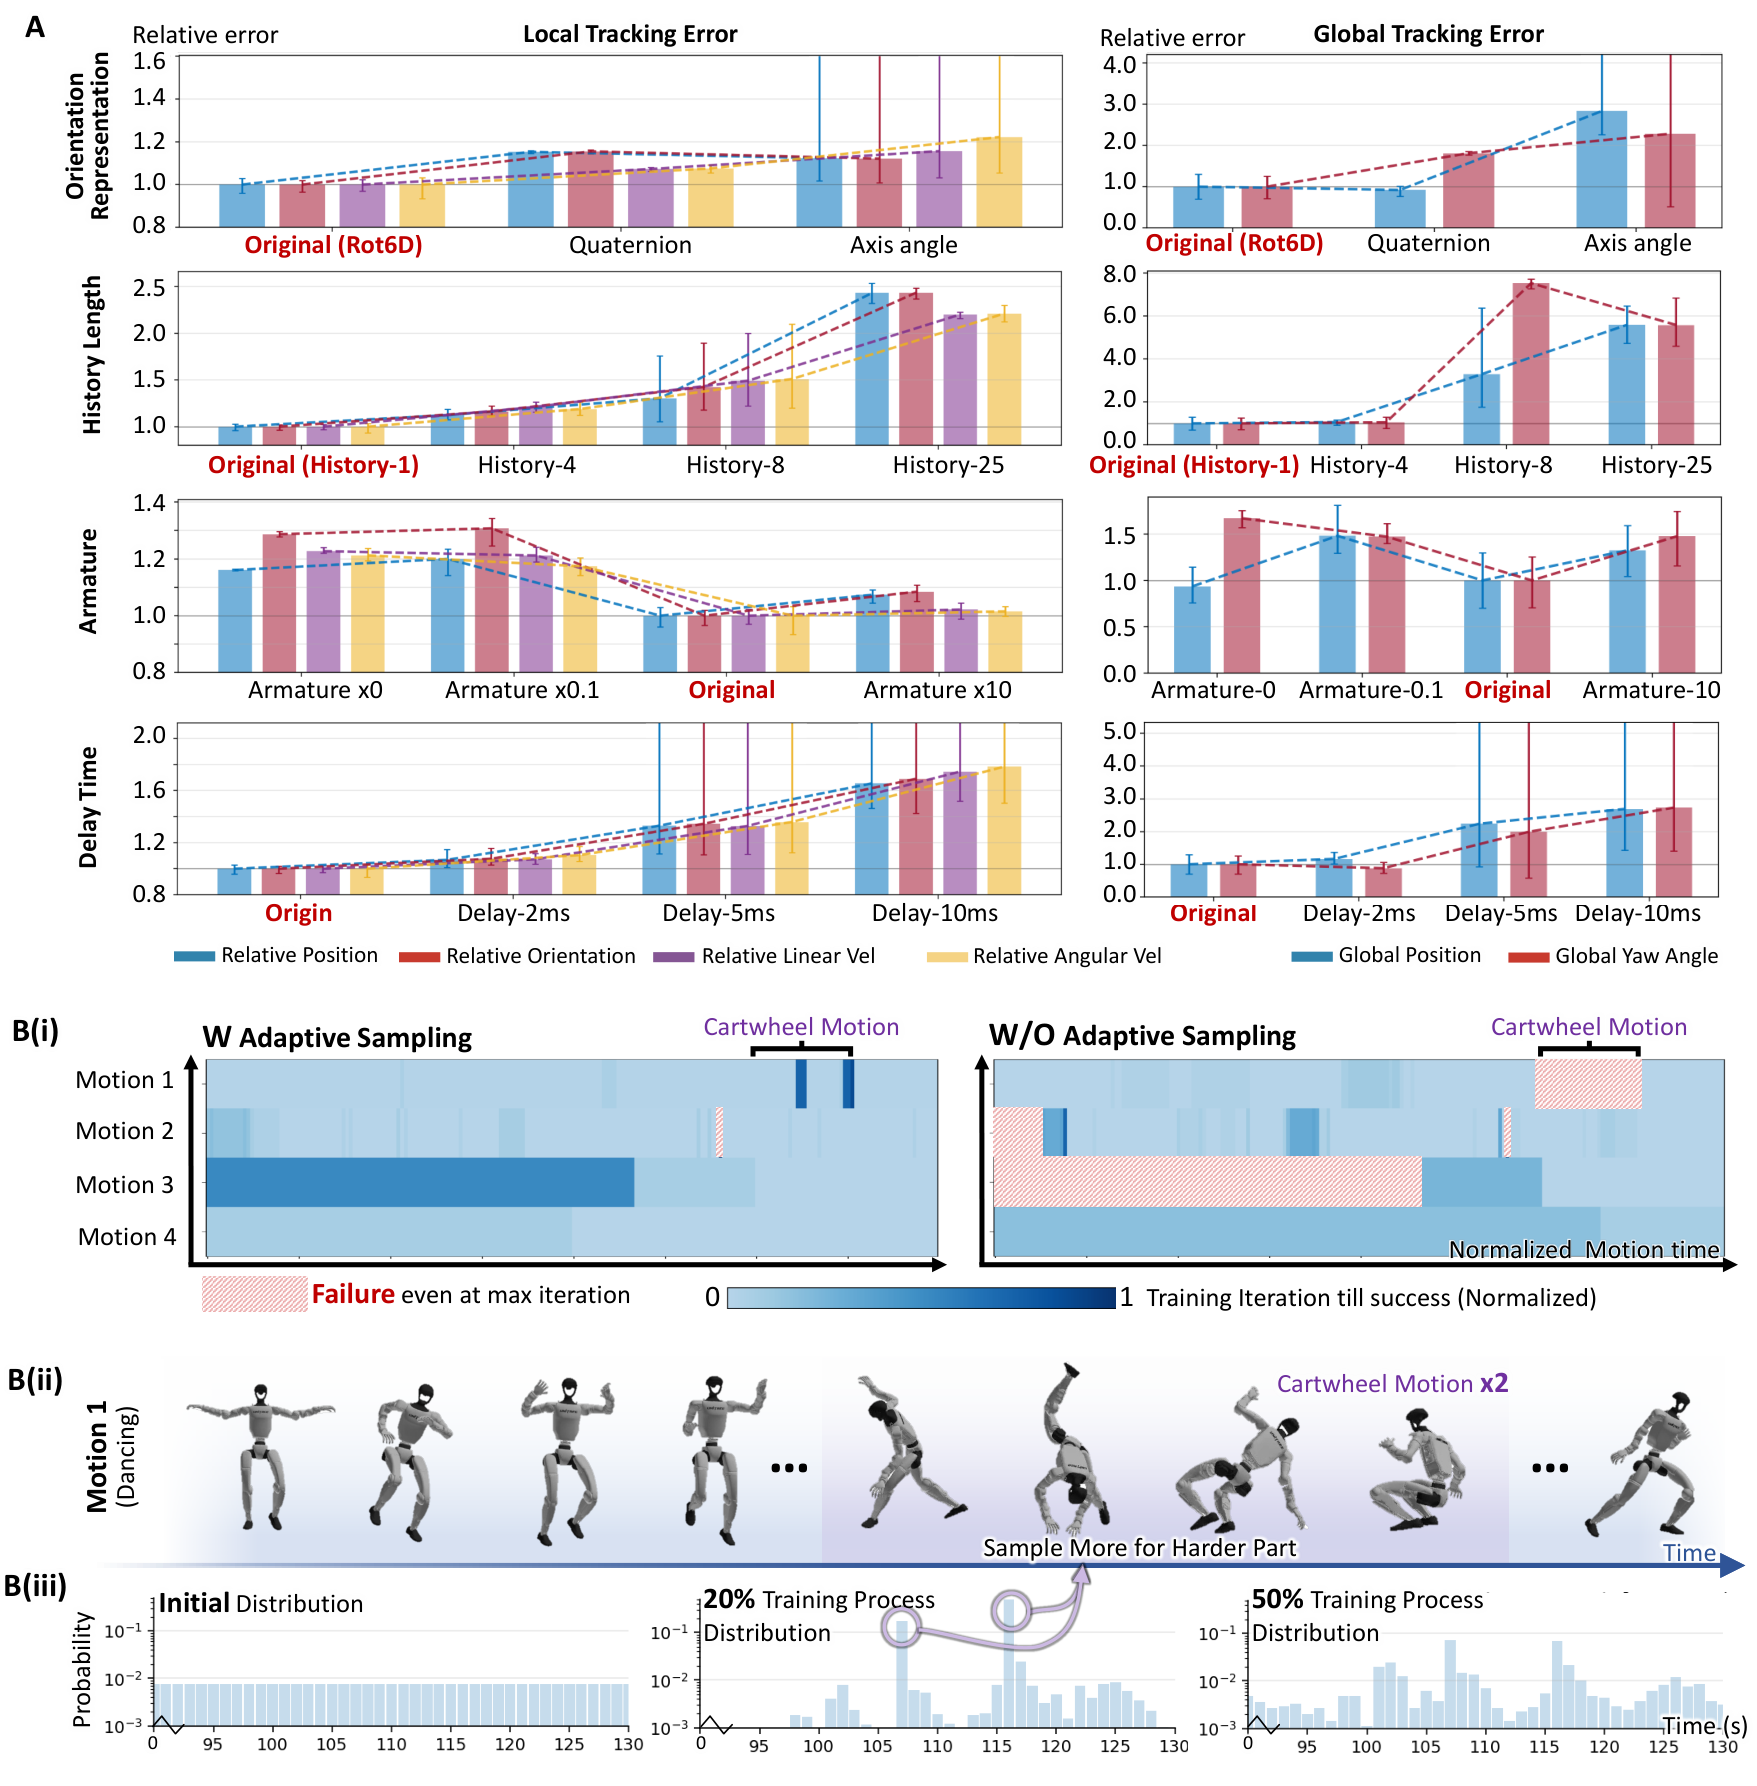
图 8|论文 Figure 8,A 为旋转表示、历史、armature 和执行延迟的真机误差消融;B(i–iii) 为自适应采样与困难侧手翻片段的学习曲线和采样分布。来源:Liao 等,BeyondMimic,Figure 8。
4. 创新点与学术贡献
- 面向动作扩展的简洁跟踪配方。在身体任务空间构造统一奖励,用锚点相对表示允许合理漂移,仅保留三项必要正则,并配合准确执行器惯量、适中的阻抗、有限随机化和低延迟部署,让多类参考动作共用训练设置。贡献是减少逐动作调参的依赖,同时保留高动态与动作自然性。
- 针对长参考序列的失败感知学习。把复位时的起始相位集中在难片段及其前序片段,改善难动作的样本使用效率,并通过消融给出具体证据。
- 从专用动作专家到统一、可组合的轨迹先验。先借助 DAgger 将多专家的动作意图编码为平滑潜变量,再对状态与潜变量的过去—未来联合轨迹扩散建模,避免直接在粗糙关节设定值上生成,同时保留“动作会造成什么未来状态”的预测关系。
- 以推理时可微代价实现零样本任务适配。通过 score/代价梯度引导未来轨迹,组合速度、关键帧、路点与避障目标,无需为每种目标重新训练策略。这里的“零样本”是相对于这些未在扩散训练中标注的下游任务而言,不能理解为无需运动数据、无需训练或无需环境信息。
- 真机闭环证据与明确的系统边界。论文同时给出复杂动作真机演示、主观自然性实验、地面反作用力比较、延迟/物理参数消融以及扩散控制任务,形成比单纯仿真演示更完整的论证。
5. 局限、复现要点与研究启示
论文自身承认,扩散控制依赖状态估计质量;预测时域为 0.64 s,有利于局部反应但不足以解决需要远距离预判的长期规划;历史条件可能造成重复运动模式,增大引导权重虽能打破惯性,却容易在动作起止及模式切换时损害稳定性;精细目标仍不如粗粒度目标容易通过现有引导满足,引导权重也需要少量调整。论文有一处方法式中的编码条件符号与周围叙述不完全一致,本解读采用上下文一致的 E ( ψ , e a n c h o r ) \mathcal E(\boldsymbol\psi,\mathbf e_{\mathrm{anchor}}) E(ψ,eanchor) 表述,复现时应以实际实现为准。
补充材料原图(与正文图号区分)
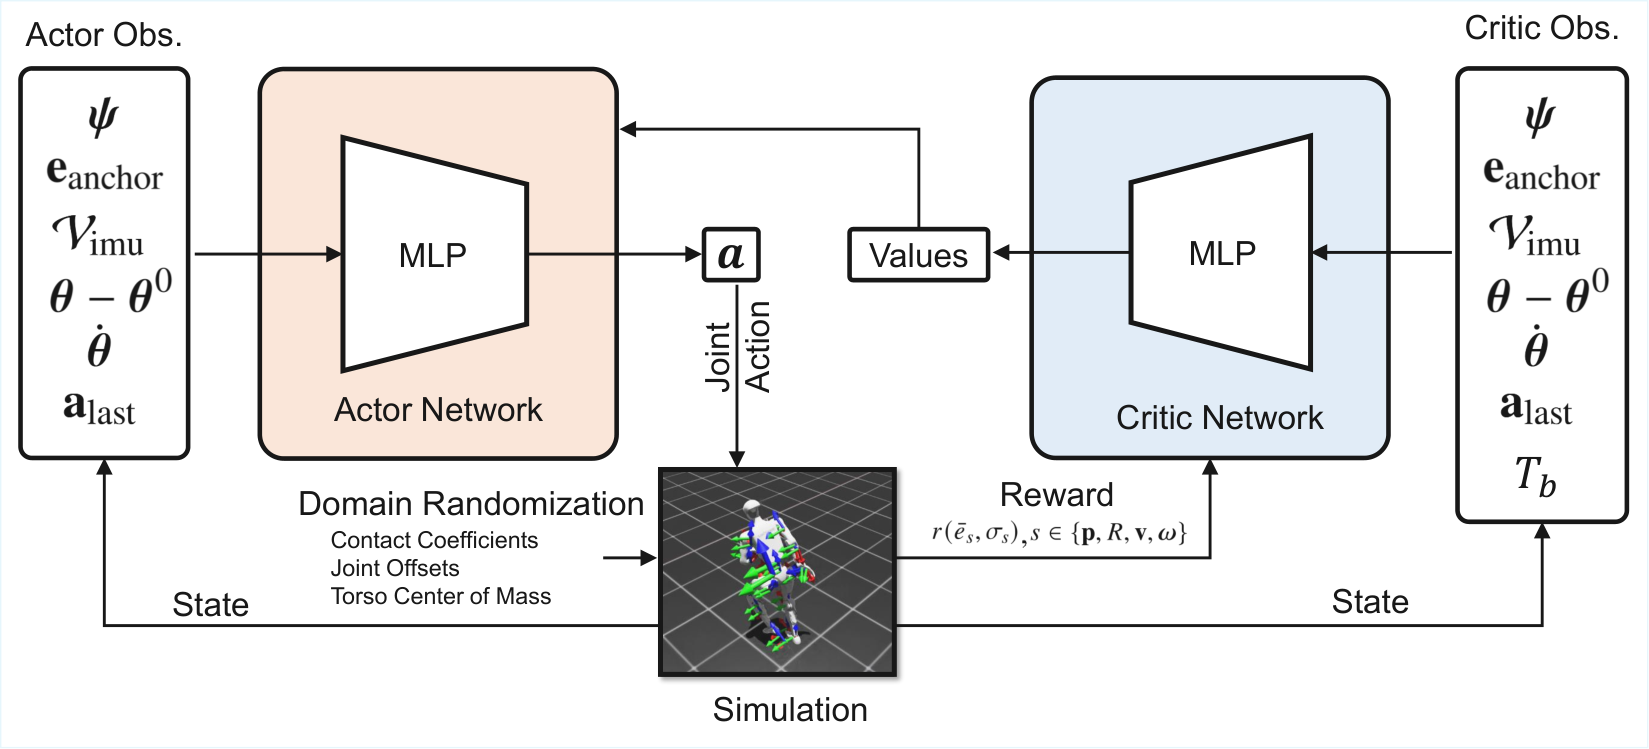
图 S1|论文补充材料 Figure S1,演员—评论家跟踪架构、观测、奖励及三类随机化设置。来源:Liao 等,BeyondMimic,Figure S1。
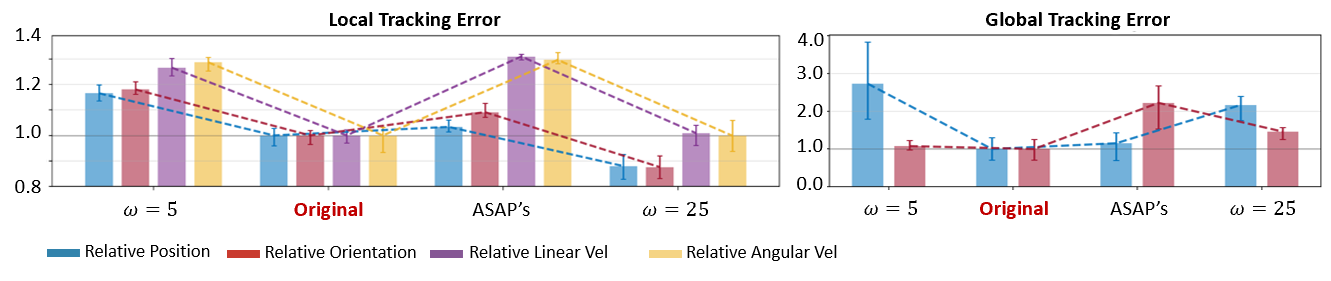
图 S2|论文补充材料 Figure S2,PD 增益选择的附加消融;论文采用较适中的 10 Hz 自然频率以平衡跟踪和执行器冲击。来源:Liao 等,BeyondMimic,Figure S2。
资料来源:论文原文与补充材料;作者项目主页;官方运动跟踪代码及 README。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献49条内容

所有评论(0)