看到Gen-HumanEgo开源后!Training-Ready Data将会是无本体数据的新要求。
大家对人类数据的兴趣越来越大了。
尤其是 Ego 方案。
它离人类真实操作最近,看起来也最像机器人应该学习的那类经验。
但它长期存在的问题,一直没有被很好解决。
第一视角视频不会告诉模型手怎么动、物体在哪里、任务步骤如何变化。
还有那个一直被认为是客观评估质量的标准:多模态信息如何在时间和空间上对齐,这件事也不容易。
今天,GenRobot 正式开源Gen-HumanEgo。
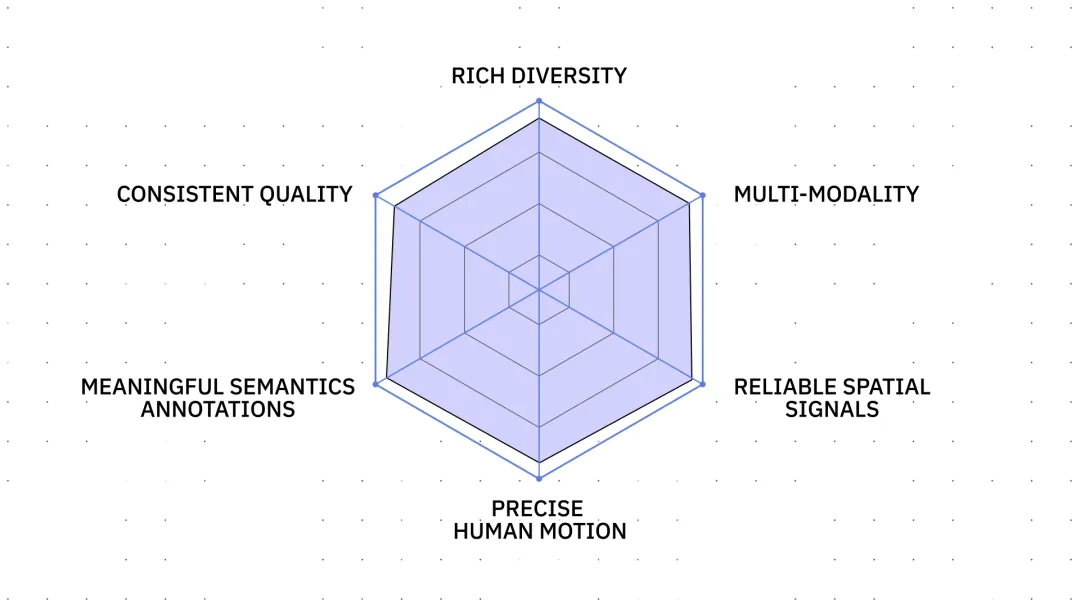
这是一套面向第一视角人类行为数据集,包含 1,800+ 小时人类操作示范 Ego 数据,覆盖 10,000+ 项不同任务。
开源地址(欢迎试用):https://huggingface.co/datasets/genrobot2025/Gen-HumanEgo
数据官网:https://www.genrobot.ai/data/open-dataset
而且,它进入策略训练时可以直接被使用,用于提升模型性能与学习效率。
规模和场景丰富度之外,Gen-HumanEgo传递的更有价值的点是:什么样的 Ego 数据才真正值得拿去训练模型?第一视角人类视频如何被转化为可以直接被模型训练使用的多模态信号?
后者也是能让 human data 走向机器人训练的关键。
01 人类视频正在从 “采下来” 走向 “可训练”
之前,每当讨论数据时,基本都先看规模。
多少小时、多少场景、多少任务、多少条轨迹。
这些确实重要。
没有规模,模型很难从真实世界里学到足够多的变化。但只看规模,很容易漏掉另一个问题。
一段 Raw Human Data 可能只是记录。
虽然来自真实世界,但这还不等于模型能直接从里面学到稳定的经验。
一旦到训练端,原始视频就不能只停留在画面记录,需要被转成可监督、可索引、可复用的结构化信号。
这是数据的可训练性问题。
模型对数据的要求是:动作要可表达,空间要可对齐,任务语义要能被拆开,质量还要足够稳定。
要Training-Ready。
行业初期关心低成本采到足够多的人类行为。但当下问题变成了:采到之后,能不能把它能够直接被训练使用、对齐的数据资产。
02 一段人类操作里,机器人真正需要看的东西比视频多得多
拿起一个物体,看起来是一个很简单的动作。
但如果我们把它放到机器人学习里,这个动作其实包含很多层信息。
手腕在哪里,指尖在哪里,手指关节如何弯曲,手掌如何调整角度,手和物体之间的距离如何变化,动作从接近、抓握到移动又如何连续发生。
原始 RGB 视频能看到结果,但监督信号真的很“薄”。
机器人需要更细的信息。
尤其是灵巧操作场景里,很多关键差别都藏在手指和物体接触前后的几厘米里。
Gen-HumanEgo这次,把第一视角视频拆成了几层信息。
这几层,组成了模型能用的完整结构化训练数据。
第一层是手的运动。
手不是画面里一个会动的轮廓,而是一套连续变化的三维几何。
Gen-HumanEgo中,通过21 个三维关键点给出手腕、关节、指尖的位置,MANO 参数约束手的形状和姿态,完整 Hand Mesh 把手掌和手指的表面也还原出来。
这样一来,模型看到的就不是“有人把东西拿起来了”,而是手指怎么弯、掌心怎么转、两只手怎么配合,动作如何从接近物体一路过渡到抓握和移动。
第二层是空间信息。
Depth 去弥补的是 RGB 最容易缺掉的那部分:手、物体和环境之间的距离关系。
人类不用想也能判断一个杯子离手还有多远,但模型如果只有二维画面,很多交互都会被压成纹理变化。
遇到透明、高反、细小结构或者快速运动时,这个问题会更明显。
第三层是任务语义。
机器人训练不只需要知道“发生了抓取”,还要知道动作进行到哪一步:接近、接触、抓握、移动、放置,各自对应不同的状态变化和监督信号。
这些内容,展示的正是一段人类操作,怎样被拆成机器人可以学习的过程。
而能够产生这么完整和丰富的数据,依赖的是采集端和强大的数据处理链路。
03 “无死角”的采集设备和数据专属的基础模型
采集端,GenRobot使用了六目Ego设备。
而处理这个采集数据的,还有一个基座模型。
两者构成了完整的从输入到输出的数据处理链路。
之前,我们一直讨论的基模大多是为了服务action。
而GenRobot,提出了一个专为数据服务的Data Foundation Model。它更是一套端到端的多模态数据生成与持续进化系统。
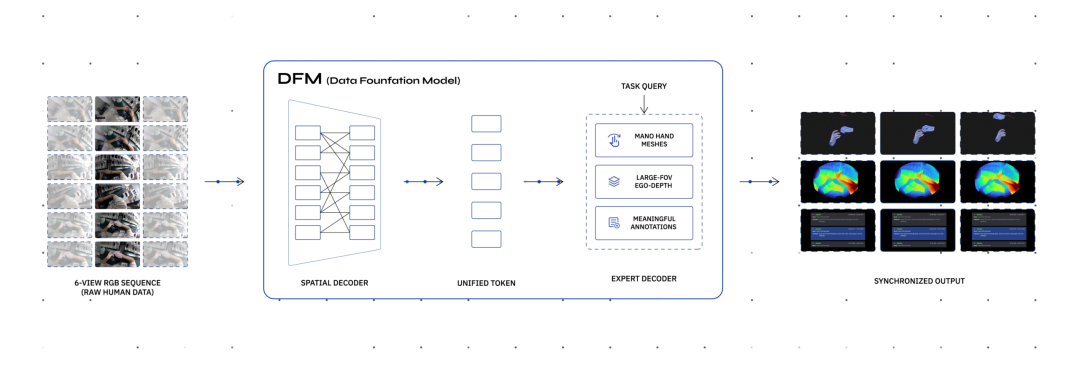
解决的是将Raw Human Data转换为高精度、多模态、时空对齐、可直接用于训练的Training-Ready Data。
解决人类视频存在的缺陷、跳变和不稳定
Gen-HumanEgo 这次没有选择单个相机,直接上了六目。
六路相机的意义在于补足单视角的天然缺陷。
部分遮挡
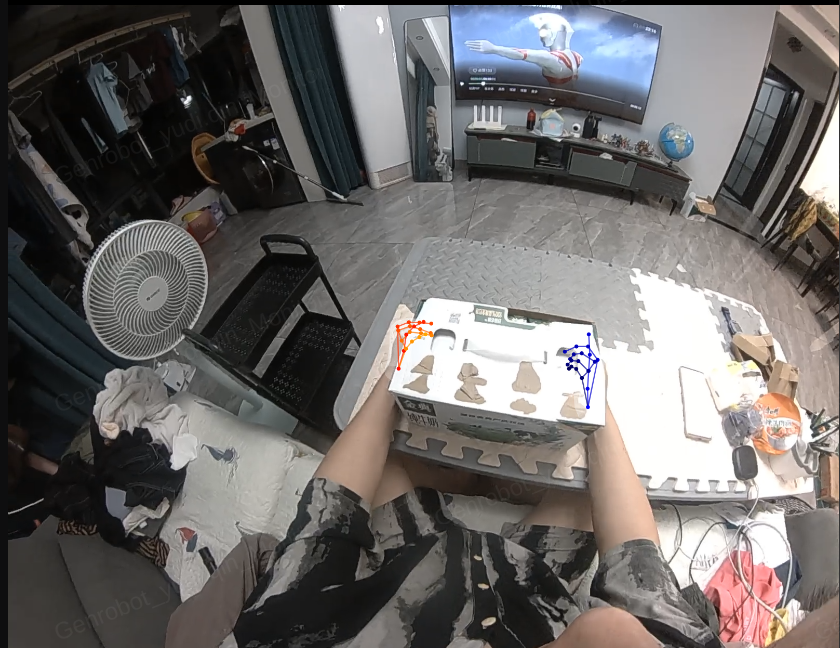
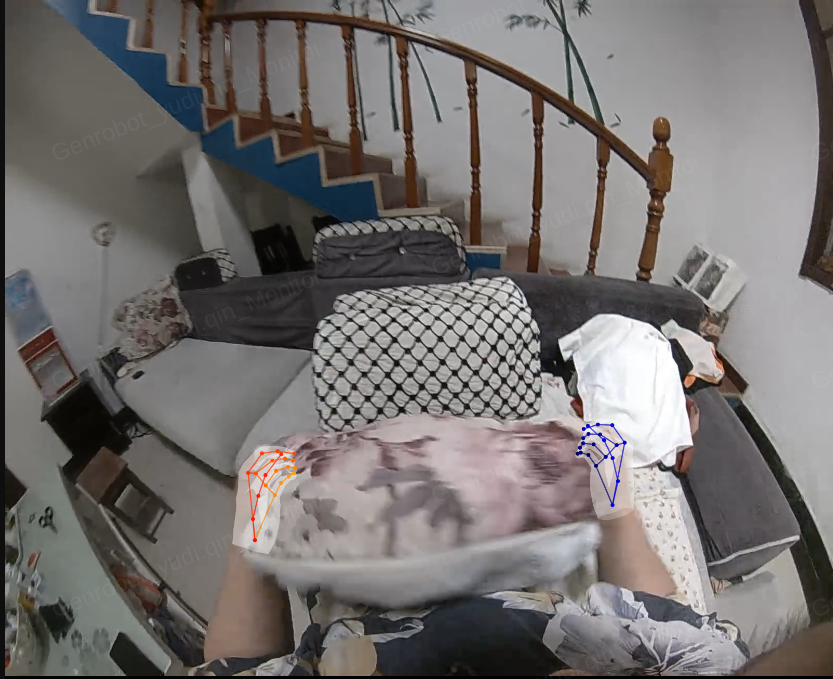
真实人类操作里,手会互相遮挡,会出画,会重新入画,会快速运动,手指关节长度也可能在跟踪中出现漂移。
单视角方案在这些场景里很容易出现跳变和不稳定。
运动模糊
多视角输入让系统能从更完整的空间关系里恢复动作。
再加上时序信息,模型可以利用连续帧之间的运动一致性,让轨迹更稳定。
据悉,目前GenRobot已经能实现手部追踪 1 cm量级下的定位精度。
这对长序列数据尤其重要。
单帧精度当然要看,但机器人训练更怕的是长时间不稳定。
一个动作如果每隔几帧就跳一次,或者遮挡之后重新入画无法稳定关联,后面的训练信号就会变脏。
深度也是类似逻辑。
GenRobot 目前的深度真值生产系统精度已经到了毫米级,多设备同步误差控制在 5 毫秒以内。
Data Foundation Model:一套持续进化系统
六路相机解决了“看得全”。
但一段 Ego 视频本质上还是原始记录。
每一帧里都有视角、手部运动、物体姿态、深度和任务步骤。真正难的地方,不是分别把这些信息标出来,而是让它们在同一条时间线、同一个空间关系里对上。
DFM 要处理的正是这段转化压力。
通过统一感知基座、多源混合训练和时空多视角融合,生成模型训练需要的监督信号,包括 Hand Tracking、6D Pose、Depth、Task、Sub-task、CoT 语义标注等。
GenRobot的这条链路已经给出了一些工程指标:Hand Tracking 和 6D Pose 都达到 1 cm 以内精度;Raw Data 到 Model-Ready Data 的转换约 1 分钟完成,整体数据生产效率提升 3.2 倍。
还有一个值得注意的是,质量验证被前置到了数据生成阶段。通过 Ground Truth 评测和模型反馈,系统可以持续发现弱势场景,再反向指导补采和迭代。
DFM正在高效地把真实人类操作怎样稳定地变成机器人模型可以学习的世界经验。放回 Gen-HumanEgo,这条链路的意义就很清楚了。
04 首个全量“Hand Mesh × Depth” 的Ego 数据
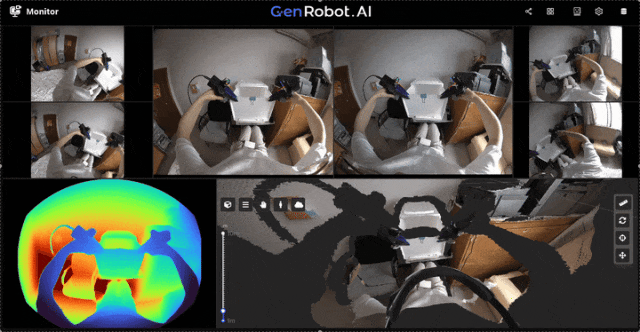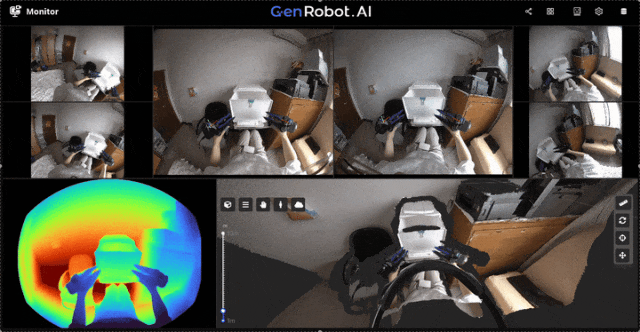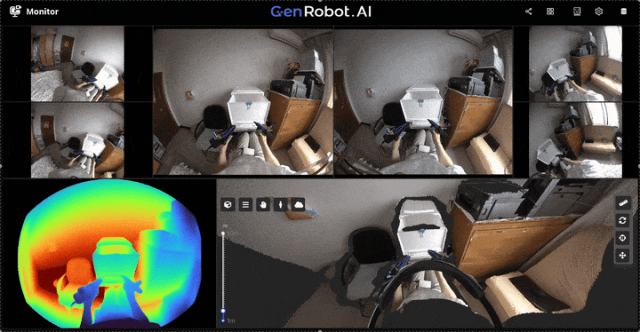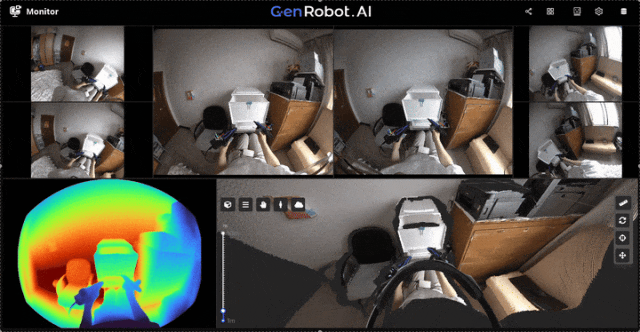
这次开源的数据里,还有一个亮点:“Hand Mesh × Depth”。
而且是业内首个具备这个能力和信息的数据集,而且是基于DFM处理的。
Hand Mesh 可以理解成比关键点更完整的手部表达。
关键点记录的是手腕、关节、指尖这些位置;MANO 参数进一步约束手的形状和姿态;再往前走一步,系统就可以把手掌、手指、关节结构和表面几何重建成完整的三维手部模型。
这件事对灵巧操作很重要。
很多动作的差别,不在“手有没有出现”,而在手指怎么弯、掌心怎么转等关键操作。单纯 RGB 视频很难稳定表达这些细节,关键点也只能给出骨架位置。
Hand Mesh 补上的,是更连续、更细颗粒度的手部几何。
为了进一步提高 Hand Mesh 在复杂真实环境中的重建精度与稳定性,数据集还融合多相机和时序信息增强场景理解。
Depth 补的则是空间关系。
它让模型看到手、物体和环境之间的距离变化,而不是只在二维画面里猜动作。尤其是在完成抓握、旋转、插拔、开合等任务下(还有光照不足、反光等),手部几何和深度信息放在一起,更接近机器人真正需要学习的监督信号。
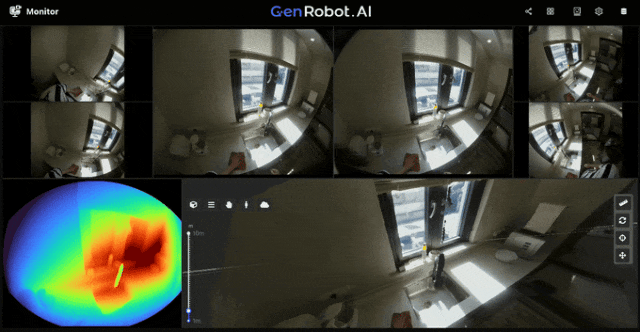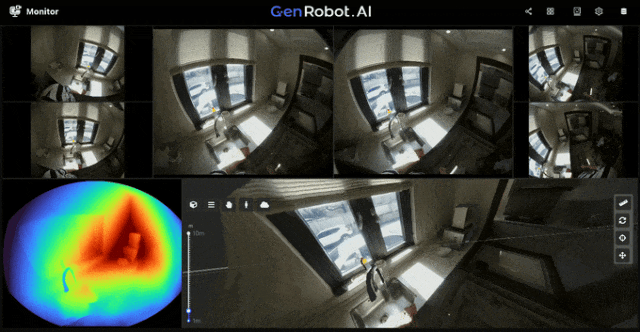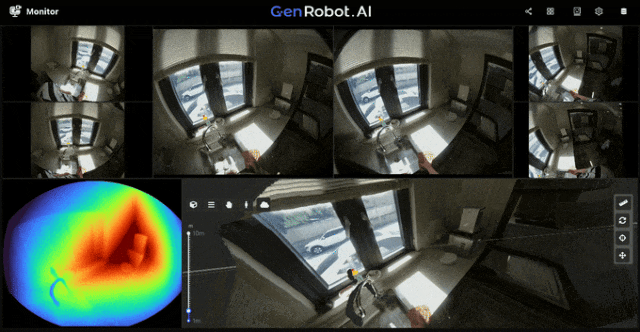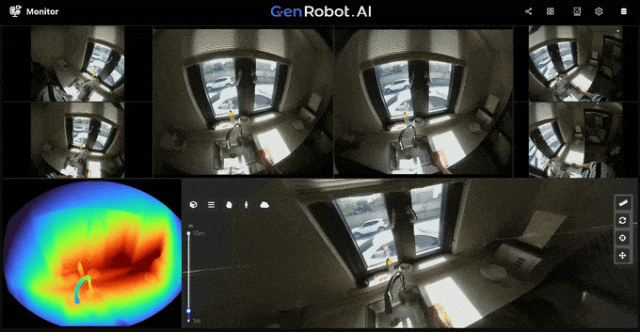
逆光玻璃环境下擦金属台面
开关抽屉
所以 Hand Mesh × Depth 的价值,不是多了几个维度信息,而是让第一视角人类示范从“看见人怎么做”,继续往前走到“描述人怎么在三维世界里完成操作”。
这对推动Human-to-Robot Learning以及In-Context Learning 这类研究有着促进作用。
05 从 UMI 到 Ego,押的是无本体 + Data Infra
这不是GenRobot第一次开源。
如果扒一下之前的信息,他们的推进线索很清晰。
1 月他们开源了 10Kh Real Omni-Open Data(当时行业规模最大的UMI数据),4 月将其扩展到 1.3 万小时级 ,当下的9 月则是 Gen-HumanEgo。
都是无本体下的数据探索。
UMI 给了怎样在真实场景里规模化获得人类示范的路径。**紧接着把 Ego 往前推了一步,更结构化了。**开始处理第一视角下更细的动作、空间和语义表达。
所以可以看到,从 UMI 到 Ego,变化不只是采集设备,还有数据密度:人类在物理世界操作的完整信息。
而支撑这个能力的,则是一套越来越完整的data infra。
Gen-HumanEgo 这次并不是孤立的数据集发布,而是又一次无本体数据上的优化提升。
06 写在最后
Gen-HumanEgo给了一条路线:人类行为数据应该怎样从记录,走向可训练。
机器人要学人类技能,不能只看一个动作的结果。它需要知道手怎么动,接触什么时候发生,任务步骤如何变化。
这些信息如果不能被稳定表达和对齐,再大的视频规模也很难直接变成我们想要的训练能力。
从 UMI 到 Ego的转变,是规模化示范到结构化训练的信号。
而完成结构化信息的生成,背后则是一套完整的data infra,这也是GenRobot持续押注的。
谁能短时间内采集输出更丰富的场景和机器人学习数据,谁就能赋予基模更大的能力。
这将会是物理AI时代的关键。
重磅!
全网首个!具身智能开源知识库来啦(技术/产业/投融资/上下游)
推荐阅读
我们用低成本的机械臂完成pi0/pi0.5/GR00T/世界模型等VLA任务~
VLA+RL方向首个系统教程来啦!Online RL/Offline RL/test time RL等~
VLA/VLA+触觉/VLA+RL/具身世界模型等!具身大脑+小脑算法与实战全栈路线来啦~
1v1 科研论文辅导来啦!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献162条内容

所有评论(0)