大促值守机器人应急止血实操:只读从库复制延迟突发上升时的自适应切流
·
大促值守机器人应急止血实操:只读从库复制延迟突发上升时的自适应切流
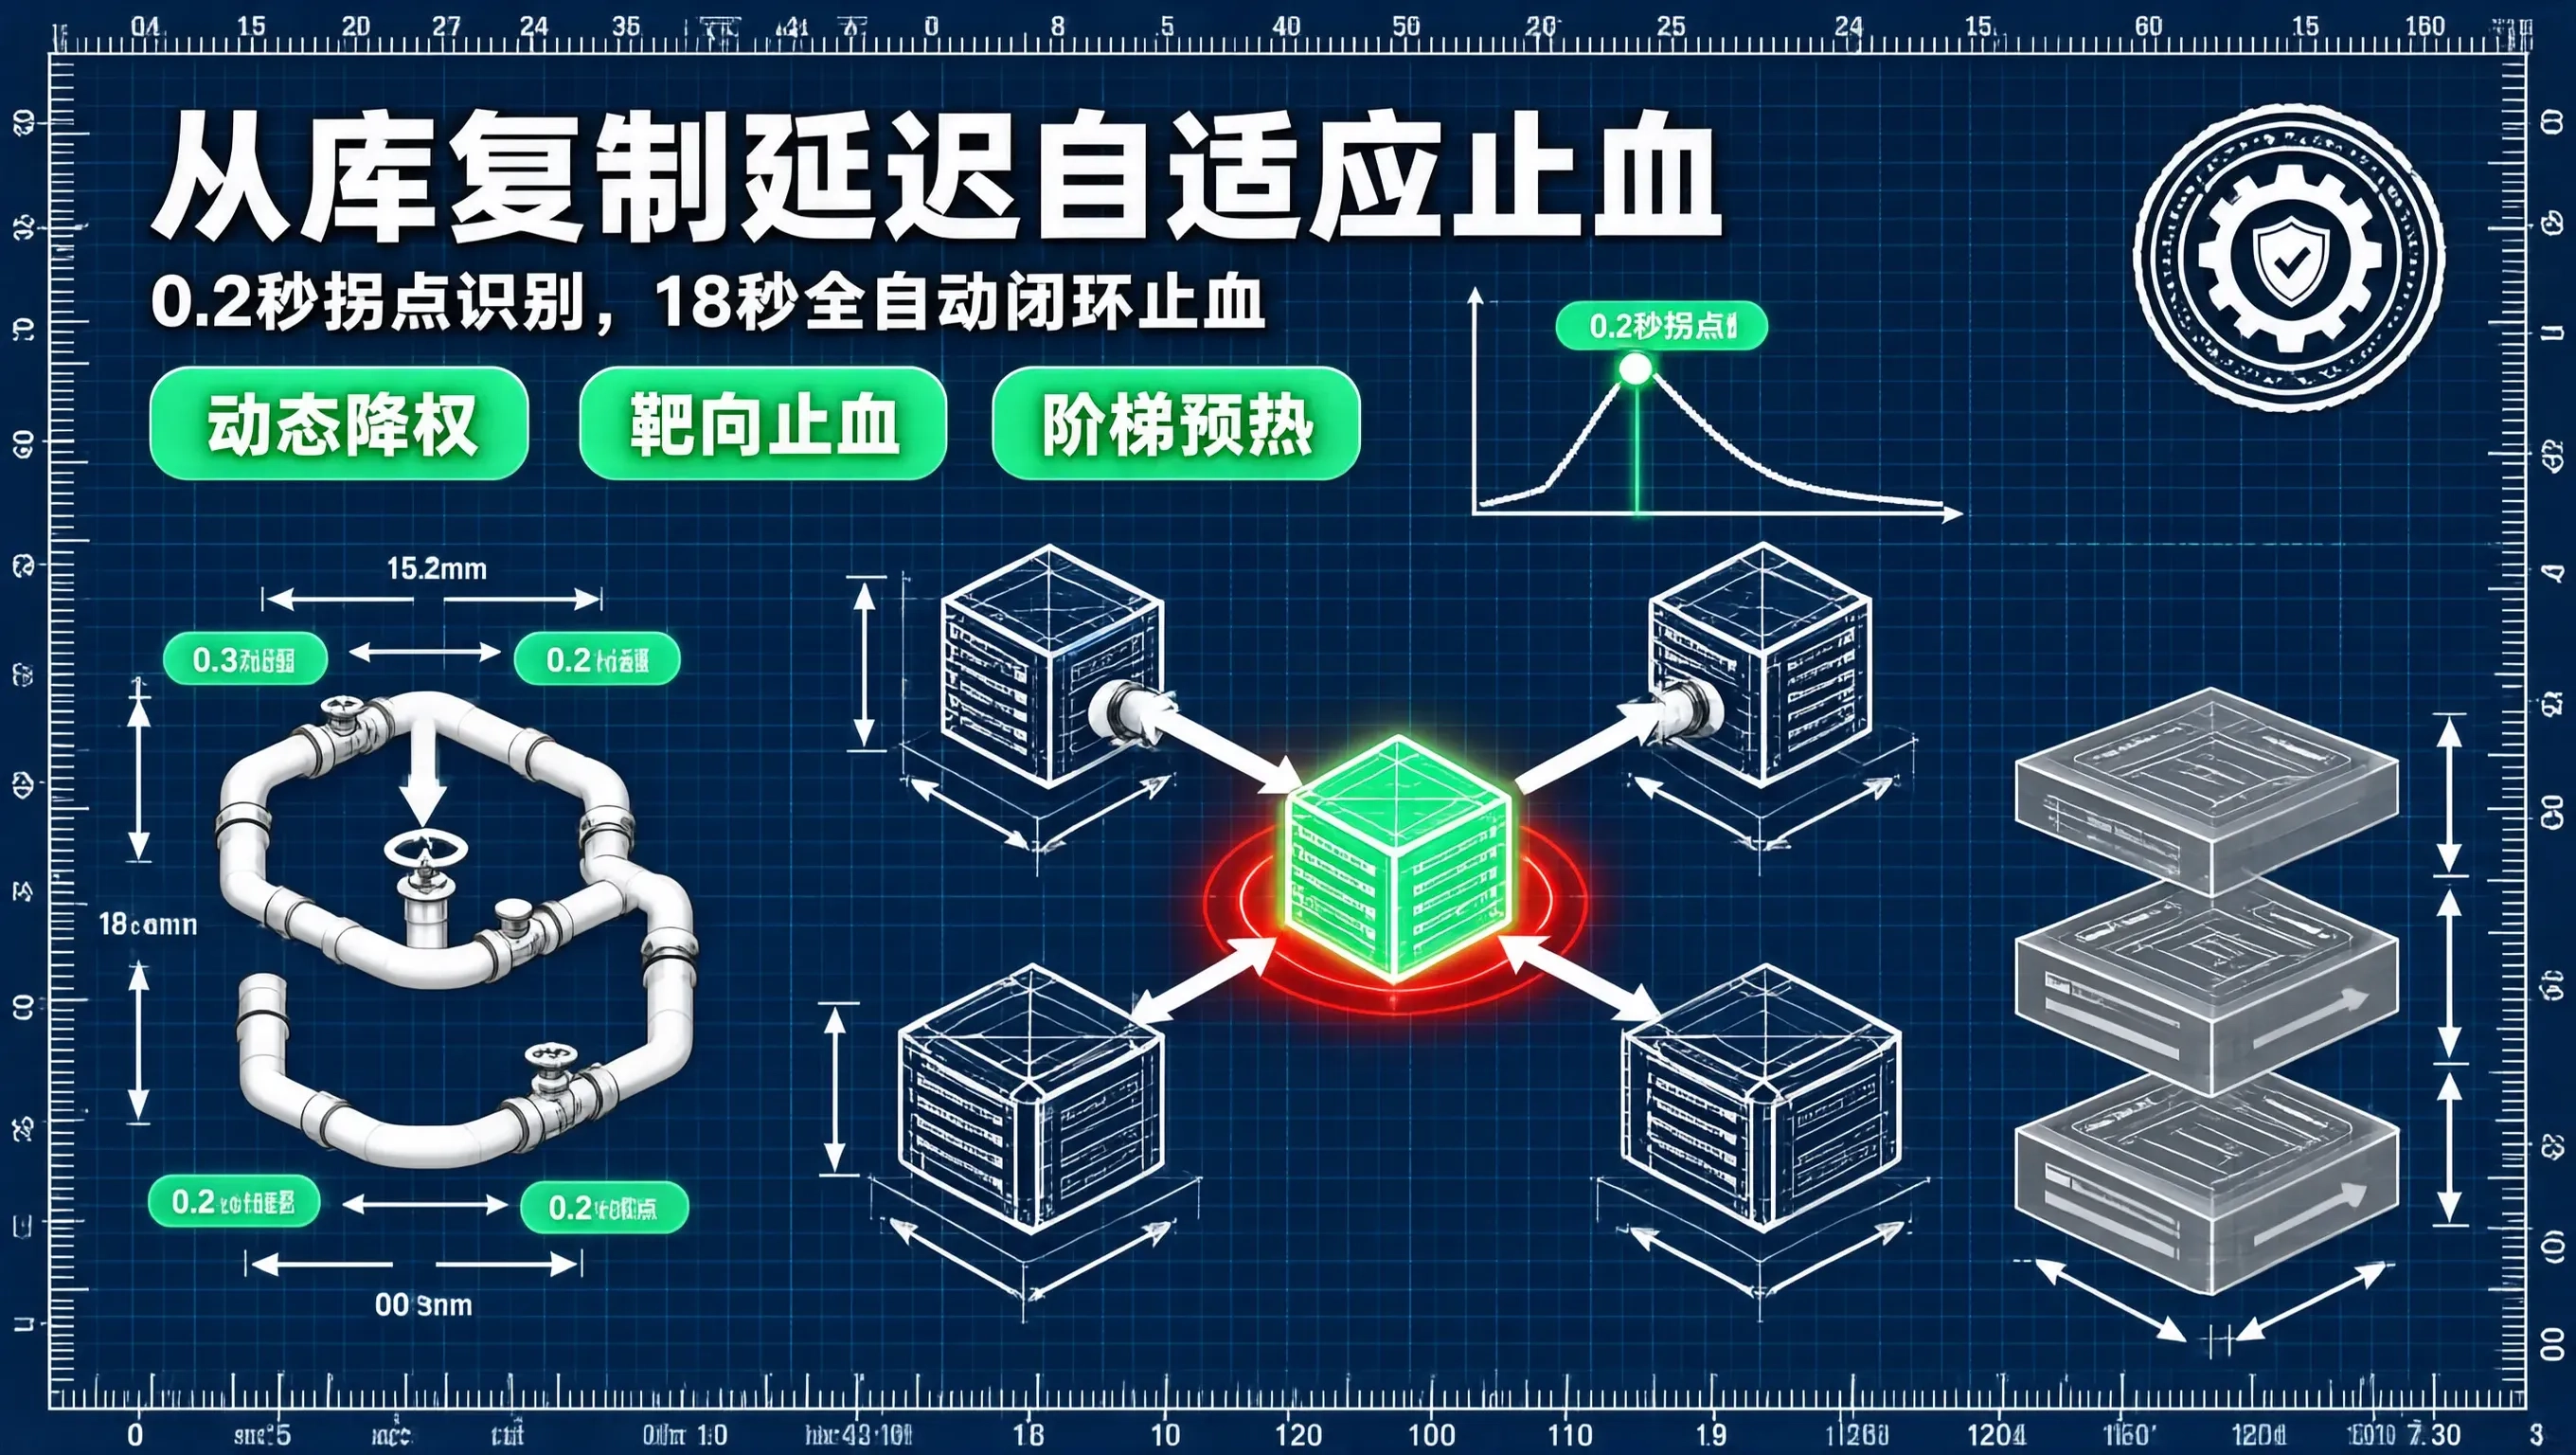
在大促核心交易链路中,为了保护主库(Master)的绝对写入安全,全网超过 80% 的高频只读查询(如订单列表、商品详情、物流轨迹) 都被路由到了只读从库(Read Replicas)集群上。
然而,在持续高并发的长跑保驾期中,只读从库往往是系统中最脆弱的薄弱环节之一:
- 某位业务人员偶然触发了一条未完全覆盖索引的慢查询;
- 该查询霸占了从库的 CPU 与内存 Buffer Pool;
- 导致从库上的 Binlog 回放 SQL 线程发生严重阻塞排队,
Seconds_Behind_Master在 30 秒内从 0ms 狂飙至 120 秒!
如果网关依然盲目向这个已经产生严重复制延迟的从库分发只读请求:
- 买家在刚支付成功后刷新页面,会发现“订单依然显示为待支付”;
- 恐慌的买家会疯狂重复点击支付或发起客诉,瞬间在全网引发毁灭性的信任危机与客诉风暴!
如何利用 智能值守机器人与微秒级数据库代理网关,构建一套“0.2 秒延迟拐点识别、权重动态降零(Drain)、慢查询精准止血与延迟归零自适应重上线”的自动化闭环?
[只读从库突发复制延迟 4 阶自动止血与自愈状态机]

  14:20:15  某只读从库 (Slave-03) 突发复制延迟飙升至 45 秒!
                     │
                     ▼ (值守 AI 助手 0.2 秒捕获延迟拐点)
  ┌─────────────────────────────────────────────────────────────┐
  │ 阶段一: 数据库接入网关权重秒级动态降零 (Traffic Drain)      │
  │   - 网关在 50ms 内将 Slave-03 流量权重调整为 0              │
  │   - 在途读请求在 1ms 内平滑切流至同机房健康从库 (业务 0 报错!) │
  └──────────────────────────────┬──────────────────────────────┘
                                 │
                                 ▼
  ┌─────────────────────────────────────────────────────────────┐
  │ 阶段二: 异常从库慢查询精准定位与主动止血 (Targeted Kill)    │
  │   - 探针扫描 Performance Schema: 抓出阻塞 SQL 线程的罪魁祸首│
  │   - 自动下发: KILL QUERY 184920 (仅杀慢查询, 保留连接池)    │
  └──────────────────────────────┬──────────────────────────────┘
                                 │ Binlog 回放线程恢复满速追平
                                 ▼
  ┌─────────────────────────────────────────────────────────────┐
  │ 阶段三: 复制延迟归零判定与自适应预热加权 (Safe Re-Weight)   │
  │   - 延迟持续 30 秒稳定在 0ms ──▶ 流量权重按 10% -> 100% 恢复│
  └─────────────────────────────────────────────────────────────┘
核心微架构一:数据库代理网关的动态自适应健康评分
数据库接入代理网关(Database Proxy)内置了基于毫秒级心跳探针的动态权重衰减算法:
class ReadReplicaTrafficGovernor:
    """只读从库自适应流量权重调度中枢"""
    MAX_TOLERABLE_LAG_SEC = 1.0 # 业务允许的最大复制延迟阈值

    def compute_replica_traffic_weight(self, replica_metrics: dict) -> float:
        replication_lag = replica_metrics["seconds_behind_master"]
        base_weight = replica_metrics["configured_base_weight"] # 例如 100

        # 1. 第一道硬防线: 复制延迟超过 1 秒,权重直接非线性暴跌归零!
        if replication_lag > self.MAX_TOLERABLE_LAG_SEC:
            return 0.0 # 彻底摘除流量,杜绝任何脏读流入业务!

        # 2. 毫秒级轻微抖动 (0.1s ~ 1.0s): 平滑衰减权重
        if replication_lag > 0.1:
            decay_factor = 1.0 - (replication_lag / self.MAX_TOLERABLE_LAG_SEC)
            return max(0.0, base_weight * decay_factor)

        return base_weight # 复制延迟严格为 0ms,全额承接流量
- 0.2 秒全自动剔除:一旦从库延迟突破 1.0 秒,代理网关在 50 毫秒 内将发往该节点的读流量降为 0;
- 业务端 0 感知:在途请求被透明分发至同机房内其他 5 台健康的只读实例,前台用户完全感知不到任何数据陈旧或报错。
核心微架构二:异常慢查询的精准定位与靶向清除
在将流量平滑疏散后,值守机器人立即登录 Slave-03 实例排查阻塞源头:
-- 机器人自动执行的靶向慢查询探针 SQL
SELECT
    id,
    user,
    host,
    time,
    state,
    info
FROM information_schema.processlist
WHERE command != 'Binlog Dump'
  AND user != 'system user'
  AND time > 5
ORDER BY time DESC
LIMIT 1;
- 精准靶向清除:机器人识别出一条执行耗时已达 28 秒的复杂 Ad-hoc 查询,自动向该会话发送
KILL QUERY 184920; - 回放线程极速追平:慢查询被中断释放了 CPU 与表锁后,InnoDB 的 Binlog 回放 SQL 线程以每秒 5,000 事务的极速在 12 秒内将
Seconds_Behind_Master重新追平至 0!
阶段三:阶梯预热与安全重上线(Gradual Re-weighting)
为了防止刚刚追平延迟的从库在瞬间被 100% 流量打崩,系统执行三阶平滑加权上线:
- 观察 30 秒,确认复制延迟持续维持在
0ms; - 初始赋予 10% 流量 进行 Buffer Pool 缓存预热;
- 2 分钟后若指标平稳,恢复 100% 全额权重,完成一次完美的闭环自愈!
生产实战收益
在大促长跑期间的一次实战处置中:
- 依靠这套自适应切流与靶向止血系统;
- 整个故障发现、网关切流、慢查询清除、到重新加权上线,全流程在 18 秒内全自动闭环完成;
- 期间全网业务未发生一笔“买家查不到最新订单”的客诉,展现了现代自动化智能值守体系的极速响应力。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)