2026 具身智能技术实战(二):SmolVLA 输出的 50 步动作怎么执行?——动作分块、缓存与闭环控制
上一篇,我们用 LeRobot 跑通了 SmolVLA 推理,拿到了形状为 [1, 50, 6] 的动作片段。
但模型能输出 50 步动作,还没有回答一个更实际的问题:程序应该怎样使用它们?
每次控制循环都重新推理,还是一次算完、逐步取出?如果第二次调用时相机画面已经变了,机器人会不会立即换一个动作?想更快响应环境,是不是把动作片段改短就行?
这一次,我们没有停留在源码解释,而是在本地加载同一份预训练权重,逐次记录模型调用、缓存长度和返回动作,并与参考片段逐项比较。
先给结论:在本文固定版本的普通同步路径中,调用 select_action() 并不意味着每次都重新推理。队列中还有动作时,它会继续取出已有动作。
实测环境:WSL2 / Ubuntu 26.04、Python 3.12、RTX 4080 Laptop GPU、LeRobot 0.4.4、PyTorch 2.10.0、Transformers 4.57.6。
测试范围:合成图像与模型空间状态、固定采样噪声、RTC 关闭。64 次
select_action()调用全部通过参考值检查,包含参考片段在内共进行了 9 次真实模型推理。本文没有连接真机或物理仿真。“取出动作”不等于“设备执行动作”;闭环部分解释控制程序应如何组织,不宣称完成了闭环抓取验证。
一、先分清三个数字:生成多少、取出多少、多久执行一次
上一篇的输出 [1, 50, 6] 分别表示批量大小、动作片段长度和每步动作维度。
在本文模型配置中,有两个名字相近的参数:
| 参数 | 本文含义 | 初始值 |
|---|---|---|
chunk_size | 一次生成的动作片段长度 | 50 |
n_action_steps | 普通 select_action() 路径每次补充队列时取用的前若干步 | 50 |
此外还有控制循环频率,它不是这两个参数自动决定的。
举一个纯粹用于理解的假设:控制循环以 10 Hz 取出并发送动作,50 步对应约 5 秒的指令数量。但本次实验没有按 10 Hz 调度,更没有模拟设备运动,因此不能把实验的调用编号换算成真实机器人时间。
还要记住,模型推理本身需要耗时。同步调用在队列为空时执行推理,会影响循环周期;仅在代码中写一个目标频率,不代表系统已经实时运行。
二、两个 API 不是同一种“预测”
predict_action_chunk():返回整个动作片段
本次直接调用得到 [1, 50, 6],便于观察完整输出,也用于构造参考值。
select_action():返回一个动作,必要时才补充队列
同一份模型调用 select_action(),每次返回 [1, 6]。它内部维护一个动作队列。
把本次安装版本的逻辑压缩成便于阅读的伪代码,就是:
if action_queue_is_empty:
    chunk = run_model(current_observation)
    action_queue.extend(chunk[:n_action_steps])

return action_queue.popleft()
因此,第一次调用可能要运行模型,第二次却只是取出已经算好的下一个动作。
这不是模型“忽略了传感器”,而是调用路径选择了动作缓存。传入新观测与使用新观测重新计算,是两件不同的事。
源码位置:LeRobot v0.4.4 的 SmolVLA 实现。本文同时读取了本地实际安装的源码,并将其 SHA-256 写入结果文件;不要把某一固定版本的结论无条件套到未来版本或 RTC 路径。
三、怎样证明它真的用了缓存?
只看“第二次调用很快”,证据不够。速度受 GPU 预热、缓存和系统负载影响,不能凭耗时判断有没有推理。
我们采用两层验证:
- 在实际
_get_action_chunk()入口增加计数包装,原样转发输入、原样返回结果,不替换模型计算。 - 固定采样噪声,先分别为输入 A、B 生成参考片段;之后逐一检查
select_action()返回值是否对应参考片段中的准确位置。
如果当前返回动作与 A 的第 2 步相同,又没有发生新的模型推理,就能确认它来自此前的 A 片段,而不是因为输入 B 恰好生成了相似的动作。
输入 A 与 B 怎样构造?
- A:三路桌面色块图、六维零状态,以及“把红色方块放到蓝色托盘”的指令。
- B:移动图中红色方块、把状态改为模型空间中的 0.25,并换成“把红色方块留在桌面”的指令。
这里同时改变了图像、状态和语言,目的是给缓存提供明显不同的新输入,不是分析三个模态各自的贡献。
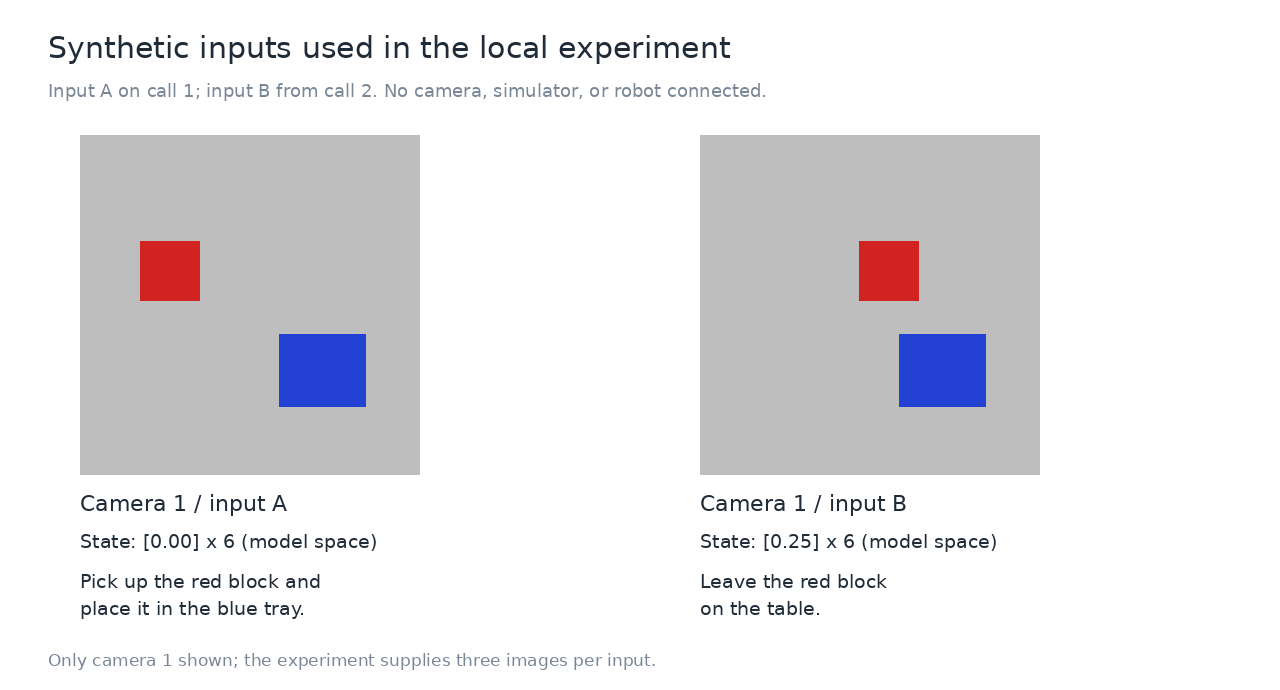
图 1:从实验生成的输入图片制作,展示每组的第一路图像。不是相机照片,也不是仿真场景截图。实际推理每组输入三路图片。
四、实验一:传入新图片,动作却仍然来自旧片段
保持原始设置:
policy.config.n_action_steps = 50
policy.reset()
第 1 次调用传入 A;从第 2 次开始,全部传入 B,共调用 51 次。
实测结果:只有第 1 次与第 51 次调用触发模型推理。
第 2~50 次返回的动作,全部与 A 参考片段的对应位置一致。第 51 次才根据 B 重新生成片段,并返回 B 片段的第一步。
可以按下面的过程理解:
调用 1:输入 A → 模型生成 A 的 50 步 → 返回第 1 步,剩余 49 步
调用 2:输入 B → 不重新推理 → 返回 A 的第 2 步
……
调用 50:输入 B → 不重新推理 → 返回 A 的第 50 步,队列清空
调用 51:输入 B → 模型生成 B 的 50 步 → 返回 B 的第 1 步
给函数传入了新观测,并不等于这个返回动作已经使用了新观测。
如果你在机器人程序里发现相机在更新,动作却暂时沿用旧计划,除了模型能力和通信延迟,也应该检查这个队列机制。
但这不是故障判定的唯一依据:真实系统还可能有控制器缓冲、通信队列和执行器延迟,不能把所有反应慢都归因于 LeRobot。
五、实验二:只取前 5 步,会发生什么?
这次不改模型的 chunk_size=50,只将取用长度改成 5:
policy.config.n_action_steps = 5
policy.reset()
修改以后调用 reset(),是为了按新的设置重新建立队列。不要只修改配置,却继续使用旧队列的状态。
第 1 次输入 A,后续输入 B,共调用 11 次。
实测:第 1、6、11 次触发模型推理。
每次模型仍生成 [1, 50, 6],但这条同步队列路径只取其中前 5 步。队列耗尽后,再用当次输入重算。
这意味着:
- 模型生成长度没有变成 5。
- 相比缓存 50 步,重新使用观测的调用间隔缩短。
- 每轮生成但未入队的后续动作不会被该队列继续消费。
- 不能据此承诺性能提升;更频繁地运行模型可能增加计算负担。
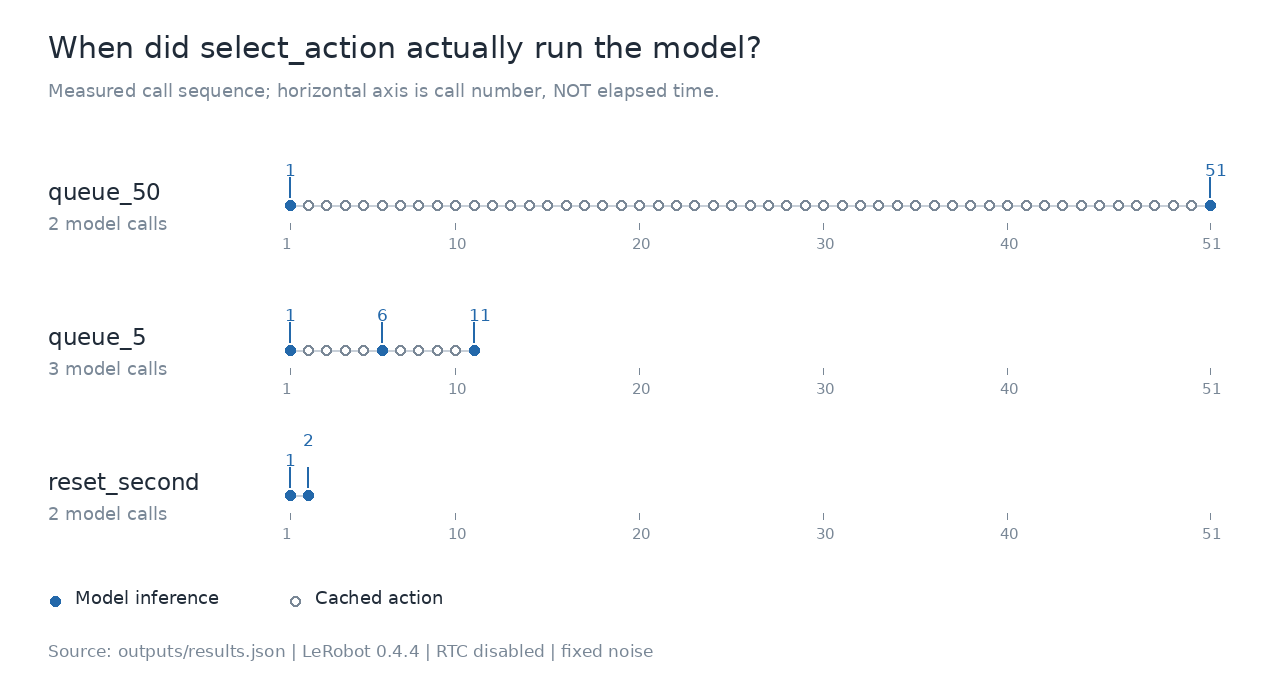
图 2:由实际逐次调用记录生成。蓝色实心点表示发生模型推理,灰色空心点表示取缓存动作。横轴是调用编号,不是时间。不同场景使用同一横轴尺度;较短的行表示该场景仅运行了较少调用,不代表缺失测量。
这里没有“5 一定比 50 更好”的结论。如何选择取用长度,需要结合观测变化、推理延迟、动作连续性和执行系统评估。
六、实验三:reset 能让新输入立即生效吗?
最后一个实验只有两次调用:
policy.config.n_action_steps = 50
policy.reset()
first = policy.select_action(batch_a, noise=fixed_noise)

policy.reset()
second = policy.select_action(batch_b, noise=fixed_noise)
实测两次调用都触发了模型推理。 第二次动作与 B 参考片段第一步一致。
这里的 reset 清空了策略内部队列,使下一次调用需要重新计算。
但必须给这个结论加上一条重要边界:
清空模型缓存,不等于停止机器人。
已经发送给控制器的指令可能仍在执行;应用程序也可能有另外一层动作队列。任务切换、取消和急停需要各自的处理流程,不能用一次 policy.reset() 代替。
另外,在每一个控制步都 reset,会使本例每次都重新推理,失去缓存带来的好处。它是一个状态管理操作,不是无条件加速或提高安全性的开关。
七、64 次动作取出,检查结果是什么?
本次检查覆盖全部 64 次返回动作,每次比较完整的 6 维向量,而不是只抽查第一个数字。
| 场景 | select_action 调用数 | 模型推理次数 | 推理发生的调用编号 | 与对应参考动作的最大绝对差 |
|---|---|---|---|---|
| 缓存 50 步 | 51 | 2 | 1、51 | 0 |
| 缓存 5 步 | 11 | 3 | 1、6、11 | 0 |
| 第二次调用前 reset | 2 | 2 | 1、2 | 0 |
场景中的推理合计 7 次,加上 A、B 两次参考计算,总计 9 次真实模型推理,没有训练或微调。
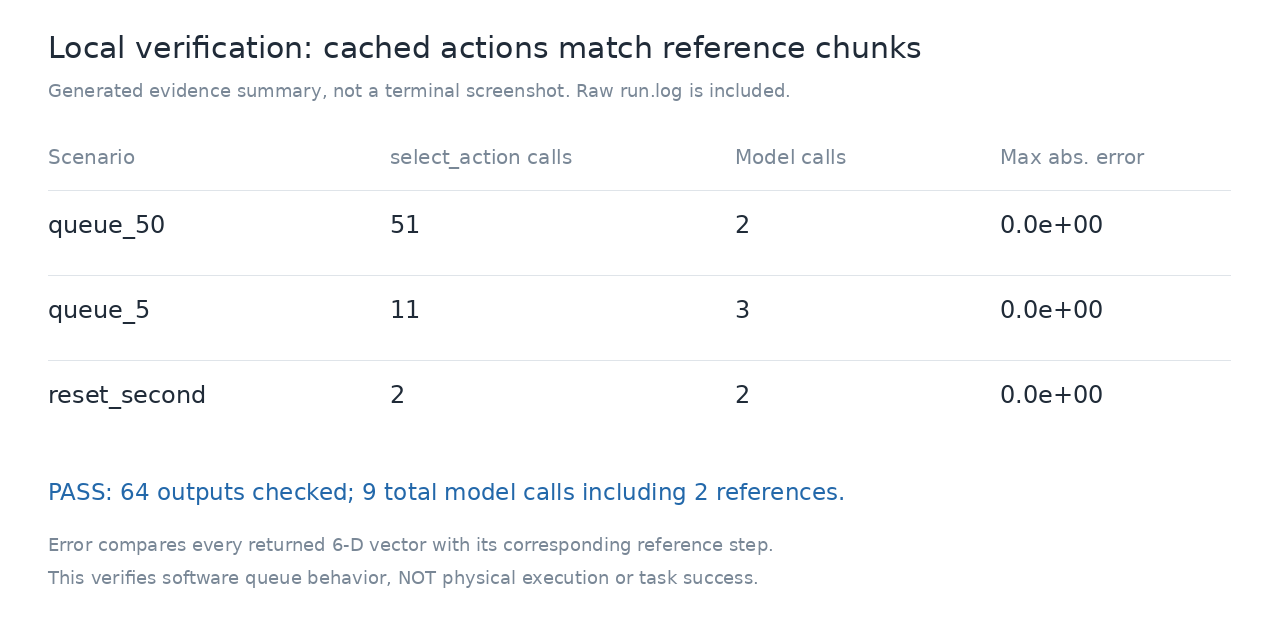
图 3:从本地 results.json 生成的结果汇总图,不是终端截图。原始 run.log、逐次调用 calls.csv 和 JSON 一同提供,方便复核。
本次日志中的关键内容为:
queue_50:      inference_at=[1, 51],    max_abs_error=0.0, passed=true
queue_5:       inference_at=[1, 6, 11], max_abs_error=0.0, passed=true
reset_second: inference_at=[1, 2],     max_abs_error=0.0, passed=true
PASS: all 64 select_action calls checked against reference chunks; 9 total model inferences.
前三行按实际结果整理了展示格式,完整原始输出在 run.log 中。
固定噪声是为了排除采样随机性对比较的干扰。最大差为 0 是本次环境的实际观察,不保证所有硬件和软件组合都逐位一致。脚本的断言容差是 1e-5。
八、怎样在本地复现?
8.1 复用上一篇环境
如果已经跑过第一篇,可以继续使用原虚拟环境与模型缓存,不需要重新下载策略权重。
新环境可以安装:
uv venv --python 3.12 .venv
uv pip install --python .venv/bin/python "lerobot[smolvla]==0.4.4"
本次实测使用 PyTorch 2.10.0、Transformers 4.57.6。建议保持相同版本以减少差异。当前实验脚本显式要求 CUDA,并未验证 CPU 运行。
8.2 运行配套脚本
将附件中的完整 run_experiment.py 放入工作目录:
.venv/bin/python run_experiment.py --output outputs
已有缓存时可以禁止联网:
export HF_HUB_OFFLINE=1
.venv/bin/python run_experiment.py --offline --output outputs
如果第一篇曾使用自定义 HF_HOME,需要继续指向同一目录。作者本机执行时使用:
export HF_HOME=/home/ziling/.cache/csdn-smolvla-20260921/huggingface
这是作者路径,不要求其他读者照搬。首次运行且缓存不存在时,不要启用 offline。
模型与底座配置在脚本中已固定到精确 revision:
smolvla_base:
d9f33c94a60fb382c90dea2164c96845bd955e28

SmolVLM2-500M-Video-Instruct:
7b375e1b73b11138ff12fe22c8f2822d8fe03467
脚本使用 strict=True 加载完整策略权重。为了避免重复下载另一份 VLM 权重,初始化时设置 load_vlm_weights=False,随后由完整策略 checkpoint 填充权重;不是用随机权重做演示。
8.3 输出与绘图
outputs/
├── results.json       # 每次调用、推理事件、版本与断言结果
├── calls.csv          # 64 次调用的动作和队列记录
├── A_camera1.png ...  # 实际使用的三路 A 输入
└── B_camera1.png ...  # 实际使用的三路 B 输入
作者运行脚本另存了 run.log。配套 render_figures.py 直接读取 results.json 和输入图片生成文章三幅配图,不依赖手工填数。
绘图脚本使用 Linux DejaVuSans 字体;其他系统可以调整字体路径。完整代码和绘图脚本在同一附件中,正文下面解释其中最重要的验证部分。
九、核心验证代码:不是模拟一个队列来证明队列
如果自己写一个假队列,再展示它每 50 次“推理”一次,只能说明假队列按自己设定的规则工作,不能证明 LeRobot 的行为。
本实验包装的是模型真实执行入口:
original = policy._get_action_chunk

def counted(batch, noise=None, **kwargs):
    chunk = original(batch, noise=noise, **kwargs)
    events.append({**context, "chunk_shape": list(chunk.shape)})
    return chunk

policy._get_action_chunk = counted
它不修改输入,不合成动作,也不绕过原始计算。下划线接口是用于固定版本研究的内部入口,不建议把这种包装直接放进生产控制程序。
逐次验证则比较返回动作和参考动作:
action = policy.select_action(current_batch, noise=fixed_noise.clone())
error = (action - reference_chunk[:, reference_step]).abs().max()
assert torch.isfinite(action).all()
assert error <= 1e-5
这两段是完整脚本的关键逻辑节选;上面的变量由附件脚本负责构造,不能把节选当作可单独运行的程序。
原始结果也保存了每次调用耗时,但本文没有用这组测试做吞吐量排名。循环没有真实控制频率,固定噪声、合成输入和单次测量,都不足以推导生产系统性能。
十、动作缓存与闭环控制到底是什么关系?
闭环的关键是让新的观测影响后续决策。它不一定要求每个底层控制周期都运行一次 VLA,也不等于机械地减少缓存长度。
一种典型的应用层安排是:
- 读取当前相机和机器人状态;
- 生成一个动作片段;
- 只取用其中一部分;
- 再根据更新后的观测生成后续片段。
本文 n_action_steps=5 实验展示了“取用部分片段后重新计算”的软件机制。但我们输入的 B 是预先构造的,不是机器人执行 A 以后产生的反馈,所以它还不是物理闭环实验。
进一步做真机或仿真时,至少需要补上:
- 与训练一致的相机、状态、归一化和动作语义;
- 动作后处理及执行器接口;
- 实际观测反馈和控制周期管理;
- 推理延迟期间的执行策略;
- 任务切换、旧动作废弃与独立停止机制;
- 任务成功率与安全边界测试。
这一版普通 select_action 路径不支持开启 RTC;不能把本文结论直接当作异步推理或实时动作分块方案的完整说明。
总结:看见新观测,不代表当前动作已经由它决定
这次实验回答了三个具体问题:
默认缓存没有耗尽时,会继续返回旧片段;缩短 n_action_steps 会改变补充队列的时机;reset 会清空策略缓存,使下一次调用重新计算。
我们用真实模型验证了这些行为,但没有把它包装成“机器人已经能闭环抓取”。
理解这层机制以后,再遇到“相机更新了,为什么动作没马上变”,就多了一个可以检查的具体位置:不是只盯着模型输出,还要看动作队列什么时候被消费、什么时候被替换。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 5
 0
- 0


 已为社区贡献15条内容

所有评论(0)