从“看见”到“办完”:拆解领本AI EmoGPT自主交互世界模型的技术链路
大语言模型进入机器人之后,最容易实现的是“听懂一句话并给出回答”。但在家庭环境中,真正有价值的交互往往没有明确指令:老人忘记眼镜放在哪里,饮水机的水即将用完,孩子近期的作息发生变化……
机器人需要理解连续发生的生活,而不只是处理当前一轮对话。
领本AI自研EmoGPT自主交互世界模型,面向“一老一小”等家庭场景,构建从多模态感知、长期记忆、状态建模到主动决策、交互和行动的能力链。其目标是让机器人从被动响应指令,进一步具备持续理解环境、识别潜在需求并协同完成任务的能力。
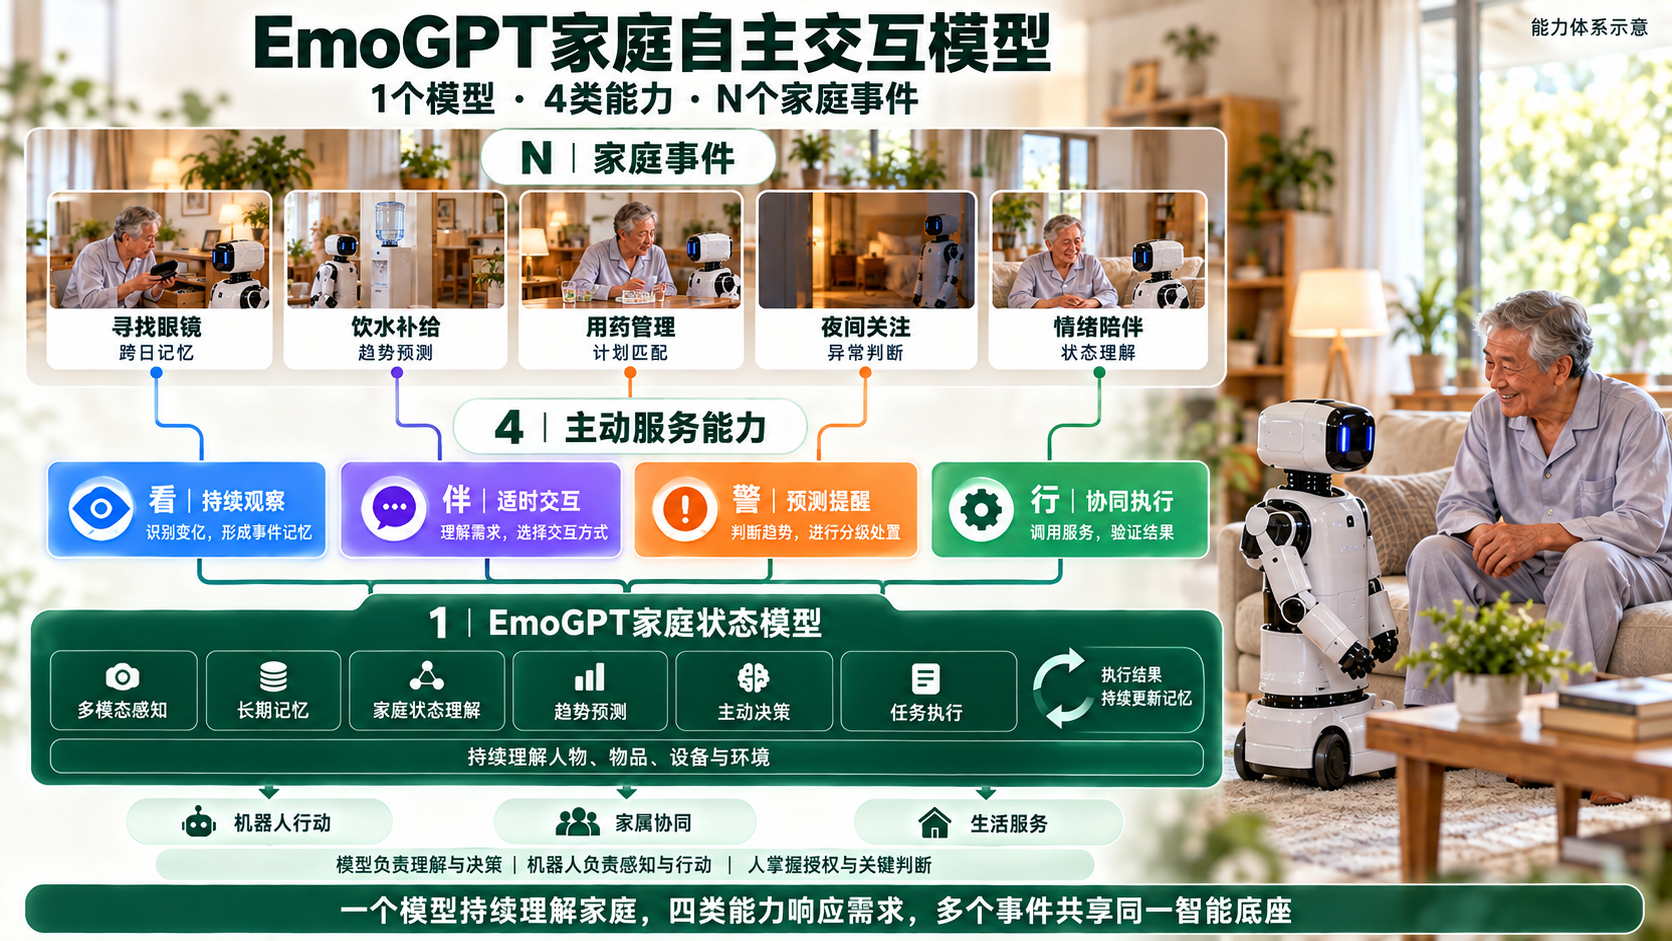
1. 自主交互为什么需要“世界模型”
传统智能助手的典型链路是:
用户提问 → 模型生成回答
家庭机器人面对的链路更长:
连续观察 → 事件记录 → 状态更新 → 需求判断 → 交互确认 → 调用执行 → 结果验证
这里的“世界模型”并不只是生成未来视频或模拟物理环境。对于家庭自主交互,它还需要形成一个可持续更新的家庭状态表示:谁在家、物品在哪里、设备处于什么状态、近期发生过哪些事件、个人习惯是否发生变化,以及哪些事项仍待处理。
可以将EmoGPT的运行链路抽象为:
Oₜ → Eₜ → Mₜ/Sₜ → Dₜ → Aₜ → Fₜ → Sₜ₊₁
其中:
-
Oₜ(Observation):视频、语音、文本、传感器及设备状态;
-
Eₜ(Event):从连续数据中抽取出的结构化事件;
-
Mₜ(Memory):与人物、物品、时间和场景关联的长期记忆;
-
Sₜ(State):当前家庭状态及变化趋势;
-
Dₜ(Decision):是否介入、何时介入、向谁确认;
-
Aₜ(Action):对话、提醒、机器人操作或服务调用;
-
Fₜ(Feedback):用户反馈和任务执行结果;
-
Sₜ₊₁:根据反馈更新后的家庭状态。
这条链路对应到用户可感知的服务,就是日常观察、情感陪伴、事件预警和行动协同。四类能力并非固定流水线,而是由模型根据事件动态组合。
2. EmoGPT能力链的七个关键环节
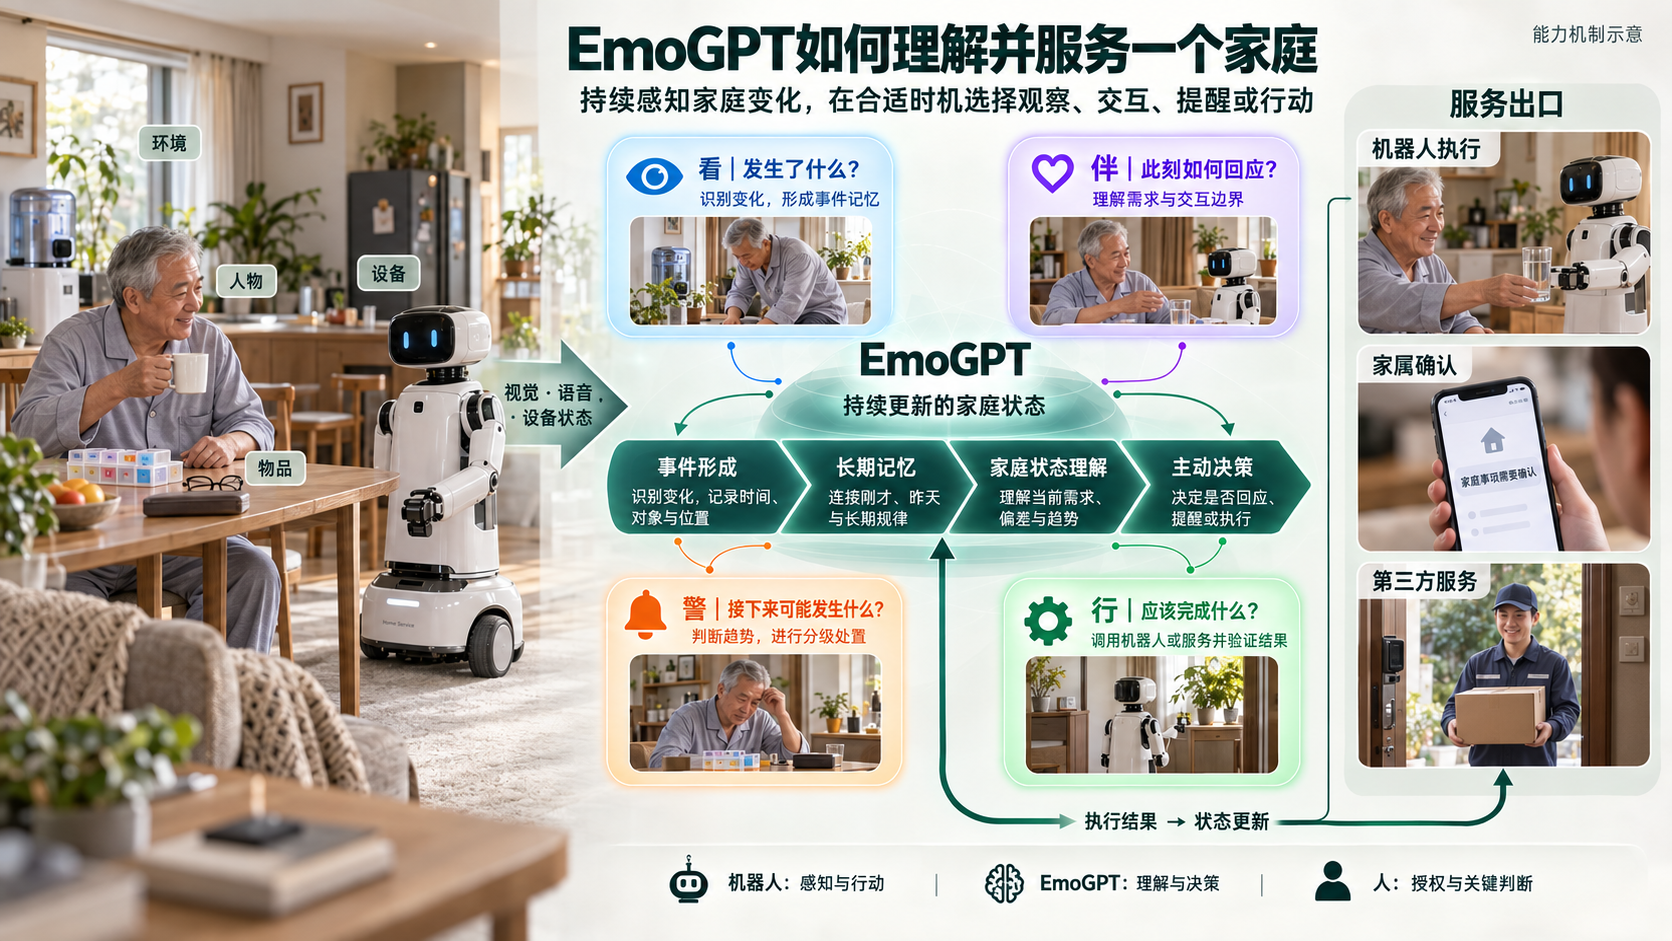
多模态感知:把画面转化为有效事件
摄像头能够拍到房间,不等于模型理解了房间里发生的事。
“桌面上出现一副眼镜”和“老人整理桌面时把眼镜放进抽屉”,是两个不同层级的信息。后者包含人物、动作、物体、目标位置和发生时间,可以作为后续检索与推理的事件依据。
事件化长期记忆:保留有用信息
家庭交互需要跨分钟、跨天甚至更长周期调用信息。直接保存和检索全部原始视频,不仅效率低,也会带来更大的隐私与存储压力。
长期记忆应将关键观察组织为带有时间、对象、位置、来源和置信度的事件。当第二天出现“眼镜盒为空”和“老人询问眼镜位置”时,模型检索的是眼镜最近一次可信观测,而不是只依赖当前画面猜测。
家庭状态建模:理解事件之间的关系
单个事件说明“发生了什么”,状态模型则需要回答“现在可能是什么情况”。
家庭状态至少涉及四类对象:
-
人物状态:活动、作息、需求和交互偏好;
-
物品状态:位置、使用轨迹和最后观测时间;
-
设备状态:水位、运行状态和耗材余量;
-
服务状态:任务是否确认、执行和完成。
主动决策:判断是否需要介入
主动交互不等于频繁打扰。模型需要判断事件的重要程度、信息置信度、用户当前状态、家庭授权范围和介入成本。
一次完整判断可能包括:
-
当前信息是否足够可靠;
-
问题是否会自行消失;
-
现在是否是合适的交互时机;
-
应该提示老人、通知子女还是保持观察;
-
执行动作前是否需要再次确认。
自主交互的重要要求是:该出现时出现,不该介入时保持安静。
自然交互:把判断转化为恰当沟通
对老人,交互应简洁、明确并避免制造焦虑;对孩子,需要区分陪伴、提醒与管控边界;对子女或照护人员,则应提供事实依据、风险等级和可选操作。
自然交互承担的任务不仅是回答问题,还包括澄清意图、请求授权、解释判断依据和获取执行反馈。
机器人与服务调用:从语言生成走向任务完成
EmoGPT可以将已经确认的需求转化为机器人或数字服务可以执行的任务。执行出口可包括机器人导航、视觉复核、物品抓取、家属消息、生活服务平台及人工照护服务。
模型负责理解场景和组织任务,机器人本体负责移动与操作,外部服务完成配送等现实环节。
结果回写:让行动成为下一次判断的依据
发出指令并不代表任务已经完成。
机器人取回眼镜后,需要确认老人是否接收;订水后,需要确认是否送达、是否换桶以及水位是否恢复。
执行结果重新写入家庭状态,形成“观察—判断—行动—验证—更新”的闭环。
3. EmoGPT与LLM、VLM和VLA的关系
LLM擅长语言理解、知识推理和表达;VLM把视觉内容与语言语义联系起来;VLA进一步将视觉和语言输入映射为机器人动作。
自主交互世界模型不是对这些模型的简单替代。它更关注连续时间中的状态与任务管理:如何保存长期事件、识别状态变化、决定是否介入、选择执行出口,并根据结果修正后续判断。
在实际系统中,可以由视觉模型负责场景识别,语言模型负责语义推理和交互,VLA或机器人控制模块负责具体动作。EmoGPT关注的是如何将这些能力组织成面向真实家庭的连续服务闭环。
4. 三个“一老一小”场景
找眼镜:跨日记忆驱动机器人行动
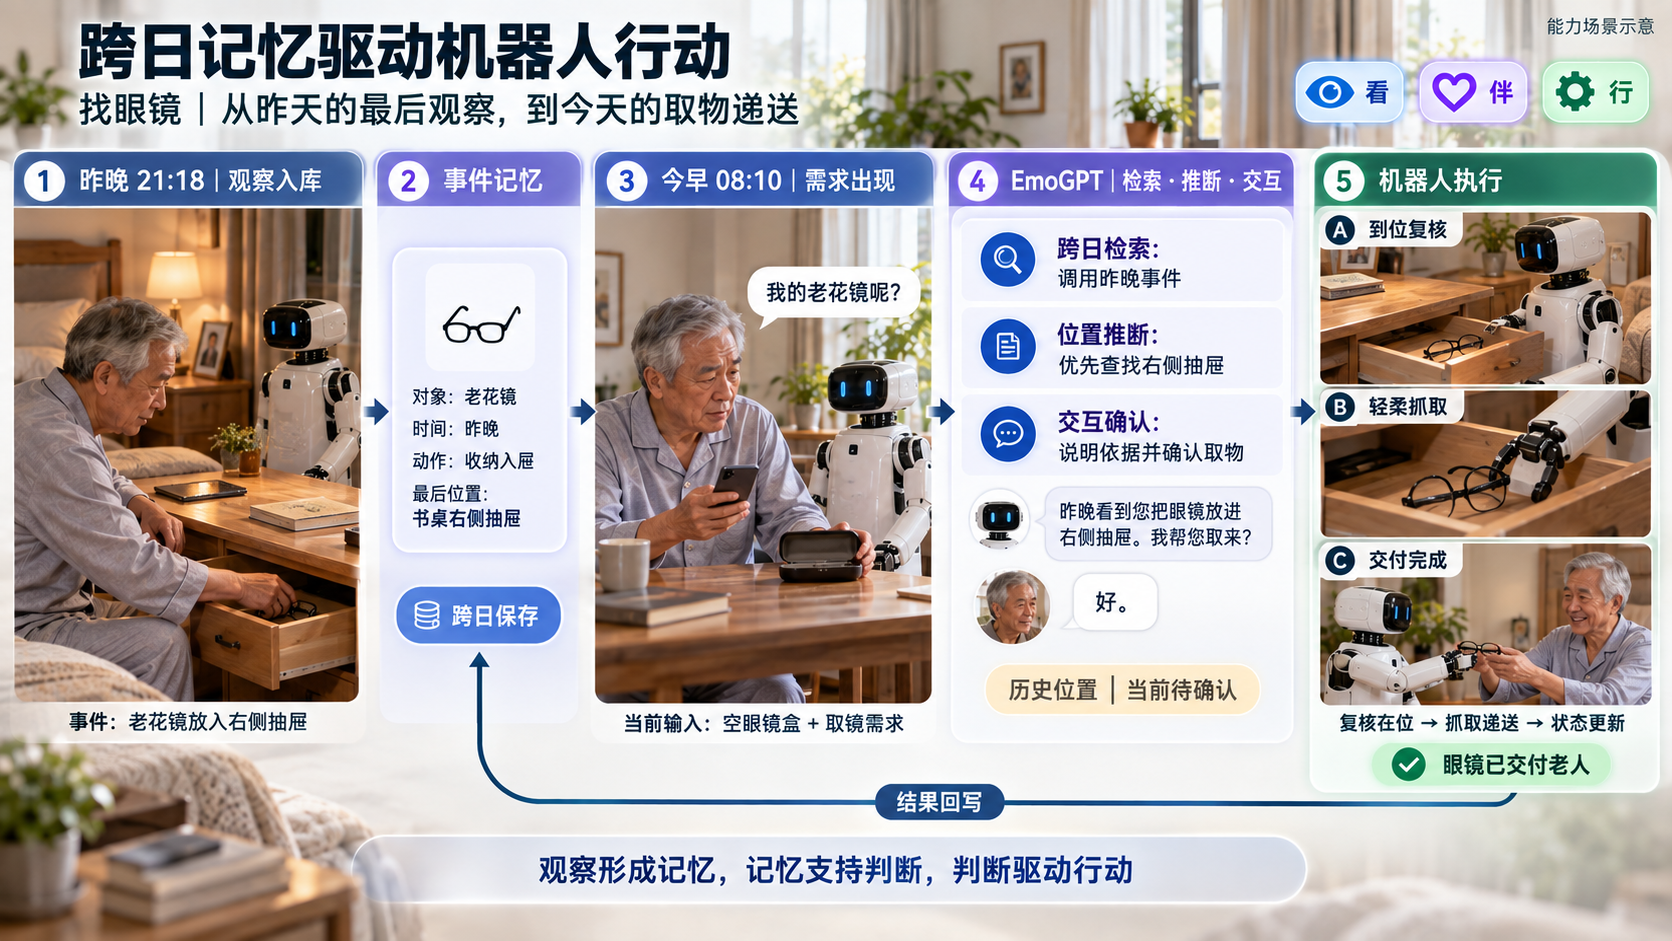
前一晚,老人整理桌面时将眼镜放入抽屉。第二天,老人准备看手机,发现眼镜盒为空。
EmoGPT结合当前需求,检索眼镜最后一次可信观测,判断其可能仍在抽屉,并向老人说明依据。获得确认后,机器人前往目标区域,打开抽屉进行视觉复核,取出眼镜并递交给老人,随后更新物品状态。
该场景验证的是跨日记忆一致性、位置推断、交互确认和机器人任务闭环。
饮水补给:在需求出现前完成服务准备
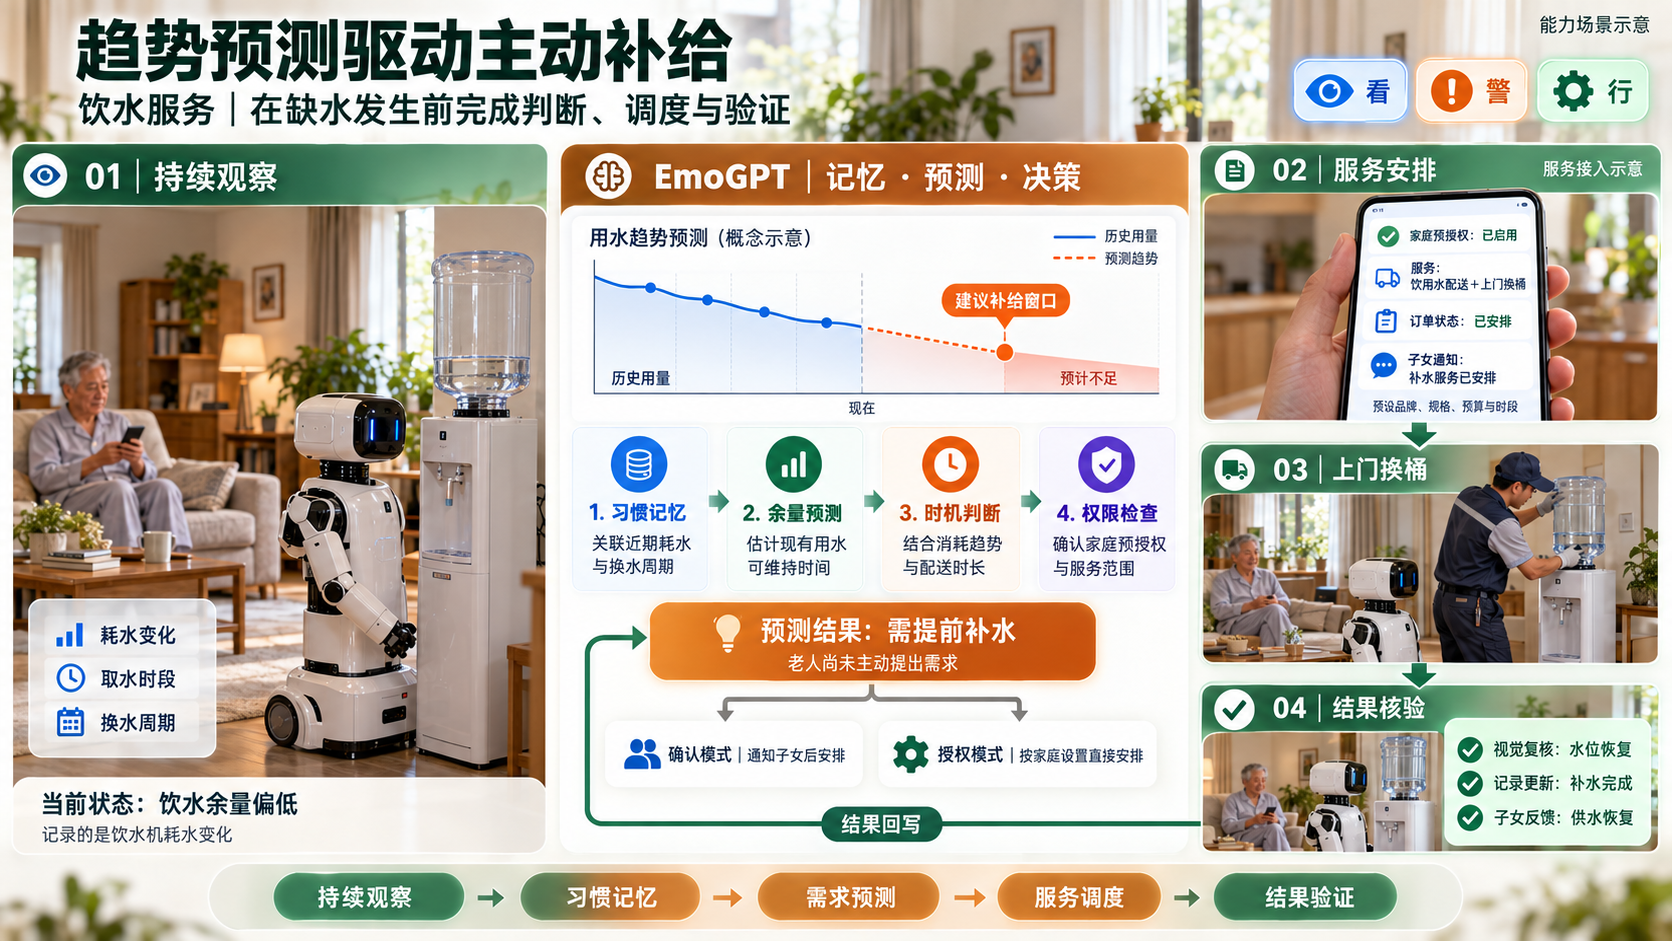
机器人日常巡检时发现饮水机水位进入低位。EmoGPT结合近期耗水变化、家庭换水周期和配送时间,判断现有余量可能不足以覆盖下一补给周期。
系统可以先向子女端推送补水建议;若家庭已设置品牌、规格、预算和配送时段等授权规则,也可以调用已接入的服务平台安排送水。换水完成后,机器人再次观察水位并回写结果。
这里需要区分饮水机耗水量和老人实际饮水量,不能仅凭水位推断个人饮水是否达标。
儿童作息与学习陪伴:帮助建立节奏
在家庭授权范围内,EmoGPT可以结合约定的学习计划、休息间隔及近期活动状态,识别孩子是否已经连续学习较长时间,或者是否多次偏离既定作息。
模型需要选择合适时机,通过机器人进行简短提醒或互动引导;如果孩子已经说明计划变化,系统应更新安排,避免机械重复。
涉及学习评价、情绪风险或家庭规则变更时,应由家长作出关键决定。
5. 自主交互模型应该如何评价
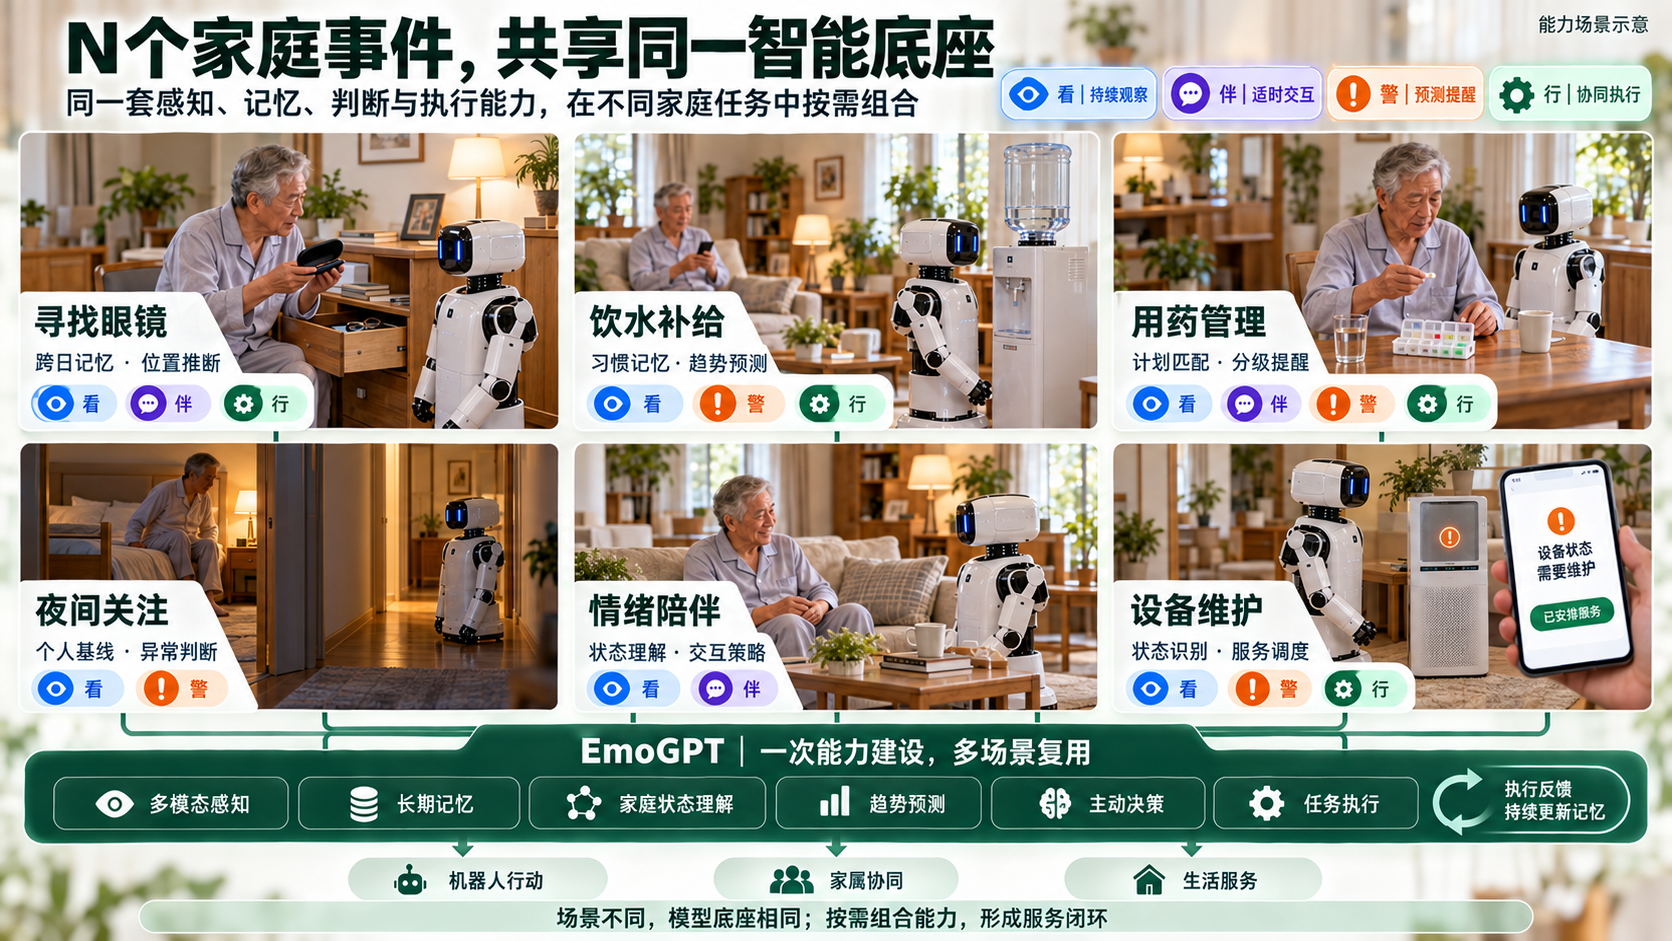
自主交互不能只看单轮问答准确率。更有意义的评价维度包括:
-
跨日记忆一致性:相同人物、物品和事件在不同时间检索时是否一致;
-
状态更新准确性:新观察出现后,旧状态能否被及时修正;
-
误介入率:用户不需要帮助时,模型主动打扰的比例;
-
漏介入率:存在明确需求或风险时,模型未响应的比例;
-
介入时机:提醒是过早、过晚,还是处于有效窗口;
-
闭环完成率:从判断到执行、验证和回写的任务完成比例;
-
权限遵循率:模型是否始终在预授权范围内行动;
-
人工接管有效性:低置信度或高风险事件能否及时交由人处理;
-
解释可追溯性:系统能否说明判断所依据的观察、记忆和规则。
这些指标比“能否回答问题”更接近家庭自主交互的真实要求。
结语
“一老一小”场景对智能系统提出了更高要求:既要主动,也要克制;既要记住长期变化,也要允许用户纠正;既要能调用机器人和外部服务,也要把关键决定留给人。
领本AI通过EmoGPT自主交互世界模型,探索的是一条从多模态感知到现实任务闭环的技术路径。其价值不止于让机器人更会说话,而在于让机器人理解持续发生的生活,在授权范围内发现需求、协同处理问题,并用执行结果不断更新对家庭的理解。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)