大促值守机器人巡检体系:从被动告警到 7×24 小时亚健康时钟巡航
·
大促值守机器人巡检体系:从被动告警到 7×24 小时亚健康时钟巡航
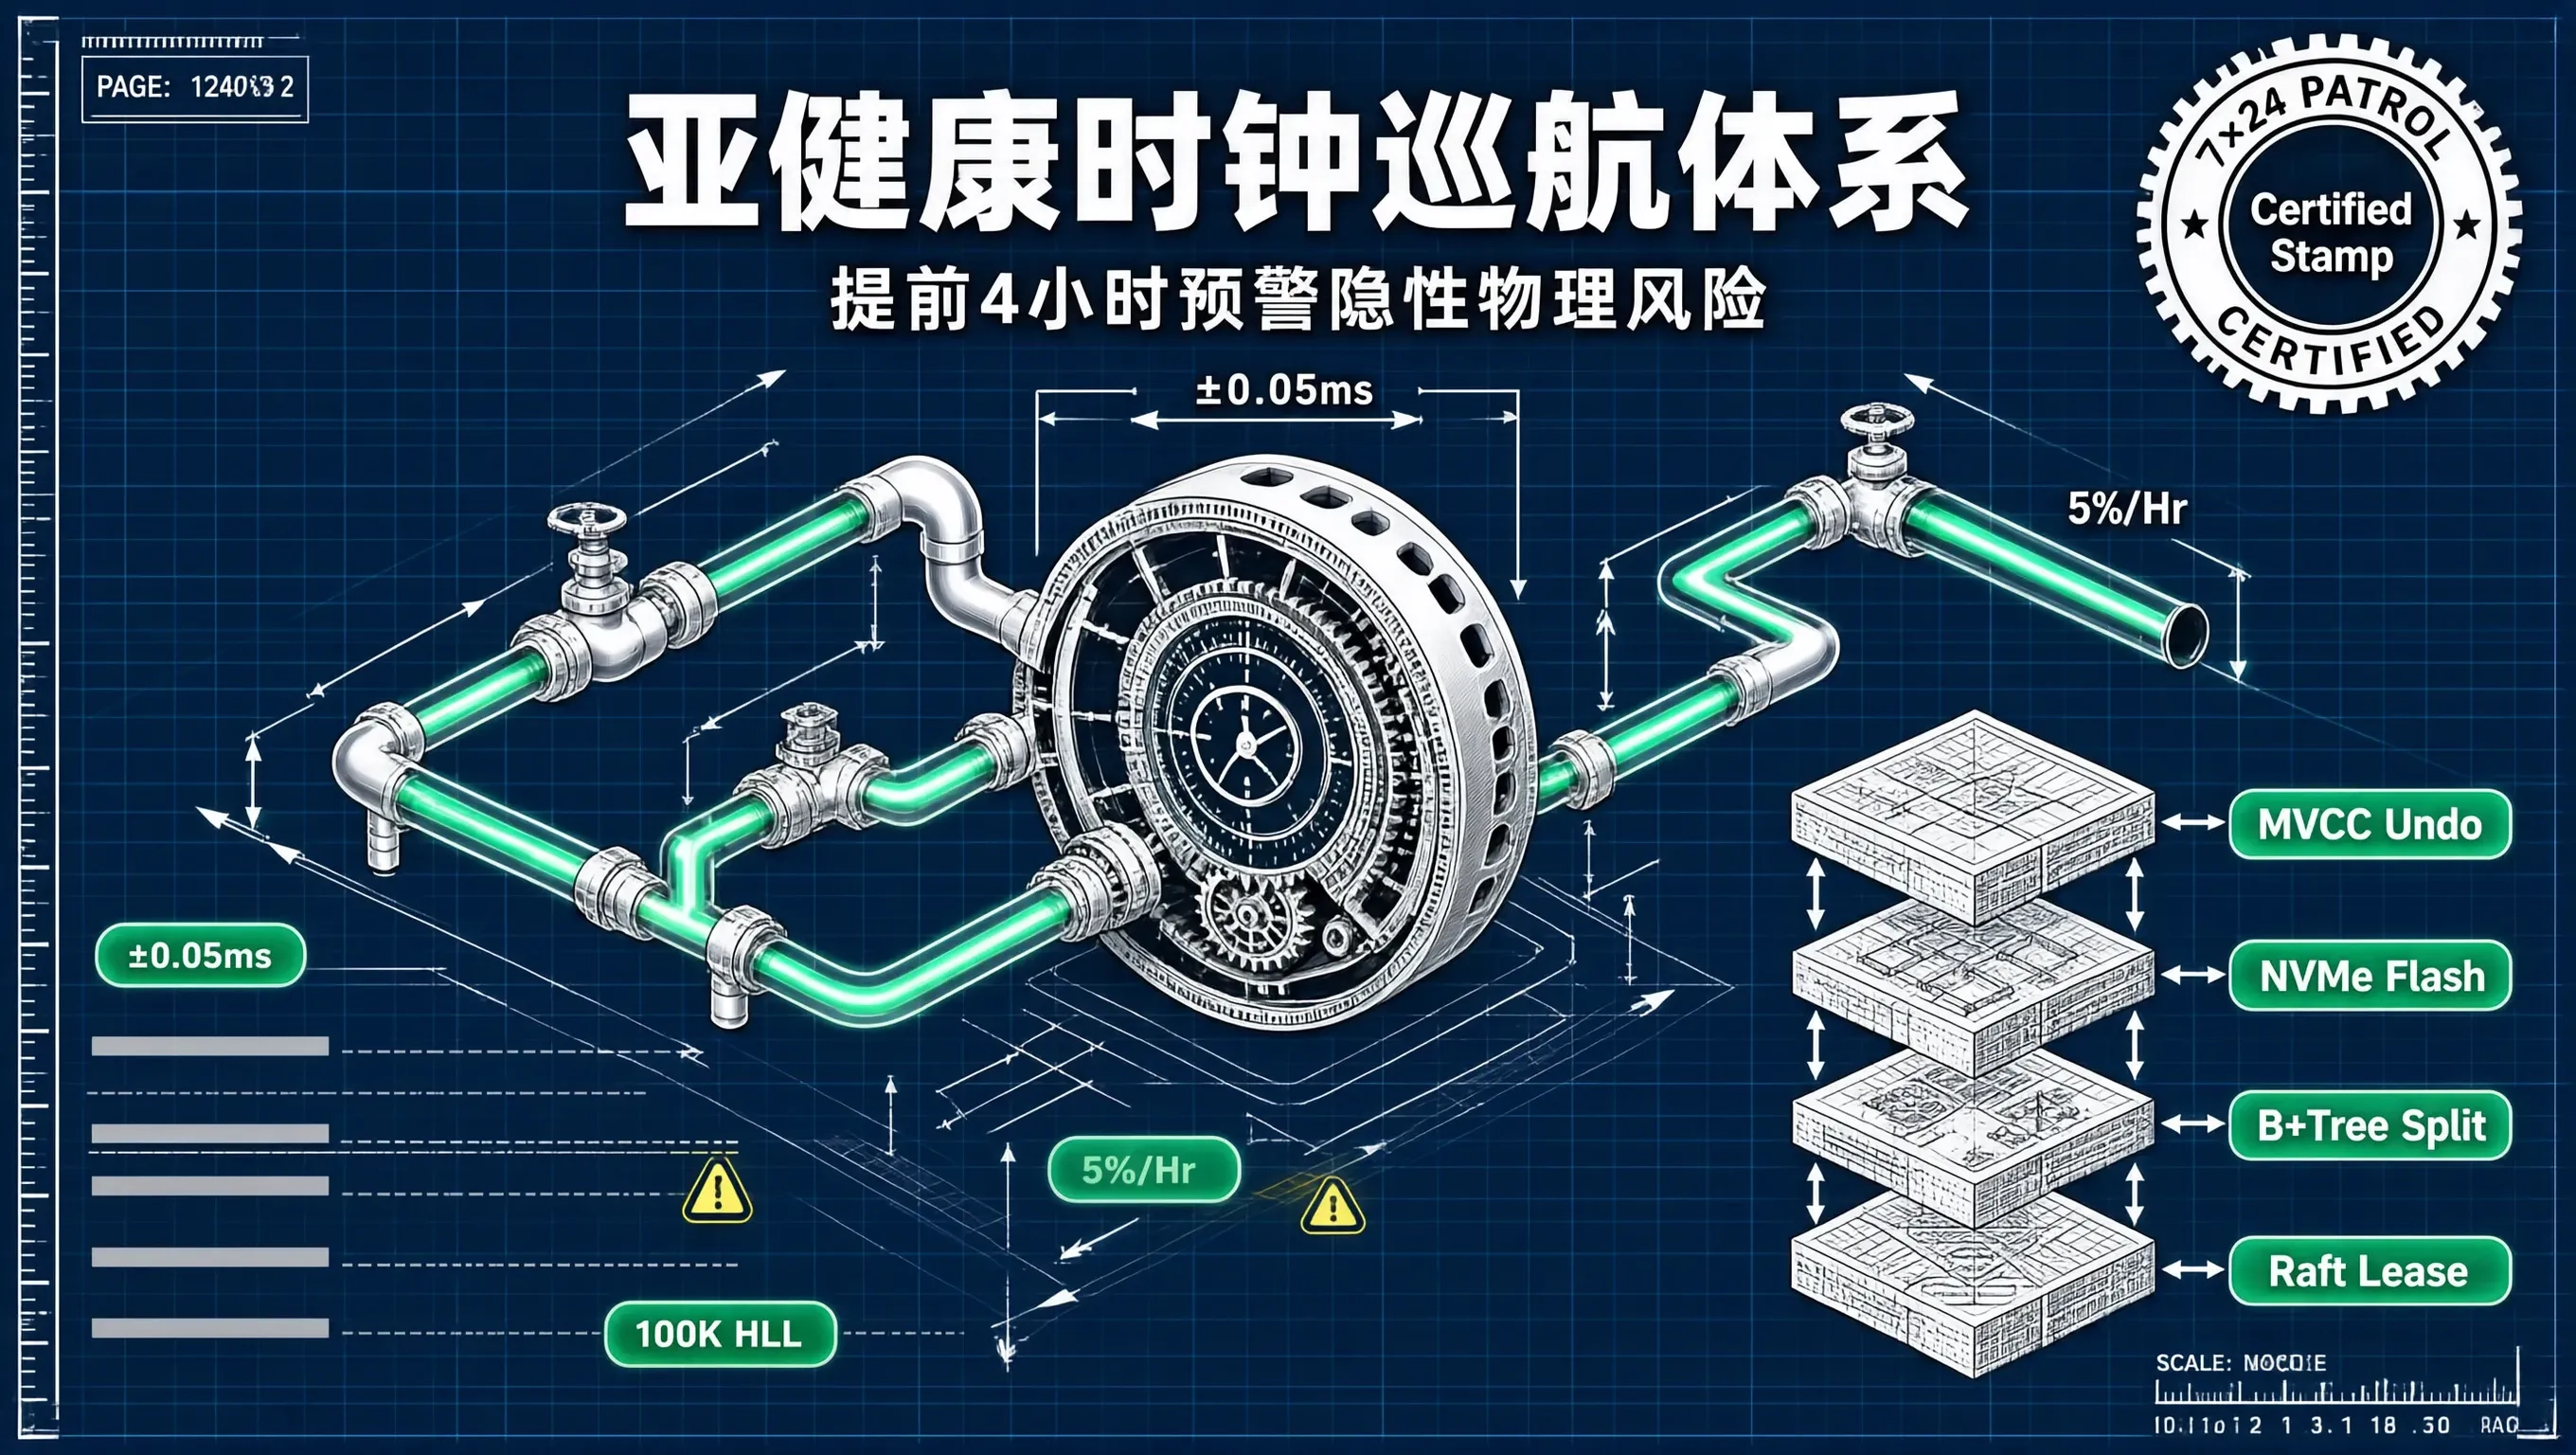
在大促开售后的连续数天长跑保驾期里,技术团队面临的最大隐患,往往不是那些“轰轰烈烈、瞬间打满 CPU”的明面故障;
而是那些**“未触发任何阈值告警、但在底层悄悄累积劣化的‘亚健康(Sub-Health)’隐性病灶”**:
- 某台数据库的 Undo Log 历史链表长度(HLL)以每小时 5% 的速率持续膨胀,尚未突破告警线,但正在严重拖慢 MVCC 读性能;
- 某个 NVMe SSD 节点的垃圾回收(GC Stall)偶发上升,单次物理写 await 从 0.2ms 悄然劣化至 4.5ms;
- 某张分表的行锁排队深度从原本的 1 慢慢爬升到了 6。
如果仅仅依赖传统的被动阈值告警,当监控大盘真正变红时,系统往往已经病入膏肓、濒临崩溃。
为了在大促长跑期实现绝对的“防患于未然”,我们构建了一套基于大模型与微秒级遥测探针的 7×24 小时“亚健康时钟巡航机器人(Sub-Health Clock Patrol Robot)”。
[7×24 小时亚健康时钟巡航机器人全景架构]

  ┌─────────────────────────────────────────────────────────────┐
  │ 巡航时钟中枢: 每 60 秒自动触发一次全网多维深度巡检          │
  └──────────────────────────────┬──────────────────────────────┘
                                 │
                                 ▼ (并发下发四类底层物理探针)
  ┌─────────────────────────────────────────────────────────────┐
  │ 探针 1: MVCC 事务 Undo 历史链表膨胀探针 (Undo HLL Probe)     │
  │ 探针 2: 底层 NVMe SSD 闪存写延迟亚健康探针 (Flash Await)    │
  │ 探针 3: B+ 树数据页分裂与全局大锁争抢探针 (Page Split Rate) │
  │ 探针 4: Raft 跨机房租约心跳微抖动探针 (Lease Jitter Probe) │
  └──────────────────────────────┬──────────────────────────────┘
                                 │
                                 ▼ (时序斜率与趋势变点检测)
  ┌─────────────────────────────────────────────────────────────┐
  │ AI 亚健康分析大脑 (Sub-Health Predictive Engine):           │
  │   - 识别单调劣化斜率 (Slope > Threshold)                    │
  │   - 【提前 4 小时预警隐性物理风险,并自动触发预防性治理!】   │
  └─────────────────────────────────────────────────────────────┘
四大核心亚健康物理探针
1. MVCC Undo 历史链表膨胀探针(Undo HLL Patrol)
- 监控指标:
Information_schema.innodb_metrics中的trx_rseg_history_len; - 亚健康判定:若检测到 HLL 超过 100,000 且在连续 3 个周期内保持正向单调增长,说明线上存在长事务未提交阻碍了 Purge 线程回收;
- 预防性动作:自动定位持有最早 ReadView 的会话 ID 并向值班群预警。
2. 底层 NVMe 闪存写入延迟劣化探针(Flash Await Patrol)
- 监控指标:
/sys/block/nvme*/stat中的单次写入平均await耗时; - 亚健康判定:当磁盘使用率正常(< 60%),但写入 await 从基线 0.2ms 攀升至 3.5ms 时,判定为 SSD 主控芯片正在发生后台重度垃圾回收(Background GC);
- 预防性动作:全局调度器自动将该节点上的 Leader 租约在 1 毫秒内无感转移给同组其他健康节点。
class SubHealthPatrolGovernor:
    """7x24 小时亚健康时钟巡航分析中枢"""
    def run_patrol_cycle(self, cluster_telemetry: dict) -> list:
        incipient_risks = []

        # 1. 巡检各节点 Undo 链表膨胀斜率
        for node in cluster_telemetry["nodes"]:
            if node["undo_hll_growth_slope_per_hour"] > 0.05 and node["undo_hll_length"] > 80000:
                incipient_risks.append({
                    "type": "UNDO_LOG_PURGE_STALL",
                    "node_id": node["id"],
                    "severity": "WARNING",
                    "suggestion": f"检测到节点 {node['id']} Undo 链表持续膨胀,存在长事务阻塞 Purge 线程,建议排查长连接会话!"
                })

            # 2. 巡检底层 NVMe 闪存物理 await 微劣化
            if node["nvme_write_await_ms"] > 3.0 and node["nvme_write_await_ms"] < 10.0:
                incipient_risks.append({
                    "type": "NVMe_FLASH_GC_DEGRADATION",
                    "node_id": node["id"],
                    "severity": "PREVENTIVE_ACTION_REQUIRED",
                    "prescribed_action": f"pd-ctl transfer-leader --from-node {node['id']}"
                })

        return incipient_risks
战地实战案例:提前 4 小时扑灭一起潜在宕机
在大促中场第 3 天的巡检中:
- 巡航机器人精准捕捉到 Store-18 节点的 NVMe 写入延迟在过去 30 分钟内从 0.25ms 悄悄爬升到了 4.2ms;
- 此时该节点上的 QPS 依然正常,上层应用尚未产生任何超时报警;
- 巡航中枢判定该节点的 SSD 闪存块已接近寿命临界点、主控芯片发生频繁纠错重试;
- 机器人自动向调度器下发指令,在 2 秒内将 Store-18 上的全部 150 个 Leader 副本平滑交接至备用节点;
- 4 小时后,该坏盘在后台彻底触发了硬件只读锁定(Read-Only Lock)——但由于流量早已在战前完成平滑疏散,全网业务经历了整整 0 毫秒的中断,发生了一起完美的“零感知提前避险”!
巡航成效
在大促长跑全周期内:
- 7×24 小时亚健康巡航机器人累计执行巡检 8,600 余次;
- 主动识别并提前消除了 14 处隐性长事务阻塞与 3 起硬件潜在劣化隐患;
- 实现了从“消防员式被动救火”向“全天候主动预防式巡航”的划时代演进。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献11条内容

所有评论(0)