WALA:用稀疏未来帧训练可执行潜动作的两阶段框架
0. 简介
WALA(World- and Action-supervised Latent Actions)面向机器人操作策略学习,处理的是带动作标注的机器人演示数据稀缺、而大规模人类视频缺乏动作标签这一核心矛盾。它没有简单地在视觉-语言-动作模型上堆砌更多机器人数据,而是通过语义-几何潜动作模型预训练与潜世界监督下的策略学习两个阶段,把无动作视频中的场景演变转化为对潜动作的约束。从 RoboCasa-GR1-Tabletop 基准看,WALA 达到 75.2% 平均成功率,比此前最强的 DIAL(70.2%)高 5 个百分点;真实机器人实验中,50 条机器人演示加 400 条人类视频的成绩(74.2%)接近 200 条纯机器人演示的水平(75.0%)。下面结合论文与代码仓库,重点拆解两阶段如何分工、稀疏未来帧为何必要、推理时如何丢弃全部辅助模块。
1. 潜动作潜力在哪里,为什么这么多工作都在做这个
1.1 现有路线的瓶颈
机器人策略学习的路线图上已经有两条主干:一条是 VLA(Vision-Language-Action)路线,从 RT-1、RT-2 到 OpenVLA、π₀,核心是用大规模视觉-语言预训练模型接机器人动作头;另一条是 WAM(World Action Model)路线,LingBot-VA、DreamZero、Motus 这些工作用视频预测或生成模型把未来动力学显式建模进来。前者的瓶颈是机器人演示数据的规模天花板——人类视频虽然多,但缺动作标签;后者的瓶颈是推理成本——生成未来视频或跑世界模型前向都很重。
1.2 潜动作的双重约束
潜动作(latent actions) 给出了第三个方向:不直接预测机器人关节指令,也不生成未来像素,而是学一个中间表示空间。这个空间的特殊之处在于,它同时承担两个职责:第一,当有机器人动作标签时,潜动作必须能解码为可执行的控制信号;第二,无论有没有动作标签,潜动作都必须能预测未来的场景演变。LAPA、Moto、UniVLA 这些前序工作已经探索了潜动作的可行性,但它们主要把潜动作当作预训练目标,WALA 的区别在于:它在策略训练阶段保留了可训练的潜世界模型解码器,让策略生成的潜动作同时对真实动作和未来演变负责。WALA 是 VLA 路线的纵向延伸,不是 WAM 路线的横向移植。它用潜动作这个接口,把无动作视频的动力学信息注入到策略学习中,同时把世界模型的计算负担留在训练期,推理时只保留视觉-语言主干和动作头。
2. 两阶段框架:预训练与策略学习的职责切分
2.1 阶段划分与信息流:预训练与策略学习的职责切分
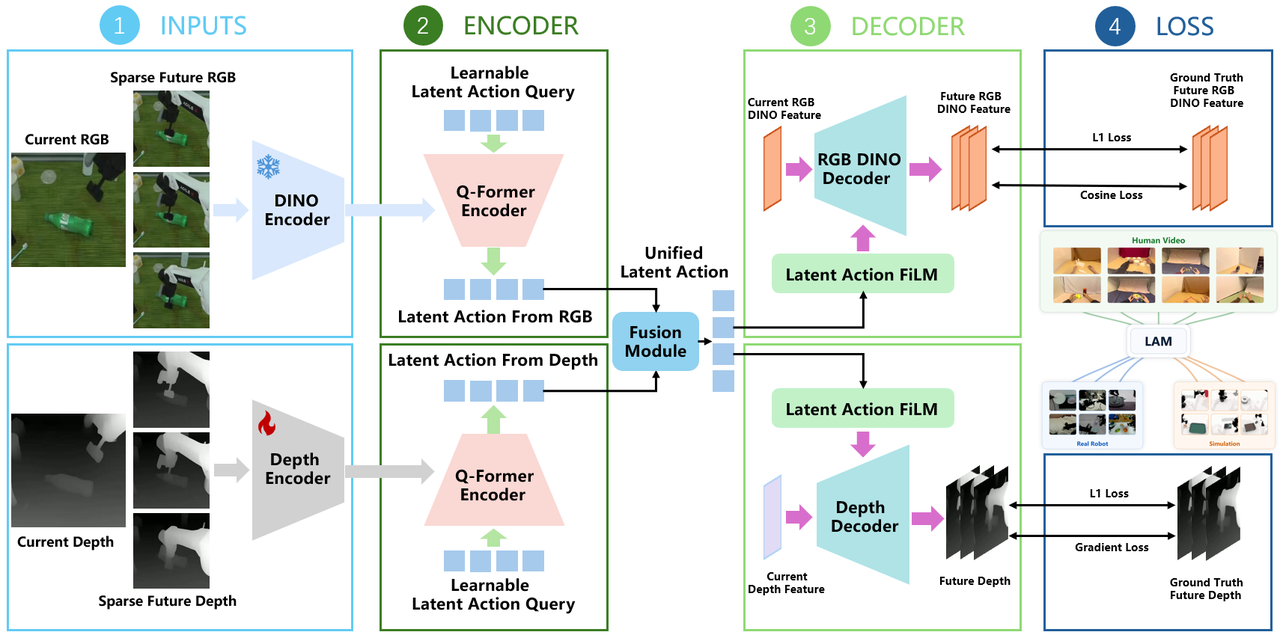
WALA 的架构分两个阶段,每个阶段都有明确的输入、输出和训练目标。第一阶段(LAM 预训练) 在无动作视频上学习潜动作空间的语义和几何基础;第二阶段(策略训练) 在有动作标注的机器人演示和无动作视频的混合数据上训练策略,冻结的潜动作编码器提供稳定目标,可训练的解码器作为潜世界模型参与监督。
2.2 第一阶段:语义-几何潜动作模型。
第一阶段的输入是当前帧 o t o_t ot 和稀疏采样的未来帧 { o t + τ 1 , o t + τ 2 , … , o t + τ K } \{o_{t+\tau_1}, o_{t+\tau_2}, \ldots, o_{t+\tau_K}\} {ot+τ1,ot+τ2,…,ot+τK},其中 K K K 通常取 3-5, τ k \tau_k τk 是非均匀的时间偏移。模型首先用冻结的 DINOv3 提取语义特征,用深度估计器(或离线深度)获取几何信息,然后计算 未来变化量(deltas):
Δ X t , k = ϕ ( I t + τ k ) − ϕ ( I t ) , Δ D t , k = D t + τ k − D t \Delta X_{t,k} = \phi(I_{t+\tau_k}) - \phi(I_t), \quad \Delta D_{t,k} = D_{t+\tau_k} - D_t ΔXt,k=ϕ(It+τk)−ϕ(It),ΔDt,k=Dt+τk−Dt
这里的关键是,
ϕ
\phi
ϕ 是冻结的 DINOv3 编码器,
I
t
I_t
It 是 RGB 图像,
D
t
D_t
Dt 是稠密深度图,三者都不参与梯度更新,因此 deltas 是一个稳定的、不随训练漂移的量。潜动作编码器 接收当前观测和这些 deltas,把「场景怎么变了」压缩成一组固定长度的潜动作 tokens,token 数由 num_transition_tokens 控制,默认取 32 到 50 之间:
z t ∗ = E θ ( X t , D t , Δ X t + , Δ D t + ) z_t^* = E_\theta(X_t, D_t, \Delta X_t^+, \Delta D_t^+) zt∗=Eθ(Xt,Dt,ΔXt+,ΔDt+)
潜动作解码器 执行逆向任务,从当前状态和潜动作预测未来的语义和几何变化:
Δ X ^ t , k = G ψ rgb ( X t , z t ∗ , k ) , Δ D ^ t , k = G ψ dep ( D t , z t ∗ , k ) \widehat{\Delta X}_{t,k} = G_\psi^{\text{rgb}}(X_t, z_t^*, k), \quad \widehat{\Delta D}_{t,k} = G_\psi^{\text{dep}}(D_t, z_t^*, k) ΔX t,k=Gψrgb(Xt,zt∗,k),ΔD t,k=Gψdep(Dt,zt∗,k)。换句话说,编码器负责从已经发生的变化里反推动作,解码器负责从动作正向推出变化,两者构成一个自洽的闭环。训练目标因此包含语义预测和几何预测两部分,分别约束这个闭环在 DINOv3 特征空间和稠密深度空间的还原精度:
L LAM = ∥ Δ X ^ − Δ X ∥ 1 + λ cos L cos ⏟ 语义损失 + λ dep ( ∥ Δ D ^ − Δ D ∥ 1 + λ grad L grad ) ⏟ 几何损失 \mathcal{L}_{\text{LAM}} = \underbrace{\|\widehat{\Delta X} - \Delta X\|_1 + \lambda_{\cos} \mathcal{L}_{\cos}}_{\text{语义损失}} + \lambda_{\text{dep}} \underbrace{(\|\widehat{\Delta D} - \Delta D\|_1 + \lambda_{\text{grad}} \mathcal{L}_{\text{grad}})}_{\text{几何损失}} LLAM=语义损失 ∥ΔX −ΔX∥1+λcosLcos+λdep几何损失 (∥ΔD −ΔD∥1+λgradLgrad)
其中 L cos \mathcal{L}_{\cos} Lcos 是 DINOv3 特征空间的余弦相似度损失,负责约束特征变化的方向而非仅仅幅度; L grad \mathcal{L}_{\text{grad}} Lgrad 是深度梯度一致性损失,匹配预测深度变化与真实深度变化在水平和竖直方向上的梯度。直观理解是,L1 项管「变了多少」,余弦项管「往哪个方向变」,梯度项管「变化的空间轮廓对不对」,三者缺一都会让潜动作退化成一个粗糙的全局标量。
难点提示(为什么预测 deltas 而不是绝对未来状态):如果直接预测 X t + τ k X_{t+\tau_k} Xt+τk 和 D t + τ k D_{t+\tau_k} Dt+τk,编码器学到的可能是"未来长什么样",而不是"动作导致了什么变化"。用 deltas 强制编码器关注相对演变,避免把静态场景信息混入潜动作。这个设计在消融实验中被证明关键——没有 deltas 的变体性能显著下降。
2.3 第二阶段:潜世界监督下的策略学习
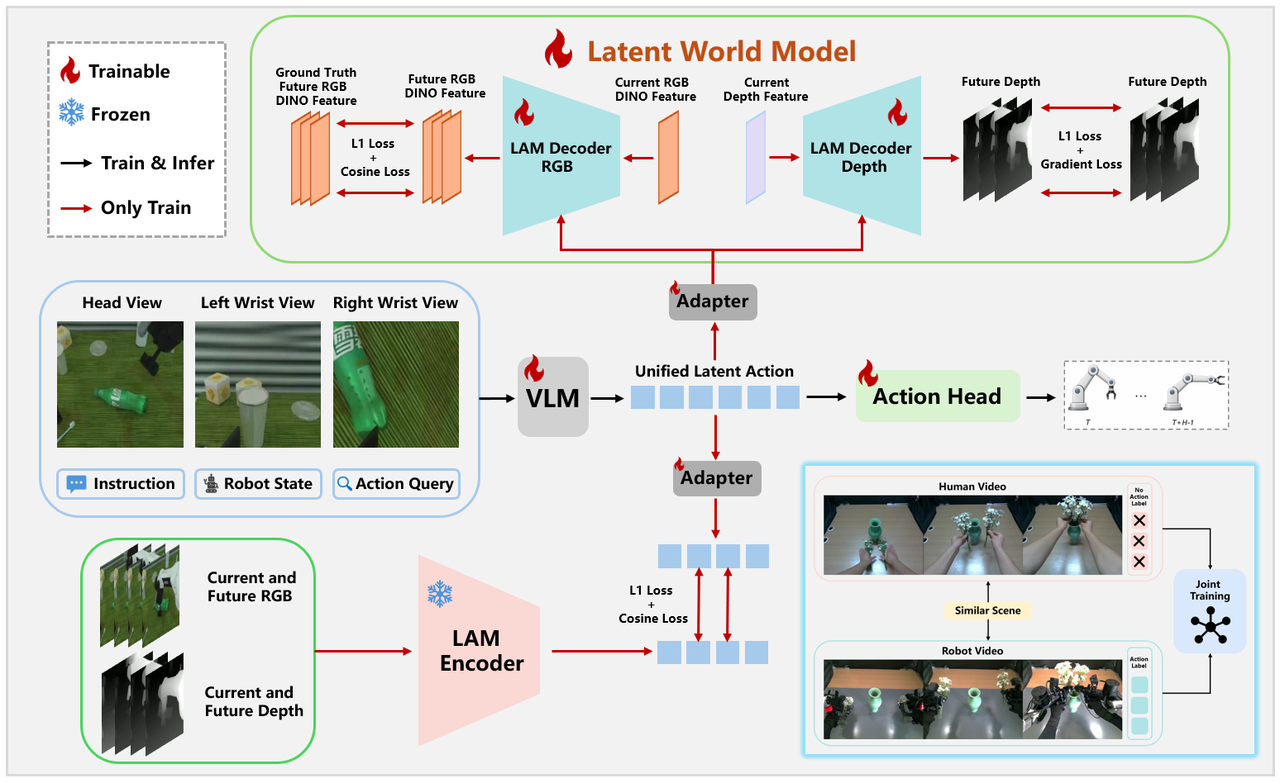
第二阶段把预训练模型整合到策略学习中。编码器被完全冻结,作为"真相源"提供稳定的潜动作目标 z t ∗ z_t^* zt∗;解码器继续训练,但现在它的输入换成了视觉-语言主干网络生成的策略潜动作 z ~ t \widetilde{z}_t z t。视觉-语言主干(Qwen3-VL-4B)接收多视角观测、语言指令、机器人状态和学习的动作查询,生成统一的潜动作表示。动作头将潜动作转化为具体的机器人控制指令。。这里要厘清的是,同一个解码器在两个阶段接收的潜动作来源不同,因此它在第二阶段实际扮演的是「潜世界模型」而非「重建器」。训练目标函数由此结合三个损失项,分别对应可执行性、分布一致性和未来动力学:
L policy = m ⋅ L act + λ align L align + λ wm L wm \mathcal{L}_{\text{policy}} = m \cdot \mathcal{L}_{\text{act}} + \lambda_{\text{align}} \mathcal{L}_{\text{align}} + \lambda_{\text{wm}} \mathcal{L}_{\text{wm}} Lpolicy=m⋅Lact+λalignLalign+λwmLwm,其中 m ∈ { 0 , 1 } m \in \{0, 1\} m∈{0,1} 指示当前样本是否有机器人动作标签,这个二元开关是整套框架能吃下混合数据的关键所在。三个损失项各自承担不同职责:
- L act \mathcal{L}_{\text{act}} Lact:机器人动作预测损失,确保输出的动作与演示数据一致(L1损失)
- L align \mathcal{L}_{\text{align}} Lalign:潜动作目标匹配损失,拉近 z ~ t \widetilde{z}_t z t 与冻结编码器产生的 z t ∗ z_t^* zt∗
- L wm \mathcal{L}_{\text{wm}} Lwm:潜世界模型损失,通过预测未来语义和几何变化来监督潜动作
对于有标签的机器人演示, m = 1 m=1 m=1,三个损失都启用,潜动作同时受到可执行性(能转化为真实动作)、分布一致性(落在预训练空间内)和未来动力学(能预测场景演变)三重约束;对于无标签的人类视频, m = 0 m=0 m=0,动作损失被屏蔽,但 L align \mathcal{L}_{\text{align}} Lalign 和 L wm \mathcal{L}_{\text{wm}} Lwm 仍然有效——这就是无动作视频参与训练的通道,它们通过潜动作目标匹配和未来预测两条路径,把场景演变的动力学信息注入到策略学习中,弥补机器人演示数据的不足。
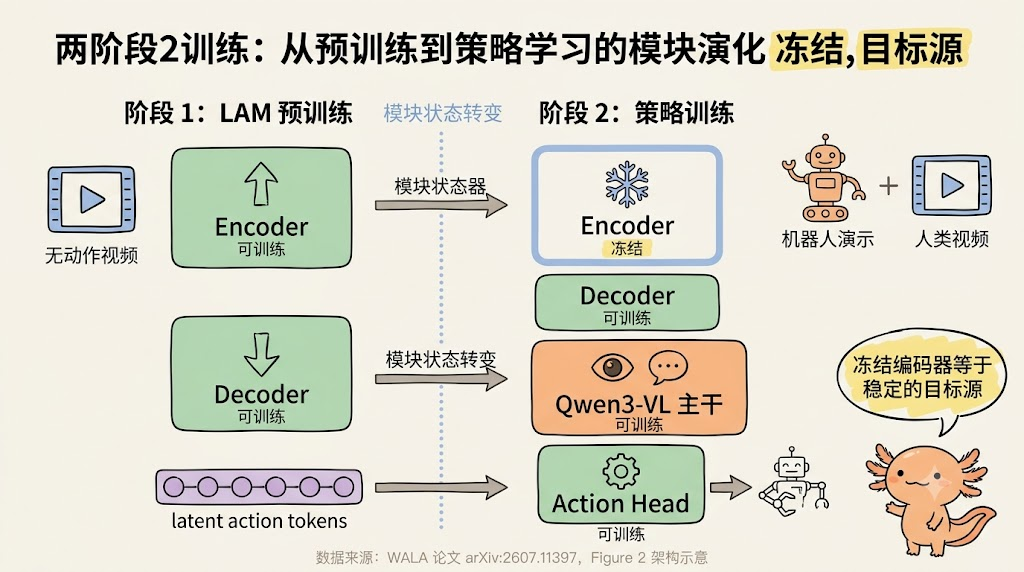
难点提示(解码器的双重语义):第一阶段预训练时,解码器的输入潜动作来自编码器,编码器看得到未来,所以解码器面对的是"由未来推出的动作";第二阶段策略训练时,解码器的输入换成了主干网络生成的潜动作,而主干只看到当前帧。解码器仍然被要求预测正确的未来变化量,这就把压力反向传给了主干:主干必须产出一个"能解释未来"的潜动作,尽管它看不到未来。这正是这套监督结构真正起作用的地方。
3. 稀疏未来帧:为什么不用连续视频
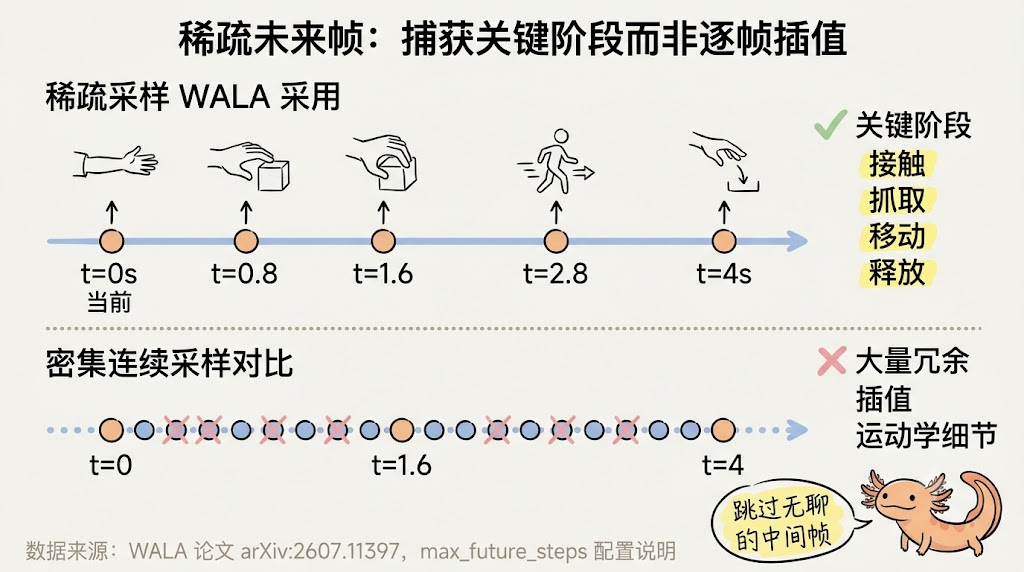
WALA 的一个关键设计选择是使用 稀疏采样的未来观测,而不是连续的视频帧。论文在未来 2-4 秒的时间窗口内采样 K = 3 ∼ 5 K=3\sim 5 K=3∼5 个关键帧,这些帧覆盖了一个完整子任务(如"抓取物体")的主要阶段,既要足够稀疏以避免冗余计算和低层次插值,又要足够密集以覆盖操作的关键转折点。这个设计背后有三个重要考量,分别对应计算效率、表示抽象度和泛化能力,每一个都关乎潜动作能否真正捕获跨时间跨度的高层次意图。
3.1 计算效率与信息密度的平衡
连续帧之间的变化往往非常微小,包含大量冗余信息。例如,在一个抓取-放置任务中,关键的变化发生在 接触物体前、抓取时、移动后、释放时 等几个离散时刻,而不是每一帧。稀疏采样能够在大幅降低计算成本的同时,捕获更显著的场景演变。如果用连续帧,编码器需要处理几十上百帧的 DINOv3 特征(每帧 1024 个 patch × 768 维),而稀疏采样只需要处理 3-5 帧,显存占用和计算量都降低一个数量级。
3.2 强制学习高层次动作表示
如果使用密集的连续帧,模型可能会退化为学习低层次的运动学插值,而不是真正的动作意图。通过引入时间上的跳跃( τ 1 , τ 2 , … , τ K \tau_1, \tau_2, \ldots, \tau_K τ1,τ2,…,τK 通常是非均匀的),模型被迫学习能够跨越较大时间跨度解释场景变化的抽象表示。这正是"潜动作"所需要的抽象层次。
直观理解是,如果让你预测一个人从起点走到终点的每一步脚步,你学到的是步态模式;但如果只告诉你起点、中间拐弯处、终点,你被迫学习的是路径规划和意图推理。WALA 的稀疏采样就是在做后者。密集帧会把大量容量花在插值上,而稀疏帧迫使模型回答一个更难也更有用的问题:要让场景从当前状态变成若干秒后的那个状态,中间需要发生什么性质的动作。
3.3 泛化到不同动作速度
真实世界中的操作速度差异很大——人类和机器人的动作节奏不同,同一任务在不同场景下的执行速度也不同。稀疏采样使得潜动作表示对具体的时间尺度不那么敏感,提高了跨域泛化能力。无论是 2 秒内完成抓取还是 4 秒,只要采样覆盖了"接触前-抓取-移动-释放"这几个关键阶段,潜动作表示就能泛化。
落到代码上,仓库里 RoboCasa 配置的两个参数是 max_future_steps: 64 和 future_action_window_size: 31,意味着模型可以在最多 64 步的未来窗口内稀疏采样,每次预测的动作序列长度是 31 步。这两个数字共同界定了「未来」的跨度:既要足够长以覆盖一个完整的操作子阶段,又不能长到让当前观测对末端状态失去预测力。
4. 语义-几何分支:DINOv3 特征 + 稠密深度
4.1 为什么避开像素重建:DINOv3 特征 + 稠密深度
WALA 避免了像素级的未来帧重建,这是另一个核心设计。核心问题在于:像素空间包含大量与操作任务无关的信息(光照变化、纹理细节、背景元素等),而 DINOv2/v3 等自监督学习的视觉特征已经过滤掉了这些干扰,保留了语义层面的物体类别、姿态等信息。
进一步看,单纯的语义特征不足以捕获精确的空间关系。这里的关键是,深度信息提供了物体位置、接触状态、遮挡关系等几何约束,这对于接触丰富的操作任务至关重要。WALA 的潜动作模型同时预测 DINOv3 特征空间的变化和稠密深度空间的变化,语义特征能说清"什么东西变了",深度图说清"变到了哪里、离得多近"。
4.2 LAM 编码器的核心结构
这里的关键是两条分支如何汇成一个潜动作。仓库里 ContinuousTransitionBottleneckTokenizer 这个类同时承载了 RGB 分支、深度分支和融合模块,类名里的 transition bottleneck 就是论文所说的潜动作瓶颈。下面是它的核心结构,从 wala/model/modules/latent_action_model/latent_action_model.py 抽取(省略了 composition / reencode / content-invariance 三组辅助损失权重和深度分支的完整构造):
# wala/model/modules/latent_action_model/latent_action_model.py
class ContinuousTransitionBottleneckTokenizer(nn.Module):
    """Continuous latent action tokenizer for semantic and geometric dynamics.

    The RGB branch encodes current DINOv3 patch features together with future
    feature deltas, then decodes future DINOv3 patch deltas from the latent
    tokens. When depth is enabled, depth maps are normalized per clip, converted
    into local geometry channels, patchified, and fused with the RGB latent
    tokens. The depth decoder predicts dense normalized depth residuals.
    """

    def __init__(
        self,
        *,
        dino_dim: int = 768,
        hidden_dim: int = 768,
        num_transition_tokens: int = 50,
        encoder_layers: int = 6,
        decoder_layers: int = 4,
        num_heads: int = 8,
        max_future_steps: int = 64,
        max_patches: int = 1024,
        dropout: float = 0.0,
        use_depth: bool = False,
        depth_loss_weight: float = 1.0,
        depth_gradient_loss_weight: float = 0.2,
        depth_patch_size: int = 14,
    ) -> None:
        super().__init__()

        # ---------------- RGB / DINO transition encoder ----------------
        self.current_input_proj = nn.Linear(dino_dim, hidden_dim)
        self.delta_input_proj = nn.Linear(dino_dim, hidden_dim)

        self.transition_queries = nn.Parameter(torch.randn(1, num_transition_tokens, hidden_dim) * 0.02)
        self.transition_token_embed = nn.Parameter(torch.randn(1, num_transition_tokens, hidden_dim) * 0.02)

        # 时间 / patch / 类型三套位置编码:让编码器区分「第几个未来帧」「第几个 patch」
        # 「这是当前特征还是 delta」,否则 deltas 会被当成无序集合。
        self.time_embed = nn.Parameter(torch.randn(1, max_future_steps, hidden_dim) * 0.02)
        self.patch_embed = nn.Parameter(torch.randn(1, max_patches, hidden_dim) * 0.02)
        self.current_type_embed = nn.Parameter(torch.zeros(1, 1, hidden_dim))
        self.delta_type_embed = nn.Parameter(torch.zeros(1, 1, hidden_dim))
        self.horizon_query = nn.Parameter(torch.randn(1, 1, hidden_dim) * 0.02)

        encoder_layer = nn.TransformerDecoderLayer(
            d_model=hidden_dim, nhead=num_heads, dim_feedforward=hidden_dim * 4,
            dropout=dropout, batch_first=True, norm_first=True,
        )
        self.encoder = nn.TransformerDecoder(encoder_layer, num_layers=encoder_layers)

        # ---------------- RGB / DINO transition decoder ----------------
        horizon_layer = nn.TransformerDecoderLayer(
            d_model=hidden_dim, nhead=num_heads, dim_feedforward=hidden_dim * 4,
            dropout=dropout, batch_first=True, norm_first=True,
        )
        self.horizon_decoder = nn.TransformerDecoder(horizon_layer, num_layers=decoder_layers)

        self.current_patch_proj = nn.Linear(dino_dim, hidden_dim)
        # FiLM 调制:用潜动作 token 生成 scale/shift 去调制当前 patch 特征,
        # 而不是简单拼接,这样潜动作对每个 patch 的影响是乘性的。
        self.transition_film = nn.Sequential(
            nn.LayerNorm(hidden_dim),
            nn.Linear(hidden_dim, hidden_dim * 2),
        )
        self.delta_head = nn.Sequential(
            nn.LayerNorm(hidden_dim),
            nn.Linear(hidden_dim, hidden_dim * 2),
            nn.GELU(),
            nn.Linear(hidden_dim * 2, dino_dim),
        )
核心机制:这里要厘清的是,transition_queries 是一组可学习的查询 tokens(默认 50 个),编码器通过交叉注意力从当前特征和未来 deltas 中提取潜动作信息。解码器则从这些 tokens 预测未来的 DINOv3 特征变化量。当启用深度分支时(use_depth=True),会额外创建一组深度编码器和解码器,最后通过交叉融合层将 RGB 和深度的潜动作 tokens 合并。
工程价值:预测 DINOv3 特征变化而不是原始像素,训练稳定性提升显著。像素重建任务容易被高频细节主导,导致模型将大量容量用于重建纹理,而忽视了动作相关的结构变化。特征空间预测能够更好地平衡语义理解和几何感知。
5. 训练时的三重监督
5.1 动作头的实现
第二阶段策略训练的核心是三重损失函数。下面是从 wala/model/modules/action_model/mlp_action_head.py 抽取的动作头实现:
# wala/model/modules/action_model/mlp_action_head.py
class L1RegressionActionHead(nn.Module):
    """Continuous action regression head used by WALA."""

    def __init__(
        self,
        input_dim=2048,
        hidden_dim=4096,
        action_dim=7,
        NUM_ACTIONS_CHUNK=8,
    ):
        super().__init__()
        self.action_dim = action_dim
        self.NUM_ACTIONS_CHUNK = NUM_ACTIONS_CHUNK
        self.model = MLPResNet(
            num_blocks=2,
            input_dim=input_dim,
            hidden_dim=hidden_dim,
            output_dim=action_dim,
        )

    def predict_action(self, actions_hidden_states):
        # 每个 action query token 各自解码出一步动作:把 (B, chunk_len, hidden)
        # 摊平成 (B*chunk_len, hidden) 过同一个 MLP,再折回时间维。
        # 因此 output_dim 是 action_dim 而不是 action_dim * chunk_len——
        # 时间维度由 token 数承载,不由输出宽度承载。
        batch_size, chunk_len, hidden_dim = actions_hidden_states.shape
        x = actions_hidden_states.reshape(batch_size * chunk_len, hidden_dim)
        x = self.model(x)
        return x.view(batch_size, chunk_len, self.action_dim)

    def forward(self, actions_hidden_states, actions=None):
        if actions is None:
            return self.predict_action(actions_hidden_states)
        if actions.shape[1] != self.NUM_ACTIONS_CHUNK:
            raise ValueError(
                f"Expected actions.shape[1] == NUM_ACTIONS_CHUNK={self.NUM_ACTIONS_CHUNK}, "
                f"but got actions.shape[1]={actions.shape[1]}."
            )
        return F.l1_loss(self.predict_action(actions_hidden_states), actions)
直观理解是,这个动作头接收潜动作表示(从 Qwen3-VL 主干的 action query tokens 中提取),通过 2 层 MLP ResNet 逐 token 解码出动作序列。这里的关键是时间维度的承载方式:chunk_len 个 token 各自解码一步动作,共享同一套 MLP 权重,所以 output_dim 只需要 action_dim。工厂函数 get_action_model 把 chunk 长度设为 1 + future_action_window_size,RoboCasa 配置下 future_action_window_size=31,因此实际预测 32 步。训练时直接计算 L1 损失
L
act
\mathcal{L}_{\text{act}}
Lact,且会先校验标签的时间维与 NUM_ACTIONS_CHUNK 一致——这个断言挡住的是数据管线里 chunk 长度配错却静默广播的情况。
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献160条内容

所有评论(0)