测试时训练(TTT):从序列建模的快速权重,到图像恢复与机器人操作的实例自适应
0. 简介
测试时训练(Test-Time Training, TTT) 面向的是这样一类序列建模与恢复任务:模型的输入在推理时仍在持续演化,而训练时见过的分布与测试时遇到的分布并不一致。它没有采用"训练后权重彻底冻结"的常规路线,而是把一条序列本身当作一份临时数据集,在推理的前向传播里用自监督损失对一小份**快速权重(Fast Weights)**做梯度更新,让模型的状态在测试时也持续学习。自 2024 年 TTT 层(TTT-Layer)提出后,这条思路分别向两个方向纵深:TTTIR 把它用在图像恢复上,用 0.787M 参数在 LOL-v2-Real 上把 PSNR 提升到 30.78 dB;RoboTTT 把它接进机器人 VLA 策略,把可视运动上下文扩到 8K 时间步,长程任务平均完成率提升 87%。下面结合官方 TTT-LM 代码、TTTIR 论文与 RoboTTT 论文,重点拆解三件事:TTT 的核心递推机制如何写进一个层、为什么它能在推理时继续学习、以及这套范式在视觉与机器人上的实例自适应价值。
1. TTT:它到底在干什么
1.1 两个考生的比喻
先把公式放一边。想象两个学生参加同一场考试。第一个学生考前把知识背得滚瓜烂熟,进考场后大脑上锁,不管题目长什么样,都只用脑子里那套背好的东西作答——这就是普通神经网络:训练结束后权重冻结,推理时一个参数都不动。第二个学生同样背了书,但手里多一个便签本,每读一道题就把这道题里的要点抄进便签,后面答题时参考便签,越往后答得越顺。这个便签本就是 TTT 的快速权重(Fast Weights),而"边考边往便签上写"这个动作,就是测试时训练。
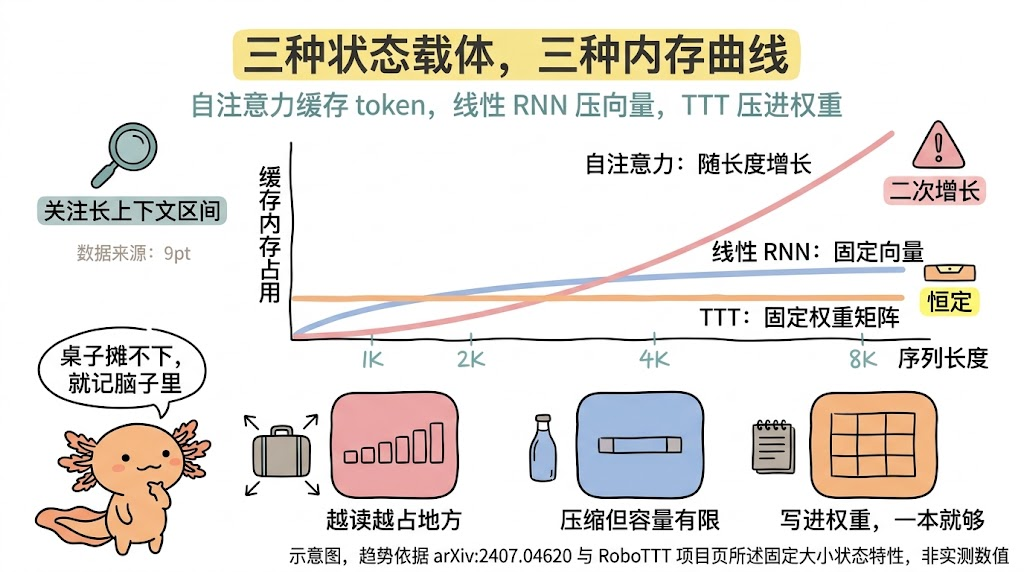
这里的关键是,第二个学生并没有把整张卷子复印摊在桌上。他只有一个固定厚度的便签本,读到的信息被他消化、压缩、写进便签。自注意力(Transformer)走的恰恰是"复印摊桌"路线:每读一个 token 就把它的键值缓存起来,读得越多,桌子越占地方。TTT 换了个思路——不留原件,只留笔记,笔记本厚度从头到尾不变。
1.2 名字里的"训练"是字面意思
TTT 里的"训练"不是修辞,是字面意思。真正发生的事情是:在推理的前向传播内部,模型对一小份参数算了一次梯度、做了一次减法。这件事发生在 forward 里面,不在训练脚本的 optimizer.step() 里,也不需要任何人调用 loss.backward()——它是模型结构自带的一部分,跟激活函数、归一化层一样属于前向计算的组成部分。把这个过程剥到最干净,只留骨架,它长这样:
# 概念示意(非仓库代码):TTT 层内部每读一个 token 发生的事
def ttt_layer_step(W, x_t):
    # 第一步 Update:算自监督损失的梯度,把这个 token 写进快速权重
    loss = reconstruction_loss(W, x_t)      # 让 W 去重建刚看到的 x_t
    W = W - eta * grad(loss, W)             # 一次梯度下降,就一步
    # 第二步 Apply:用刚更新过的 W 处理这个 token,输出给下一层
    return f(x_t, W), W                     # W 带到下一个时间步
这段是为了讲清机制的概念示意,真实实现见第 4.2 节从 ttt-lm-pytorch 抽出的代码——那里的 W1_last = W1_init - (...) @ grad_l_wrt_Z1 就是上面 W = W - eta * grad(...) 这一行的工程版本,只不过为了效率被改写成了矩阵乘法的形式。两者做的是同一件事:读一个 token,改一次权重,再用新权重输出,然后把这份权重交给下一个时间步。整个 TTT 层的复杂度,本质上就是这三行的重复。
1.3 为什么必须用自监督:测试时没有标准答案
有人会问:测试时更新参数,那用什么算损失?训练时有标签,推理时哪来的监督信号?这正是 TTT 设计里最巧的一环——它不需要标签,用的是自监督。具体做法是让快速权重去做一件"自己就能判分"的事:重建刚刚读到的那个 token。模型把 x t x_t xt 压进权重再还原出来,还原得不像就是损失,这个损失完全由输入自己产生,不依赖任何人告诉它正确答案是什么。
一句话理解:自监督损失在这里的作用不是"学会任务",而是"把这一条输入的特征刻进便签"。任务能力早在外层训练时就学好了,内循环只负责把当前这条输入的个性写进快速权重。
1.4 两层循环:外层学"怎么学",内层学"这一条输入"
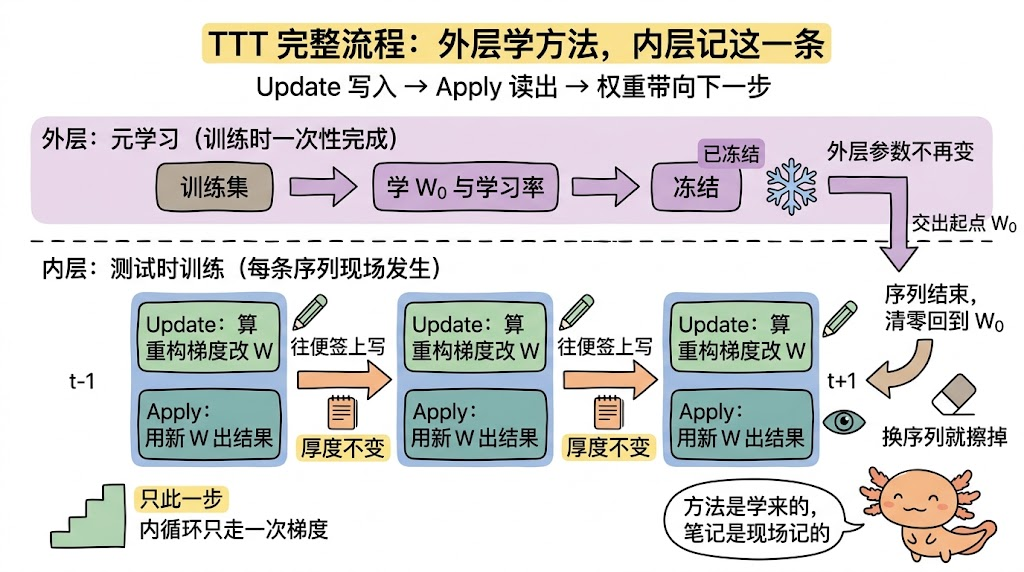
TTT 最容易被误解的地方是它有两层循环,很多人只看到内层就以为"模型在推理时乱改自己"。实际结构是这样:外层是普通的监督训练,跑在训练集上,学的是快速权重的初始值 W 0 W_0 W0、内循环学习率 η \eta η 以及那几个投影矩阵——换句话说,外层学的是"该怎么做笔记"这套方法论。内层才是测试时的那一次次梯度更新,它不改外层学到的任何东西,只在 W 0 W_0 W0 这个起点上,针对眼前这条具体输入往前挪几步。
进一步看,这就解释了为什么 TTT 部署后不会"越跑越飘"——这是很多人对测试时更新最直接的担心。外层参数一旦训好就彻底冻结,内层每次都从同一个 W 0 W_0 W0 出发,读完一条序列后清零重来,不会跨样本累积漂移。换句话说,模型的"人格"由外层锁定,内层只负责临场适配;它不会因为读了一批奇怪的输入就永久地变成另一个模型。
类比:外层训练相当于教一个新人"遇到陌生项目该怎么记要点、记哪些";内层是他真的接手某个具体项目后当场记的那一页笔记。换项目就换新纸,方法论不变。
2. 研究问题与现有方法的缺口
2.1 自注意力与 SSM 的长期困境
序列建模的主流是自注意力:Transformer 在长上下文上表现优异,代价是随序列长度二次增长的复杂度与缓存成本。状态空间模型(SSM)与各类线性 RNN 把复杂度降回线性,但它们的隐藏状态是固定大小的向量,表达能力有限。核心问题在于,这两条路线都在用"一组训练后冻结的全局参数"处理所有输入;当测试分布的退化形态随实例变化时,瓶颈就出现在这套静态参数上。TTT 的切入点是把这个隐藏状态本身换成一个小的机器学习模型,让每一条输入序列都去更新它,从而在保持线性复杂度的同时提升长上下文表达力。
2.2 两条互补的纵深路线
同一套"测试时继续学习"的思想,在不同任务上长成了两种形态。一种面向序列建模本身,以 TTT-Linear / TTT-MLP 为代表,把快速权重做成 RNN 的隐藏状态,追求的是在长文本、长视频上以线性代价逼近自注意力的表达力。另一种面向单张图像的恢复与机器人控制,以 TTTIR 与 RoboTTT 为代表,它们不只把测试时更新当作"状态压缩",而是用一套带物理或恢复引导的目标序列去监控内循环,让快速权重在推理时演化成实例专属的算子。这两种形态共享同一条回路的骨架——更新(update)与应用(apply)——但监督信号与目标设计截然不同。
3. 整体框架:把隐藏状态换成一个小模型
3.1 输入输出接口与两步递推
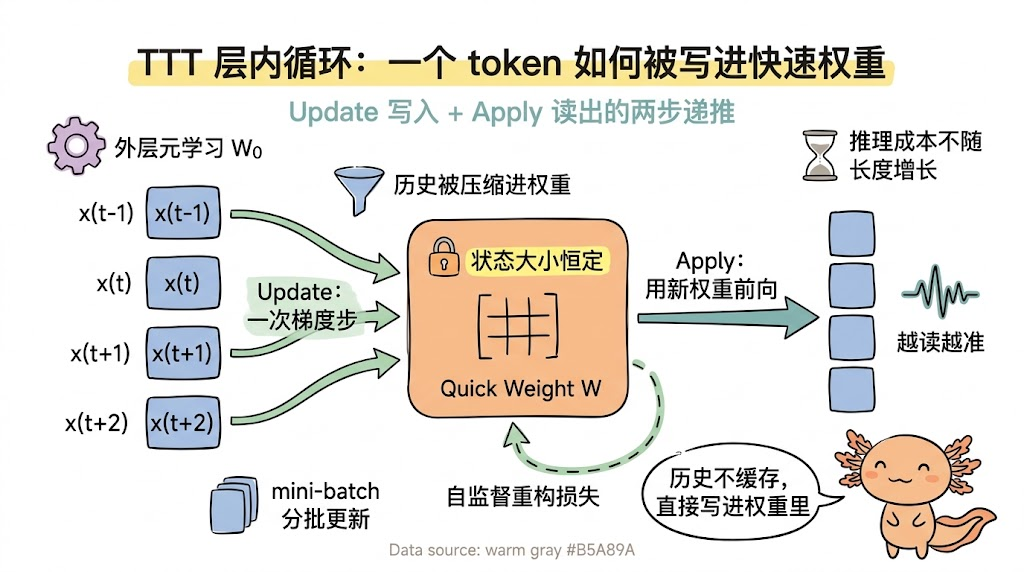
TTT 层的输入是 token 序列,输出继续喂给下一层。它不缓存历史 token,而是把历史压缩进一组快速权重。设第 t t t 个 token 为 x t x_t xt,层内的小模型为 f f f,其参数就是快速权重 W t W_t Wt,则每个 token 触发两个操作。第一步是更新:对自监督损失 ℓ \ell ℓ 做一次梯度步,把 token 写进权重;第二步是应用:用更新后的模型把 token 映射成输出。
W t = W t − 1 − η ∇ W ℓ ( W t − 1 ; x t ) , o t = f ( x t ; W t ) W_t = W_{t-1} - \eta \, \nabla_W \ell(W_{t-1}; x_t), \qquad o_t = f(x_t; W_t) Wt=Wt−1−η∇Wℓ(Wt−1;xt),ot=f(xt;Wt)
其中 η \eta η 是内循环学习率, ℓ \ell ℓ 通常是重构损失——例如让 W W W 重建刚刚收到的那个 token x t x_t xt,从而把 token 里的信息以梯度的形式写进快速权重。更新后的权重 W t W_t Wt 携带了整个历史的信息,因此任意长的历史都以固定的成本被条件化。这意味着历史被压缩进权重,而不是被缓存成一份不断增长的 token 列表;缓存大小恒定,是这套机制在工程上最值钱的一点。
3.2 训练与推理的关键不对称
这里要厘清一个常见误解:TTT 不是在测试时才突然开始训练。它有两层循环。外层是普通的监督学习,学习的是快速权重的初始化 W 0 W_0 W0 与内循环的元参数(学习率、投影矩阵),这是通过"梯度的梯度"完成的元学习(meta-learning)。内层则是在每一条序列的前向过程中原地更新 W 0 W_0 W0 得到 W t W_t Wt。因此训练时更新、推理时也更新,不同的是推理时的快速权重没有监督信号,只有自监督损失;而外层参数 W 0 W_0 W0 一旦训好就冻结。这意味着 TTT 层在部署后性能不降反升,因为它在读测试数据的过程中持续微调自己。
直觉理解:把快速权重想成一位能在考试时翻资料的考生。外层训练给了他一肚子"怎么学习"的能力(这是元学习),考试时他每看一道题就把答案要点用便签写进脑子里,越做越顺。自注意力则像把所有题面复印一份摊开在桌上,题越多桌子越占地方。
4. TTT-Linear:快速权重做成线性模型
4.1 线性模型作为隐藏状态
TTT-Linear 的隐藏状态是一个线性模型 f ( W , x ) = W x + b f(W,x) = W x + b f(W,x)=Wx+b,参数 W W W 与偏置 b b b 用矩阵表示。直观理解是, W t W_t Wt 由一整段历史加权组合而成,因此天然承载跨 token 的信息。为了让单步梯度更新在长序列上可行,论文把每条序列切成若干 mini-batch,在每个 mini-batch 内对所有 token 的损失做一次只读的梯度平均,再一次性更新权重。mini-batch 之外还引入归一化,把 ℓ \ell ℓ 的二阶信息(loss 的 L2 曲率)考虑进来,使学习率更稳。
难点提示(mini-batch 梯度是怎么回事):普通 TTT 是"来一个 token 就更新一次",梯度每步都变,数值不稳且耗时。TTT-Linear 的做法类似批量梯度下降——攒够一个小批次后再更新,一次 mini-batch 内所有 token 共享同一个 W W W,只在批末尾把梯度累加后应用。这牺牲了逐 token 的最优性,换来了稳定与可并行。
4.2 代码透视:内循环的双形式
下面是官方 PyTorch 实现里 TTT-Linear 的核心 ttt 方法,直接从 ttt-lm-pytorch 仓库抽出,保留了原有的变量名与注释。看它之前先记住三个量:W1 是被更新的快速权重,XV 是重构目标侧的投影,eta 是逐 token 的学习率,这三者构成内循环更新所需的输入。这里要厘清的是,ttt 这一个方法同时承担了"更新"与"应用"两个操作,它读入一组 token 后先算出重构梯度、再据此修正权重,最后用修正后的权重对 token 做一次前向——整个内循环就被这一层封装起来。
# ttt-lm-pytorch / ttt.py —— TTTLinear.ttt(节选)
def compute_mini_batch(params_dict, inputs):
    W1_init = params_dict["W1_states"]            # 当前 mini-batch 的快速权重
    b1_init = params_dict["b1_states"]
    XQ, XV, XK = inputs["XQ"], inputs["XV"], inputs["XK"]
    eta = inputs["eta"]                            # 每 token 学习率

    # 重构目标:用 (XV - XK) 作为自监督信号
    reconstruction_target = XV_mini_batch - XK_mini_batch
    Z1 = XK_mini_batch @ W1_init + b1_init         # 前向:线性模型
    # 对 Z1 求重构损失的梯度(含归一化层的二阶信息)
    grad_l_wrt_Z1 = ln_fused_l2_bwd(Z1, reconstruction_target, ln_weight, ln_bias)

    if use_dual_form:
        # 对偶形式:把"逐 token 更新"合并成矩阵乘,一次算出整批输出
        Attn1 = torch.tril(XQ_mini_batch @ X1.transpose(-2, -1))
        W1_last = W1_init - (last_eta_mini_batch * X1).transpose(-1, -2) @ grad_l_wrt_Z1
        b1_last = b1_init - torch.sum(last_eta_mini_batch * grad_l_wrt_Z1, dim=-2, keepdim=True)
    return ...
这段代码交代了 TTT 内循环的三件事。首先是自监督信号的构造:用
X
V
−
X
K
X_V - X_K
XV−XK 作重构目标,而不是直接用原始 token,这让损失对输入表征有梯度可导。其次是归一化层带来的二阶项 ln_fused_l2_bwd,它把
ℓ
\ell
ℓ 的 L2 曲率融进梯度,相当于给学习率做了自适应缩放,使更新在输入分布变化时依旧稳定。最后是 use_dual_form 这个分支:当 mini-batch 大小能整除设定值时走对偶形式,把"逐 token 更新再逐 token 前向"合并成若干矩阵乘法。这里是值得注意的工程细节——对偶形式并不改变计算结果,只是把原本串行的更新重排成可并行的高效矩阵运算,这正是官方实现里 TTT-Linear 能追上自注意力速度的关键。
4.3 TTT-MLP 与 TTT-Linear 的取舍
TTT-MLP 把线性模型换成两层 MLP,表达力更强,代价是每步更新与推理的计算量上去了;TTT-Linear 则用闭式近似的"快速权重"关系换来了可并行的矩阵乘。进一步看,两者的外层损失、元学习流程与部署逻辑完全一致,差异只在隐藏状态这个小模型的结构。TTT-Linear 的 W W W 是一个矩阵,更新规则有闭合形式;TTT-MLP 则需要真的跑一次反向传播。下面是 W W W 与偏置 b b b 的初始化——这一小段代码决定了快速权重的起点。
# ttt-lm-pytorch / ttt.py —— TTTLinear 快速权重初始化(节选)
class TTTLinear(TTTBase):
    def __init__(self, config: TTTConfig, layer_idx: Optional[int] = None):
        super().__init__(config, layer_idx)
        # W1: [num_heads, head_dim, head_dim] 的线性模型权重(快速权重主体)
        self.W1 = nn.Parameter(torch.normal(0, 0.02, size=(self.num_heads, self.head_dim, self.head_dim)))
        # b1: [num_heads, 1, head_dim] 的偏置,随头分组存储
        self.b1 = nn.Parameter(torch.zeros(self.num_heads, 1, self.head_dim))
这里的关键是
W
1
W_1
W1 的维度选择:它把隐藏状态拆成
num_heads
\text{num\_heads}
num_heads 个头、每头一个
head_dim
×
head_dim
\text{head\_dim} \times \text{head\_dim}
head_dim×head_dim 的矩阵。这既保留了 Transformer 多头注意力的并行结构,又让更新规则可写成矩阵乘法,从而可利用 GPU 的矩阵核。
W
1
W_1
W1 用 torch.normal(0, 0.02) 作初始化的原因,是让快速权重从一个接近零的随机起点开始,再靠元学习在训练中把它塑造成能承载历史语义的结构。
5. 用代码走一遍完整模型:配置与调用
5.1 通过 HuggingFace 接口加载
官方 PyTorch 实现基于 HuggingFace Transformers,因此 TTT 模型与普通 Transformers 模型共用同一套 from_pretrained / generate 接口,不需要为 TTT 另写一套推理管线。下面这段调用直接取自 README 的快速开始,把它贴出来是为了让读者看到:从外部看,加载一个 TTT 模型与加载一个 LLaMA 模型在代码层面几乎没有差别。
# ttt-lm-pytorch —— 加载与生成(节选 README 快速开始)
from transformers import AutoTokenizer
from ttt import TTTForCausalLM, TTTConfig

configuration = TTTConfig()          # 默认即 ttt-1b 风格
model = TTTForCausalLM(configuration).eval()
tokenizer = AutoTokenizer.from_pretrained("meta-llama/Llama-2-7b-hf")

input_ids = tokenizer("Greeting from TTT!", return_tensors="pt").input_ids
logits = model(input_ids=input_ids)
out_ids = model.generate(input_ids=input_ids, max_length=50)
这段调用看似与普通 LM 无异,内里却有根本差异。generate 是自回归逐 token 解码,而 TTT 层的快速权重
W
t
W_t
Wt 会在解码过程中被持续更新——也就是说,读入一个 token 会改变后续所有 token 的输出分布。直接理解是,推理时的缓存不再是单纯的 KV 缓存,还多了一份权重状态;同时这也意味着 generate 的性能会随时间改善,因为模型在不断"学习"刚读入的内容。
5.2 推理时的缓存与预填充
TTT 层在外推(decoding)阶段只做单 token 更新,因此需要一个缓存把上一时间步的快速权重带进当前步。官方实现里 TTTCache 保存的就是这份状态。进一步看,预填充(prefill)与逐 token 解码在 ttt 方法里走了不同的分支:prefill 用对偶形式一次性处理整段前缀,解码则走单步更新路径。这个不对称设计与 Transformer 的 KV cache 思路一脉相承,但缓存的对象从"中间的键值"变成了"一个小模型的权重"。
工程价值:把缓存对象从 KV 换成权重,换来的是内存不随序列长度增长。自注意力的 KV 缓存长度等于已读 token 数,TTT 的权重状态则是固定大小的矩阵,这正是它能把上下文推到 8K 乃至更长而内存预算不变的工程基础。
6. 训练目标:两层循环与梯度对齐
6.1 外层元学习与内层 TTT
TTT 的训练目标是元学习式的:期望内循环用监督或自监督损失更新 W 0 W_0 W0 后,得到的主任务损失能被最小化。形式化地,外层损失反映的是"更新后的模型在任务上的表现"——也就是说,外层训练要在把内循环跑完之后的权重 W W W 上去计算主任务损失,而不是在原始的 W 0 W_0 W0 上计算。
L meta = E ( x , y ) L task ( f ( x ; W 0 − η ∇ W ℓ ( W 0 ; x ) ) , y ) \mathcal{L}_{\text{meta}} = \mathbb{E}_{(x,y)} \; \mathcal{L}_{\text{task}}\Big( f\big(x; \; W_0 - \eta \nabla_W \ell(W_0; x) \big),\; y \Big) Lmeta=E(x,y)Ltask(f(x;W0−η∇Wℓ(W0;x)),y)
其中 L task \mathcal{L}_{\text{task}} Ltask 是主任务损失,衡量的是"用更新后的权重 W = W 0 − η ∇ W ℓ ( W 0 ; x ) W = W_0 - \eta \nabla_W \ell(W_0; x) W=W0−η∇Wℓ(W0;x) 去预测标签 y y y 的误差"; W 0 W_0 W0 是要被元学习的初始化, η \eta η 是内循环学习率, ℓ ( W 0 ; x ) \ell(W_0;x) ℓ(W0;x) 是自监督损失。训练时对 W 0 W_0 W0 求梯度,需要穿过一次内循环更新,于是出现二阶梯度——这正是元学习里"梯度的梯度",也是这套机制在实现上最耗算力的地方:它要求把内循环完整跑一遍并保存其计算图。
6.2 梯度对齐:为什么自监督更新能帮主任务
一个理论上的关键结论是梯度对齐条件:若主任务损失梯度 ∇ θ L task \nabla_\theta \mathcal{L}_{\text{task}} ∇θLtask 与自监督损失梯度 ∇ θ L aux \nabla_\theta \mathcal{L}_{\text{aux}} ∇θLaux 的内积为正,那么在凸性与光滑性假设下,朝自监督方向走一步会单调降低主任务损失。换句话说,这个条件把"测试时更新到底有没有用"从经验判断变成了一个可检验的几何条件——梯度方向是否对齐,决定了自监督更新是助力还是阻力。
⟨ ∇ θ L task , ∇ θ L aux ⟩ > 0 ⟹ 一次自监督步 ⇒ L task 下降 \langle \nabla_\theta \mathcal{L}_{\text{task}} ,\; \nabla_\theta \mathcal{L}_{\text{aux}} \rangle > 0 \;\Longrightarrow\; \text{一次自监督步 } \Rightarrow \mathcal{L}_{\text{task}} \text{ 下降} ⟨∇θLtask,∇θLaux⟩>0⟹一次自监督步 ⇒Ltask 下降
这个条件解释了 TTT 为什么有效:只要辅助与主任务的梯度方向大体一致,测试时的自监督更新就在"顺水推舟"。它同时也暴露了 TTT 的局限——当分布偏移极端到自监督与主任务梯度反向时,测试时更新反而可能损害性能。应对手段是给内循环加正则(如特征对齐、矩匹配),在不重访训练数据的前提下约束自适应幅度。进一步看,这个偏置-方差框架也解释了为什么单步内循环更新(而非多步)往往是默认选择:每多一次更新,误差的方差就累积一分,而收益却早早饱和。
难点提示(偏置-方差取舍):TTT 在测试时更新参数,本质是在用"更新的方差"换"分布的偏置"——它把模型朝测试样本方向挪,缩短源分布与目标分布的差距,但挪过头就引入噪声。正则项就是控制这个挪动幅度的限位器。
7. 推理时的执行模块
7.1 训练 forward 与推理 decode 的差异
TTT 层的 forward 在训练与推理阶段行为一致,都是"更新 + 应用"。差异在缓存与梯度:训练时通过 last_mini_batch_params_dict 把上一步的权重状态传入 ttt,并通过截断的反向传播(TBPTT)把梯度限制在固定段内;推理时则通过 cache_params 传递,只做前向更新。官方实现里的 ttt 方法开头用 if last_mini_batch_params_dict is None and cache_params is not None 判断当前是解码阶段,从而决定取哪份状态——这正是训练与推理共用同一段内循环代码的关键。
7.2 解码时的单步更新
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献160条内容

所有评论(0)