RL2-VLA:在 VLA 潜变量上做强化学习,让测试时 steering 只在失败时开启
0. 简介
RL2-VLA(Reinforcement Learning on Vision-Language-Action Latents) 面向视觉-语言-动作模型(VLA)在域外(Out-of-Domain,OOD)指令与环境下的性能衰退问题。它的切入点是测试时增强:不重新训练基础 VLA,而是保留一个冻结的 VLA action expert,再用一个条件在该 VLA 内部潜变量上的轻量强化学习 steering 策略,去改变动作候选分布。论文的核心判断是,steering 并非在所有时刻都有益——当基础策略本身很可能成功时,过度扰动反而会让已准确的动作出错,因此需要一套"什么时候该介入"的机制。项目主页:https://rl2-vla.github.io/ ,对应的官方代码在:https://github.com/marmotlab/RL2-VLA
1. 研究问题与现有方法的缺口
1.1 多采样为什么可能只是在重复失败
VLA 的测试时扩展,一个很自然的思路是"多采样 + 验证"。同一个语言指令下多次采样,或者把指令改写成一串 rephrase 再采样,得到一批候选动作,然后交给一个 verifier 去排序、选出最优。这个思路的隐含前提是:基础策略的动作分布里已经存在成功解,只是单次采样没抽中,多采几次总能碰上一个好的。
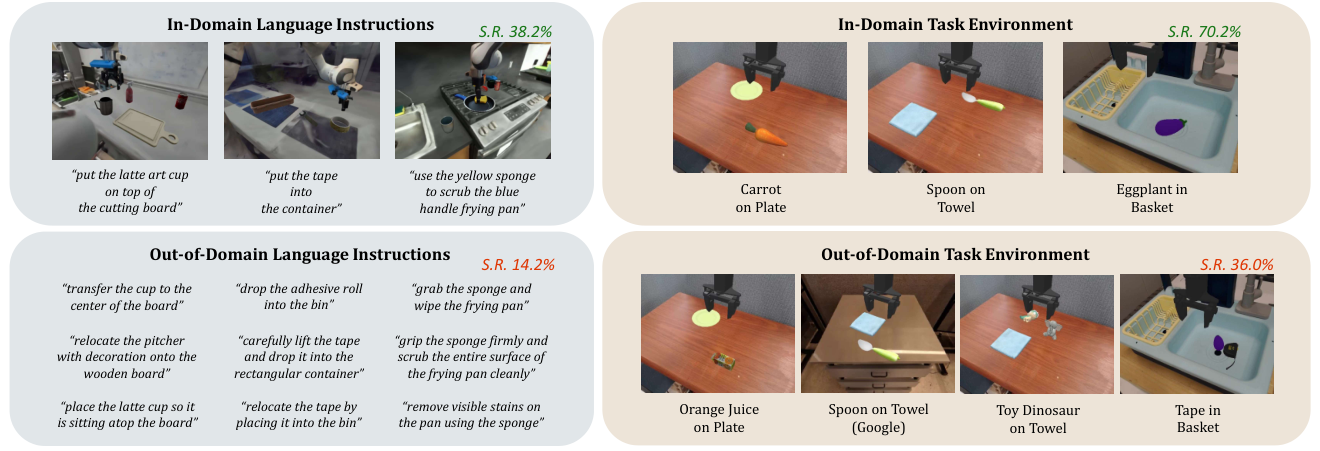
这个前提在域外场景里往往不成立。论文在 BridgeV2 验证集上做离线分析时观察到的现象很典型:当基础 VLA 因为陌生物体、背景变化或干扰物而落入失败模式时,它采样出来的多个候选动作并不是"互相独立的好解",而是同一个失败轨迹的轻微扰动——候选全都朝错误物体偏,或者抓取点集中在同一个错误区域。此时 rephrase 改写语言指令,改动的是文本侧面,视觉-动作对齐层面的系统性错误没有改变,多采样只是在成倍地复制同一个错误。这里的关键是,候选池的内部多样性(intrinsic diversity)不足,数量再多也带不来新解。
1.2 现有测试时增强路线的三个分支
把现有的 VLA 测试时增强方法归拢一下,大致落在三条线上。这三条线分别从候选选择、生成引导、输出精修三个不同侧面切入,各有各的优劣,也各有各的适用场景。下面依次展开,并在最后给出这三条线与 RL2-VLA 本身的位置关系——这一节的目的是给读者一条坐标,让他们在看到一个具体方法时,能判断它处在"只选候选"、"直接改生成"还是"改输出"的哪个位置。
第一条是离散动作选择。方法生成一批候选动作,再用外部 verifier 挑最优,代表工作有 V-GPS(用 learned value function 排序)、RoboMonkey(用偏好学习训练的大 VLM verifier)、CoVer(用对比学习训练的 verifier)、FOREWARN(在 verifier 之外加 world-model rollout)。这类方法的优点是保留了基础策略从大规模示范里学到的强行为先验,缺点是候选全部来自同一策略分布,一旦分布本身偏了,选择范围就被锁死,无法突破到分布外。
第二条是可微 steering(differentiable steering)。它不去挑候选,而是直接用一个连续引导信号去改动作生成过程,代表工作有 DynaGuide(用 world model 预测未来 latent 并按引导目标 steer)、VLS(用 VLM 打分函数引导去噪)、VLA-Pilot(同样用 VLM 引导)。这类方法能把策略推到原有分布之外,但依赖外部引导模型——预训练 VLM 的物理落地能力有限,world model 本身有预测误差和不少推理开销。
第三条是直接动作精炼。用轻量辅助策略去改基础 VLA 的输出,代表有 ConRFT(冻结 VLA 编码器、用 consistency 式 RL 目标改动作头)、Policy Decorator(学一个残差策略输出修正偏移)、DSRL(用 RL 去 steer diffusion policy 的噪声输入)、RLT(学紧凑 token 供 RL 策略用)等。这些方法的代价是通常需要在线交互、真实环境或高保真仿真,部署成本不低。
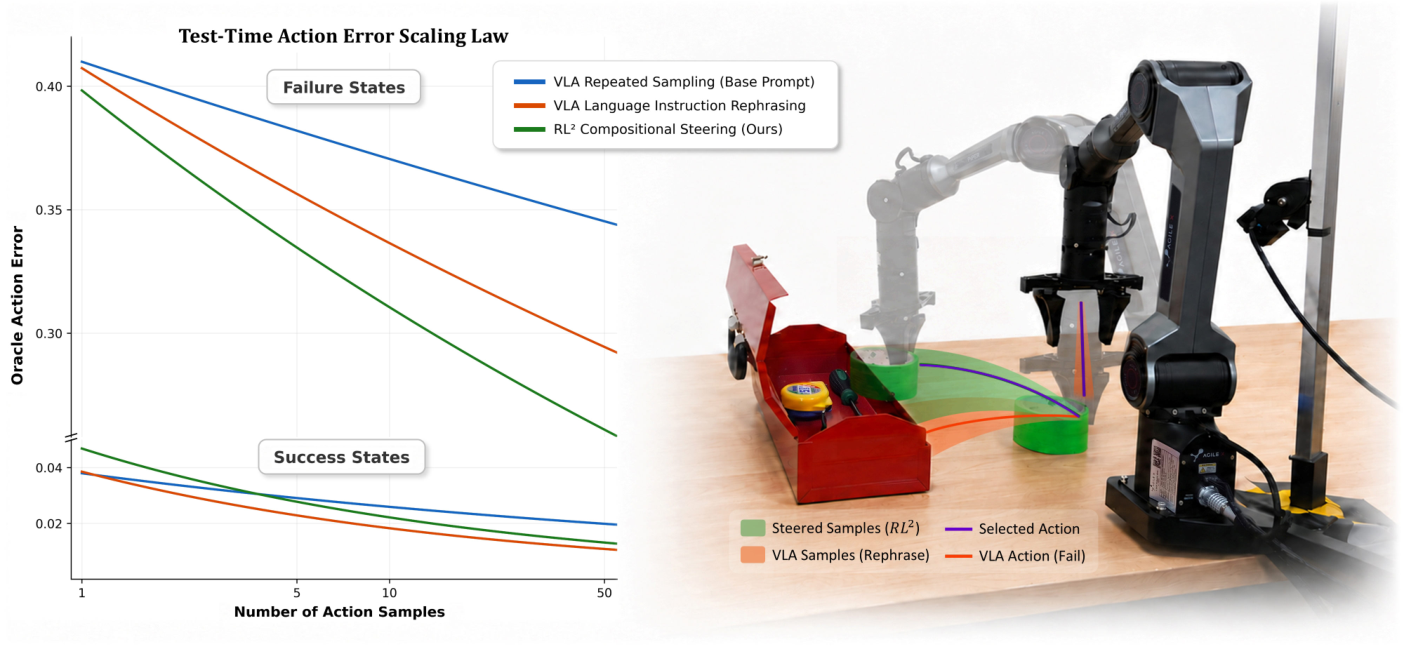
RL2-VLA 的位置是这三条线的一个交叉:它既做离散选择(保留 verifier 挑最终动作),又做可微 steering(用 RL 策略的 velocity 去组合 VLA 的 velocity),同时把两者都限定在"只在失败时"这一前提下。直接顺着这三类方法各自的短板去构造,就能看出它为什么需要这套组合。这里的差异点,恰恰是它核心判断的来源——"是否介入"与"如何介入"是两个独立的维度,二者都决定性能。
2. 整体框架
2.1 输入输出接口与三模块分工
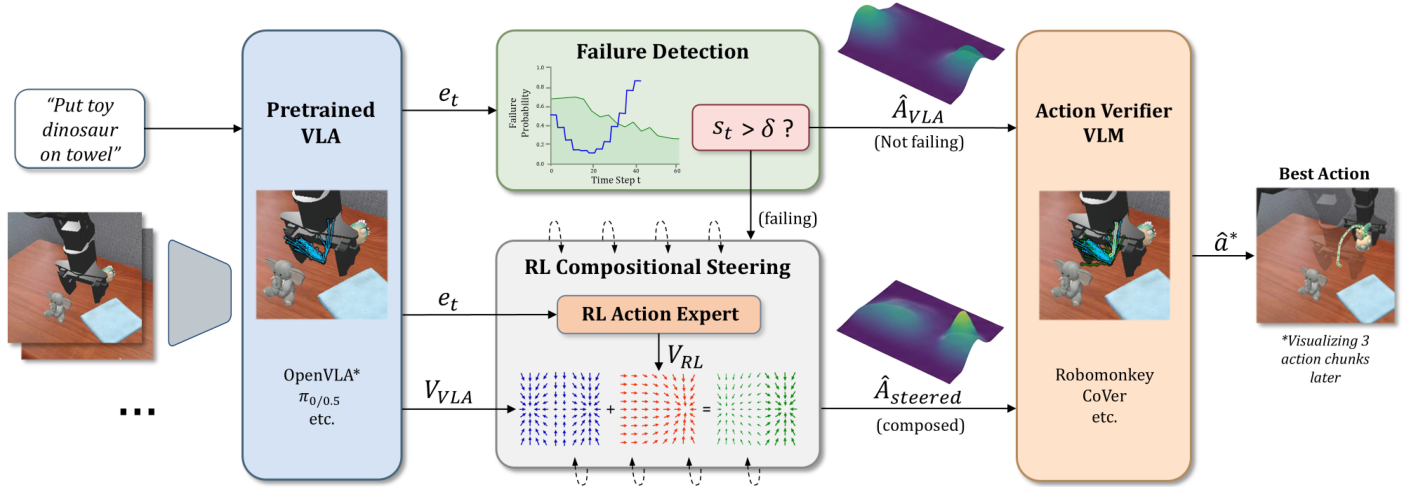
整套 RL2-VLA 在推理时挂在一个冻结的 VLA action expert 旁边,输入是当前观测与语言指令,输出是当前时间步要执行的动作。它的关键不对称在于,基础 VLA 始终不变,三条新通道是围绕它的内部表征展开的:一条从 action expert 抽取潜变量 e t e_t et,一条用 e t e_t et 训练一个轻量 RL flow-matching steering 策略,一条用 e t e_t et 训练 failure detector。
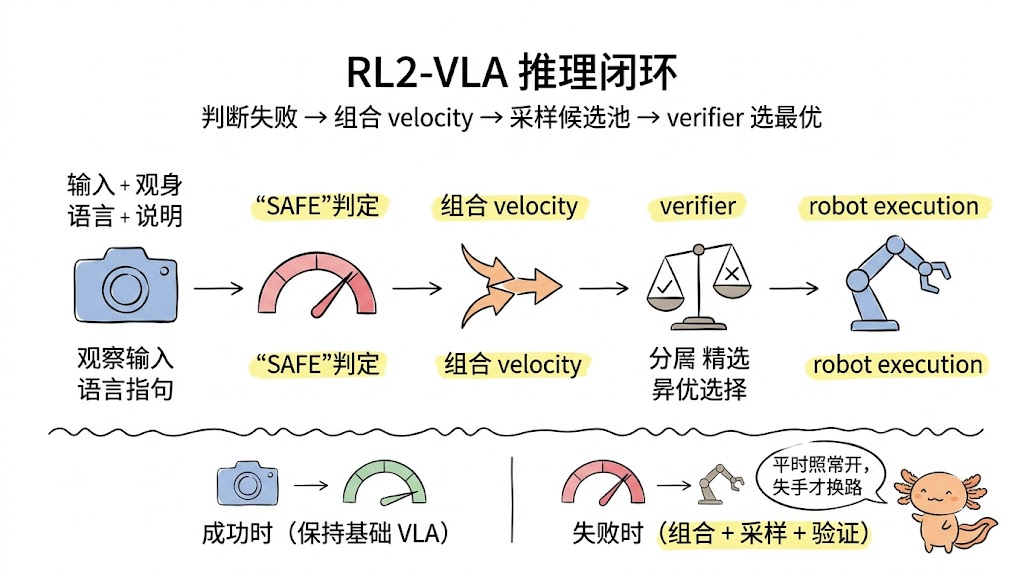
具体到每个模块的输入输出:SAFE 收到的是截至当前时间步的 VLA 特征序列 e 0 : t e_{0:t} e0:t,输出一个失败分数 s t ∈ [ 0 , 1 ] s_t \in [0,1] st∈[0,1];RL steering policy 收到的是 e t e_t et(以及 flow-matching 过程里的噪声样本与进度),输出一个引导 velocity v R L v_{\mathrm{RL}} vRL;verifier 收到的是观测、候选动作集合与语言指令,给每个候选打一个分。整个链路是"判断失败 → 组合 velocity → 采样候选池 → verifier 选优 → 执行"五步。
引入 v V L A v_{\mathrm{VLA}} vVLA(VLA 的 flow-matching velocity)与 v R L v_{\mathrm{RL}} vRL(RL 策略输出的 steering velocity):二者都是定义在动作空间上的速度场,都沿"从噪声到动作"的 ODE 行进,区别只在训练来源——一个来自大规模示范模仿学习,一个来自离线 RL。把它们按权重做加权平均,就得到一条组合后的速度场,也就是 RL2-VLA 的核心产物:
v c o m p = w ⋅ v V L A + ( 1 − w ) ⋅ v R L , w ∼ N ( μ = 0.5 , σ = 0.25 ) v_{\mathrm{comp}} = w \cdot v_{\mathrm{VLA}} + (1 - w) \cdot v_{\mathrm{RL}}, \qquad w \sim \mathcal{N}(\mu=0.5,\, \sigma=0.25) vcomp=w⋅vVLA+(1−w)⋅vRL,w∼N(μ=0.5,σ=0.25)
其中 w w w 是组合权重,从一个高斯分布里抽取、再截断到 [ 0 , 1 ] [0,1] [0,1]。直观理解是:每个候选动作都以不同比例借用了"示范先验"(VLA)和"多样性扰动"(RL),让候选池在两者之间有一个连续分布,而不是在两端做二元选择。这样得到的候选池,既有贴近示范的"稳妥解",也有偏离示范的"大胆解",为下游 verifier 提供了更宽的挑选空间——这正是它区别于"同一策略重复采样"的关键。
2.2 训练与推理的关键不对称
这里要讲清楚一个容易混淆的地方:RL2-VLA 更新的是辅助模块,不是基础模型。训练阶段要动两个东西——RL steering 策略和 SAFE failure detector;VLA 本体、verifier 都冻结不动。这决定了它的代价边界:重训一个大型 VLA 的成本(更新全部参数、维持训练稳定、需要大量算力)被规避了,但辅助模块的训练、失败检测器的部署适配没有被省略。
更进一步看,训练与推理还有一个角色上的不对称:SAFE 在训练时要用 rollout 数据去学"什么样算失败",这套数据如果来自仿真而目标平台是真实机器人,往往不能直接复用。论文在真机实验中明确报告,仿真训练的 SAFE 无法直接泛化到 PiperX 场景,必须重新采集真实 rollout。这意味着,"冻结基础 VLA"降低的是重训大模型的成本,而不是消除目标平台的数据收集和适配。这是理解整套方法"到底省了什么、没省什么"的关键边界。
3. 第一条核心机制:在 VLA 潜变量上做强化学习
3.1 一条轻量 RL 策略,条件在 VLA 的 latent 上
RL2-VLA 的 steering 策略不是从头学一个机器人控制策略,而是一个条件在 VLA action expert 内部表征上的轻量 flow-matching 策略。它的作用不是直接输出最终动作,而是输出一个引导信号,把冻结 VLA 的动作分布往"更多样、更高价值"的方向推。换句话说,这个策略扮演的是"候选生成阶段的辅助定位器",它不负责理解世界,只负责在已经理解世界的表征旁边,提供一组"值得一试的新方向"。正因为它不做’理解’这件事,才能做得足够轻。
为什么条件在 latent 而不是原始观测上?这是整套方法的一个关键取舍。VLA action expert 的潜变量里已经编码了视觉、语言与动作相关的表征,RL 策略不需要从零重建"如何理解图像、如何对齐语言"这一整套结构,只需学会在已有动作空间附近做有效偏移。论文的消融给出的数字很直观:在 OpenVLA 设置里,用 VLA latent 的 RL 达到 39.3%,不用 latent 的 RL 只有 0.5%。差距悬殊,说明 latent 提供了 steering 所依赖的表征基础。公平地说,这项消融同时改变了条件输入与训练难度,论文自己也指出无 latent 的视觉策略训练非常困难,因此更稳妥的判断是"VLA latent 为轻量 RL steering 提供了关键表征基础",而不是把 39.3 与 0.5 的全部差距都归因于单一 latent 特征。
在实现上,这个 RL 策略要在离线数据集上训练,训练数据不是原始观测,而是"观测 + 动作 + 指令 + latent"。遍历数据集每个样本,把观测送进冻结 VLA,抽出嵌入,构成带 latent 的增广数据集。training 侧一个值得注意的工程细节是,数据集用的是与基础 VLA 相同的离线微调数据(BridgeV2、DROID),而不是新采集的数据,这也是它能保持开销可控的原因之一。
3.2 关键取舍:RL 而非行为克隆
这里值得单独拎出来一个对比:为什么用 RL 训练 steering 策略,而不是用行为克隆(Behavior Cloning,BC)?论文在 π 0 \pi_0 π0 与 π 0.5 \pi_{0.5} π0.5 上做了 ablation,把训练配方从 RL 改成 BC,结果 RL 始终优于 BC,最高约 +4.5 个百分点。原因在于,BC 学到的是示范里最主流的动作模式,而 RL 的目标是发现示范之外的高价值新行为,能引入超越主导示范模式的多样性。换句话说,BC 强化"跟随示范",RL 在示范之外引入"多样性",二者在 steering 任务里价值不同。这里要做个澄清:RL2-VLA 用的不是需要在线交互的 RL,而是 offline RL,这也进一步压低了部署成本。
3.3 模块间接口:统一的策略抽象
官方仓库目前公开的部分把各个策略抽成了统一的接口,任何能做成策略的模块(基础 VLA、RL steering、组合后的策略)都实现同一个抽象类。这样做的目的是让下游系统在接入时无需关心背后到底是纯 VLA、带 steering 的 RL2-VLA,还是其它变体,只要符合统一的 infer/reset 契约即可。下面这段是官方仓库里真实存在的文件,它定义了这套契约的最小形态。
# INT-ACT/packages/policy-server-client/src/policy_server_client/base_policy.py
import abc


class BasePolicy(abc.ABC):
    @abc.abstractmethod
    def infer(self, obs: dict) -> dict:
        """Infer actions from observations."""
        raise NotImplementedError("infer() not implemented")

    @abc.abstractmethod
    def reset(self) -> None:
        """Reset the policy to its initial state."""
        raise NotImplementedError("reset() not implemented")
这段代码本身不长,但它揭示了 RL2-VLA 工程上的模块化思路:所有策略都挂在同一个 infer/reset 接口后面,基础 VLA、RL steering policy、以及组合后的策略都作为这个接口的实现出现。infer(obs) 给定观测返回动作,reset() 重置到初始状态。对下游系统来说,无论背后是纯 VLA 还是带 steering 的 RL2-VLA,调用方式都一样,这正是"modular"定位的体现。切换一个 verifier、换一个基础 VLA、或者把 steering 换成 always-on,都是在接口层面做替换,而不必重写整个链路。
工程价值:把基础策略、steering 策略、组合策略都收进同一个接口,实际部署时可以在"是否介入"这个维度上做 A/B,而不必改动机器人侧的调用代码。这也是论文反复强调 modularity 的落点。
4. 第二条核心机制:velocity 组合实现可微 steering
4.1 为什么用 velocity 组合,而不是重采样
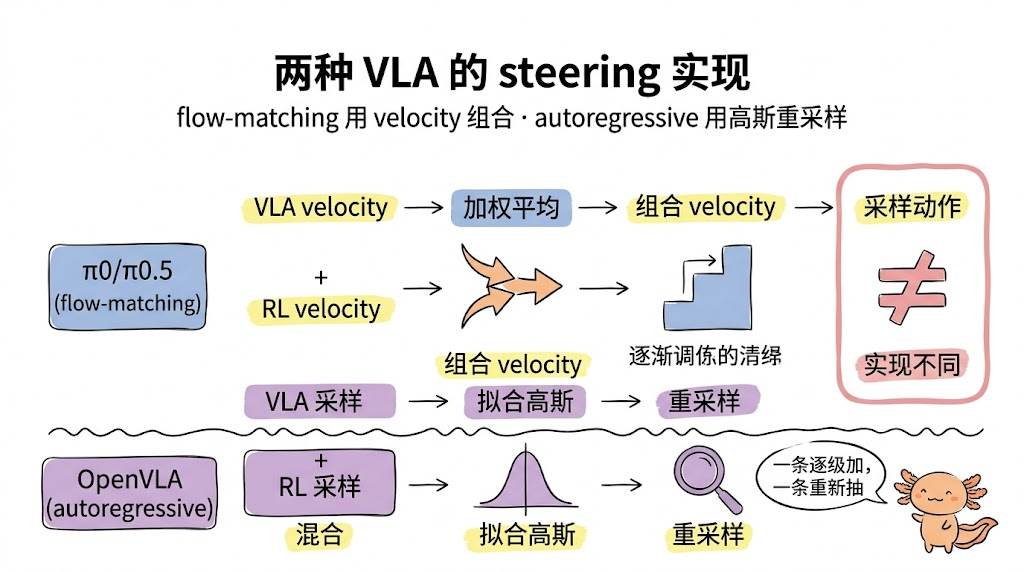
对 flow-matching 类 VLA( π 0 \pi_0 π0、 π 0.5 \pi_{0.5} π0.5),动作生成由一条 velocity field 控制。RL2-VLA 的 steering 不改变 VLA 的采样分布,而是逐 flow-matching step 把 RL 策略的 velocity 与 VLA 的 velocity 做加权平均,得到一条组合 velocity,再沿它一步推下去。这里的关键是,组合发生在连续的速度场层面,因此每一步都能同时借用 VLA 的示范先验与 RL 的多样性,生成的动作候选既不是纯示范复制,也不是纯 RL 发散。
需要强调的是,这套 flow velocity 组合只准确描述 π 0 \pi_0 π0 与 π 0.5 \pi_{0.5} π0.5 的实现。OpenVLA 是自回归动作模型,不能直接用同样的 velocity 组合,论文改用另一套处理:分别从 VLA 与 RL 采样动作,把两组候选混合,对混合动作拟合一个高斯分布,再从拟合分布里重新采样一个更大的动作批次。所以"组合 flow velocity"是一个能概括 π 0 \pi_0 π0 家族的说法,不能泛化到所有 VLA。这一差异是阅读论文时最容易误读的一点。
4.2 组合 velocity 的采样流程
官方仓库里这个流程有完整实现。下面这段直接取自 RL2_CoVer_VLA/simpler/rl2_utils.py 的 get_composed_actions,其中 pi0_policy 是冻结的基础 VLA,qam 是 RL steering 策略,w 是组合权重数组。读者可以顺着这段真实代码看到:先对观测跑一次 forward_pass_vlm 拿到条件态,再采样噪声动作,然后在同一个 flow-matching 循环里逐 step 计算 VLA 与 QAM 两个 velocity 并进行加权,最后反归一化输出动作块。
# 对噪声动作做 VLA + QAM 的 velocity 组合去噪
dt = -1.0 / pi0_policy.model.config.num_steps
time = torch.tensor(1.0)          # flow-matching 进度从 1 往 0
qam_t = 0
while time >= -dt / 2:
    vel_vla, _ = pi0_policy.model.denoise_step(
        _state, _prefix_pad_masks, _past_key_values,
        noisy_action_torch, time.expand(bsz),
    )
    vel_vla = vel_vla.detach().cpu().numpy()
    vel_qam = qam.get_denoising_vector(
        observation=hidden_states_np, noisy_action=noisy_action_jax, i=qam_t
    )
    # QAM 动作维度小于 VLA,用 VLA 补足后再组合
    vel_qam = np.concatenate([vel_qam, vel_vla[..., vel_qam.shape[-1]:]], axis=-1)
    noisy_action_np += (w * vel_vla - (1 - w) * vel_qam) * dt
    noisy_action_torch = torch.from_numpy(noisy_action_np).to(_state.device, _state.dtype)
    time += dt
    qam_t += 1
这段官方代码把论文 §V-B 的公式落成了可执行的循环。几个值得注意的工程细节:其一,w 在调用方 compute_composed_actions 里构造——若配置为 -1.0 就从
N
(
0.5
,
0.25
)
\mathcal{N}(0.5,0.25)
N(0.5,0.25) 抽取再裁剪到
[
0
,
1
]
[0,1]
[0,1],否则用固定权重;每次组合的权重因此可以逐样本不同。其二,noisy_action_np += (w * vel_vla - (1 - w) * vel_qam) * dt 这个更新式,对应论文里的加权 velocity 差分,步长 dt = -1/num_steps 决定了一次近似从噪声到动作推进多少。其三,VLA 的动作维度(含夹爪等被 pad 的维度)比 QAM 更大,代码用 np.concatenate 把 QAM 的 velocity 用 VLA 的尾部维度补足,否则两个向量无法逐元素相加。qam 的 observation 参数传的正是前面从 VLA action expert 抽出的隐状态 hidden_states_np,也就是 latent 条件。
而这套循环被谁调用、怎么决定走不走,要看 compute_composed_actions 的开头。它先解析组合权重,再按 rephrase 数 × 组合样本数构造批量,最后进入上面的去噪循环。其中 hidden_states_np 是前面从 VLA action expert 抽出的隐状态,task_list 是按唯一指令展开后的批量任务列表,w 则是已经解析好的组合权重数组——三者一旦就绪,整个去噪循环就只负责把"条件、噪声、权重"转成一份既含示范先验又含 RL 多样性的候选动作块:
# RL2_CoVer_VLA/simpler/rl2_utils.py  (compute_composed_actions, 节选)
w = cfg.merge_rel_weight                      # 组合权重
if w == -1.0:                                 # 权重采样模式
    w = np.random.normal(loc=0.5, scale=0.25, size=batch_size)
    w = np.clip(w, 0, 1)
    w = w[:, None, None]                      # (B, 1, 1)
else:
    w = np.ones(batch_size) * w
    w = w[:, None, None]

# 构造 unique 指令:原指令 + rephrase
if rephrased_list is not None and lang_rephrase_num > 1:
    unique_prompts = [task_description] + rephrased_list[:lang_rephrase_num - 1]
else:
    unique_prompts = [task_description]
这里的关键是 w == -1.0 这个哨兵:它把"用一个随机权重"和"用固定权重"统一成同一个入口。论文正文只写了从正态分布采权重,但实现里保留了一个固定权重的分支——这在消融"固定 w vs 随机 w"时很有用,也说明这套代码是围绕可复现的配置化评测设计的。unique_prompts 则决定了批量里每个 rephrase 各带多少组合样本:[原指令] + rephrase[:n-1],后面再按 composed_samples 重复展开,形如 [p]*composed_samples,从而形成 lang_rephrase_num × composed_samples 个候选的批量。
直觉理解:可以把 VLA 的 velocity 想成"最稳妥的常规开法",RL 的 velocity 想成"有人大胆指出另一条路"。平时只按常规开,一旦判断前方可能失手,就由旁座给出一个混合建议,让候选动作在"稳妥"与"大胆"之间拉开一个谱,再由一个评委(verifier)挑最优。难点就在于评委是否真的识货。
4.3 这条机制依赖什么
顺带说一句工程侧面。组合 velocity 的引入,让动作候选从"同策略的多采样"变成"跨策略的混合样本",这是它相对 Repeated/Rephrase 最本质的差异。但它依赖两个前提:一是 RL 策略确实能学到"到达任务对象"这类高价值偏移,而不是盲目发散;二是 verifier 能在混合后的候选池里认出真正更好的动作。论文的定性可视化(把 π 0 \pi_0 π0 在失败状态下的动作块做 PCA)显示,基础 VLA 的动作分布常偏离 ground truth 很远,steering 后分布明显向 ground truth 移动。这个可视化支撑了"RL 引入的是有效偏移而非纯噪声",但同时也说明,如果 verifier 识别失败,一切候选多样性的努力都会付诸东流。
5. 训练目标:三项机制背后的优化
5.1 RL steering 策略的匹配损失:QAM
训练一个 flow-matching actor-critic 网络,难点在于从 critic 的 Q ( s , a ) \mathrm{Q}(s,a) Q(s,a) 直接反向传播穿过策略的多步 flow-matching 过程,数值上不稳定。RL2-VLA 采用 QAM(Q-learning with Adjoint Matching),把不稳定的反向传播替换为稳定的逐点匹配目标,用一条穿返 ODE 计算的伴随状态 g ~ t \tilde{g}_t g~t 作为时间依赖的引导信号。
伴随状态从终态动作 a 1 a_1 a1 反着解一条 ODE 得到。这条 ODE 的物理含义是:把终态 Q 的梯度沿"时间反向"逐点传回每一个 flow-matching 步,从而为每个中间步提供一个局部、稳定的引导信号,替代直接对整条轨迹做反向传播——这正是 QAM 区别于朴素 flow Q-learning 的地方,也是它能避开数值不稳定的关键:
d g ~ t = − ∇ a t [ 2 f β ( s , a t , t ) − a t / t ] g ~ t d t , g ~ 1 = − τ ∇ a 1 Q ( s , a 1 ) d\tilde{g}_t = -\nabla_{a_t}\bigl[\,2 f_{\beta}(s,a_t,t) - a_t / t\,\bigr]\, \tilde{g}_t\, dt, \qquad \tilde{g}_1 = -\tau\,\nabla_{a_1} Q(s,a_1) dg~t=−∇at[2fβ(s,at,t)−at/t]g~tdt,g~1=−τ∇a1Q(s,a1)
其中 f β f_{\beta} fβ 是固定的行为先验, τ \tau τ 是逆温度, Q Q Q 是 critic。策略的目标 velocity field f θ f_{\theta} fθ 通过最小化匹配损失来对齐这个伴随信号。这里的关键是,匹配损失把"终态奖励"拆解成了每个时间步的局部对齐目标,从而让 policy 既能学到高价值行为,又能通过一个稳定的、一阶的优化路径去逼近它:
L A M ( θ ) = E s , { a t } ∫ 0 1 ∥ 2 ( f θ ( s , a t , t ) − f β ( s , a t , t ) ) σ t + σ t g ~ t ∥ 2 2 d t \mathcal{L}_{\mathrm{AM}}(\theta) = \mathbb{E}_{s,\{a_t\}} \int_0^1 \bigl\| \tfrac{2\bigl(f_{\theta}(s,a_t,t)-f_{\beta}(s,a_t,t)\bigr)}{\sigma_t} + \sigma_t\, \tilde{g}_t \bigr\|_2^2 \, dt LAM(θ)=Es,{at}∫01 σt2(fθ(s,at,t)−fβ(s,at,t))+σtg~t 22dt
其中噪声调度 σ t = 2 ( 1 − t ) / t \sigma_t = \sqrt{2(1-t)/t} σt=2(1−t)/t。这条损失确保策略收敛到行为正则化的最优分布 π ( a ∣ s ) ∝ π β ( a ∣ s ) exp ( τ Q ( s , a ) ) \pi(a\,|\,s) \propto \pi_{\beta}(a\,|\,s)\exp(\tau Q(s,a)) π(a∣s)∝πβ(a∣s)exp(τQ(s,a)),同时保持完整表达能力。这里的关键是,QAM 提供了一条稳定的、一阶的优化路径,避免了直接 Q 反向传播通过 flow 过程的不稳定问题。实践里作者发现,仅仅调整逆温度 τ \tau τ 就能在行为克隆基线上取得提升,无需繁琐地调其它超参。
难点提示(QAM 到底解决了什么):直接让高维 Q 值去"推"一个多步 flow 的每个中间样本,梯度会经过一条很长的路径,数值上容易爆炸或消失。QAM 的巧思是绕开这条长路径,先在终态算出 Q 的梯度,再反着沿一条 ODE 把它"传"回每一个时间步,让每个步都能拿到一个局部、稳定的引导信号。拿长途送货做类比:与其让司机每一段都看着终点算最优路线,不如先在终点算好误差,再沿来路把"怎么走更好"逐段传回。
5.2 SAFE 失败检测器的二分类损失
SAFE 是一个轻量的多任务失败检测器,条件在 VLA 内部特征上,用 LSTM 逐时间步输出失败分数。它同样要用 VLA latent 作条件,训练用二分类交叉熵损失,目标是把"这条轨迹接下来会不会失败"压成一个可解释的概率值。这个概率不用于修正动作,只用于判定要不要触发 steering,因此它的训练数据必须包含真实的成功与失败轨迹,而不能只用成功轨迹。
L B C E = ∑ i ∑ t [ y i log s t + ( 1 − y i ) log ( 1 − s t ) ] \mathcal{L}_{\mathrm{BCE}} = \sum_i \sum_t \bigl[ y_i \log s_t + (1-y_i)\log(1-s_t) \bigr] LBCE=i∑t∑[yilogst+(1−yi)log(1−st)]
其中 y i ∈ { 0 , 1 } y_i \in \{0,1\} yi∈{0,1} 是第 i i i 个 rollout 是否成功。给定 VLA 特征序列 e 0 : t e_{0:t} e0:t,LSTM 输出当前时间步的失败概率 s t ∈ [ 0 , 1 ] s_t \in [0,1] st∈[0,1],正是这个分数决定是否触发 steering。数据上,SAFE 需要每个任务采集 rollout(论文设置每 seed 100 条、3 个随机种子),按 60%/40% 划分训练/验证。这再次印证一个边界:SAFE 的部署不是零数据,它需要目标任务的失败/成功轨迹。
5.3 一条潜在的反直觉权衡
这里的损失装配里,最容易被忽略的是 QAM 与 SAFE 的任务分工:二者都吃 VLA latent,但一个是"往哪个动作方向偏移",一个是"要不要偏移"。它们共享同一套表征,却各司其职,这解释了为什么 latent 的聚合方式(First / Last / Mean / Concat)对它们都重要——论文里为不同 VLA 分别挑了不同的聚合方式。一个反直觉的点在于,QAM 的标准训练只用了带终态奖励的匹配损失,却能达到超出行为克隆的效果,说明**"步级匹配"本身携带了足够的策略改进信号**,而这一点在只读论文引言时很容易被低估。
6. 训练与推理的执行模块
6.1 训练侧:带 VLA 隐变量提取的增广数据集
RL 策略与 SAFE 使用的 latent,来自冻结 VLA action expert。训练这样一个策略,第一步不是建模型,而是把离线数据集"改造"成带 latent 的形式。具体做法是遍历数据集每一个 episode,把观测喂给固定 VLA,抽出嵌入,再连同原始观测、动作与指令一起打包成新的训练样本。下面是官方仓库里真实存在的数据集处理脚本(INT-ACT/scripts/dataset/modify_rlds_dataset.py)的完整开源主体,它通过"模型函数"(mods)逐段改写 TFDS 数据集:
# INT-ACT/scripts/dataset/modify_rlds_dataset.py(官方仓库,节选)
def mod_dataset_generator(builder, split, mods) -> tf.data.Dataset:
    """Modifies dataset features."""
    ds = builder.as_dataset(split=split)
    for mod in mods:
        ds = TFDS_MOD_FUNCTIONS[mod].mod_dataset(ds)
    for episode in tfds.core.dataset_utils.as_numpy(ds):
        yield episode

def main(args):
    builder = tfds.builder(args.dataset, data_dir=args.data_dir)
    features = mod_features(args.mods, builder.info.features)
    mod_dataset_builder = MultiThreadedAdhocDatasetBuilder(
        name=args.dataset, version=builder.version, features=features,
        split_datasets={split: builder.info.splits[split] for split in builder.info.splits},
        config=builder.builder_config, data_dir=args.target_dir,
        description=builder.info.description,
        generator_fcn=partial(mod_dataset_generator, builder=builder, mods=args.mods),
        n_workers=args.n_workers,
        max_episodes_in_memory=args.max_episodes_in_memory,
    )
    mod_dataset_builder.download_and_prepare()

if __name__ == "__main__":
    # --dataset --data_dir --target_dir --mods resize_and_jpeg_encode ...
    main(parser.parse_args())
这段代码透露了工程实现上的两个务实选择。其一,它修改的是现成的 RLDS 数据集(Robot Learning Dataset Suite 格式),按 --mods 挂上不同的 mod 函数逐段改写;MultiThreadedAdhocDatasetBuilder 支持多线程 --n_workers 与有限的内存驻留,说明这套处理是面向大数目 episode 的工程化配置,而不是一次几百样本的玩具流程。其二,脚本强制 args.data_dir != args.target_dir,即原始数据目录与目标目录不许相同,避免改写过程覆写原始数据。真正为 RL 策略准备 latent 的增广,是在下游 extract_hidden_states_and_actions.py 里对每个 episode 抽 VLA 隐状态完成——所以这个脚本本身只负责"搬运 + 清洗",把嵌入抽取交给更专用的模块,避免在通用的 TFDS 改写层耦合进模型推理。真正需要新数据的,是 SAFE 的失败轨迹,二者成本边界在这里划开了。
6.2 推理侧:三模块各付什么时间成本
…详情请参照古月居

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献160条内容

所有评论(0)