把机器人示教视频拆成原子任务:Seed-2.1-pro-0915 原子级任务标注工作台实测
一、引言:具身数据流水线,卡在「原子任务标注」这一环
具身智能领域目前非常火爆,具身数据这条流水线上,最贵的是标注,不是采集——而标注偏偏最不起眼。遥操作设备、数据手套、第一视角相机每天都在产出视频和轨迹,示教数据本身已经不缺;难的是把“收拾餐桌”这类长程演示拆成 reach → grasp → place 这样的原子步骤,再给每一步标出时间边界和动作语义。
这一步如果靠人,标注员要反复回看视频、逐帧拖动时间轴、按统一词表写动作描述,再走双人交叉、第三人仲裁。Macrodata 在其 WGO-Bench 技术报告 中给出过一个参考量级:纯人工完成切分加描述,平均要花 10 分钟以上处理 1 分钟视频。视频越长、动作越碎,这个环节越贵。
为什么现在可以尝试交给 VLM?因为视频理解模型第一次能在一次推理里同时完成三件事:时序切分、动作语义描述、交互物体识别。我这次用的模型是豆包 Seed-2.1-pro-0915(豆包 2.1 Pro 的 9 月 15 日升级版)。这次升级里有三点正好压在这条流水线上:视频标注、视频内容质检被点名是受益场景,对应第二、六章的任务定义与实测;视频推理的 token 消耗下降 30% 以上,对应 7.4 节的成本账;Agent 的端到端交付更可靠、能自己验证再声明完成,对应第五章——那套标注工作台就是它独立写出来的。于是我做了一个工程化的验证:不是在对话框里丢一条视频问「拆成几步」,而是按真实数据团队的交付要求,搭一条可复跑、可评测、可人工兜底的标注管线,并回答四个问题:
- VLM 自动切分原子任务,准确率到底在什么水位?
- 输入形态(烧录时间戳的接触表 vs 原生视频)对结果影响多大
- 0915 新版相对 0628 旧版,在这个任务上有哪些可感知的进步?深度思考开关值不值得开?
- 跑完一条 / 一批视频的真实耗时和成本是多少?人工还需要做什么?
最终交付物有三样:一套 Python 评测管线、一份同口径新旧对比评测报告,以及本文的重头戏——由 0915 新版从一份需求文档独立开发的原子级任务标注工作台 Atom 标注台。而且本次标注工作台完全是在豆包工作里交给豆包 2.1 Pro 0915 自己完成的。其中 Atom 标注台我留了一个公网入口,不装环境就能点进去把流程走一遍:在线 Demo。
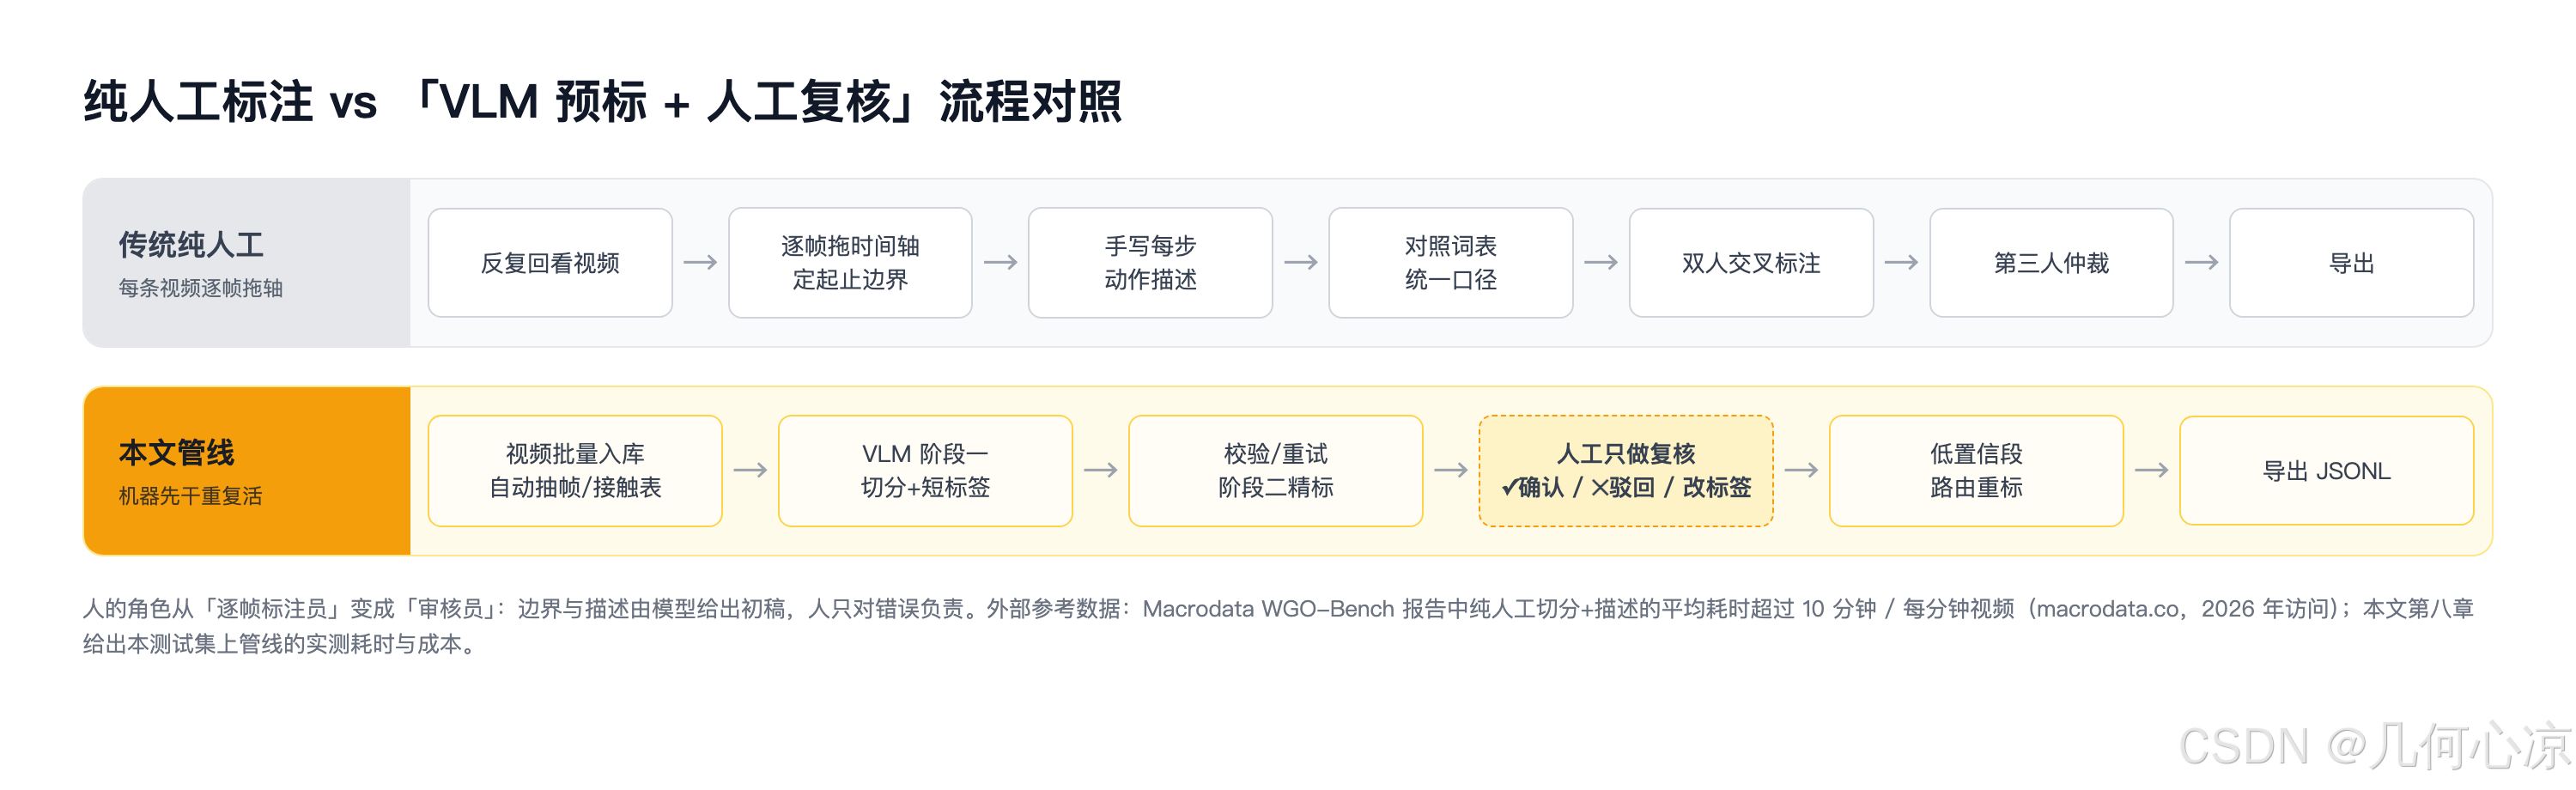
图 1 纯人工标注与「VLM 预标 + 人工复核」流程对照
二、任务定义与测试集:先有金标准,再谈模型好坏
2.1 什么是「原子任务」
沿用机器人学习领域的通行口径(EPIC-Kitchens、Open X-Embodiment 等数据集的动作分段习惯),我把原子任务的判定收敛为三条原则:
- 单一意图:一段只做一件事,比如「拿起瓶盖」和「把瓶盖拧到瓶子上」是两段;
- 一次主要状态变化:物体的位置、接触关系或装配状态发生一次明确改变;
- 可独立判定成败:每段都能单独回答「这一步做没做成」。
需要特别说明边界:这套管线产出的是时序对齐的语义标签层——第几秒到第几秒、在对什么物体做什么动作。RGB 视频给不出关节角、末端位姿、夹爪开合、力觉这些控制真值,那些仍然来自遥操作采集本身。两者是叠加关系,不是替代关系。
2.2 测试集:直接用数据集自带的人工金标
测试数据用光轮智能(LightwheelAI)开源的 EgoSuite-Open100K 样本(DevKit 为 Apache-2.0 许可,github.com/LightwheelAI/LW-Egosuite-DevKit)。选它有两个原因:第一,样本是真实的第一视角桌面操作视频,与具身数据公司的采集场景一致;第二,也是更关键的——它的 mcap 轨迹包里自带数据方标注好的 /annotation/semantic_segments 金标准,每段都有英文 subtask 描述和起止秒,我不需要自产自销、自己当裁判,只做了逐集回看核验。
最终选取 8 集、共 21 个金标原子段,时长 5.1–12.8 秒,覆盖两种采集范式(机器人夹爪遥操作模仿 robot_gripper_mimic、自然人手 natural_human_hand)和六个任务:
表 1 测试集构成(EgoSuite-Open100K,8 集 21 段)
| 集(前 8 位) | 任务 | 范式 | 时长 (s) | 金标段数 |
| 8fc9b837 | 调料瓶排列(台面) | 夹爪模仿 | 6.8 | 3 |
| 84857728 | 餐具摆放(叉 / 勺 / 碗) | 夹爪模仿 | 5.4 | 3 |
| 0d4b65a1 | 贴快递单 | 自然人手 | 12.8 | 2 |
| 52e6f31b | 调料瓶放入透明收纳盒 | 夹爪模仿 | 9.6 | 3 |
| 9547ddf3 | 香水瓶盖拧上并摆上木架 | 自然人手 | 5.3 | 3 |
| 10ca5150 | 关水龙头(左 / 右把手) | 夹爪模仿 | 5.1 | 2 |
| 07002087 | 墨镜归位陈列 | 自然人手 | 5.2 | 3 |
| c206ad1c | 香水瓶盖拧紧并上架 | 自然人手 | 6.1 | 2 |
样本规模刻意做得小而精:金标准可靠、每个 case 都能人工逐帧核对,比堆一个无法核验的大样本更有说服力。局限也提前讲明——21 段的样本量下,1 个命中段就对应约 5 个百分点的指标变化,模型间几个点的差异应视为噪声,本文只对跨配置稳定复现的量级差异下结论。
2.3 评测指标:对齐 Macrodata 的 WGO-Bench 口径
为了让数字能和公开工作对得上,评测完全采用 Macrodata 报告中的协议:
- Segment F1:预测段与金标段 IoU ≥ 0.75 贪心匹配(按 IoU 降序一一配对),计算精确率 / 召回率 / F1;评分前把首段起点、末段终点吸附到金标外边界(模型不必为视频首尾的静默帧负责);
- 标签准确率:只对时间命中的段,用 LLM-as-judge 判定预测描述与金标描述是否语义等价(输出 match bool)。为避免「模型当裁判偏袒自己」,我让新旧两个模型各当一次裁判,两个口径都报;
- 端到端可用率(E2E):时间命中且标签通过的段占金标段的比例——这是「AI 初稿能直接用」的真实比例;
- 按时长分层召回:<2s、2–5s、5–10s 分层统计,专门暴露短动作漏检;
- 成本与时延:每次调用记录 prompt/completion tokens、耗时,按方舟公示价折算。
三、方案设计:为什么是「管线 + 工作台」而不是一个 Prompt
3.1 总体架构
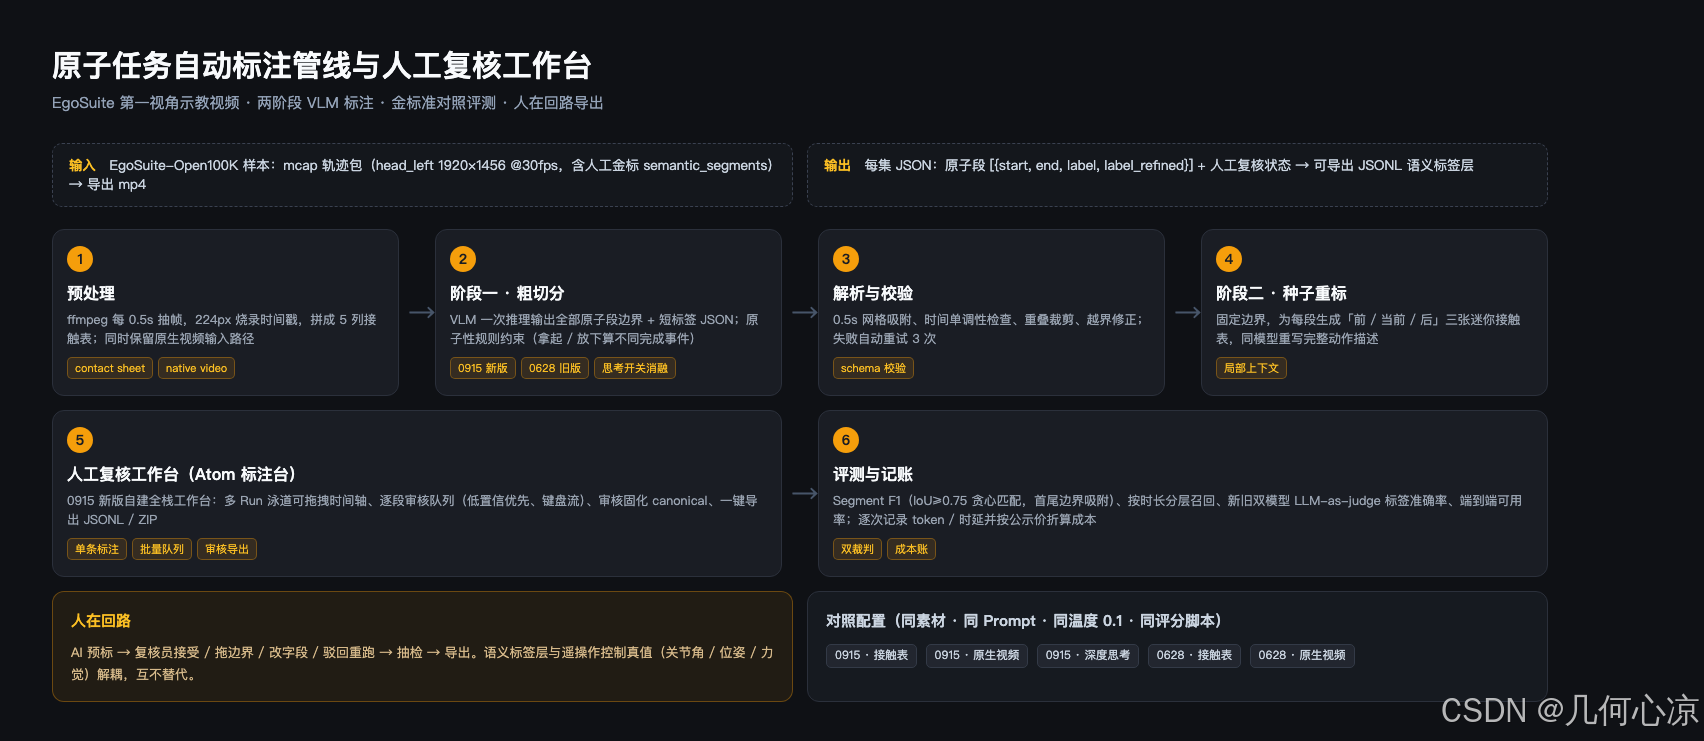
图 2 原子任务自动标注管线与人工复核工作台(Atom 标注台)
整条链路分六步:
- 预处理:ffmpeg 每 0.5s 抽一帧、缩到 224px、在左上角烧录黄底时间戳,按每行 5 列拼成接触表(contact sheet);同时保留原生 mp4 输入路径;
- 阶段一・粗切分:VLM 一次推理输出全部原子段的 start_sec / end_sec / subtask JSON;
- 解析与校验:0.5s 网格吸附、时间单调性检查、重叠裁剪、越界修正,失败自动重试;
- 阶段二・种子重标(seed relabel):固定阶段一边界,为每一段生成「前一段 / 当前段 / 后一段」三张迷你接触表,让同一个模型看着局部上下文重写完整动作描述——这是 Macrodata 配方里的精标环节;
- 人工复核工作台:Atom 标注台以多泳道时间轴并排展示金标与各配置预测,逐段确认 / 驳回 / 改标签,审核完成后导出 canonical 数据;
- 评测与记账:跑 F1、双裁判标签准确率、分层召回,汇总 token、时延与成本。
3.2 两种输入形态:接触表 vs 原生视频
接触表是视频标注里的经典做法:把时间戳直接画在帧上,模型「读图上的时钟」而不是凭感觉估秒,且 token 便宜。0915 新版支持原生视频输入(OpenAI 兼容接口的 video_url,data URL base64 内联即可),我把两条路都跑了一遍,让数据告诉我们在这个任务上该选谁。
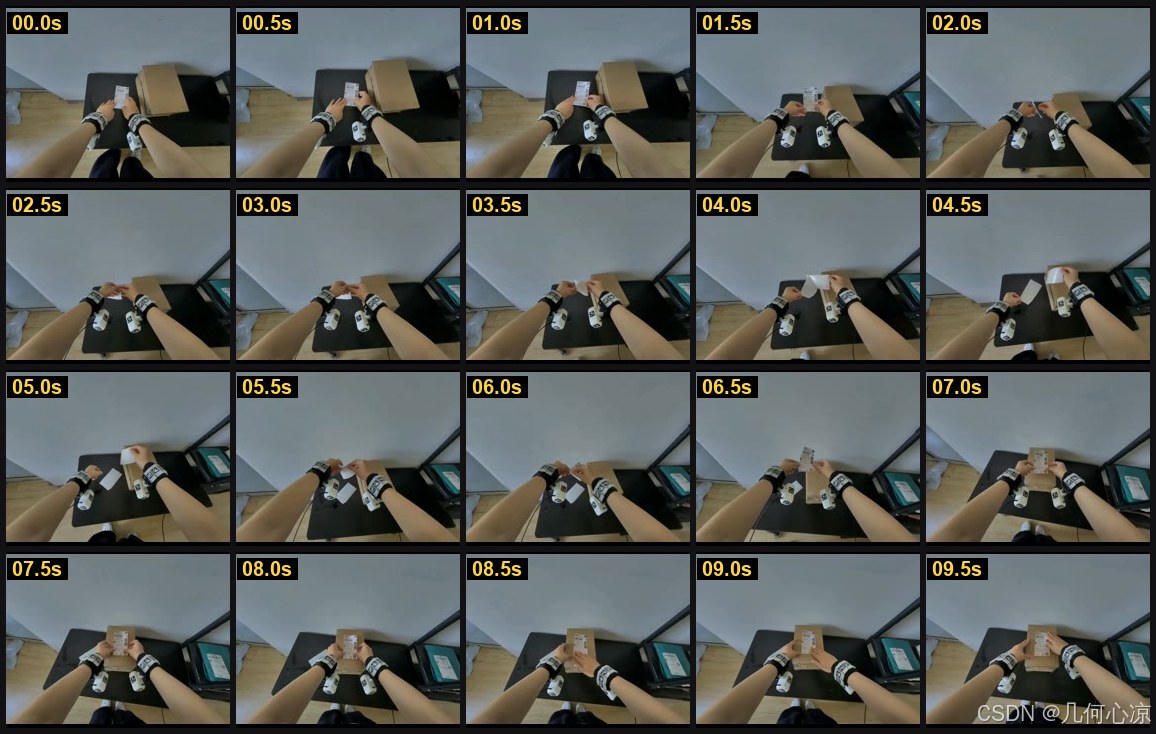
图 3 贴快递单(12.8s)的接触表:0.5s 一帧、224px、烧录时间戳、每行 5 列
3.3 Prompt 设计的几个关键点
阶段一 Prompt 里真正起作用的是三条硬约束:输出严格 JSON、时间精确到 0.5s、「拿起与放下是不同的完成事件,必须切成两段」。后者是为了对付 VLM 常见的「一整段 grasp-and-place 合并」问题。阶段二重标则强制模型引用前后段上下文,且不允许改动边界。
工程上踩了个小坑:Prompt 模板里有 JSON 花括号,最初用 str.format 填占位符直接抛 KeyError,后来全部改成 .replace() 占位填充。
3.4 对照配置
同素材、同 Prompt、同温度(0.1)、同评分脚本,共跑五组配置:
- 0915 新版・接触表
- 0915 新版・原生视频
- 0915 新版・原生视频 + 开启深度思考(消融组)
- 0628 旧版・接触表
- 0628 旧版・原生视频
四、搭建实录:从 mcap 到可复跑的评测管线
4.1 金标准抽取:protobuf 里的两个坑
EgoSuite 的金标在 mcap 包的 /annotation/semantic_segments 通道里。抽取时连踩两个 protobuf 的坑,值得记一笔:
- 金标首段没有 start 字段——proto3 标量缺省即 0,不能用 HasField 判断存在性,直接按 0 处理;
- 消息里的字段是单数 m.segment(repeated 段挂在另一个结构上),按 segments 去遍历会取不到东西。
视频导出后用 ffprobe 核对时长,8 集全部与金标时间轴对齐。
4.2 API 调通:两个默认行为要先知道
模型官方api调用官方链接:https://ark.volcengine.com/region:cn-beijing/model/detail?name=doubao-seed-2-1-pro
方舟是 OpenAI 兼容接口,视频内联的写法如下:
content = [
    {"type": "video_url",
     "video_url": {"url": "data:video/mp4;base64," + b64}},
    {"type": "text", "text": prompt},
]
body = {
    "model": "doubao-seed-2-1-pro-260915",
    "messages": [{"role": "user", "content": content}],
    "temperature": 0.1,
    "max_tokens": 2000,
    "thinking": {"type": "disabled"},      # 批量标注场景建议显式关闭
    "response_format": {"type": "json_object"},
}
实测有两个默认行为值得记下来,第一次接入可以少踩坑:
- 0915 新版默认开启深度思考:不显式关闭时,响应里带 reasoning_content。批量切分场景建议显式 thinking: disabled——关闭后单次 3–7 秒返回;开启后单集切分调用耗时 12.5–237 秒不等(思考模式的收益与代价见 7.2 节的消融实验);
- max_tokens 要给足:关闭思考后 max_tokens=50 时请求拿不到正常响应,给到 ≥200 后稳定返回。批量脚本里建议直接给到 2000,JSON 输出本身很短,给足额度不产生额外费用。
另外记录一个实测数据点:原生视频路径下两版单集 prompt tokens 都在 6.7k 左右;接触表路径下 0915 新版的输入 token 比 0628 旧版低约 18%(单集均值 11.7k vs 14.3k),折算单条成本 ¥0.073 vs ¥0.090——图片侧的 token 效率提升在账单上是看得见的。
4.3 两阶段管线的产物
阶段一每集落一个 JSON(原始返回、归一化后的段、usage、耗时全留痕);阶段二为每段生成三张迷你接触表(首 / 尾段用灰底占位图),重写后的描述写入 label_refined。五组配置共 104 个段次的重标调用全部成功、零失败。
4.4 批量跑批的两个工程坑
- 断点续跑是必需的:长任务用 nohup 后台跑时,包装 shell 退出会连带杀掉子进程,stage1 曾因此漏掉最后一集;脚本加了「结果文件存在即跳过」后重跑补齐;
- 429 要退避而不是硬刚:批量调用时触发过 RateLimitExceeded,把退避从固定 2 秒改成 20/40/60 秒递增后跑通。并发标注场景下,退避策略要写在管线里而不是靠人肉重试。
五、让 0915 新版当一回全栈工程师:Atom 标注台自建实录
前面这套管线回答的是「模型标得准不准」。但我更想验证一个更有野心的问题:如果把整套标注工作台的需求直接丢给 0915 新版,让它自己当全栈工程师,能交付到什么程度? 这一章是本文的重头戏,也是我对 0915 新版 Coding / Agent 能力印象最深的一次实测。
5.1 一份需求文档 → 一个完整全栈项目
这一章的开发全程在豆包工作里完成(模型选豆包 2.1 Pro / Seed-2.1-pro-0915)。我把功能需求写成一份 Prompt 交给它:单条处理、批量队列、两阶段标注、人工审核、导出、全链路留痕、未配 Key 也要能离线演示、页面要达到可以截图发文章的美观水准,并指定了技术栈(FastAPI + SQLModel + React + Vite + Tailwind + TypeScript)。具体prompt如下:
[应用生成](skill://doubao-app-builder?type=2&id=345607688194) 工作台搭建 Prompt 你是一名资深全栈工程师 + 产品设计师。请为我从零搭建一个具身智能机器人示教视频「原子任务自动标注工作台」,并端到端跑通、可本地启动、可直接演示。这是一个真实项目,不要写玩具占位代码,所有功能都要完整实现;前端设计要达到可以放进技术文章截图的美观水准。你可以使用你具备的前端 / 设计类 Skill 和组件库能力来打磨界面。 一、项目背景 机器人示教视频(机械臂头部相机、外部第三视角、人类第一视角)需要把一条长程演示切分成若干「原子任务」(subtask),例如 twist open the pitcher lid、pick up the pitcher、pour water into the wine glass、close the lid,每个原子任务包含精确的起止时间和自包含的动作描述。这些标注用于 VLA(视觉 - 语言 - 动作)模型训练。 工作流是:视频入库 → 抽帧 / 合成接触表(contact sheet)→ 调用多模态大模型(VLM)输出结构化 JSON → 自动校验与二阶段精修 → 人工在工作台复核修改 → 导出 JSONL 数据集。 二、技术栈(如无更优理由请按此执行) 后端:Python 3.11 + FastAPI + Pydantic v2 + SQLModel(SQLite 持久化,零配置启动)+ ffmpeg/ffprobe(通过 subprocess 调用)+ OpenAI SDK 兼容方式调用火山方舟 Ark API;后台任务用 asyncio 队列 + SSE 向前端推送进度。 前端:Vite + React + TypeScript + Tailwind CSS + shadcn/ui + lucide-react 图标;视频播放器用原生 HTML5 video 封装自定义控件;时间轴用自研 React 组件(不要笨重的视频编辑库)。 产物:docker-compose.yml(可选)+ 根目录 Makefile + 详细 README,要求在 macOS 上 make dev 或两条命令分别启动前后端即可运行;启动时自动检测 ffmpeg 是否存在并提示。 密钥:所有 API Key 只从后端 .env 读取(ARK_API_KEY、ARK_BASE_URL、ARK_MODEL 等),绝不硬编码、绝不发到前端。 必须内置 Mock VLM Provider:未配置 API Key 时返回确定性的模拟标注结果,保证无密钥也能完整体验全部界面与流程,方便演示和前端开发。 三、核心业务模型 Video:id、文件名、存储路径、时长、fps、宽高、视角类型(head /external/egocentric)、任务指令 instruction(如 "use pitcher to pour water into tall glass and wine glass")、状态(uploaded /preprocessing/annotating /pending_review/approved /failed)、失败原因、创建时间。 AnnotationRun(一次模型跑批,同一视频可有多个 run,用于多模型、多输入路径对比):id、video_id、provider 名、model 名、输入模式(contact_sheet 接触表 / native_video 原生视频)、阶段(1 仅切分 / 2 切分 + 种子重标)、prompt 版本、状态、输入 / 输出 / 思考 token 数、耗时 ms、折算成本(人民币元,单价可在设置页配置)、完整原始请求与响应(落盘保存到 data/runs/,这是评测复现证据,不能丢)、错误信息、创建时间。 Segment(原子任务段):id、video_id、run_id(模型产出时关联;人工段可为空)、序号、start_sec、end_sec、action 动词、object 操作物体、target_location 目标位置、state_change 状态变化、label 自包含祈使句标签、confidence、来源(model /human)、审核状态(pending /accepted/edited /rejected)、更新时间。 Batch:id、名称、配置 JSON(选用的 provider、模式、阶段、并发数)、总数 / 成功 / 失败 / 待审核计数、状态、创建时间。 导出物:人工审核完成后,以审核确认的 canonical segments 为准;支持「每视频一个 JSON」和「全量 segments JSONL」两种导出。 四、后端管线要求 4.1 预处理与接触表(contact sheet) 用 ffprobe 取时长 /fps/ 分辨率;用 ffmpeg 每 0.5s 抽一帧,缩放到宽 224px(不足则放大、保持比例、16:9 画布居中补黑边)。 用 PIL 把每 20 帧拼成一张 4 行 × 5 列的接触表(每张覆盖 10 秒视频);每帧左上角烧录该帧时间戳文字(如 03.5s,黑边黄字或白字黑描边,保证清晰),瓷砖间距 2–4px、深色底。 接触表与抽帧图片落盘并通过后端静态路由访问。 4.2 VLM 调用(两阶段) 阶段一「切分」:把该视频全部接触表 + 任务指令 + 切分 prompt 一次请求发出(不要逐张表拆分调用,拆分会导致模型在调用边缘伪造边界);要求只返回 JSON:{"segments":[{"start_sec":0.0,"end_sec":1.0,"subtask":"..."}]}。 阶段二「种子重标」:对每个预测段,合成「上一段 / 本段 / 下一段」三张迷你接触表(每段均匀采样不超过 5 帧),把阶段一的原标签作为强先验传入,让模型只标注本段并做最小修正。 同时实现 native_video 模式:直接把视频文件(或超长时按时间窗切片,切片需带重叠并在合并时去重边界)传给支持原生视频的模型,使用同一套输出 JSON 规范。 Provider 抽象成可插拔适配器:默认实现火山方舟(OpenAI 兼容协议,模型名取环境变量 ARK_MODEL),并预留 OpenAI 兼容的自定义 provider(base_url + model 可在设置页配置),以便后续横评多家模型。 鲁棒性:指数退避重试 3 次;JSON 解析先剥离代码块标记再解析;Pydantic 校验失败时携带错误信息进入 failed 状态;批量并发可配置(默认 2);任务可断点续跑。 4.3 校验规则(自动质检) start <end;边界在 [0, 时长] 内;按时间排序;段间不得重叠(允许空隙代表 idle);边界吸附到 0.5s 采样网格; 粒度先验:段长优先 2–10s,<1s 或>30s 的段打 warning 标记(不阻断); 记录每段是否触发了哪条校验规则,前端高亮提示。 4.4 阶段一 Prompt(作为默认模板存入后端,可在设置页编辑) Reconstruct the sequence of manipulation events in this robot video from the timestamped contact sheets. Return only JSON with this shape: {"segments":[{"start_sec":0.0,"end_sec":1.0,"subtask":"short action description"}]} Rules: - Segment only completed manipulation events, not every visible movement. - Good boundaries happen when an object becomes held, is released, reaches a new location, a door/lid opens or closes, a tool starts/stops affecting a surface, or contents move between containers. - A segment ends when the event is complete, not when the hand returns to a neutral pose; unless there is a clear pause, the next segment starts immediately. - Do not split approach, grasp adjustment, small repositioning, hesitation and retreat unless the world state changes. - Do not merge separate pick/place/open/close/pour/wipe events that complete different states; output repeated events on different objects or target locations as separate segments. - Most segments should be 2-10 seconds. Shorter segments are allowed only for fast pick/place/open/close/release events. - Each contact sheet has 4 rows and 5 columns; time runs left-to-right then top-to-bottom; each tile carries a visible timestamp in its corner — use those timestamps for start_sec/end_sec. - Skip idle time, camera motion, hesitation and tiny hand adjustments. - Write each subtask as one self-contained imperative phrase: name the manipulated object and the precise target location (e.g. "put the cup on the table next to the bowl"), never referring to previous actions. - Write subtask labels in the same language as the episode instruction. Episode instruction: {instruction} 4.5 阶段二「种子重标」Prompt 要点 输入依次为上一段 / 本段 / 下一段三张带绝对时间戳的接触表;告知 Target segment 的序号、时间窗、阶段一原始标签;规则:只标注本段、前后段仅用于消歧;原标签方向正确就保留并仅补充可见关键细节(源 / 目标 / 方向 / 开合 / 满空状态),动作错 / 物体错 / 目标错才替换;不得引入画面中不可见的动作;不拆分合并固定段;输出 {"label":"..."}。 4.6 REST API(按此设计,可增补) POST /api/videos:上传视频(multipart)或登记服务器本地路径,附带 instruction、视角; POST /api/videos/{id}/annotate:body 指定 provider、mode、stages,创建一个 AnnotationRun; POST /api/batches:传入多个视频 id + 统一配置,支持同时勾选多个 provider/mode 组合(每个组合各生成一个 run,供横评); GET /api/batches/{id}/events:SSE 推送任务进度与状态; GET /api/videos?status=&batch=、GET /api/videos/{id}(含 runs 与 segments); PATCH /api/segments/{id}:人工修改边界 / 字段 / 审核状态;POST /api/videos/{id}/segments/bulk-review:批量通过 / 驳回; POST /api/videos/{id}/approve:标记人工审核完成(canonical 固化); GET /api/videos/{id}/export?format=json|jsonl、POST /api/export(多视频打包 zip); GET/PUT /api/settings:provider 配置、模型单价、prompt 模板; GET /api/stats:总数、待审核数、平均每小时视频成本、平均段长等看板指标。 五、前端页面与交互要求 整体设计方向:专业视频工具的暗色「工作台」质感(参考 Linear / Figma 的密度与克制),深灰近黑背景、细边框、低饱和中性色 + 一个青绿色(teal/emerald)主强调色,状态色语义化(成功绿、警告琥珀、失败红、待审核蓝);中文使用系统默认字体,英文 / 数字用 Inter;圆角克制、留白合理、过渡动画 150–200ms、不要花哨渐变和大面积紫蓝色;必须有良好的空状态引导、loading 骨架屏、toast 反馈。 页面 1:任务看板 / 队列(Dashboard) 顶部统计卡片:视频总数、待审核、已完成、失败数、累计 API 成本; 视频表格:缩略图、文件名、视角、时长、指令、状态徽章、各 run 的模型 / 模式小标签、段数、token、成本、耗时、操作按钮;支持筛选与搜索; 右上角「上传视频」(支持多选拖拽上传,可批量填指令)和「创建批量任务」(选择视频 → 勾选 provider / 模式 / 阶段 → 显示预估 → 启动); 批量任务实时进度条(SSE),失败行可一键重试,可展开看错误详情。 页面 2:标注工作台(核心页面,投入最多设计精力) 三栏布局: 左:视频播放器,自定义控件(播放 / 暂停、±0.5s 逐帧步进、倍速、当前时间 / 总时长、快捷键提示); 中下:原子任务时间轴—— 带时间刻度标尺、播放头与播放器双向联动、彩色分段块(按动作类别配色)、块上显示序号与标签;支持拖拽分段左右边缘调整边界、拖动整块、在标尺上点击新增分段、右键删除 / 驳回;缩放档位(1x/2x/4x);置信度低或触发校验警告的段用条纹 / 描边醒目标记; 右:分段卡片列表,每张卡片可行内编辑 start/end、action、object、target_location、state_change、label,显示 confidence 与审核状态,按钮:通过 / 编辑后通过 / 驳回 / 定位到该段;支持键盘快捷键(J/K 或空格播放暂停、←/→ 微调 0.5s、N/P 下一段 / 上一段、A 通过、R 驳回),并提供快捷键说明弹窗。 顶部切换:同一视频的多个 AnnotationRun(不同模型 / 模式)以 Tab 或对比开关呈现,支持「金标准 vs 模型 A vs 模型 B」时间轴叠加对比视图(多泳道)。 可展开的「模型原始输出」抽屉:展示接触表缩略图、原始 JSON、token 用量、耗时、校验警告,满足评测取证需要。 「保存并提交审核完成」按钮,校验是否还有 pending 段。 页面 3:审核队列(Review) 聚焦人工复核:只看待审核视频,逐条过;左侧视频 + 时间轴,右侧键盘优先的操作流;高置信段可一键全部通过,低置信段自动排在前面。 页面 4:导出与设置 导出页:选择视频范围、字段勾选、格式(每视频 JSON / JSONL /zip),在线预览前 3 条结果再下载; 设置页:provider 列表(名称、base_url、模型名、API Key 状态、输入 / 输出单价)、两阶段 prompt 模板在线编辑并恢复默认、接触表参数(采样间隔、瓷砖宽度、每张帧数)、批量并发数。 六、评测脚本(一并提供,放 backend/scripts/) http://evaluate.py --pred <run.json> --gold <gold.json>:实现 Segment F1(预测段与金标段 IoU≥0.75 计命中,评分前把首个起点 / 末个终点吸附到金标外边界)、按段长分层召回(<2s / 2–5s / 5–10s / 10–20s / ≥20s)、段数误差; LLM-as-judge 标签评判为可选开关(裁判模型通过环境变量单独配置,输出每段 {"match": true/false} 与汇总准确率),不配置时只出切分指标。 七、交付与验收标准 先给我一份简短的实现计划(目录结构、数据模型、分步顺序),确认后直接开始完整实现,不要每一步都停下来问我; 代码完整可运行:后端启动自动建表,前端 npm install && npm run dev 可用;根目录 README 写清环境要求、ffmpeg 安装、.env 示例、启动命令、Mock 模式用法; 自带 2–3 条示例视频的 Mock 数据(可用程序生成占位视频或脚本下载公开开源样例,许可需在 README 注明),保证克隆后无 API Key 也能走完「上传→标注→审核→导出」全流程; 自己实际启动前后端、用 Mock 模式逐条走查四个页面与全部关键交互,修复发现的问题后再交付,并在最后告诉我验证了哪些路径; 前端必须是打磨过的成品水准:布局对齐、状态完整、无错位、无控制台报错、时间轴交互顺滑,截图可直接用于公开发表的技术文章; 所有模型调用的请求 / 响应 /token/ 耗时 / 成本必须留痕,便于后续做多模型横评数据汇总。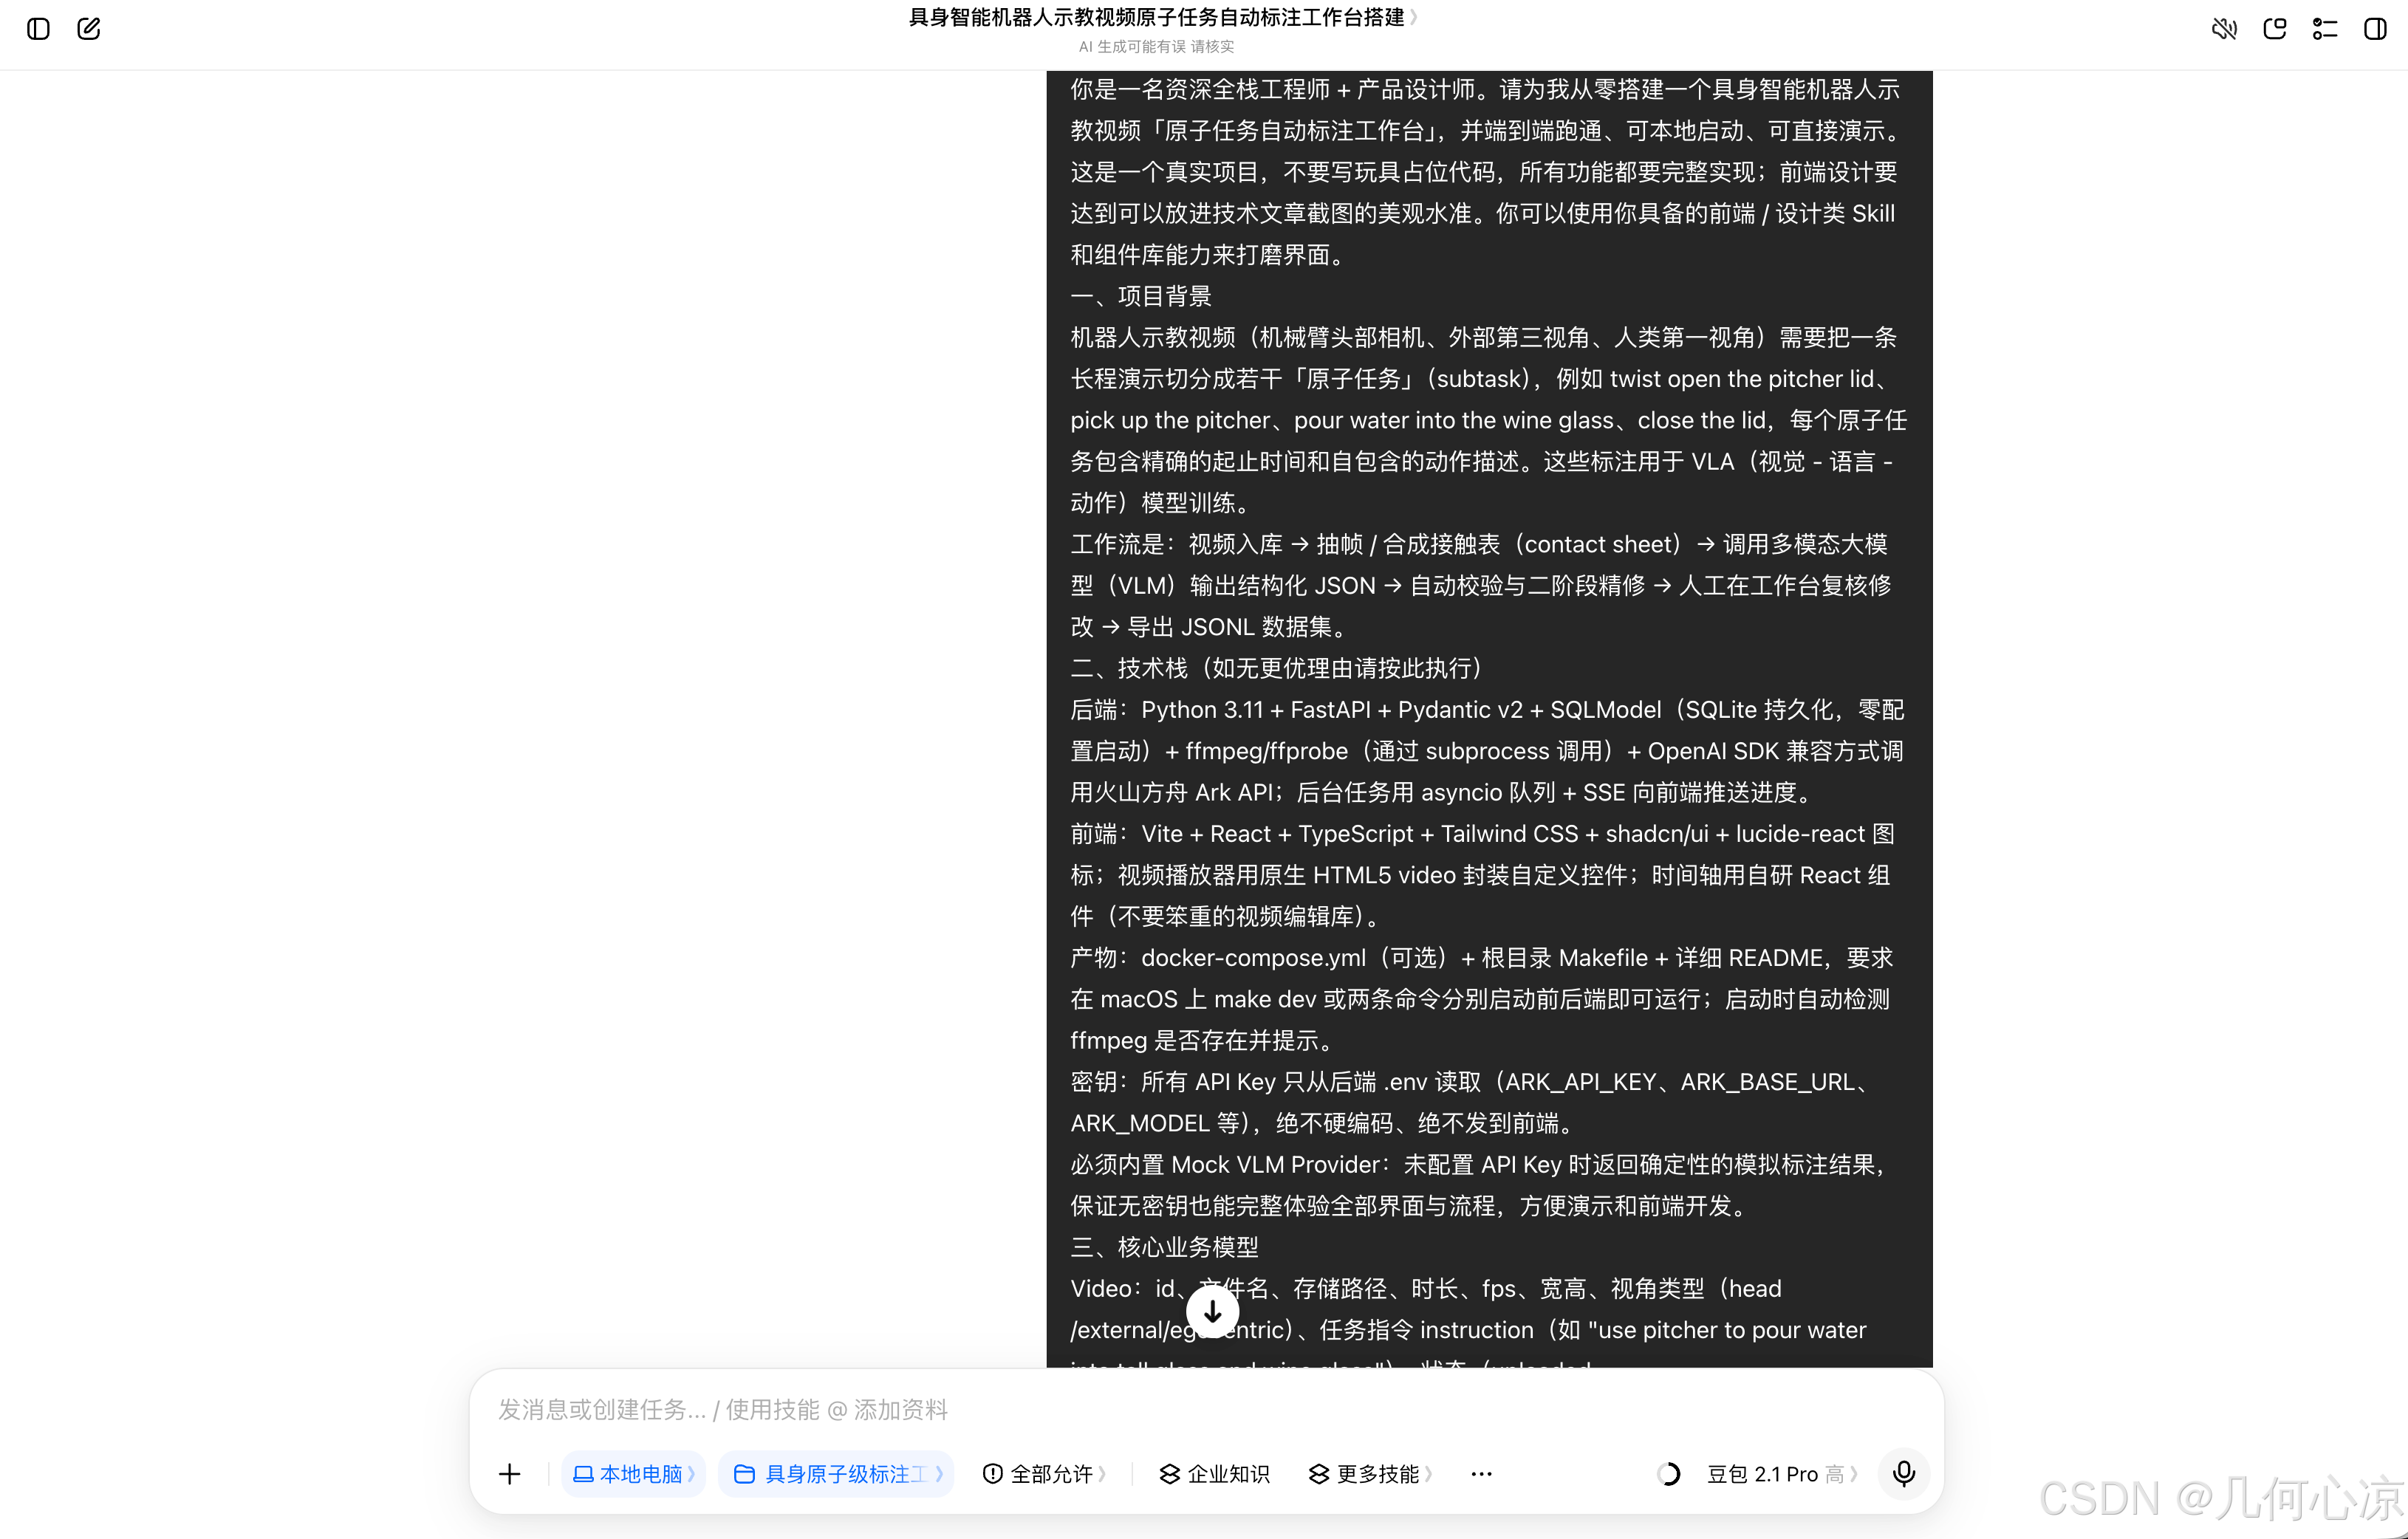
- 后端:FastAPI + Pydantic v2 + SQLModel(SQLite),ffmpeg 抽帧与接触表合成、两阶段 VLM 适配器(Mock / 火山方舟 Ark / 任意 OpenAI 兼容 provider 可插拔)、asyncio 任务队列 + SSE 实时进度、自动校验(边界单调性、重叠、0.5s 网格吸附、粒度先验 warning)、指数退避重试与断点续跑;
- 前端:任务看板、标注工作台、审核队列、导出、设置五个页面,自研 HTML5 播放器(±0.5s 步进、倍速)和可拖拽多泳道时间轴(拖整块 / 拖边缘 / 双击新增 / 右键菜单 / 1×2×4× 缩放),键盘流快捷键(J/K 播放、N/P 跳段、A 通过、R 驳回);
- 工程周边:docker-compose、Makefile(make dev 一键起前后端)、README、评测脚本(Segment F1 / 分层召回 / 可选 LLM 裁判)、3 条程序化生成的 CC0 样例视频;
- 离线可演示:未配置 API Key 时自动启用确定性 Mock VLM,从上传到导出全流程离线可跑——这一条对演示和前端开发极其友好;
- 安全意识在线:API Key 只由后端 .env 读取,前端设置页永远只回显「已配置(留空保持不变)」的掩码状态,密钥不接触前端。
说实话,交付的完整度超出我的预期:需求文档里写的条目它全部落地,而且像「审核完成才允许固化 canonical、仍有 pending 段时返回 409」「导出页在线预览前三条 JSONL 再打包」这类边角逻辑也都做了。前端是暗色专业工具风,密度和克制感接近 Linear / Figma——这正是我在需求里点名的设计方向,它理解得很准。代码我没有代写一行,只做了配置、实测和两处必要的修 bug。
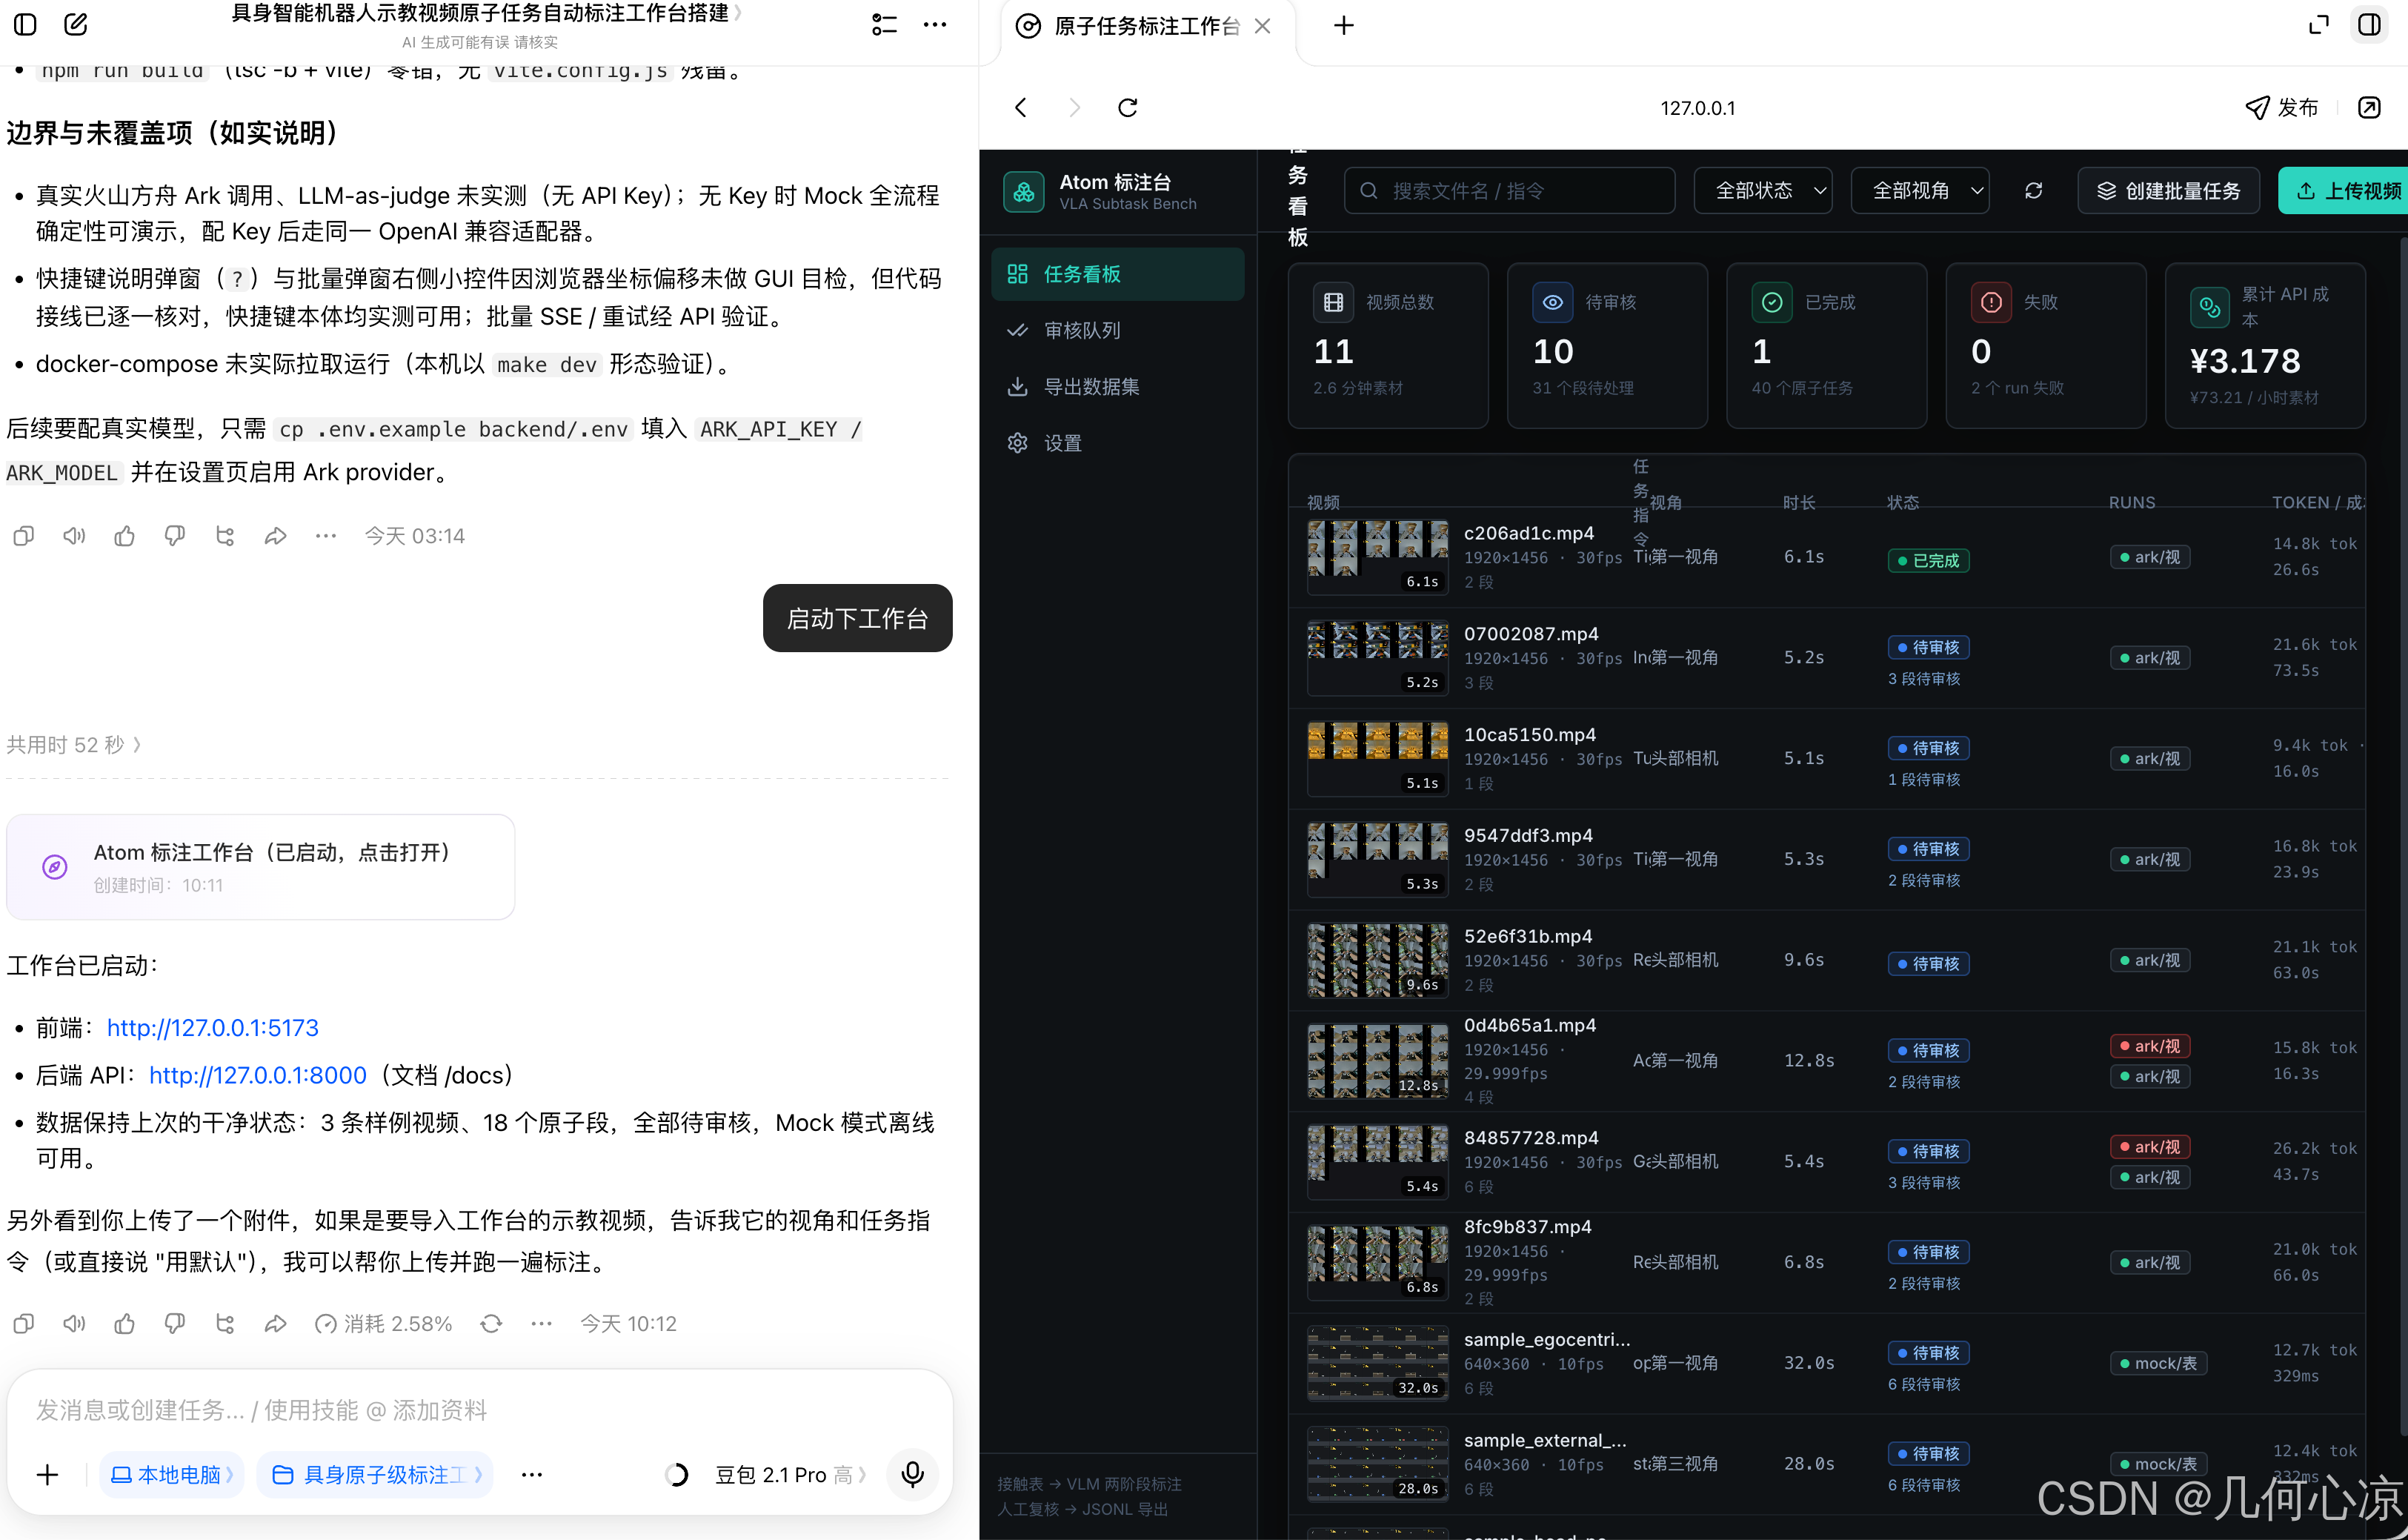
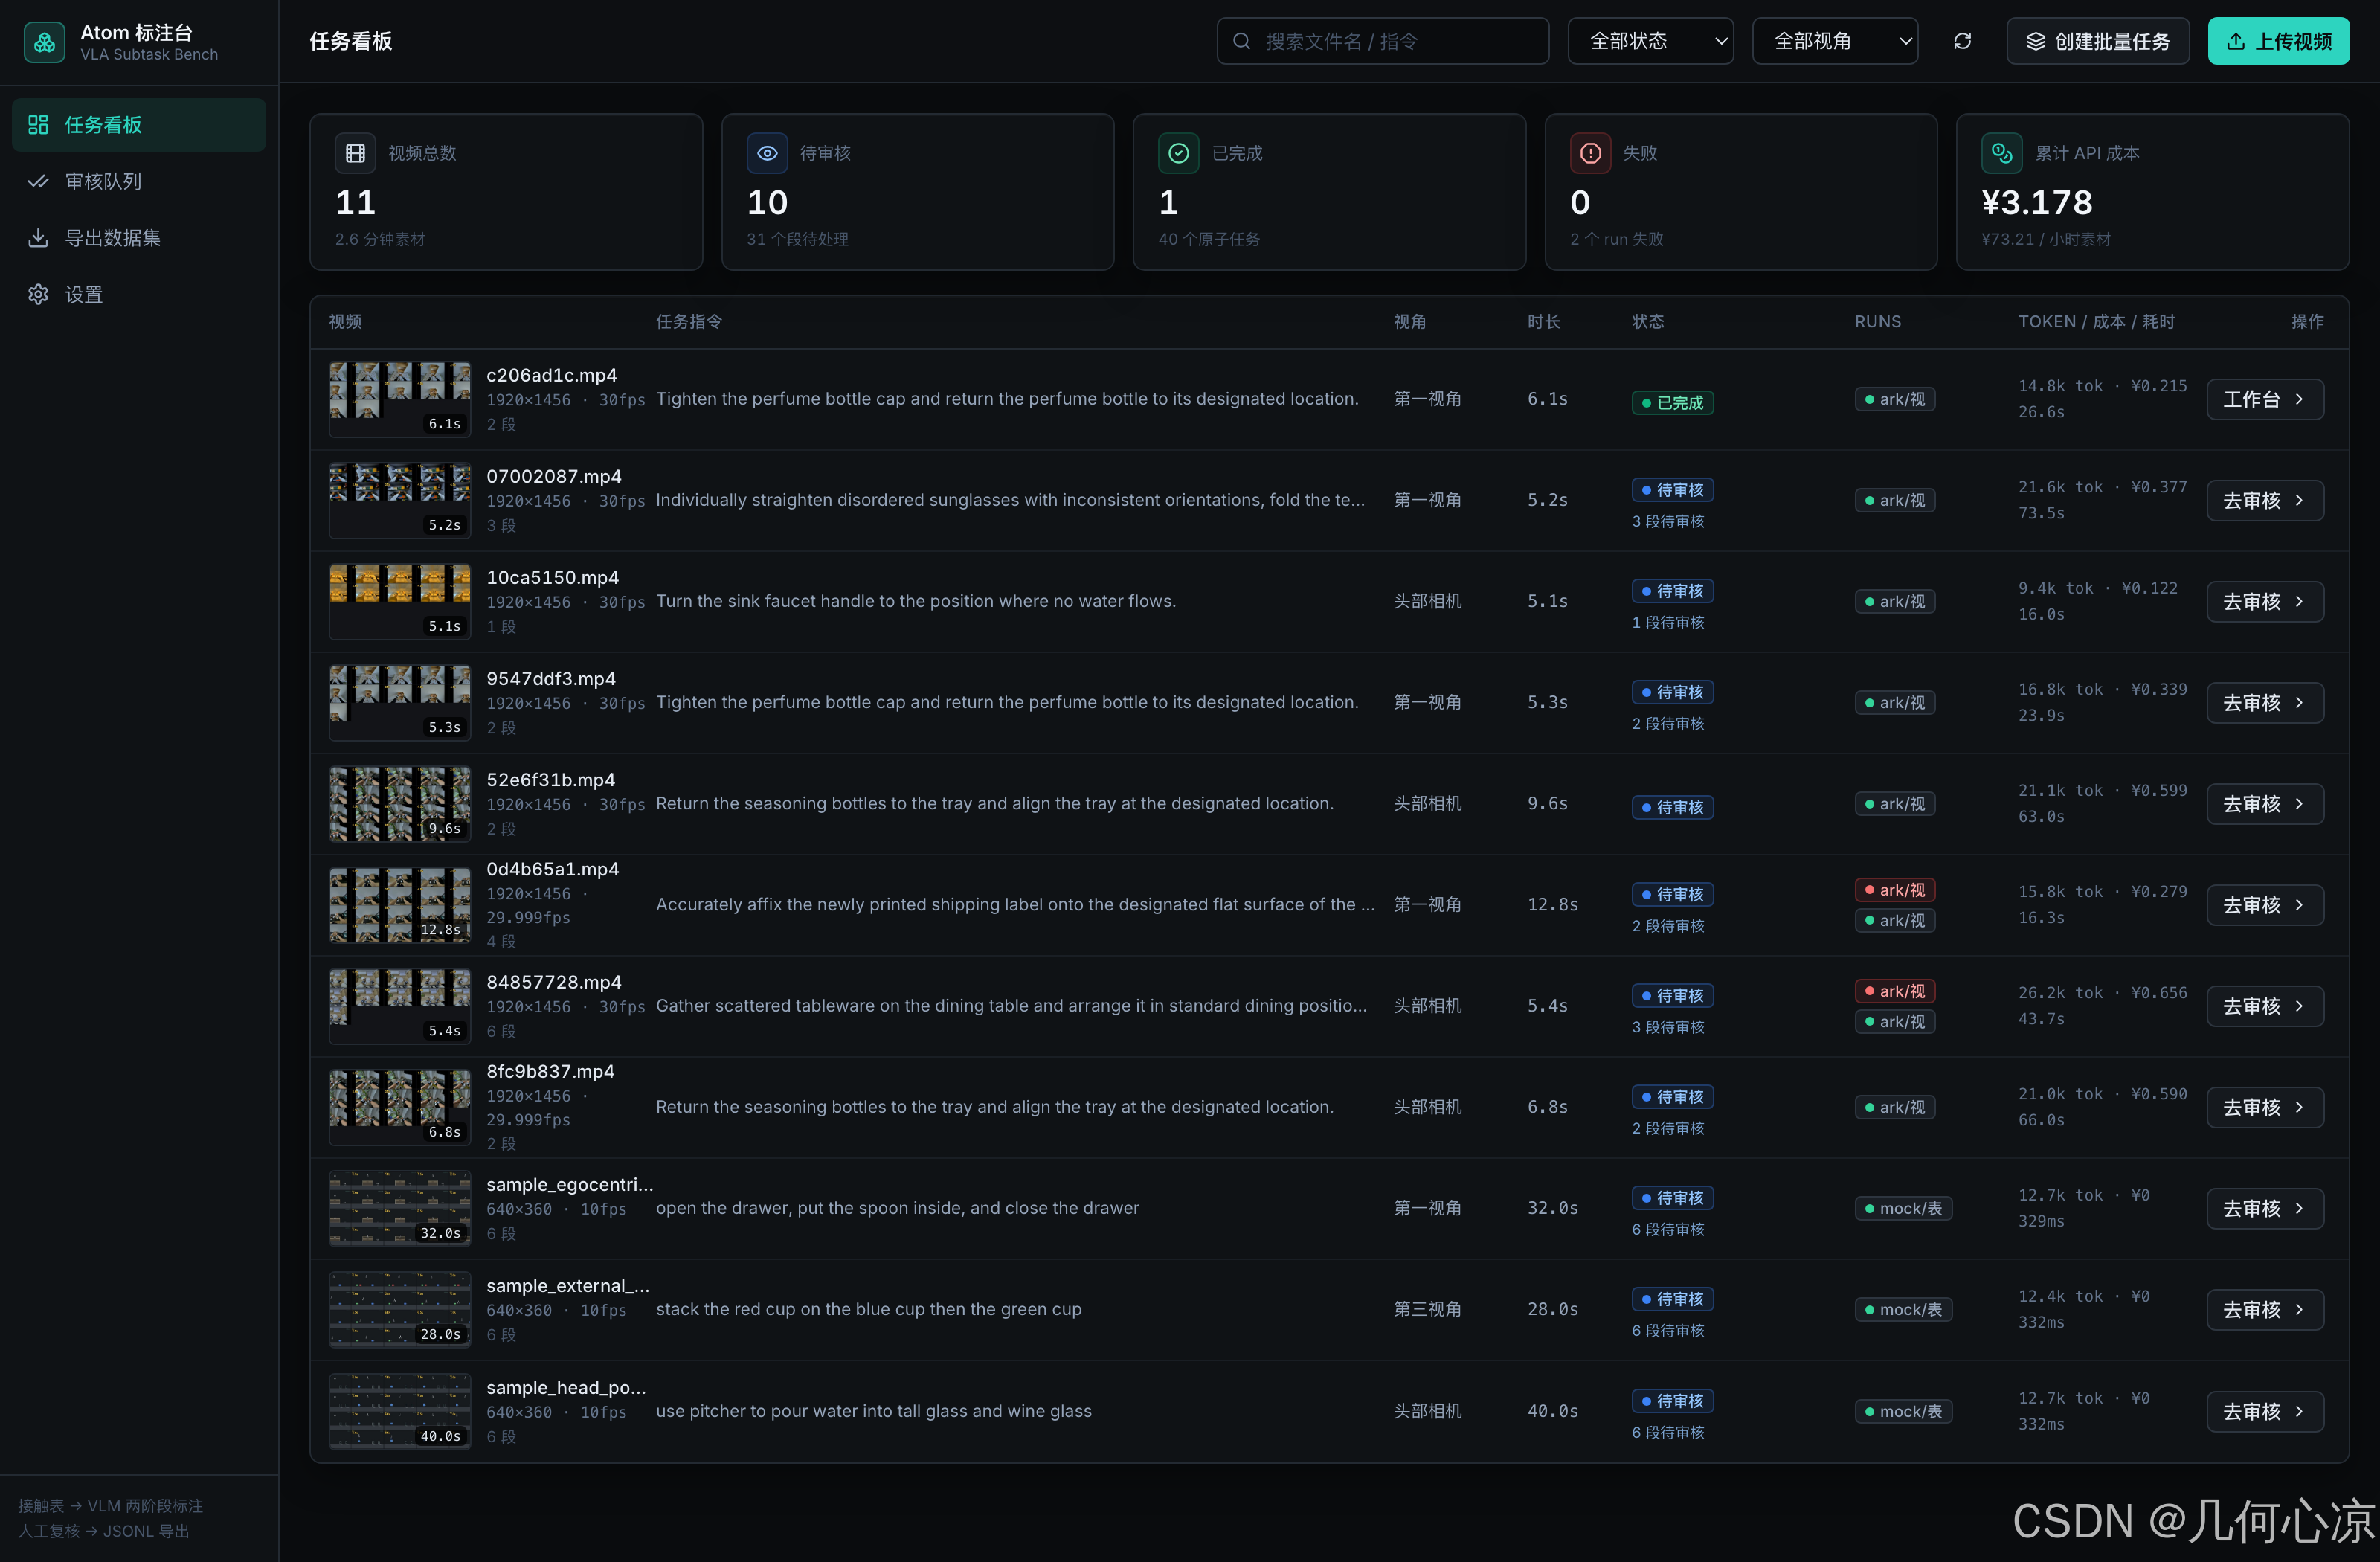
5.2 第一次跑批:两个真实 bug 与修复
在设置页填好模型与单价,登记同一批 8 集 EgoSuite 视频,在批量任务弹窗里勾选「火山方舟 Ark · 原生视频 · 两阶段(含种子重标)」即可发起批量,provider × 模式 × 视频的任意组合都会各自生成可横向对比的 Run。
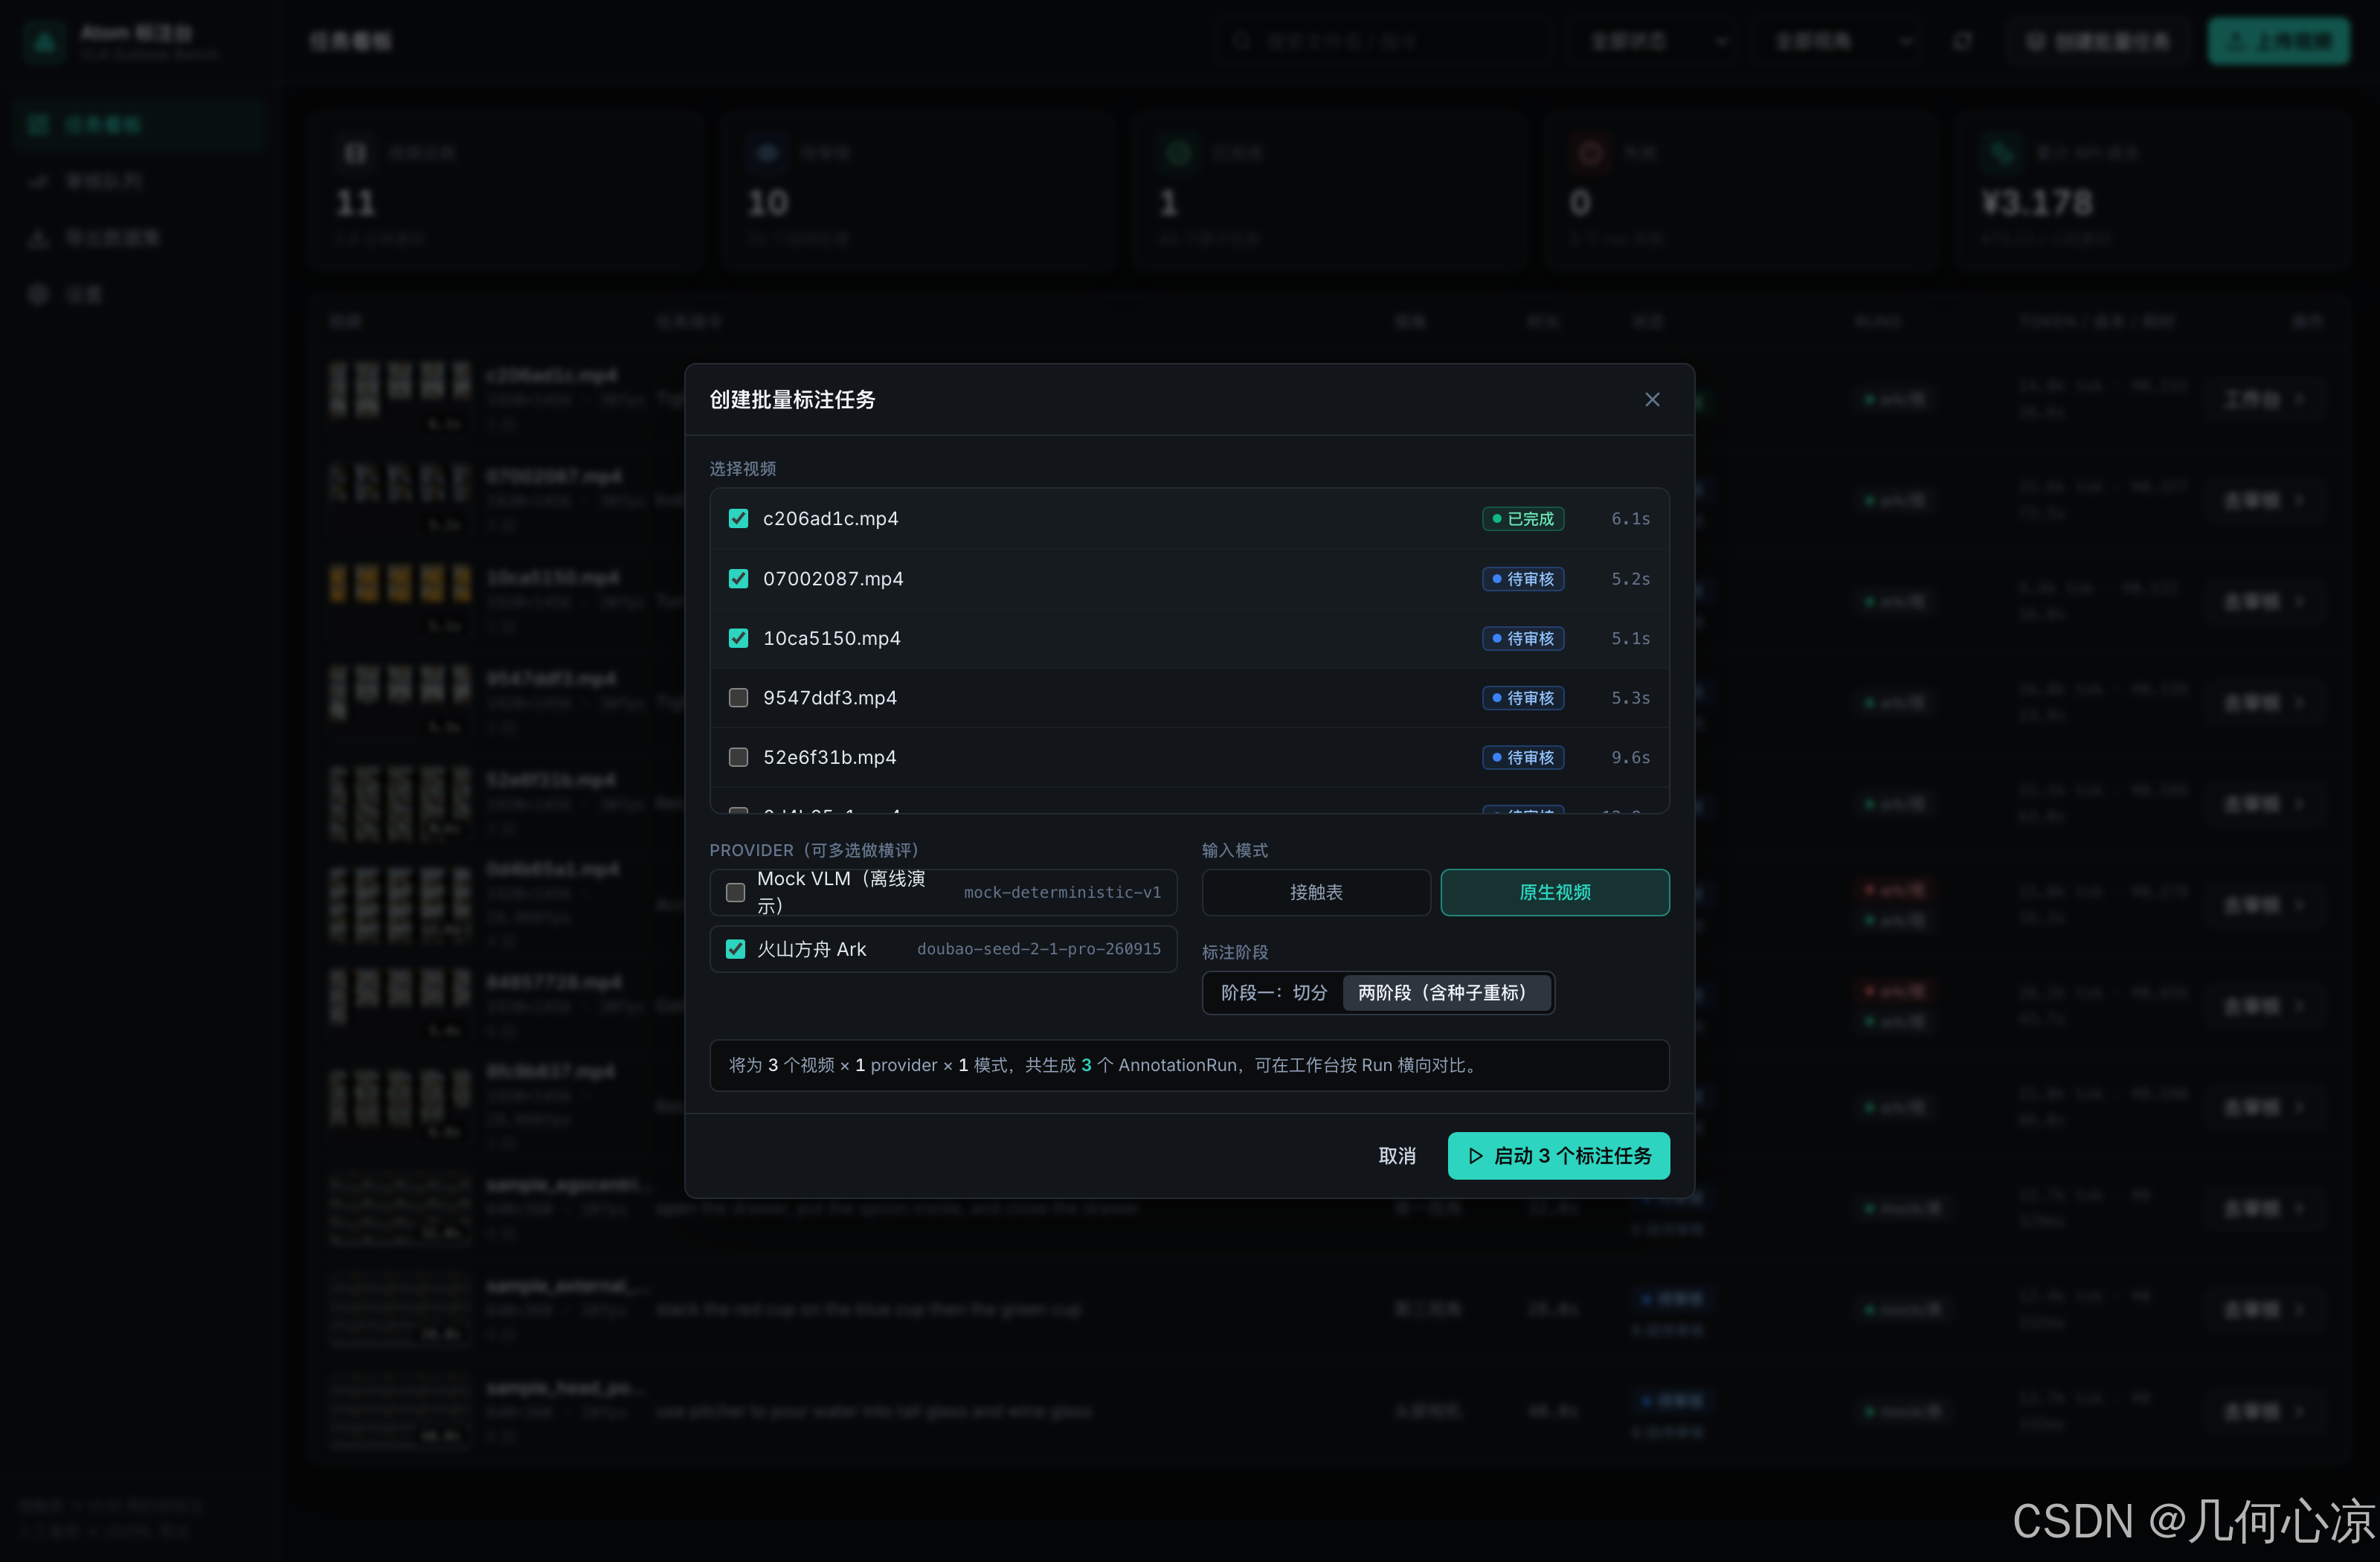
图 4 Atom 标注台任务看板:统计卡、视频表、每个 Run 的 provider / 模式 / token / 成本 / 耗时,失败 Run 以红色标记保留
第一次跑批并不顺利,8 个任务在阶段二集体失败,加上登记接口的一次 500,一共暴露两个真实 bug:
- 同步 / 异步边界错误:「登记服务器本地视频」接口被写成了同步函数,内部却直接 asyncio.create_task 调度抽帧协程,同步上下文里没有运行中的事件循环,接口直接报 500(上传接口因为本身是 async 而侥幸没踩到);改成 async 接口、阻塞部分放进 to_thread、回到事件循环后再调度预处理即可;
- 跨文件的数据类契约错误:阶段二的 Provider 适配器构造 Stage2Result 时传了 latency=...,而数据类字段名是 latency_ms,于是阶段一全部成功、阶段二全部报错;改一个字段名后,用界面上的「重试失败项」断点续跑,8 集全部成功。
这两个 bug 都不高深,却恰好是「Agent 写完整系统」最容易出的那类问题:单文件 demo 永远跑不到的、跨 async/sync 边界和跨文件数据契约的错。修它们各花了我一两分钟,前提是我看得懂它的代码——这也是我对 Agent 自建工具最真实的体感:它把两周的活压缩到一天,但验收者必须具备读代码和定位问题的能力;「零代码」目前更接近「少代码 + 会验收」。
5.3 修好之后:8 集真实批量留痕
修复后,8 集批量任务(并发 2)约 8 分钟全部跑完,每集的请求 / 响应原文、token、耗时、成本都落盘留痕:
表 2 Atom 标注台的 8 集真实批量留痕(doubao-seed-2-1-pro-260915 · 原生视频 · 两阶段 · 温度 0.1)
| 视频 | 预测段数 | 输入 / 输出 tok | 其中思考 tok | 耗时 | 成本 |
| 8fc9b837(调料瓶归位) | 2 | 12.4k / 8.7k | 8.5k | 66.0s | ¥0.590 |
| 84857728(整理餐具) | 3 | 16.8k / 9.4k | 9.1k | 43.7s | ¥0.656 |
| 0d4b65a1(贴快递单) | 2 | 12.3k / 3.5k | 3.4k | 16.3s | ¥0.279 |
| 52e6f31b(调料瓶入收纳盒) | 2 | 12.3k / 8.8k | 8.7k | 63.0s | ¥0.599 |
| 9547ddf3(香水瓶盖上架) | 2 | 12.4k / 4.5k | 4.4k | 23.9s | ¥0.339 |
| 10ca5150(关水龙头) | 1 | 8.2k / 1.3k | 1.2k | 16.0s | ¥0.123 |
| 07002087(墨镜归位) | 3 | 16.9k / 4.7k | 4.5k | 73.5s | ¥0.377 |
| c206ad1c(香水瓶盖上架) | 2 | 12.4k / 2.4k | 2.3k | 26.6s | ¥0.215 |
| 合计 | 17 | 103.7k / 43.2k | 约 42.0k | 329s | ¥3.18 |
折合每分钟视频成本约 ¥3.39。对比我显式关闭深度思考、阶段二只发必要图片的受控管线(约 ¥0.95 / 分钟,见 7.4 节),Atom 标注台默认配置下贵了约 3.6 倍——差距几乎全部来自默认开启的深度思考(4.3 万输出 token 里约 4.2 万是思考链)和阶段二「每段三张迷你接触表」的多轮图片调用。这恰好为 7.2 节的思考消融结论提供了一个工程视角的旁证:0915 新版把思考档位的选择权交给了调用方,但 Agent 产物默认倾向开思考换稳妥,上线前值得替它做一次成本调优——在设置页把 Prompt 里的思考策略和并发参数改掉即可,它把这两处都做成了可配置项。
5.4 页面巡礼:完成度最高的几个界面
下面这些截图就是线上 Demo 里的同一套页面,可以对着点(Demo 里预置了 3 条 CC0 合成样例视频和它们的 Mock 标注结果,也支持自己上传视频跑一遍)。
单条工作台页是这套系统完成度最高的部分:自研 HTML5 播放器(±0.5s 步进、倍速)、可拖拽时间轴、多 Run 泳道、右侧逐段卡片把动作动词 / 物体 / 目标位置 / 状态变化拆成结构化字段。
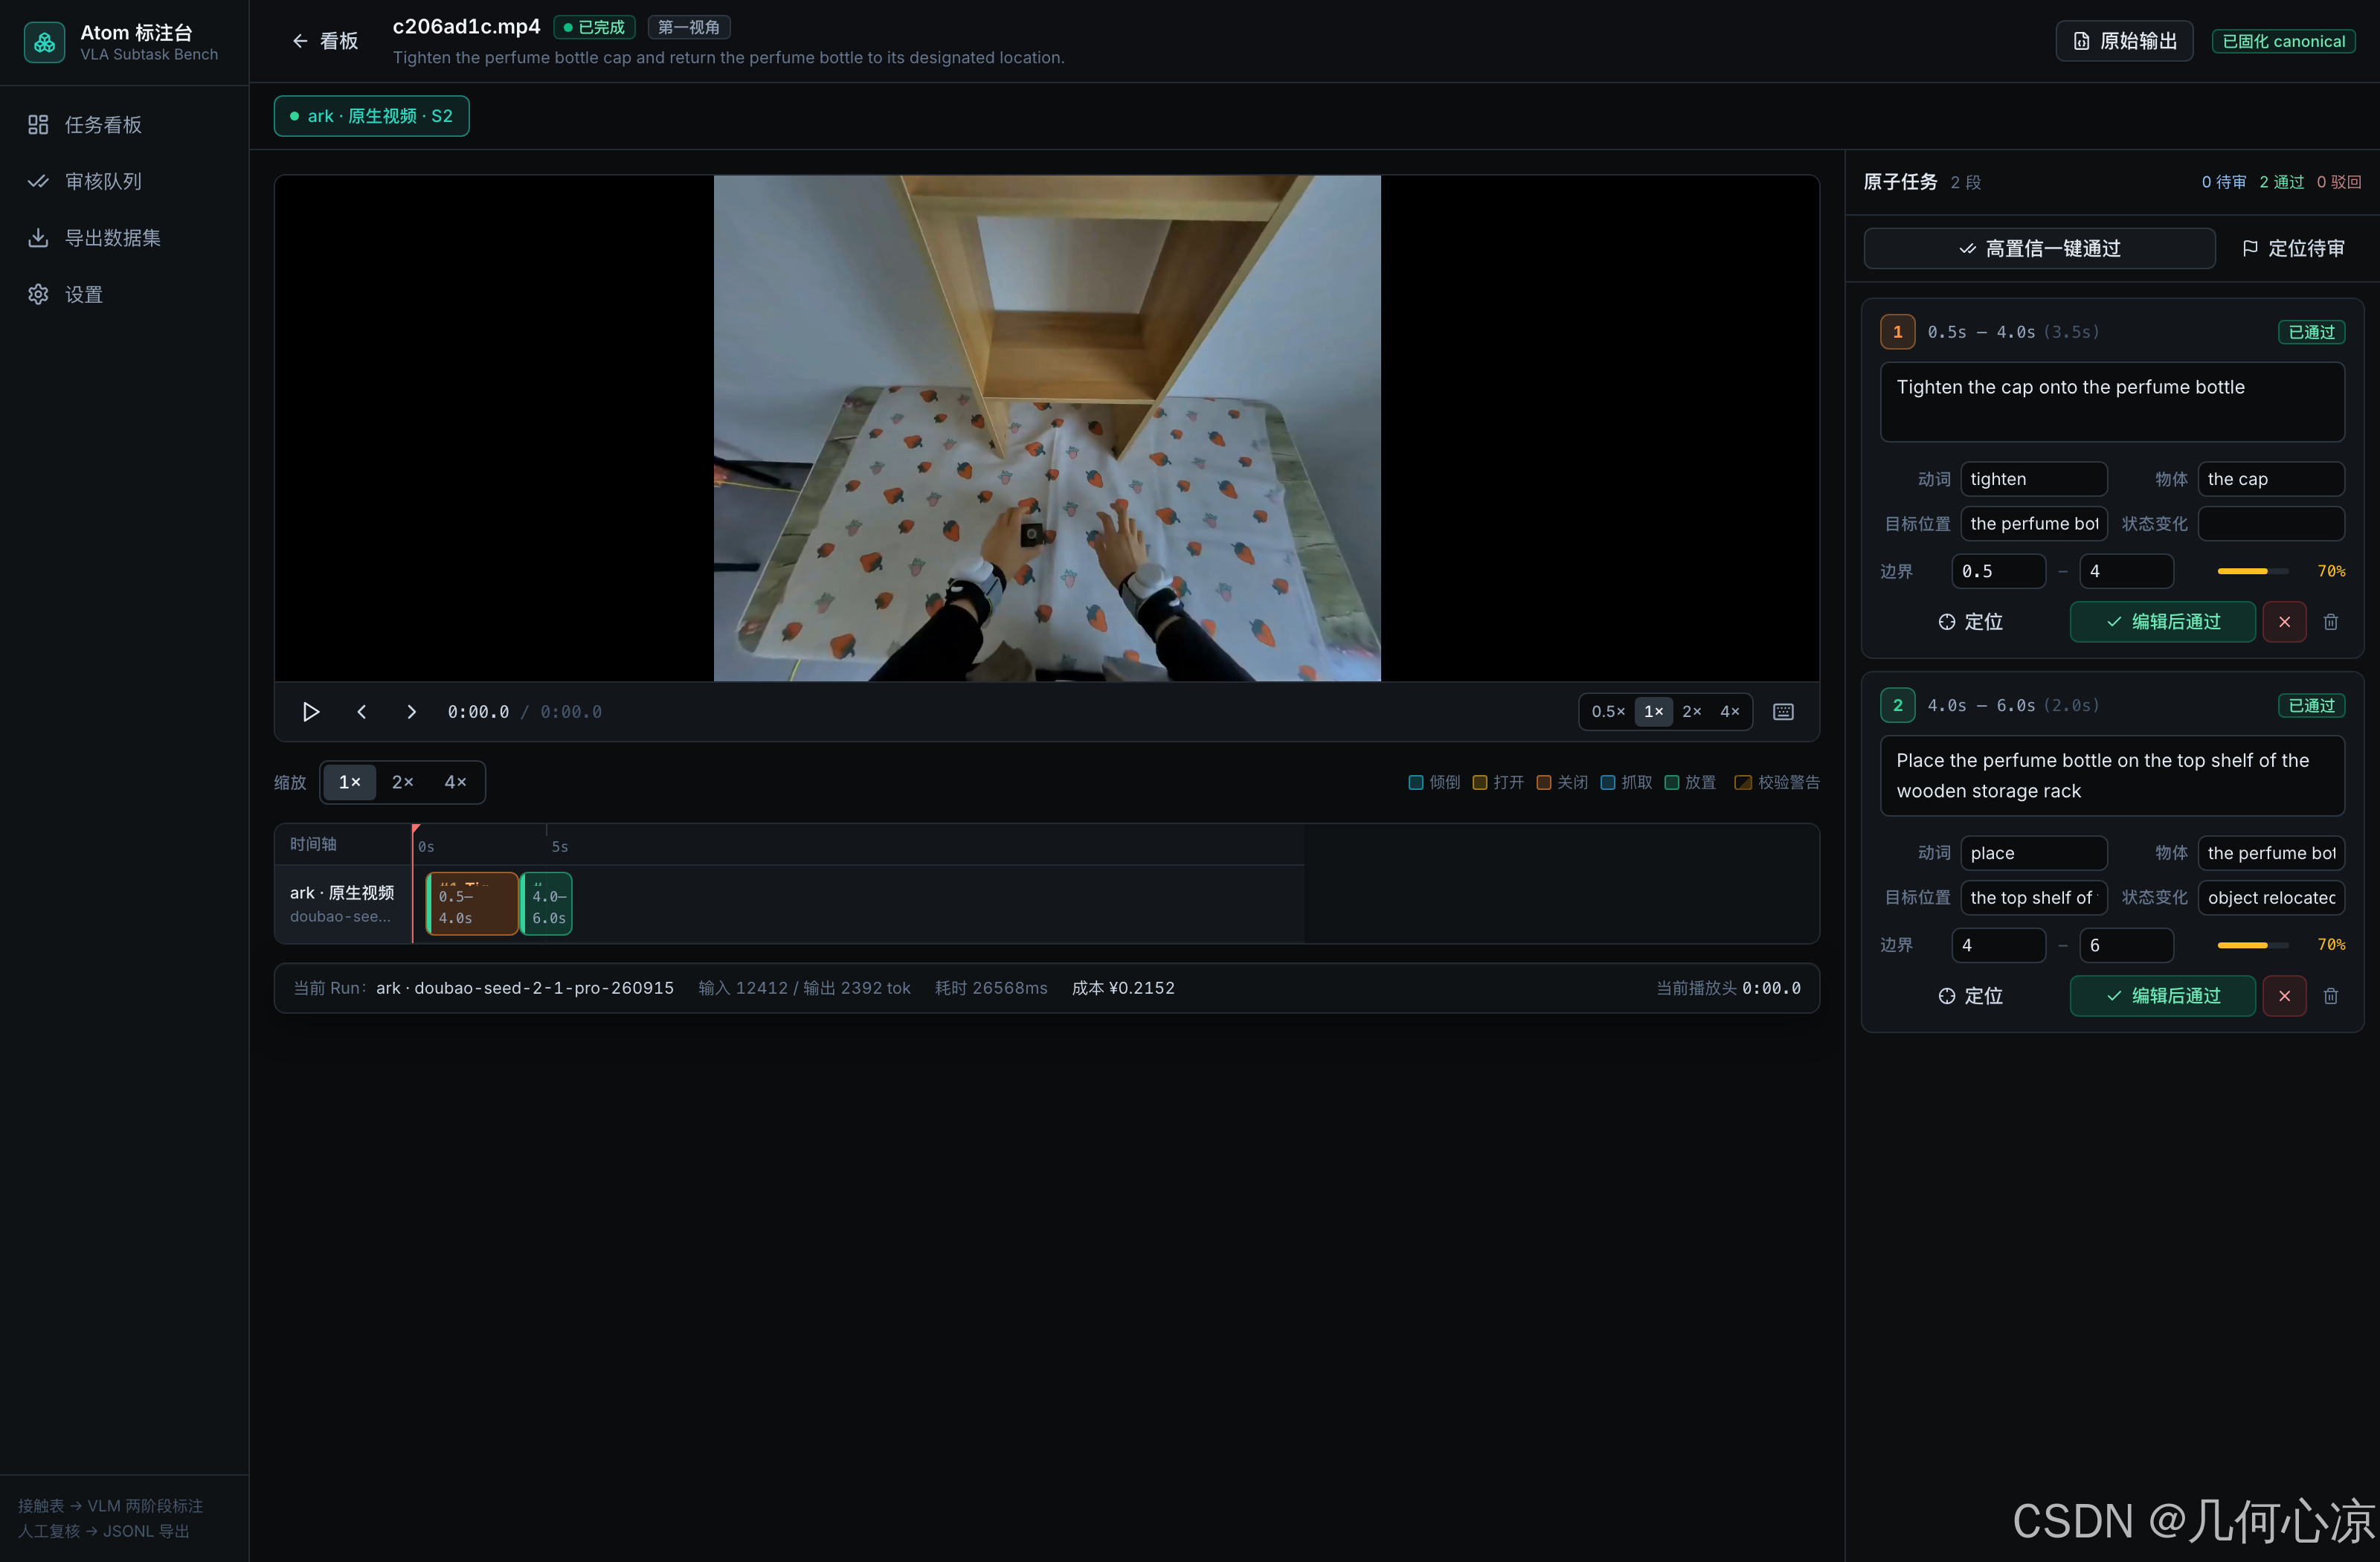
图 6 单条工作台:视频播放器、可拖拽时间轴、原子段结构化字段卡片,底部留痕当前 Run 的 token / 耗时 / 成本
点开「原始输出」抽屉,阶段一的完整响应 JSON、思考链原文和接触表证据文件都在——评测复现意识到位,也让我能直接核对它「想」的过程:思考链里它先复述切分原则,再逐段核对时间窗,最后才输出 JSON。
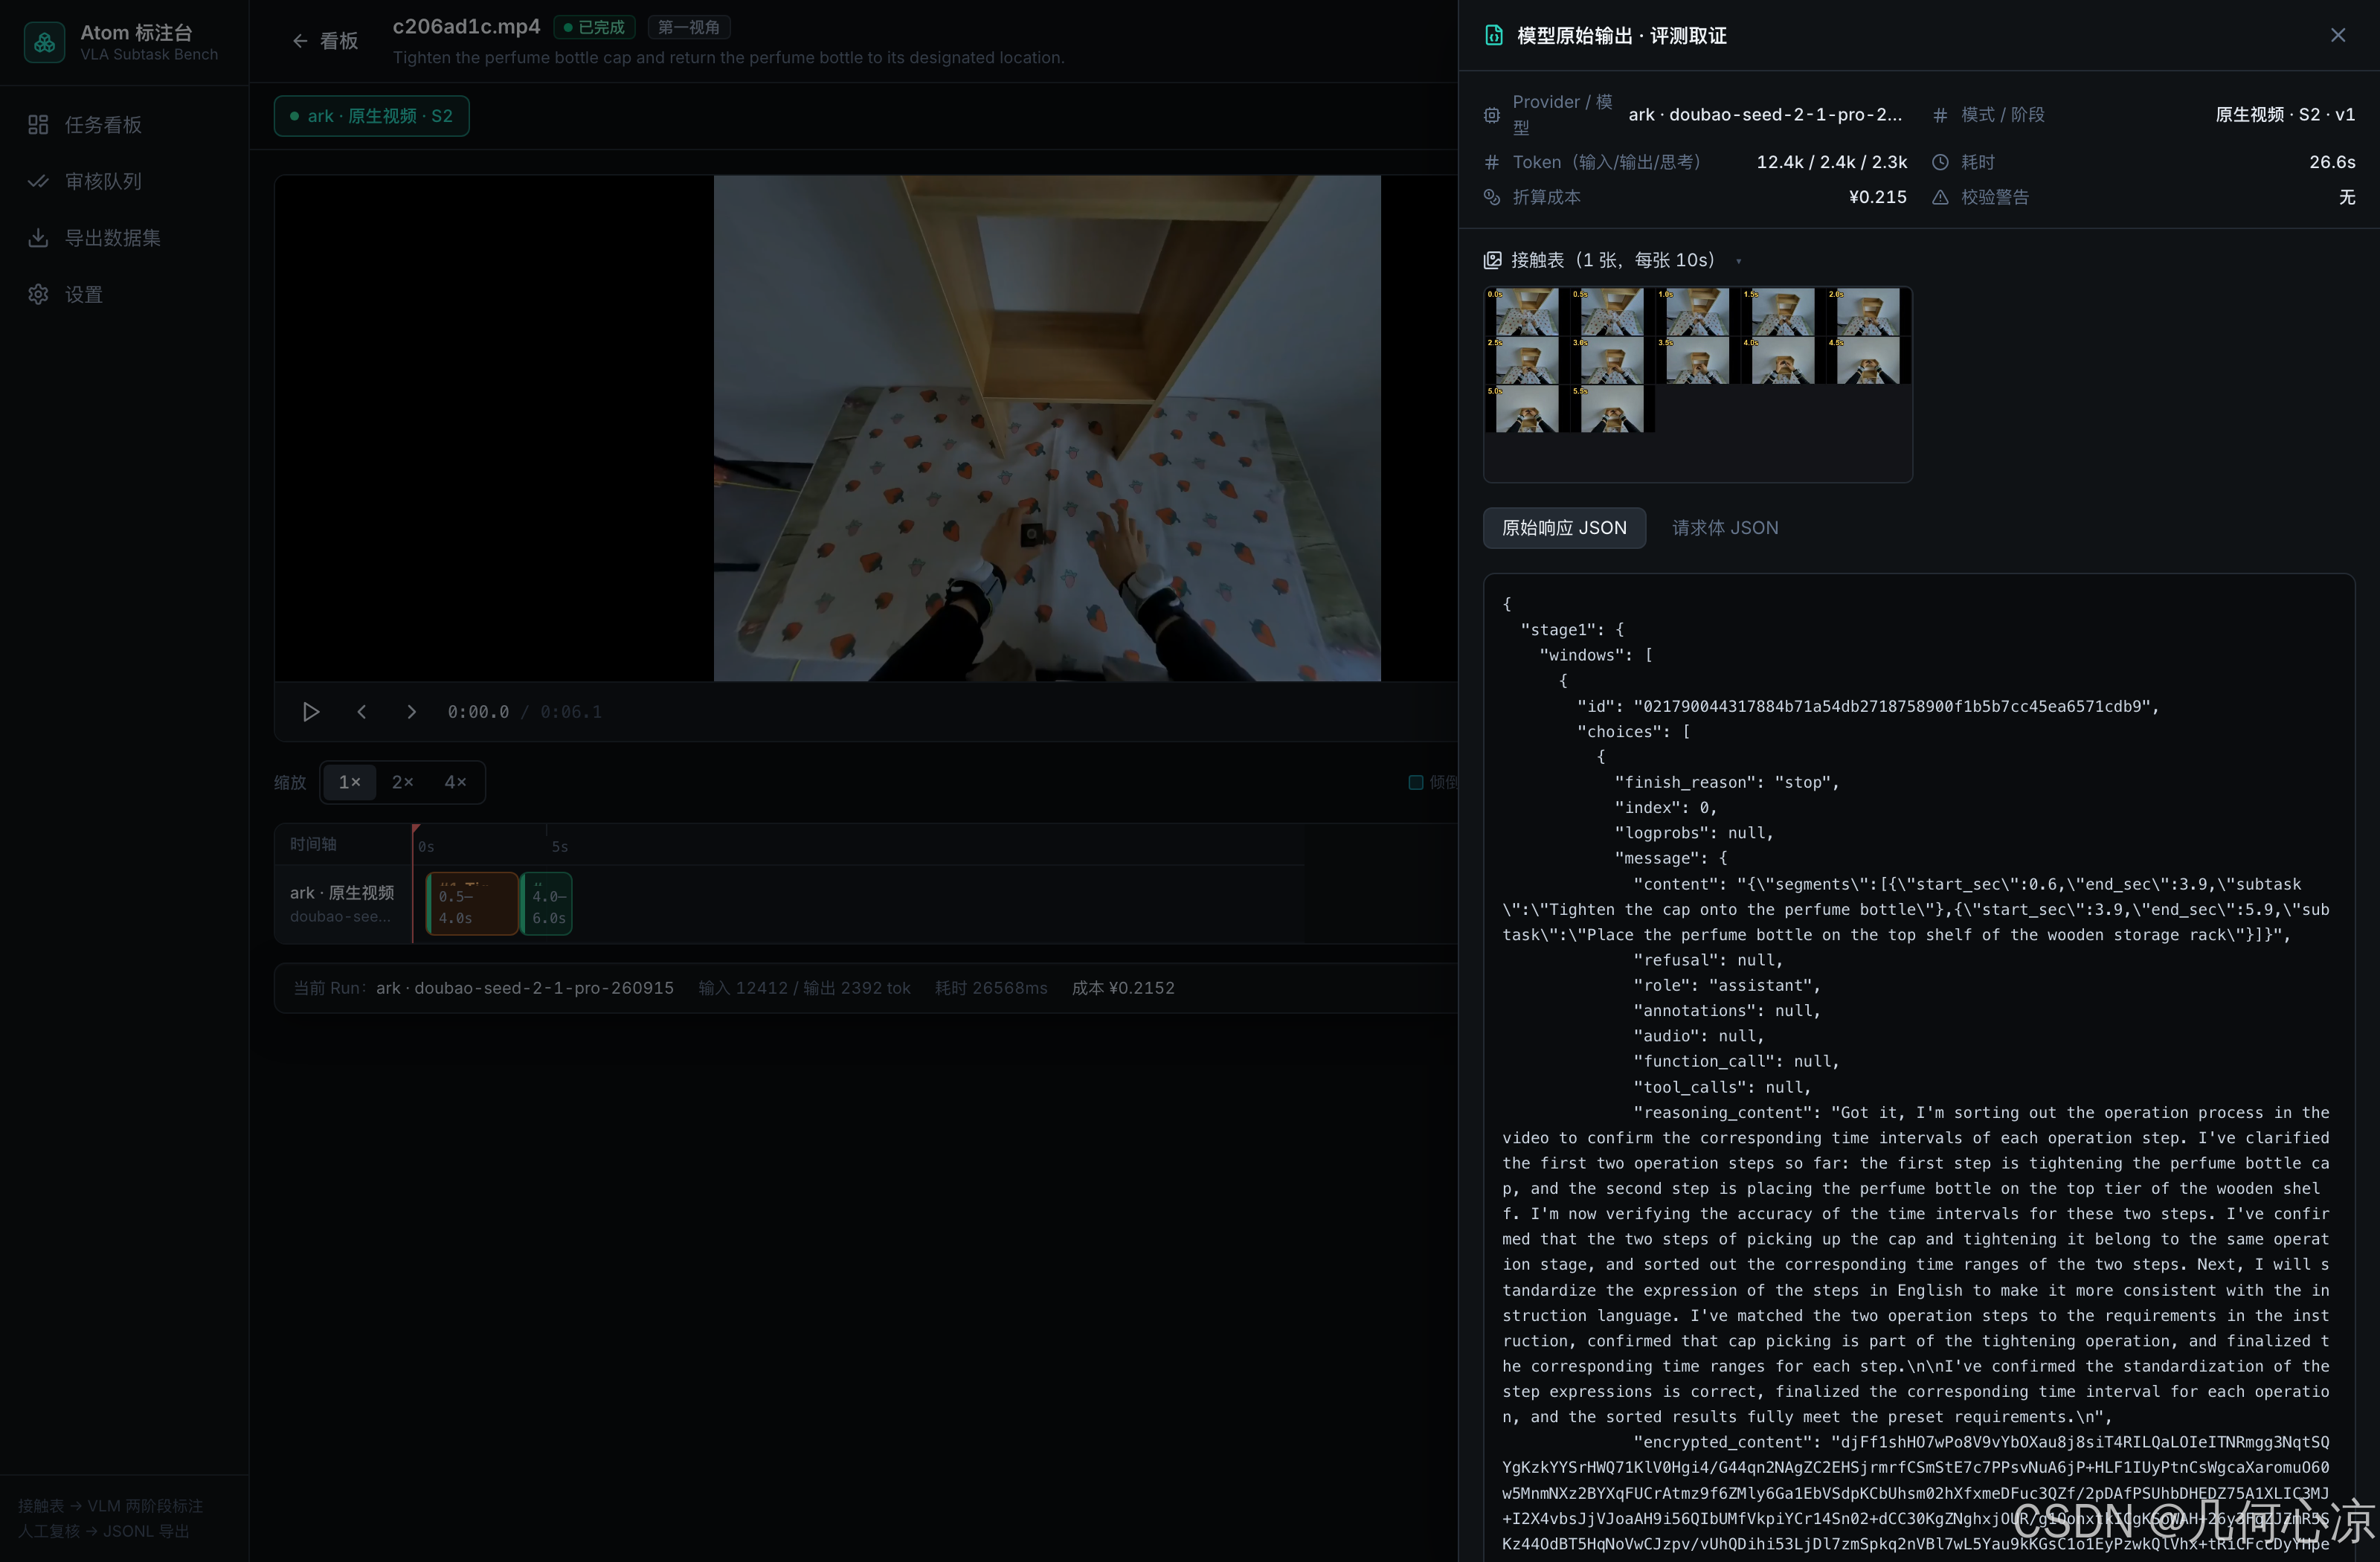
图 7 模型原始输出抽屉:响应 JSON、思考链原文、token(输入 / 输出 / 思考)与接触表证据文件全部留痕
人工复核被设计成独立的审核队列:低置信段排前,键盘流逐条处理(A 通过 / R 驳回、N / P 跳转),右侧卡片给出动作分解字段,顶部有审核进度条与「高置信全通过」。
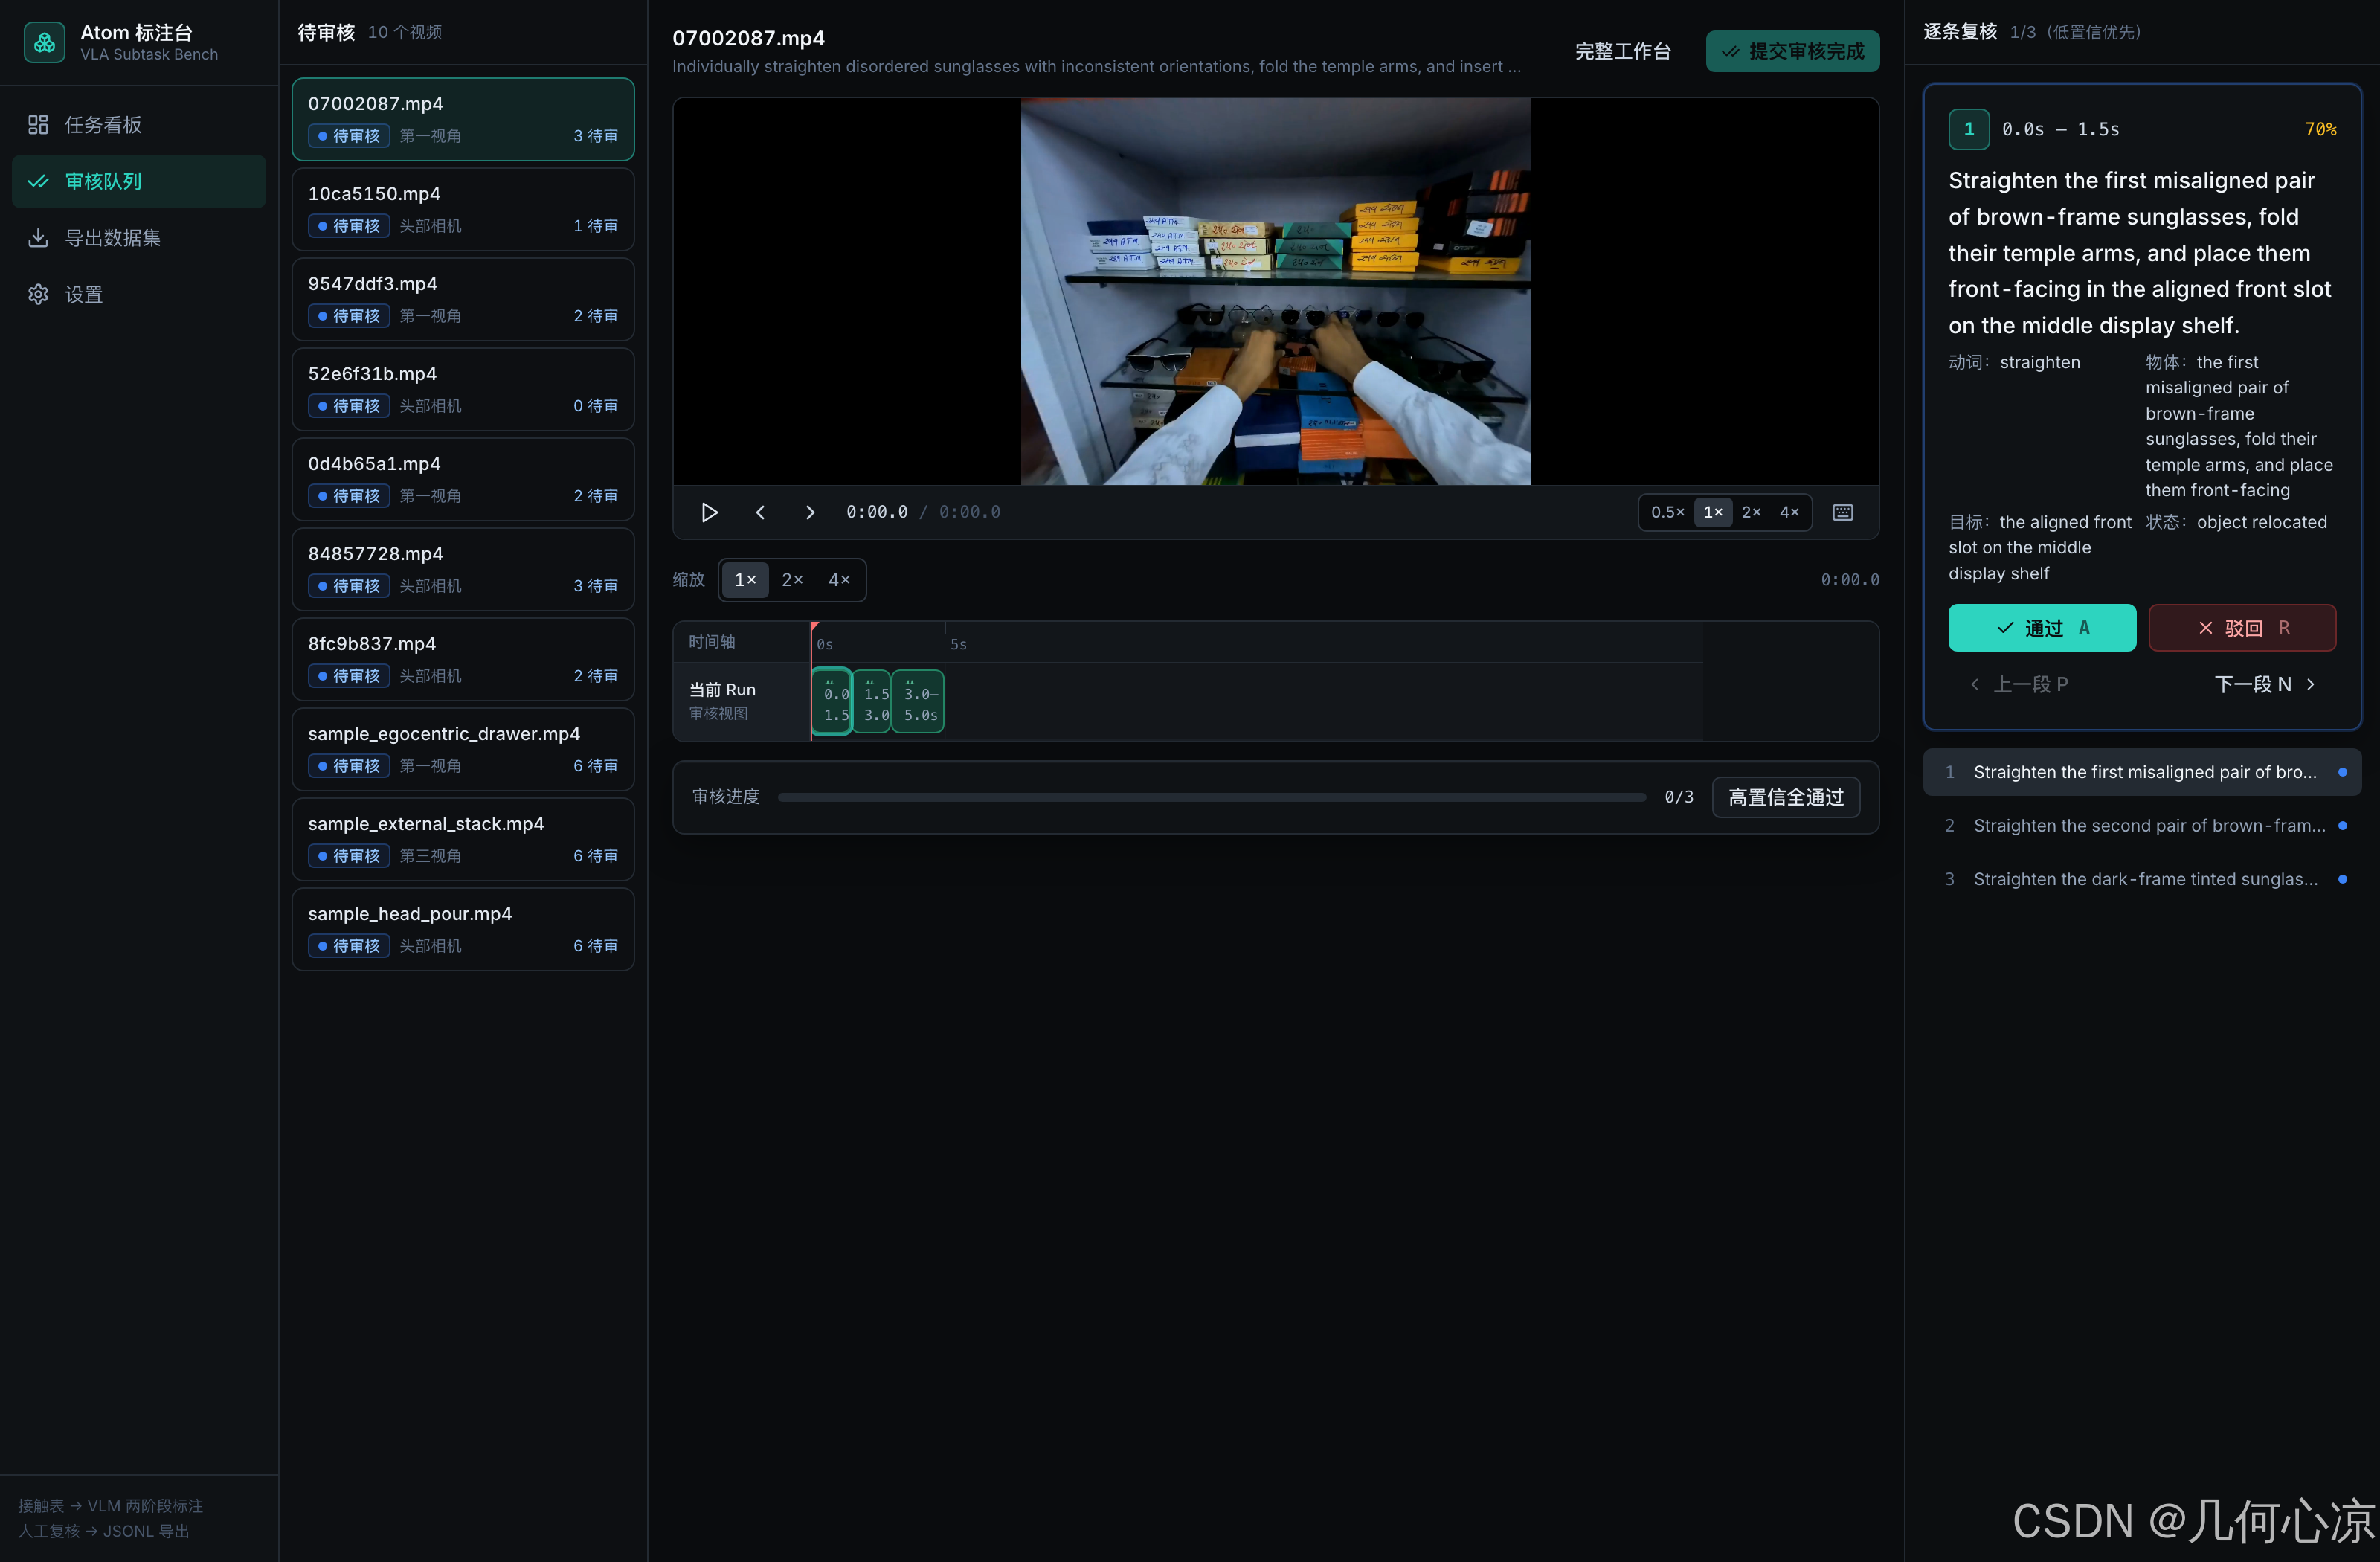
图 8 审核队列:视频列表、播放器、时间轴与逐段复核卡,低置信优先、键盘流操作
全部段复核通过后可「提交审核完成」,结果固化为 canonical 数据;导出页勾选字段、预览前三条 JSONL,再打包下载 ZIP / JSONL,直接对接下游训练数据脚本。
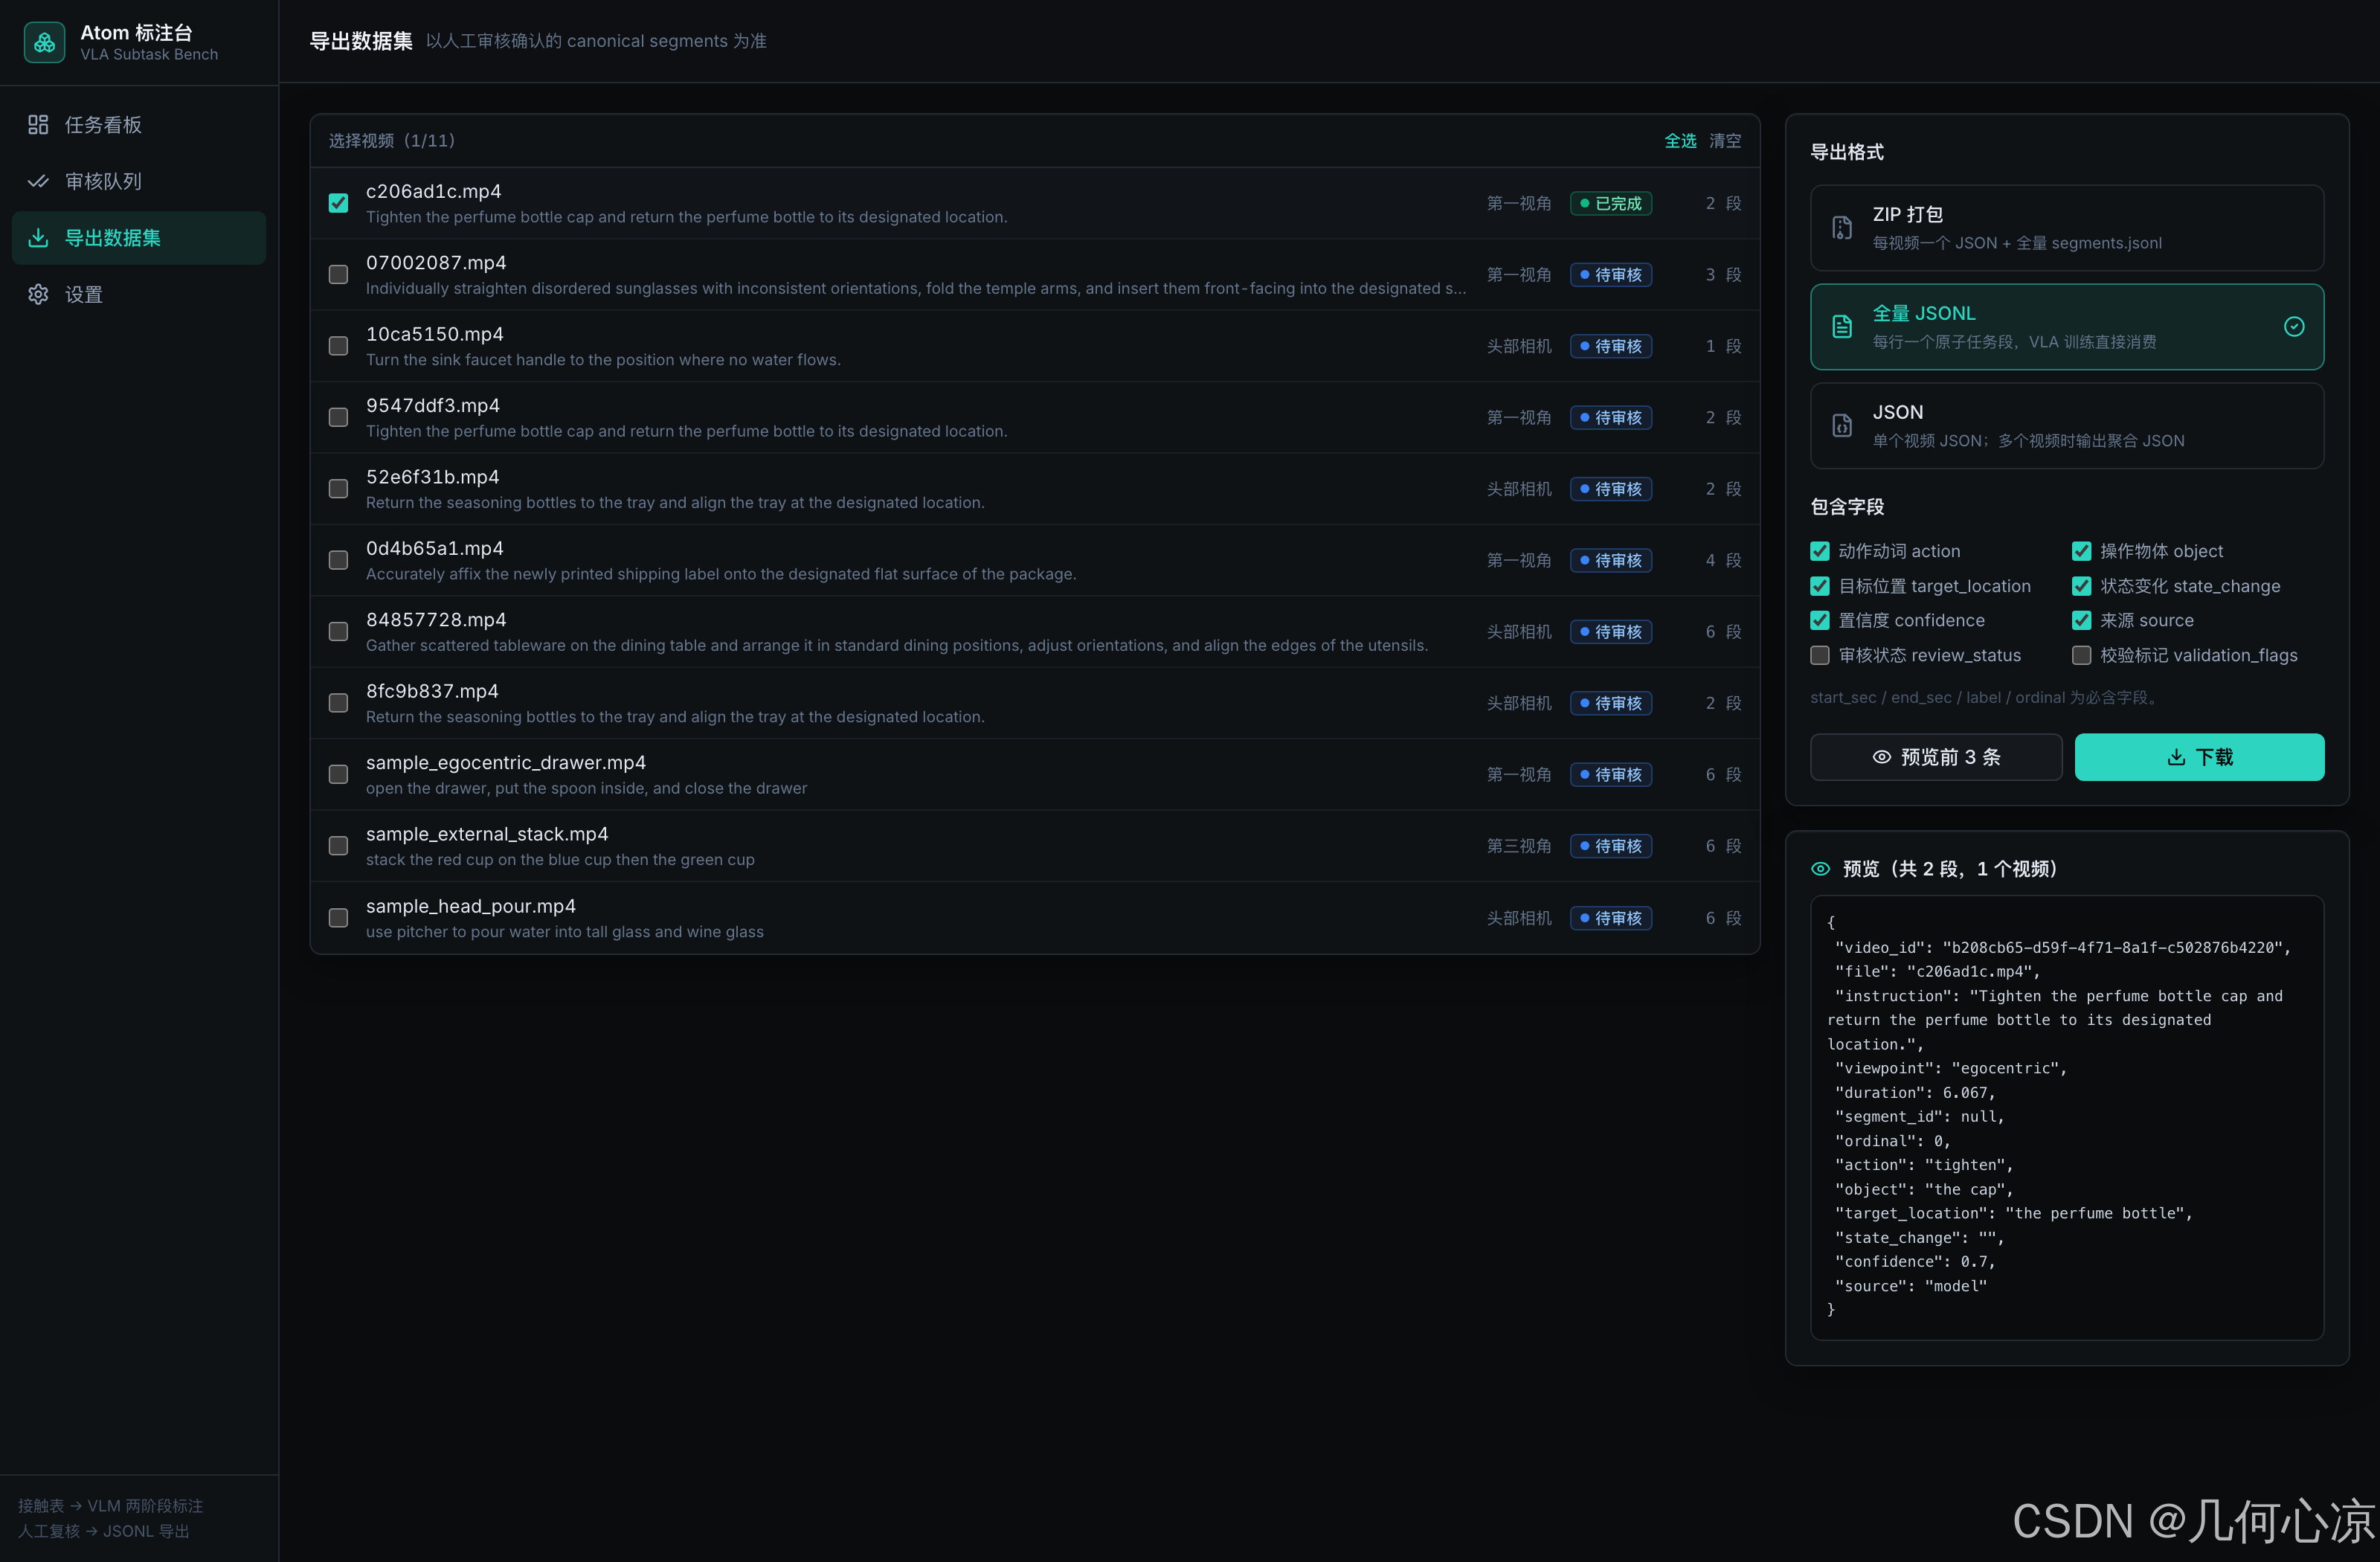
图 9 导出:以人工固化的 canonical segments 为准,字段可选,在线预览 JSONL 后打包下载
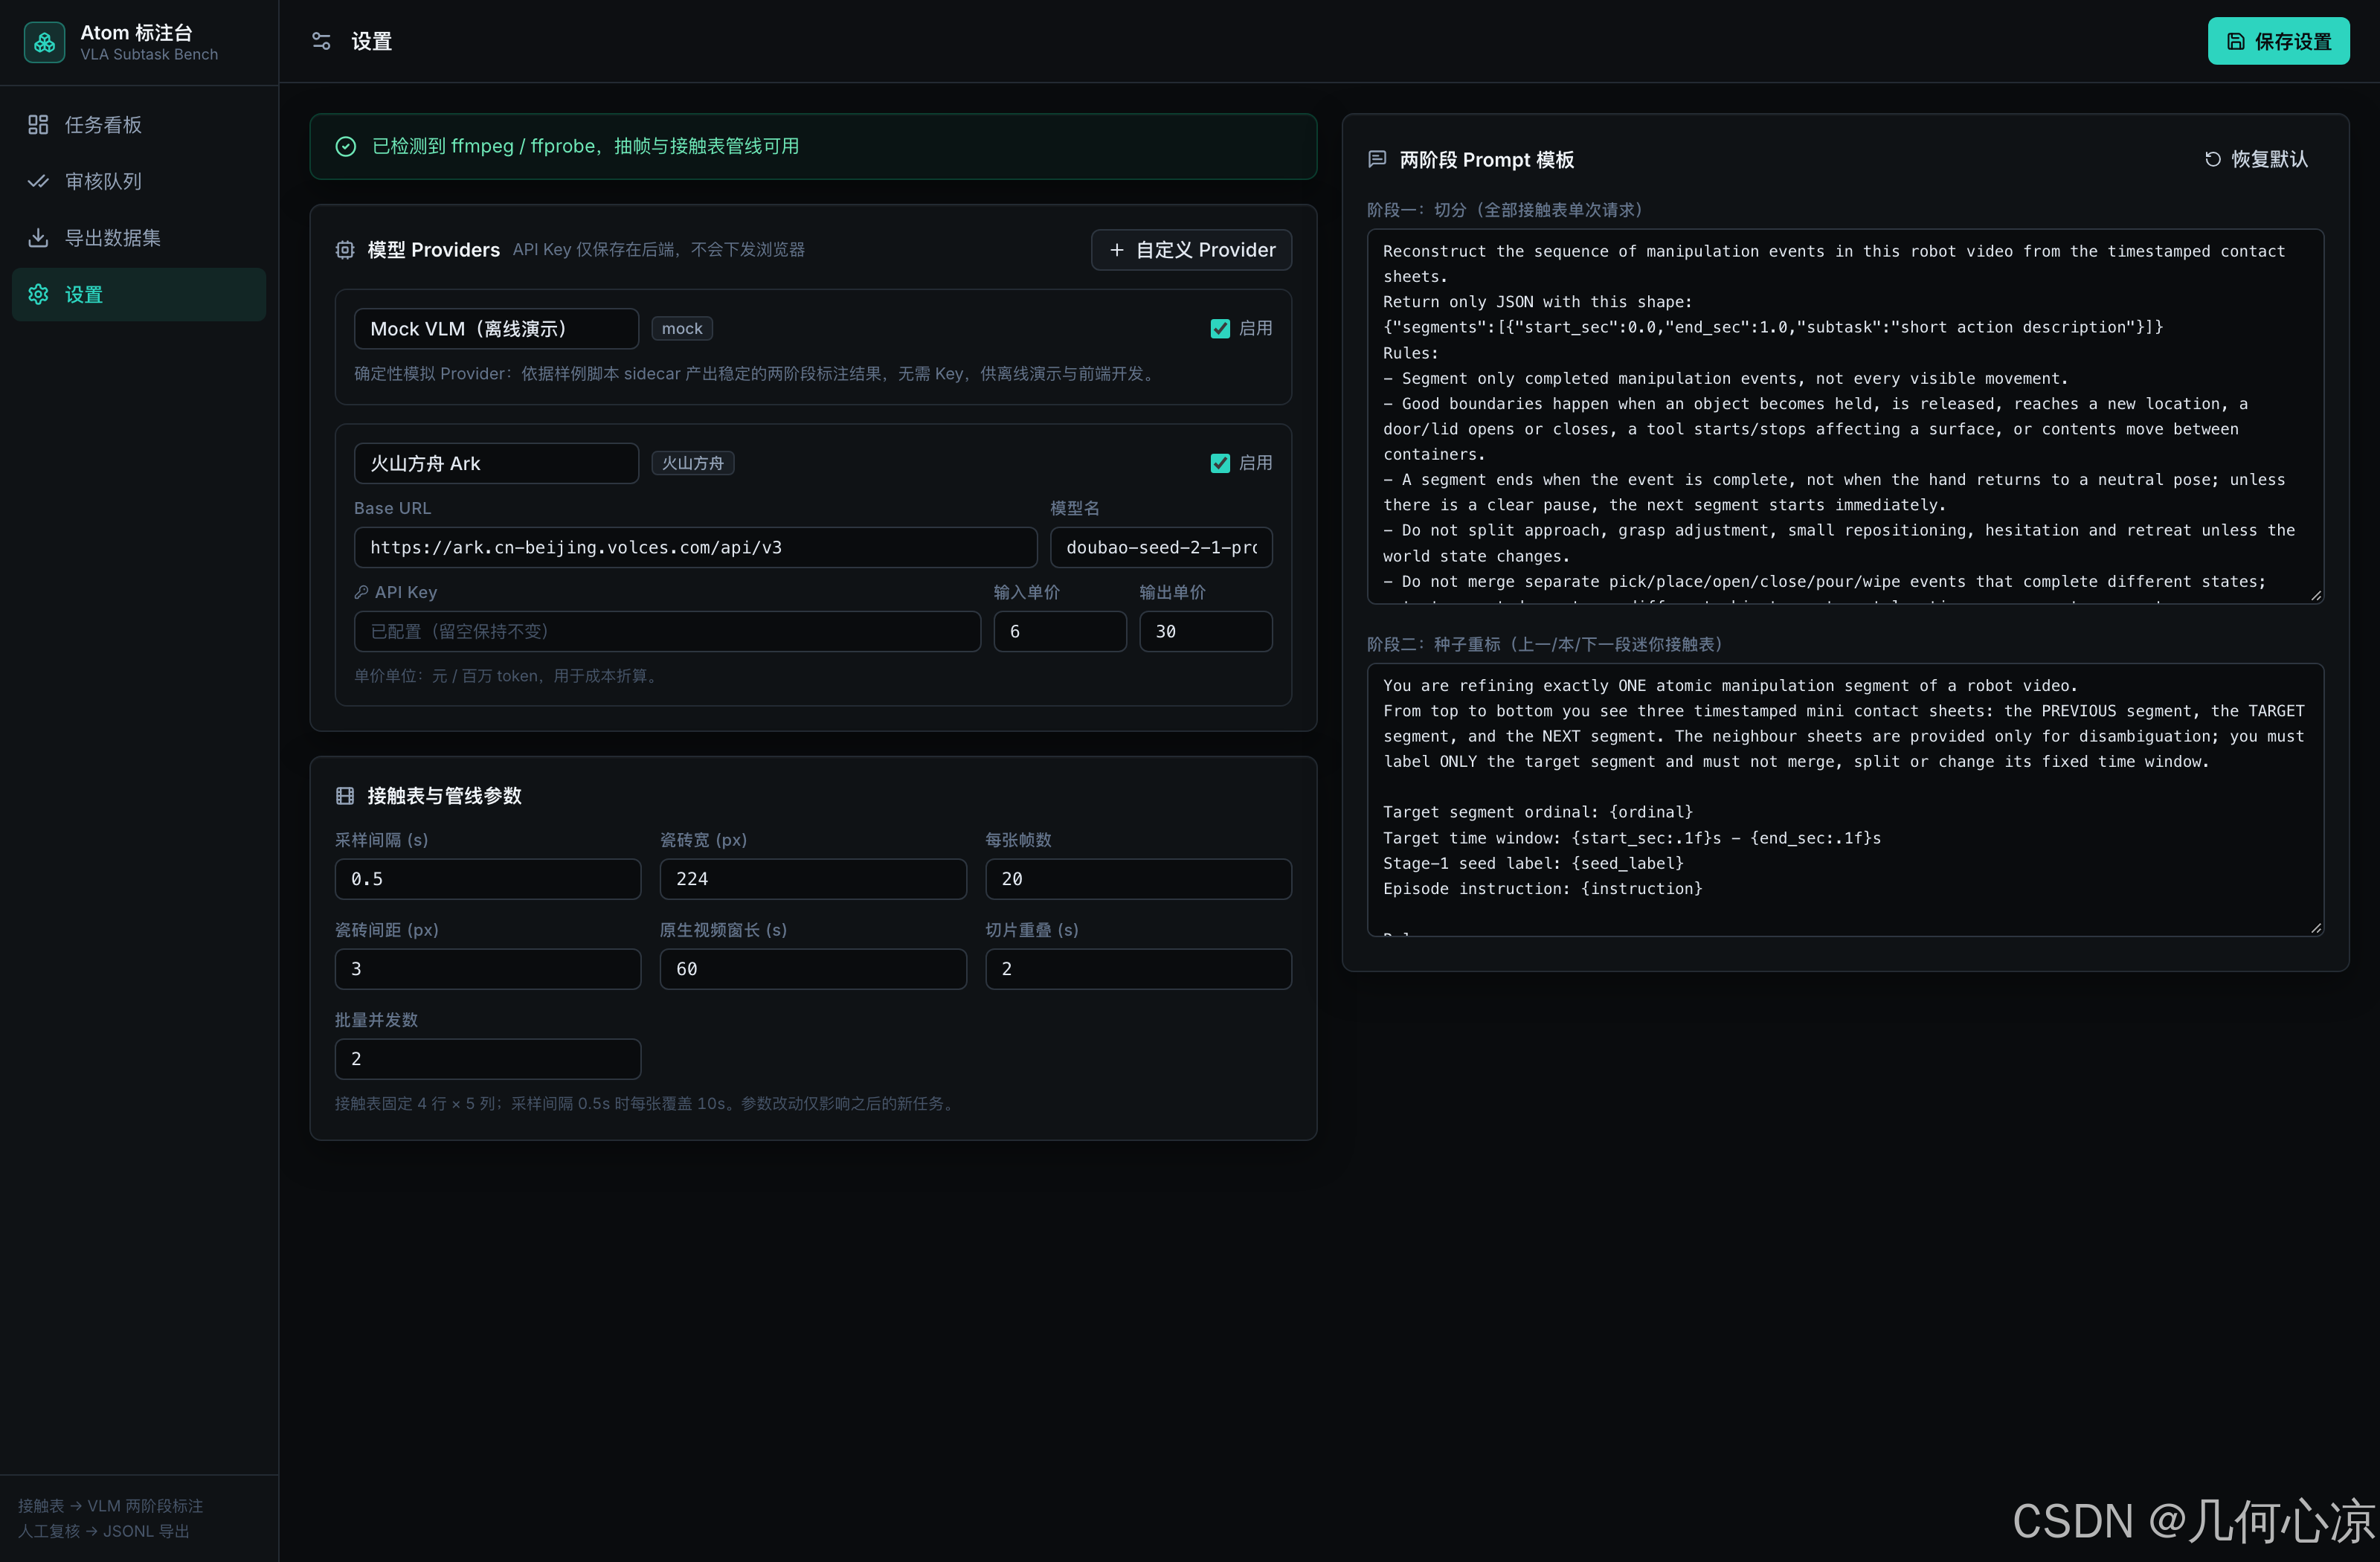
图 10 设置页:Provider 与单价、两阶段 Prompt 在线编辑、接触表与并发参数;Key 仅后端持有,前端只显示掩码状态
六、效果实测:21 个金标段上的五组配置
6.1 总览:一张大表和三个反直觉结论
五组配置在同一 8 集 / 21 段金标上的 micro 汇总如下(标签准确率给出两个裁判的口径,a = 0915 裁判、b = 0628 裁判;成本 / 时延为阶段一 + 阶段二合计的每集均值):
表 3 五组配置总览(n = 21 个金标段)
| 配置 | 精确率 | 召回 | Segment F1 | 标签 (一) a/b | 标签 (二) a/b | E2E (一) a/b | E2E (二) a/b | 输入 / 输出 tokens | 时延 / 条 | 成本 / 条 |
| 0915・接触表 | 33% | 29% | 31% | 33%/17% | 17%/17% | 10%/5% | 5%/5% | 11.7k / 0.1k | 10.6s | ¥0.073 |
| 0915・原生视频 | 48% | 48% | 48% | 50%/30% | 20%/10% | 24%/14% | 10%/5% | 17.9k / 0.1k | 13.2s | ¥0.111 |
| 0915・视频 + 思考 | 48% | 48% | 48% | 40%/20% | 10%/10% | 19%/10% | 5%/5% | 17.9k / 2.0k | 67.6s | ¥0.167 |
| 0628・接触表 | 26% | 29% | 27% | 17%/0% | 17%/0% | 5%/0% | 5%/0% | 14.3k / 0.1k | 12.1s | ¥0.090 |
| 0628・原生视频 | 52% | 52% | 52% | 46%/46% | 18%/18% | 24%/24% | 10%/10% | 17.9k / 0.1k | 13.3s | ¥0.111 |
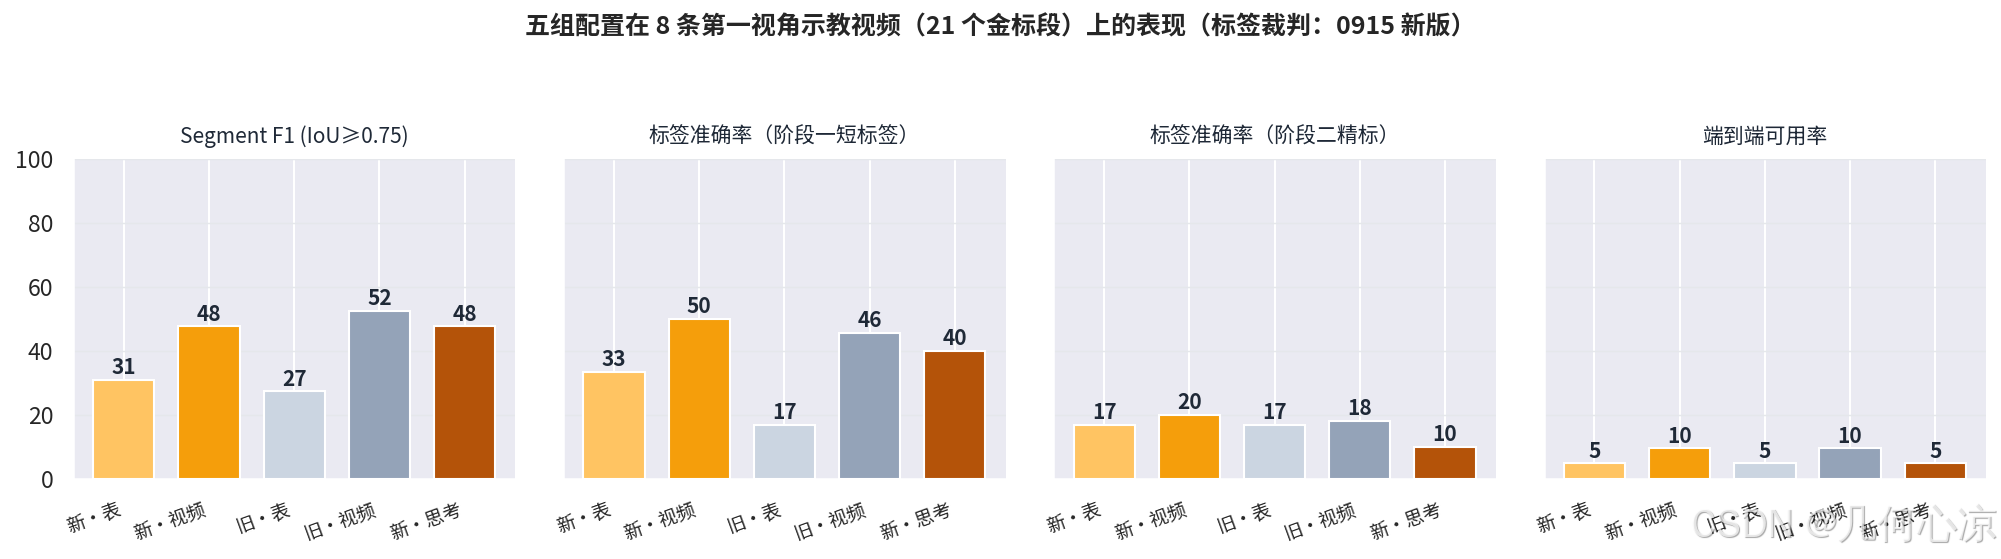
图 11 五组配置的 Segment F1、阶段一 / 二标签准确率、端到端可用率(标签为 0915 裁判口径)
逐集的时间窗命中情况(tp / 预测段数)如下,它比总表更能暴露问题分布:
表 4 逐集时间窗命中(tp / 预测段数)
| 集(任务) | 金标 | 新・表 | 新・视 | 新・思 | 旧・表 | 旧・视 |
| 8fc9b837 调料瓶排列(台面) | 3 | 1/2 | 1/2 | 0/2 | 0/3 | 1/2 |
| 84857728 餐具摆放 | 3 | 2/3 | 2/3 | 2/3 | 2/5 | 2/3 |
| 0d4b65a1 贴快递单 | 2 | 0/2 | 0/4 | 0/4 | 0/4 | 0/4 |
| 52e6f31b 调料瓶入收纳盒 | 3 | 2/2 | 2/3 | 2/3 | 2/2 | 1/2 |
| 9547ddf3 香水瓶盖上架 | 3 | 0/3 | 1/2 | 1/2 | 0/3 | 3/3 |
| 10ca5150 关水龙头 | 2 | 0/1 | 0/1 | 0/1 | 1/2 | 0/1 |
| 07002087 墨镜归位 | 3 | 0/2 | 2/4 | 3/4 | 0/1 | 3/3 |
| c206ad1c 香水瓶盖上架 | 2 | 1/3 | 2/2 | 2/2 | 1/3 | 1/3 |
这张表里有三个反直觉的结论,后文逐一展开:
- 原生视频稳定赢接触表,但在夹爪视频上两者打平(6.4);
- 深度思考开关对切分零贡献,标签反而更差、成本翻倍(7.2);
- 阶段二精标在这批短视频上没有净收益,多数配置标签准确率反而下降(见表 3 的阶段一 / 二标签两列)。
6.2 成功 case:边界与标签一次全对
c206ad1c(拧香水瓶盖并上架,6.1s,金标 2 段)是最干净的成功 case:0915 新版在原生视频路径下输出 2 段,边界吸附后与金标完全重合,F1 = 1.0,两个标签「tighten the perfume bottle cap」「place the perfume bottle on the top layer of the wooden shelf」在新旧两个裁判下均判定通过。
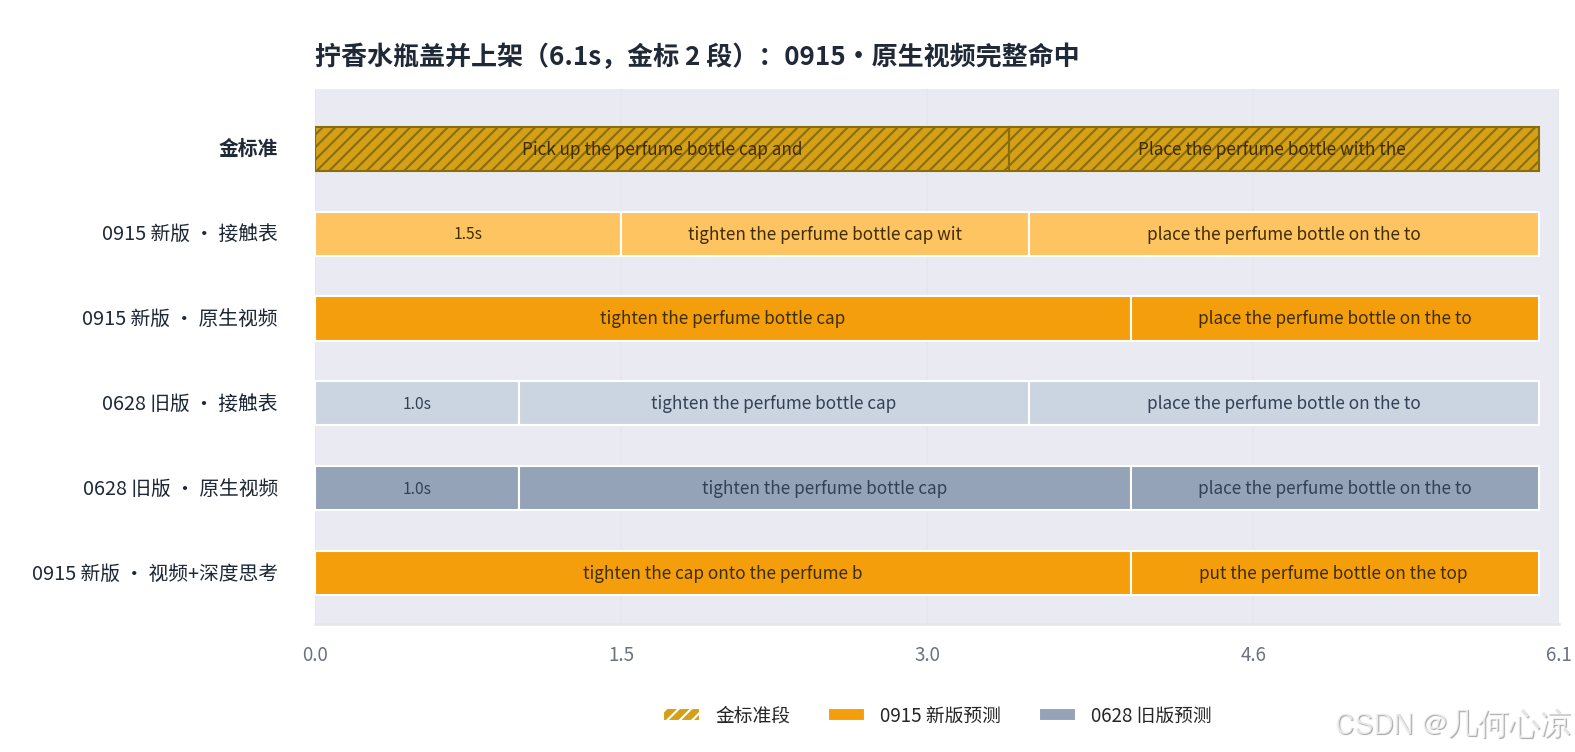
图 12 拧香水瓶盖并上架:0915・原生视频(及思考组)切出 2 段与金标完全重合;接触表路径过分割为 3 段
这类「两个动作、中间有明确状态切换、物体在画面中占比大」的视频,是当前 VLM 自动标注最舒服的区间:切分和语义都可以直接进人工复核的「一键确认」队列。
6.3 失败 case:粒度错配是最大误差源
0d4b65a1(贴快递单,12.8s,自然人手)是五组配置全部零命中的一集,而且失败方式高度一致:金标只切了 2 个粗段(「拿起并撕离底纸」4.4s、「贴到包裹上」8.0s),所有模型都切成了 4 个更细的事件(拿起 → 撕底纸 → 放置 → 抹平)。模型的切分从动作语义上并不算错,甚至更符合「原子」直觉,但它与数据方既定的标注粒度规范不一致——IoU 再宽容也救不回一对多的结构 mismatch。
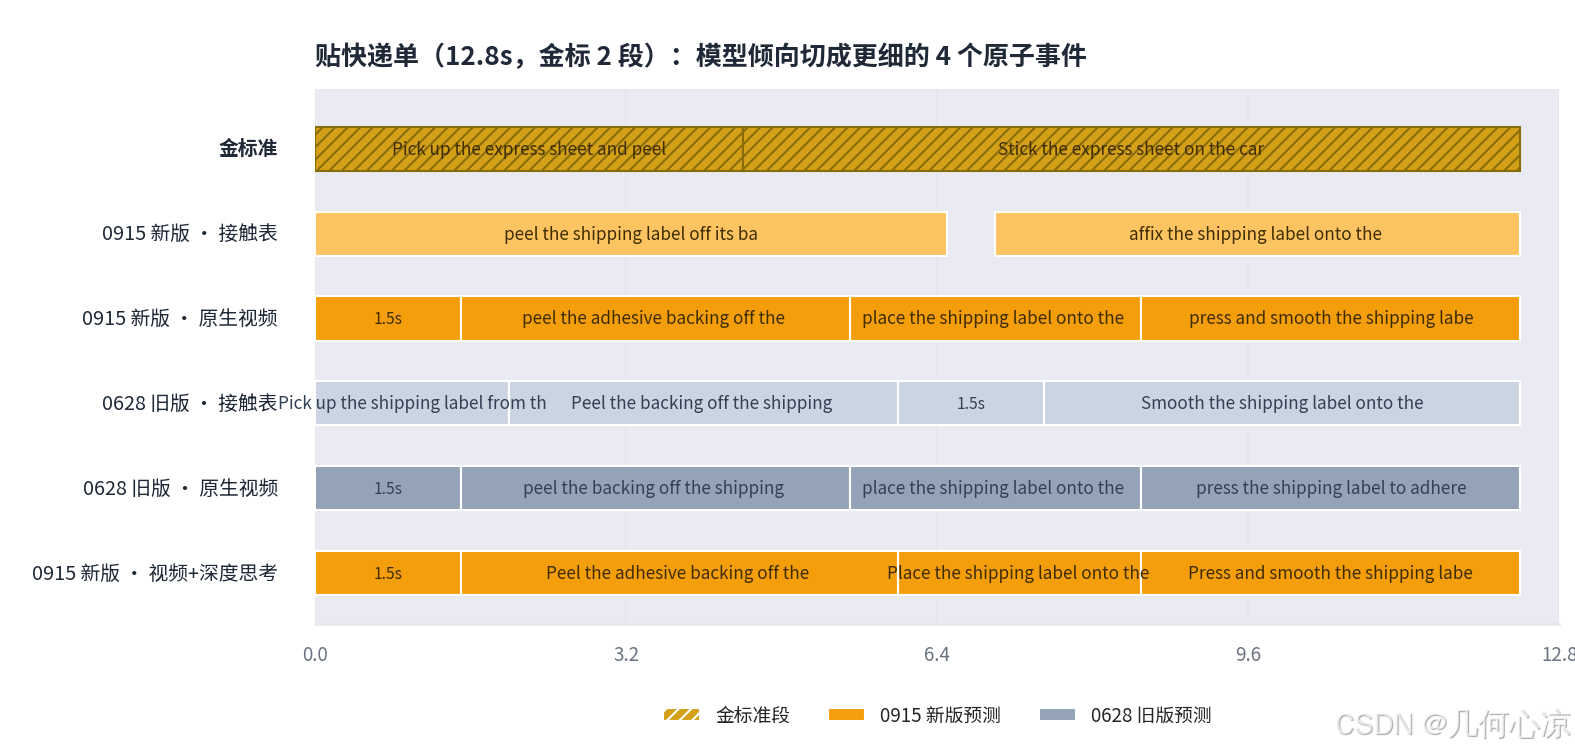
图 13 贴快递单:金标 2 个粗段,五组配置一致过分割为 4 个细事件,时间窗全部无法匹配
这说明自动标注管线真正要对齐的不是「动作本身」,而是数据集的粒度约定。工程上的对策也明确:阶段一 Prompt 里给 2–3 个该数据集的金标样例(few-shot 锚定粒度),比换更强的模型更有效。这是我下一步会补的实验。
另一类系统性错误是物体幻觉,而且它暴露了一个输入路径之间的差异。8fc9b837 的画面里只有台面角落、没有托盘,金标是「把调料瓶移到台面角落排成一排」。翻看各配置的输出:新旧两版的原生视频路径都稳定输出「放入收纳托盘(storage tray)」,而两版的接触表路径都正确识别为「在台面上排成一排」——同一模型在不同输入形态下的表现分叉,说明这更像视频抽帧后的视觉先验问题,靠模型自检很难发现,必须靠人工或物体清单校验兜住。
6.4 分层看短板:短动作、长粗段,与两种采集范式
按金标段长分层统计时间切分召回:
表 5 按金标段长分层的召回率(分母为该层金标段数)
| 段长分层 | 金标数 | 新・表 | 新・视 | 新・思 | 旧・表 | 旧・视 |
| 短段 <2s | 6 | 0% | 33% | 33% | 17% | 50% |
| 中段 2–5s | 14 | 43% | 57% | 57% | 36% | 57% |
| 长段 5–10s | 1 | 0% | 0% | 0% | 0% | 0% |
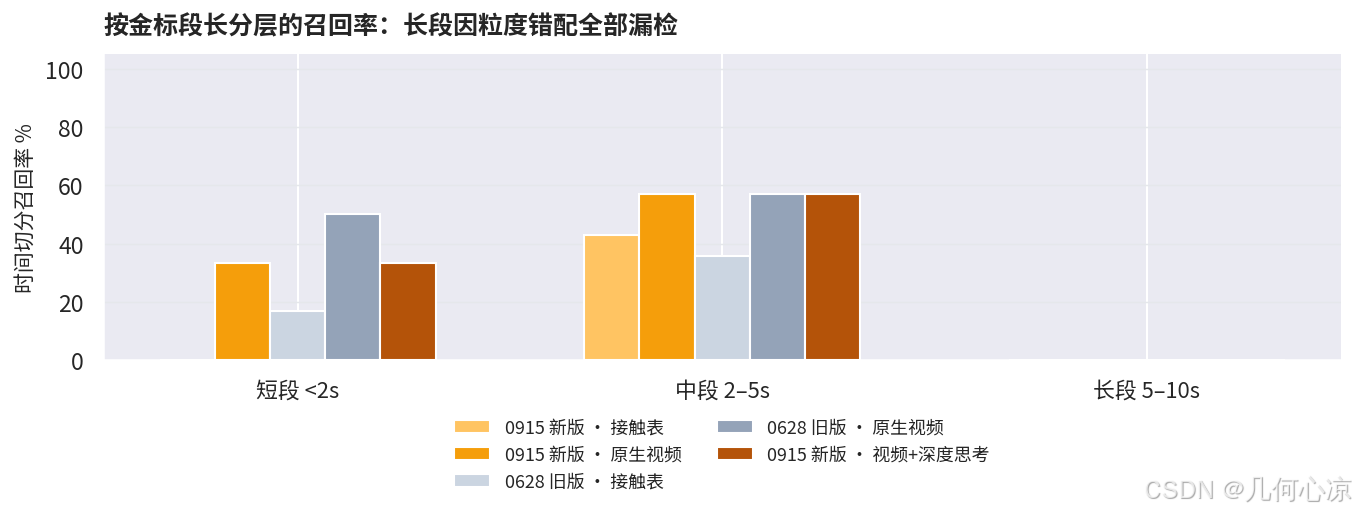
图 14 按金标段长分层的召回率:中段是主战场,长粗段因粒度错配全部漏检
中段(2–5s)是模型的舒适区,原生视频路径召回 57%;短动作(<2s)普遍吃力,接触表路径最差时 0/6;唯一的长段(贴快递单 8s 段)因前述粒度错配零命中。这与 Macrodata 在 743 段上的观察方向一致(他们报告 <2s 段召回仅 7.4%),短动作漏检是当前视频模型的共性短板。
更有意思的是按采集范式分层(4 集夹爪 / 4 集自然人手):
表 6 两种采集范式下的 Segment F1
| 范式(金标段数) | 新・表 | 新・视 | 新・思 | 旧・表 | 旧・视 |
| 机器人夹爪(11) | 53% | 50% | 40% | 43% | 42% |
| 自然人手(10) | 10% | 45% | 55% | 10% | 61% |
接触表在夹爪视频上并不输原生视频(0915 新版 F1 53% vs 50%)——夹爪特写里动作主体大、帧间信息密度高;但在自然人手视频上,接触表路径直接崩到 10%,原生视频则保持在 45%–61%。我的理解是:人手操作的场景上下文(身体姿态、桌面全局布局、双手配合)只有在连续视频里才完整,0.5s 抽样的静态帧网格把这些信息丢了。结论是输入形态要按素材类型选,而不是默认全上视频或全上接触表。
七、0915 新版 vs 0628 旧版:提升点、思考消融与成本账
7.1 新旧对比:切分打平,标签与 token 效率是看得见的提升
先看切分:同路径对比,原生视频 F1 为 48%(新)vs 52%(旧),接触表为 31% vs 27%。n = 21 时 1 个命中就是 5 个百分点,这几个点的差异在噪声范围内,不能解读为谁更强——可以负责任地说,0915 新版在切分精度上没有退步。
真正的提升在标签侧,而且跨裁判口径方向一致:
- 接触表路径标签准确率翻倍:0915 裁判口径 17% → 33%,0628 裁判口径 0% → 17%。接触表路径要求模型从静态帧网格里同时读时间戳和动作语义,这正是官方升级材料里点名加强的「视频标注」场景,提升是肉眼可见的;
- 视频路径标签稳中有升:0915 裁判口径 46% → 50%;
- token 效率:接触表路径输入 token 从 14.3k / 集降到 11.7k / 集(-18%),单条成本从 ¥0.090 降到 ¥0.073。
再加上第五章展示的能力——一份需求文档独立交付一个全栈标注系统——0915 新版的升级不是单点刷分,而是「读视频写标签更准、跑图更省、还能自己把工具造出来」的组合提升。对于具身数据团队,这意味着同一份预算可以跑更多预标量,且工具链本身也可以交给模型搭。
7.2 深度思考消融:切分零增益,成本时延双输
思考组与同模型关思考的视频组切分总命中数相同(F1 都是 48%,逐集看互有一集的增减),但阶段一标签从 50% 降到 40%,端到端从 24% 降到 19%;代价是输出 token 从 0.1k / 条涨到 2.0k / 条(含推理 token),平均时延从 13.2s / 条涨到 67.6s / 条(最慢一集 237 秒),单条成本从 ¥0.111 涨到 ¥0.167。
这是一个明确的选型结论:结构化、有唯一正确输出的视频切分任务上,默认关思考。 0915 新版把深度思考做成了可调开关,这本身是对的——思考更适合开放式分析,而不是「输出时间码 JSON」这种收敛任务,冗长的推理链反而会干扰最终标签的措辞。Atom 标注台默认开思考跑出 ¥3.39 / 分钟的账单(5.3 节),与这里的消融互为印证。
7.3 双 LLM 裁判:一致率 84.9%
两个模型各盲评一次阶段一的时间命中段对,53 个判定中一致 45 个,一致率 84.9%;8 个不一致主要集中在「容器类名词是否算语义等价」(tray / box / counter 之间),0628 裁判整体更严。本文所有图表主口径用 0915 裁判、表格同时给出 b 列,正是为了避免「谁出题谁阅卷」。LLM 裁判本身也有约 15% 的不确定性,这是小样本评测必须交代的误差带。
7.4 成本与时延:每分钟视频不到一块钱
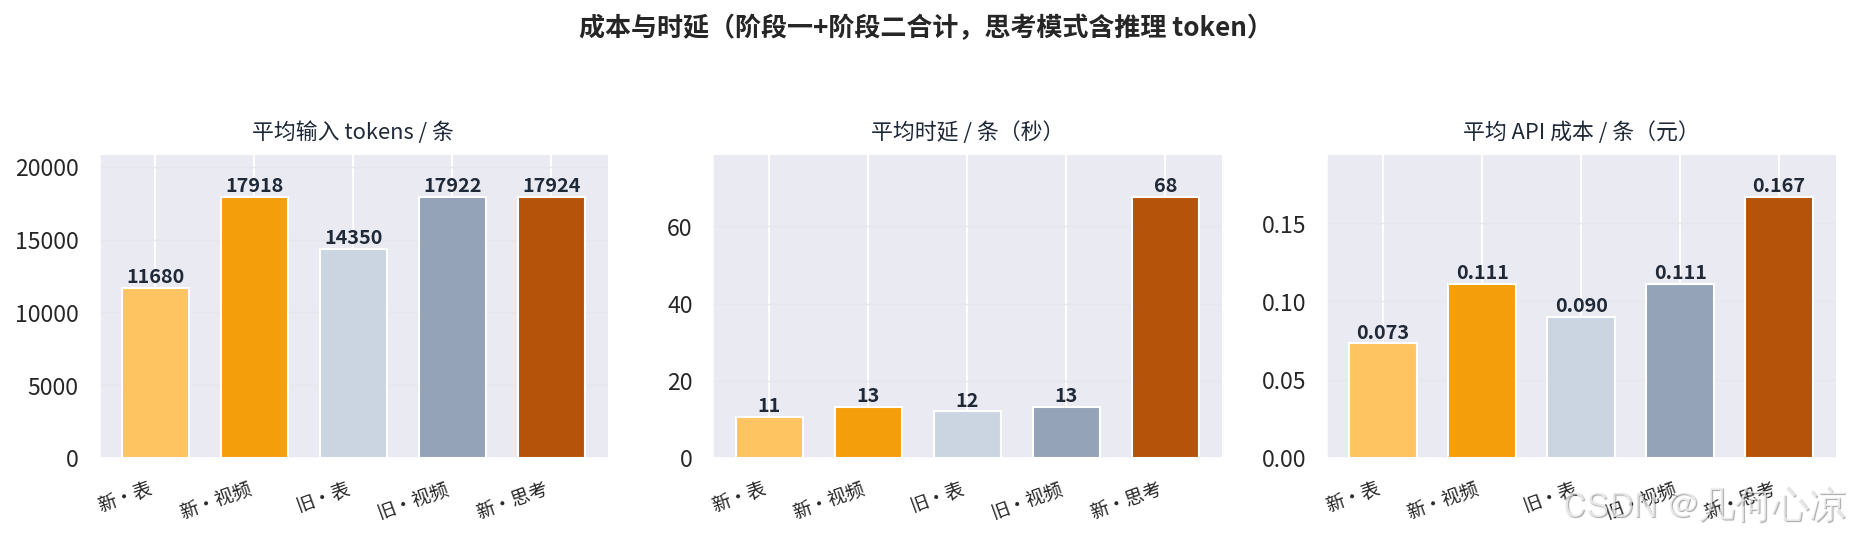
图 15 五组配置的平均输入 tokens、时延与 API 成本(阶段一 + 阶段二合计)
按总素材 56.3 秒折算到每分钟视频:
表 7 折算每分钟视频的 API 成本与时延
| 配置 | 元 / 分钟视频 | 处理时延 / 分钟视频 |
| 0915・接触表 | ¥0.63 | 90s |
| 0915・原生视频 | ¥0.95 | 113s |
| 0915・视频 + 思考 | ¥1.42 | 577s |
| 0628・接触表 | ¥0.77 | 103s |
| 0628・原生视频 | ¥0.95 | 113s |
作为外部参照:Macrodata 在其 100 集 / 743 段 WGO-Bench 上报告的最优切分 F1 为 0.306、标签准确率 61%、端到端 0.168,API 成本约 $2.64 / 小时视频,纯人工 >10 分钟 / 分钟视频。请注意两边样本规模、素材和裁判口径都不同,数字不能直接比高低;我的 F1 略高只说明这批 5–13 秒的短剪辑相对更容易,而 E2E 更低则与标签裁判更严、样本更小有关。量级上能确认的是:VLM 预标把 API 成本压到了每分钟视频一元人民币以内,它要替代的不是标注员的判断,而是拖时间轴、写初稿的重复劳动。
八、人在回路:复核动作从「写」退化为「看和改」
从这 21 段在 Atom 标注台里的复核过程看,人工的工作量分布很清楚:
- 约 1/4 的段可以一键确认(最好的视频配置 E2E 阶段一为 24%),其余段至少需要改标签或改边界;
- 最高频的人工动作是「合并过分割段」——贴快递单式的粒度错配,模型普遍切细,人工要做的是拖边界把相邻段合并并改写描述,Atom 标注台的拖拽时间轴正好是为这个动作设计的;
- 第二高频是核验物体名词——tray / box / counter 这类容器幻觉,需要对着画面点一下;
- 真正从零标注的情况没有出现。
我没有组织正式的计时人效实验(只有作者本人操作,样本不足以给出可信的「节省了多少分钟」),因此不编造人效数字;能确定的是复核动作从「拖时间轴 + 写描述」退化成了「看 + 合并 + 改词」,认知负担和单段耗时都明显更轻。Macrodata「>10 分钟 / 分钟视频」的纯人工基线可作为外部参照,严谨的人效对比应在标注员、双盲条件下另做。
九、总结:0915 新版能接管到哪一步
这次实验能站住的结论(严格限定在本次 8 条视频、21 个金标段、单次 temperature=0.1 运行):
- 当前 VLM 做原子任务切分,2–5s 中段、动作主体清晰的视频已经具备「预标 + 快速复核」价值,最好配置时间 F1 约 0.5、约四分之一段端到端直接可用;短动作(<2s)和与金标粒度规范不一致的长粗段是主要短板;
- 0915 新版相对 0628 旧版:切分精度持平,标签质量与 token 效率可见提升——接触表路径标签准确率翻倍(17%→33%)、输入 token 降约 18%,与官方主打的视频标注场景方向一致;
- 输入形态比模型版本更影响结果:自然人手场景必须给原生视频(接触表 F1 仅 10%),夹爪特写场景接触表即可、还更便宜;
- 深度思考在收敛型 JSON 任务上应默认关闭:零切分增益、标签反降、成本时延翻倍;0915 提供了开关,选对档位是调用方的功课;
- 阶段二局部重标配方在 5–13 秒短视频上为负收益,需改成全片关键帧 + 局部高帧率的混合上下文;
- 0915 新版的 Agent 全栈能力是本次最大的惊喜:一份需求文档 → 当天可跑的 Atom 标注台,人的角色变成提需求、配密钥、修边角 bug 和验收;
- 成本可预期:受控管线 0915 原生视频约 ¥0.95 / 分钟、接触表约 ¥0.63 / 分钟,工程上完全跑得通批量。
能力边界也要讲清楚:这套管线产出的是 RGB 语义标签层,给不出关节角、末端位姿、夹爪开合、力觉等控制真值;粒度规范对齐、物体名词核验、边界合并仍必须有人在回路;n=21 是探路样本,上述结论在更大、更长、更多任务类型的数据集上可能变化,我也没有做重复运行的稳定性实验。
工作台与全部管线脚本、实验 JSON、评测结果均在本地留痕,换一个数据集只需要替换 mcap 与金标通道名即可复跑。对具身数据团队来说,这条「VLM 预标 → 双阶段精修 → 人工合并裁决」的路线已经可以进生产环境做灰度——只是要记住,模型负责起草,粒度和事实的最后一厘米仍然在人手里。
想自己上手的话:Atom 标注台已部署到腾讯云开发 CloudBase 云托管,公网入口是 在线 Demo。这个公开实例刻意没有配置任何模型 API Key——既是为了不把凭证暴露在公网,也让它天然退回内置 Mock VLM:界面、交互、批量队列、时间轴编辑、导出链路都是真实可用的,但标注结果来自确定性 Mock 而非真实模型推理,因此本文的切分精度、token 与成本数字请以本地受控运行的记录为准,不要在 Demo 上复现指标。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 1
 0
- 0


 已为社区贡献6条内容

所有评论(0)