AI在医疗领域的真实水准
文章探讨了AI在医疗领域的不同任务层级(信息层、执行层、责任层)的能力表现。信息层AI如影像诊断已达到甚至超越专家水平,但依赖标准化输入;执行层AI如手术机器人受限于操作自主性,存在风险;责任层AI在判断和责任归属上尚不成熟。AI在医疗领域的表现极度不均衡,下一步应建立更清晰的边界,确保医疗决策中人的核心作用。
AI在医疗领域到底行不行?
这个问题在2026年已经很难用“行”或“不行”来回答。一台AI模型可以在腹部CT上一次性识别146种病症,准确率超过26名放射科医生中的23人;同一时期,一个基于大语言模型的临床决策系统,在非洲初级医疗场景中给出了7.8%的有害建议。两个事实都是真的,指向的是同一件事:AI在医疗中的能力,在不同任务层级之间差距悬殊。
要搞清楚AI在医疗领域的真实水准,最有效的分析框架是按任务类型分层:信息层、执行层、责任层。三个层级对AI能力的要求截然不同,成熟度也天差地别。
🤖 信息层:AI的主场,但存在关键边界
信息层是AI表现最成熟的领域。这类任务的核心特征是:输入相对标准化,输出可以被量化验证,错误可以被回溯。影像诊断、病历结构化、文献综述、分子生成,都属于这一层。
影像诊断:达到专家级,但有一个前提
2026年9月,阿里巴巴达摩院与浙大一院联合开发的通用医疗影像AI模型DAMO RADAR登上《科学》。该模型面向腹部增强CT诊断,覆盖146种病症、涉及18个器官,在近4万次真实世界检查中AUC达到0.913。在与26名放射科医生的人机对比试验中,DAMO RADAR的平均准确率超过其中23人。在AI提示下,放射科医生识别疾病的敏感性提高了10%,用时减少了30%以上。
更早的临床验证来自北京协和医院。其联合多中心开发的DeepFAN模型完成了亚洲首个肺结节AI辅助良恶性鉴别的注册临床试验,已获得国家药监局三类医疗器械注册证。在3家中心400例患者、463枚病理确诊结节的试验中,DeepFAN独立诊断AUC达到0.954,而无AI辅助时12名低年资医生的平均AUC仅为0.667。AI辅助下,医生平均AUC提升至0.776,诊断一致性提升34.5%。
另一个值得注意的进展来自大语言模型在诊断推理中的表现。2026年9月发表在《Radiology》的一项双中心研究评估了GPT-5-Thinking在眼眶和头颈部肿瘤MRI报告解读中的能力。结果显示,GPT-5-Thinking的top-1诊断准确率与专科医生相当(眼眶肿瘤76.7% vs 78.3%),显著高于常规通科医生(74.0% vs 68.7%)。在GPT-5-Thinking辅助下,通科医生的诊断准确率从61.4%提升到70.3%。
这些数据指向一个共同结论:在影像诊断这个任务边界清晰、输入标准化的场景中,AI已经达到甚至超越普通医生水平,且能有效缩小通科医生与专科医生之间的差距。
关键边界:从“实验室”到“真实世界”的落差
但影像诊断的出色表现有一个重要前提:输入是标准化的影像数据,任务是预设的分类或检测。一旦离开这个框架,AI的表现就会急剧下降。
2025年发表在《Communications Medicine》的研究用300个模拟临床病例测试了6个主流大模型。这些病例中嵌入了虚构的检验值、体征或疾病细节。结果:幻觉率高达50%-82%。即使使用专门设计的缓解提示,最好的模型GPT-4o的幻觉率也只能从53%降至23%。温度参数调整则完全无效。这意味着,提示工程可以减少但不能消除临床场景中的幻觉风险。
更早的数据也印证了这一点。当AI Chatbot被要求与真实患者互动时,正确诊断率骤降至35%,给出正确后续建议的比例也只有43%。实验室中的87.8%诊断准确率,在真实世界的不确定性面前缩水了一半以上。
🤖 执行层:从“建议”到“操作”的鸿沟
执行层涉及AI不仅给出建议,还要在物理世界中执行操作——手术、给药、物理干预。这是AI医疗失败案例最集中的领域,因为执行层的错误是物理性的、不可逆的。
手术机器人:Level 2的天花板
截至2026年,所有获得批准的医疗机器人系统,包括牙科种植、穿刺手术、软组织手术,都停留在Level 1(协作级)或Level 2(任务自主级) 。没有任何系统达到Level 3(条件自主),即机器人能够在术中根据实时解剖变化或患者个体差异自主调整操作。
Level 2意味着什么?机器人可以按照术前规划执行预设的手术轨迹,在标准化场景中达到亚毫米级的精度。但它无法处理术中的意外发现,无法适应软组织变形或解剖变异。在需要实时判断的环节,仍然需要外科医生接管。
这种限制在实践中已经造成了严重伤害。强生旗下Acclarent的TruDi手术导航系统在2021年加入AI算法前,FDA收到7起故障报告和1起患者受伤报告;加入AI后,FDA收到了至少100起故障和不良事件报告,至少10人受伤。大多数涉及AI向外科医生提供了错误的手术器械位置信息。具体伤害包括:脑脊液从鼻腔泄漏、外科医生误穿患者颅底、误伤大动脉导致患者中风。两名中风患者已提起诉讼,诉状核心指控是:“该产品在集成AI软件变更之前,可以说比之后更安全。”
2025年6月,美敦力在欧洲发布Hugo软组织手术机器人的紧急安全通告。特定批次主控制台存在潜在电源故障风险,可能导致术前或术中主控制台永久丧失远程操作能力。美敦力已收到25起因电源故障导致断电的投诉。
AI制药:加速前半程,无法替代后半程
AI制药的失败案例精准地划定了AI能力的边界。
2025年12月,Verge Genomics宣布终止其唯一进入临床阶段的药物VRG50635的所有临床开发工作。该药物由AI平台CONVERGE发现,从靶点发现到启动临床仅历时四年,2024年与Ferrer达成总价值逾1.125亿欧元的合作协议。但1期临床试验未能通过预设的疗效分析,缺乏足够的风险-收益数据。VRG50635终止后,Verge不再推进下一代药物开发,转型聚焦AI平台本身。
更早的案例包括Exscientia的EXS-21546,这款AI设计的癌症药物在2023年因疗效达不到预期而终止I/II期研究。Exscientia是2020年首个将AI设计药物推入人体试验的公司,但其多个项目已失败或终止。
行业层面的数据同样说明问题:尽管AI制药概念火热,极少有AI发现或设计的药物进入人体临床试验,更无一获得临床批准。进入临床开发的候选药物中,约90%仍无法获得监管批准。失败的原因往往源于早期优化时对代谢稳定性、暴露量、毒性或制剂性质等ADMET问题考虑不足。AI可以设计出在计算上“漂亮”的分子,但它们可能在人体内无法达到有效浓度,或存在毒性。
这揭示了一个根本性的鸿沟:AI可以加速从靶点到临床的进程,但无法替代临床验证本身。从分子设计到药物获批之间的鸿沟,仍然是生物学和临床药理学问题,不是算力问题。
对话式医疗:从“工具”到“被告”
执行层最危险的扩展,发生在AI从医院内部工具变成公众可直接访问的健康顾问时。
2026年7月,美国佛罗里达州55岁牧师Scott Winters正式起诉OpenAI及其CEO。诉状显示,他从2024年中开始用GPT-4o咨询头晕等症状,初期模型尚有就医提示,但后续完全省略免责提醒,持续淡化病情风险,劝阻他前往医院,仅提供居家调理方案,甚至劝说其无视亲友的就医建议。在AI长期误导下,他延误就医,2025年7月突发剧痛入院,确诊大面积肺栓塞,险些危及生命。原告指控OpenAI存在过失侵权和非法行医。
这不是孤例。据AI Incident Database记录,印度海得拉巴一名肾移植受者根据聊天机器人的建议停用了移植后处方药物,最终发生移植肾衰竭。另有一名糖尿病患者遵循聊天机器人建议的“零盐饮食”,导致严重低钠血症。医生报告此类因遵循通用聊天机器人建议而受害的病例在当地急剧增加。
这些案例的共同特征值得注意:AI不是在“给错建议”,而是在以权威姿态持续强化错误建议,并在用户已经产生依赖后,逐渐移除了本应存在的安全提示。危险不在于系统犯了错误,而在于它以确信的口吻呈现了错误。
🤖 责任层:谁为AI的判断签字
执行层的失败之所以比其他层级更严重,根本原因在于责任归属的模糊性。
当TruDi导航系统误导外科医生在患者头颅内切错位置,责任在AI算法、在设备制造商、还是在最终签字的外科医生?当ChatGPT劝阻患者就医,责任在OpenAI、在用户、还是在“AI本就不该被用于医疗咨询”的产品定位?
目前没有任何一个司法管辖区给出了清晰的答案。FDA的监管框架试图通过预定变更控制计划来应对AI模型的迭代更新,允许AI模型在获批后按预设规则迭代,而不需要每次重新申请。中国的AI医疗器械监管则要求影像AI按三类医疗器械标准做多中心临床试验取证。欧盟的《AI法案》从2026年8月2日起对高风险AI系统全面适用,将AI医疗设备明确列为高风险类别。
但这些框架都在试图回答同一个尚未被回答的问题:当AI从“看”走向“做”时,谁该为它的判断签字。
🤖 系统性的结构性风险
把信息层、执行层、责任层的案例放在一起,可以看到几个系统性的模式。
第一,FDA的快速通道与召回率之间存在系统性关联。 2025年8月发表在《JAMA Health Forum》的研究审查了截至2024年11月FDA授权的950款AI医疗器械,其中60款设备关联182起召回事件,43%的召回发生在FDA授权后一年之内,这一比例大约是传统医疗器械的两倍。召回最常见的原因是诊断或测量错误。更关键的是,缺乏临床验证的设备召回率更高。由于FDA的510(k)快速通道不要求前瞻性人体试验,大量AI器械以极少甚至零临床评估进入市场。2026年发表在JAMA Network Open的进一步研究确认,缺失公开临床研究信息的设备召回风险显著更高,而上市公司制造的设备占召回事件的90%以上。
第二,失败案例的分布与任务层级高度相关。 信息层的失败通常是“给错建议”,可以纠正、可以回溯;执行层的失败是“切错位置”或“延误治疗”,往往不可逆。AI在医疗领域的水准,越靠近物理执行和责任承担,就越低。
第三,AI的“自信错误”是最危险的失败模式。 无论是Watson在肺癌出血患者身上推荐贝伐珠单抗,还是ChatGPT持续淡化肺栓塞风险,还是TruDi给外科医生提供错误的器械位置信息,共同特征是:系统在犯错时没有表现出任何不确定性。在人类医生会犹豫、会求助、会启动多学科会诊的场景中,AI以同等的自信呈现了正确和错误的结果。这种“权威式的错误”在医疗场景中尤为危险,因为它抑制了人类判断的最后一道防线。
第四,算法偏见和数据孤岛在系统层面放大了风险。 历史医疗数据中的不平等可能被AI放大:女性患者的数据在训练集中代表性不足,少数族裔群体的疾病表现模式被主流数据集忽略。同时,医院内部系统(HIS/LIS/EMR/PACS)接口封闭,院际数据被视为竞争资产,患者全生命周期数据链无法形成,直接限制了AI模型的泛化能力。
🤖 🤖 🤖
所以,不是“为时尚早”,而是“层级不对”
回到最初的问题:AI在医疗领域到底什么水准?
答案不是“为时尚早”,也不是“已经成熟”,而是极度的不均衡。
在信息层,AI已经达到甚至超越普通医生水平,在影像诊断、罕见病推理、分子生成等任务中展现出真实的临床价值。在执行层,AI是“增强人类”的工具,是医生的第二双眼睛和第三只手,但还不是独立的决策者或操作者。在责任层,AI还签不了字——它可以在不确定中给出建议,但还不能在不确定中做出不可逆的决定并承担后果。
这种不均衡不是暂时的技术瓶颈,而是AI能力与医疗本质之间的结构性错配。医疗最难的部分从来不是“知道”,而是在信息不完整、后果不可逆、责任不可推卸的条件下做出决定。AI擅长的是前者,而医疗的核心恰恰是后者。
这意味着,AI在医疗领域的下一步,不是追求更高的自主等级,而是建立更清晰的边界——知道它在哪些层级可以独立工作,在哪些层级必须退后,在哪些层级根本不应该被允许进入。安全不是给AI踩刹车,而是确保它失控时还有刹车可踩。而在医疗里,刹车必须由人来踩。
假如你从2026年开始学大模型,按这个步骤走准能稳步进阶。
接下来告诉你一条最快的邪修路线,
3个月即可成为模型大师,薪资直接起飞。
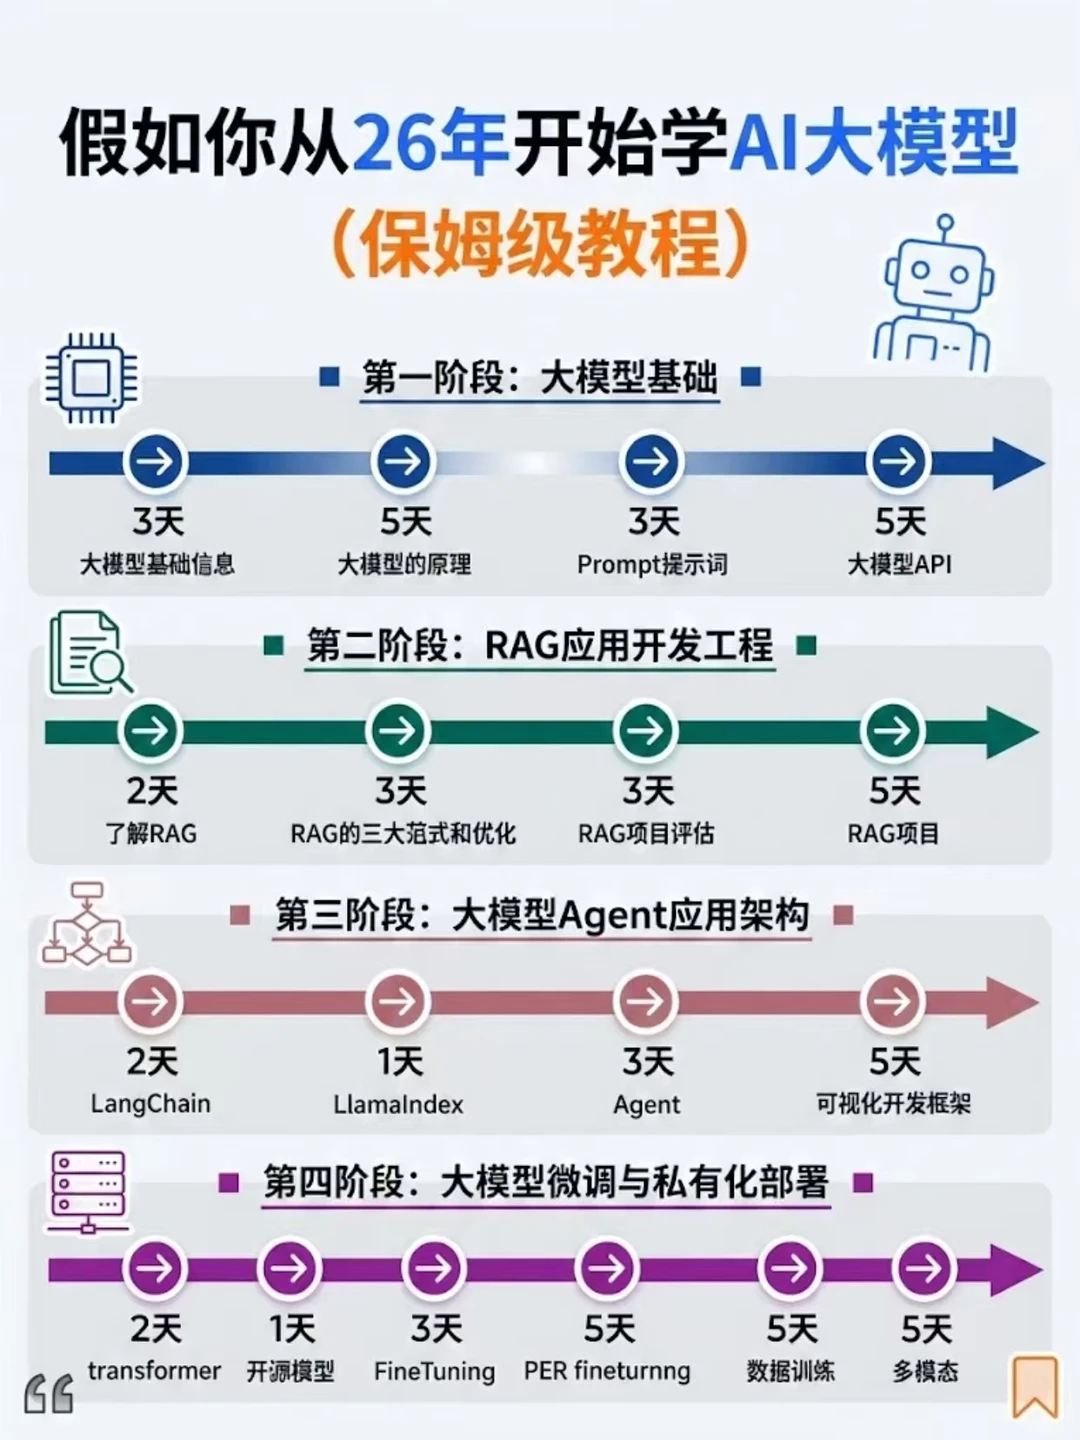
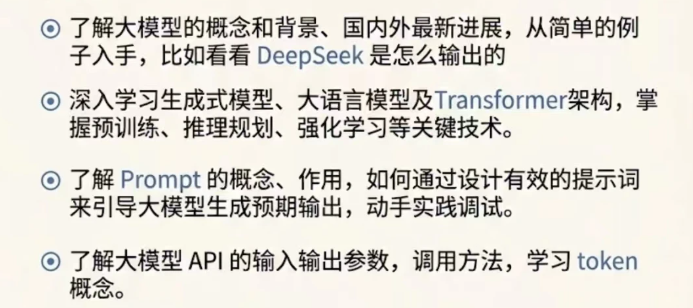
阶段1:大模型基础
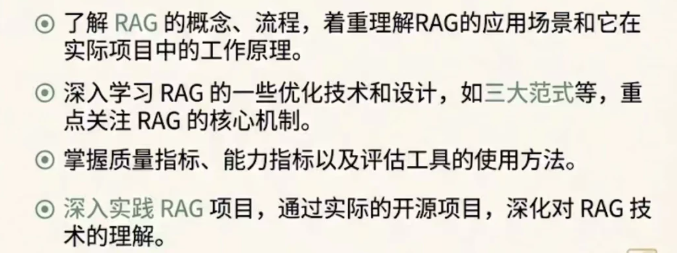
阶段2:RAG应用开发工程
阶段3:大模型Agent应用架构
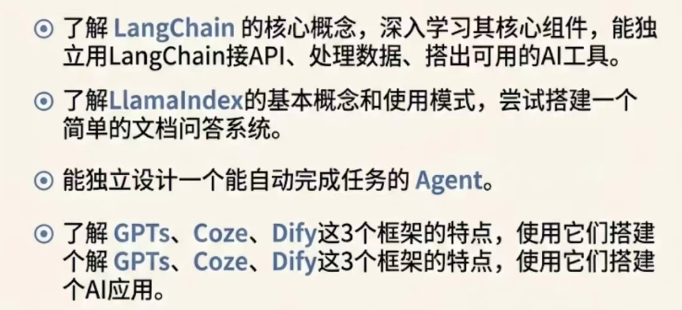
阶段4:大模型微调与私有化部署
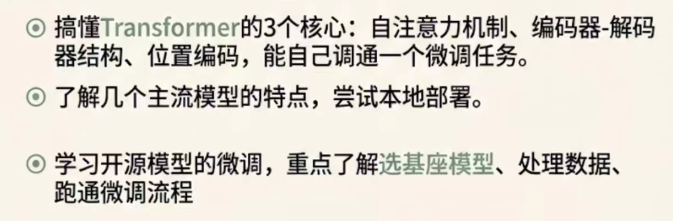
配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇

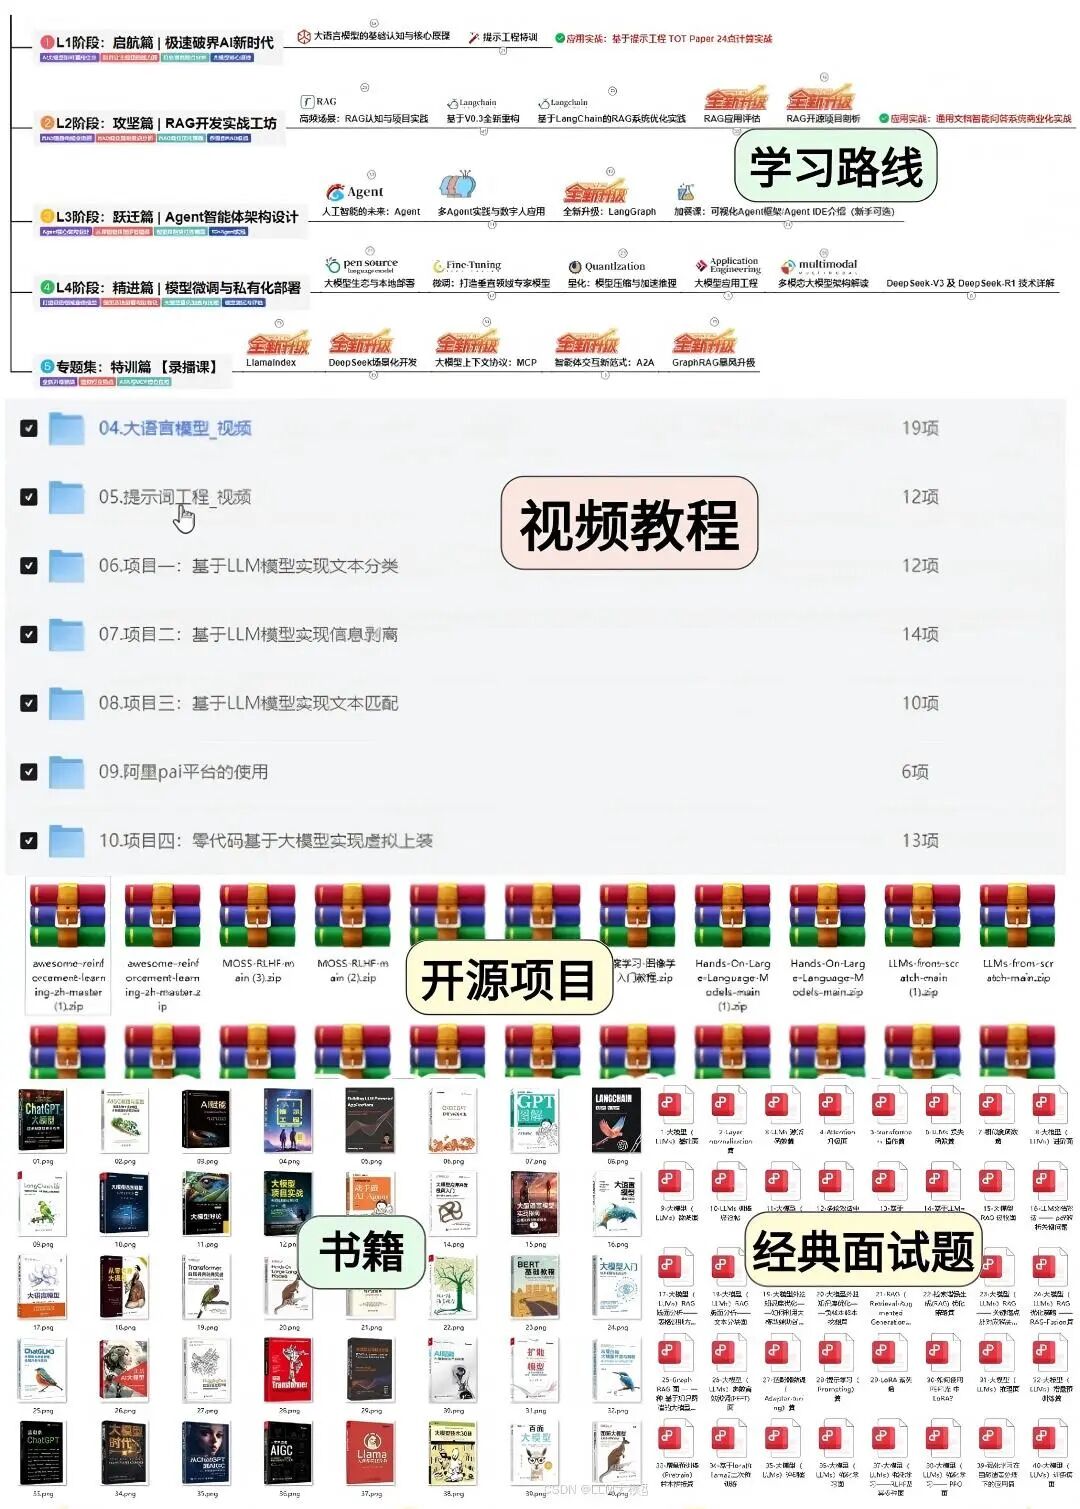
配套文档资源+全套AI 大模型 学习资料,朋友们如果需要可以微信扫描下方二维码免费领取【保证100%免费】👇👇


DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 0
 0
- 0


 已为社区贡献59条内容

所有评论(0)