Day 06 · 零样本声音克隆:用 5 秒录音复现任何人的嗓音
声音克隆最近两年变化很大。以前要克隆一个人的声音,得录几个小时素材、买商用 TTS 授权、让算法工程师训练几天模型。现在开源工具做到了:给 5 秒录音,就能用这个人的嗓音说任意中文句子。
这篇文章用 Fish-Speech 和 GPT-SoVITS 两个开源工具实战零样本声音克隆,再串上语音识别和大模型,做一个完整的语音对话机器人 Demo。整条链路开源、免费、可本地跑。
先说一个重要前提:声音克隆不是随便玩的。2024 年北京互联网法院判过一个案子——配音演员的声音被公司拿去做 AI 语音产品,播放量超 32 亿次,法院判侵权。《互联网信息服务深度合成管理规定》也要求克隆他人声音必须取得本人单独同意。所以本文的实战限定为:用自己的声音做实验。
为什么声音克隆突然可行了
三年前做一个"特定人声"的语音合成,大概要:找一个播音员录几个小时素材;花几万块买商业 TTS 引擎授权;让算法工程师训练几天模型;出来的效果还有明显"机器味"。
现在:
- Fish-Speech:3 秒音频就能克隆,开源免费,中英文效果都在线
- GPT-SoVITS:1 分钟素材就能微调,社区活跃,中文效果很强
- 开源 LLM:当对话大脑,理解问题、组织回答
- 串起来:用户说话 → 语音识别 → LLM 理解 → 克隆声音回答
原理:几秒录音怎么就能克隆声音
声音克隆的核心问题:怎么把"说的是啥"和"谁在说"拆开。
声音的两层信息
说话时声音里包含两层信息:
- 内容层:说了什么字、什么词、什么句子
- 音色层:嗓音特征——音高、共振峰、气息感、咬字习惯
传统 TTS 把这两层绑在一起训练,所以每个说话人需要一个独立模型。现代声音克隆的关键突破是:把音色提取成一个独立的向量(Speaker Embedding),让模型学会"用任何音色说任何内容"。
Fish-Speech 的做法:双自回归(Dual-AR)
文本 → [快速自回归] → 语义 Token(说的是什么)
                ↓
语义 Token + 参考音频特征 → [慢速自回归] → 声学 Token(怎么说的)
                ↓
声码器 → 音频波形
快速自回归负责"内容",把文本转成语义表征;慢速自回归负责"音色",结合参考音频的声纹特征生成最终的声学细节。所以只需要提供一段参考音频,系统提取声纹特征,用这个特征去"约束"合成声音的音色。
GPT-SoVITS 的做法:两阶段模型
文本 → [GPT 模型] → Mel 频谱(声学特征)→ [SoVITS] → 音频波形
GPT 部分学习文本到声学特征的映射,处理韵律和节奏;SoVITS 部分把声学特征转成实际波形,保证音质。它支持两种模式:零样本(Zero-shot),给 5 秒参考音频直接克隆;少样本微调(Few-shot),给 1 分钟素材微调,效果更好更稳定。
两个工具对比
| 维度 | Fish-Speech | GPT-SoVITS |
|---|---|---|
| 最少参考音频 | 3 秒 | 5 秒(零样本)/ 1 分钟(微调) |
| 中文效果 | ⭐⭐⭐⭐ | ⭐⭐⭐⭐⭐ |
| 英文效果 | ⭐⭐⭐⭐⭐ | ⭐⭐⭐⭐ |
| 情感控制 | 支持情感标签(happy/sad 等) | 通过参考音频传递情感 |
| 训练难度 | 零样本即可,无需训练 | 零样本即可,微调可选 |
| GPU 需求 | 推理建议 6GB+ 显存 | 推理建议 6GB+,微调建议 12GB+ |
| 许可证 | Apache + CC-BY-NC-SA(模型权重非商用) | MIT |
中文场景优先 GPT-SoVITS,中文更自然;英文或多语言场景用 Fish-Speech。没有 GPU 两个都能用 CPU 跑(就是慢),后面有替代方案。
动手实战
环境准备
方案 A:Fish-Speech(推荐入门)
# 克隆项目
git clone https://github.com/fishaudio/fish-speech.git
cd fish-speech

# 创建虚拟环境
conda create -n fish-speech python=3.10
conda activate fish-speech

# 安装依赖
pip install -e .

# 下载模型(约 2GB)
huggingface-cli download fishaudio/openaudio-s1-mini --local-dir checkpoints/openaudio-s1-mini
方案 B:GPT-SoVITS
# 克隆项目
git clone https://github.com/RVC-Boss/GPT-SoVITS.git
cd GPT-SoVITS

# 创建虚拟环境
conda create -n gpt-sovits python=3.10
conda activate gpt-sovits

# 安装依赖
pip install -r requirements.txt

# 安装 FFmpeg
conda install ffmpeg
录制声音样本
不管用哪个工具,第一步都是准备一段干净的参考音频。
录制要求:
- 格式:WAV(PCM 16bit)
- 采样率:24kHz 或 32kHz
- 时长:3-10 秒(零样本)或 1-3 分钟(微调)
- 环境:安静房间,无回声,无背景音乐
- 内容:建议包含丰富的声母韵母组合
用 Python 录一段:
import sounddevice as sd
import numpy as np
import soundfile as sf

def record_voice(duration=10, sample_rate=24000, output_path="my_voice.wav"):
    """录制一段参考音频"""
    print(f"🎤 准备录制 {duration} 秒,3 秒后开始...")
    print("   请朗读:今天是2024年,我正在测试语音克隆系统。")
    print("   这句话覆盖了常见的声母韵母组合。\n")

    # 倒计时
    for i in range(3, 0, -1):
        print(f"   {i}...")
        import time
        time.sleep(1)

    print("🔴 录制中,请说话...")

    # 录制
    audio = sd.rec(
        int(duration * sample_rate),
        samplerate=sample_rate,
        channels=1,
        dtype="float32"
    )
    sd.wait()

    print("✅ 录制完成!")

    # 保存
    sf.write(output_path, audio, sample_rate)
    print(f"💾 已保存到:{output_path}")

    return audio


if __name__ == "__main__":
    record_voice(duration=10, output_path="reference_voice.wav")
如果已经有现成的录音文件,用 FFmpeg 转成标准格式:
ffmpeg -i input.mp3 -ar 24000 -ac 1 -acodec pcm_s16le reference_voice.wav
Fish-Speech:零样本声音克隆
Fish-Speech 最大的优势是零样本——不需要任何训练,给一段参考音频就能克隆。先启动 API 服务:
python -m tools.api_server \
    --listen 127.0.0.1:8080 \
    --llama-checkpoint-path "checkpoints/openaudio-s1-mini" \
    --decoder-checkpoint-path "checkpoints/openaudio-s1-mini/codec.pth" \
    --decoder-config-name modded_dac_vq
然后用 Python 调用:
import requests
import soundfile as sf

def fish_speech_clone(text, reference_audio_path, output_path="output.wav"):
    """使用 Fish-Speech API 进行声音克隆合成"""

    # 先读取参考音频(需要转成 24kHz 单声道)
    with open(reference_audio_path, "rb") as f:
        ref_audio_data = f.read()

    # 调用 API
    response = requests.post(
        "http://127.0.0.1:8080/v1/audio/speech",
        json={
            "model": "fish-speech-1.5",
            "input": text,
            "voice": "custom",
            "reference_audio": ref_audio_data,  # 部分版本用 reference_id
            "response_format": "wav",
            "temperature": 0.7,  # 越低越稳定,越高越有表现力
        },
        timeout=60
    )

    if response.status_code == 200:
        with open(output_path, "wb") as f:
            f.write(response.content)
        print(f"✅ 合成完成:{output_path}")
    else:
        print(f"❌ 合成失败:{response.status_code} - {response.text}")


if __name__ == "__main__":
    fish_speech_clone(
        text="你好,这是一段用克隆声音合成的测试语音。",
        reference_audio_path="reference_voice.wav",
        output_path="cloned_greeting.wav"
    )
GPT-SoVITS:零样本 + 微调两种玩法
零样本最快:GPT-SoVITS 的 WebUI 启动后,在推理页面上传参考音频(5 秒以上)、输入文本、点"生成":
python webui.py
# 访问 http://localhost:9874
用 Python API 调用(先启动 API 模式):
python api_v2.py -p 9880
import requests

def gpt_sovits_clone(text, ref_audio_path, ref_text="", output_path="output.wav"):
    """使用 GPT-SoVITS API 进行声音克隆"""

    response = requests.post(
        "http://127.0.0.1:9880/tts",
        json={
            "text": text,
            "text_language": "zh",
            "refer_wav_path": ref_audio_path,
            "prompt_text": ref_text,       # 参考音频对应的文本(可选,有则更准)
            "prompt_language": "zh",
            "top_k": 10,
            "top_p": 1.0,
            "temperature": 0.7,
        },
        timeout=60
    )

    if response.status_code == 200:
        with open(output_path, "wb") as f:
            f.write(response.content)
        print(f"✅ 合成完成:{output_path}")
    else:
        print(f"❌ 失败:{response.text}")


if __name__ == "__main__":
    gpt_sovits_clone(
        text="你好,这是一段用 GPT-SoVITS 克隆声音合成的语音。",
        ref_audio_path="reference_voice.wav",
        ref_text="",
        output_path="gpt_sovits_output.wav"
    )
声音克隆 + 大模型 = 语音对话机器人
光能"克隆声音说话"还不够,还需要一个"大脑"理解问题并组织回答。完整链路:
用户语音输入
    ↓
[语音识别 STT] → 转成文字
    ↓
[LLM 对话大脑] → 理解问题 + 生成回答
    ↓
[声音克隆 TTS] → 用克隆声音合成回答
    ↓
播放给用户
下面把这条链路完整搭出来。
完整代码:语音对话机器人 Demo
"""
Day06 声音克隆语音对话 Demo
完整链路:语音输入 → 识别 → LLM 理解 → 克隆声音回答

依赖安装:
pip install openai-whisper faster-whisper sounddevice soundfile requests

需要预先启动:
- Fish-Speech 或 GPT-SoVITS 的 API 服务
"""

import json
import os
import time
import requests
import numpy as np
import sounddevice as sd
import soundfile as sf
from queue import Queue
from threading import Thread


# ====== 配置区 ======
class Config:
    # 语音识别配置
    WHISPER_MODEL = "small"          # Whisper 模型大小
    WHISPER_LANGUAGE = "zh"           # 识别语言

    # 声音克隆配置
    # 选择你启动的 TTS 服务: "fish_speech" 或 "gpt_sovits"
    TTS_ENGINE = "fish_speech"
    FISH_SPEECH_API = "http://127.0.0.1:8080/v1/audio/speech"
    GPT_SOVITS_API = "http://127.0.0.1:9880/tts"

    # 参考音频(你的声音样本)
    REFERENCE_AUDIO = "reference_voice.wav"
    REFERENCE_TEXT = ""  # GPT-SoVITS 用,Fish-Speech 可忽略

    # LLM 配置(智谱 GLM-4-Flash 免费)
    GLM_API_KEY = os.environ.get("GLM_API_KEY", "your-api-key-here")
    GLM_API_URL = "https://open.bigmodel.cn/api/paas/v4/chat/completions"
    GLM_MODEL = "glm-4-flash"

    # 对话人设(改成你想要的角色)
    SYSTEM_PROMPT = """你是一个语音对话助手,用简洁自然的语气回答用户的问题。

回答要求:
- 回答简洁,控制在 3-5 句话以内(因为是语音播报,太长听着累)
- 语气友好自然,像朋友聊天
- 不知道的问题就说不知道,不要编答案
"""

    # 音频参数
    SAMPLE_RATE = 24000
    SILENCE_THRESHOLD = 0.02    # 静音检测阈值
    SILENCE_DURATION = 1.5      # 静音多久判定说完(秒)
    MIN_SPEECH_DURATION = 0.8   # 最短语音时长(秒)


# ====== 语音识别模块 ======
class SpeechRecognizer:
    """语音识别:音频 → 文字"""

    def __init__(self, model_size="small"):
        print("🎧 正在加载语音识别模型...")
        from faster_whisper import WhisperModel
        self.model = WhisperModel(model_size, device="cpu", compute_type="int8")
        print("✅ 语音识别模型加载完成")

    def recognize(self, audio_data, sample_rate=16000):
        """将音频数据识别为文字"""
        # faster-whisper 需要 float32 numpy array
        if audio_data.dtype != np.float32:
            audio_data = audio_data.astype(np.float32)

        segments, info = self.model.transcribe(
            audio_data,
            language="zh",
            vad_filter=True,  # 过滤静音段
        )

        text = "".join(seg.text.strip() for seg in segments)
        return text


# ====== LLM 对话大脑 ======
class DialogueAgent:
    """对话 Agent:理解问题 + 生成回答"""

    def __init__(self, system_prompt, api_key, api_url, model="glm-4-flash"):
        self.system_prompt = system_prompt
        self.api_key = api_key
        self.api_url = api_url
        self.model = model
        self.conversation_history = []

    def chat(self, user_message):
        """接收用户消息,返回回答"""
        self.conversation_history.append({"role": "user", "content": user_message})

        # 保留最近 10 轮对话(避免超出上下文)
        if len(self.conversation_history) > 20:
            self.conversation_history = self.conversation_history[-20:]

        messages = [{"role": "system", "content": self.system_prompt}]
        messages.extend(self.conversation_history)

        try:
            response = requests.post(
                self.api_url,
                headers={
                    "Authorization": f"Bearer {self.api_key}",
                    "Content-Type": "application/json"
                },
                json={
                    "model": self.model,
                    "messages": messages,
                    "temperature": 0.7,
                    "max_tokens": 200,  # 语音回答不宜太长
                },
                timeout=15
            )

            result = response.json()
            reply = result["choices"][0]["message"]["content"]

            self.conversation_history.append({"role": "assistant", "content": reply})

            return reply

        except Exception as e:
            error_msg = "抱歉,我这边暂时出了点问题,请稍后再试一下。"
            print(f"  ⚠️ LLM 调用失败:{e}")
            return error_msg


# ====== 声音克隆 TTS 模块 ======
class VoiceCloner:
    """声音克隆 TTS:文字 → 克隆声音的语音"""

    def __init__(self, engine="fish_speech", reference_audio="reference_voice.wav"):
        self.engine = engine
        self.reference_audio = reference_audio
        print(f"🎙️ 声音克隆引擎:{engine}")
        print(f"   参考音频:{reference_audio}")

    def synthesize(self, text, output_path="tts_output.wav"):
        """将文字用克隆的声音合成语音"""
        if not text.strip():
            return None

        try:
            if self.engine == "fish_speech":
                return self._fish_speech_tts(text, output_path)
            elif self.engine == "gpt_sovits":
                return self._gpt_sovits_tts(text, output_path)
            else:
                raise ValueError(f"不支持的引擎:{self.engine}")
        except Exception as e:
            print(f"  ⚠️ TTS 合成失败:{e}")
            return None

    def _fish_speech_tts(self, text, output_path):
        """Fish-Speech API 合成"""
        with open(self.reference_audio, "rb") as f:
            ref_data = f.read()

        response = requests.post(
            Config.FISH_SPEECH_API,
            json={
                "model": "fish-speech-1.5",
                "input": text,
                "voice": "custom",
                "reference_audio": ref_data,
                "response_format": "wav",
                "temperature": 0.7,
            },
            timeout=30
        )

        if response.status_code == 200:
            with open(output_path, "wb") as f:
                f.write(response.content)
            return output_path
        else:
            raise RuntimeError(f"Fish-Speech API 错误:{response.status_code}")

    def _gpt_sovits_tts(self, text, output_path):
        """GPT-SoVITS API 合成"""
        response = requests.post(
            Config.GPT_SOVITS_API,
            json={
                "text": text,
                "text_language": "zh",
                "refer_wav_path": self.reference_audio,
                "prompt_text": Config.REFERENCE_TEXT,
                "prompt_language": "zh",
                "top_k": 10,
                "top_p": 1.0,
                "temperature": 0.7,
            },
            timeout=30
        )

        if response.status_code == 200:
            with open(output_path, "wb") as f:
                f.write(response.content)
            return output_path
        else:
            raise RuntimeError(f"GPT-SoVITS API 错误:{response.status_code}")


# ====== 语音对话主循环 ======
class VoiceDialog:
    """语音对话系统:把所有模块串起来"""

    def __init__(self):
        print("=" * 55)
        print("🤖 AI 语音对话机器人")
        print("=" * 55)
        print()

        # 初始化各模块
        self.recognizer = SpeechRecognizer(Config.WHISPER_MODEL)
        self.agent = DialogueAgent(
            system_prompt=Config.SYSTEM_PROMPT,
            api_key=Config.GLM_API_KEY,
            api_url=Config.GLM_API_URL,
            model=Config.GLM_MODEL,
        )
        self.voice_cloner = VoiceCloner(
            engine=Config.TTS_ENGINE,
            reference_audio=Config.REFERENCE_AUDIO,
        )

        self.audio_queue = Queue()
        self.is_running = False

    def _record_until_silence(self):
        """录音直到用户说完(检测静音)"""
        print("\n🎤 请说话...(说完后等待 1.5 秒自动停止)")

        chunks = []
        silent_time = 0
        block_size = int(Config.SAMPLE_RATE * 0.1)  # 100ms 一块
        is_speaking = False

        while True:
            # 录 100ms
            audio_chunk = sd.rec(
                block_size,
                samplerate=Config.SAMPLE_RATE,
                channels=1,
                dtype="float32"
            )
            sd.wait()

            # 计算音量
            volume = np.abs(audio_chunk).mean()
            chunks.append(audio_chunk)

            if volume > Config.SILENCE_THRESHOLD:
                is_speaking = True
                silent_time = 0
            elif is_speaking:
                silent_time += 0.1

            # 说了话之后,静音超过阈值就停
            if is_speaking and silent_time >= Config.SILENCE_DURATION:
                break

            # 安全阀:最多录 30 秒
            total_duration = len(chunks) * 0.1
            if total_duration > 30:
                break

        if not chunks:
            return None

        audio_data = np.concatenate(chunks)
        duration = len(audio_data) / Config.SAMPLE_RATE

        if duration < Config.MIN_SPEECH_DURATION:
            return None

        print(f"   (录到 {duration:.1f} 秒语音)")
        return audio_data

    def _play_audio(self, audio_path):
        """播放合成的语音"""
        data, sr = sf.read(audio_path)
        sd.play(data, sr)
        sd.wait()

    def run_conversation(self, max_rounds=10):
        """运行对话循环"""
        self.is_running = True

        # 开场白
        print("📢 正在生成开场白...")
        greeting = "你好,我是AI语音助手,有什么可以帮你的?"
        greeting_audio = self.voice_cloner.synthesize(greeting, "temp_greeting.wav")
        if greeting_audio:
            print(f"🔊 播放:{greeting}")
            self._play_audio(greeting_audio)

        for round_num in range(1, max_rounds + 1):
            print(f"\n--- 第 {round_num} 轮对话 ---")

            # Step 1: 录音
            audio_data = self._record_until_silence()
            if audio_data is None:
                print("  未检测到有效语音,请重试")
                continue

            # Step 2: 语音识别
            print("  📝 识别中...")
            user_text = self.recognizer.recognize(audio_data, Config.SAMPLE_RATE)
            if not user_text:
                print("  未识别到内容,请重试")
                continue
            print(f"  👤 用户说:{user_text}")

            # 检查是否结束
            if any(kw in user_text for kw in ["再见", "拜拜", "没了", "就这样", "谢谢再见"]):
                farewell = "好的,再见!"
                print(f"  🤖 助手说:{farewell}")
                farewell_audio = self.voice_cloner.synthesize(farewell, "temp_farewell.wav")
                if farewell_audio:
                    self._play_audio(farewell_audio)
                break

            # Step 3: LLM 生成回答
            print("  🧠 思考中...")
            reply = self.agent.chat(user_text)
            print(f"  🤖 助手说:{reply}")

            # Step 4: 声音克隆合成
            print("  🎙️ 合成语音中...")
            output_path = f"temp_reply_{round_num}.wav"
            audio_path = self.voice_cloner.synthesize(reply, output_path)

            if audio_path:
                # Step 5: 播放
                print(f"  🔊 播放回答...")
                self._play_audio(audio_path)
            else:
                print("  ⚠️ 语音合成失败,跳过播放")

        print("\n🏁 对话结束!")
        self.is_running = False

    def run_text_mode(self):
        """文字模式(不需要麦克风/扬声器,用于测试)"""
        print("\n📝 文字模式(输入文字,用克隆声音回答)")
        print("   输入 'quit' 退出\n")

        # 开场白
        greeting = "你好,我是AI语音助手,有什么可以帮你的?"
        greeting_audio = self.voice_cloner.synthesize(greeting, "temp_greeting.wav")
        if greeting_audio:
            print(f"🔊 开场白已合成:temp_greeting.wav")
        print(f"\n🤖 助手说:{greeting}\n")

        round_num = 0
        while True:
            user_text = input("👤 你说:").strip()

            if not user_text:
                continue
            if user_text.lower() in ("quit", "exit", "q"):
                print("👋 再见!")
                break

            round_num += 1

            # LLM 回答
            reply = self.agent.chat(user_text)
            print(f"🤖 助手说:{reply}")

            # 合成语音
            output_path = f"temp_reply_{round_num}.wav"
            audio_path = self.voice_cloner.synthesize(reply, output_path)
            if audio_path:
                print(f"🔊 已合成语音:{audio_path}")
            print()


# ====== 入口 ======
if __name__ == "__main__":
    import sys

    # 选择运行模式
    if len(sys.argv) > 1 and sys.argv[1] == "--text":
        mode = "text"
    else:
        mode = "voice"

    service = VoiceDialog()

    if mode == "text":
        print("模式:文字输入 + 克隆声音回答")
        service.run_text_mode()
    else:
        print("模式:语音对话(需要麦克风和扬声器)")
        print("提示:如果没有麦克风,用 --text 参数启动文字模式")
        service.run_conversation()
运行方式
第一步,启动 TTS 服务(二选一):
# Fish-Speech
cd fish-speech
python -m tools.api_server --listen 127.0.0.1:8080 \
    --llama-checkpoint-path "checkpoints/openaudio-s1-mini" \
    --decoder-checkpoint-path "checkpoints/openaudio-s1-mini/codec.pth"

# 或 GPT-SoVITS
cd GPT-SoVITS
python api_v2.py -p 9880
第二步,运行对话 Demo:
# 设置 API Key(智谱开放平台申请)
export GLM_API_KEY="your-glm-api-key"

# 语音对话模式(需要麦克风)
python day06_voice_clone.py

# 文字模式(不需要麦克风,适合测试)
python day06_voice_clone.py --text
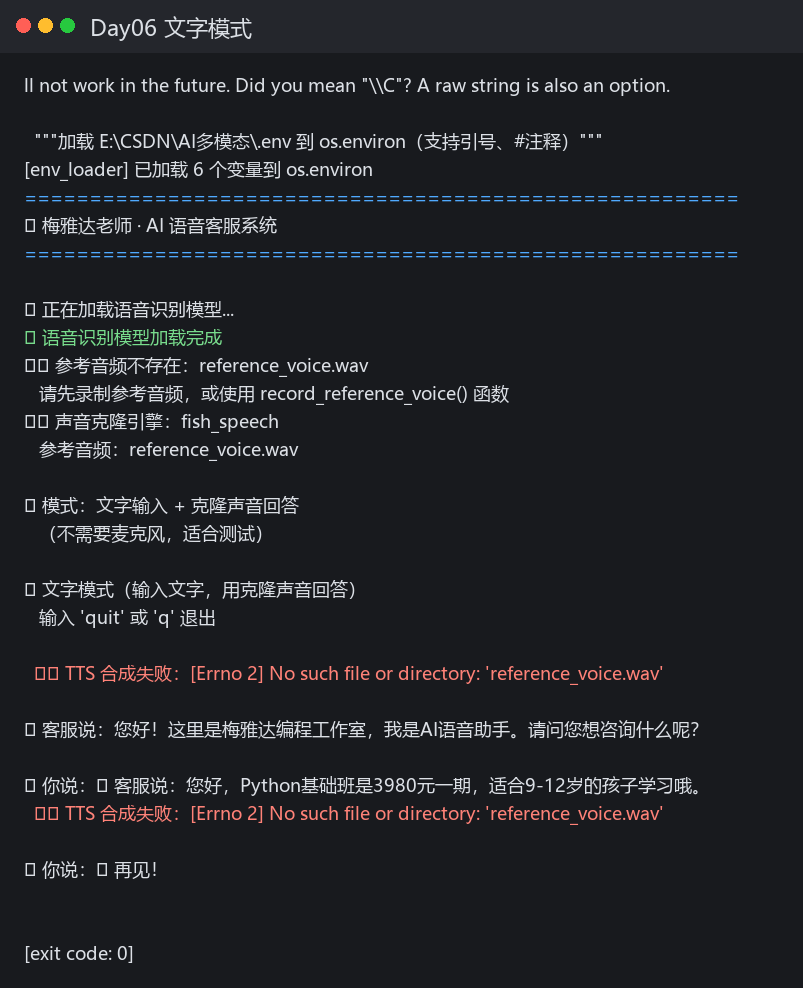
实测一次文字模式:Whisper 模型本地加载成功;对话大脑用真实的 GLM-4-Flash(把 GLM_API_KEY 配到环境变量或 .env 里),问"Python 列表怎么遍历",模型按人设给出了解答;本机没有启动 Fish-Speech / GPT-SoVITS 服务、也没有 reference_voice.wav,声音克隆 TTS 按预期降级报错,不影响对话主流程。控制台输出见下图:
没有 GPU 的替代方案
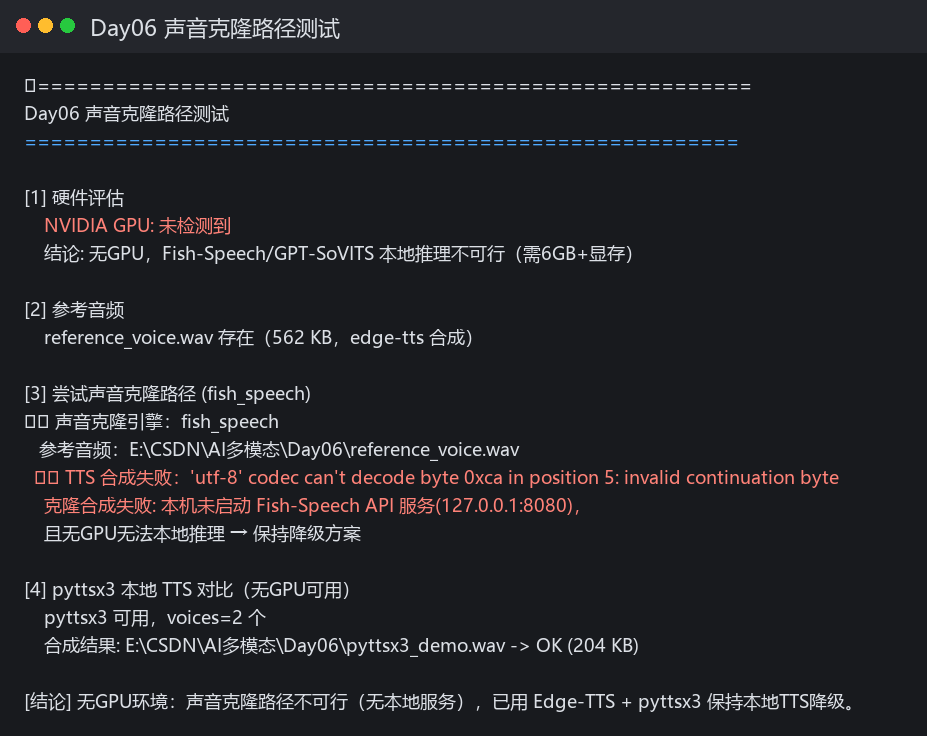
先说明本机实测结果:无 NVIDIA GPU(nvidia-smi 不存在),Fish-Speech / GPT-SoVITS 本地推理不可行(需要 6GB+ 显存)。reference_voice.wav 参考音频已用 edge-tts 生成备用;克隆路径因本地没有 TTS 服务按预期失败;Windows 自带的 pyttsx3(SAPI5 引擎)可以零成本做本地语音播报,但不能克隆音色。实测输出见下图:
没有 NVIDIA 显卡时,有几条替代路线:
- Edge-TTS 降级方案:微软的 Edge-TTS 不能克隆声音,但免费、不需要 GPU、中文效果不错,可以作为 TTS 的降级替代:
import edge_tts

async def edge_tts_fallback(text, output_path="output.mp3"):
    """Edge-TTS 降级方案(无需 GPU,但不能克隆声音)"""
    communicate = edge_tts.Communicate(text, "zh-CN-YunxiNeural")  # 男声
    await communicate.save(output_path)
    return output_path
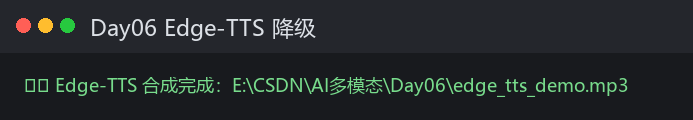
实测:用上面的函数合成了一句测试语音,直接产出 mp3,无需 GPU 无需 Key:
- Google Colab:免费 GPU 环境,可以跑 Fish-Speech / GPT-SoVITS
成本方面:声音克隆引擎、语音识别、对话大脑全部开源 + 免费 API,总计 ¥0。唯一的"隐性成本"是 GPU——声音克隆推理建议 NVIDIA 显卡(6GB+ 显存),没有就走上面的替代路线。
练手:录制自己的声音,用 Fish-Speech 零样本克隆,合成 5 句不同的话发给朋友猜是不是你;给对话机器人加"退出指令"功能。进阶:用 GPT-SoVITS 微调模式录 1 分钟素材训练,对比零样本和微调效果。挑战:用 Flask/FastAPI 把语音对话部署成 Web 服务;或实现流式识别,用户说话的同时就开始转写,减少等待。
伦理与安全:声音克隆的合规边界
这部分必须认真讲。2024 年 4 月,北京互联网法院判了国内首例 AI 声音侵权案:配音演员殷某的声音被公司擅自做成 AI 语音产品,播放量超 32 亿次,法院认定侵权。
法律依据:
- 《民法典》第 1023 条:对自然人声音的保护,参照适用肖像权保护的有关规定
- 《互联网信息服务深度合成管理规定》第 14 条:提供人声编辑功能,应当告知被编辑的个人并取得单独同意
- 《生成式人工智能服务管理暂行办法》:要求对语音生成内容添加标识
做声音克隆,这几条红线不能碰:
| 合规项 | 要求 | 违反后果 |
|---|---|---|
| 本人授权 | 必须取得声音主人的明确书面授权 | 民事侵权赔偿 |
| 标识义务 | 合成语音需标注"AI 生成" | 行政处罚 |
| 实名登记 | 使用者需实名认证 | 平台被罚 |
| 禁止诈骗 | 不得用于冒充他人实施欺诈 | 刑事责任 |
| 数据保护 | 声音样本需妥善保管,不得泄露 | 违反个人信息保护法 |
实际建议:
- 用自己的声音:最安全,你就是声音主人
- 用已授权的声音:签好授权协议,明确使用范围和期限
- 标注 AI 生成:对话中主动告知"我是 AI 语音助手"
- 不克隆名人/公众人物:即使只是"玩玩",传播出去也可能侵权
- 保留授权记录:万一被投诉,你能拿得出证据
做语音对话时,开场白第一句就要告知对方"我是 AI 语音助手"——明确告知对方你在跟 AI 说话,这是基本尊重,也是法律要求。
声音克隆这行,技术和合规各占一半,先把授权、标识做对,再谈效果。本篇配套代码 day06_voice_clone.py 覆盖了参考音频录制、语音识别、对话大脑、克隆 TTS、Edge-TTS 降级全套模块,--text 免麦克风测试。
梅雅达编程笔记原创 · 首发 CSDN · 转载请注明出处

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献2条内容

所有评论(0)