2026外滩大会物理智能圆桌:具身智能不能照搬数字AI路线(第二篇:技术原理深度拆解)
VLA和WA是怎么做到的?——技术原理深度拆解
一、VLA的架构与关键机制
1. 核心架构:三模态融合的端到端模型
VLA的底层架构可以拆解为"编码器-融合器-解码器"三段式:
视觉输入 → 视觉编码器 → ┐
                          ├→ 跨模态融合 → 动作解码器 → 动作输出
语言指令 → 语言编码器 → ┘
-
视觉编码器:通常基于ViT(视觉Transformer),把摄像头拍到的图像转换成一组特征向量。早期VLA只用单帧图像,现在的VLA(如π₀系列)已经用多帧时序视觉输入,捕捉运动信息。
-
语言编码器:复用预训练大语言模型(LLM)的编码能力,把自然语言指令转换成语义特征。这是VLA"听得懂人话"的关键来源。
-
跨模态融合:把视觉特征和语言特征"对齐"到同一个语义空间里,让模型知道"语言里说的'杯子'对应画面里的哪个物体"。
-
动作解码器:把融合后的特征转换成具体的机器人动作指令——关节角度、末端位姿、抓取力度等。
2. 关键机制:从RT-2到π₀的演进
VLA的发展经历了几个关键跃迁:
第一代(RT-2时期,2023年):直接把VLM(视觉语言模型)的输出头换成动作token,验证了"端到端VLA"的可行性。但问题也很明显——动作精度差、泛化有限。
第二代(OpenVLA/π₀时期,2025年):引入了大规模预训练。比如OpenVLA用了70亿参数、97万条机器人演示数据做预训练;Physical Intelligence的π₀则在更大规模的多机器人数据上训练,验证了"机器人基础模型"的可行性。
核心机制创新:
-
动作token化:把连续的机器人动作离散化成"动作token",像语言模型生成文字一样生成动作序列
-
多本体统一:不同机器人(机械臂、人形、移动底盘)的动作格式不一样,VLA通过统一的动作表示实现跨本体迁移
-
分层动作解码:高层生成子目标、低层生成具体动作,解决长程任务的记忆问题
3. 主流技术路线分化
|
路线 |
代表 |
核心思路 |
优势 |
劣势 |
|---|---|---|---|---|
|
纯端到端VLA |
RT-2、OpenVLA |
一个模型从视觉直通动作 |
简洁、端到端优化 |
动作精度有限、可解释性差 |
|
分层VLA |
π₀、π₀.5 |
高层做任务规划,低层做动作执行 |
长程任务能力强、可调试 |
系统复杂度高 |
|
轻量化VLA |
端侧部署方案 |
小模型+量化+蒸馏,跑在边缘设备上 |
延迟低、成本低 |
能力上限受限 |
二、WA/WAM的架构与关键机制
1. 核心架构:预测+控制的闭环
WAM(世界动作模型)的核心思想是:不仅要预测世界怎么变,还要让动作和预测对齐。
基础架构可以理解为"世界预测 + 动作生成 + 双向对齐":
当前观测 + 动作假设 → 世界预测器 → 未来状态预测
                          ↕(双向约束)
当前观测 + 任务目标 → 动作生成器 → 动作序列
-
世界预测器:输入当前状态和动作,输出未来N步的视觉状态(或特征表示)。本质上是一个视频生成/预测模型。
-
动作生成器:输入当前状态和目标,输出应该执行的动作。
-
双向对齐:这是WAM区别于"世界模型+控制器"简单拼接的关键——动作生成要以世界预测为参照,世界预测要以动作条件为输入,两者联合训练、相互约束。
2. 关键机制:五大架构流派
根据2026年的最新研究,WAM主要分化为五大技术路线:
|
流派 |
核心思路 |
代表工作 |
特点 |
|---|---|---|---|
|
级联式(Cascaded) |
世界模型先输出视觉计划,再用逆动力学模型转成动作 |
视觉规划+逆控制 |
直观、可解释,但两阶段有信息损失 |
|
联合自回归式 |
视频帧和动作token交替生成,统一自回归 |
DreamZero |
统一框架、训练简单,但动作-视频尺度难平衡 |
|
联合扩散式 |
视频和动作通过同一扩散过程联合去噪 |
联合视频-动作流匹配 |
生成质量高,但推理慢 |
|
潜在规划式 |
在压缩的潜在空间做规划,不生成像素级视频 |
潜在世界模型+规划 |
效率高,但可解释性弱 |
|
世界模拟器 |
构建可交互的三维世界模拟器,支持物理仿真 |
神经辐射场+物理引擎 |
最接近真实物理,但计算量巨大 |
3. 具身原生路线的突破
蚂蚁灵波LingBot-VA 2.0代表了一个重要方向——具身原生架构。它不是把视频生成模型或语言模型"改造"一下用到机器人上,而是从底层就为机器人设计:
-
因果时序预训练:训练过程遵循物理世界的因果时序,而不是像语言模型那样"左右都能猜"
-
预测与执行并行:未来状态预测和动作执行同时进行,不是"先全想完再动手"
-
实时观测修正:最新的传感器输入可以随时修正后续决策,匹配机器人"边干边想"的真实运行逻辑
这正好回应了沈宇军的判断:不能用一问一答的训练逻辑,去支撑一个需要持续处理物理信号的智能系统。
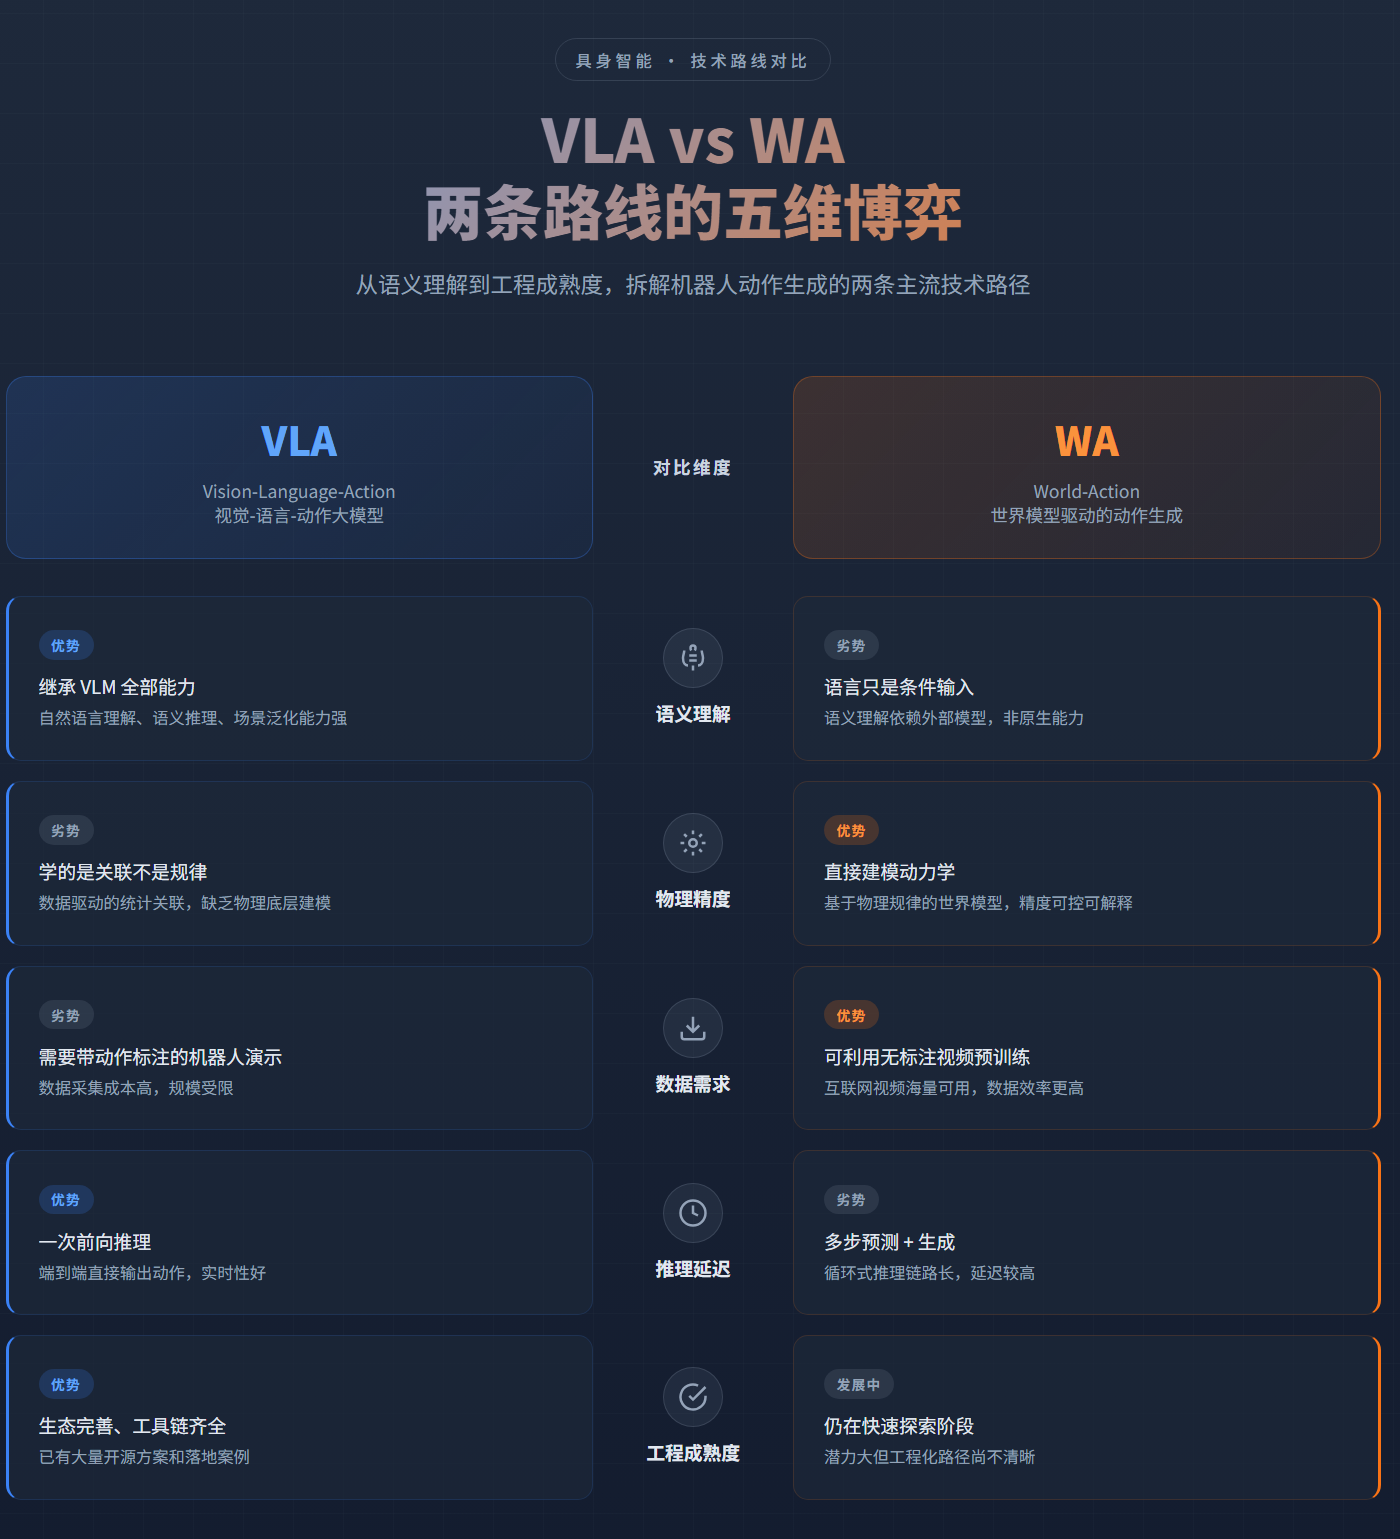
三、两条路线的取舍逻辑
理解了技术原理,你就明白为什么行业不是"选边站",而是在做权衡:
|
维度 |
VLA路线 |
WA路线 |
取舍逻辑 |
|---|---|---|---|
|
语义理解 |
强(继承VLM全部能力) |
弱(语言只是条件输入) |
场景越依赖自然语言交互,VLA越重要 |
|
物理精度 |
弱(学的是关联不是规律) |
强(直接建模动力学) |
操作越精密、物理交互越多,WA越重要 |
|
数据需求 |
需要带动作标注的机器人演示 |
可利用无标注视频预训练 |
数据越难获取,WA的数据效率优势越明显 |
|
推理延迟 |
较低(一次前向) |
较高(多步预测+生成) |
实时性要求越高,越需要优化WA的推理效率 |
|
工程成熟度 |
高(生态完善、工具链齐全) |
中(仍在快速探索) |
追求快速落地,VLA更稳妥;追求长期上限,WA空间更大 |

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献2条内容

所有评论(0)