LangGraph实战:从链式调用到可恢复的智能流程
写过 LangChain 的 Chain 或 LCEL 表达式,大多有过这种体验:线性地把「提示 → 模型 → 输出解析」串起来很爽,但一旦业务变成「根据模型返回决定下一步走哪条分支」「出错要回退重试」「机器人要记住上一轮对话并随时打断」,链就不够用了。
LangGraph 就是为解决这个问题而生的。它把 LLM 应用看成一张有向图:节点是计算步骤,边是流转规则,而贯穿全程的是一个可变的状态对象。本文从环境安装、定义、核心概念、执行原理,到一个可运行的对话机器人示例,再到多步骤流水线、RAG 检索、错误处理、竞品对比、性能成本、反模式、安全、测试部署,把 LangGraph 完整梳理一遍。文末附「核心 API 速查表」。
前置:安装与环境
LangGraph 跑在 Python 3.10+ 上(v1.0 起已放弃 Python 3.9)。最小依赖只要两个包:
pip install langgraph langchain-openai
只有MemorySaver随主包提供。要用数据库做持久化(生产推荐),需额外安装对应的检查点包:
pip install langgraph-checkpoint-sqlite    # 提供 SqliteSaver
pip install langgraph-checkpoint-postgres  # 提供 PostgresSaver
注意:langgraph.prebuilt(含ToolNode/tools_condition)随主包一起安装,无需单独装。但SqliteSaver/PostgresSaver已经从主包拆出到上面的独立包,导入路径也变了(见 §二 5 与官方迁移说明)。另外,若只想「最快搭一个会调工具的 Agent」而不手写图,LangChain 1.0 的from langchain.agents import create_agent 已把 LangGraph 运行时封装成高层入口(对标老牌的langgraph.prebuilt.create_react_agent,二者都还在);但只要想自定义循环 / 分支 / 人工介入 / 持久化,本文讲的StateGraph底层仍是绕不开的控制面。
调用云端模型需要密钥,用环境变量注入(别硬编码进代码,更别写进 state,见 §十二安全):
export OPENAI_API_KEY="sk-..."
版本提示:本文示例在 langgraph 1.2.11(2026-08 最新稳定版)下实际跑通验证(核心 API:StateGraph / MessagesState / ToolNode / tools_condition / interrupt / Command / RetryPolicy / add_messages 均可用)。自 v1.0(2025-10)起官方承诺 2.0 之前不再有破坏性变更,1.x 之间日常升级基本无痛;但要留意 v1.0 已放弃 Python 3.9、要求 3.10+。上线前仍建议锁定版本(如langgraph==1.2.11)并对照官方迁移说明。
一、LangGraph 是什么:定位、动机与生态边界
1.1 它要解决的根本问题
LLM 应用的控制流,天然比传统软件「软」。传统程序每一步做什么由代码写死;而 LLM 应用里,下一步往往要等模型吐出结果才知道——它可能决定调工具、可能决定追问用户、可能决定任务已完成。这种「由运行时数据驱动的控制流」用线性链表达非常别扭:
• 想循环?得自己在链外手写while。
• 想分支?得在链里塞复杂的条件路由。
• 想中途让人审核?几乎要从零造状态机。
• 想崩了续跑?中间状态全丢了,只能重来。
LangGraph 的思路是直接把控制流显式建模成图,让「循环 / 分支 / 暂停 / 恢复」成为框架的一等公民,而不是开发者用胶水代码拼出来的补丁。
1.2 几个关键定语
LangGraph 是 LangChain 生态下的一个图状态编排框架(graph-based stateful orchestration framework)。拆开理解:
• 基于 LangChain:它不是另起炉灶。底层的模型调用、提示模板、工具、记忆组件,仍然复用 LangChain / LCEL 那一套。LangGraph 管的是「这些组件怎么按图的拓扑结构被调度」。
• 图(Graph):应用的流程用节点 + 边描述,不再是一条直线。这意味着天然支持分支、循环、并行、人工介入(human-in-the-loop)。
• 状态(Stateful):图在运行过程中维护一个共享状态对象,所有节点读写它。这让多轮对话、长任务进度、回退重算成为可能。
• 编排(Orchestration)而非 Agent 框架:LangGraph 提供的是「流程控制原语」,既可拿它写死固定流程,也可搭出带 LLM 自主决策的 Agent。它比 LangChain 老的AgentExecutor更底层、更可控,也避免了AgentExecutor那种「黑盒循环、难以干预」的痛点。
1.3 在生态里的位置
LangChain 核心(模型/检索/工具/Memory 抽象)
        │
        ├── LCEL           线性组合的声明式链条
        ├── LangGraph      ★ 图状态编排,本文主角
        ├── LangServe      把链/图部署成 HTTP 服务
        └── LangSmith      可观测性 / 追踪 / 评测平台
一句话定位:LangGraph 用「图 + 状态」表达控制流,把 LLM 应用从「一次性链式调用」升级为「可循环、可恢复、可干预的持久化流程」。
和 LangChain 的关系:LangChain 是工具箱(模型、检索、工具调用),LangGraph 是流程图。两者常常一起用——图里的节点内部,往往就是一段 LCEL 链或一个 ToolCalling。
1.4 整体架构分层图
把 LangGraph 应用从外到内拆开看,它其实是这样一层层叠起来的:
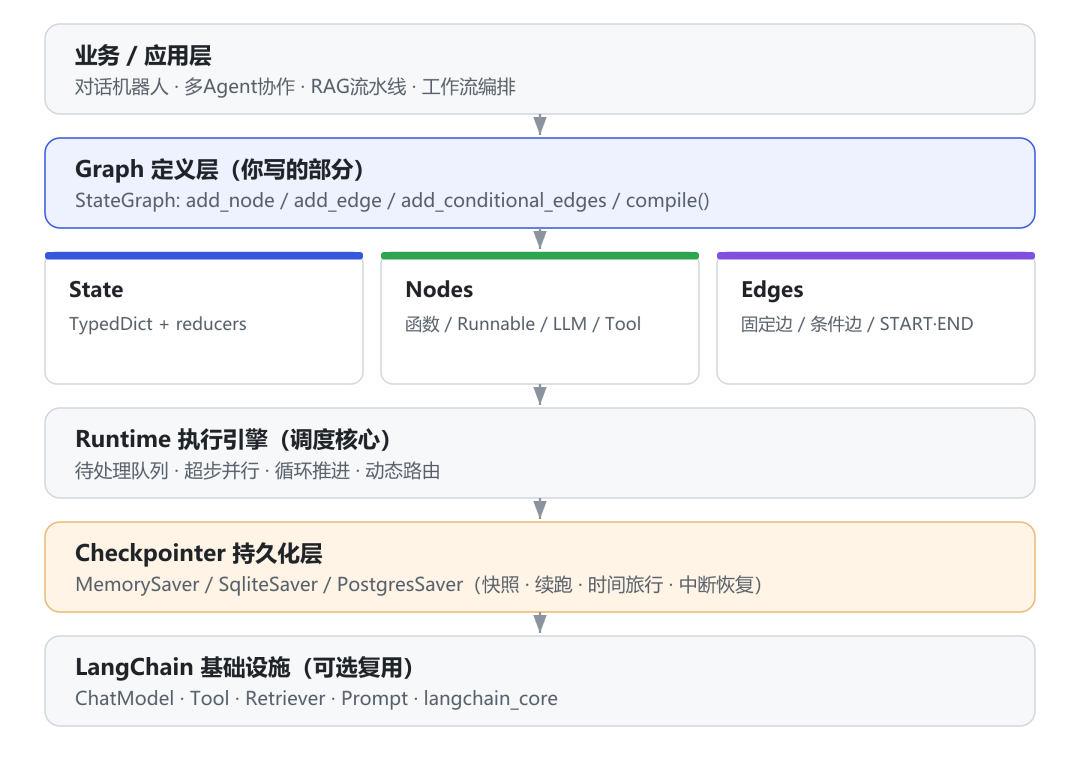
LangGraph 整体架构分层图
上图自外到内六层:业务层 → Graph 定义层(由开发者声明)→ State / Nodes / Edges → Runtime 执行引擎 → Checkpointer 持久化层 → LangChain 基础设施。
数据流方向是:在「Graph 定义层」声明节点和边 → 运行时把图编译成「调度队列」→ 每跑完一个节点就用 reducer 合并进 State → 把合并后的 State 交给 Checkpointer 落盘 → 按边规则决定下一个节点。上层越靠近业务、下层越靠近运行时,这种分层使得在不改业务代码的情况下,可单独替换持久化方案(比如从 MemorySaver 换 PostgresSaver)。
二、核心概念
理解以下五个概念,就掌握了 LangGraph 的骨架。
1. State(状态)—— 图里所有人共享的那张"黑板"
大白话:State 就是一块所有节点都能看、都能往上写的公共白板。节点不负责"算出最终答案交出来",而是"往白板上补一小笔",框架负责把这一笔安全地合并进白板。
为什么需要它:前文提过,LLM 应用的控制流是"软"的——下一步要等模型吐结果才知道。这种流程往往需要跨多步记住东西(比如多轮对话的历史)。如果每一步都从零开始、互相看不见对方算过什么,根本拼不出一个连贯的任务。State 就是那个"让所有人共享记忆"的地方。
类比:把它想成公司群里的一个共享文档。A 同事写一段、B 同事接着写一段,文档越来越长——这就是"追加"。但若把"当前负责人"这个字段也写进文档,每次换人只是把名字改成新的——这就是"覆盖"。同一个 State 里,有的字段要越攒越多,有的字段只记最新值,怎么合并得看字段的脾气。
这个"怎么合并"的规则,就是 reducer(归约器)。先记住一句话:State 这个类本身不会自动合并任何东西,它只是"登记了一张白板上有哪些字段、每个字段怎么合"的说明书;真正动手合并的是框架,发生在节点返回之后。 下面这个最小例子,就是这张说明书:
from typing import Annotated, TypedDict
from langgraph.graph.message import add_messages

class ChatState(TypedDict):
    # messages:要"越攒越多",所以用 add_messages 追加,而不是替换
    messages: Annotated[list, add_messages]
    # step:只记"当前在第几步",新值直接顶掉旧值就行,不用 reducer
    step: str
先看"声明了什么":
•messages用Annotated[list, add_messages]声明——拆开看两部分:
◦ list是什么、从哪来:list就是 Python 内置的列表类型(不用 import,语言自带),表示"一组按先后顺序排列的元素"。对话里的消息天然是有顺序的——先用户问、再 AI 答、再用户追问……所以用一个列表把"历史消息"按发生顺序存起来,是最自然的容器。换成dict就丢了顺序、换成tuple又不可变(add_messages要往里追加,得用可变的list)。
◦ add_messages是什么:Annotated[list, add_messages]里第二个位置上的add_messages,就是messages字段的 reducer——它告诉框架"这个列表里的元素,按消息追加的方式合并",而不是把整个列表替换掉。所以Annotated[list, add_messages]合起来读就是:"messages 是个列表,新消息接在旧历史后面"。
•step是普通str——没写 reducer,框架就按默认规则"新值覆盖旧值",正好符合"只记当前步骤"的需求。
光看声明还是抽象的,关键在于框架怎么用它。设想白板现在有这两行内容:
白板当前:messages=[用户问, AI答1], step="1"
轮到某个节点干活,它只返回了这些变化量——注意,节点没有、也不该返回完整白板,只返回"我改了哪几笔":
# 节点 return 的部分更新(不是整块白板)
{"messages": [AI答2], "step": "2"}
框架拿到后,按每个字段的 reducer 合并回白板:
messages 字段:旧 [用户问, AI答1]  ──add_messages 追加──>  新 [用户问, AI答1, AI答2]   ✅ 越攒越多
step    字段:旧 "1"              ──默认覆盖───────>  新 "2"                          ✅ 只留最新
同一个返回值{...},messages走的是"追加"、step走的是"覆盖"——差别完全由声明时有没有挂 reducer 决定。这就是 reducer 概念落地的全部秘密:它不改变你写节点的方式,只改变框架"把你的返回值并回白板"的那一步。
把messages的 reducer 去掉会怎样?把声明改成messages: list,同样返回{"messages": [AI答2]},框架会按默认"覆盖"处理:
messages 字段:旧 [用户问, AI答1] ──默认覆盖──> 新 [AI答2] ❌ 历史全没了,多轮对话直接崩
所以 reducer 不是可有可无的语法糖,而是"状态能不能正确累积"的开关。
新手最高频翻车点:忘了Annotated、把messages写成普通list,节点一返回,历史就被整体覆盖、多轮对话直接崩。记住:凡是"要累积"的字段,必须配 reducer。 其他常见 reducer 还有max(取新旧较大者,如"最高错误等级")、集合并集(如"已访问过的节点集合"),本质都是"给字段指定一个合并函数"。
2. Node(节点)—— 真正干活的那个人
大白话:Node 就是图里真正做事的函数。它拿到当前白板(State),干完活,返回"要往白板上补的那一笔"。
类比:State 是共享文档,Node 就是"被指派去干一件具体活的人"——有人负责问模型要回复(agent),有人负责执行工具(tools),有人负责把数据库查回来。每个人只干一件小事,干完把结果写回白板。
一个关键点先说在前面:下面这个函数,在被登记之前,它只是一个普通的 Python 函数,跟"节点"毫无关系。 "节点"不是靠函数长什么样决定的,而是靠后面builder.add_node("agent", call_model)这道登记动作——把函数绑上一个名字、挂进图里——它才真正成为图的一个节点。这也解释了为什么节点函数写出来"没什么特别":它不需要继承谁、不需要装饰器,只要满足"state进、部分更新出"这个约定即可。
def call_model(state: ChatState):
    # 读白板上的历史消息
    response = llm.invoke(state["messages"])
    # 干完活,只返回"要追加的那条 AI 消息",不返回整块白板
    # 注意:这里没有任何 add_messages(...) 调用——"把这条回复追加进历史 messages"
    # 这一动作,关联的是上面 §2 State 里 ChatState.messages 挂的 add_messages 规则,
    # 由框架在节点返回后自动完成,不是在这个函数里手动追加的
    return {"messages": [response]}
从"函数"到"节点"到底发生了什么,用一段最小闭环看清:
from langgraph.graph import StateGraph, START, END

builder = StateGraph(ChatState)
# 👇 这一步才是关键:把 call_model 登记成名叫 "agent" 的节点
builder.add_node("agent", call_model)
builder.add_edge(START, "agent")        # 入口箭头指向它
app = builder.compile()

# 跑起来时,框架内部做的是:
# 1. 取出当前白板 state(首轮是用户提问)
# 2. 调用 call_model(state)  <-—— 你的函数在这里被当作节点执行
# 3. 拿到返回值 {"messages": [response]}
# 4. 用 reducer(add_messages)把这条 response 追加进白板的 messages
# 5. 沿箭头走到下一个节点
final_state = app.invoke({"messages": [("user", "深圳天气?")]})
对照看这三件事,节点概念就立住了:
• 它"接收"了什么:函数参数state就是框架塞进来的当前白板,不是你自己传的。
• 它"返回"了什么:{"messages": [response]}只是"变化量"——一条新 AI 消息,不是整个 State。框架拿到后按上一节的 reducer 规则并回白板。
• 它"成为节点"靠什么:不是函数本身,而是add_node("agent", call_model)这行登记。同一个函数可以被登记成不同名字的节点,也能被多个图复用。
节点签名统一是state -> 部分更新,这句话拆开看就是 LangGraph 对所有节点的两条硬约定:
• "签名"指函数的输入和输出长什么样:每个节点函数,第一个参数必须是"当前整个白板(State)",返回值必须是一个"部分更新"的字典——也就是"我只改了哪几笔",而不是"整块白板重画一遍"。
• "部分更新"长什么样:就是前面call_model节点函数里返回的那个字典return {"messages": [response]}——只列出你动过的字段。框架拿到后,按 §2 State 里给每个字段挂的 reducer 规则,把这几笔并回白板。你不该返回完整 State(比如把messages连同历史手动拼好再整体丢回去),那等于绕过 reducer、亲手覆盖了历史,正是前文说的翻车点。
对照两个反例就更清楚了:
# ✅ 正确:只返回变化量,框架按 reducer 合并
def call_model(state):
    return {"messages": [response]}

# ❌ 反例 1:返回值不是字典(返回了对象本身),框架无法识别"改了哪几笔"
def bad_node(state):
    return response          # 报错或行为不可预期

# ❌ 反例 2:以为要"自己拼好整个白板",结果手动覆盖掉了历史
def worse_node(state):
    return {"messages": state["messages"] + [response]}  # 多此一举,还绕过 reducer
最后一句:节点也能写成async def,框架会在异步运行时自动调度它;写成同步就同步调。不管同步异步,"接收整个白板、只返回变化量"这条约定不变。
3. Edge(边)—— 决定"下一步去谁那"
大白话:Edge 就是箭头,规定"这个节点干完之后,轮到谁"。前面 §2 的节点只管"干活",至于干完去哪、是顺序走还是看情况分流,全是边说了算。
类比:普通边像流水线上的传送带,注定往下一家走;条件边像路口的红绿灯,看情况决定往左还是往右。节点是"干活的人",边是"派单的规则"。
先分清两类箭头:
• 普通边(fixed edge):写死的A → B,永远按顺序走。
• 条件边(conditional edge):由一个函数"看一眼白板"再决定下一步去哪——这是实现"分支 / 循环 / 路由"的核心。
下面这个should_continue就是条件边的"红绿灯函数"——它自己不是节点,只是挂在边上、被框架在合适时机调用的一个普通函数:
from langgraph.graph import END

def should_continue(state: ChatState):
    last = state["messages"][-1]
    # 模型这次想调工具 -> 去 tools 节点;否则 -> 结束
    if last.tool_calls:
        return "tools"
    return END
从"函数"到"边"到底发生了什么,把它挂进图、跑一轮看清:
from langgraph.graph import StateGraph, START, END

builder = StateGraph(ChatState)
builder.add_node("agent", call_model)
builder.add_node("tools", call_tools)

# 👇 普通边:START 之后必然进 agent
builder.add_edge(START, "agent")
# 👇 条件边:agent 干完后,框架调用 should_continue(state),
#    拿返回值决定下一个节点是 "tools" 还是 END —— 这条边本身不干活,只"指路"
builder.add_conditional_edges("agent", should_continue)
# 👇 普通边:tools 干完必然回 agent,形成循环
builder.add_edge("tools", "agent")

app = builder.compile()
result = app.invoke({"messages": [("user", "深圳天气?")]})
框架内部在agent节点跑完后,做的是:
1. agent 节点返回(比如模型决定调工具)
2. 框架发现 "agent" 引出的是条件边,于是调用 should_continue(state)
3. 读到返回值 "tools"  -> 沿这条边走到 tools 节点
4. tools 跑完 -> 普通边把它指回 agent -> 再走一遍条件边……
5. 直到某次 should_continue 返回 END -> 图结束
对照看这三件事,边概念就清楚了:
• 它"控制"了什么:节点之间"谁先谁后、是否循环、是否分支",全由边定义,节点本身对此一无所知。
• 普通边 vs 条件边:普通边是常量箭头(A→B写死);条件边是"函数指路"——同一个出发点,不同白板状态走向不同节点,这才是 LangGraph 能跑"循环 / 分支"的真正开关。
• START/END是什么:两个特殊箭头。START是所有图的入口(第一个节点从它出发),END命中即代表图跑完了。条件边返回END,就是告诉框架"到此为止"。
把上面这一段拆解(框架怎么在节点跑完后走条件边、怎么循环、怎么走到 END)和三件事对照完,边概念就立住了。
4. Graph(图)—— 把上面的零件拼起来的"图纸"
大白话:Graph 就是那张把节点和边连起来的总图。前面 §2 的节点、§3 的边都是零散零件,Graph 负责把它们登记、连线,最后compile()一下,变成能跑的app。
类比:Node 是零件、Edge 是导线,Graph 是把它们焊成一台机器的电路图;compile()就是"通电出厂"——出厂前只是图纸,出厂后才是一个能实际运转的机器。
from langgraph.graph import StateGraph, START, END

builder = StateGraph(ChatState)
builder.add_node("agent", call_model)      # 登记"模型"节点
builder.add_node("tools", call_tools)      # 登记"工具"节点

builder.add_edge(START, "agent")                  # 起点 -> agent
builder.add_conditional_edges("agent", should_continue)  # agent 干完看情况分流
builder.add_edge("tools", "agent")                # 工具干完回到 agent(循环)

app = builder.compile()                    # 通电出厂,得到可执行的 app
从"图纸"到"机器"到底发生了什么——builder阶段只是在攒配置,compile()才真正生成可执行的运行时:
1. builder.add_node / add_edge 只是在"画图纸",此时还不能跑
2. compile() 做校验(节点名是否冲突、START 有没有出口、有没有孤立节点)+ 生成调度器
3. 之后拿到的 app 才是"机器",可以反复 invoke
compile()之后,app有三个常用入口:
•app.invoke(input):同步跑完整张图,返回最终 State。
•app.stream(input):逐步吐出每个节点/状态的增量,方便做流式界面。
•app.ainvoke/app.astream:对应的异步版本。
对照看这三件事,图概念就立住了:
• 它"装"了什么:builder是图纸,app是机器——节点和边都得先add_*登记进builder,compile()后才生效。漏登记任何一个,图都跑不起来。
• compile()干了什么:不是语法糖,而是"校验 + 生成调度器"的出厂动作。后面所有invoke都是在这台机器上跑。
• 为什么不直接跑、要先 compile:因为编译期能提前发现"节点没连出口""条件边返回了不存在的节点"这类错误,而不是跑到一半才崩——这也是图相比手写while循环的另一层保障。
5. Checkpointer(检查点器)—— 给图装个"存档点"
大白话:Checkpointer 把每一步之后的白板快照存下来。有了存档,图就能"中途停、之后接着跑"。
为什么它是 LangGraph 最实用的能力:普通链一旦崩了或想让人介入,中间状态全没了,只能重来。Checkpointer 让图变成"可暂停、可恢复、可回放"的流程,由此解锁三件事:
• 断点续跑:进程重启,用同一个thread_id接着上次继续。
• 时间旅行:恢复到历史某一步重跑,方便调试。
• 人工介入:在关键节点interrupt_before,把控制权交给人,人改完再resume。
类比:像游戏存档。thread_id就是存档槽——同一个槽读档,才接得上上次进度;换个槽就是从新游戏开始。
先说清一件事:Checkpointer 不是图自带的,而是compile(checkpointer=...)时"插"进去的。不传就是无存档模式,图照样能跑,只是崩了不能续。
from langgraph.checkpoint.memory import MemorySaver

checkpointer = MemorySaver()                  # 开发用(进程内,重启即丢)
app = builder.compile(checkpointer=checkpointer)

# thread_id 就是"存档槽",同一段会话的多次调用必须用它关联
app.invoke({"messages": [("user", "帮我查下深圳天气")]},
           config={"configurable": {"thread_id": "chat-001"}})
从"跑一步"到"能续跑"到底发生了什么——把上面那次调用拆开,看快照是怎么写、怎么读的:
1. 框架每跑完一个节点,就用当前白板(State)生成一份快照
2. 快照按 thread_id 归类存进 Checkpointer(MemorySaver 存在进程内存)
3. 这次调用的 thread_id="chat-001",所以快照都挂在 "chat-001" 这个槽下
4. 下次再用同一个 thread_id 调用(哪怕进程重启、换了 app 实例),
   框架先读槽里最新的快照,从那一步接着跑,而不是从头来
"接着跑"长这样——注意第二次调用完全没传新输入,只靠thread_id把存档读出来续上:
# 假设第一次跑到一半(比如等人工审核)停了,过会儿这样续:
app.invoke(None, config={"configurable": {"thread_id": "chat-001"}})
#                       ^ 传 None,框架从 "chat-001" 槽的最后快照恢复执行
对照看这三件事,Checkpointer 概念就立住了:
• 它"存"了什么:每个节点跑完后的整块白板快照,不是单条消息,是"那一刻的全部状态"。
• 它"靠什么"区分不同会话:全靠thread_id这个存档槽。写死同一个 id 或让多用户共用,会互相串档(详见 §19.1 实战坑)。
• 它"不是"什么:不是数据库、不是框架内置强制功能——是编译时可插拔的组件,选MemorySaver(开发)还是SqliteSaver/PostgresSaver(生产)只是换存储后端,上层的快照/恢复逻辑不变。
后端选型提醒:只有MemorySaver随主包提供(重启即丢,仅开发用)。要落盘得额外装包——SqliteSaver来自langgraph-checkpoint-sqlite,PostgresSaver来自langgraph-checkpoint-postgres。老教程里的from langgraph.checkpoint.postgres import ...在 1.x 已失效(详见官方迁移指南)。
深度提示:检查点粒度是"节点执行之后"。若图在节点 B 中途崩溃,重启后是从 B 之前的快照重跑 B,不是从 B 之后。所以节点要设计得"能被安全地重跑"(幂等)。
6. 五个概念组合起来的整体视图
单个看 State / Node / Edge / Graph / Checkpointer 容易各看各的。下面用三张图按「先认概念 → 再看流程 → 再看数据」递进,把关系讲清——一张图只讲一件事,避免信息挤在一起看不清。
图1 · 五个概念各自是什么。 先认清楚每个零件:
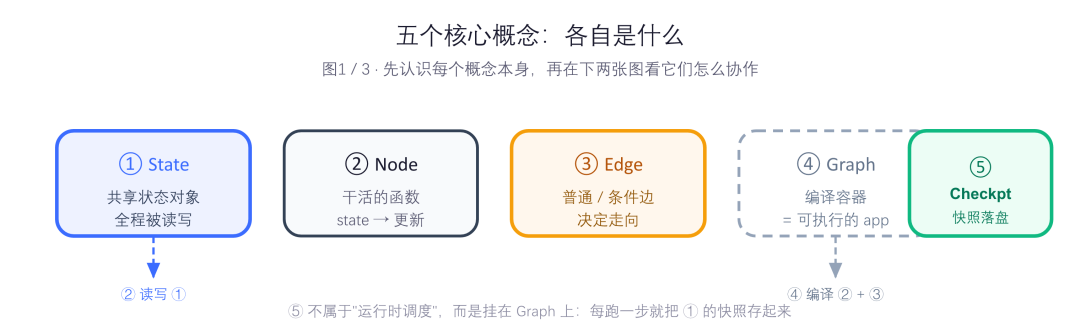
图1 核心概念各自是什么
图2 · 一次运行的流程。 Node 通过 Edge 串成一条可循环的控制流:从START进入agent(call_model),should_continue这个条件边读状态决定下一步——有tool_calls就走tools(call_tools),否则走到END;tools跑完经普通边回到agent,形成「模型决定调工具 → 执行 → 再交给模型」的循环。
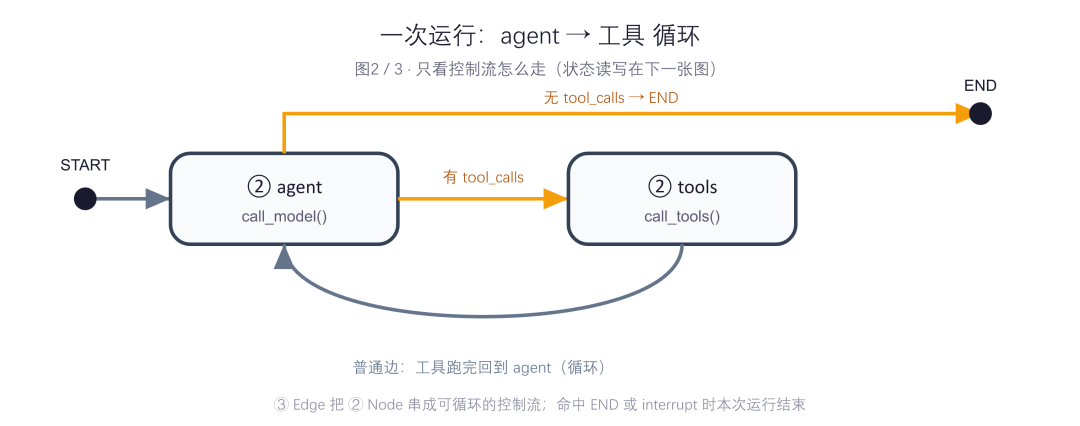
图2 一次运行流程
图3 · 状态与持久化。 流程之外,数据是这样流的:每个 Node 都读写同一个State,State合并后由Checkpointer每步落盘;崩溃或人工介入时用同一个thread_id从快照恢复,而不是从头再跑。
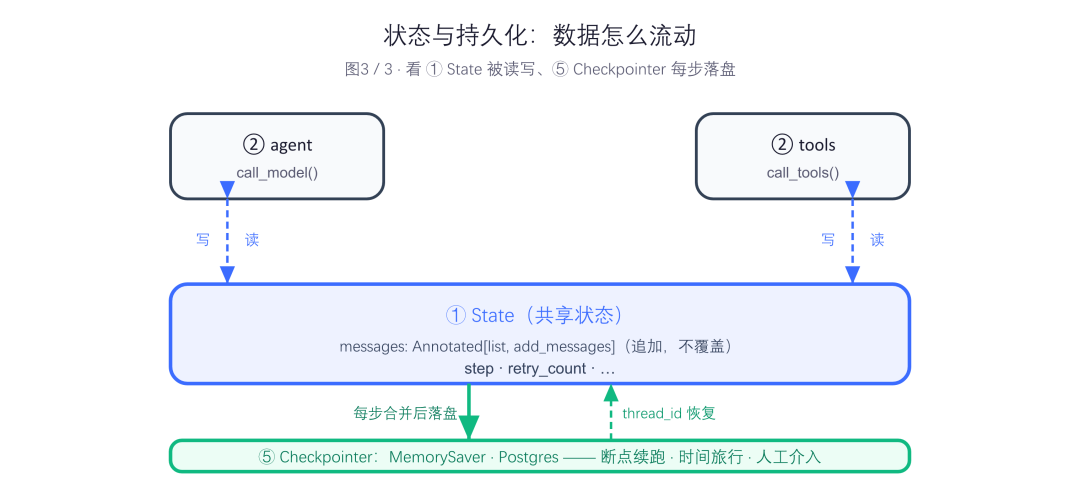
图3 状态与持久化
把三张图合起来看:Node 是干活的函数,Edge 决定 Node 之间怎么走,所有 Node 共享读写同一个 State,Graph 把 Node + Edge 编译成一个可执行的app,Checkpointer 则在每个 Node 跑完、State 合并之后把快照落盘——四者一起,才构成 LangGraph 区别于普通链的那套「可循环、可恢复、可干预」的能力。
三、基本工作原理与执行流程
3.1 执行模型
把上面的概念串起来,LangGraph 跑一次请求的真实流程是这样的:
        ┌─────────────┐
START -> │   Node A    │ ──(普通边)──-> ┌─────────────┐
        │ 读/写 State │               │   Node B    │ -> END
        └─────────────┘               │ 读/写 State │
              ^                       └─────────────┘
              │ 条件边返回 "A"
              └────────────────────────────┘  (循环)

每次节点执行后:State 按 reducer 合并 -> 写检查点 -> 按边规则选下一节点
1. 初始化:框架创建一个空的State(或基于检查点恢复)。
2. 入边:从START进入第一个节点。
3. 执行节点:节点函数拿到当前state,计算后返回更新片段。
4. 合并状态:框架用各字段的 reducer(如add_messages)把返回值合并回全局state。
5. 写检查点:如果配置了 checkpointer,把合并后的state落盘。
6. 选下一跳:普通边直接走;条件边调用路由函数,根据state决定下一个节点名,或END。
7. 循环 / 终止:回到第 3 步,直到命中END(或interrupt暂停)。
关键点在于:状态是全局共享且可被 reducer 累加的,流转方向由 state 动态决定。这正是它能表达「模型自我决定要不要再调一次工具」的原因。
3.2 底层引擎:为什么是「图」而不是「栈」
LangGraph 的运行时并非简单的递归调用。它内部把图编译成一种规划 + 调度的结构(早期版本基于 NetworkX 做拓扑分析,后续版本用自研的轻量执行引擎)。前面 §3.1 讲的那 7 步(入边→执行→合并→落盘→选下一跳→循环),本质就是这引擎在一遍遍重复"取一个待办、跑它、把新的待办塞回去"。它有三个值得说清的核心机制:
• 待处理队列(pending queue)—— "还有谁要跑"的待办清单
大白话:引擎内部维护一张"待执行节点"的清单。每跑完一个节点,就根据边规则,把"接下来该跑的节点"加进清单;引擎不断从清单里取一个出来跑,直到清单清空(走到END)或遇到interrupt暂停。
类比:像外卖平台的"待派单队列"——一个骑手送达后,系统把新订单塞进队列,调度器再派给下一个空闲骑手。代码里add_edge("tools", "agent")表面看是"调到 agent",实际动作是"往这张待办清单里再塞一个 agent 任务",这也是 LangGraph 能处理任意复杂 DAG + 循环的底层原因——它从不靠"一次性把流程图走完",而是靠"清单 + 逐个调度"。
• 超步(super-step)并行—— "互不打架的节点可以同时跑"
大白话:当多个节点彼此没有依赖(读写的 state 字段不冲突、或能安全合并)时,引擎可以在同一个调度轮次(称为一个"超步")里把它们一起并行执行,而不是排着队一个一个来。
类比:公司群里三个人各自改文档里不同的章节,完全可以同时改;但如果两个人都要改"摘要"那一节,就得排队。所谓"超步并行",就是引擎自动判断"这一轮哪些节点互不打架,放一起跑"。
为什么关键:多 Agent 扇出(fan-out)场景——一个 supervisor 同时派给 5 个子 Agent 各查一个数据源——这 5 个节点互不依赖,引擎就在同一个超步里并行跑完,总耗时≈最慢那一个,而不是 5 倍串行。前提是节点得是async(同步节点再怎么并行也还是排队)。
• 循环安全—— "允许回头,但得自己保证能停"
大白话:普通流程图工具怕"回到已访问节点"(会拓扑排序失败);LangGraph 因为用的是"队列 + 条件边"而非"拓扑排序一次性跑完",所以允许节点被重复访问——这正是 §3 里tools → agent → tools → agent循环能成立的根因。但代价是:引擎不会替你保证"循环一定会停",能不能收敛、会不会死循环,取决于你写的条件边路由函数。
类比:电梯允许反复上下楼(循环),但不会自己决定停哪层——得靠你按的楼层按钮(路由函数)最终指向"停下"。如果路由函数永远返回"再去 tools",图就永远转。should_continue里那句if last.tool_calls: return "tools"就是收敛开关——模型不再要求调工具时返回END,循环才结束。实战里常加一道保险:给工具调用次数设上限,超过就强制走END,防止模型抽风无限调工具。
把这三件事串起来:引擎靠待处理队列决定"下一轮跑谁",靠超步并行让互不依赖的节点同时跑,靠条件边 + 队列而非拓扑排序来支撑"允许回头"的循环——而循环的收敛责任,交给了你写的路由函数。
理解这个很重要:代码里的add_edge("tools", "agent")不是「函数调用返回」,而是「往调度队列里再塞一个 agent 任务」。这正是 LangGraph 能处理任意复杂 DAG + 循环的底层原因。
四、入门示例:一个带工具调用的对话机器人
下面用一个最小可运行的例子,搭一个能查天气的多轮对话机器人。模型如果发现需要天气信息,就触发工具节点,工具返回后模型再综合回答——这就是一个天然的「循环」。
from typing import Annotated, TypedDict
from langgraph.graph import StateGraph, START, END, MessagesState
from langgraph.graph.message import add_messages
from langgraph.prebuilt import ToolNode
from langchain_openai import ChatOpenAI
from langchain_core.tools import tool

# ---- 1. 定义工具 ----
@tool
def get_weather(city: str) -> str:
    """查询指定城市的天气(示例用假数据)"""
    return f"{city} 今天 26°C,多云,微风。"

tools = [get_weather]

# ---- 2. 定义状态(直接用内置的 MessagesState 即可)----
# MessagesState 等价于 { messages: Annotated[list, add_messages] }

# ---- 3. 定义节点 ----
llm = ChatOpenAI(model="gpt-4o-mini").bind_tools(tools)

def agent(state: MessagesState):
    return {"messages": [llm.invoke(state["messages"])]}

tool_node = ToolNode(tools)

# ---- 4. 路由:有工具调用就进工具节点,否则结束 ----
def should_continue(state: MessagesState):
    if state["messages"][-1].tool_calls:
        return "tools"
    return END

# ---- 5. 组装图 ----
builder = StateGraph(MessagesState)
builder.add_node("agent", agent)
builder.add_node("tools", tool_node)
builder.add_edge(START, "agent")
builder.add_conditional_edges("agent", should_continue)
builder.add_edge("tools", "agent")   # 工具结果回到 agent,形成循环

app = builder.compile()

# ---- 6. 运行(带检查点即可多轮)----
result = app.invoke(
    {"messages": [("user", "深圳天气怎么样?")]},
    config={"configurable": {"thread_id": "demo-1"}},
)
print(result["messages"][-1].content)
# => "深圳今天 26°C,多云,微风……"
跑起来会看到:用户提问 →agent节点决定调用get_weather→tools节点执行 → 结果回到agent→ 模型生成最终自然语言回答 →END。模型自己完成了「要不要调工具、调完再答」的循环判断,无需编写任何 if-else 控制主流程。
4.1 用 stream 看透每一步
想真正理解图在干什么,把invoke换成stream:
for chunk in app.stream(
    {"messages": [("user", "深圳天气怎么样?")]},
    config={"configurable": {"thread_id": "demo-1"}},
):
    print(chunk)
# 输出类似:
# {'agent': {'messages': [AIMessage(...tool_calls=[...])]}}
# {'tools': {'messages': [ToolMessage(...)]}}
# {'agent': {'messages': [AIMessage('深圳今天...')]}}
每一个 key 就是刚执行完的节点名,value 就是它写回 state 的增量。这种「逐节点可见」的特性,是后面做可观测性和调试的基础。
五、多步骤任务编排示例:固定 DAG 流水线
对话机器人是「循环型」用法。但 LangGraph 同样擅长固定流程型任务——比如一个「技术文章自动采集与审阅流水线」。它不涉及对话,却充分体现了「条件分支 + 人工介入 + 状态贯穿」的价值。
场景:给定文章 URL → 抓取 → 摘要 → 质量打分;分数 ≥ 7 直接发布,否则交人工审核;抓取失败则走通知分支。
from typing import TypedDict
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import MemorySaver
from langgraph.types import interrupt

class PipelineState(TypedDict):
    url: str
    raw_text: str
    summary: str
    score: float
    error: str           # 出错时记录,交给路由决定走向
    status: str          # draft / published / review / failed

llm = ...  # ChatOpenAI(...)

def fetch(state: PipelineState):
    try:
        text = http_get(state["url"])     # 伪代码:真实用 requests
        return {"raw_text": text}
    except Exception as e:
        return {"error": str(e)}          # 不抛异常,改成写 state

def summarize(state: PipelineState):
    r = llm.invoke(f"摘要下面的文章:\n{state['raw_text']}")
    return {"summary": r.content}

def score(state: PipelineState):
    r = llm.invoke(f"给质量打分0-10:\n{state['summary']}")
    return {"score": float(r.content)}

def human_review(state: PipelineState):
    # 质量不达标,暂停交人工;resume 时带回人工决定
    decision = interrupt({"need_review": state["summary"]})
    return {"status": "review" if decision == "reject" else "published"}

def publish(state: PipelineState):
    return {"status": "published"}        # 伪代码:写库/发通知

def notify(state: PipelineState):
    return {"status": "failed"}           # 伪代码:告警

# 路由函数:根据 state 动态选下一跳
def route_after_fetch(state: PipelineState):
    return "summarize" if not state.get("error") else "notify"

def route_after_score(state: PipelineState):
    return "publish" if state["score"] >= 7 else "human_review"

b = StateGraph(PipelineState)
b.add_node("fetch", fetch)
b.add_node("summarize", summarize)
b.add_node("score", score)
b.add_node("human_review", human_review)
b.add_node("publish", publish)
b.add_node("notify", notify)

b.add_edge(START, "fetch")
b.add_conditional_edges("fetch", route_after_fetch)   # summarize | notify
b.add_edge("summarize", "score")
b.add_conditional_edges("score", route_after_score)   # publish | human_review
b.add_edge("publish", END)
b.add_edge("human_review", END)
b.add_edge("notify", END)

app = b.compile(checkpointer=MemorySaver())
上面这 15 行就是整张图的「图纸」。拆开看,它只干了两类事:先摆点(节点),再连边(流转规则)。
先摆点:6 个节点各管一件事
b.add_node("fetch", fetch)
这一行把「名字叫fetch的节点」和「真正干活的fetch函数」绑定起来。前面 6 行add_node就是在白板上贴了 6 张便签:fetch(抓取)、summarize(摘要)、score(打分)、human_review(人工审核)、publish(发布)、notify(通知)。此刻它们之间没有任何连线,图还跑不起来——add_node只负责「注册」,不负责「让它下一步去哪」。
再连边:边决定「跑完一个节点后去哪」
•b.add_edge(START, "fetch")是一条普通边,意思是「图一启动,先去fetch」。它唯一、固定,没有分支。
•b.add_edge("summarize", "score")也是普通边:summarize跑完必然去score,中间不判断。
•b.add_edge("publish", END)/("human_review", END)/("notify", END)三条普通边,表示这三个节点跑完就到终点END,流程结束。
• 而b.add_conditional_edges("fetch", route_after_fetch)和b.add_conditional_edges("score", route_after_score)是条件边:它们不直接写死下一个节点,而是把「下一个去哪」交给一个路由函数决定。运行时fetch跑完后,框架会调用route_after_fetch(state),根据 state 当前内容返回"summarize"或"notify";同理score跑完由route_after_score在"publish"和"human_review"之间二选一。
点 + 边如何拼成一个可运行的图
把点想成车站、边想成轨道:
• 普通边是单行道——列车到站只能沿唯一轨道开向下一站;
• 条件边是道岔——列车到站后,道岔函数看一眼「当前 state(信号灯)」决定扳向哪条轨道。
所以这张图的实际形状是:一条主线START → fetch → summarize → score串下来,在fetch和score两个道岔处各分出一叉——fetch分叉到notify(出错时),score分叉到human_review(分数不达标时);主线终点publish、两个分叉终点notify/human_review最终都汇入END。compile()做的事,就是把这个「车站 + 轨道 + 道岔」的图纸编译成可执行的运行时。
三个关键认知(收口)
1. 节点之间默认不连通,必须靠add_edge/add_conditional_edges显式连——漏连一条边,列车就开不到下一站(表现为「图停在某个节点不结束」)。
2. 条件边的「下一步」永远由路由函数的返回值决定,返回值必须是已add_node注册过的节点名或END;返回没注册的名字会直接报错。
3.START和END是框架保留的虚拟节点,不用add_node注册,只用在边里当起点/终点——正因如此,图有且只有一个入口(START),但可以有多个出口(多个节点都连到END)。
这个例子和对话机器人有本质区别:它的主流程是固定的 DAG(fetch → summarize → score),分支靠「打分」和「是否出错」两个运行时条件触发,且把「人工审核」建模成图里的正规节点。这正是 RAG 流水线、文档处理、ETL+AI 这类场景的典型写法。
六、RAG 检索节点示例:把「检索」建模成一个普通节点
前面场景表里反复提到 RAG,但还没给过真实代码。RAG 在 LangGraph 里的本质,就是把「向量检索」做成一个普通节点,检索结果写进 state,再交给生成节点。
from typing import Annotated, TypedDict
from langgraph.graph import StateGraph, START, END

# 假设索引已离线构建好
from langchain_community.vectorstores import FAISS
from langchain_openai import OpenAIEmbeddings

embeddings = OpenAIEmbeddings()
vs = FAISS.load_local("kb_index", embeddings)   # 预构建的本地索引

class RAGState(TypedDict):
    question: str
    context: str          # 检索到的上下文
    answer: str

def retrieve(state: RAGState):
    docs = vs.similarity_search(state["question"], k=3)
    return {"context": "\n\n".join(d.page_content for d in docs)}

def generate(state: RAGState):
    prompt = f"问题:{state['question']}\n上下文:{state['context']}\n回答:"
    return {"answer": llm.invoke(prompt).content}

b = StateGraph(RAGState)
b.add_node("retrieve", retrieve)
b.add_node("generate", generate)
b.add_edge(START, "retrieve")
b.add_edge("retrieve", "generate")
b.add_edge("generate", END)

app = b.compile()
这就是最经典的 RAG 固定 DAG:retrieve → generate。要加「重排」「自评」「无相关结果时反问用户」等分支,无非是多挂几个节点 + 条件边,图的写法完全一致。注意:检索节点返回的是纯数据(context 字符串),不依赖 LLM,所以它可以和模型节点并行、可独立单测(见 §八)。
七、进阶模式与生产可靠性
入门示例只是冰山一角。生产里的 LangGraph 应用通常用以下模式组合出来——前一小半是「能力拓展」类模式(子图、多 Agent、人机协同、时间旅行、流式、异步),后一小半是「稳不稳」类模式(重试、错误边、熔断兜底),两者共同决定一个图能不能上生产。
7.1 子图(Subgraph):图的嵌套与复用
一个复杂系统往往由多个子流程组成,例如「售前咨询机器人」内部包含一个「订单查询子图」。LangGraph 允许把一张编译好的图直接作为一个节点加到另一张图里:
# order_graph 是已 compile 的子图
parent_builder = StateGraph(ParentState)
parent_builder.add_node("chat", chat_node)
parent_builder.add_node("order_lookup", order_graph)  # 子图作为节点
子图有独立的状态 schema,通过父图与子图 state 之间的「状态通道(state keys 交集)」传递数据。好处是:子图可以单独测试、单独部署、被多张父图复用。
7.2 多 Agent 协作:Supervisor 模式
当任务需要多个专长 Agent(如「写代码的 Agent」「做检索的 Agent」「审稿的 Agent」),最经典的写法是 Supervisor(supervisor-worker):
     ┌──────────────┐
───> │  Supervisor  │ ── 派活给 ──> Worker A
     │ (路由决策)    │ ── 派活给 ──> Worker B
     └──────────────┘ <── 回收结果 ──┘
           │
       回到 Supervisor 或 END
Supervisor 节点本身是一个 LLM,它根据当前 state 决定「下一步交给哪个 worker」,worker 执行完把结果写回 state 再回到 Supervisor,直到 Supervisor 判断任务完成。这等价于一个由 LLM 动态调度的状态机,比把全部能力塞进一个巨型 prompt 更可控、更易观测。
LangGraph 官方提供了langgraph-supervisor库和预建的create_supervisor,可以几行代码搭出这种多 Agent 拓扑,无需手写所有边。
2026 演进:Supervisor 之外,LangChain 现在把 Deep Agents(基于 LangGraph 的高层包)作为「复杂自主任务」的推荐入口——它能规划、调子 Agent、用文件系统做长期工作记忆。若只想要一个能跑的自主 Agent、不想自己画边,可以先试 Deep Agents;要完全掌控则用本文的StateGraph+ Supervisor。另一个 2026 新增能力是异步子 Agent(async subagents):基于 Agent Protocol,子 Agent 跑在独立进程、持有自己的状态,可同时拉起成千上万个,适合「研究型 / 长任务扇出」场景。
7.3 人机协同(Human-in-the-loop)
很多生产流程不能让模型「一言堂」:比如模型要发起一笔退款、要删除数据、要对外发邮件。LangGraph 用interrupt把控制权交还给人:
from langgraph.types import interrupt, Command

def human_approval(state):
    # 暂停,把待确认信息抛给调用方
    decision = interrupt({"question": "确认要执行退款吗?", "amount": state["amount"]})
    if decision == "approve":
        return {"status": "refunded"}
    return {"status": "cancelled"}

# 调用方在外部恢复:
app.invoke(Command(resume="approve"),
           config={"configurable": {"thread_id": "x"}})
配合 checkpointer,即使人工审批隔了几个小时,图的上下文也完好无损。这是 RPA、金融、医疗等强合规场景的刚需。
7.4 时间旅行(Time-travel)与回放
因为每一步都存了检查点,所以能「回到过去」:
# 取出某个历史检查点,从那一步重新跑
config = {"configurable": {"thread_id": "demo-1",
                           "checkpoint_ns": "",
                           "checkpoint_id": "abc123"}}
app.invoke(None, config)   # 从该检查点续跑
用途包括:debug 时复现某次失败、A/B 试不同分支、对同一个输入换不同模型重跑某一步。这在传统「链」里基本做不到。
7.5 流式输出(Streaming)
app.stream不仅按节点 yield,还可以按mode控制粒度:
•mode="values":每次 state 变更后 yield 整个 state(默认)。
•mode="updates":只 yield 节点写回的增量(调试最常用)。
•mode="messages":把节点内部 LLM 的 token 级流式输出也透传出来,做打字机效果 UI。
7.6 异步节点与 ainvoke
节点可以声明为async def,配合ainvoke/astream实现非阻塞执行;当多个互相独立的异步节点存在时,运行时会在同一超步内并发它们。
async def call_model_async(state):
    resp = await llm.ainvoke(state["messages"])   # 非阻塞调用
    return {"messages": [resp]}

builder.add_node("agent", call_model_async)
# 异步入口
result = await app.ainvoke(
    {"messages": [("user", "hi")]},
    config={"configurable": {"thread_id": "demo"}},
)
要点:并发收益来自 I/O 重叠(如并行发起多个工具/API 调用),不是让单个串行 LLM 调用变快。若节点是「一个接一个」的依赖链,async 不会缩短整体延迟,只是不阻塞事件循环。
7.7 节点级重试(RetryPolicy)
前面 7.1–7.6 是「能力拓展」,下面 7.7–7.9 解决「图跑在生产里挂了怎么办」。节点里抛异常,默认会向上传播并中止整张图的运行;生产需要更稳妥的策略,LangGraph 提供两条互补路径。
给节点声明重试策略,框架会在节点抛指定异常时自动重跑,无需手写try/except:
from langgraph.types import RetryPolicy

# 仅在超时类异常时重试,最多 3 次
b.add_node(
    "fetch",
    fetch,
    retry=RetryPolicy(max_attempts=3, retry_on=TimeoutError),
)
说明:RetryPolicy在 1.x 是一个 NamedTuple,常用字段max_attempts(含首次的总尝试次数,默认 3)与retry_on(异常类型或可调用判定,默认重试所有异常)。跨大版本时字段仍建议对照所安装版本的源码确认(详见官方迁移指南)。
7.8 把「失败」也建模成一条边
更可控的写法是不让节点抛异常,而是把错误写进 state,再由路由函数决定走向——这样失败成了图里的「一等公民」,而不是意外崩溃:
def fetch(state):
    try:
        return {"raw_text": http_get(state["url"])}
    except Exception as e:
        return {"error": str(e)}     # 写 state,而非 raise

def route_after_fetch(state):
    return "summarize" if not state.get("error") else "notify"
这种「显式错误通道」的好处是:失败路径可观测、可测试、可走人工兜底,而不是默默丢失上下文。
7.9 熔断与兜底
对于依赖外部服务的节点(LLM、数据库、第三方 API),建议组合使用:重试(瞬时故障)+ 错误边(持久故障进兜底节点)+ 幂等设计(见 §八)。不要把「重试」当成万能药——对「参数错误」「权限不足」这类永久失败,重试只会白白烧 token。
八、可观测、测试与生产化:让图稳稳上线
图写完了,离「能放心用」还差一段路:能不能看清它每一步在干什么(可观测)、改了之后能不能自动验证(测试)、跑挂了能不能快速定位(调试)、上线后能不能量化它做得对不对(评测)。这四件事在传统开发里分属不同岗位,但在 LangGraph 里被同一套「状态 + 检查点 + 纯函数节点」串成了一条链——下文按「观测 → 测试 → 排错 → 评测」的顺序依次展开,合在一起就是「让图稳稳上线」的完整闭环。
8.1 怎么看清图在干什么
• stream(mode="updates"):最低成本的实时观测,逐个节点打印增量。
• LangSmith Deployment(原 LangGraph Platform)与 LangSmith Studio(原 LangGraph Studio):官方平台提供每一步的 state 快照、token 消耗、耗时瀑布图,以及在 UI 里直接「回退到某步重跑」。本地开发用langgraph dev(默认 2024 端口、免 Docker、热重载,自带 Studio UI)或langgraph up(基于 Docker 的近生产环境);生产上线用langgraph deploy一键推到 LangSmith Deployment,图在langgraph.json里声明。
• 自建日志:在节点里用装饰器统一打印入参/出参 state,配合thread_id串起一次完整会话。
8.2 生产落地的几个要点
1. 检查点存储选型:开发用MemorySaver(随主包,重启即丢)。生产务必换成落盘后端——SqliteSaver(来自langgraph-checkpoint-sqlite,单机够用)或PostgresSaver(来自langgraph-checkpoint-postgres,支持多实例共享同一份状态、适合横向扩展)。两者都需先pip install对应包。
2. 节点幂等:因为崩溃会从节点「之前的快照」重跑,节点里的副作用(写库、发消息)要做到可重入,或把副作用放进专门的「提交节点」并配合interrupt兜底。
3. 防止失控循环:条件边的路由函数要设计收敛条件,例如「工具调用超过 N 次就强制 END」「检测到重复回答就退出」,否则模型可能陷入无效循环烧 token。
4. 并发与超步:fan-out 场景(多个 worker 并行)要注意它们写回 state 的字段不能互相覆盖,否则并行变串行甚至丢数据。
5. 版本稳定性:LangGraph 在 1.0 之前迭代较快、API 曾有较大变动(如MessagesState的引入、compile参数调整)。当前 1.x 已趋稳定,但跨大版本升级仍建议锁定版本号并跑一遍图的行为回归测试。
8.3 测试图
写完图,还要能测、能上线,这条链路才完整。
LangGraph 的图本质是「纯函数 + 状态」,测试成本很低(节点通常不依赖 LLM/外部服务的部分可脱离这些依赖单测,依赖部分用 Mock 注入):
# 1) 单测纯函数节点:把 LLM / 外部依赖用 Mock 注入,不依赖真实服务
def test_summarize(monkeypatch):
    # 用 stub 替换 llm,固定返回可控结果,节点本身逻辑(拼 prompt->取 content)仍真实执行
    monkeypatch.setattr("__main__.llm", type("M", (), {
        "invoke": lambda self, _: type("R", (), {"content": "LangGraph 是图编排框架。"})()
    })())
    out = summarize({"raw_text": "x", "score": 0.0})
    assert "LangGraph" in out["summary"]

# 2) 单测路由函数:纯逻辑,无需 LLM,直接断言分支
def test_route_after_score():
    assert route_after_score({"score": 9.0}) == "publish"
    assert route_after_score({"score": 3.0}) == "human_review"

# 3) 端到端跑图(依赖真实 LLM/网络的部分用 Mock 替换 fetch、summarize、score)
def test_pipeline_end_to_end(monkeypatch):
    # 把三个依赖外部资源的节点都换成 stub,只验证「图 Topology + 路由」是否正确
    monkeypatch.setattr("__main__.fetch", lambda s: {"raw_text": "正文"})
    monkeypatch.setattr("__main__.summarize", lambda s: {"summary": "摘要"\})
    monkeypatch.setattr("__main__.score", lambda s: {"score": 9.0})
    res = app.invoke({"url": "https://example.com/post"},
                     config={"configurable": {"thread_id": "test-1"}})
    assert res["status"] in ("published", "review", "failed")
要点:节点写成无副作用的纯函数(副作用留给专门的提交节点 +interrupt),测试就能脱离 LLM/数据库独立跑;依赖外部服务的节点用 Mock 注入,只验证拓扑与路由逻辑。
8.4 部署成服务
最省事的是用官方 LangServe 把图直接暴露成 HTTP:
# serve.py
from fastapi import FastAPI
from langserve import add_routes
from your_module import app as graph_app   # 编译好的 LangGraph

api = FastAPI()
add_routes(api, graph_app, path="/agent")
# uvicorn serve:api --host 0.0.0.0 --port 8000
或者只在外部用 FastAPI 包一层,自己控制请求/响应结构:
from fastapi import FastAPI

api = FastAPI()

@api.post("/chat")
def chat(req: dict):
    return graph_app.invoke(
        req["input"],
        config={"configurable": {"thread_id": req["thread_id"]}},
    )
无论哪种,记得:生产环境 checkpointer 必须换成持久化的(Sqlite/Postgres),thread_id由客户端/会话层稳定传入,否则每次请求都是新会话。
8.5 调试排错 walkthrough
图跑不起来时,绝大多数问题集中在这几类。按现象对号入座:
|
现象 |
根因 |
排查 / 修复 |
|---|---|---|
| 图不结束、一直转 |
条件边永远不返回 |
给路由函数加收敛条件:工具调用次数上限、重复回答检测;调试期用 |
| 记忆断片 / 不续聊 | config
漏传 |
固定 |
| 历史被覆盖、多轮失效 | messages
没配 |
状态里消息字段必须用 |
| 检查点写不进 / 导入报错 |
没装对应包,或照老教程写 |
1.x 改用 |
interrupt后卡住 | resume
时没传 |
用同一 |
| “x is not a valid state key” |
节点返回了 state schema 之外的字段 |
节点返回值只能是 state 里声明的键 |
| 工具结果没回到模型 | ToolNode
输出没接回 agent 的边 |
确认有 |
第一性原理:图是「节点 + 边 + 状态」三件套。出问题时分别问——节点返回值对吗?边(尤其条件边的路由函数)返回了合法的下一个节点名吗?状态按 reducer 正确合并了吗?这三问能定位 90% 的坑。
8.6 实战踩坑:不报错但会咬人的陷阱
上面的排错表解决「跑不起来」。下面这些则是跑起来了、却不按预期工作的隐性陷阱——它们通常不抛异常,排查起来更费时间,是实战里最容易被咬的地方。
1. 部分状态更新把别的节点的值覆盖掉
只有messages配了add_messages这类 reducer;开发者自己加的标量字段(如score、status、retry_count)默认是「整体覆盖」。某个节点只要返回了含该字段的字典,框架就用返回值整体替换那个字段——多个节点写同一个标量就会互相踩。
def node_a(state):
    return {"score": 8}          # 写了 score = 8
def node_b(state):
    # 只写 status,score 不动 ✅
    return {"status": "ok"}
# 但若 node_b 误写成 {"score": 0, "status": "ok"},node_a 刚写的 8 就被悄悄抹掉
避坑:跨节点共享的字段,要么各节点只写自己的键、绝不回写别人的键;要么显式声明 reducer(如Annotated[int, max]、Annotated[set, lambda a, b: a | b])。
2. 把stream的增量当成最终 state
app.stream每次 yield 的是「刚执行完那个节点写回的片段」,不是累积全量。新手常写出:
final = None
for chunk in app.stream(input, config):
    final = chunk                 # ❌ 每轮被覆盖,最后只剩最后一个节点的增量
# 想要全量,用 mode="values",或自己合并:
for chunk in app.stream(input, config, mode="values"):
    final = chunk                 # ✅ values 模式每次给的是合并后的完整 state
3. 想从检查点续跑,却把 input 又传了一遍
app.invoke(input, config)的input会合并进当前 state。时间旅行 / 恢复时若还传原始 input,历史会被重复追加,分支直接错乱。续跑应传None,只靠 config 里的thread_id+checkpoint_id定位:
app.invoke(None, config={"configurable": {"thread_id": "demo",
                                         "checkpoint_id": "abc123"}})
4. thread_id写死 / 串台,多会话互相污染
随手写"thread_id": "demo"(尤其测试或单用户 demo),多个请求 / 用户共用同一 id,state 互相串台——A 的上下文跑到 B 的对话里。生产必须由会话层稳定且唯一地传入(用户 ID + 会话 ID),绝不用常量。
5. 异步节点里调了同步阻塞 IO,卡死整个事件循环
节点标了async def,内部却用requests.get(阻塞)而不是httpx.AsyncClient/aiohttp:这一节点把事件循环卡住,所谓「超步并行」全失效,甚至其他协程饿死。混用 async 时,节点内所有 IO 都必须是非阻塞的。
6. ToolNode把工具异常吞成了ToolMessage
工具里抛异常时,ToolNode不会向上抛,而是把错误文本包成一个ToolMessage塞回 state——模型「看到」的是一段报错而不是成功结果。新手以为工具跑通了,实际是错误进了上下文,可能误导模型下一步决策。需要严格失败处理时,要么在工具内部捕获并返回结构化错误,要么用 §七 7.8 的显式错误边,别依赖异常自动上浮。
7. 条件边返回了未注册的节点名,静默走到END
路由函数拼错节点名、或返回大小写不一致的字符串,add_conditional_edges不会做校验,结果往往是「图提前结束、该跑的节点没跑」。养成习惯:路由返回值做成常量 / 枚举,或在测试里断言每个分支返回的都是已add_node的名字。
8. 把检索 / 工具的大结果直接塞进messages被累加放大
把整篇文档、长 JSON 作为ToolMessage内容返回,又因add_messages每轮累加,几轮下来这些大块文本被反复带入上下文,token 成本平方级膨胀(§十一)。正确做法:state 里只存引用 / ID / 摘要,原始大对象放外部存储(向量库、KV、对象存储),按需取用。
一句话收口:LangGraph 的坑大多不在「语法」,而在「状态怎么合并、上下文怎么累积、并发怎么调度」这三件运行时的事。把 §二 的 reducer、§十一 的 state 体积、本节的状态合并顺序想清楚,能挡掉大部分实战雷。
8.7 评测(Evals):怎么证明图「做对了」
写完图不等于做完,还要能量化它的行为。评测 LangGraph 应用有几条互补路径:
• LangSmith 追踪:LangChain 生态原生集成,自动记录每一步的 state 快照、token 消耗、耗时瀑布图。在线跑真实流量时,可在平台对轨迹做标注与回归比对。
• 离线轨迹回放:检查点存下的状态可用time-travel(§七 4)从某个历史节点重跑,对固定输入比对不同分支/不同模型的输出——不花额外 token 就能复现问题。
• 断言式 eval:对app.invoke的最终结果写 pytest 断言,适合闭环明确的任务。例如:
def test_pipeline_publishes():
    res = app.invoke({"url": "https://example.com/post"},
                      config={"configurable": {"thread_id": "eval-1"}})
    assert res["status"] in ("published", "review")
    assert "LangGraph" in res["summary"]
• LLM-as-judge:对开放任务(如「回答是否合理」「工具选择是否恰当」),用一个强模型对图的输出或轨迹打分。适合没有唯一正确答案的场景,但要防 judge 本身被注入(见 §十二 安全)。
关键前提:节点写成纯函数、副作用隔离(§八),评测才能稳定、可重复地跑,而不必每次都真去调 LLM 或外部 API。
九、典型应用场景
|
场景 |
为什么适合用 LangGraph |
|---|---|
| 多轮对话 / 客服机器人 | MessagesState
+ checkpointer 天然支持上下文记忆与断线续聊 |
| 多步骤任务编排(RAG 流水线) |
检索 → 重排 → 生成 → 自评,可作为固定节点串成图(见 §五/§六) |
| 带工具 / 自主决策的 Agent |
条件边让「模型决定下一步」成为一等公民,支持 ReAct 式循环 |
| 需要人工审核的流程 | interrupt
在关键节点暂停,人确认后再 |
| 长任务 + 故障恢复 |
检查点让任务在崩溃后从最近状态续跑,不必从头来 |
| 多 Agent 协作 |
Supervisor 模式 + 子图,把不同专长 Agent 编排成可观测系统 |
| 可审计 / 可回放的业务流 |
时间旅行 + 检查点,满足金融/医疗合规审计需求 |
十、与竞品框架的横向对比
选框架时,光和「普通 Chain」比还不够。把 LangGraph 放进更大的坐标系,才知道它适合哪类问题。
|
框架 |
核心范式 |
状态/持久化 |
循环/分支 |
人工介入 |
最适合 |
|---|---|---|---|---|---|
| LangGraph |
显式图 + State + Checkpointer |
强(原生快照/时间旅行) |
一等公民 |
一等( |
有状态 Agent、需恢复/审核/审计的流程 |
| OpenAI Agents SDK |
轻量 Agent 循环(agent/handoff/guardrails) |
弱(RunState 序列化 + Sessions 自接) |
handoff 分支 |
RunState 续跑 |
OpenAI 原生、轻量嵌入已有服务 |
| LlamaIndex Workflows |
事件驱动(event → step) |
弱(默认无持久化,需自接) |
事件触发分支 |
需自接 |
复杂异步 RAG、文档处理管线 |
| Haystack Pipelines |
声明式 YAML/代码流水线 |
弱(偏一次性执行) |
声明式分支 |
弱 |
标准化 RAG、搜索/问答 |
| 自写状态机
(Python + dict + while) |
任意 |
自己实现 |
任意 |
自己实现 |
极简任务、学习原理、完全掌控 |
| 原生 Chain + while |
线性链包循环 |
无 |
while 控制 |
无 |
一次性短循环、快速原型 |
怎么选(决策线):
• 需要持久化 / 恢复 / 人机协同 / 时间旅行 → LangGraph。
• 主要是标准化 RAG、检索问答,不想管图 → Haystack。
• 是事件流、异步文档管线,且不需要把状态落盘 → LlamaIndex Workflows。
• 只是玩具 / 学习 / 完全掌控,或团队不愿引入图概念 → 自写状态机也行,代价是维护成本全自己扛。
关键认知:LangGraph 的差异化不在「能画图」,而在把状态持久化 + 人机协同 + 可回放做成原生能力。若场景根本不需要这三者,它的图抽象反而是负担。
2026 坐标系补充:同赛道还有 CrewAI(角色扮演式多 Agent)、AutoGen(微软,对话式多 Agent)、Microsoft Agent Framework、Mastra(TS 优先)、PydanticAI(类型安全 Agent)、Deep Agents(LangChain 高层封装)。其中 OpenAI Agents SDK(2025-03 发布,OpenAI 原生) 是最直接的对手:更轻、概念更少,2026-02 起通过可序列化RunState、Sessions 与沙箱快照补齐了「持久化 / 续跑」短板;但在「图级精细控制、时间旅行、企业级 checkpointer」上仍不如 LangGraph 原生。选型按「要轻量嵌入 vs 要可控长跑」二选一,而非谁更流行。
10.1 反模式:什么时候不该用 LangGraph
文章通篇在推它,但诚实地说,以下场景硬上 LangGraph 是过度设计:
• 简单单轮任务(如一次性 summarization、单轮 RAG 问答):用 LCEL 链更轻,图反而增加样板代码。
• 纯同步线性脚本,没有任何循环/分支/状态累积:一张直线图 = 一条链,毫无收益。
• 把整个逻辑塞进一个巨型节点:节点里写满 if-else 和业务逻辑,图退化成「只有一个节点的壳」——失去了可观测、可恢复、可并行的全部优势。正确做法是把步骤拆成多个小节点。
• 无收敛条件的循环:条件边永远不返回END(如「模型每次都说还要调工具」),会陷入死循环烧 token。路由函数必须设计退出条件(调用次数上限、重复检测)。
• 把 secrets / 大对象放进 state:state 会被 checkpointer 持久化到数据库——API key 写进 state 等于把密钥落库;大对象拖慢每次序列化。
• 不锁版本就上线:跨大版本升级(尤其 1.0 之前版本的 API 曾有较大变动)即踩坑,上线务必锁定版本并跑一遍图的行为回归(见官方迁移指南)。
判断准绳:「我需要循环、需要跨调用保存状态、需要让人中途介入、需要崩了续跑」这四条,命中两条以上才值得上 LangGraph。
十一、性能与成本:什么时候该担心
LangGraph 本身的运行时开销很小,真正的成本几乎都在 LLM 调用和检查点 I/O 上。按经验量级梳理:
• 检查点写入:单步一次 DB 写,典型耗时 毫秒级;而一次 LLM 调用往往是 数百毫秒到数秒。所以 checkpointer 开销相对 LLM 延迟通常可忽略——一旦把大对象(如整篇文档的 embedding)塞进 state,序列化成本会陡增。结论:别把大对象放 state,只放引用/ID。
2026 优化(DeltaChannel):v1.2 引入的 DeltaChannel(增量通道) 让 checkpointer 只写「相对上一步的 diff」而非整份状态快照,进一步压低高频检查点的写入成本——对中等规模 state、多并发场景收益明显。但它不改变铁律:大对象(整篇文档 embedding、大文件)仍不该直接进 state,diff 也救不了序列化体积。
• 高并发瓶颈:每步一次写,意味着数千个并发thread_id时,PostgresSaver会成为写瓶颈。缓解:用异步连接池、对短暂会话用MemorySaver、或降低检查点频率(只在关键节点interrupt/落盘)。
• 超步并行:只有当多个节点互相独立且使用 async 时,引擎才真正并行。若节点是串行 LLM 调用,并行不会凭空缩短单请求延迟;并行收益主要来自 I/O 重叠(如同时发起多个工具调用)。
• Token 成本(最容易被忽视):add_messages让上下文每轮累加。下面这张表把「平方增长」落到实处——假设每轮新增约 500 token 上下文,模型调用始终带全量历史:
|
轮次 |
当轮带入上下文 (token) |
累计消耗 (token) |
|---|---|---|
|
1 |
500 |
500 |
|
2 |
1,000 |
1,500 |
|
3 |
1,500 |
3,000 |
|
4 |
2,000 |
5,000 |
|
5 |
2,500 |
7,500 |
|
累计消耗约 |
• 延迟体感:invoke会等整张图跑完才返回;用stream可以边跑边吐中间结果,显著改善用户体感。
一句话:LangGraph 不是性能瓶颈,「把什么放进 state」和「模型被调用多少次/带多少上下文」才是。优化重点永远在后者。
十二、安全与权限:最小实践
图把多个步骤和(可能的)多个 Agent 串在一起,攻击面也随之扩大。几条务实的底线:
1. 最小权限(least privilege):多 Agent 场景里,每个 worker 只应拿到它需要的工具。不要把「全部工具」一股脑 bind 给所有节点——权限越大,模型误用或越权调用的风险越高。
2. interrupt的 resume 输入要像外部输入一样对待:Command(resume=...)是外部穿越进来的数据,必须校验、鉴权,防止恶意 resume 注入伪造的 state(例如伪造「已审批」)。
3. Checkpointer 存的是全文:state 里可能包含对话、PII、业务数据,落盘后就是一份完整副本。生产用PostgresSaver时要加密静止存储、收紧库权限、设 TTL 清理。
4. 工具结果 / 检索内容是不可信输入:模型基于工具返回或检索文档来决定下一步,这本身就是 prompt injection 的入口。对外部内容做净化、约束模型可选动作,不要让它「自由发挥」地执行高危操作。
5. 密钥绝不进 state:API key、token 应放在环境变量或节点闭包里,而不是 state 字段——因为 state 会被持久化。这是最容易被忽略、后果最严重的一条。
十三、认知拓展:图不止用于 LLM
一个容易误导的心智模型是「LangGraph = Agent 专属框架」。其实它底层是一个通用的有状态编排引擎——节点可以是任意 Python 函数,LLM 只是其中一种节点类型。
这意味着完全可以用它编排不含任何模型的业务工作流,照样享受状态持久化、人工介入、可回放:
validate -> charge_api -> notify
                  │
              (异常) -> human_approve (interrupt) -> refund / abort
上面的退款审批流没有一个 LLM 节点,但「中途让人审核、崩了能从审核前续跑、每一步可审计」这些能力照常生效。把 LangGraph 当成「带检查点的状态机 + 流程 DSL」,其用武之地远不止聊天机器人。
十四、总结
LangGraph 的本质,是把 LLM 应用从「一段直线代码」重构成「一张有状态的有向图」:
• State 解决「全局数据共享与累加」;
• Node / Edge 解决「步骤与流转,含分支和循环」;
• Checkpointer 解决「持久化、续跑、可干预」;
• Subgraph / Supervisor 解决「复杂系统的模块化与多 Agent 协作」;
• RetryPolicy / 错误边 / 安全最小权限 解决「生产可用性与可靠性」。
它不替代 LangChain,而是站在 LangChain 之上,补齐了「复杂控制流」这一块短板。要不要上它,判断准绳很朴素:「需要循环、需要跨调用保存状态、需要让人中途介入、需要崩了续跑」这四条,命中两条以上,LangGraph 就是当下生态里最直接的那块拼图;否则,一条 LCEL 链可能更干净。 而它作为通用编排引擎的另一面(§十三)也提醒我们:图的边界,由流程复杂度决定,而非是否用到了 LLM。
下一步建议:先用 §四 的天气机器人把最小闭环跑起来,建立「图能循环」的体感;再依次加入 checkpointer 持久化(§二 5)、固定 DAG 流水线(§五/§六)、人工interrupt(§七)、多 Agent 节点(§八 之前的进阶模式);最用 §八 的可观测、测试、调试与评测把质量关起来。不要一上来就追求完整架构——先把最小闭环跑起来,再逐步长胖。
附录一:核心 API 速查表
|
API |
一句话说明 |
|---|---|
StateGraph(schema) |
创建图容器,入参是状态 schema(TypedDict / MessagesState) |
add_node(name, fn) |
注册一个节点(函数 / async 函数 / Runnable / 子图) |
add_edge(a, b) |
添加固定边: |
add_conditional_edges(a, route_fn) |
添加条件边: |
compile(checkpointer=...) |
编译成可执行 |
app.invoke(input, config) |
同步跑完整个图,返回最终 state |
app.stream(input, config, mode=...) |
逐步产出节点增量( |
app.ainvoke
/ |
异步版本,配合 async 节点 |
START
/ |
特殊入口/出口节点 |
interrupt(value)
/ |
人工介入暂停 与 外部恢复 |
MemorySaver
(主包)/ |
检查点器:内存 / 本地库 / 数据库(后两者需额外装包) |
MessagesState
/ |
内置消息状态 与 「追加」reducer |
RetryPolicy(max_attempts=, retry_on=) |
节点级重试(NamedTuple; |
langgraph.prebuilt.ToolNode
/ |
预建工具节点 与 「是否继续」路由 |

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 2
 0
- 0


 已为社区贡献4条内容

所有评论(0)