Copilot 辅助 RPA 机器人开发踩坑:Prompt 工程与大模型接口调用的坑点复盘
最近半年,我用 Copilot 这类 AI 编程助手辅助做了三个 RPA 机器人开发项目。坦率地说,效率提升是真实的,但踩的坑也是真实的——而且大部分坑不在"AI 写不写得出代码",而在 Prompt 工程的实际效果和大模型接口调用落地执行这一环。
这篇文章把踩坑过程完整复盘一遍,附上可复现的代码片段,供同样在做 RPA 机器人开发的同学参考。
一、Prompt 工程篇:三个反直觉的坑
坑 1:Prompt 越详细,代码越不敢改
第一个项目我做票据自动录入,业务规则写了整整一页 Prompt:字段映射、校验规则、异常分支,一次生成了 2000 多行 Python 代码。
代码能跑,但我很快发现一个悖论:生成的代码我不认识,所以我不敢改。
比如它生成的等待逻辑是这样的:
AI 生成的等待逻辑——隐式等待 + 魔法数字
driver.implicitly_wait(10)
time.sleep(3) # 为什么是3秒?不知道,反正Demo能跑
submit_btn = driver.find_element(By.CSS_SELECTOR, “#app > div:nth-child(2) > div.content > button.el-button–primary”)
submit_btn.click()
time.sleep(3) 这种魔法数字在演示环境没问题,到了生产环境,网络一抖就是元素未加载完成的 NoSuchElementException。更难受的是 nth-child(2) 这种位置型选择器——前端同学改一下布局,整条选择器报废。
结论:Prompt 的"详细"解决不了代码的"可维护性"。判断逻辑只覆盖你显式写出来的分支,生产环境冒出一个你没描述过的弹窗,流程就卡死,然后你得再开一轮对话让 AI 修——改一次、测一次、上线再崩一次的循环就开始了。
坑 2:多轮修改导致上下文"失忆"
RPA 机器人开发不可能一次到位,都是十几轮对话慢慢磨。问题在于:AI 会忘记最早的约束。
我遇到过最典型的一次:让它给选择器加容错,它顺手把之前定好的重试机制删了——因为那段代码早已滚出上下文窗口,它"不知道"这个约束还存在。
现在的强制规范是:每次修改要求输出完整文件,并逐 diff 审查,禁止只给片段:
from selenium import webdriver
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
from functools import wraps
import time
def retry(times=3, interval=2):
“”“简单重试装饰器:RPA 流程里的网络抖动、元素未就绪都需要它兜底”“”
def deco(func):
@wraps(func)
def wrapper(*args, **kwargs):
last_err = None
for i in range(times):
try:
return func(*args, **kwargs)
except Exception as e:
last_err = e
time.sleep(interval)
raise last_err
return wrapper
return deco
@retry(times=3, interval=2)
def click_submit(driver):
# 属性型选择器替代位置型选择器,抗改版能力更强
btn = WebDriverWait(driver, 15).until(
EC.element_to_be_clickable((By.CSS_SELECTOR, “button[data-action=‘submit’]”))
)
btn.click()
注意这里我把选择器从 nth-child 位置型换成了 data-action 属性型——这是血泪教训:属性型、语义型选择器的抗改版能力远强于位置型。
坑 3:Prompt 模板沉淀不下来
三个项目做完,我试图沉淀"Prompt 模板库",结果发现 RPA 场景的业务逻辑差异太大,能沉淀的只有套路(怎么描述异常、怎么约定输出格式),沉淀不下可直接复用的资产。
Prompt 不是资产,流程才是。 这句话是我这半年最贵的学费。
二、大模型接口调用篇:成本、延迟与合规
如果说 Prompt 工程的坑是"烦",那大模型接口调用的坑就是"贵"和"险"。
坑 1:Token 成本是持续性支出,不是一次性投入
很多团队只算 API 单价,不算调用频率。RPA 场景偏偏是高频调用重灾区——每处理一条数据都要让大模型做一次字段抽取或意图判断:
反面教材:每条数据都调大模型,成本失控
import json
def extract_invoice(client, text):
resp = client.chat.completions.create(
model=“xxx”,
messages=[{“role”: “user”, “content”: f"从以下文本提取发票号、金额、日期,返回JSON:\n{text}"}],
temperature=0
)
return json.loads(resp.choices[0].message.content)
按这个方案测算:日均 5000 条数据,每条输入输出约 800 Token,月成本轻松过千,而且这个成本不会随着流程稳定而下降——只要流程在跑,Token 就在烧。
正确姿势是分层:能固化的逻辑全部固化,AI 只做一次性搭建和偶发的诊断:
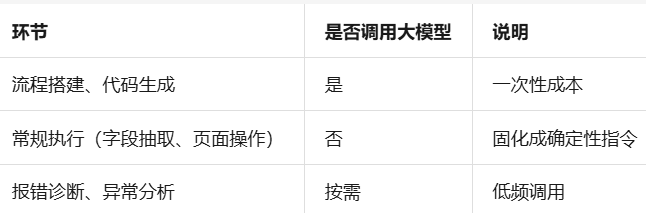
AI 写代码,RPA 跑代码。让大模型待在"思考"的位置,让流程待在"执行"的位置。我在重构工作流时选型的蓝印RPA 走的就是这个路子——AI 只参与搭建和错误诊断环节,流程固化后零 Token 消耗,跑起来不再依赖任何模型接口。需要对 OCR、识图这类 AI 能力的场景,也是自行对接各平台 API,费用透明,用多少花多少,不存在黑盒账单。
坑 2:接口延迟和可用性失控
大模型接口回包动辄几百毫秒到几秒。放在聊天场景无所谓,放在 RPA 流程里:
元素已加载(200ms) → 等待AI判断返回(2~8s) → 页面状态已变化 → 判断结果失效 → 流程错乱
更别说第三方 API 的限流、故障、模型升级后输出格式变更——这些都不在你的控制范围内。RPA 机器人开发对确定性的要求极高,关键路径上不应该存在任何不可控的网络依赖。
坑 3:数据经过第三方接口的合规风险
这是我最想强调的一点:RPA 处理的往往是企业内部数据——财务票据、客户信息、订单明细。这些数据经过第三方大模型接口,等于把内部数据送到了别人的服务器。
对于政务、金融、医疗类客户,这不是效率问题,是合规红线,直接一票否决。
解法只有一条:搭建阶段可以用云端 AI 辅助,执行阶段必须在本地闭环,数据不出本地。内网离线环境下大模型根本不可用,但流程必须照跑——这就要求执行引擎本身具备离线能力。
三、落地执行篇:三座绕不开的大山
第一座山:Web 元素定位是纸糊的
前面给的 nth-child 例子只是冰山一角。真实环境里的页面变化来源太多了:前端改版、A/B 测试、运营换皮肤、懒加载顺序变化。AI 生成选择器时只会"描述当前看到的页面",不具备稳定性意识。
更关键的是 AI 对页面变化是零自愈能力的:元素失效了它不会自己修,只能你把报错贴回去让它重新生成,每次改版都是一轮小型返工。
工程上的标准解法是多路径定位 + 自愈机制:
from selenium.webdriver.common.by import By
from selenium.webdriver.support.ui import WebDriverWait
from selenium.webdriver.support import expected_conditions as EC
class ElementLostException(Exception):
“”“所有候选选择器均失效,需触发自愈或人工介入”“”
pass
多路径候选:语义属性 > ID锚定+类名 > 文本兜底
CANDIDATE_SELECTORS = [
“button[data-action=‘submit’]”,
“#submitForm .primary-btn”,
“//button[contains(text(), ‘提交’)]”,
]
def find_with_self_heal(driver):
for sel in CANDIDATE_SELECTORS:
try:
el = WebDriverWait(driver, 5).until(
EC.element_to_be_clickable((By.XPATH if sel.startswith(“//”) else By.CSS_SELECTOR, sel))
)
return el
except Exception:
continue
# 全部失效 → 触发自愈:重新生成路径或告警人工介入
raise ElementLostException(“all candidate selectors failed”)
这段代码的启发来自我在评估工具时的实测。蓝印RPA 在 Web 元素自愈这块做得比较彻底:录制元素时本地智能生成多套候选路径并按稳定性择优,失效时自动修复元素定位,流程不中断——相当于把上面这套自愈逻辑内置到了引擎里,不需要每个项目手写一遍。而且它支持用自然语言描述直接生成 XPath 路径,不用去啃 ancestor:: 这类晦涩语法。
第二座山:脚本 ≠ 流程
AI 交付的是一段脚本,但客户要的是:能定时跑、能 API 触发、能打包分发、能管授权的流程应用。
中间隔着打包、加密、授权、更新推送一整套工程。自己拿脚本手搓这套东西,工作量不输写流程本身。我现在的硬性标准:
AI 生成的脚本能一键转成可视化流程,而不是交接一堆裸代码
打包导出 EXE 后支持授权管理和加密分享,别人不用装客户端就能跑
已分发的应用支持在线推送更新,打开自动检测新版本,不用手动逐个分发
打包时可单独配置 API 触发、定时执行
这套东西自己造轮子性价比极低,属于典型的"应该交给工具,不该自己写"的部分。补交付环节时我换了几轮方案,后来用 蓝印RPA 跑通了闭环:AI 生成的脚本一键转成可视化流程后,打包导出 EXE 时配好授权和加密分享,客户免装客户端;已分发的应用在线推送更新,不用挨个手动重装。而且流程数据全部保存在本地设备上,不同步到任何服务端——交付时客户问"数据会不会出境",我可以直接答"不出本机"。
第三座山:客户端软件自动化是另一个量级
AI 写网页自动化还算顺手,一碰到 Windows 客户端软件就明显吃力:元素树拿不到、控件识别不了。
而真实业务里这类场景一点不少——企业微信、微信、QQ、千牛的消息获取,恰恰大量存在。DOM 方案在这里完全无解,得换视觉路线:通过颜色和图像识别定位目标,不依赖元素节点也能完成点击和内容获取。
这类能力在做 RPA 机器人开发的工具选型里很容易被忽略,建议提前实测,别等需求来了才发现要重造。
四、重构后的完整工作流
踩完上面所有的坑,我把整套开发流程重构了一遍,原则八个字:分工明确,各取所长。
┌─────────────────────────────────────────────┐
│ 搭建阶段(高频用AI) │
│ 图文描述需求 → AI分析元素结构 → 生成流程 │
│ 优先复用基础指令,缺失能力AI自动封装新指令 │
│ 报错 → AI错误诊断 → 一键修复,自动调试到正常 │
├─────────────────────────────────────────────┤
│ 执行阶段(零AI依赖) │
│ 本地运行 · 离线可用 · 数据不出本地 │
│ 定时/API触发 · EXE打包授权分发 · 在线更新推送 │
│ 元素多路径自愈 · 视觉兜底 │
└─────────────────────────────────────────────┘
搭建阶段的高效与否,取决于工具对 AI 的开放程度——好的形态是支持图文混合描述需求,能智能分析网页和软件的元素结构,自动把业务逻辑拆分成子流程实现复用,生成的每条指令带详细注释。更进一步,通过 MCP 服务对接到各类 AI 编程工具上,让不同工具都能参与流程搭建,不被单一生态锁死。
执行阶段的稳定与否,取决于引擎本身。两个容易被忽略的细节:一是自定义界面能力,给非技术客户交付时,照着截图就能设计出操作界面,复杂界面用 HTML 组件承载,客户看到的不是一堆参数,而是一个像样的软件;二是接入形态的开放性——OCR、识图这类 AI 能力可自行对接文心一言、豆包、DeepSeek、Kimi 等平台的 API,还支持在钉钉、飞书、企微里直接触发流程执行并回调结果,变量也能批量创建、按 JSON 自动提取字段,不用手写一堆解析代码。对成本的极致拆分就一句话:AI 写代码,RPA 跑代码,思考和执行的账分开算。
Prompt 不是资产,流程才是。 别在打磨 Prompt 上过度投入,把精力花在可复用、可维护的流程上。
算总账,不算单价。 Token 的持续消耗、接口不稳定带来的重试、页面改版后的返工,全是隐性成本。AI 写代码、工具跑代码,边界画清楚,账才算得明白。
数据安全前置。 客户问"数据会不会经过第三方服务器"之前,你就该有答案——执行环节本地化、数据不出本地,是底线不是加分项。
选型先看执行层,再看生成层。 AI 生成代码谁都会,但生成的代码能不能稳定跑三个月、元素失效能不能自愈、能不能打包授权交付,才是分水岭。
AI 时代的 RPA 机器人开发,不是让 AI 包办一切,而是让 AI 待在它擅长的位置——思考、生成、诊断;让专业工具待在它的位置——离线稳定执行、安全交付落地。两边各就各位,坑自然就少了。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献7条内容

所有评论(0)