把 3 小时故障复盘压到一杯咖啡的时间:用蓝耘元生代做一个可追踪的日志调查 Agent
文章目录
这不是一个“把日志粘给模型,让它猜原因”的聊天机器人。项目把日志检索、证据提取、根因分析、人工确认和复盘报告串成一条可恢复的调查流程,模型统一从蓝耘元生代 MaaS 接入。
线上接口报错时,我最怕看到的一句话是:“应该是数据库抖了一下。”
它听起来像结论,其实没有证据。是哪个实例先报错?错误从几点开始?发布、配置变更和依赖超时谁在前?有没有同类请求成功?这些问题没回答,所谓根因只是经验判断。
我给一个内部工具做过类似的排障流程。原来的做法很朴素:从日志平台导出片段,人工搜索 trace_id,再翻发布记录和服务依赖。一次跨服务故障,信息通常散在三四个页面里。为了避免模型读到一条 ERROR 就下结论,我把任务改造成一个“证据优先”的日志调查 Agent。
这篇文章给出一个可运行的最小版本。示例使用脱敏日志文件,不连接真实生产系统;替换工具层后,可以接 Elasticsearch、Loki、ClickHouse 或企业自己的日志 API。模型入口使用蓝耘元生代 MaaS,编排层用 LangGraph,观测数据按 OpenTelemetry GenAI 的思路记录。
一、项目要解决的不是日志总结,而是调查闭环
输入是一段告警信息,例如:
2026-09-12 10:14:27 order-api 的 5xx 比例升高,主要接口 POST /api/orders
期望输出不能只有一段泛泛的解释,而要包含:
- 故障时间线;
- 有出处的关键证据;
- 根因与置信度;
- 仍未确认的疑点;
- 建议动作,其中高风险动作必须等人确认;
- 一份可以直接放进事故复盘文档的 Markdown 报告。
这个任务适合 Agent,但不适合完全放任模型自由执行。日志检索是确定性操作,根因推断带有概率性,重启、回滚、修改配置又属于高风险动作。把三类事情混在一个循环里,模型很容易越权,或者在工具失败时反复调用。
所以项目采用固定图流程:程序控制阶段,模型负责分类、提炼和推理。
LangGraph 的 checkpoint 能在每一步保存状态,interrupt() 可以让流程暂停,等审核人批准后再从原位置继续。官方文档也特别提醒,暂停前的副作用必须可幂等执行。因此,本项目把所有写操作放到审核节点之后,前面的工具全部只读。
二、蓝耘在这个项目里承担什么角色
蓝耘负责模型服务入口,本地应用负责业务流程、工具权限、状态保存和结果审计。这条边界要先讲清楚。
根据蓝耘 MaaS 文档,平台提供 OpenAI 兼容接口,固定 Base URL 为:
https://maas-api.lanyun.net/v1
聊天接口为:
https://maas-api.lanyun.net/v1/chat/completions
这意味着项目可以继续使用 OpenAI Python SDK,主要修改 base_url、api_key 和 model。蓝耘公开页面还列出了 DeepSeek、Qwen、Kimi、MiniMax、GLM 等多类模型,并强调统一网关、模型切换和智能路由能力。模型列表更新较快,调用名称应从自己的控制台复制,不要照抄旧文章。
在这个项目里,我把模型调用分成两个角色:
| 角色 | 工作 | 选择原则 |
|---|---|---|
| 快速分析模型 | 提取服务名、时间窗、错误码、检索关键词 | 低延迟、指令遵循稳定、结构化输出稳定 |
| 深度推理模型 | 根据证据生成时间线、根因候选和反证 | 推理能力强、长上下文表现好 |
开发阶段也可以只配置一个模型。等流程跑稳后,再拆成快慢两档。统一接口的好处在这里很明显:切换模型时,业务状态结构和工具代码不用跟着改。
蓝耘 MaaS 接入
下面两张图来自蓝耘公开接入文档,用于说明 API Key 和模型标识所在位置。正式投稿时,建议换成自己账号的实测截图,并把 Key、余额、账号信息打码。
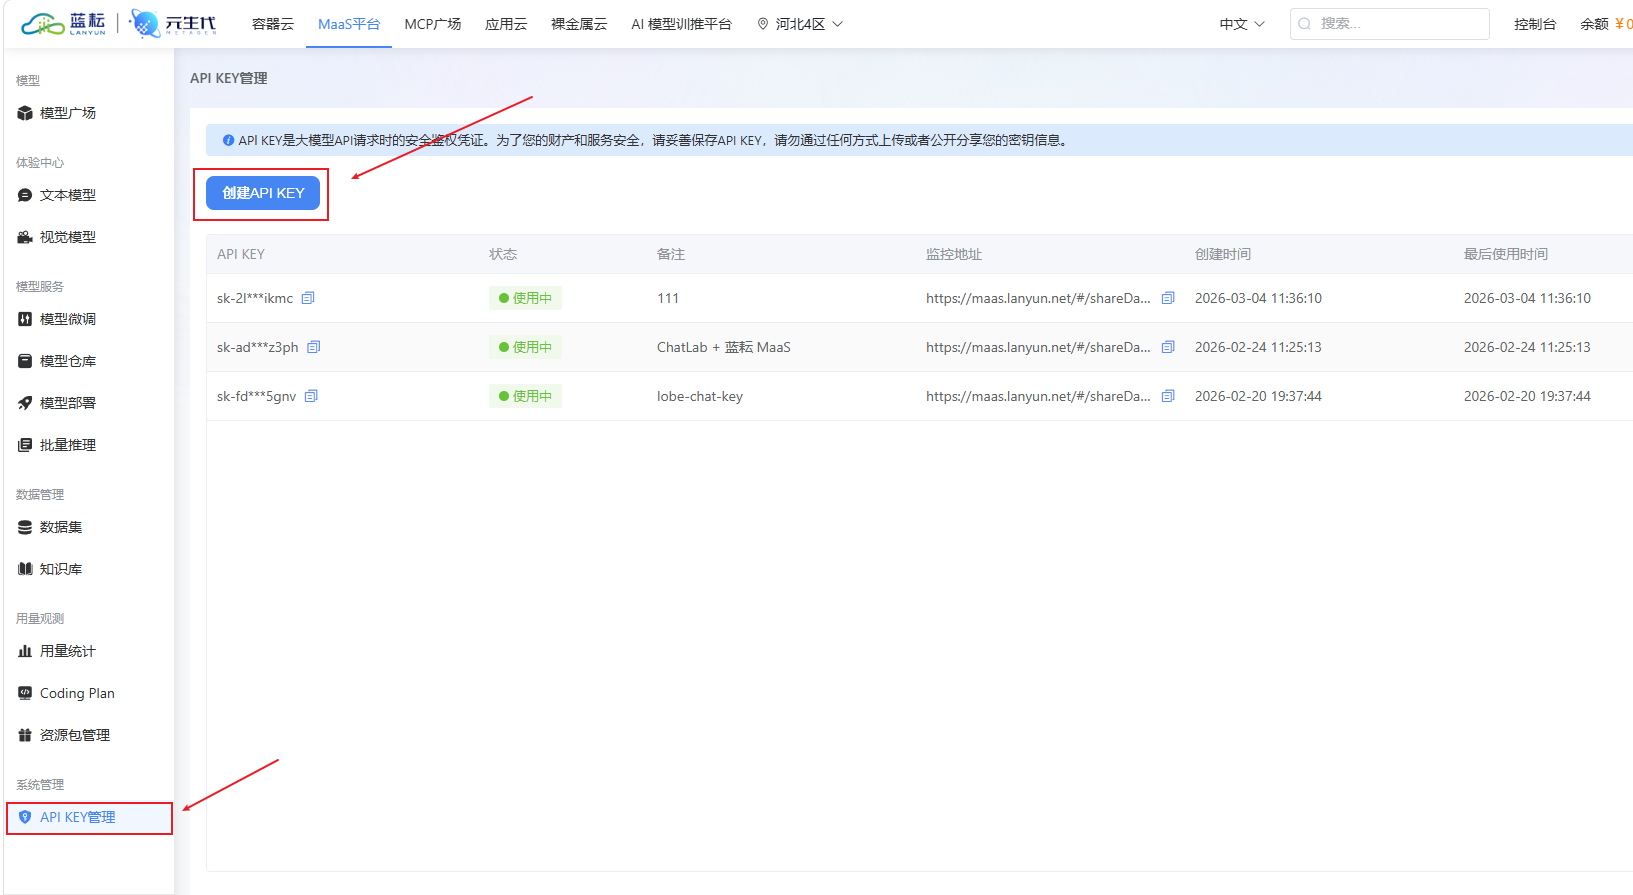
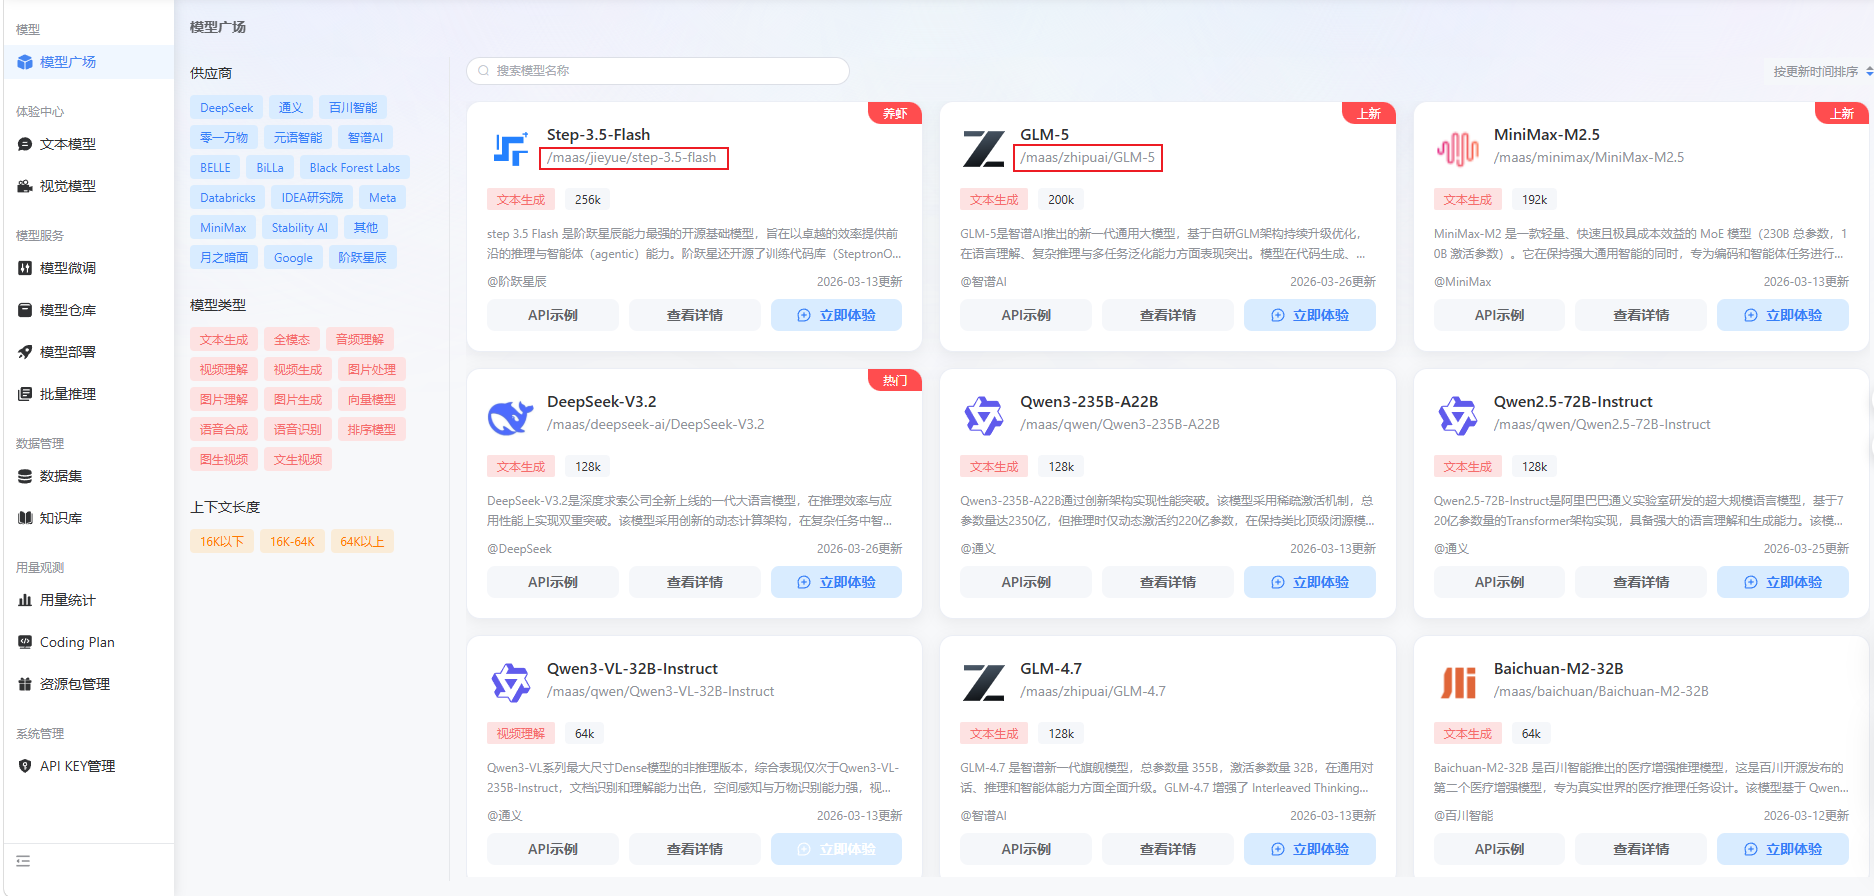
截图时至少保留三张:模型详情页、已打码的 API Key 管理页、项目实际运行结果。这样读者能确认模型名称、接入过程和最终输出是同一条链路。
三、目录和依赖
最小项目只有几个文件:
log-incident-agent/
├─ app.py
├─ incident_graph.py
├─ lanyun_client.py
├─ tools.py
├─ telemetry.py
├─ fixtures/
│  └─ order-api.log
├─ output/
└─ requirements.txt
requirements.txt:
openai>=1.75.0
langgraph>=0.4.0
pydantic>=2.10.0
python-dotenv>=1.0.1
opentelemetry-api>=1.32.0
opentelemetry-sdk>=1.32.0
版本号只是一个可用起点。安装时如果依赖已经有较新稳定版,应先在测试环境升级验证。
Windows PowerShell 下设置环境变量:
$env:LANYUN_API_KEY="sk-你的密钥"
$env:LANYUN_FAST_MODEL="从蓝耘模型页复制的完整调用名"
$env:LANYUN_REASONING_MODEL="从蓝耘模型页复制的完整调用名"
Linux 或 macOS:
export LANYUN_API_KEY="sk-你的密钥"
export LANYUN_FAST_MODEL="从蓝耘模型页复制的完整调用名"
export LANYUN_REASONING_MODEL="从蓝耘模型页复制的完整调用名"
API Key 不要写进代码、截图、日志和 Git 仓库。示例也不提供默认密钥,环境变量为空时直接启动失败。
四、先把蓝耘模型调用封装成一个窄接口
lanyun_client.py 只暴露两个方法。业务层不需要知道供应商细节。
import json
import os
from typing import TypeVar

from openai import OpenAI
from pydantic import BaseModel

T = TypeVar("T", bound=BaseModel)

client = OpenAI(
    api_key=os.environ["LANYUN_API_KEY"],
    base_url="https://maas-api.lanyun.net/v1",
)

FAST_MODEL = os.environ["LANYUN_FAST_MODEL"]
REASONING_MODEL = os.environ["LANYUN_REASONING_MODEL"]


def ask_text(system_prompt: str, user_prompt: str, *, reasoning: bool = False) -> str:
    response = client.chat.completions.create(
        model=REASONING_MODEL if reasoning else FAST_MODEL,
        messages=[
            {"role": "system", "content": system_prompt},
            {"role": "user", "content": user_prompt},
        ],
        temperature=0.1,
    )
    return response.choices[0].message.content or ""


def ask_json(
    system_prompt: str,
    user_prompt: str,
    schema: type[T],
    *,
    reasoning: bool = False,
) -> T:
    schema_text = json.dumps(schema.model_json_schema(), ensure_ascii=False)
    prompt = (
        f"{user_prompt}\n\n"
        "只输出一个 JSON 对象,不要使用 Markdown 代码块。"
        f"输出必须满足这个 JSON Schema:{schema_text}"
    )
    raw = ask_text(system_prompt, prompt, reasoning=reasoning)
    return schema.model_validate_json(raw)
这里没有把“兼容 OpenAI”理解成“每个模型行为完全相同”。不同模型对 JSON 约束、停止词、推理字段的处理可能不同,应用层仍要做校验。Pydantic 校验失败时,应该把失败状态交给图节点决定是否重试,而不是默默吞掉错误。
五、用结构化状态阻止模型随口下结论
调查过程中最重要的是证据和结论分开保存。
from typing import Literal, TypedDict

from pydantic import BaseModel, Field


class IncidentScope(BaseModel):
    service: str
    start_time: str
    end_time: str
    keywords: list[str] = Field(default_factory=list)


class Evidence(BaseModel):
    evidence_id: str
    timestamp: str
    source: str
    trace_id: str | None = None
    content: str


class Finding(BaseModel):
    title: str
    confidence: Literal["low", "medium", "high"]
    evidence_ids: list[str]
    counter_evidence: list[str] = Field(default_factory=list)


class InvestigationState(TypedDict, total=False):
    alert: str
    scope: dict
    evidence: list[dict]
    findings: list[dict]
    proposed_actions: list[str]
    approval: dict
    report: str
    errors: list[str]
Finding 不能只写“数据库连接池耗尽”,还必须给出 evidence_ids。报告生成节点只允许引用状态里已有的证据编号。这个限制能减少模型把常识写成事实的情况。
六、工具层只返回事实,不返回“建议”
为了让示例可以本地运行,工具先读脱敏日志文件。生产环境只需把函数实现替换为日志平台查询。
from datetime import datetime
from pathlib import Path

LOG_FILE = Path("fixtures/order-api.log")


def search_logs(
    service: str,
    start_time: str,
    end_time: str,
    keywords: list[str],
    limit: int = 200,
) -> list[dict]:
    start = datetime.fromisoformat(start_time)
    end = datetime.fromisoformat(end_time)
    rows: list[dict] = []

    for line_no, line in enumerate(LOG_FILE.read_text(encoding="utf-8").splitlines(), 1):
        parts = line.split(" | ", 4)
        if len(parts) != 5:
            continue

        timestamp, level, row_service, trace_id, message = parts
        current = datetime.fromisoformat(timestamp)

        if row_service != service or not start <= current <= end:
            continue
        if keywords and not any(word.lower() in message.lower() for word in keywords):
            continue

        rows.append(
            {
                "evidence_id": f"log-{line_no}",
                "timestamp": timestamp,
                "source": str(LOG_FILE),
                "trace_id": trace_id or None,
                "content": f"{level}: {message}",
            }
        )

        if len(rows) >= limit:
            break

    return rows
这里故意不让工具总结原因。工具负责“找到了什么”,模型负责“这些事实说明什么”。如果 MCP 服务返回的工具描述或结果中包含诱导指令,也不能把它当系统指令执行。MCP 官方安全建议明确要求把工具视为潜在的任意代码执行入口,调用前要有用户控制和清晰授权;对生产系统而言,只读账号、参数白名单、网络隔离和审计日志都应放在模型之外实现。
七、LangGraph 编排:失败能续跑,高风险动作要停下来
下面是核心图代码的精简版:
import json

from langgraph.checkpoint.memory import InMemorySaver
from langgraph.graph import END, START, StateGraph
from langgraph.types import interrupt

from lanyun_client import ask_json, ask_text
from models import Finding, IncidentScope, InvestigationState
from tools import search_logs


def parse_scope(state: InvestigationState):
    scope = ask_json(
        "你负责把告警转换成日志查询范围。缺失信息要保守补全,时间窗不要超过 30 分钟。",
        state["alert"],
        IncidentScope,
    )
    return {"scope": scope.model_dump()}


def collect_evidence(state: InvestigationState):
    scope = IncidentScope.model_validate(state["scope"])
    evidence = search_logs(**scope.model_dump())
    return {"evidence": evidence}


def analyze_root_cause(state: InvestigationState):
    evidence_text = json.dumps(state["evidence"], ensure_ascii=False, indent=2)
    finding = ask_json(
        "你是事故调查员。只能依据给定证据推断。找不到证据时降低置信度,不得补写不存在的发布或监控信息。",
        f"告警:{state['alert']}\n证据:{evidence_text}",
        Finding,
        reasoning=True,
    )
    return {
        "findings": [finding.model_dump()],
        "proposed_actions": [
            "检查支付服务连接池当前占用",
            "核对 10:10 前后的配置变更记录",
        ],
    }


def needs_review(state: InvestigationState):
    risky_words = ("重启", "回滚", "删除", "扩容", "修改")
    return "review" if any(
        word in action
        for action in state.get("proposed_actions", [])
        for word in risky_words
    ) else "report"


def human_review(state: InvestigationState):
    decision = interrupt(
        {
            "message": "以下动作需要人工确认",
            "actions": state.get("proposed_actions", []),
        }
    )
    return {"approval": decision}


def write_report(state: InvestigationState):
    material = json.dumps(state, ensure_ascii=False, indent=2)
    report = ask_text(
        "根据调查状态生成 Markdown 事故报告。证据必须带 evidence_id,未确认内容放入待核实项。",
        material,
        reasoning=True,
    )
    return {"report": report}


def build_graph():
    graph = StateGraph(InvestigationState)
    graph.add_node("parse_scope", parse_scope)
    graph.add_node("collect_evidence", collect_evidence)
    graph.add_node("analyze_root_cause", analyze_root_cause)
    graph.add_node("human_review", human_review)
    graph.add_node("write_report", write_report)

    graph.add_edge(START, "parse_scope")
    graph.add_edge("parse_scope", "collect_evidence")
    graph.add_edge("collect_evidence", "analyze_root_cause")
    graph.add_conditional_edges(
        "analyze_root_cause",
        needs_review,
        {"review": "human_review", "report": "write_report"},
    )
    graph.add_edge("human_review", "write_report")
    graph.add_edge("write_report", END)

    return graph.compile(checkpointer=InMemorySaver())
演示版用 InMemorySaver,进程退出后状态会消失。生产环境应换成 PostgreSQL、MongoDB 等持久化 checkpointer,并把 thread_id 绑定到事故编号。
八、给 Agent 加上可观测性,不然出了错还是靠猜
普通应用日志只能告诉我们“请求失败了”。Agent 还要回答:哪个模型被调用、用了多少 Token、工具参数是什么、哪一步重试、最终结论引用了哪些证据。
OpenTelemetry 已经定义了 GenAI 相关属性,并在持续补充 invoke_agent、plan、execute_tool、invoke_workflow 等 Agent span 约定。规范仍在发展,项目里最好锁定语义约定版本,避免升级后字段含义悄悄变化。
下面的包装器记录模型角色和业务步骤,不记录 API Key:
from contextlib import contextmanager

from opentelemetry import trace

tracer = trace.get_tracer("log-incident-agent")


@contextmanager
def agent_span(name: str, *, model: str | None = None):
    with tracer.start_as_current_span(name) as span:
        span.set_attribute("gen_ai.operation.name", name)
        span.set_attribute("gen_ai.agent.name", "log-incident-agent")
        if model:
            span.set_attribute("gen_ai.request.model", model)
        try:
            yield span
        except Exception as exc:
            span.record_exception(exc)
            span.set_attribute("error.type", type(exc).__name__)
            raise
接着在节点中包一层:
def collect_evidence(state: InvestigationState):
    with agent_span("execute_tool") as span:
        scope = IncidentScope.model_validate(state["scope"])
        span.set_attribute("tool.name", "search_logs")
        span.set_attribute("tool.service", scope.service)
        evidence = search_logs(**scope.model_dump())
        span.set_attribute("tool.result_count", len(evidence))
        return {"evidence": evidence}
线上不要默认保存完整 Prompt 和日志正文。它们可能含手机号、订单号、Token、Cookie 或内部地址。更稳妥的做法是先脱敏,再按比例采样,同时保存内容哈希、证据编号、耗时、Token 用量和错误类型。
九、一次脱敏故障样本的运行过程
测试日志中埋入了这样一条因果链:
10:12:03 payment-client 连接池等待时间升高
10:12:08 order-api 调用 payment-service 超时
10:12:08 同一 trace 出现 POST /api/orders 504
10:13:11 多个实例重复出现 pool exhausted
启动:
python app.py "2026-09-12 10:14:27 order-api 的 5xx 比例升高,主要接口 POST /api/orders"
程序先输出查询范围:
{
  "service": "order-api",
  "start_time": "2026-09-12T10:04:27",
  "end_time": "2026-09-12T10:14:27",
  "keywords": ["504", "timeout", "pool", "POST /api/orders"]
}
证据聚合后,报告应呈现类似结果。模型措辞会变化,证据编号和引用约束不应变化:
## 初步结论

order-api 的 5xx 上升与 payment-service 调用超时相关,置信度为 medium。
当前证据支持“下游连接池耗尽导致请求排队并超时”,但尚缺少连接池监控曲线和配置变更记录,不能直接认定为最终根因。

## 证据

- [log-18] 10:12:03,payment-client 连接池等待时间升高。
- [log-21] 10:12:08,trace_id=7fd1... 调用 payment-service 超时。
- [log-22] 同一 trace 返回 POST /api/orders 504。
- [log-37] 10:13:11,另一实例出现 pool exhausted。

## 待核实

- 10:10 前后是否调整过连接池上限或超时时间。
- payment-service 数据库连接数是否同时达到上限。
这段输出最重要的地方不是“猜中了连接池”,而是模型主动保留了待核实项。缺少监控曲线时,把置信度写成 high 反而不合格。
建议保留的项目运行截图
正式发布文章时,可按下面顺序截图:
- 蓝耘模型广场中的模型名称和上下文信息;
- API Key 管理页,完整密钥必须遮挡;
- 终端中的告警输入、证据数量和
thread_id; - 人工审核暂停界面;
- 最终 Markdown 复盘报告;
- Trace 页面中的
parse_scope → execute_tool → analyze_root_cause → write_report调用链。
如果没有真实 Trace 后端,可以先把 span 导出到控制台,但不要拿手写 JSON 冒充观测平台截图。
十、我实际遇到的坑:兼容接口跑通了,结构化输出却不稳定
第一次接入时,普通对话很顺利,ask_json() 偶尔会失败。返回内容看着像 JSON,前后却带着解释文字或 Markdown 围栏:
下面是分析结果:
```json
{"service":"order-api", ...}
```
直接交给 model_validate_json() 就会报错。
最初我想用正则截取第一个花括号。这个补丁对嵌套对象、字符串里的花括号并不可靠,还会把模型输出错误藏起来。最后采用了三层处理:
- Prompt 明确要求只输出 JSON,并附上 schema;
temperature降到0.1,减少格式漂移;- 校验失败时只允许重试一次,第二次仍失败就保存原始响应摘要并结束该节点。
核心重试代码如下:
from pydantic import ValidationError


def ask_json_once_retry(system_prompt, user_prompt, schema, *, reasoning=False):
    last_error = None

    for attempt in range(2):
        try:
            return ask_json(
                system_prompt,
                user_prompt,
                schema,
                reasoning=reasoning,
            )
        except ValidationError as exc:
            last_error = exc
            user_prompt += "\n上一次输出未通过 JSON Schema 校验,请修正格式。"

    raise RuntimeError("模型连续两次未返回有效 JSON") from last_error
还有一个容易误判的问题:统一 API 解决的是协议接入,不保证模型输出习惯完全一致。切模型后必须重跑结构化输出测试、长日志截断测试、超时测试和空结果测试。
十一、为什么选择蓝耘,而不是把项目绑死在单一模型上
这个项目更看重“可替换”而不是某个榜单第一。
蓝耘的价值主要有三点。第一,OpenAI 兼容接口降低迁移成本,现有 SDK 和大量上层框架可以继续用。第二,一个入口可以连接多类模型,快模型和推理模型不必分别维护鉴权与响应解析。第三,平台公开介绍了智能路由、跨模型降级、负载均衡、Prompt 缓存等能力,这些功能对持续运行的 Agent 比一次 Demo 的回答效果更有用。
类似服务也有很多,选型时可以按同一张表核对,不需要踩一捧一:
| 对比项 | 应该问的问题 |
|---|---|
| 接口兼容性 | 是否兼容现有 SDK,流式、工具调用和错误码是否一致 |
| 模型覆盖 | 是否有任务需要的推理、代码、长文本或多模态模型 |
| 可用性 | 限流、超时、熔断和故障切换怎么处理 |
| 成本 | 输入、输出、缓存和高峰时段如何计费 |
| 数据治理 | 日志保留、数据地域、私有化和权限审计是否满足要求 |
| 可观测性 | 能否拿到 Token、延迟、请求 ID 和错误明细 |
| 迁移难度 | 切换模型或供应商时要改多少业务代码 |
对小团队而言,统一入口省下的是集成和运维精力。对有强合规要求的团队,私有部署、数据留存策略和审计能力可能比模型数量更重要。最终仍要用自己的日志样本做评测。
十二、从 Demo 到生产,还差哪些工作
这个最小版本可以说明流程,但不能直接接管生产操作。上线前至少补齐以下内容:
- 日志工具使用只读账号,并限制服务名、时间窗和返回条数;
- 对订单号、手机号、邮箱、Cookie、Token 做入口脱敏;
- 高风险工具放入独立权限域,默认需要人工批准;
- 每次调查设置最大模型调用次数、最大 Token 和总超时;
- 保存 Prompt 版本、模型名、证据编号、审核人和最终报告哈希;
- 建立固定评测集,检查证据引用正确率、漏报率和错误根因率;
- 对空日志、工具超时、模型限流和 checkpoint 恢复做故障演练。
MCP 让工具接入更统一,但工具描述和返回值不能天然信任。LangGraph 让任务可暂停、可恢复,但副作用是否安全仍取决于应用设计。蓝耘让模型切换更方便,但模型升级后仍要重新评测。三者解决的是不同层的问题,边界分清后,系统才容易维护。
结语
日志调查 Agent 省下的不只是搜索几行文本的时间。更重要的是,它把排障步骤固定下来:先定范围,再拿证据,然后给结论,最后由人决定是否执行高风险动作。
蓝耘元生代在项目中提供统一模型入口,使快速解析和深度推理可以共享一套调用方式。LangGraph 保存调查状态,OpenTelemetry 留下调用链,工具层只负责取证。即使模型换了,调查流程和证据规则仍然保留。
如果准备复现,建议先用一份脱敏日志做 20 个故障样本,不要急着接生产写操作。先观察模型在哪些地方会漏证据、抬高置信度或选错工具。把这些失败样本写进评测集,比继续堆 Prompt 更有用。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 55
 0
- 0


 已为社区贡献36条内容

所有评论(0)