【C 语言】数组详解:从一维数组、二维数组到内存布局、VLA 与二分查找
🔥 星光编译者 · 个人主页
📚 学习专栏: 《C/C++ 成长笔记》 · 《Linux 实践手册》 · 《数据结构与算法》
🌄 向云端飞扬,编译属于自己的代码星河。
☕ 写在开篇
你好,这里是 星光编译者。
这里记录我在 C/C++、Linux、数据结构与算法 学习中遇到的真实问题、亲手验证过的代码,以及那些容易被忽略的实现细节。
比起简单罗列结论,我更愿意从问题出发,把一个知识点的来由讲清楚,把“为什么会这样”和“应该怎样解决”说明白,让每一次踩坑都沉淀成可以复用的经验。
如果这篇记录能帮你少绕一点路,或让某个模糊的地方忽然变得清晰,那么这次分享便有了意义。愿我们在一次次阅读、编译与调试中稳步向前,慢慢搭起属于自己的技术世界。
🔥 本文定位:系统讲清 C 语言数组的创建、初始化、下标访问、连续存储、元素个数计算、二维数组、变长数组,并用字符汇聚与二分查找把知识落到代码中。
💡 学习目标:能正确声明和初始化一维、二维数组;掌握下标边界和遍历模板;理解数组在内存中为何连续;会用
sizeof计算真实数组的元素个数;知道 VLA 的含义与兼容性;能独立写出安全的二分查找。📌 阅读说明:示例面向 C 语言初学者,默认使用标准 C 写法。文中会主动修正课件示例中容易被复制的拼写、格式化输出和可移植性问题。
文章目录
- 一、为什么需要数组:把同类数据组织起来
- 二、一维数组的创建:类型、名字与长度
- 三、一维数组的初始化:完整、不完整与自动推导
- 四、下标访问与遍历:合法范围永远是 0 到 n-1
- 五、数组的输入与输出:循环负责产生全部下标
- 六、连续存储:下标为什么能快速定位元素
- 七、sizeof 计算元素个数:好用,但有作用域边界
- 八、二维数组的创建与初始化
- 九、二维数组的访问与遍历:外层行、内层列
- 十、二维数组的内存布局:逻辑是表格,物理仍是一条连续空间
- 十一、C99 变长数组:运行时确定长度,不是运行时随意伸缩
- 十二、数组练习一:字符从两端向中间汇聚
- 十三、数组练习二:二分查找
- 十四、常见误区、高频面试题与练习
- 总结
一、为什么需要数组:把同类数据组织起来
假设要保存一个班级 20 名同学的数学成绩。如果只会定义普通变量,可能会写出:
int score1;
int score2;
int score3;
/* ...一直写到 score20 */
这种代码有两个明显问题:变量名很多,难以统一管理;想计算平均分时,也无法自然地用一个循环处理全部数据。
数组解决的正是这类问题。它把若干个相同类型的元素放进一个有序集合,再用统一的名字和下标访问其中某一个元素:
int scores[20];
这条语句一次创建了 20 个 int 元素。它们共享数组名 scores,但各自拥有从 0 到 19 的编号。
可以先记住数组的三条核心性质:
- 数组中的元素类型相同。
- 数组包含固定数量的元素,标准 C 中普通数组不能声明为 0 个元素。
- 数组元素在内存中连续排列,可以通过下标直接定位。
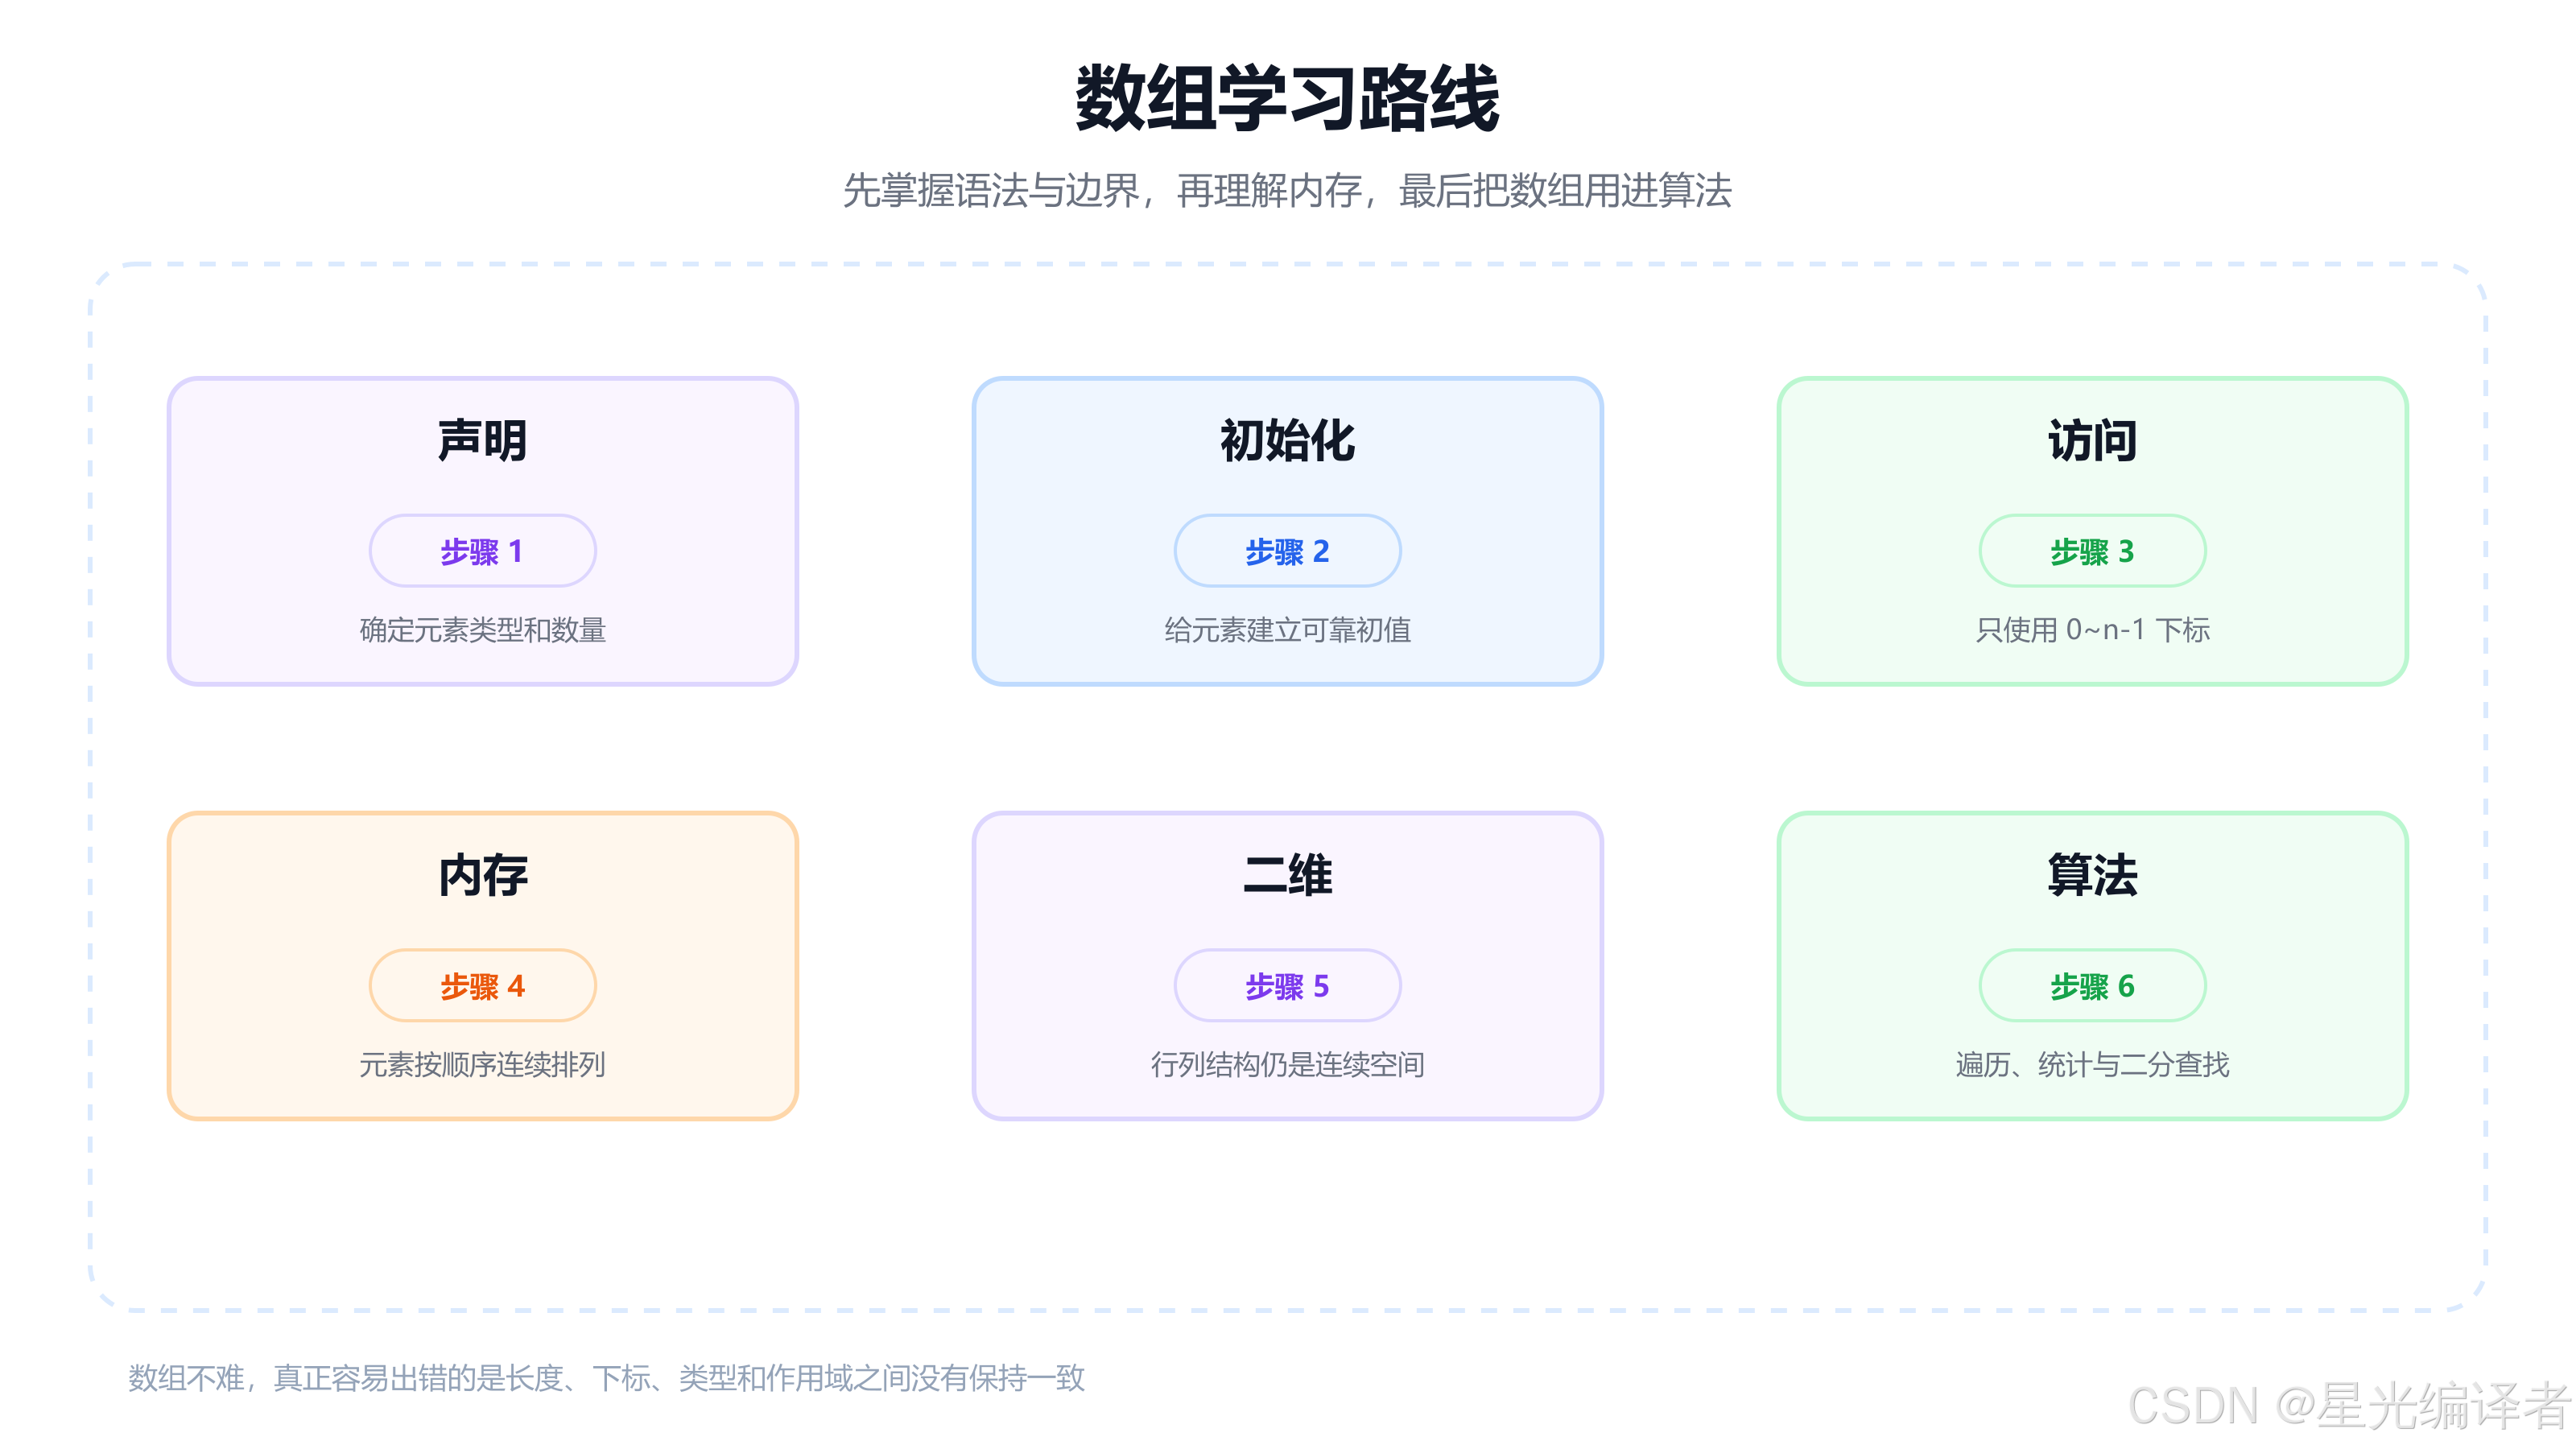
数组可以是一维的,也可以是多维的。初学阶段最常见的是一维数组和二维数组:
int line[5];       // 一维数组:5 个 int
int table[3][5];   // 二维数组:3 行,每行 5 个 int
二维数组看起来像一张表,但它并没有破坏“元素连续存储”这一基本规律。后文会从逻辑结构和真实内存两个角度拆开说明。
二、一维数组的创建:类型、名字与长度
一维数组的基本声明形式如下:
元素类型 数组名[元素个数];
例如:
int math[20];
char letters[8];
double prices[10];
把 int math[20] 拆开看:
| 部分 | 含义 |
|---|---|
int | 每个元素的类型 |
math | 数组名 |
20 | 元素个数 |
math[0] | 第一个元素 |
math[19] | 最后一个元素 |
2.1 数组也有自己的类型
数组类型不仅包含元素类型,还包含元素个数。去掉数组名后,可以看出声明中的类型信息:
int arr1[10];
int arr2[12];
char ch[5];
arr1的类型是“由 10 个int组成的数组”;常写作int[10]。arr2的类型是int[12]。ch的类型是char[5]。
因此,int[10] 与 int[12] 不是同一个数组类型。这里更准确的说法是:数组是由已有元素类型派生出来的派生类型,不应把它和 struct、typedef 意义上的“自定义类型”混为一谈。
2.2 长度必须满足什么条件
对于最普通、最容易移植的固定长度数组,方括号中使用正的整数常量表达式:
int a[10];
int b[3 + 5];
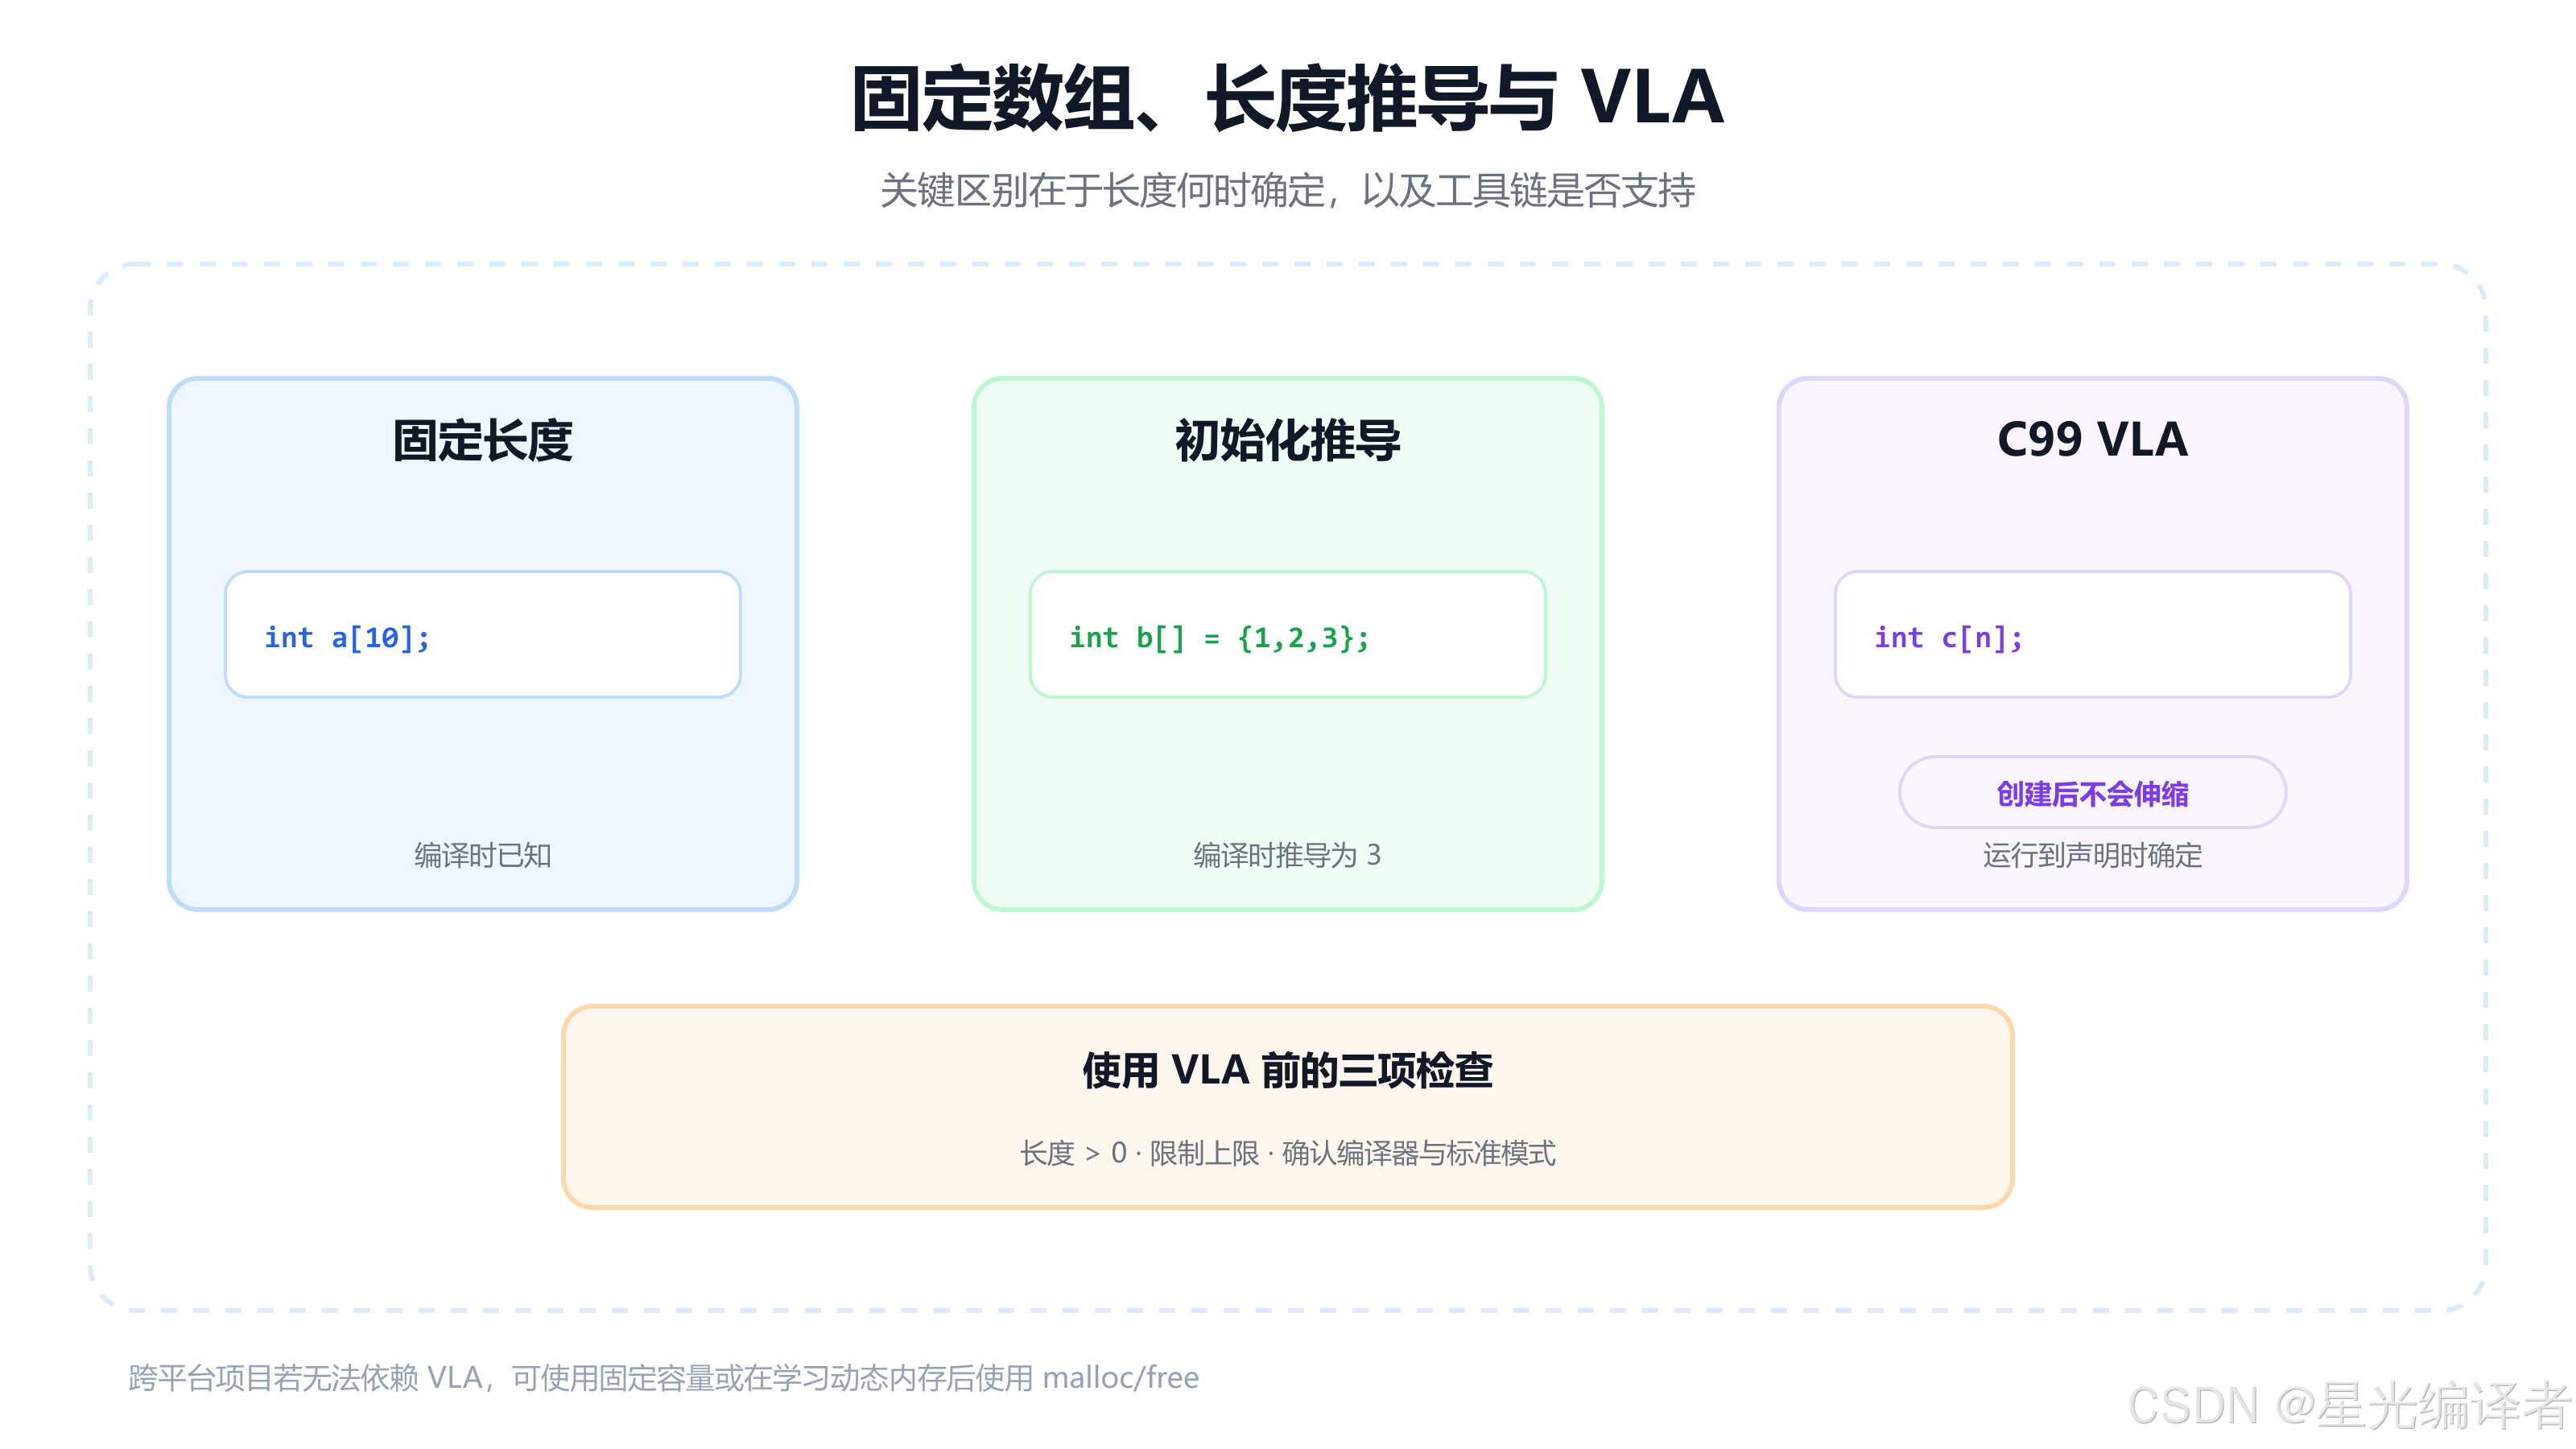
如果长度由运行时变量决定,就进入 C99 变长数组的范畴。它是否可用取决于语言标准、编译选项和编译器支持,不能看到 int arr[n] 能编译,就默认所有环境都支持。第十一节会专门讨论。
三、一维数组的初始化:完整、不完整与自动推导
数组声明后,如果没有初始化,自动存储期的局部数组元素是未确定值,不能把它们当成自动清零:
int main(void)
{
    int arr[5];       // 局部数组,元素值未确定
    return 0;
}
创建数组时可以用大括号给出初值。
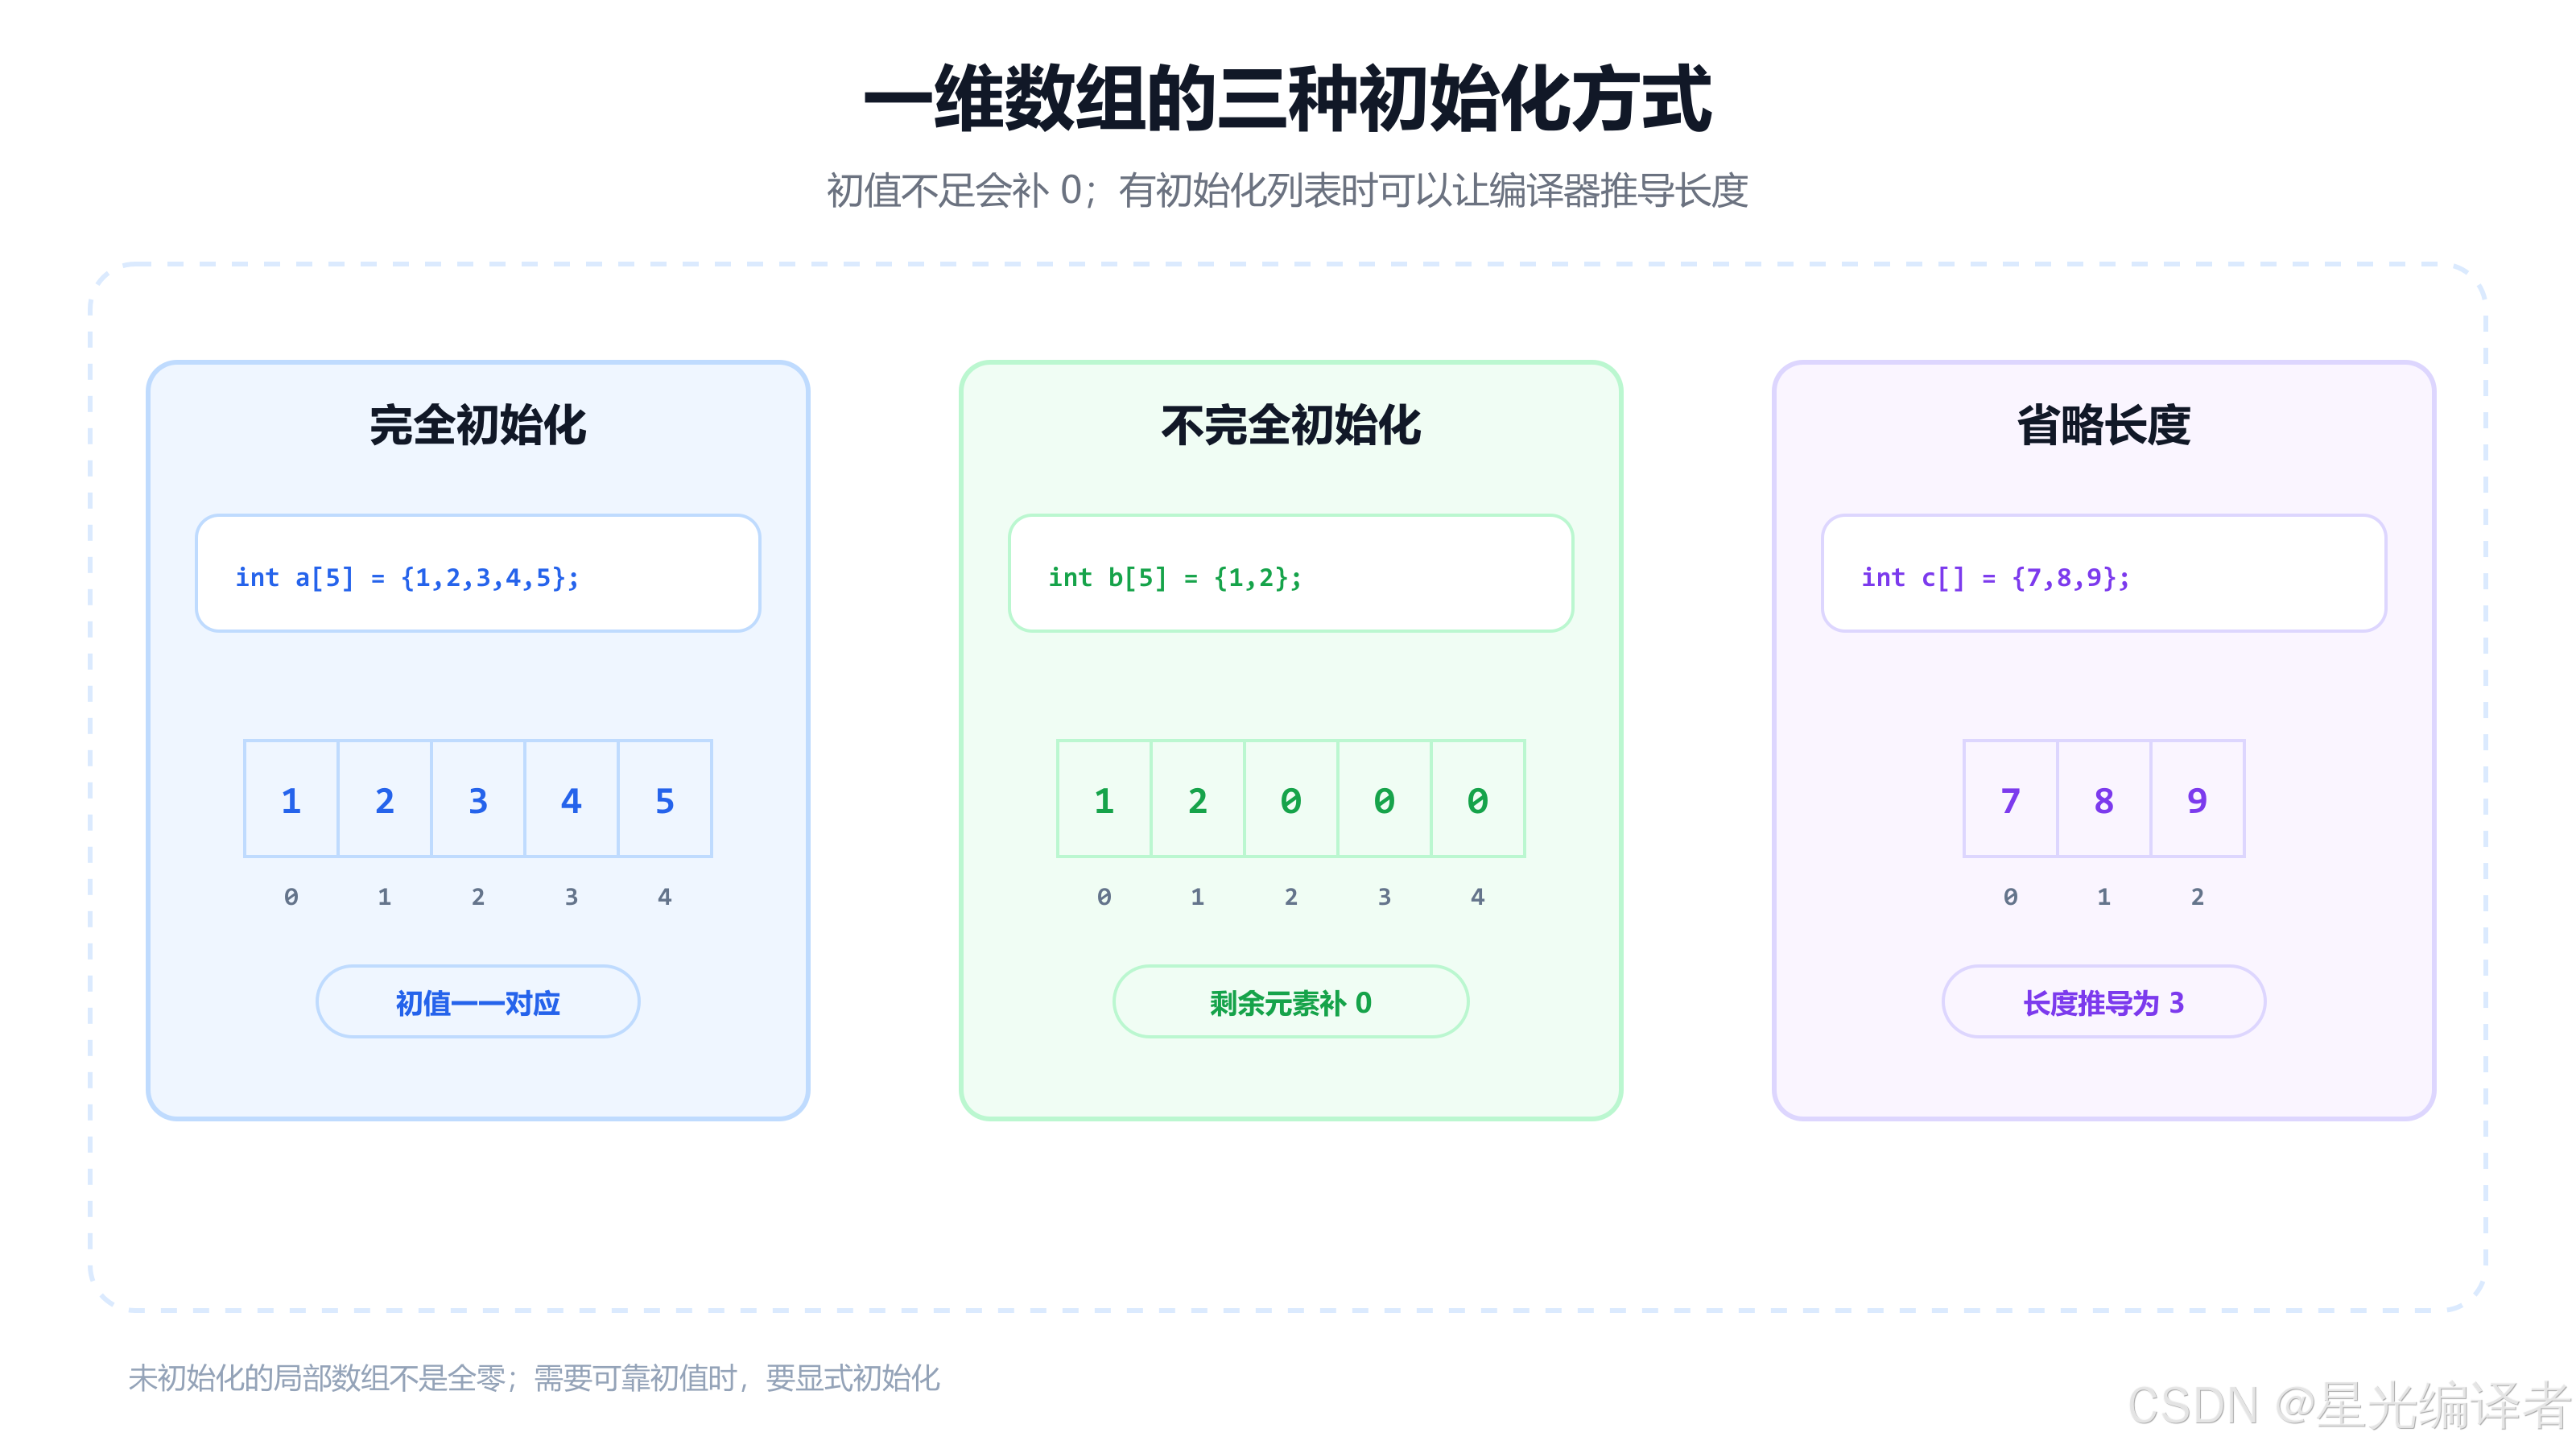
3.1 完全初始化
初始值数量与元素个数一致:
int arr[5] = {1, 2, 3, 4, 5};
对应关系是:
arr[0] = 1
arr[1] = 2
arr[2] = 3
arr[3] = 4
arr[4] = 5
3.2 不完全初始化
初始值比元素个数少时,剩余元素会被初始化为 0:
int arr[6] = {1};
实际结果是 {1, 0, 0, 0, 0, 0}。因此,下面这行是初学阶段最常用的数组清零写法之一:
int arr[100] = {0};
它不是“只把第一个元素设为 0,其他元素不管”,而是先显式初始化第一个元素,再由规则把剩余元素全部补成 0。
3.3 省略长度,让编译器推导
如果已经写出初始化列表,可以省略第一维长度:
int arr[] = {10, 20, 30, 40};
编译器根据 4 个初始值把它确定为 4 个元素的数组。注意,这不是变长数组;它的长度在编译时已经能从初始化列表推导出来。
3.4 初始化项不能超过容量
下面的声明是错误的:
int arr[3] = {1, 2, 3, 4};
数组只给三个元素留了空间,却提供四个初始值。编译器通常会直接诊断“初始化项过多”。
还有一个容易混淆的区别:
int a[5] = {0};  // 初始化,全部元素为 0
int b[5];        // 未初始化的局部数组,不能假设元素为 0
数组创建发生在一条声明中,后面不能再用大括号对整个数组进行普通赋值:
int arr[3];
// arr = {1, 2, 3};  // 错误:数组不能这样整体赋值
若要在创建后修改数组,需要逐个元素赋值,或使用适合的库函数完成复制、填充。
四、下标访问与遍历:合法范围永远是 0 到 n-1
C 语言用下标引用操作符 [] 访问数组元素:
int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

printf("%d\n", arr[7]);  // 8
printf("%d\n", arr[3]);  // 4
下标从 0 开始,所以“第几个元素”与“下标是多少”相差 1:
| 自然语言位置 | 下标 | 表达式 |
|---|---|---|
| 第 1 个元素 | 0 | arr[0] |
| 第 4 个元素 | 3 | arr[3] |
| 第 10 个元素 | 9 | arr[9] |
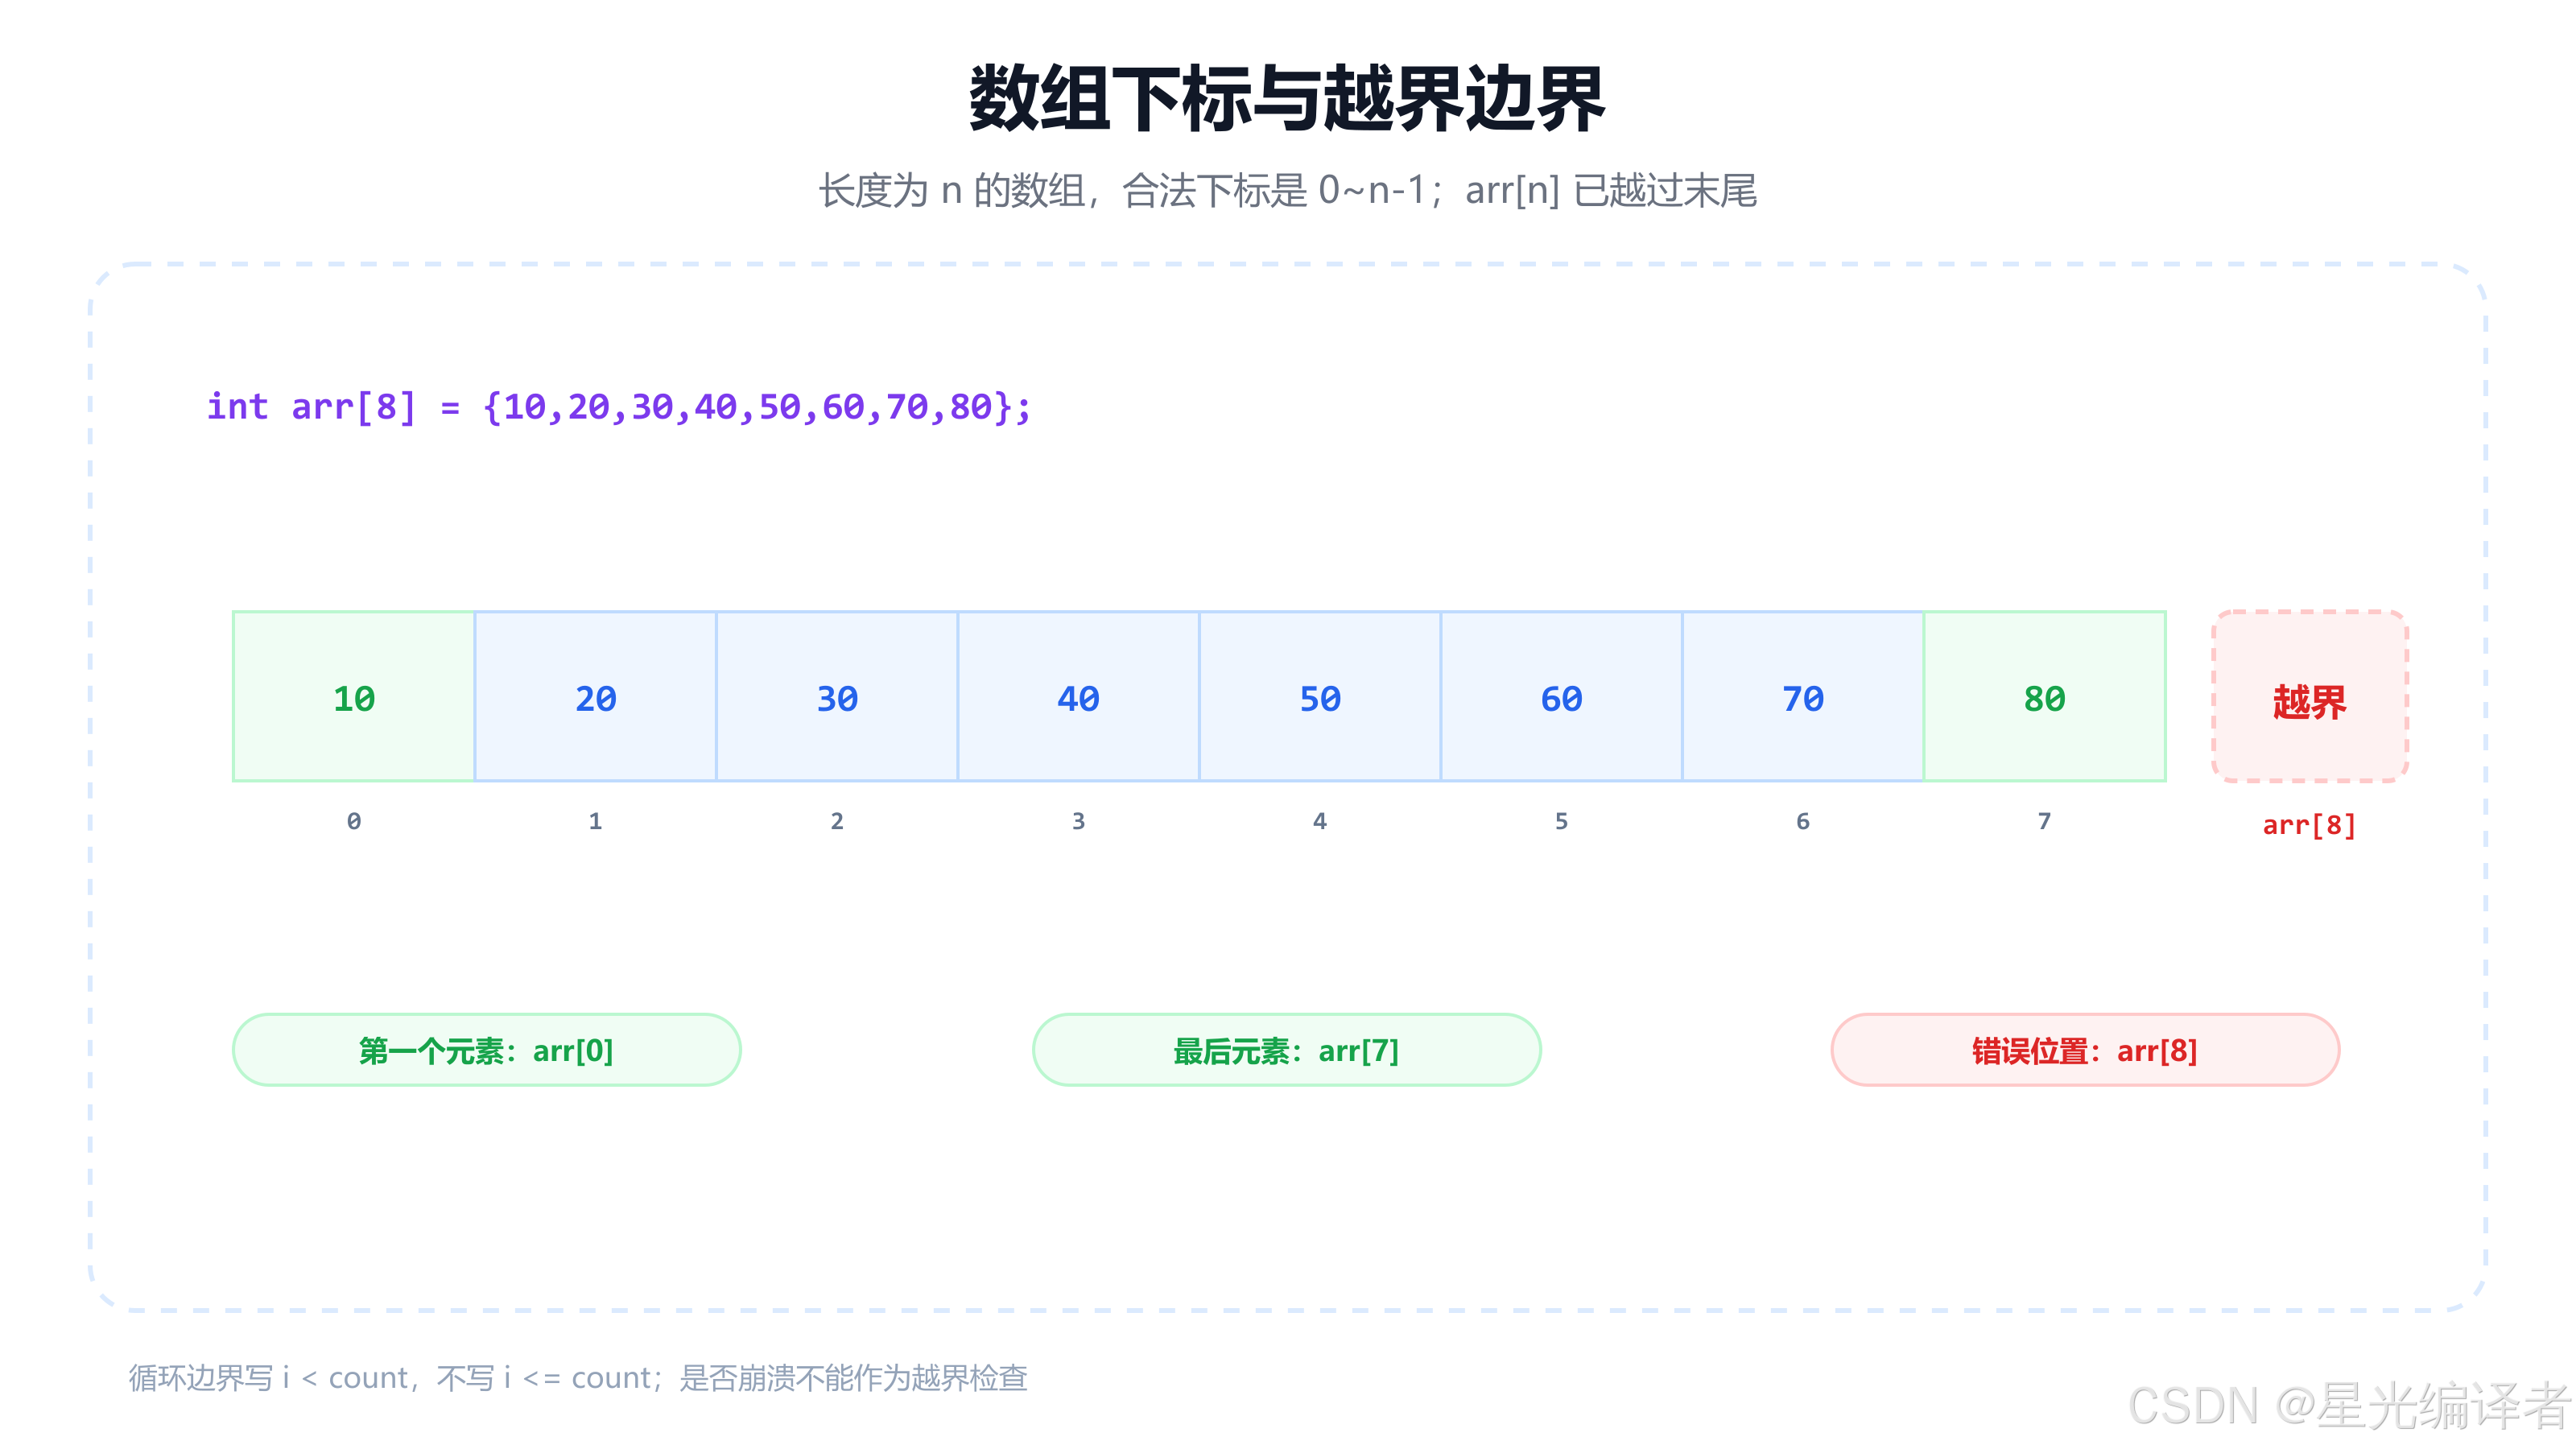
若数组有 n 个元素,合法下标范围一定是:
0 <= index && index < n
不是 index <= n。arr[n] 已经越过最后一个元素。
4.1 遍历数组的标准模板
要访问整个数组,只需让循环变量依次产生全部合法下标:
#include <stdio.h>

int main(void)
{
    int arr[10] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};

    for (size_t i = 0; i < 10; ++i)
    {
        printf("%d ", arr[i]);
    }
    printf("\n");

    return 0;
}
这里刻意写成 i < 10,而不是 i <= 10。多执行的那一次会访问 arr[10],造成未定义行为。
4.2 越界为什么危险
C 语言不会在每次下标访问时自动检查边界。越界后,程序可能:
- 读到看似随机的数据;
- 覆盖别的变量;
- 在另一台机器或换成优化编译后才崩溃;
- 表面运行正常,却已经埋下难以定位的错误。
“这次没崩”从来不能证明下标合法。边界必须由程序员从数组长度推导并维护。
五、数组的输入与输出:循环负责产生全部下标
数组本身不提供“一次读取全部整数”的特殊语法。通常仍然使用循环,逐个访问元素:
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};
    size_t count = sizeof arr / sizeof arr[0];

    for (size_t i = 0; i < count; ++i)
    {
        if (scanf("%d", &arr[i]) != 1)
        {
            fprintf(stderr, "第 %zu 个整数输入失败\n", i + 1);
            return 1;
        }
    }

    for (size_t i = 0; i < count; ++i)
    {
        printf("%d%c", arr[i], i + 1 == count ? '\n' : ' ');
    }

    return 0;
}
这段代码比只写 scanf("%d", &arr[i]); 多了一次返回值检查。scanf 成功转换一个整数时返回 1;如果用户输入了不匹配的内容,程序就及时报告,而不是继续使用旧值或错误状态。
从结构上看,数组输入和输出都在重复同一件事:
产生下标 i → 访问 arr[i] → 对该元素完成一次操作
操作可以是输入、打印、求和、找最大值,也可以是更复杂的过滤或变换。数组把数据组织整齐,循环把相同操作批量应用到这些数据上。
5.1 求和与平均值
#include <stdio.h>

int main(void)
{
    int scores[] = {86, 92, 75, 88, 95};
    size_t count = sizeof scores / sizeof scores[0];
    int sum = 0;

    for (size_t i = 0; i < count; ++i)
    {
        sum += scores[i];
    }

    printf("sum = %d\n", sum);
    printf("average = %.2f\n", (double)sum / count);
    return 0;
}
最后一行先把 sum 转换为 double,避免两个整数相除时丢掉小数部分。
六、连续存储:下标为什么能快速定位元素
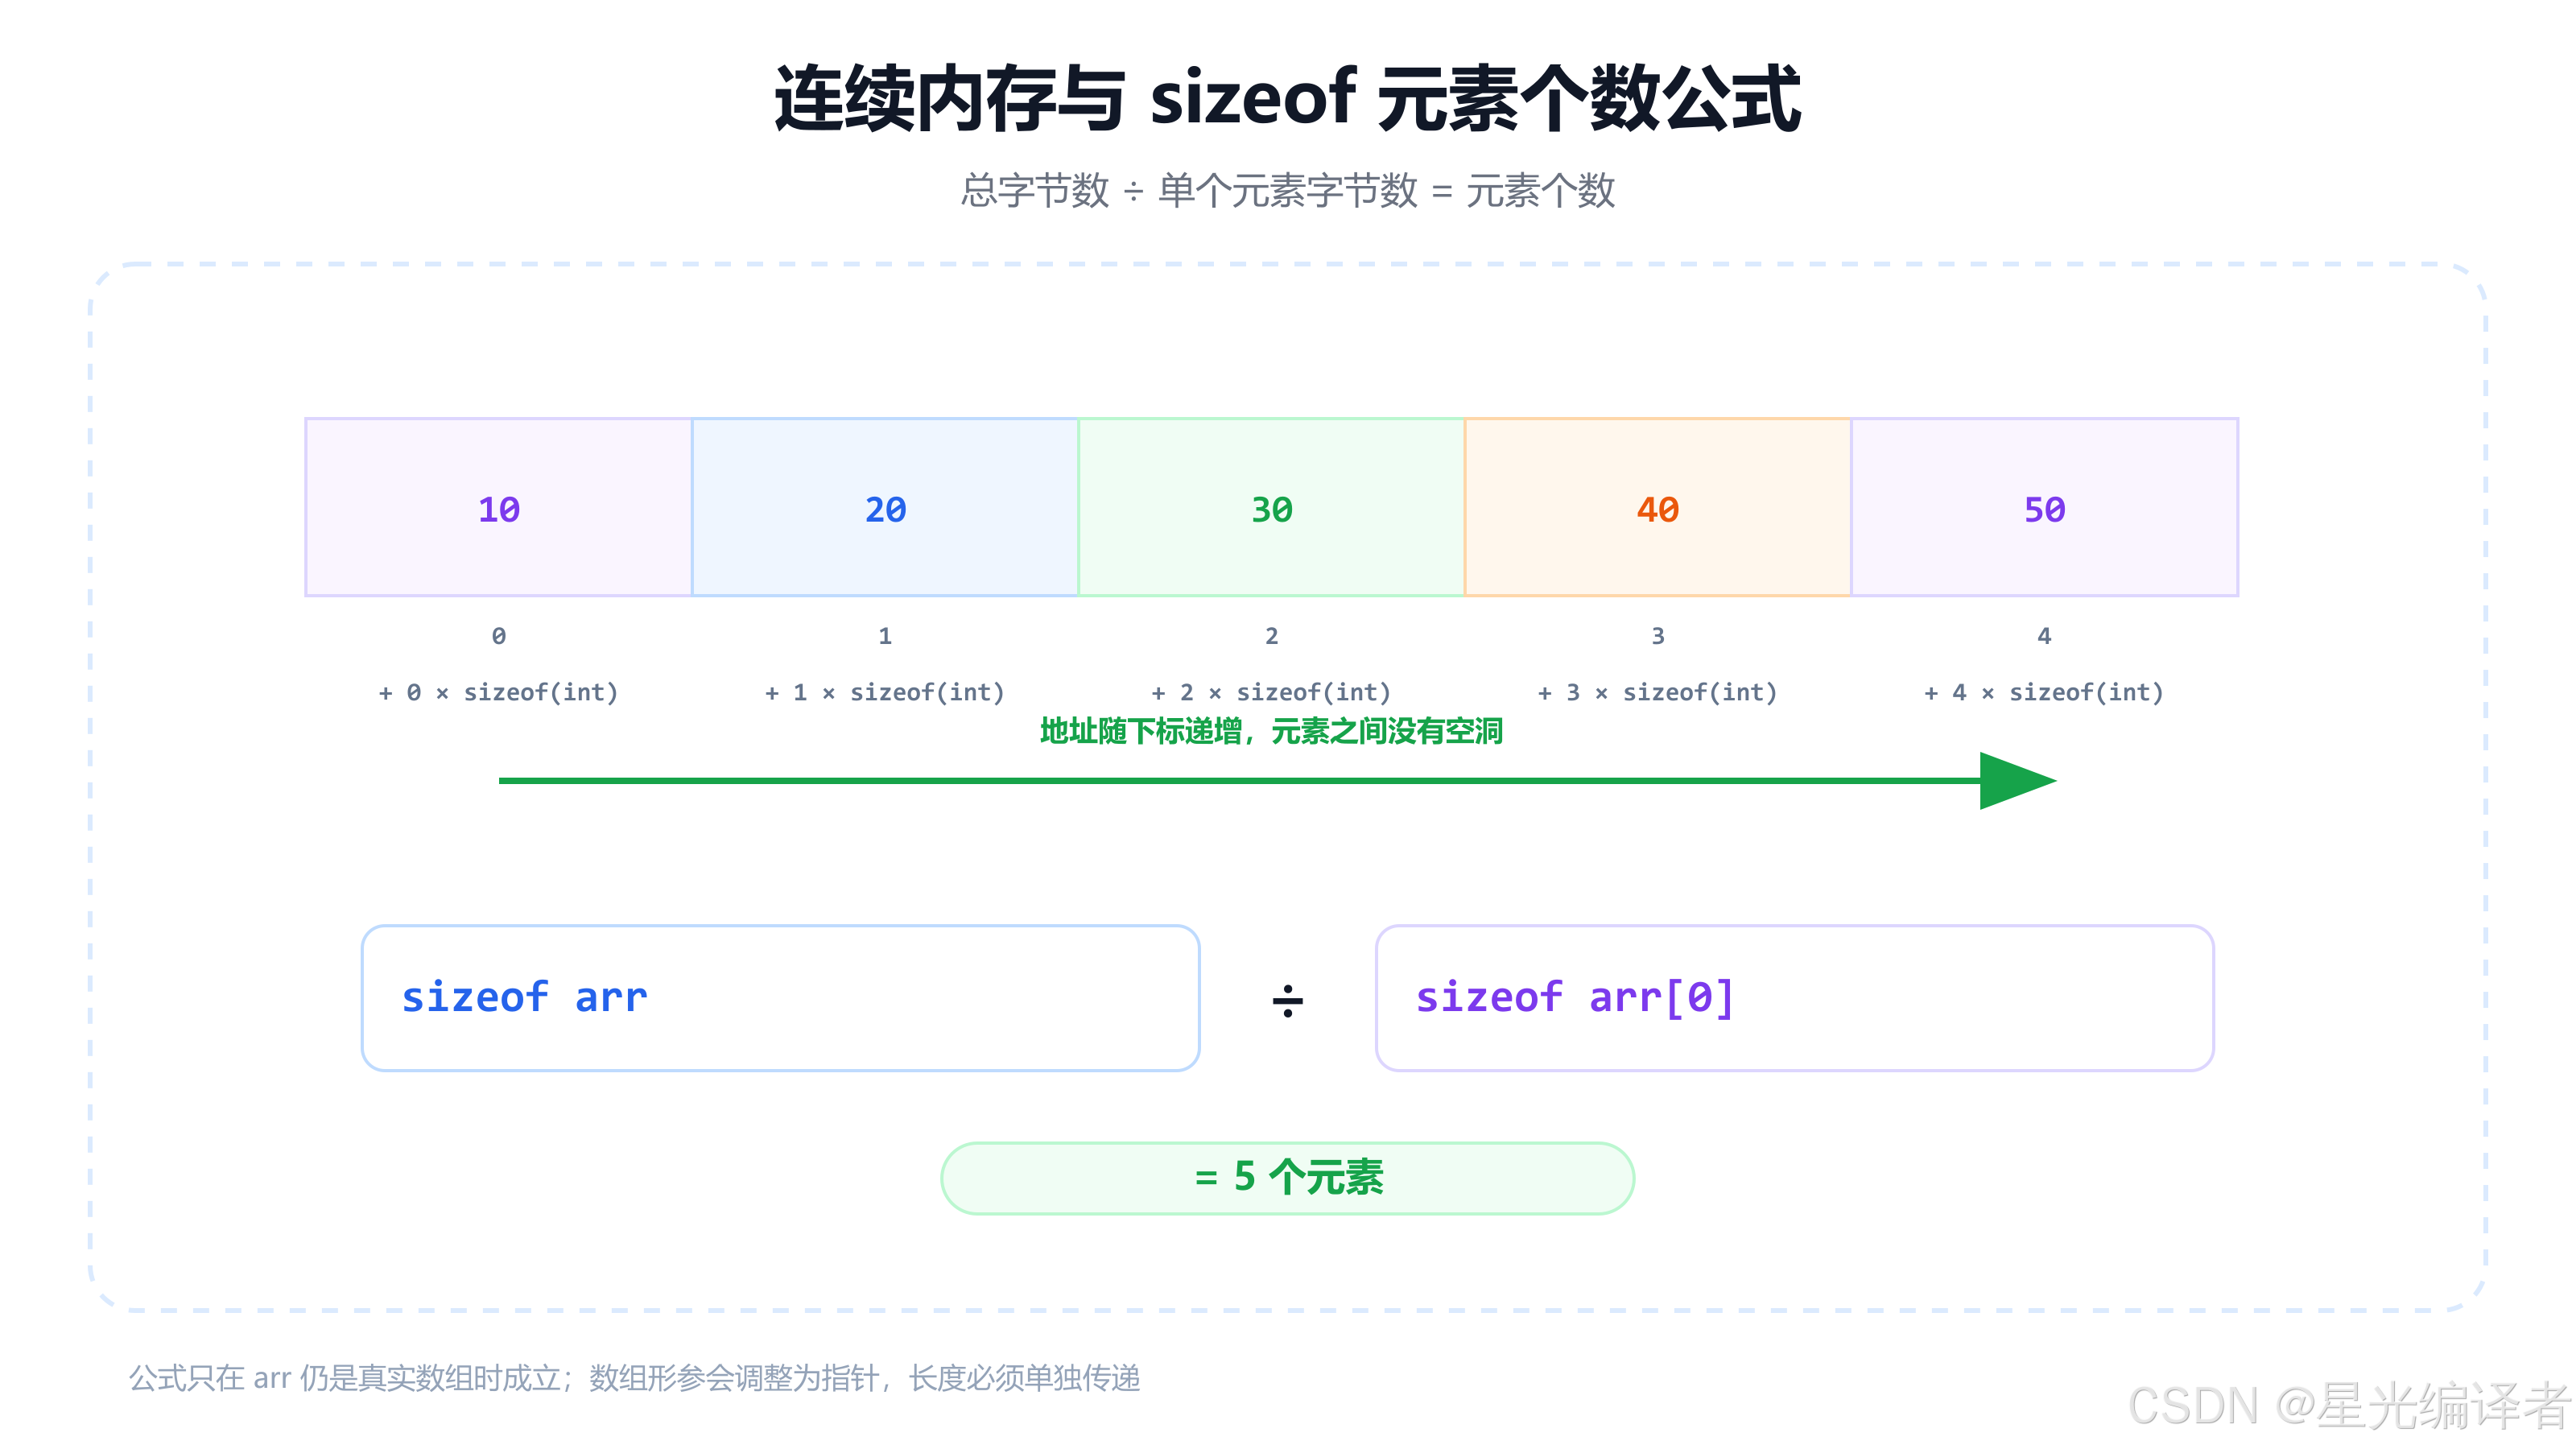
数组最重要的内存特征是:所有元素按下标顺序连续存放。
可以打印各元素地址观察这一点:
#include <stdio.h>

int main(void)
{
    int arr[5] = {10, 20, 30, 40, 50};

    for (size_t i = 0; i < 5; ++i)
    {
        printf("&arr[%zu] = %p\n", i, (void *)&arr[i]);
    }

    return 0;
}
%p 要求对应参数是 void *,因此使用 (void *)&arr[i] 更符合标准接口。某次运行可能看到相邻地址相差 4 字节,但具体地址每次运行都可能不同。
如果当前实现中 sizeof(int) == 4,那么地址关系可以写成:
&arr[1] 比 &arr[0] 向后 4 字节
&arr[2] 比 &arr[1] 向后 4 字节
&arr[3] 比 &arr[2] 向后 4 字节
更一般地说,相邻元素首地址之间的字节距离是 sizeof arr[0],不能把“int 永远 4 字节”当成语言标准保证。
数组连续存储带来两个直接结果:
- 只要知道首元素位置、元素大小和下标,就能快速定位任意元素。
- 后续学习指针时,可以从
arr[i]与地址偏移的关系理解数组访问。
此时先建立直觉即可:
第 i 个元素的位置 = 首元素位置 + i × 单个元素大小
七、sizeof 计算元素个数:好用,但有作用域边界
sizeof 可以得到对象或类型占用的字节数,结果类型是 size_t。
#include <stdio.h>

int main(void)
{
    int arr[10] = {0};

    printf("数组总字节数:%zu\n", sizeof arr);
    printf("单个元素字节数:%zu\n", sizeof arr[0]);

    return 0;
}
如果这个实现的 int 占 4 字节,sizeof arr 就是 40,sizeof arr[0] 就是 4。二者相除可得到元素个数:
size_t count = sizeof arr / sizeof arr[0];
这条公式有三个优点:
- 不把长度
10重复写死在循环中; - 修改初始化列表后,遍历长度会自动同步;
- 不依赖
int到底占多少字节。
推荐把遍历写成:
for (size_t i = 0; i < sizeof arr / sizeof arr[0]; ++i)
{
    printf("%d ", arr[i]);
}
或先保存到 count,让条件更容易阅读。
7.1 为什么使用 %zu
sizeof 的结果是 size_t,打印它应使用 %zu:
printf("%zu\n", sizeof arr);
课件中常见的 %d 用来打印 int,与 size_t 并不保证匹配。在 64 位环境里,二者宽度经常不同。让格式说明符与实参类型对应,是写 C 程序必须养成的习惯。
7.2 公式为什么不能随便放进函数
看下面的代码:
void print_array(int arr[])
{
    size_t count = sizeof arr / sizeof arr[0]; // 错误思路
}
函数形参中的 int arr[] 会调整为 int *arr。此时 sizeof arr 得到的是指针大小,不是调用者数组的总大小,计算结果自然不是真实元素个数。
正确做法是把长度作为独立参数传入:
void print_array(const int arr[], size_t count)
{
    for (size_t i = 0; i < count; ++i)
    {
        printf("%d%c", arr[i], i + 1 == count ? '\n' : ' ');
    }
}

int main(void)
{
    int data[] = {3, 1, 4, 1, 5};
    size_t count = sizeof data / sizeof data[0];

    print_array(data, count);
    return 0;
}
一句话概括:sizeof 数组 / sizeof 数组[0] 必须在“名字仍代表真实数组”的位置使用。
八、二维数组的创建与初始化
二维数组可以理解为“元素是一维数组的数组”。基本语法如下:
元素类型 数组名[行数][列数];
例如:
int matrix[3][5];
double data[2][8];
int matrix[3][5] 表示:
- 整个数组有 3 行;
- 每行有 5 个
int; - 总元素个数是
3 * 5; - 行下标范围是
0~2; - 列下标范围是
0~4。
8.1 平铺初始化
int matrix[3][5] = {
    1, 2, 3, 4, 5,
    2, 3, 4, 5, 6,
    3, 4, 5, 6, 7
};
初始值按行依次填入。前 5 个进入第 0 行,接着 5 个进入第 1 行,最后 5 个进入第 2 行。
8.2 按行分组初始化
为了让结构更直观,更推荐给每行使用一层大括号:
int matrix[3][5] = {
    {1, 2, 3, 4, 5},
    {2, 3, 4, 5, 6},
    {3, 4, 5, 6, 7}
};
8.3 不完全初始化
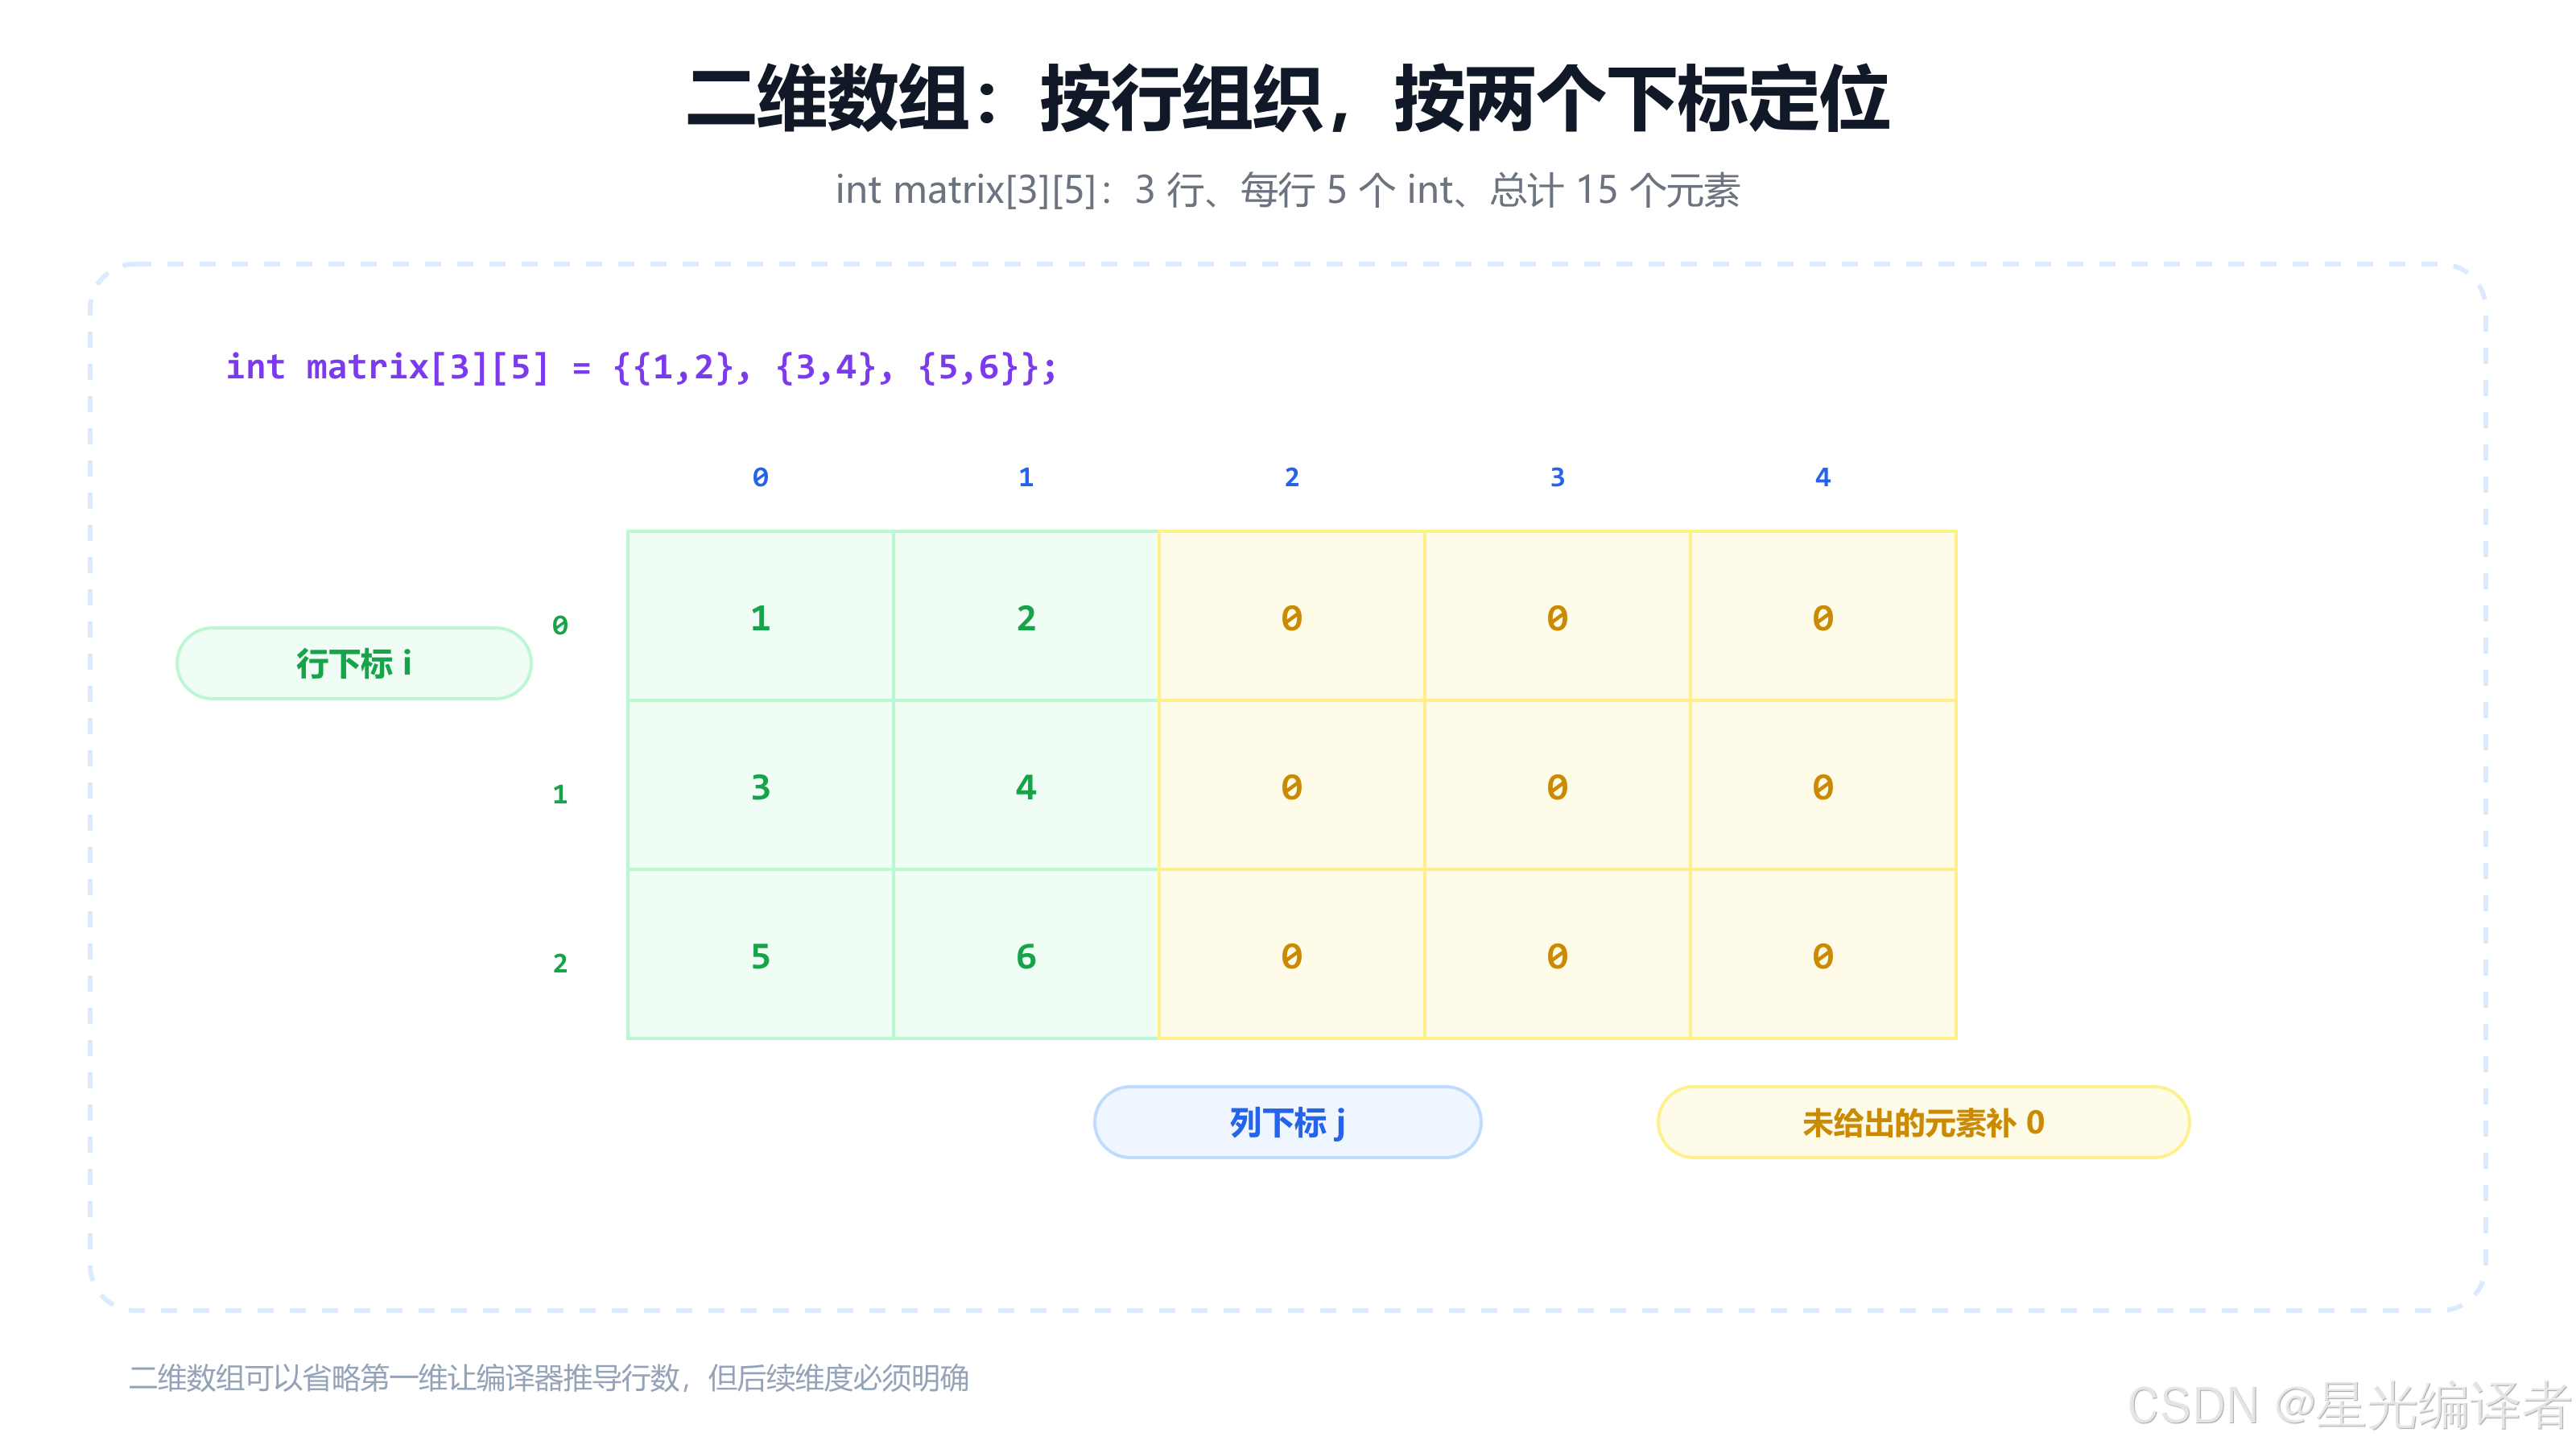
int a[3][5] = {{1, 2}, {3, 4}, {5, 6}};
每行没有显式给出的元素都会补 0,得到:
1 2 0 0 0
3 4 0 0 0
5 6 0 0 0
而:
int b[3][5] = {1, 2};
会先按整体顺序填入 b[0][0] 和 b[0][1],其余元素全部补 0。
8.4 可以省略行数,不能省略列数
初始化二维数组时可以让编译器推导第一维:
int a[][5] = {1, 2, 3, 4, 5, 6, 7};
int b[][5] = {{1, 2}, {3, 4}, {5, 6}};
但通常不能写成:
// int wrong[3][] = {1, 2, 3};
原因是编译器需要知道“每行有多少元素”,才能确定从一行跳到下一行要跨过多少字节。第一维表示有多少行,可以根据总初始值推导;后续维度决定单个子数组的形状,不能随意缺失。
九、二维数组的访问与遍历:外层行、内层列
二维数组用两个下标定位元素:
matrix[行下标][列下标]
例如:
#include <stdio.h>

int main(void)
{
    int matrix[3][5] = {
        {1, 2, 3, 4, 5},
        {2, 3, 4, 5, 6},
        {3, 4, 5, 6, 7}
    };

    printf("%d\n", matrix[2][4]); // 7
    return 0;
}
注意自然语言中的“第 3 行第 5 列”对应下标 [2][4],因为两维都从 0 开始。
9.1 用嵌套循环遍历
#include <stdio.h>

int main(void)
{
    int matrix[3][5] = {0};
    size_t rows = sizeof matrix / sizeof matrix[0];
    size_t cols = sizeof matrix[0] / sizeof matrix[0][0];

    for (size_t i = 0; i < rows; ++i)
    {
        for (size_t j = 0; j < cols; ++j)
        {
            if (scanf("%d", &matrix[i][j]) != 1)
            {
                fprintf(stderr, "输入 matrix[%zu][%zu] 失败\n", i, j);
                return 1;
            }
        }
    }

    for (size_t i = 0; i < rows; ++i)
    {
        for (size_t j = 0; j < cols; ++j)
        {
            printf("%d%c", matrix[i][j], j + 1 == cols ? '\n' : ' ');
        }
    }

    return 0;
}
两层循环的职责非常清楚:
外层 i:依次选择每一行
内层 j:在当前行中依次选择每一列
外层循环每执行一次,内层循环会完整走过当前行的全部列。把 i 和 j 的范围写反,是二维数组最常见的越界来源之一。
9.2 自动计算行数与列数
在二维数组仍是完整数组对象的作用域内:
size_t rows = sizeof matrix / sizeof matrix[0];
size_t cols = sizeof matrix[0] / sizeof matrix[0][0];
sizeof matrix:整个二维数组的字节数;sizeof matrix[0]:一整行的字节数;sizeof matrix[0][0]:一个元素的字节数。
所以“总大小除以一行大小”得到行数,“一行大小除以一个元素大小”得到列数。
十、二维数组的内存布局:逻辑是表格,物理仍是一条连续空间
二维数组在代码中呈现为行列结构,但在内存里,各行仍然按顺序连续排列:
matrix[0][0] ... matrix[0][4]
紧接着
matrix[1][0] ... matrix[1][4]
紧接着
matrix[2][0] ... matrix[2][4]
这种顺序称为行优先顺序。可以用地址验证:
#include <stdio.h>

int main(void)
{
    int matrix[3][5] = {0};

    for (size_t i = 0; i < 3; ++i)
    {
        for (size_t j = 0; j < 5; ++j)
        {
            printf("&matrix[%zu][%zu] = %p\n",
                   i, j, (void *)&matrix[i][j]);
        }
    }

    return 0;
}
同一行的相邻元素是连续的,跨行边界也没有空洞:matrix[0][4] 后面紧接着 matrix[1][0]。
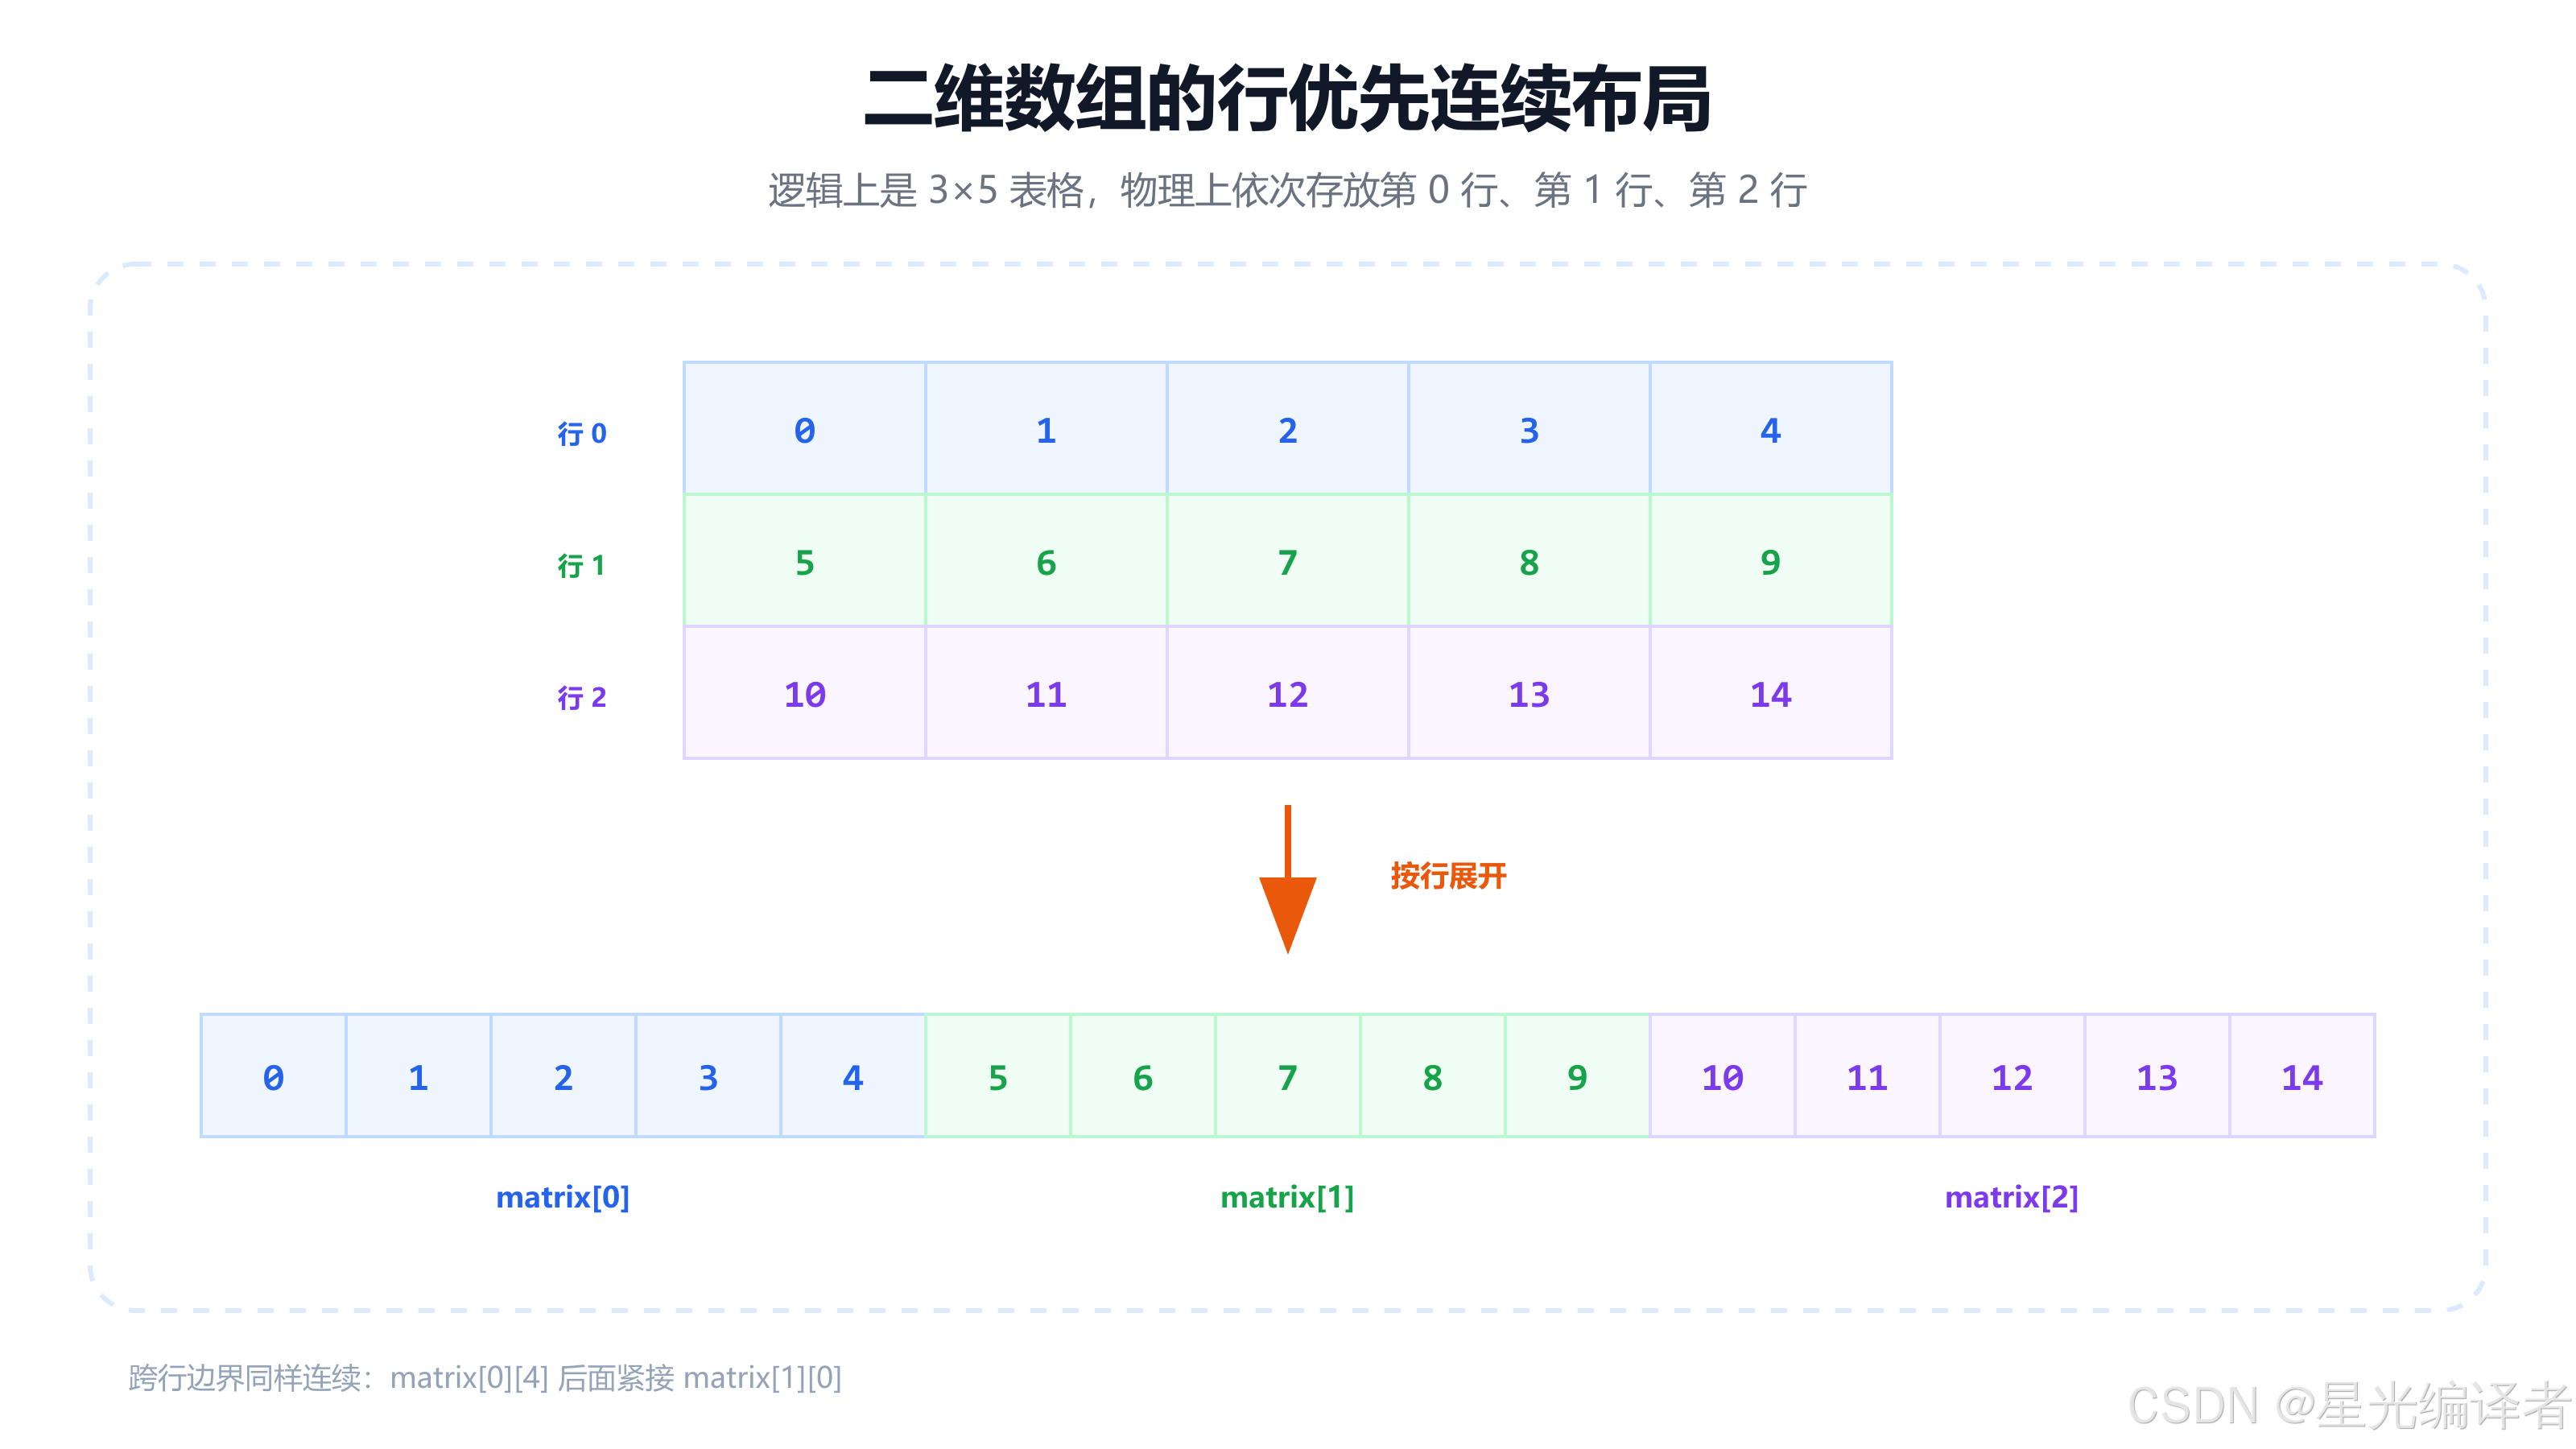
对于 int matrix[3][5],可以从类型层次理解:
matrix          :3 行组成的二维数组
matrix[0]       :第 0 行,是一个 int[5]
matrix[0][0]    :第 0 行第 0 列,是一个 int
当每个元素大小为 sizeof(int) 时,matrix[i][j] 相对首元素的线性序号是:
i * 列数 + j
这也解释了为什么编译器访问二维数组时必须知道列数:只有知道一行有多宽,才能从第 i 行的起点继续定位第 j 列。
十一、C99 变长数组:运行时确定长度,不是运行时随意伸缩
C99 引入了变长数组(variable length array,VLA),允许数组长度由运行时表达式决定:
int n = 0;
scanf("%d", &n);
int arr[n];
它的“变长”容易被误解。准确含义是:长度在到达声明时才确定。一旦本次执行创建了 arr,它在自己的生命周期内不会自动扩容或缩小。
11.1 使用 VLA 前必须检查长度
#include <stdio.h>

int main(void)
{
    int n = 0;

    if (scanf("%d", &n) != 1 || n <= 0 || n > 10000)
    {
        fprintf(stderr, "请输入 1~10000 之间的长度\n");
        return 1;
    }

    int arr[n];

    for (int i = 0; i < n; ++i)
    {
        if (scanf("%d", &arr[i]) != 1)
        {
            fprintf(stderr, "输入失败\n");
            return 1;
        }
    }

    for (int i = 0; i < n; ++i)
    {
        printf("%d%c", arr[i], i + 1 == n ? '\n' : ' ');
    }

    return 0;
}
长度不能是 0 或负数,也不应完全相信用户输入。很多实现把局部 VLA 放在栈上,过大的长度可能耗尽有限的栈空间。
11.2 VLA 不能使用普通初始化列表
下面这种写法不符合 VLA 的规则:
int n = 5;
// int arr[n] = {0}; // VLA 不能这样初始化
如果需要初值,应创建后再循环赋值:
int arr[n];

for (int i = 0; i < n; ++i)
{
    arr[i] = 0;
}
11.3 编译器兼容性
VLA 来自 C99,但后续标准允许实现不提供完整的 VLA 支持;不同编译器的支持情况也不同。GCC、Clang 在许多 C 模式下支持,微软的 C 编译器长期以来通常不支持标准 VLA 声明。
如果项目重视跨平台兼容,常见选择是:
- 长度上限明确且不大:使用固定长度数组,并单独记录实际使用数量;
- 长度只在运行时知道:后续学习动态内存分配,使用
malloc和free; - 确认编译器和项目规范允许:再使用 VLA。
VLA 是数组长度确定时机的变化,不是可以替代动态容器的“自动扩容数组”。
十二、数组练习一:字符从两端向中间汇聚
题目要求:先显示一串 #,再把目标字符串中的字符从左右两端逐步替换进来,直到完整呈现。
例如目标字符串是:
welcome to bit...
显示过程可以是:
#################
w###############.
we#############..
wel###########...
...
welcome to bit...
程序需要维护两个下标:
left从 0 开始向右移动;right从字符串最后一个有效字符开始向左移动;- 每轮同时复制两个位置;
- 当
left > right时,全部字符已经替换完成。
跨平台核心版本可以写成:
#include <stdio.h>
#include <string.h>

int main(void)
{
    char source[] = "welcome to bit...";
    char display[] = "#################";
    size_t left = 0;
    size_t right = strlen(source) - 1;

    puts(display);

    while (left <= right)
    {
        display[left] = source[left];
        display[right] = source[right];
        puts(display);

        ++left;
        if (right == 0)
        {
            break;
        }
        --right;
    }

    return 0;
}
这里比课件示例多处理了一个细节:size_t 是无符号类型,若 right 已经为 0 再执行 --right,会下溢到一个极大的值,因此在递减前检查。
如果希望每一步暂停一秒,可根据平台添加延时:Windows 常见 Sleep(1000),需包含 <windows.h>;POSIX 环境常用其他接口。为了让核心算法保持可移植,延时不应与数组逻辑绑死。
这个练习真正训练的不是动画效果,而是三个数组能力:
- 字符串本质上是以
\0结尾的字符数组; - 下标可以从两端同时向中间推进;
- 循环条件必须覆盖中间只剩一个字符的奇数长度情况。
十三、数组练习二:二分查找
在一个已经按升序排列的数组中查找目标值,最直接的方法是从头到尾逐个比较,最坏需要检查全部元素。
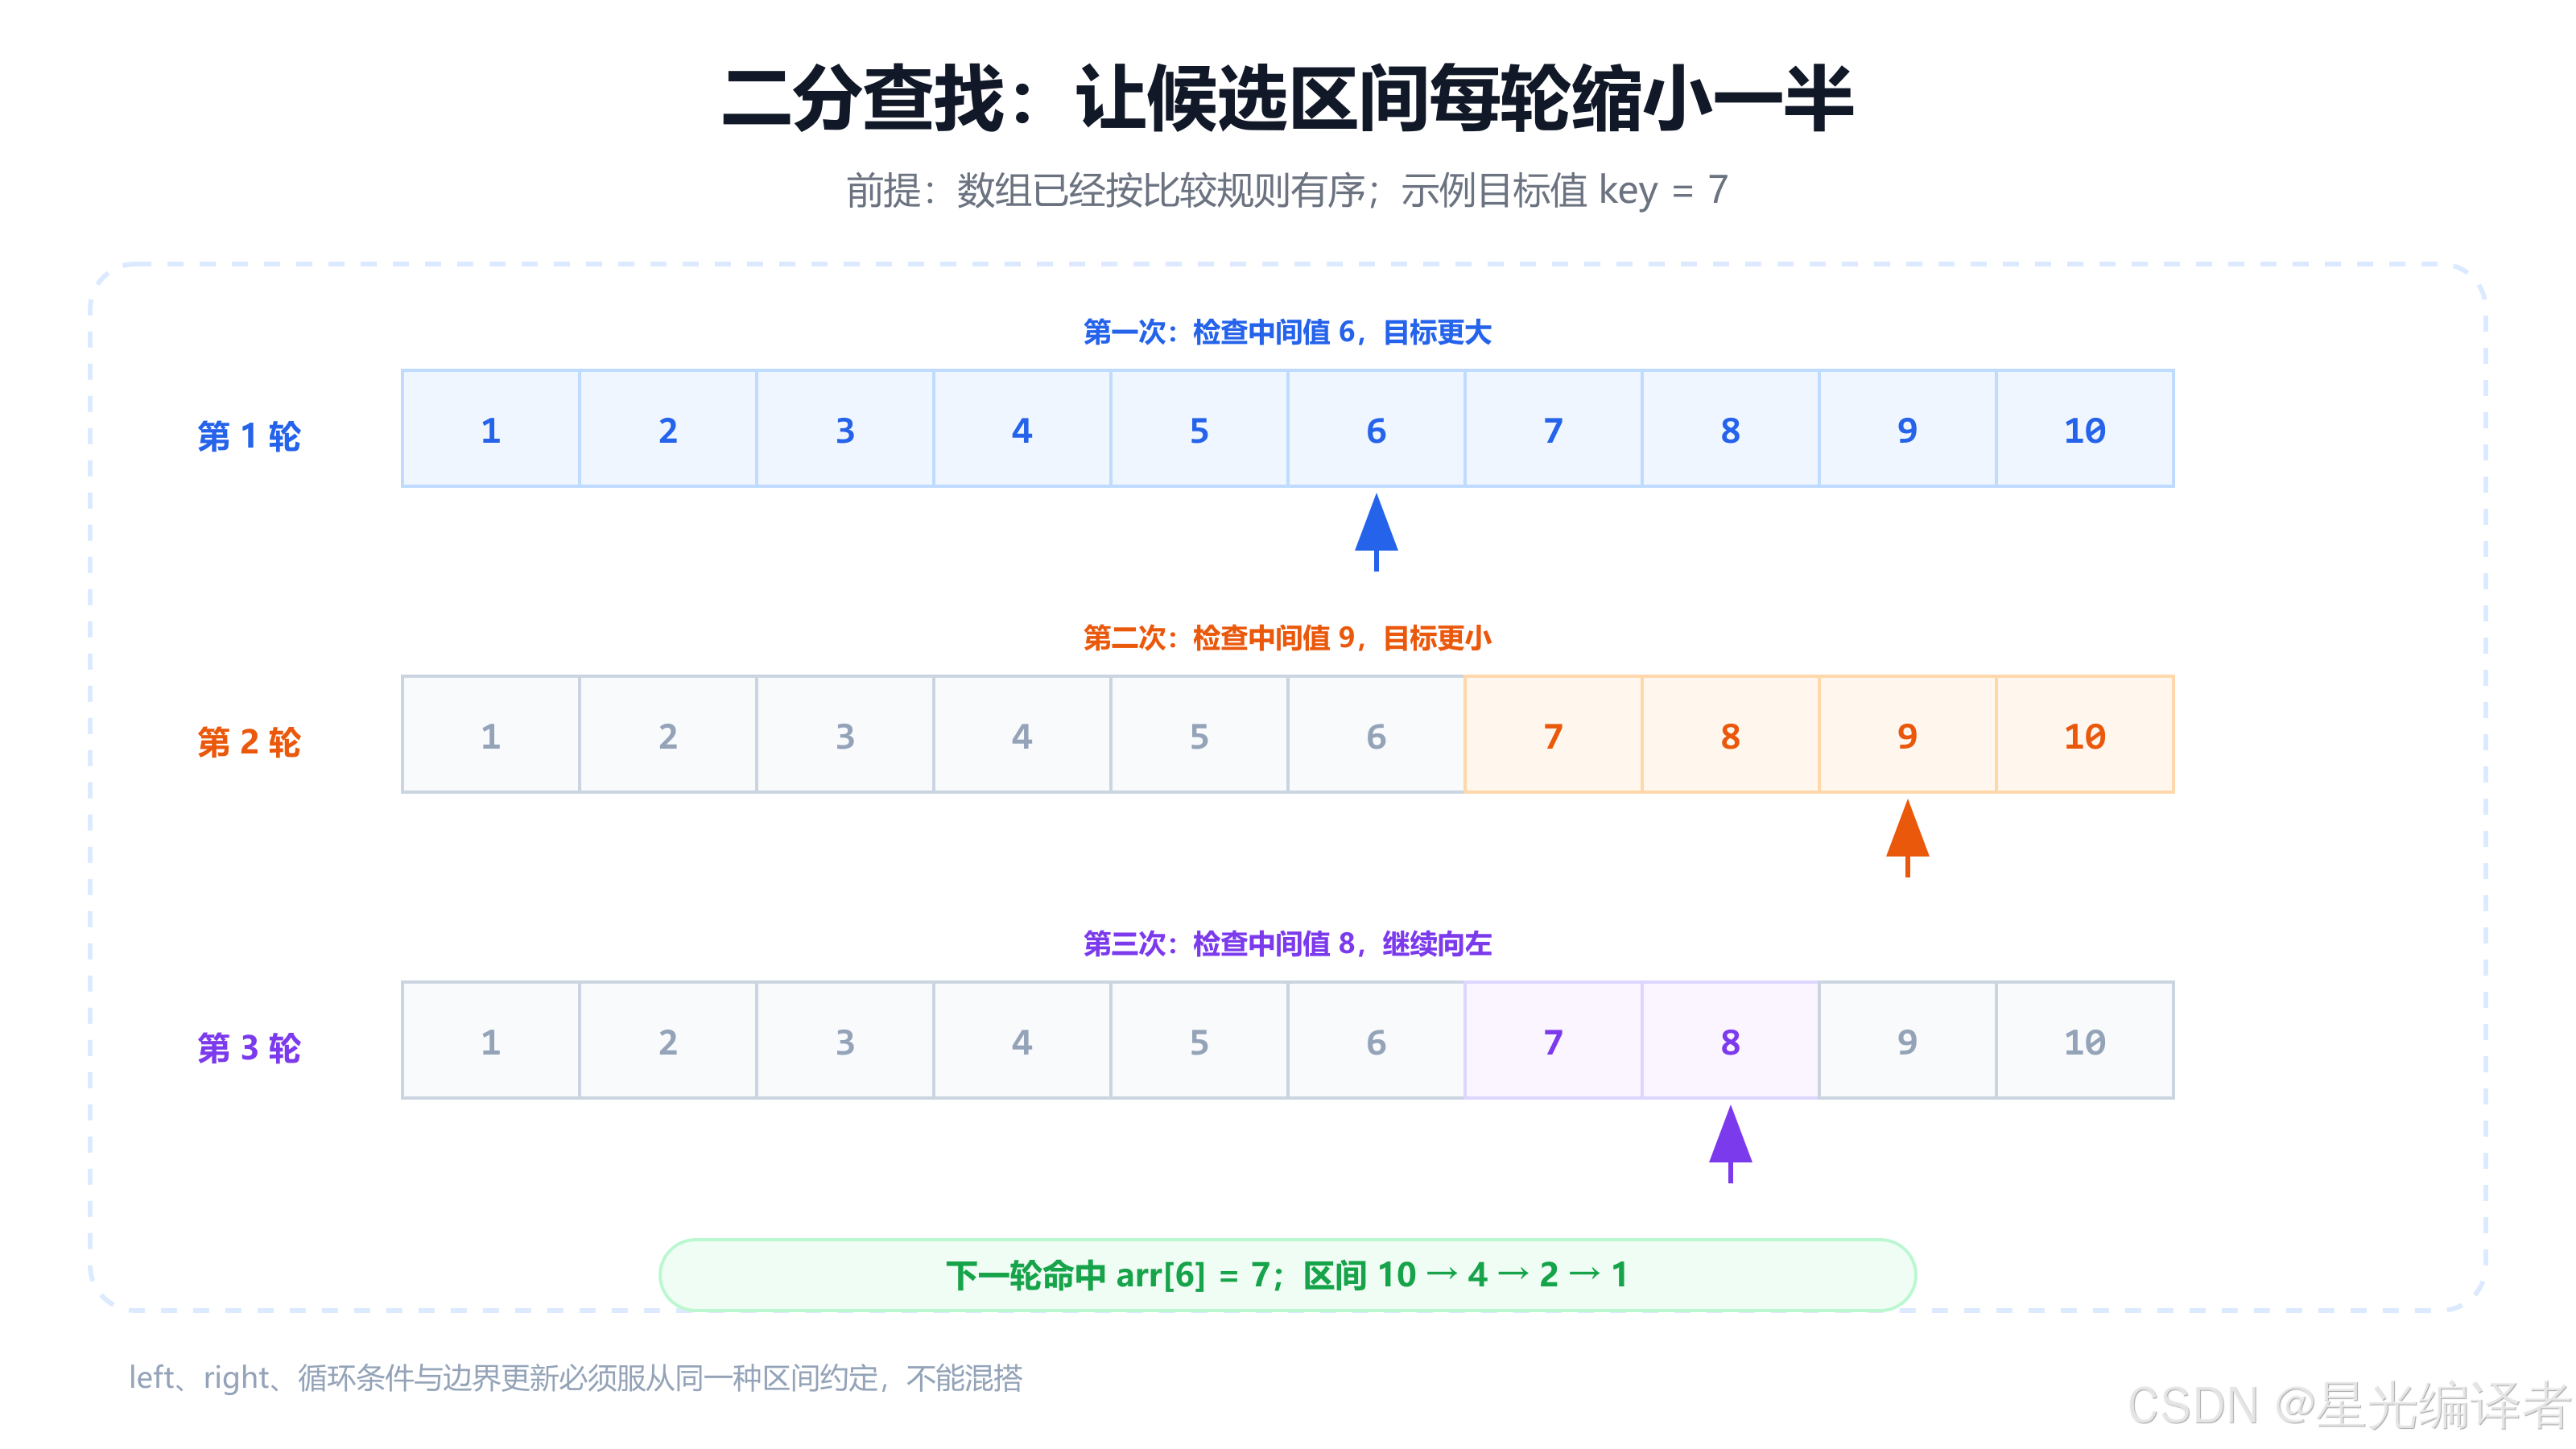
二分查找每次检查当前区间的中间元素,并根据比较结果丢弃一半不可能的范围:
目标小于中间值 → 只保留左半区间
目标大于中间值 → 只保留右半区间
目标等于中间值 → 查找成功
13.1 完整实现
#include <stdio.h>

int main(void)
{
    int arr[] = {1, 2, 3, 4, 5, 6, 7, 8, 9, 10};
    int key = 7;
    size_t count = sizeof arr / sizeof arr[0];
    size_t left = 0;
    size_t right = count; // 使用左闭右开区间 [left, right)
    size_t index = 0;
    int found = 0;

    while (left < right)
    {
        size_t mid = left + (right - left) / 2;

        if (arr[mid] < key)
        {
            left = mid + 1;
        }
        else if (arr[mid] > key)
        {
            right = mid;
        }
        else
        {
            index = mid;
            found = 1;
            break;
        }
    }

    if (found)
    {
        printf("找到了,下标是 %zu\n", index);
    }
    else
    {
        printf("找不到\n");
    }

    return 0;
}
这份实现使用左闭右开区间 [left, right):left 指向候选区间第一个元素,right 指向候选区间之后的位置。循环条件是 left < right。
课件中也使用了常见的左右闭区间 [left, right],两种写法都正确,但初始化、循环条件和边界更新必须保持同一套约定,不能混用。
13.2 为什么 mid 要这样计算
不推荐:
mid = (left + right) / 2;
更稳妥:
mid = left + (right - left) / 2;
第二种写法避免先计算可能很大的 left + right。在本文的十个元素里当然不会溢出,但养成正确模板后,面对大数组时不用重新修正。
13.3 二分查找成立的前提
二分查找并不是“任何数组都能更快查找”。它至少要求:
- 数据已经按照比较规则有序;
- 能通过下标快速访问中间元素;
- 区间更新不会遗漏目标,也不会停在原地。
若数组是 {7, 1, 9, 3, 5},直接做二分查找没有意义。必须先排序,或改用线性查找。
13.4 复杂度直觉
线性查找每次只排除一个元素,最坏比较次数随 n 线性增长,通常记为 O(n)。
二分查找每次把候选区间缩小一半:
n → n/2 → n/4 → n/8 → ... → 1
所以最坏比较次数约为 log2(n),记为 O(log n)。当数组很大时,这种差距会非常明显。
十四、常见误区、高频面试题与练习
14.1 常见误区
误区一:长度为 10 的数组,最后一个下标也是 10
长度是元素个数,下标从 0 开始,因此最后一个合法下标是 9。
误区二:局部数组不初始化也会自动清零
自动存储期的未初始化局部数组元素是未确定值。需要全零时明确写 {0}。
误区三:int arr[5] = {1} 只有第一个元素可用
第一个元素为 1,其余元素会按初始化规则补 0,全部五个元素都已初始化。
误区四:数组名就是普通指针
数组表达式在许多场景会转换为指向首元素的指针,但数组和指针不是同一种类型。sizeof arr、&arr、字符串字面量初始化等场景会暴露它们的差别。
误区五:在函数内对形参使用 sizeof 仍能求数组长度
void f(int arr[]) 中的 arr 实际按指针处理,sizeof arr 得到指针大小。长度需要单独传递。
误区六:sizeof 的结果用 %d 打印即可
sizeof 返回 size_t,使用 %zu 更匹配、更可移植。
误区七:int 在所有平台都占 4 字节
C 标准没有这样保证。数组相邻元素之间的字节距离应写成 sizeof arr[0]。
误区八:二维数组在内存中每行分开存放
二维数组整体仍连续。上一行最后一个元素后面紧接下一行第一个元素。
误区九:二维数组初始化时可以省略任意一维
常规初始化中可以省略第一维,由初始值数量推导;后续维度必须给出,编译器需要它确定子数组大小。
误区十:VLA 的长度会在生命周期中自动变化
VLA 只是在执行到声明时才确定长度;创建后不会随变量的新值自动改变。
误区十一:VLA 是所有 C 编译器都支持的基础能力
不同标准模式和编译器支持不同。跨平台项目必须先确认工具链与规范。
误区十二:二分查找不要求数组有序
二分查找根据中间值排除一半区间,只有在顺序关系成立时,这个排除才有逻辑依据。
14.2 高频面试题
问题 1:数组的核心特点是什么?
元素类型相同、数量确定、内存连续,并通过从 0 开始的下标访问。
问题 2:int arr[10] 有哪些合法下标?
0~9。访问 arr[10] 越界并导致未定义行为。
问题 3:int arr[5] = {0} 是否只初始化第一个元素?
不是。第一个元素显式为 0,剩余元素按规则也初始化为 0。
问题 4:怎样计算真实数组的元素个数?
在数组尚未退化为指针的作用域使用 sizeof arr / sizeof arr[0]。
问题 5:为什么数组形参中不能用同一公式?
数组形参会调整为指针,sizeof arr 只得到指针大小。
问题 6:二维数组为什么不能省略列数?
编译器必须知道每一行的大小,才能根据行下标计算地址偏移。
问题 7:二维数组按什么顺序存储?
按行优先连续存储:先放完第 0 行,再放第 1 行,依次类推。
问题 8:VLA 的“变长”是什么意思?
长度在运行时到达声明时确定,不代表数组创建后可以自动伸缩。
问题 9:二分查找的前提和复杂度是什么?
前提是数组按比较规则有序;时间复杂度为 O(log n)。
问题 10:left + (right - left) / 2 有什么好处?
避免先计算 left + right,降低大下标相加溢出的风险。
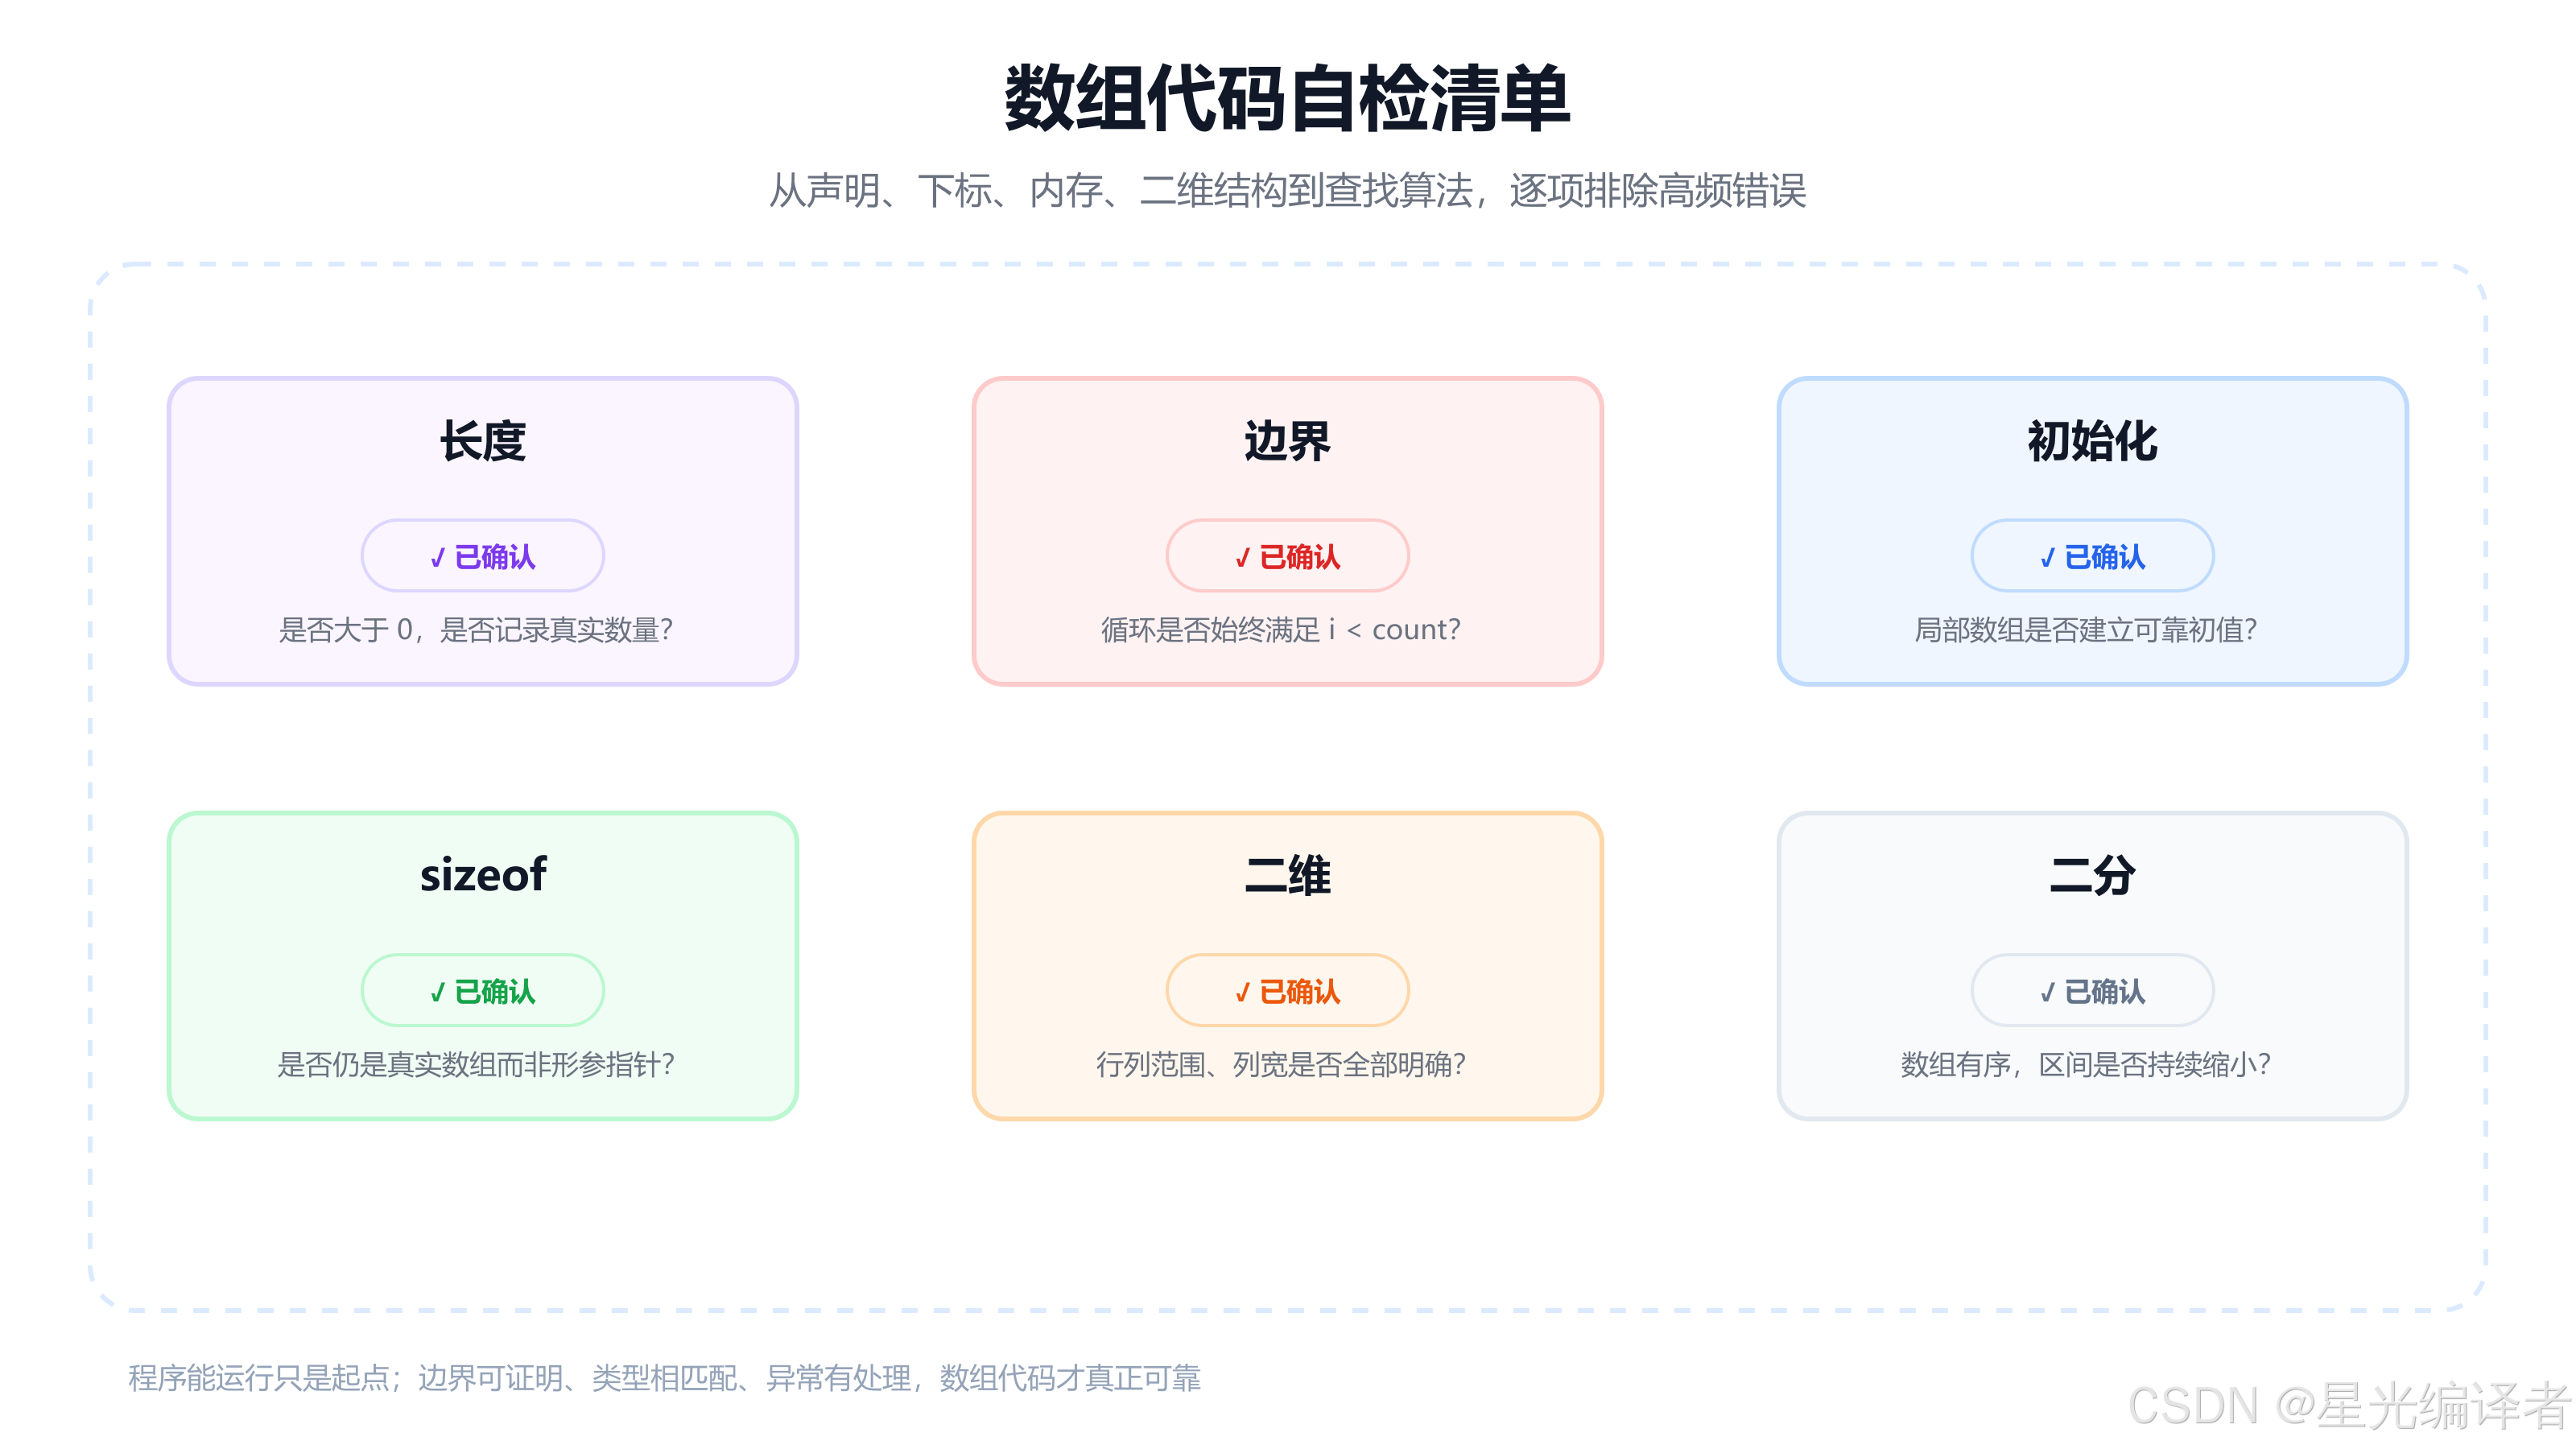
14.3 排查清单
- 数组长度是否大于 0?
- 元素类型是否一致?
- 未初始化的局部数组是否被错误地当成全零?
- 循环是否使用
i < count,而不是i <= count? - 每次下标访问是否落在
0~count-1? -
scanf是否传入元素地址并检查返回值? -
%p对应的指针是否转换为void *? -
sizeof的结果是否使用size_t和%zu? - 元素个数公式是否只用于真实数组,而不是函数形参?
- 二维数组的行列范围是否没有写反?
- 二维数组初始化时是否明确列数?
- VLA 长度是否经过正数和上限检查?
- 是否确认目标编译器支持 VLA?
- 二分查找前是否保证数组有序?
- 二分区间的初始化、循环条件与边界更新是否属于同一种约定?
14.4 建议练习
练习一:数组逆序
把 {1, 2, 3, 4, 5} 原地改成 {5, 4, 3, 2, 1},只允许使用一个临时变量。
练习二:最大值与下标
找出数组中的最大值,并同时输出它第一次出现的下标。
练习三:统计成绩区间
统计 60 分以下、6079、8089、90~100 各有多少人。
练习四:二维数组转置
把一个 3×4 矩阵转置到 4×3 的新数组中。
练习五:打印每行和每列之和
分别遍历二维数组,输出每一行与每一列的总和。
练习六:字符汇聚反向动画
在完整字符串显示后,再从中间向两端逐步恢复为 #。
练习七:封装线性查找
编写函数接收数组、长度和目标值,找到时返回下标,找不到时返回约定值。
练习八:封装二分查找
分别用左闭右闭、左闭右开两种区间写法实现,并为长度 0、长度 1、目标在两端和目标不存在编写测试。
练习九:寻找第一个重复元素
先用双层循环完成,再思考学习排序或哈希结构后如何优化。
练习十:验证内存连续性
打印一维、二维数组各元素地址,并用 sizeof 验证相邻元素与相邻行的跨度。
14.5 参考资料
- 本文依据课程 PDF《第5讲:数组》整理,并对数组类型、输入校验、
sizeof的适用边界、格式化输出、VLA 兼容性和二分区间约定做了补充。 - WG14 C 标准工作组文档:Clarify array length specifications and
sizeofexpressions - GCC 官方文档:Arrays of Variable Length
- Microsoft C 编译器文档:
/std- Specify language standard version - 建议结合编译器警告阅读示例:GCC/Clang 可启用
-Wall -Wextra -Wpedantic,MSVC 可启用较高警告级别。
总结
数组是 C 语言从“单个变量”走向“批量数据处理”的关键一步。它把同类型数据放进连续内存,用下标建立统一访问方式,再与循环组合,形成输入、输出、统计、查找和二维表格处理的基础。
整条知识主线可以压缩为:
确定元素类型与数量
        ↓
创建并初始化数组
        ↓
使用 0~n-1 的下标访问
        ↓
用循环覆盖全部合法下标
        ↓
理解连续内存与 sizeof
        ↓
扩展到二维数组的行列结构
        ↓
根据环境选择固定数组、VLA 或动态内存
        ↓
在有序数组上用二分查找缩小区间
最值得记住的是下面十点:
- 数组保存若干个相同类型的元素,普通数组长度必须有效。
- 长度为
n的数组,合法下标是0~n-1,arr[n]已经越界。 - 不完全初始化会把剩余元素补 0,但未初始化的局部数组不能假设为 0。
- 数组元素连续存储,相邻元素的字节距离是单个元素的大小。
sizeof arr / sizeof arr[0]能计算真实数组的元素个数。- 数组传入函数后通常按指针处理,长度必须单独传递。
- 二维数组逻辑上有行列,物理上仍按行优先连续排列。
- 二维数组可以省略第一维进行推导,但必须让编译器知道后续维度。
- VLA 是运行时确定一次长度,不是能自动扩容的数组,而且要考虑编译器支持。
- 二分查找依赖有序性,正确性来自统一的区间定义与持续缩小的边界。
掌握数组后,循环不再只是重复打印,变量也不再只能单独存在。数据开始拥有结构,程序开始能够批量处理问题;后续的字符串、指针、排序、查找与动态内存,也都会在这块基础上继续生长。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)