具身智能专题:LightNav-0激发VLM空间智能,迈向通用具身导航
(1)《三年面试五年模拟》AIGC / LLM / AI Agent 算法工程师与开发工程师求职面试秘籍,独家资源见 WeThinkIn/AIGC-Interview-Book,欢迎 Star!
(2)AIGC / LLM / AI Agent 算法岗与开发岗求职面试内推学习社群,涵盖 AIGC、LLM 大模型、AI Agent、传统深度学习、自动驾驶、机器学习、计算机视觉、自然语言处理、强化学习、大数据挖掘、具身智能、元宇宙、AGI 等方向的最新面试干货与核心知识,欢迎加入(https://t.zsxq.com/33pJ0)!
论文标题:LightNav-0:激发VLM空间智能,迈向通用具身导航
论文作者:亮源新创
发表时间:2026年8月31日
目录
本文要点
(1)LightNav-0是亮源新创2026年8月31日发布的通用导航模型,底座Qwen3-VL-4B-Instruct。
(2)10项公开导航仿真的单目成功率全部第一,同一套权重零样本落到人形、四足、轮式和飞行本体。
(3)做法上最值得看的是Real2Sim2Real数据引擎,2000多个互联网场景变成可执行仿真,再合成4000多小时轨迹。
(4)短板在路径贴合和机构场景的极值指代,RxR的nDTW输给DualVLN,INSIGHT-Bench上机构场景碰上极值指令只有18.0%。
(5)文末附GitHub README和Hugging Face模型卡的推理示例。
亮源新创在2026年8月31日把LightNav-0的技术报告挂上arXiv,9月9日更新到v2。我把HTML版报告、官方博客、GitHub README和Hugging Face模型卡对着读了一遍。架构精读CSDN上已经有长文,这篇只写数据引擎那半边。
一个4B模型,10项公开导航仿真的单目成功率全部第一。同一套权重零样本落到人形、四足、轮式和飞行本体上。导航语料覆盖2000多个场景,合计4000多小时轨迹。截至9月16日,GitHub仓库显示592个star,权重按Apache 2.0开源。
一、指向token与RVQ动作接口
底座是Qwen3-VL-4B-Instruct,不加导航专用预测头。每一步先吐两个指向token,一个点可走的空地,一个点任务目标,再吐三个残差矢量量化动作token,解码成10个SE(2)航点,交给各本体自己的底层控制器。后文不再展开。
二、导航对VLM空间先验的利用
操作要接触力、夹爪和物体形变,预训练视觉语言模型里这些监督很少。导航要的是图上哪块能走、目标在哪,这两件事模型本来就会用指点来表达。
报告把空间意图写成图像平面上的格子token,不绑深度、相机标定和跨本体的统一坐标系。室内找椅子、室外跟人,换本体也不用换这套接口。
环境覆盖的消融把账算清楚了。训练场景从八分之一加到全量,R2R成功率加16.7分,RxR加21.1分。数据从一半加到全量,R2R只多0.8分。8B相对4B还互有涨跌。场景种类比堆参数、堆小时更值钱。
三、Real2Sim2Real场景到仿真转换
互联网场景不会自己长出导航目标。无标注的Habitat-GS、HM3D、MP3D和VLNVerse走自动预标注。先在可通行位置采样视点,每个视点渲四个朝向的RGB和度量深度,Molmo2在图上开集指点,深度把像素抬到三维。
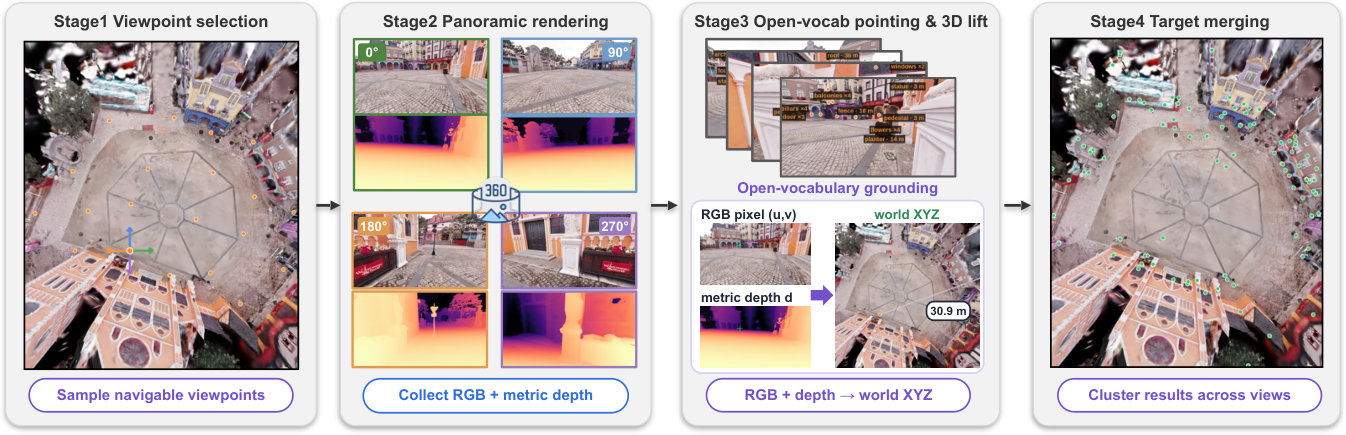
合并很严。同类观测至少来自两个视点、两次观察,三维散布小于0.6米,才收成一个目标。InteriorGS自带官方三维框,跳过发现,直接写进同一份目标清单。
目标有了之后,抽一个起点,保证目标在离线清单的某个视角里可见,在导航网格上规划路径,钉住停车点,渲出第一人称视频和动作标签。训练时相机还要随机,视场90到130度,高度0.5到1.5米,俯仰从负15度到15度。
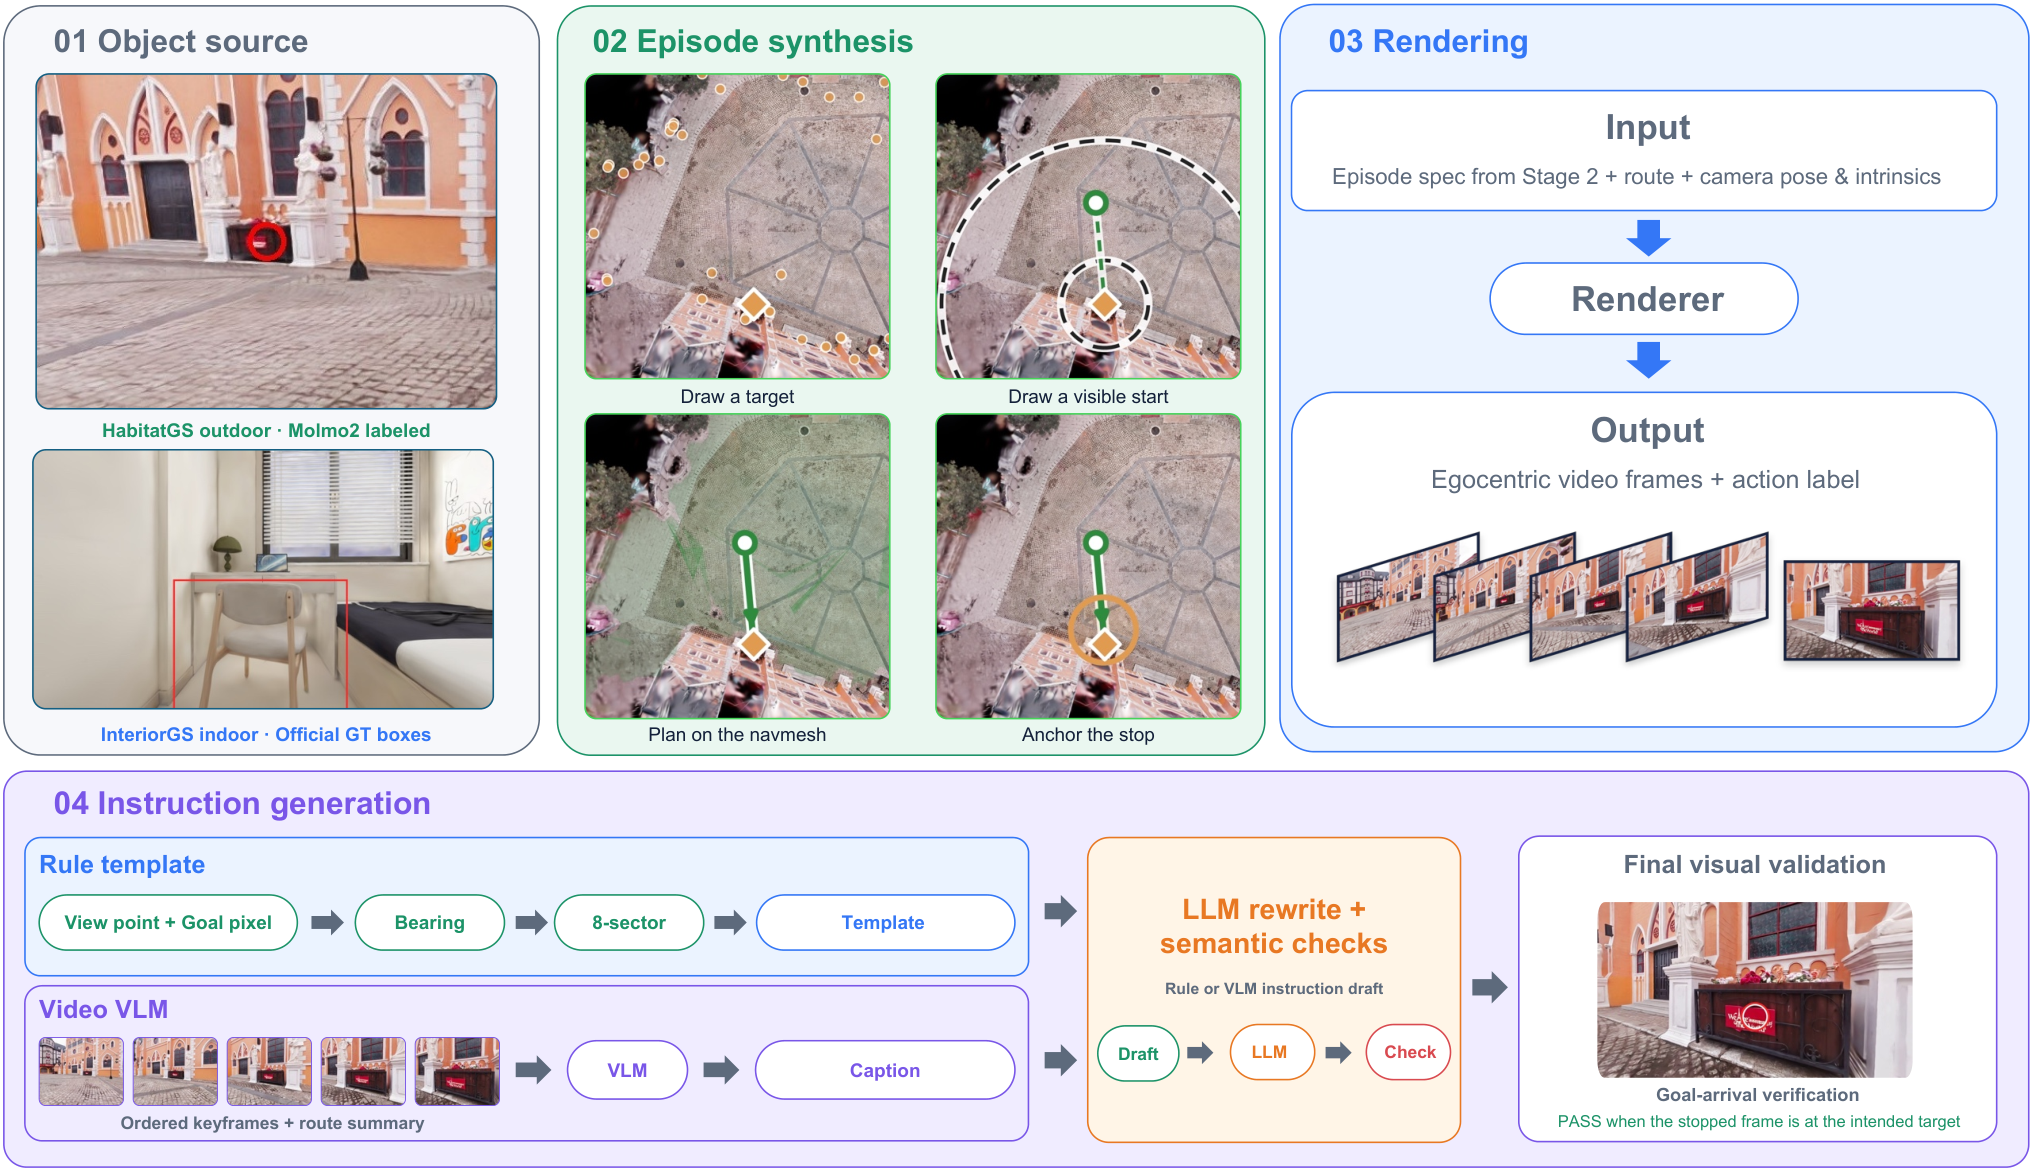
指令后写。几何模板按目标所在扇区填方向词,视频路线把均匀抽出的6帧和路径摘要交给Seed2.0。两路草稿都要过改写和语义门,方向反了就退回原文。最后用指点模型看结尾第1、3、6、10帧,目标没出现的回合标成可疑。
四、23.2M条监督微调样本配比
监督微调这摊样本按任务加总,图上写着23.2M条。采样时导航动作占77.6%,VQA占22.4%,免得动作监督把空间能力冲掉。各源小时数报告没拆。
| 来源 | 样本条数 | 小时数 |
|---|---|---|
| VQA | 5.2M | 未报告 |
| ObjectNav | 4.7M | 未报告 |
| SRDF | 4.7M | 未报告 |
| ScaleVLN | 2.8M | 未报告 |
| Tracking | 2.8M | 未报告 |
| VLN-CE RxR | 1.8M | 未报告 |
| VLN-CE R2R | 642K | 未报告 |
| INSIGHT-Bench | 454K | 未报告 |
| 图上合计 | 23.2M | 未报告 |
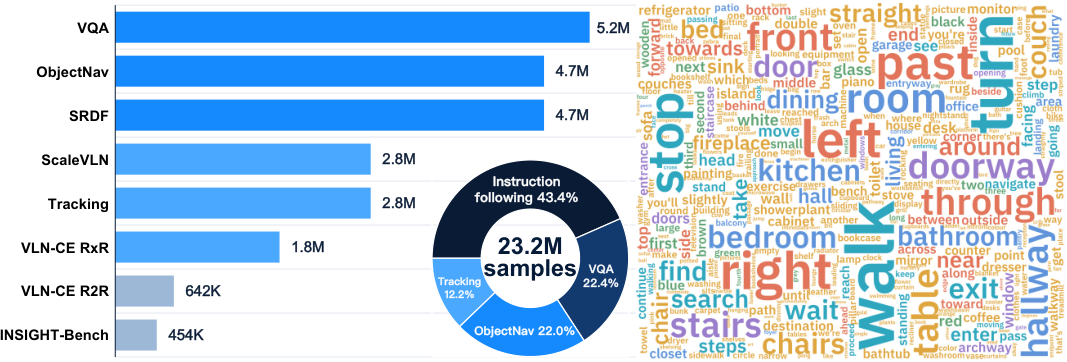
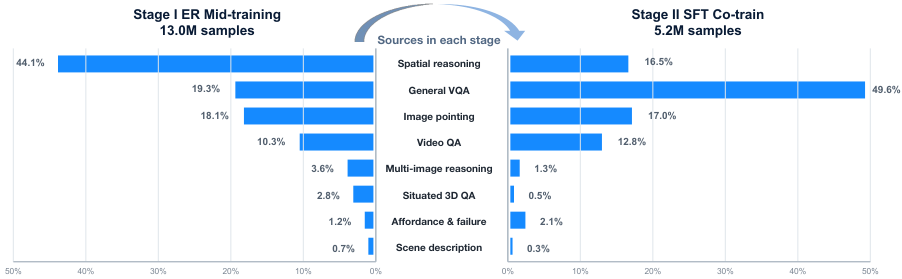
具身推理中训用36个源。指点占采样概率的35.14%,单图VQA占25.05%,视频推理占19.81%,一般视觉和抽象推理占20.00%。微调再叠16个导航源和33个辅助源。中训图上写着13.0M条,微调里留下来一起训的推理样本是5.2M条。
质检也写进配比。停止样本上限2%,轨迹簇上限5%,目标从头到尾没出现过的回合直接扔掉。跟踪数据来自EVT-Bench的行人跟随,报告没写其他类别。
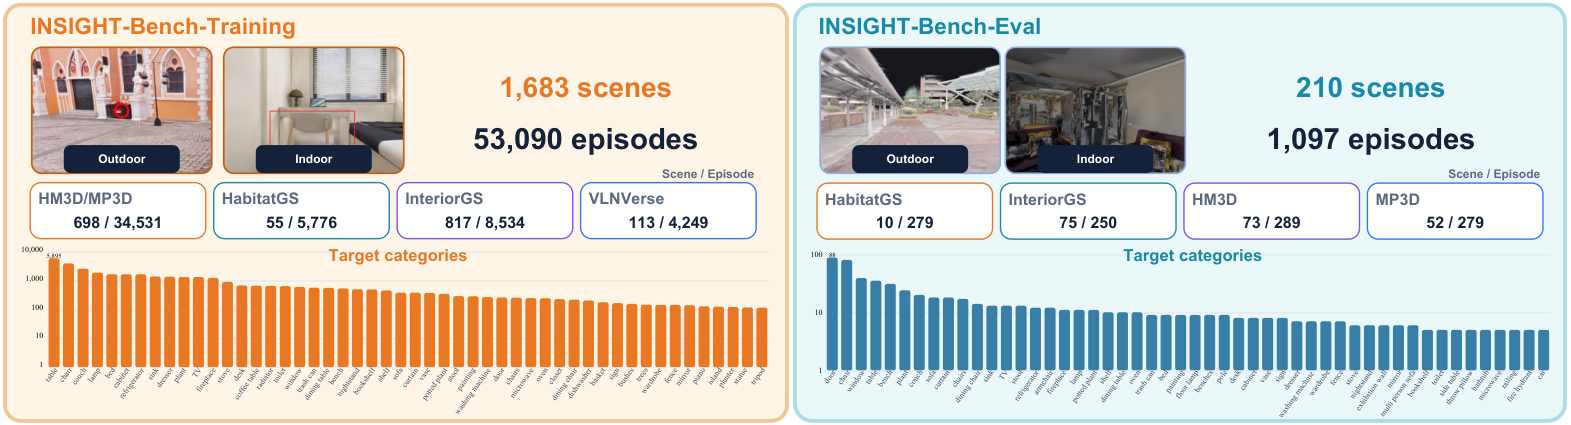
INSIGHT-Bench是这条流水线切出来的一块,不是全部2000多个场景。训练1683个场景、53090条回合,评测210个场景、1097条,两边场景完全不重叠。HM3D和MP3D贡献698个训练场景、34531条回合。InteriorGS场景最多,817个训练场景只产出8534条。Habitat-GS只有55个训练场景、10个评测场景。
评测还按功能和布局切了五类场景,公寓、住宅、商业、机构和户外。指令按几何证明分成五类,直接点名、方向、关系、极值和序数。标签跟目标的生成过程走。
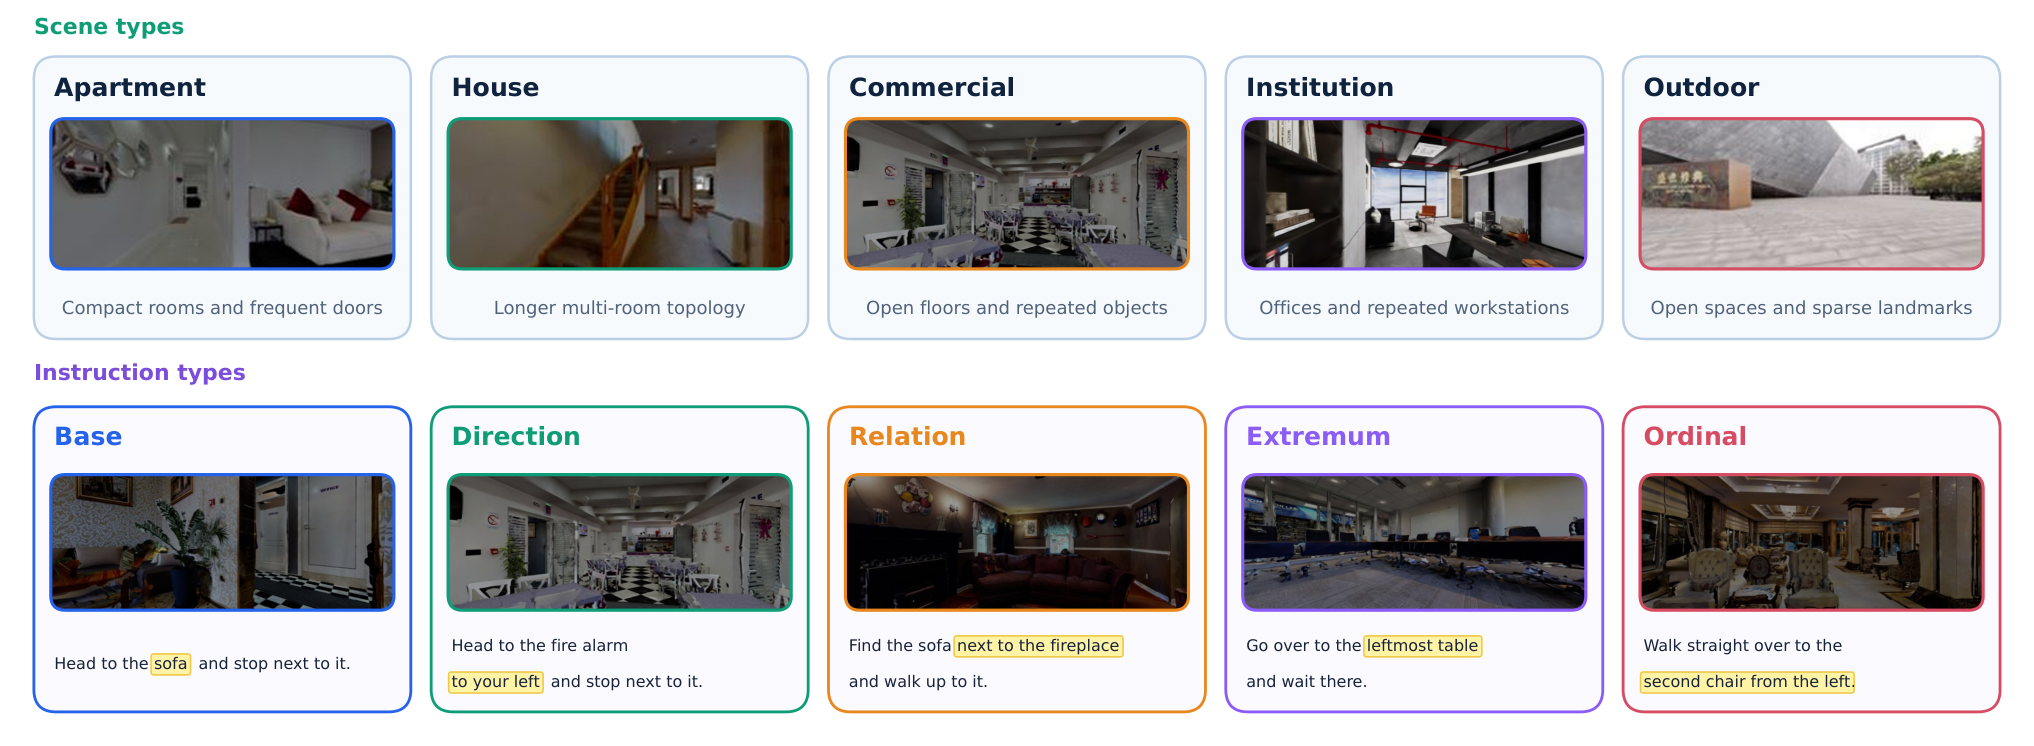
评测集里公寓120个场景239条,住宅61个场景216条。商业只有10个场景,回合却有195条。机构和户外场景更少,分别11个和8个,回合数到219和228。训练侧每个场景平均31.5条,评测侧平均5.2条。
五、10项导航仿真单目成功率第一
先把几个能说明数据引擎好坏的数字放在一起。十条公开仿真设定上,LightNav-0的单目成功率都是第一,下面只挑和场景覆盖、路径质量直接相关的项。
| 设置 | LightNav-0 | 对照 |
|---|---|---|
| VLN-CE R2R成功率 | 68.5 | 单目Qwen-RobotNav-4B为66.9,全景8B为72.1 |
| VLN-CE RxR的nDTW | 67.4 | DualVLN为70.0 |
| INSIGHT-Bench成功率 | 43.7 | JanusVLN为27.4 |
| INSIGHT户外成功率 | 34.2 | JanusVLN为16.7 |
| 机构场景碰上极值指令 | 18.0 | 未报告分格对照 |
| EVT-Bench分心跟踪成功率 | 82.6 | 单目ReferTrack为73.3,全景CoMaTrack为74.2 |
R2R相对最强单目前辈,成功率从66.9到68.5。户外那项更贴数据引擎,INSIGHT-Bench从JanusVLN的16.7拉到34.2,报告把原因写在训练里加了户外三维高斯轨迹。公开对照几乎都在室内Habitat里训。
输的地方也硬。RxR的nDTW是67.4,DualVLN是70.0,到了终点但路线不够贴。全景方法在R2R上还有72.1。机构大空间里要找最左、最近那种目标,成功率掉到18.0%。真机只有定性演示,没有成功率。
六、本地部署与推理实践
权重在Hugging Face上,协议Apache 2.0。以下命令来自GitHub README。模型卡上的安装命令指向lightrobo/LightNav-0,和仓库主页lightorigins不一致,这里按README。
git clone https://github.com/lightorigins/LightNav-0.git && cd LightNav-0
python3.11 -m venv .venv && source .venv/bin/activate
pip install -e ".[vllm,video]"
hf download LightOriginsHQ/LightNav-0 --local-dir checkpoints/LightNav-0
lightnav-predict --model_path checkpoints/LightNav-0 \
    --backend vllm_local --video clip.mp4 --fps 4 \
    --instruction "follow the person in the red shirt"
fps设成4,和模型卡写的训练输入一致,分辨率256乘448。这条示例走的是跟踪提示。仓库还提供lightnav-serve,--task tracking或vln起WebSocket服务,真机和MuJoCo演示都走同一套客户端协议。Habitat评测和部署说明在仓库docs/里。
七、总结与思考
Real2Sim2Real值钱的地方,是一条回合里语言、画面、指点和动作必须说同一件事。场景捕获一次,目标、路线、视角、指令可以反复组合。这才解释得了扩环境比扩小时更有效。
导航比操作更早吃到视觉语言模型的空间先验,我看就是输出停在图像平面和可通行空间里,预训练里本来就有。操作还要过接触这一关,报告没提供那部分监督,这条经验不能直接搬。
短板也明白。仿真榜单的单目第一,挡不住全景方法在R2R上更高,也挡不住机构大空间里左右最值仍然容易指错。8B相对4B互有涨跌,加参数帮不上忙。真机跨本体目前是视频,不是数字。数据引擎证明场景可以规模化,还没证明物理世界已经规模化。
参考链接
- 技术报告原文 arXiv 2608.30935 v2,v1于2026年8月,v2于2026年9月,HTML版
- 官方博客 Introducing LightNav-0
- 代码仓库 lightorigins/LightNav-0
- 模型权重与模型卡示例 LightOriginsHQ/LightNav-0
- 评测集 lightorigins/Light-INSIGHT-Bench
- 对比方案 Qwen-RobotNav技术报告、DualVLN、Uni-NaVid(RSS 2025)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 1
 0
- 0


 已为社区贡献13条内容

所有评论(0)