AI训练数据开始“上货架”了:数据标注公司的下一单,可能不再等客户发需求
做了十几年数据标注,我们一直习惯一种生意模式:客户先来找你。
“这里有100万张图片,能不能标?”
“有5万小时语音,多少钱一个小时?”
“机器人数据要采3个月,你们能不能组织人?”
然后数据标注公司开始算:需要多少人、多少台电脑、一天能做多少、最后能赚多少钱。
客户先有需求,我们再组织生产。
这套模式,我一直把它理解成数据标注行业的“来料加工”。
但这几天,我看到一个挺有意思的变化:AI训练数据,开始被直接摆到“货架”上卖了。
8月16日,艺恩数据市场正式上线,首批34个成品数据集公开上架,覆盖具身本体/Ego、视频、社媒、电商和文本语料等类别。
客户可以直接查看数据集规格、标注字段、样例结构和授权说明,还可以申请样例测试。这件事情本身可能不算特别大的新闻。
但我觉得,它背后可能藏着数据标注行业下一轮商业模式的变化。
一、做了十几年数据标注本质上是在做来料加工
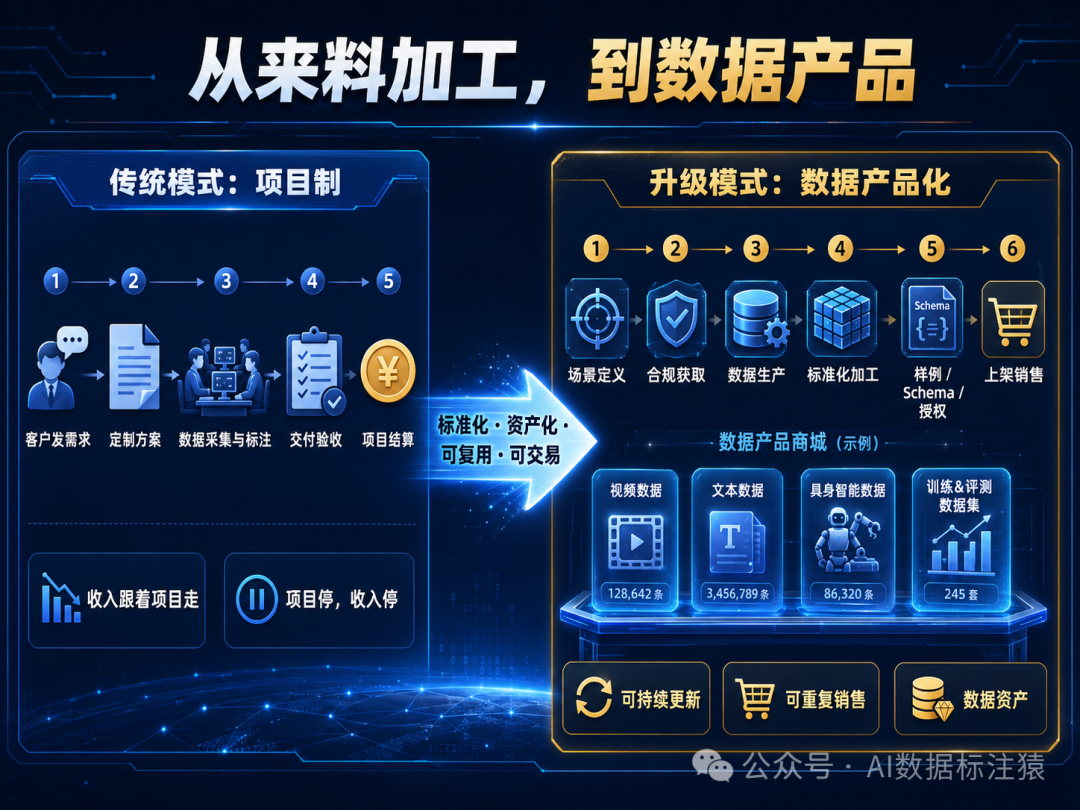
传统的数据标注项目,非常像代工厂。
客户提供原材料:图片、视频、语音、文本。
客户再提供生产标准:怎么画框、怎么分类、怎么审核、准确率达到多少。
数据标注公司负责什么?
招人、培训、管理、生产、质检,然后按照条、帧、小时或者人天结算。
-
一帧5毛钱。
-
一条2毛钱。
-
一个有效小时70块钱。
业务模型非常清楚:人干了多少活,公司就收多少钱。
但这种模式有一个很明显的问题:
- 项目来了,公司才有收入;
- 项目结束,人员就要释放;
- 下一个项目来了,又要重新招聘和培训;
而且同样的数据交付以后,通常跟供应商也没有什么关系了。
公司每一年都在重复建设产能,却很难沉淀真正能够反复产生收入的东西。
所以很多数据标注公司做了五年、十年,回过头看,最大的资产还是:几百名员工、一些客户关系和一套项目管理经验。
项目一停,收入也跟着停。
二、数据一旦被摆上货架,逻辑就不一样了
这次我最关注的,不是34个数据集到底有多少条数据。
而是几个变化。
第一,数据是在客户提出具体需求之前,就已经生产好了。
第二,数据开始有标准化的Schema、字段定义、样例和交付格式。
第三,客户可以先看样例,再决定买不买。
第四,数据来源、授权和合规开始成为产品的一部分。
这已经很像我们买软件、买数据库甚至买商品了。
艺恩目前公开展示的数据中,已经出现家庭Ego操作数据、视频理解数据、社媒数据等产品,并强调RLDS等标准化交付形式。
这意味着:
以前客户的问题是:“你能不能帮我生产这批数据?”
以后客户的问题可能变成:“你现在有什么数据可以直接给我用?”
看起来只换了一句话,背后的商业逻辑完全不同。
一个是项目。
一个是产品。
三、标注公司的下一步不是多接几个项目
如果这个趋势成立,数据公司的核心能力也会发生变化。
过去,我们最关心的是产能。
客户来了10万条数据,我能不能两周交完?
以后更重要的问题可能变成:什么数据值得提前生产?
比如一家机器人公司已经拥有几十万次普通抓取数据。
你继续帮它采机器人抓杯子、拿盒子,当然还能卖钱。
但真正值钱的,可能已经变成:
-
透明物体怎么抓;
-
软包装怎么抓;
-
抓取失败以后怎么恢复;
-
有人突然进入机器人工作区域怎么办;
-
换一个工厂以后模型还能不能完成任务。
这时候,数据公司不能只等客户把SOP写完以后交给你。
你必须开始理解:
-
模型到底缺什么?
-
哪些数据已经严重重复?
-
哪些长尾数据最有价值?
-
哪一批数据加入训练以后,模型能力能够真正提升?
这其实意味着一个很大的角色变化:数据标注公司开始从“执行需求”,走向“定义数据需求”。
这一步,比多招100个标注员难得多。
四、未来数据公司可能出现三种生意
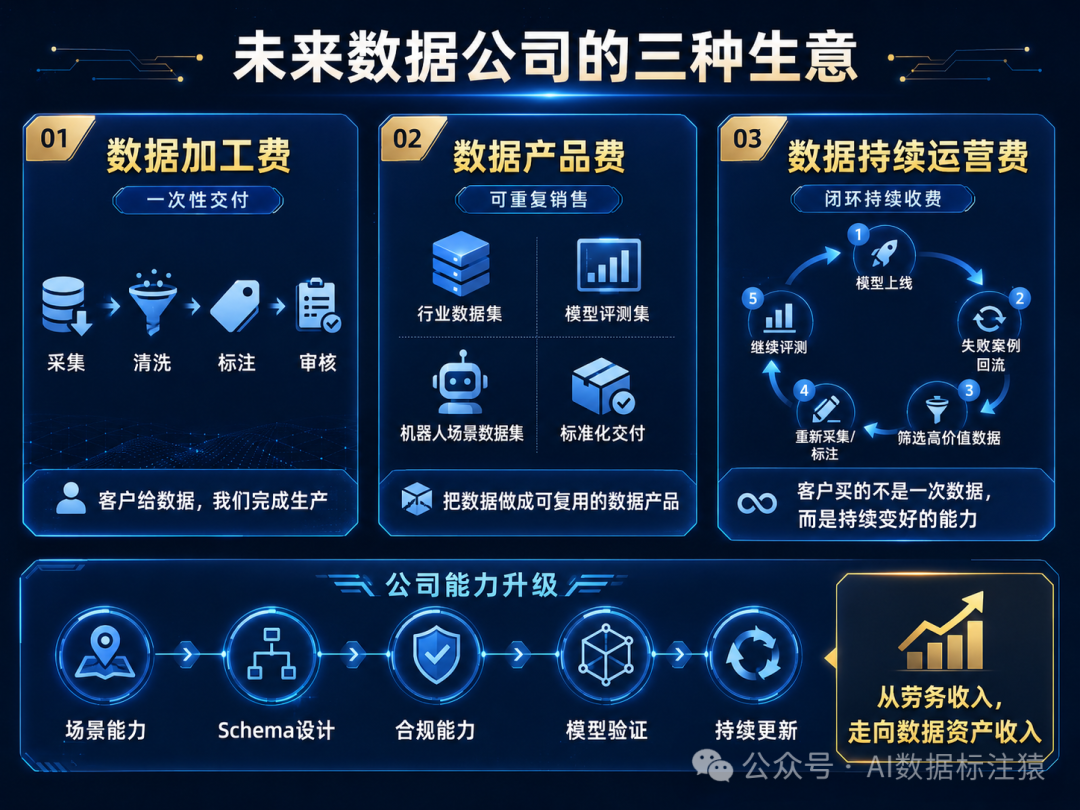
我越来越觉得,未来数据服务可能会明显分成三个层级。
第一层:数据加工费。
客户给数据,我们采集、清洗、标注、审核。
做一次,结算一次。
这是劳务型收入。
第二层:数据产品费。
自己建设行业数据集、模型评测集、机器人场景数据集。
一套数据经过合法授权和标准化加工以后,可以面向不同客户提供。
这是数据资产型收入。
第三层:数据持续运营费。
模型上线以后不断产生失败案例;
失败案例回流;
再筛选高价值数据;
重新采集、标注和训练;
最后继续评测模型。
8月17日,觅蜂科技宣布完成新一轮数亿元融资,资金用途就包括建设具身智能数据“平台型供给”基础设施,并强化数据采集、治理和闭环评测能力。
我认为“闭环”这两个字,比“融资数亿元”更值得数据标注公司关注。
因为它意味着:数据交付结束,可能不是项目结束,而是下一轮数据生产刚刚开始。
五、但把数据变成产品没有想象中那么简单
看到这里,千万别理解成:赶紧把以前做过的客户数据留下来,以后拿出去卖。
这是完全错误的。
数据产品真正最大的门槛,首先不是标注能力,而是:你有没有权利卖。
-
数据从哪里来的?
-
采集对象是否授权?
-
是否包含个人信息?
-
客户项目里的数据能不能二次使用?
-
知识产权属于谁?
-
能不能用于商业训练?
-
能不能跨客户销售?
这些问题不解决,硬盘里存了100TB数据,也不代表拥有100TB数据资产。
除此之外,还要解决:
-
数据是否标准化、是否有版本、Schema是否清楚;
-
质量如何证明、能不能直接进入模型训练;
-
买完以后模型效果有没有提升。
所以,真正的数据产品公司,本质上也不是“囤数据”的公司。
而是能够完成:场景定义 + 合规获取 + 数据生产 + 标准化加工 + 模型验证的一家公司。
六、普通数据标注公司现在应该做什么?
我不认为大多数数据标注公司现在就应该去建设一个“数据交易市场”。
那太早了。
但至少可以开始改变四件事情。
第一,不要只记录一个项目赚了多少钱,要开始沉淀场景能力。
你做过自动驾驶,就要知道什么数据最难;
做过大模型,就要知道什么任务需要专家;
做过具身智能,就要知道哪些场景的数据最稀缺。
第二,开始积累Schema和数据标准设计能力。
未来客户付钱的,不只是标注动作,还有你定义数据结构的能力。
第三,补上合规能力。
数据来源和授权链路,很可能成为未来数据产品最重要的护城河之一。
第四,开始理解模型验证。
一批数据到底值多少钱,最后不能只看标注准确率。
更重要的是:它进入训练以后,让模型提高了多少。
写在最后
过去十几年,数据标注行业一直在卖一件东西:
人干了多少活。
一帧多少钱,一条多少钱,一个小时多少钱。
所以大家最关心的是:
-
哪里还有项目?
-
谁手里有甲方?
-
现在还能不能找到100个人?
但当AI训练数据开始被标准化、被展示、被试用,甚至被直接摆到货架上的时候,我觉得这个行业真正值钱的东西开始发生变化了。
未来最好的数据公司,不一定拥有最多的标注员。
它可能拥有的是:最多的、合法的、标准化的、模型真正需要的数据产品。
所以数据标注行业的下一场竞争,也许不是把一个框再便宜一分钱。
而是谁先完成这一步:
从等客户发项目,到主动生产数据产品。
从“来料加工”,走向“数据资产”。
我是AI数据标注猿刘吉。
跟着我,用数据视角看AI世界。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 3
 0
- 0


 已为社区贡献14条内容

所有评论(0)