为什么原有终端监控平台终端显示在线,可审计日志却大量缺失不全?怎么监控电脑?
一、现象描述:故障是什么、触发场景
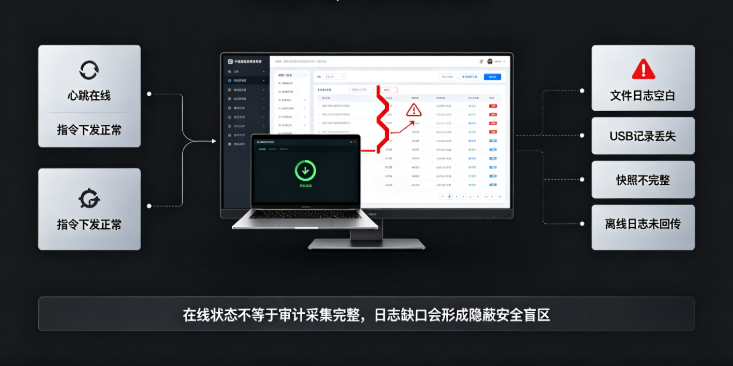
企业早期部署一套终端监控工具,用来监控电脑的文件操作、外设插拔、程序运行、打印、剪贴板等行为,运维工作中出现一类高频疑难故障: 原有管理平台终端心跳状态判定为在线,简单配置指令可以正常下发;但审计模块无法拿到完整行为记录,文件操作日志、USB 拷贝记录、窗口访问记录大面积空白,部分时间段无任何数据,屏幕快照、外设事件经常丢失。
二、故障典型特征
-
并非全部终端异常,集中出现在部分工位、跨 VLAN 终端,同网段少量设备采集正常。
-
内网 ping 服务器 IP 正常,心跳端口 telnet 连通;手动触发日志同步,持续上报超时。
-
业务工作时间故障加重,夜间低负载偶然回传少量历史日志。
-
对原有客户端重装修复,仅维持 1‑3 天正常,故障反复复现。
-
外勤笔记本断网外出,回到内网之后,离线期间产生的操作记录完全无法同步回原有管理后台。
触发场景:多 VLAN 复杂内网环境、笔记本频繁切换内外网、原有服务器 IO 性能瓶颈、终端本地磁盘空间不足。
业务风险:运维主观认为监控能力已经生效,一旦发生文件拷贝、资料外发行为,没有完整审计证据支撑事件溯源,监控体系实际形成安全盲区。
三、排查思路:从浅到深定位逻辑
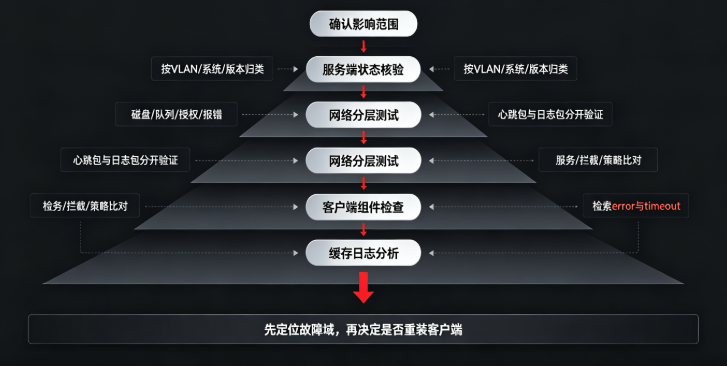
按照故障范围确认→服务端检查→网络层验证→原有客户端核查→缓存日志分析的顺序开展排查,不优先选择重装客户端这种治标不治本的手段。
-
确认故障影响范围 统计故障属于单台、一批次还是全部终端,梳理故障终端所属 VLAN、交换机、操作系统版本,区分单点故障还是环境策略类问题。
-
原有服务端基础状态核验 核查磁盘剩余容量、数据库消息队列、授权数量,确认是否出现接收队列溢出;查看系统日志,统计终端上报报错频次。
-
网络分层连通性测试 分开测试小包心跳报文与大容量日志上报报文。环境中心跳小包可以放行,但防火墙、ACL、流控策略拦截大体积批量上报数据包,造成 “终端在线,日志不传” 的假象。
-
原有客户端状态核验 登录故障终端,核查客户端服务运行状态,是否被其他安全软件拦截组件;查看本地缓存目录,确认本地是否已经生成行为日志,只是无法上传后台。
-
版本、策略模板对比 将故障终端和采集正常终端做比对,核对客户端版本、缓存阈值、离线缓存策略配置差异。
-
导出客户端本地运行日志,检索 error、timeout 关键字,定位上报失败报错信息。
四、根因分析:找到问题根源
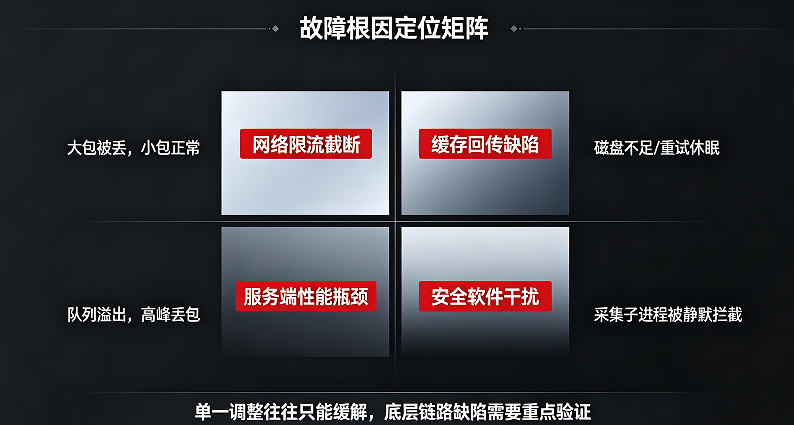
经过多轮现场排障,原有软件故障主要由四点叠加造成:
-
批量上报报文容易被网络设备限流截断 原有软件的日志上报模块对大报文分片处理能力较弱。防火墙、核心交换机允许心跳小包通行,批量审计日志数据包直接被丢弃。终端心跳握手维持在线状态,日志上报持续超时。外勤设备回网大批量同步离线缓存日志时,该问题会进一步放大。
-
原有软件离线缓存‑回传机制存在设计缺陷 终端脱离内网后,行为日志保存本地,待网络恢复批量上传。
-
终端磁盘空间不足时,原有程序缺少保护逻辑,缓存日志直接丢失;
-
上报多次超时后,原有客户端直接进入休眠,不会自动重试存量缓存,只有重启客户端才会重新执行上传。
-
原有服务端接收性能存在瓶颈 上班高峰期大量终端集中上报审计数据,数据库写入、磁盘 IO 压力过载,接收队列溢出,上报数据包直接丢弃,后台无对应记录。原有产品缺少错峰上报、队列削峰的相关能力。
-
原有客户端多组件容易被安全软件干扰 原有程序采集模块依赖多个子进程协同工作,部分杀毒、EDR 会拦截采集子进程,心跳主进程依旧存活显示在线,但文件、剪贴板、外设相关事件完全无法采集。
补充误区:部分管理员误解监控电脑需要不间断全量屏幕录像,采集间隔设置过大导致日志稀疏属于配置问题,不属于软件本身故障。
五、解决方案:修复步骤与替换落地
前期尝试过调优防火墙策略、扩容服务器存储、加入杀毒白名单、升级原有软件至最新版本,问题只能短暂缓解,底层机制缺陷无法彻底修复,故障依旧反复复现。 综合业务现状,最终决定替换部署域智盾软件,完整解决该类问题,落地操作如下:
步骤 1:环境前期评估
梳理全网终端操作系统,包含 Windows、信创、macOS 外勤笔记本,统计终端数量,规划服务器磁盘存储,评估跨 VLAN 网络端口放行策略。
步骤 2:分批客户端迁移部署
采用灰度上线,优先对故障频发工位安装新客户端;新旧客户端并行短暂过渡,完成业务验证之后,卸载旧版监控程序。
新客户端内置优化后的离线缓存逻辑,磁盘空间不足会做告警提示;多次上报失败具备自动重试机制,外勤笔记本接入内网自动同步离线阶段全部操作日志。同时将客户端目录、进程加入终端杀毒信任列表,避免采集组件被拦截。
步骤 3:服务端策略配置
在管理后台配置缓存上限、错峰上报策略,避免业务高峰瞬间产生海量上报压力;开启日志本地缓存保护,防止日志被新数据覆盖。支持手动触发日志同步,方便运维调试排查。
步骤 4:功能验证
选取故障复现较高的笔记本,模拟跨 VLAN 访问、断网离线办公、重新接入内网等场景,执行 U 盘拷贝、文件修改、打印操作,核验后台是否完整采集全部审计记录。
步骤 5:应急兜底
迁移过渡阶段,保留终端本地缓存日志导出能力,出现安全事件可直接读取本地缓存作为取证材料。
六、预防方案:如何避免后续再次出现同类问题
-
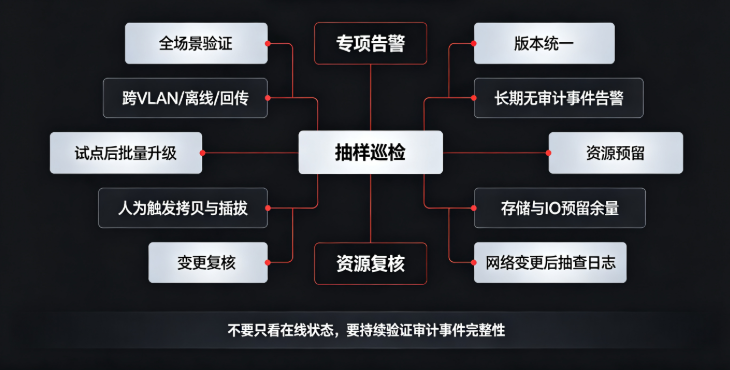
上线全场景验证 部署终端监控,不可仅测试内网在线场景,必须模拟跨 VLAN、离线外勤、回网同步整套流程,验证缓存、上报链路可靠性。
-
配置专项告警 启用 “终端长期无审计事件” 告警,不只是简单的上下线告警,及时发现采集异常的终端,跳出 “在线即正常” 的思维误区。
-
统一客户端版本管理 全网保持客户端版本一致,新版本上线前小批量试点,再批量推送。
-
定期抽样巡检 运维定期抽样不同网段、外勤笔记本,人为执行文件拷贝、外设插拔,核对后台审计记录完整性,不能仅看终端在线状态。
-
服务器资源预留 结合终端数量规划存储、IO 资源,预留性能余量,防止高峰队列溢出。
-
网络变更联动检查 防火墙、ACL 策略调整之后,同步抽查审计日志上报情况,网络策略改动是上报故障高频诱因。
七、复盘总结
很多企业在做终端监控、思考怎么监控电脑时,只关注客户端安装、平台在线状态,忽略心跳在线不等于审计采集正常,原有软件底层机制缺陷会制造隐蔽的安全盲区。
本次排障过程中,网络调优、服务器扩容只能做临时缓解,原有软件离线缓存、报文处理的底层短板无法通过配置修复。更换域智盾软件之后,依靠优化后的离线缓存、报文上报、多组件抗干扰设计,彻底解决终端在线但日志缺失的顽疾。
同时也要意识到,无论使用哪一套终端监控产品,都不能只依赖平台的在线离线状态,离线外勤终端缓存回传场景极易被忽视,需要纳入常态化测试巡检,技术工具搭配运维流程,才能保障监控审计能力持续可用。
本文基于真实内网运维排障经验、公开终端安全行业报告编写,仅作为故障排查技术科普,不构成选型实施建议。
责编:璇玑

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)