02 基础 —— AI Agent 全景图
AI Agent 的能力上限 = 模型能力 × 数据质量 + 流程编排。
- 乘号(Data × LLM):决定能力的基础量级,是核心驱动力
- 加号(+ 流程编排):在基础之上的优化增量,是锦上添花
一、从 ChatGPT 到 Agent
1. 传统大模型助手的局限
-
每次对话都是从零开始:没有记忆。
-
无法访问你的数据:没有知识库。
-
只能对话,不能执行:没有工具调用能力。
-
本质上是 无状态的对话机器人。
2. AI Agent 的突破
AI Agent 不只是“更聪明的 ChatGPT”,而是一个具备 感知 → 推理 → 行动 循环的系统。它能:
-
查资料(RAG):检索外部知识库,避免幻觉。
-
记住你(Memory):跨对话保存偏好和上下文。
-
调用工具(Skill):执行任务,而不仅仅是回答。
-
连接外部世界(MCP):与应用、系统、数据源交互。
3. 核心洞察
-
Agent 的价值不在于“更聪明”,而在于 突破无状态限制。
-
它通过 数据 + 工具 +记忆,让 AI 从“对话机器人”升级为“行动系统”。
二、Agent 的本质:感知 → 推理 → 行动
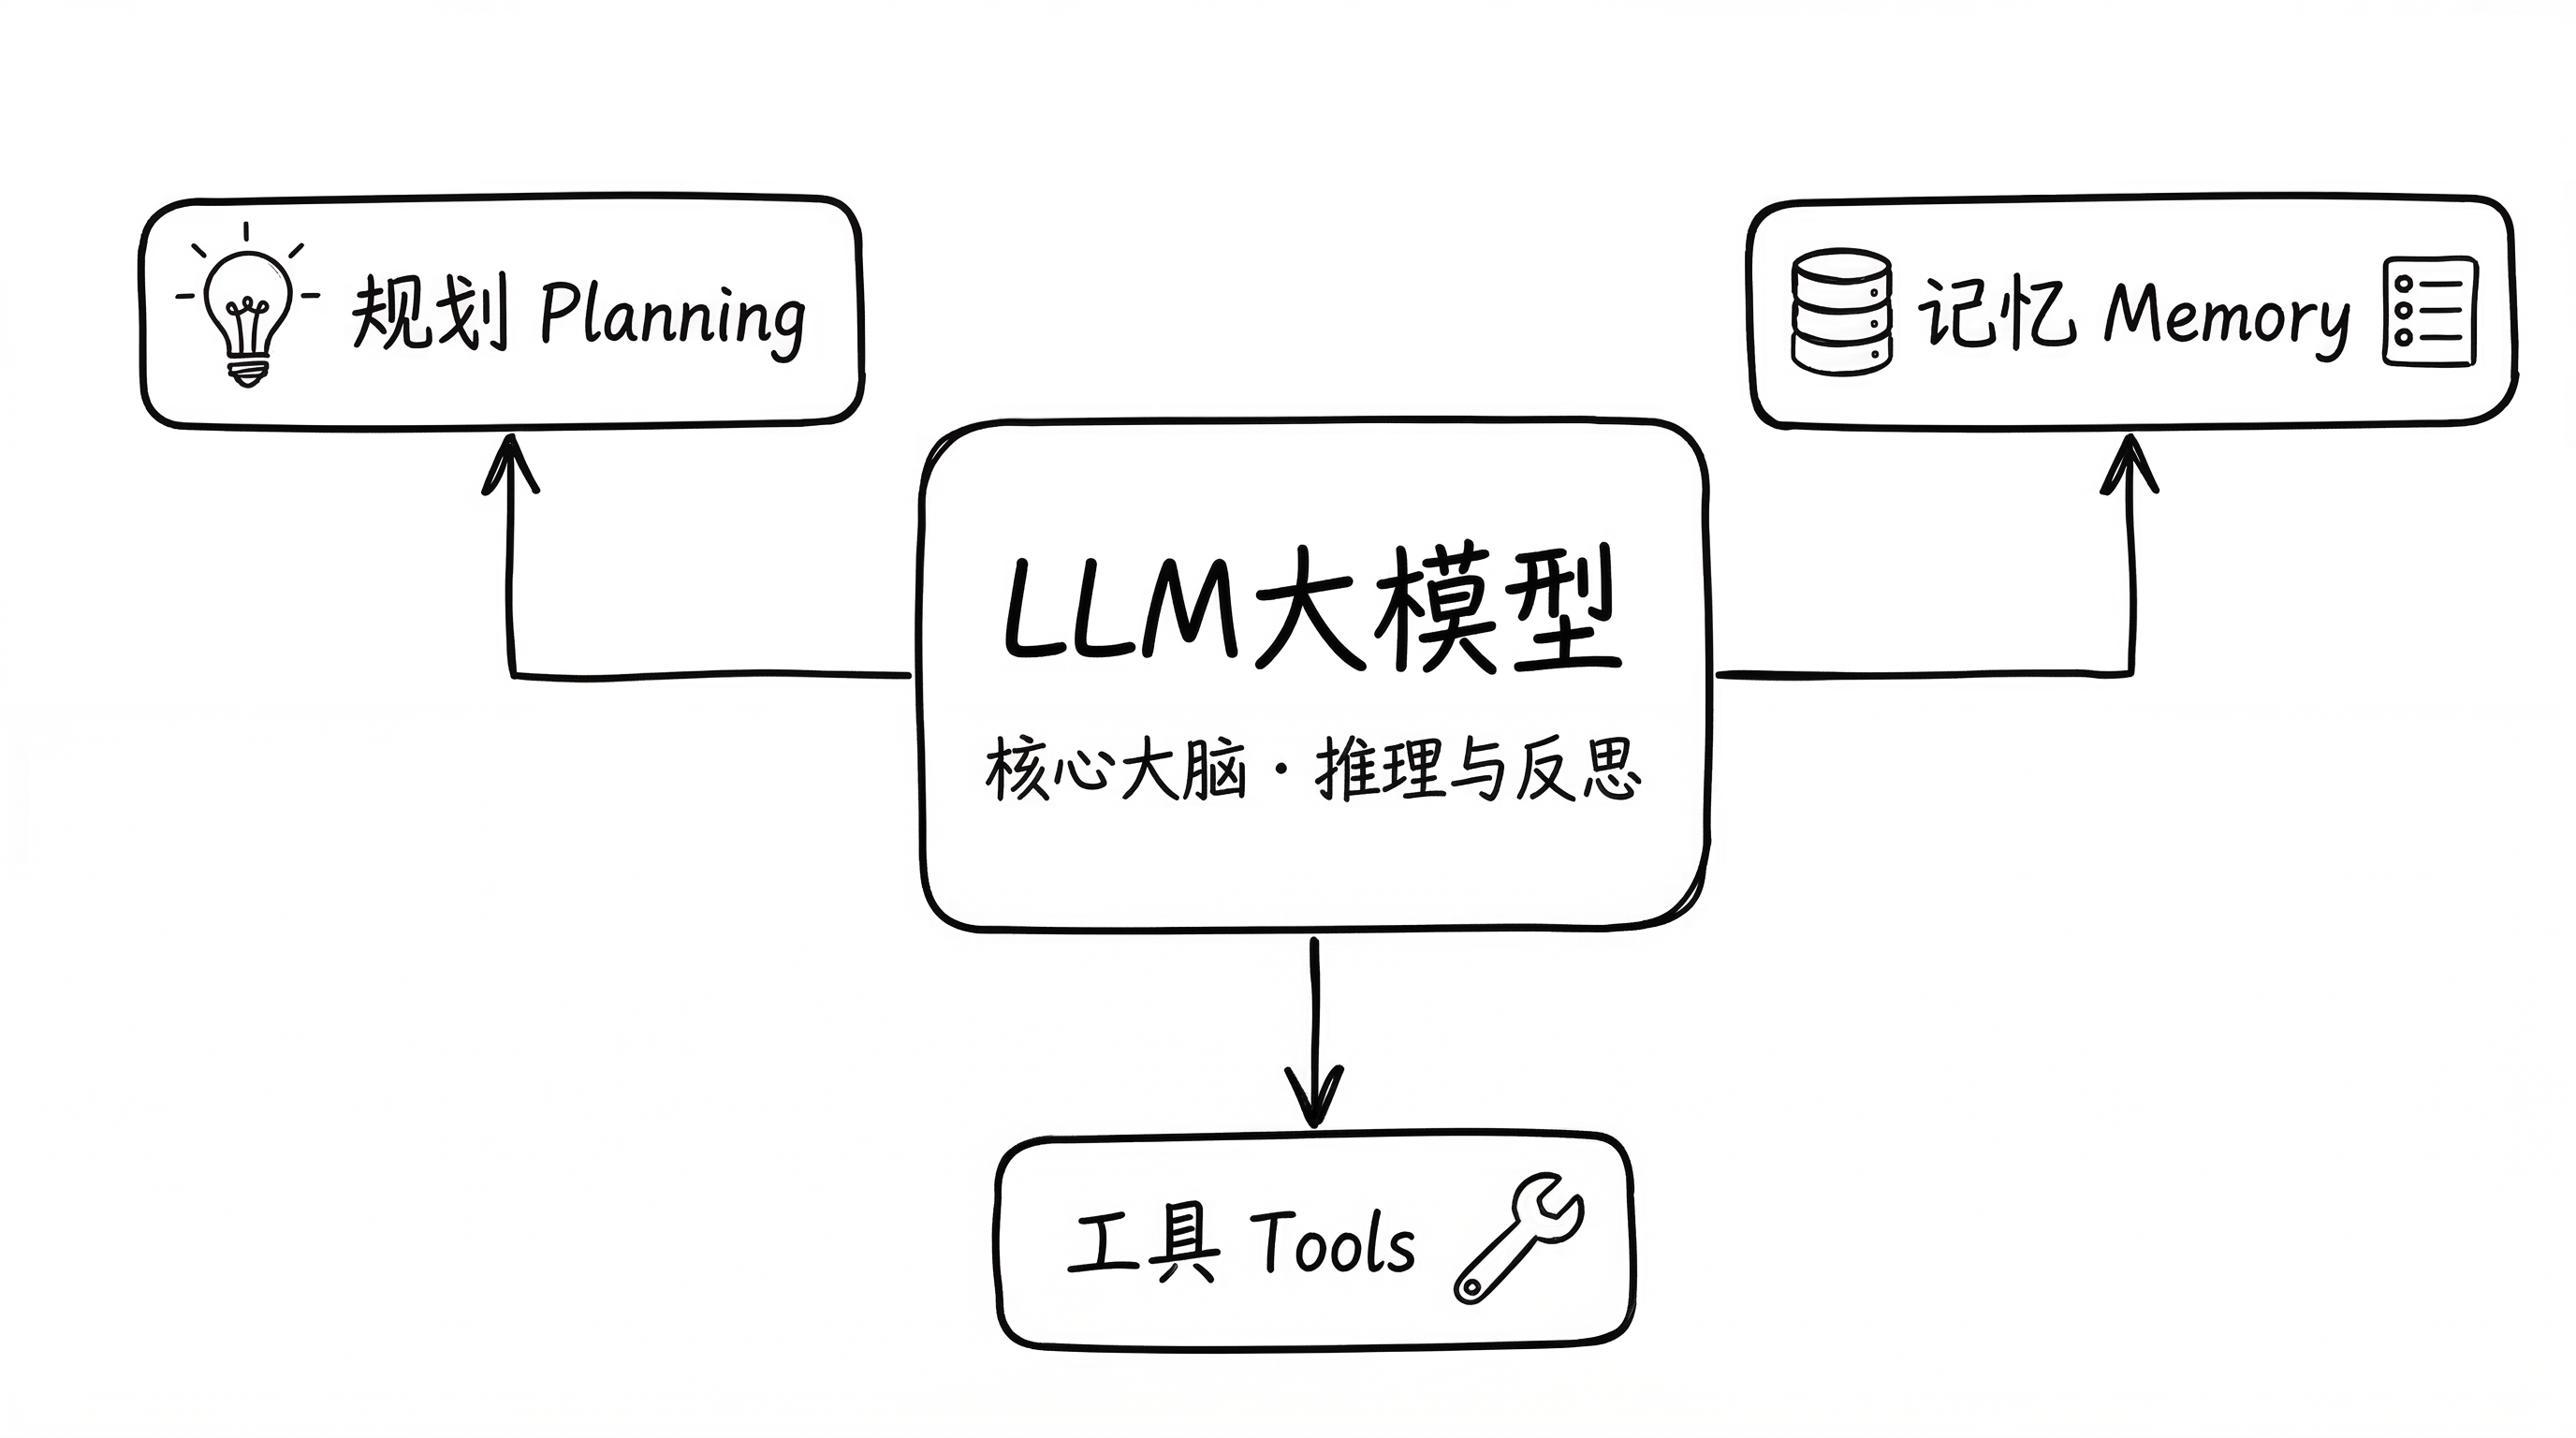
核心架构包含四个组件:
- Memory(记忆系统) - 存储与召回历史交互和用户偏好
- LLM(大语言模型) - 作为核心大脑,负责推理与决策
- Planning(规划能力) - 制定任务分解与执行策略
- Tool Use(工具调用) - 连接外部数据源与执行能力
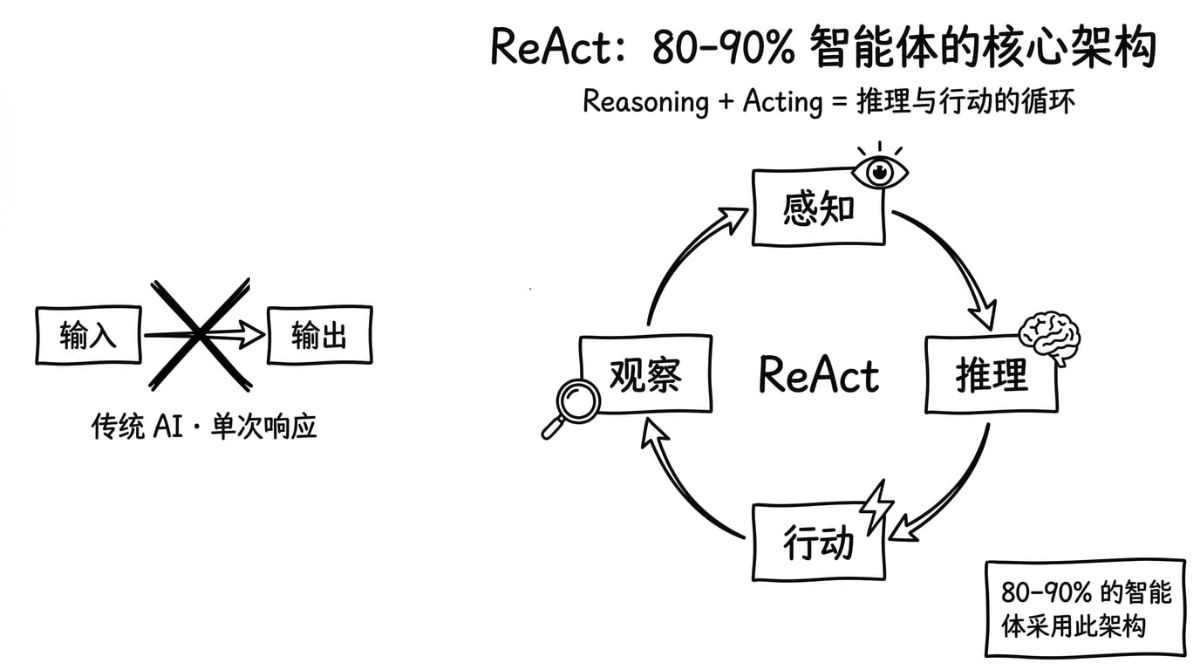
基于以上四个组件,AI Agent 的运行模式是:感知 → 推理 → 行动 → 观察 → 继续推理。
这是一个循环迭代的过程,而非传统 AI 对话的单次响应模式。
eg. 用户说:“帮我查一下上个月的销售数据,并分析增长原因”
Agent 的思考过程:
-
推理:“我需要先查询销售数据”
-
行动:调用数据库查询工具
-
观察:拿到了数据“10 月销售额 100 万,11 月 120 万”
-
推理:“增长了 20%,我需要查一下这期间的营销活动”
-
行动:查询营销记录
-
观察:发现“11 月有双十一促销”
-
推理:“现在信息足够了,可以给出分析”
-
行动:生成最终报告……
看到了吗?Agent 不是一次性生成答案,而是在 “推理-行动-观察” 的循环中逐步完成任务。
这很明显是一个循环迭代的过程,这个推理 - 行动的循环,行业里用得最广泛的架构叫 ReAct。 ReAct 这个词拆开就是 Reasoning + Acting,先推理再行动。
三、主流架构模式
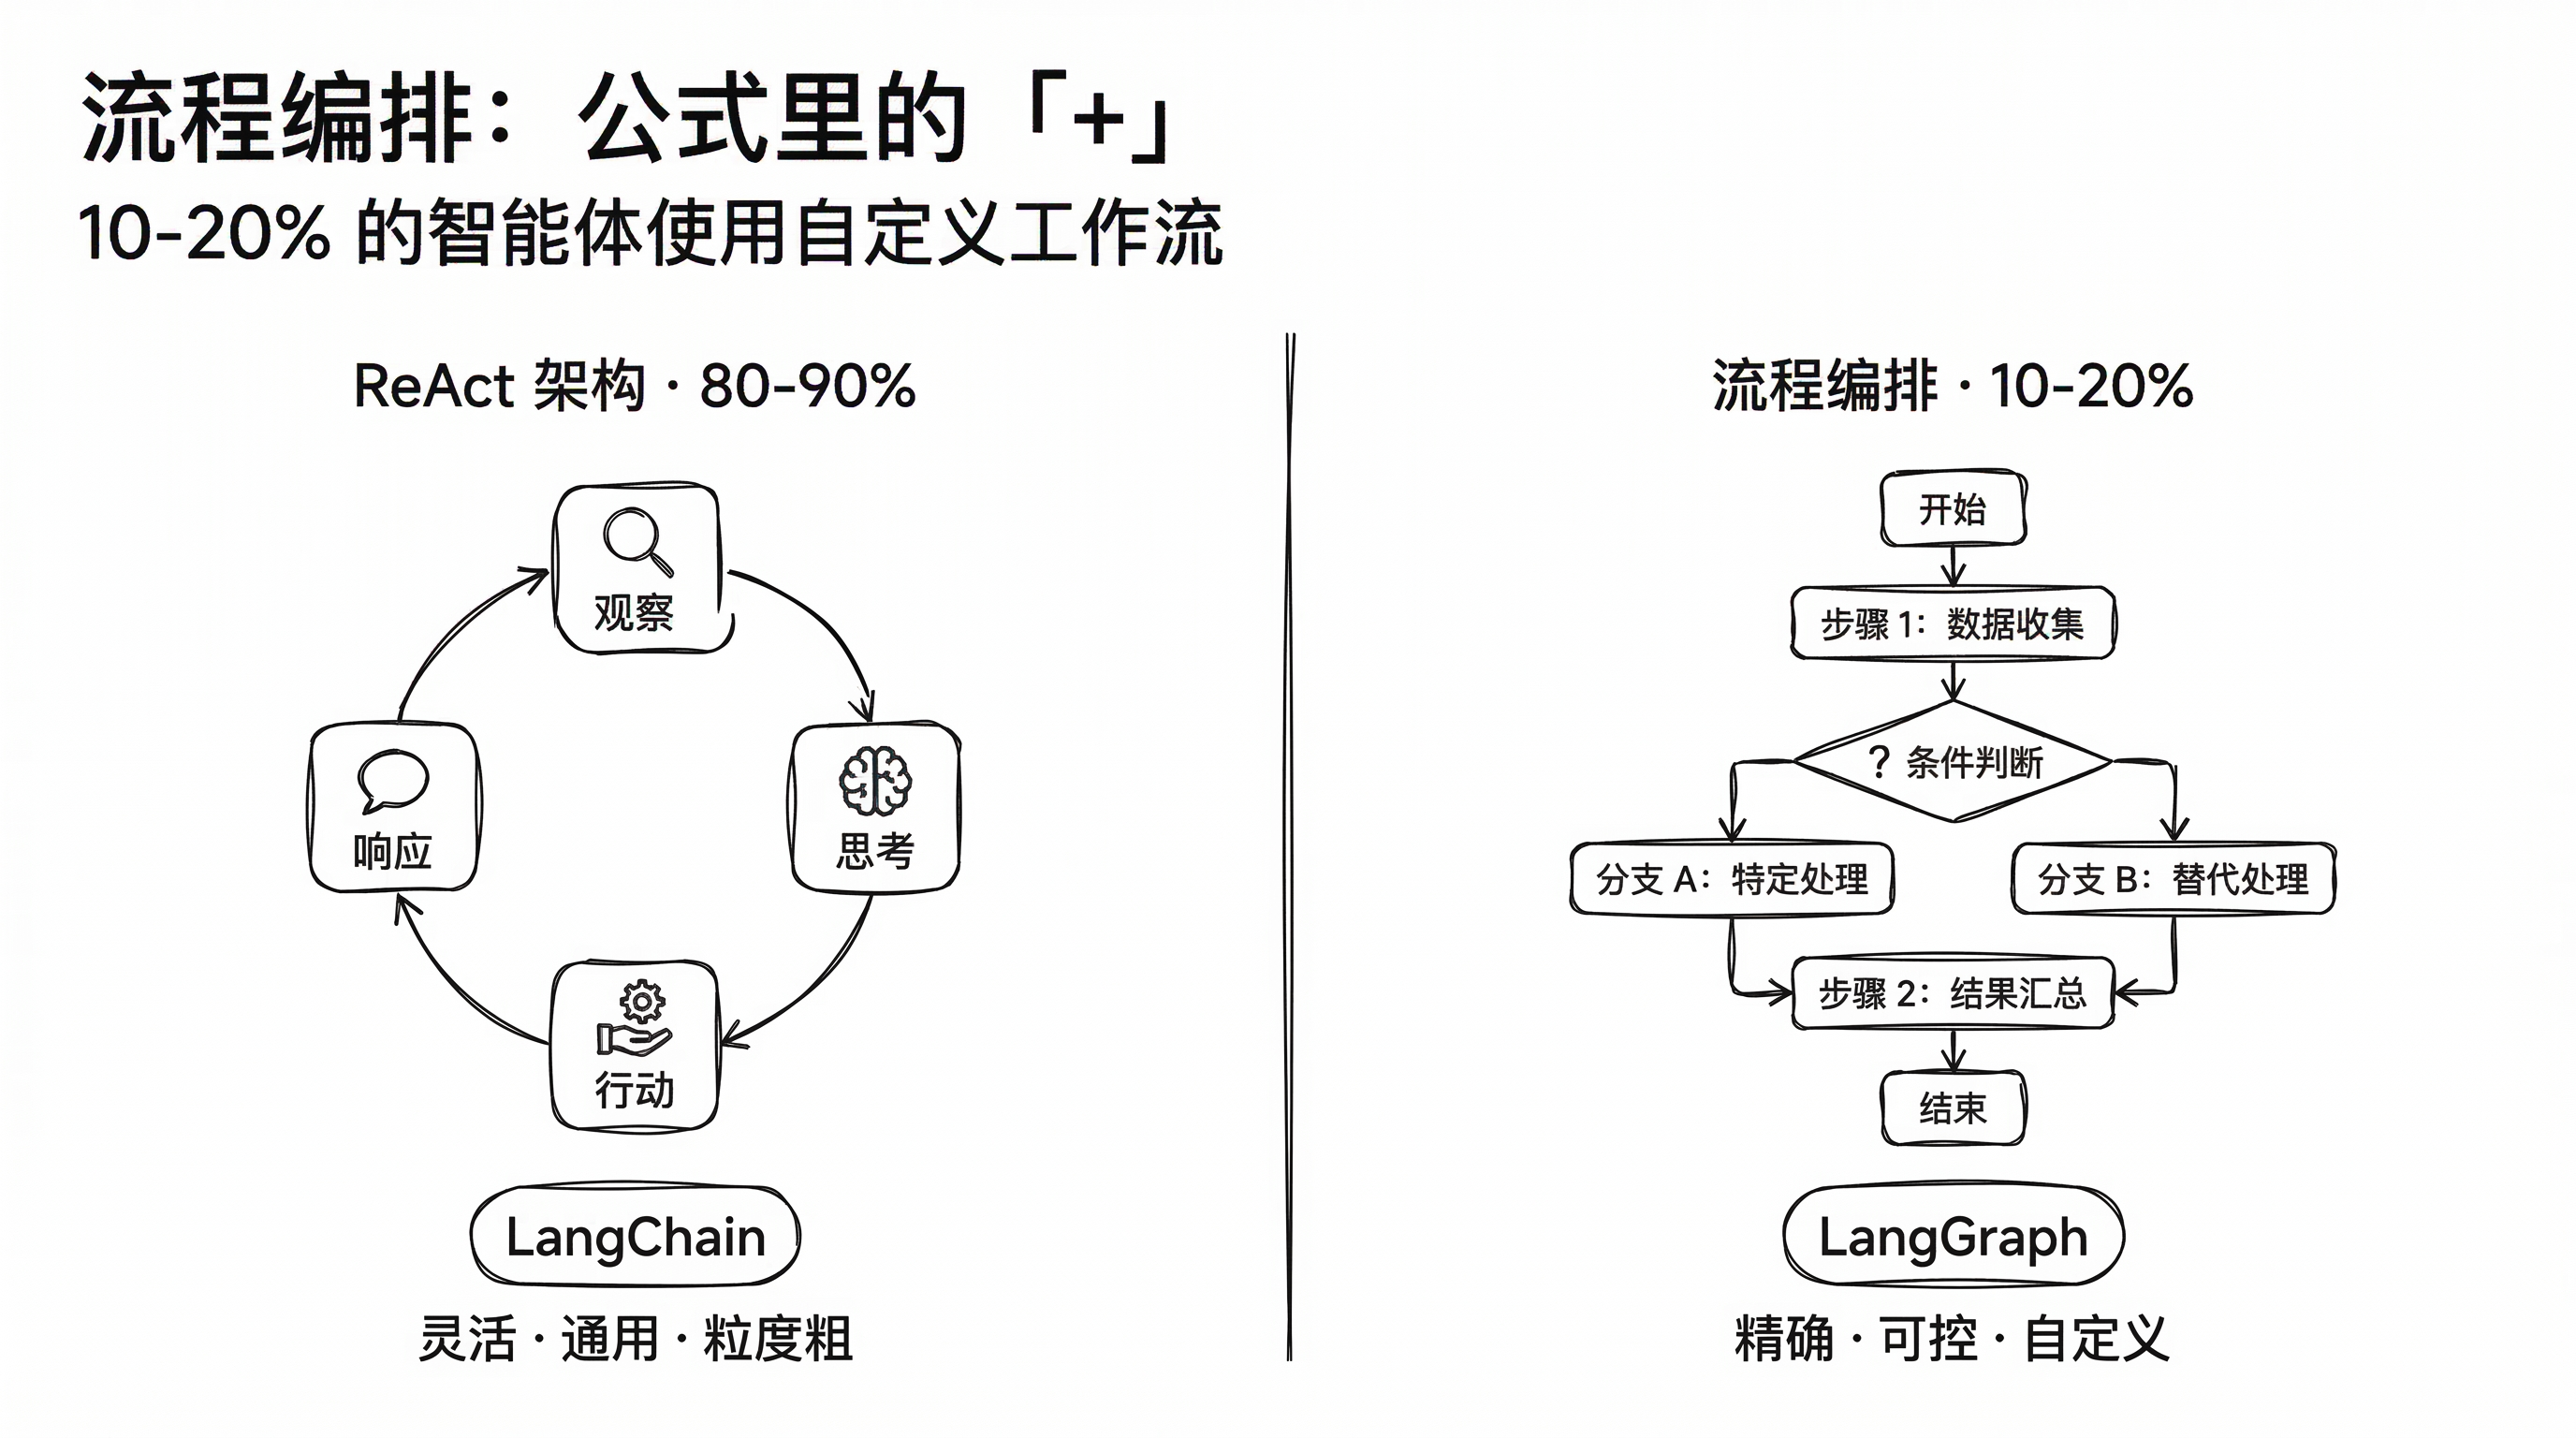
1. ReAct 架构(占比 80% - 90%)
ReAct(Reasoning + Acting)是目前行业最广泛采用的 Agent 架构模式。
核心特点:
- 交替进行推理(Reasoning)与行动(Acting)
- 模型自主决定何时调用工具、何时返回结果
- 灵活性高,适用于开放式任务
代表实现:
- LangChain 的默认 Agent 实现
- OpenAI 的 Function Calling 模式
- 大部分商业 Agent 产品
2. 流程编排架构(占比 10% - 20%)
通过预定义的工作流(Workflow)将多个步骤按特定顺序和条件串联。
核心特点:
- 显式定义节点(Node)与边(Edge)
- 支持条件分支、循环、并行执行
- 可控性强,适用于固定流程任务
代表实现:
- LangGraph (LangChain 的底层编排框架)
- Dify 的工作流模式
- 企业级 RPA + AI 混合方案
四、AI Agent 地图速览 —— RAG / MCP / Skill 分别是什么?
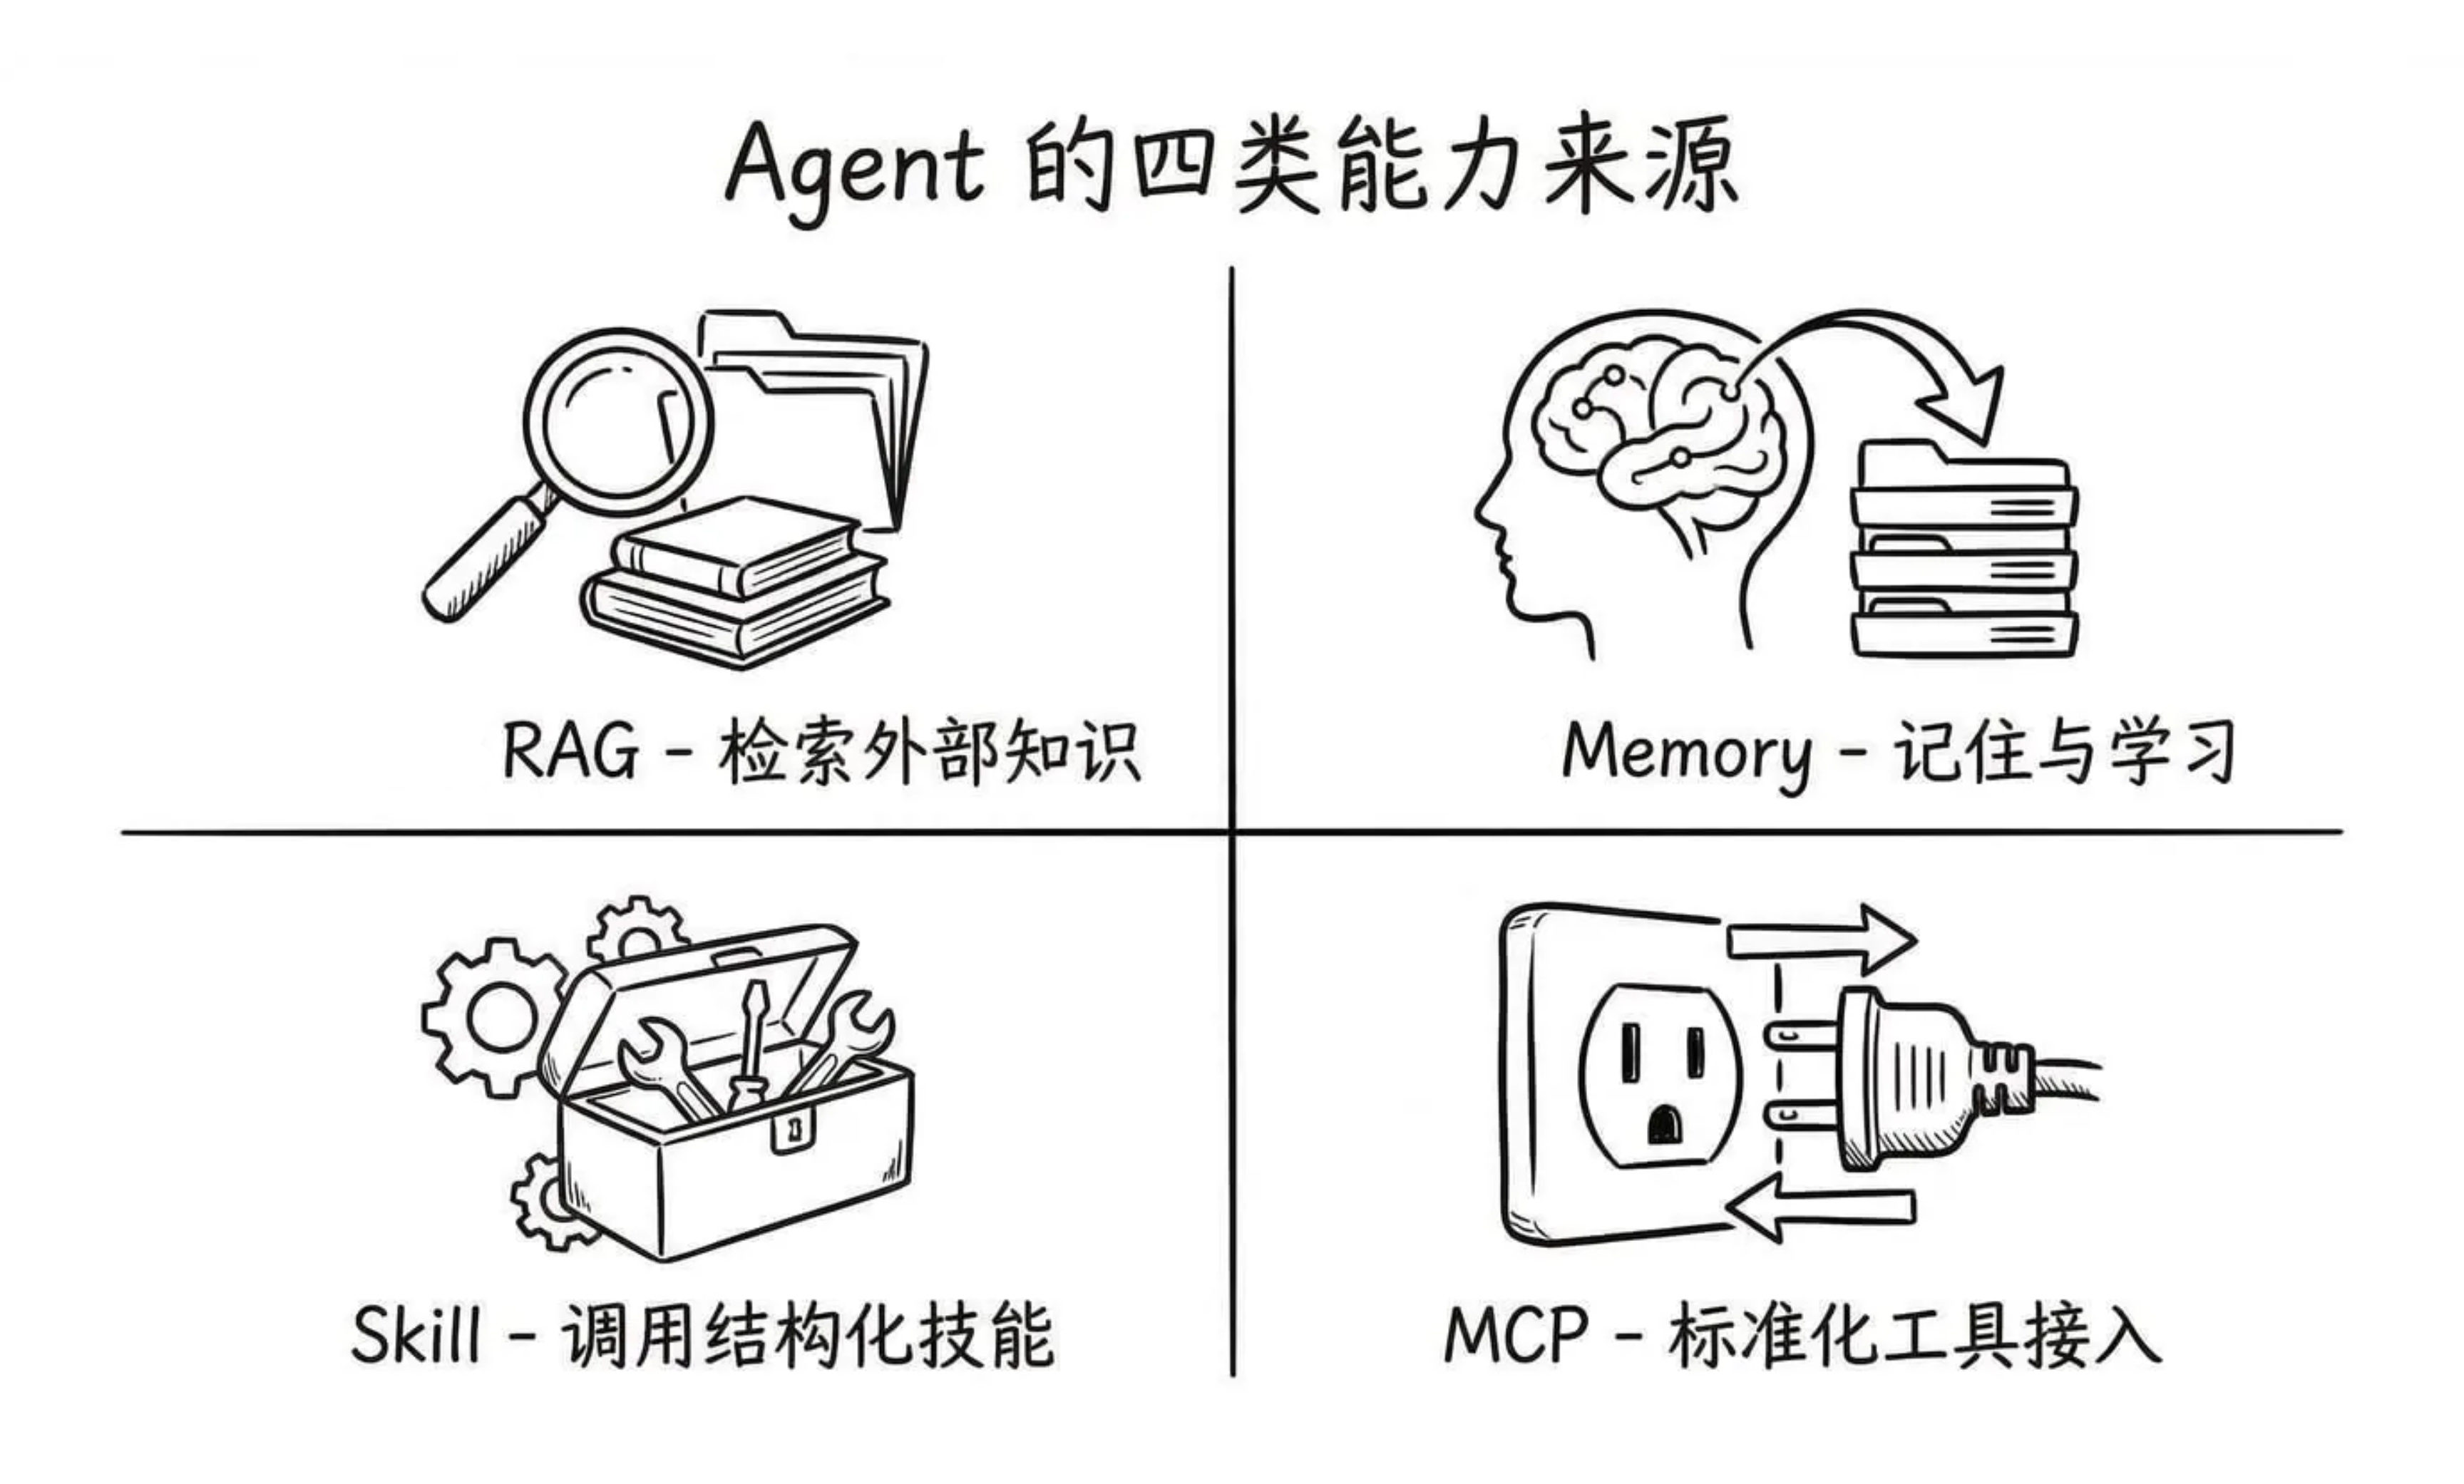
1. RAG —— 让 Agent 会「查资料」
(1)RAG 的本质:知识数据的检索。
(2)RAG 的效果天花板取决于:
- 知识库的数据质量(文档完整性、更新频率)
- 切分策略(Chunk Size、重叠度)
- 检索策略(纯向量 vs 混合检索)
- Embedding 模型选择
不管 RAG 怎么演进,你拆到底会发现,它的效果天花板始终卡在同一个地方 —— 你的知识数据质量。文档切得好不好、embedding 模型选得对不对、检索策略是纯向量还是混合检索 —— 这些全是数据层的活儿。
(3)从 Naive RAG 到 Agentic RAG 的演进:
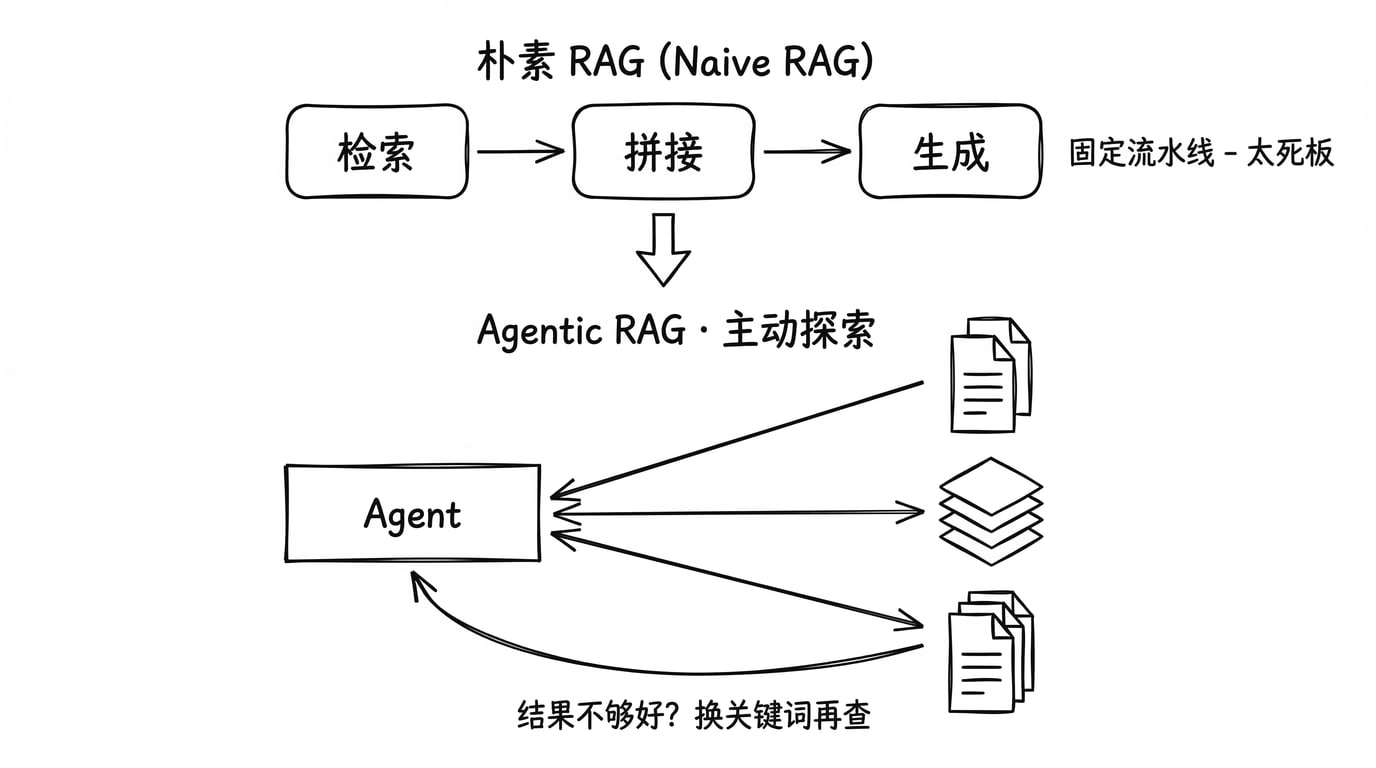
Naive RAG(朴素 RAG):
- 固定流程:检索 → 拼接 → 生成
- 单次检索,结果直接注入 Prompt
- 局限:无法处理复杂查询、无法自适应调整策略
Agentic RAG:
- Agent 主动判断:要不要查?查哪里?查几次?
- 支持多轮检索、策略调整、多源交叉验证
- 从“被动检索”升级为“主动探索”
2. MCP —— 标准化工具接入
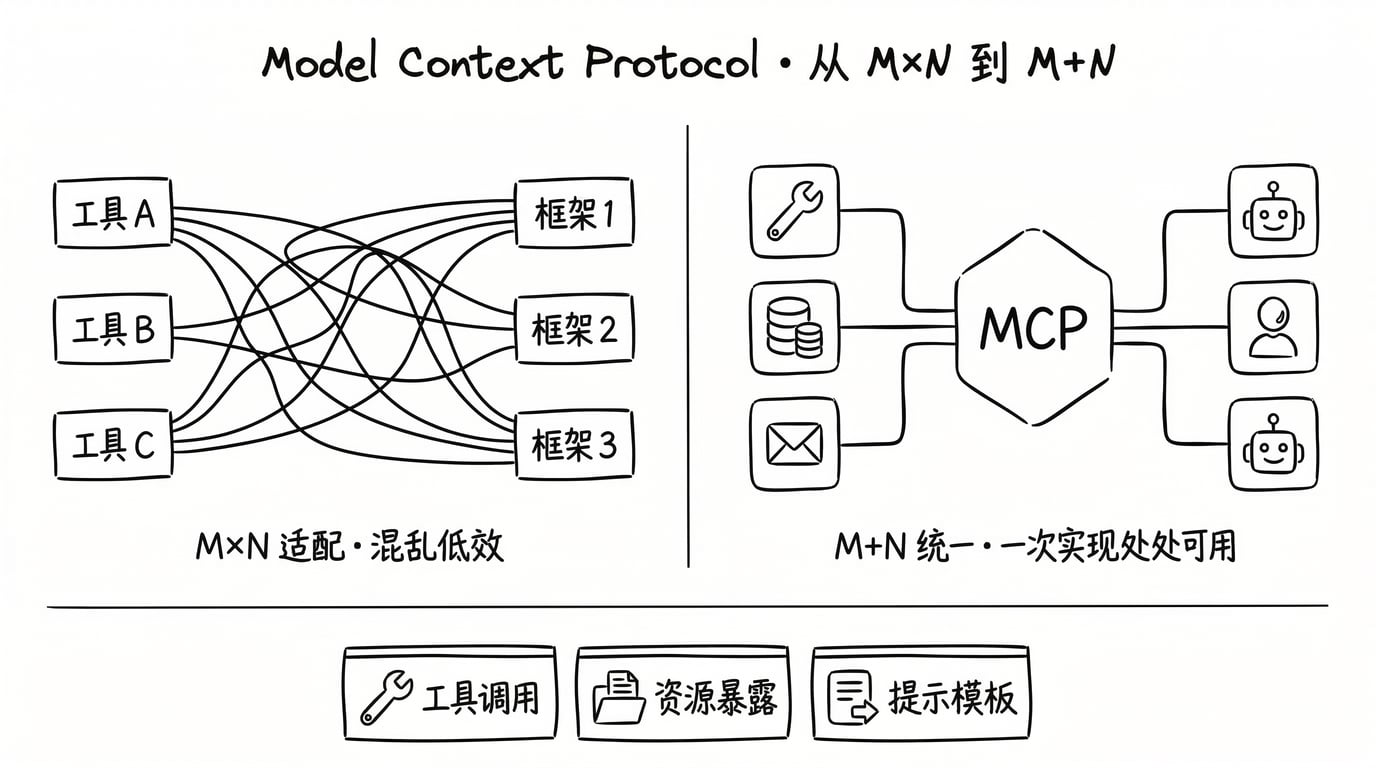
(1)在 MCP(Model Context Protocol)出现之前,Agent 工具接入面临 M×N 集成问题:
- M 个 Agent 框架 × N 个工具 = M×N 种适配方案
- 每个工具需要为每个框架单独开发接口
- 每个框架需要为每个工具单独编写适配代码
(2)MCP 的解决方案:统一协议标准
- 工具侧:实现统一的 MCP Server
- Agent 侧:实现统一的 MCP Client
- 集成复杂度从 M×N 降低到 M+N
如 USB 统一了键盘、鼠标、打印机的接口标准。
(3)MCP 的三大能力:
- Tool Calling:工具调用(执行操作)
- Resource Exposure:资源暴露(读取数据)
- Prompt Templates:提示模板(预设交互)
3. Skill —— 调用结构化技能
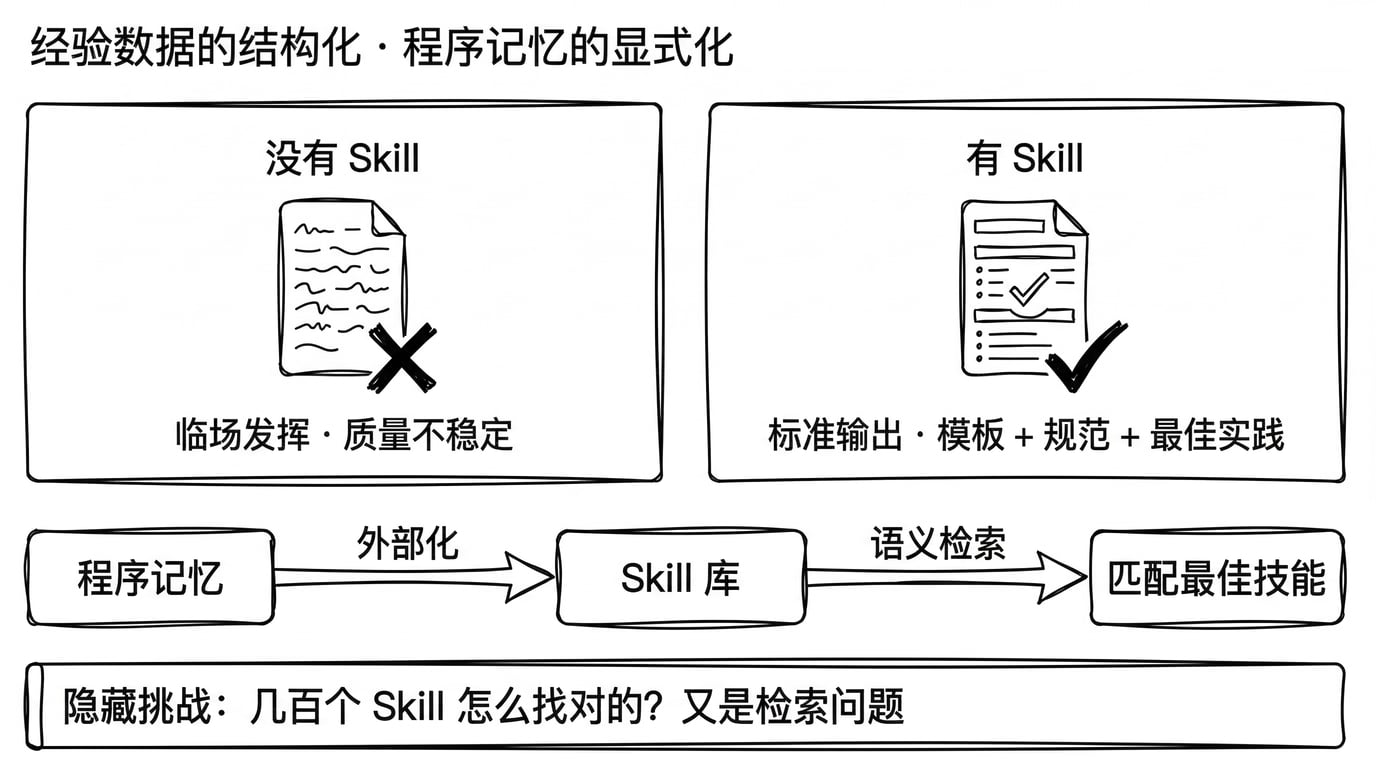
Skill 的本质 是将人类专业经验转化为 Agent 可理解和执行的结构化数据。
(1)组成要素:
- 操作流程(Step-by-step 指令)
- 领域规则(约束条件、质量标准)
- 成功案例(历史优秀输出)
- 术语表(领域特定词汇)
(2)与程序记忆的关系:
Skill 是程序记忆的显式化与可复用化。程序记忆是 Agent 在运行中学到的“遇到什么情况该怎么做”, Skill 是将这些经验提前总结并外部化存储。
(3)Skill 的效果取决于:
- 技能结构化程度(是否清晰可执行)
- 发现能力(如何在技能库中检索匹配的 Skill)
- 复用性(跨场景、跨用户的适用性)
4. Memory —— 个性化数据的积累与召回
(1)Agent 记忆分为三种:
① 语义记忆(Semantic Memory)
- 记住事实与偏好
- 示例:“用户是 Python 开发者”、“用户偏好简洁回答”
② 情景记忆(Episodic Memory)
- 记住过往经验
- 示例:“上次用 Docker 方案解决了部署问题”
③ 工作记忆(Working Memory)/ 程序性记忆(Procedural Memory)
- 记住行为规则
- 示例:“遇到代码问题先查文档再写代码”
(2)Memory 的效果取决于:
- 记忆提炼质量(如何从对话中抽取关键信息)
- 召回策略(何时调用哪些记忆)
- 遗忘机制(如何降权过时信息)
| 能力 | 本质定义 | 作用场景 | 特点/优势 | 类比 |
|---|---|---|---|---|
| RAG | 检索增强生成(Retrieval-Augmented Generation) | 从知识库/文档中检索相关信息,再生成回答 | 避免幻觉,提升准确性,依赖数据质量 | 图书馆检索:先查书,再回答 |
| MCP | Model Context Protocol | 标准化工具接入,让 Agent 能调用外部系统 | 像 USB 接口一样,解决工具生态互联问题 | 插接口:统一标准,随插随用 |
| Skill | 结构化技能调用 | 把经验转化为可复用的任务执行单元 | 可复用、可移植,解决“怎么做事”问题 | 工具箱:告诉 Agent 怎么做 |
| Memory | 个性化记忆系统 | 保存用户偏好、上下文、历史交互 | 个性化、持久化,解决“为谁做事”问题 | 档案库/日记:记住你是谁 |
五、数据是这一切的基础
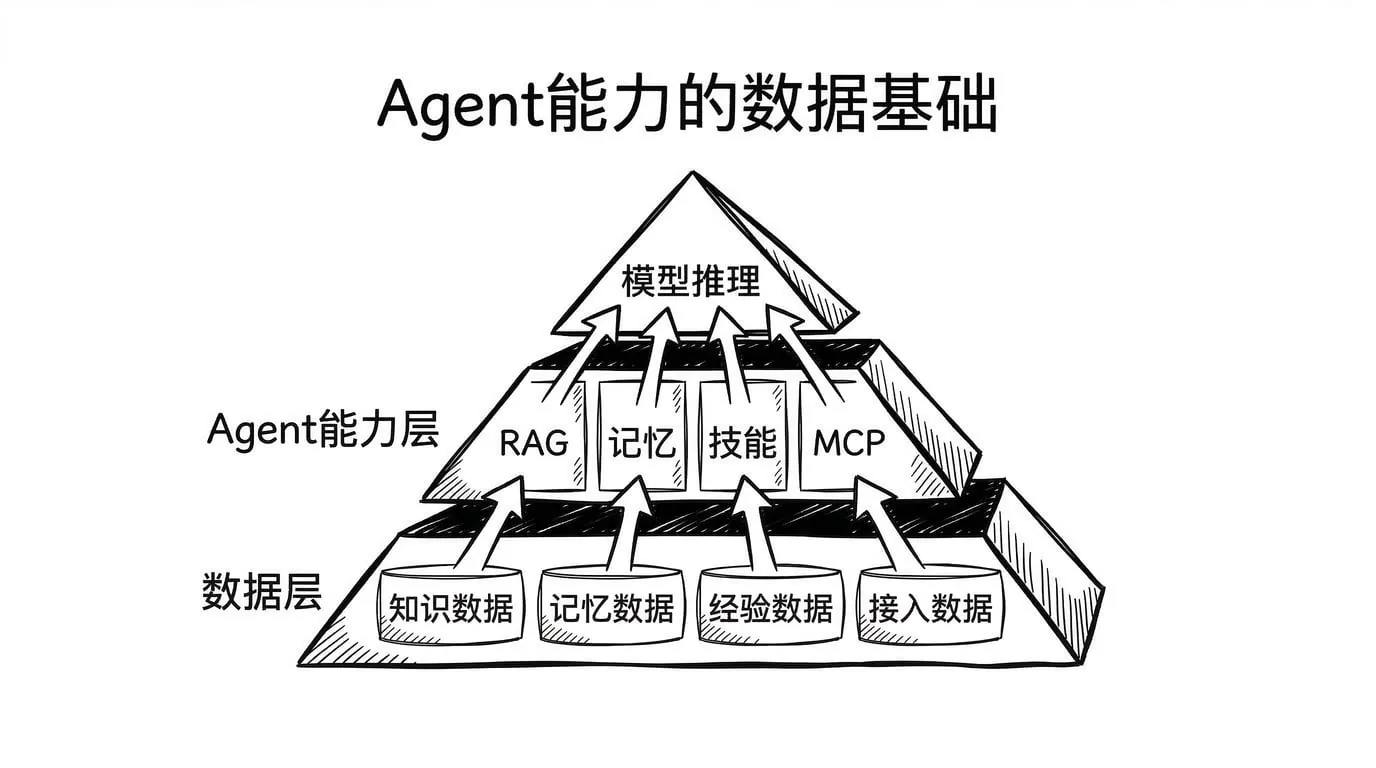
RAG 的效果好不好?取决于知识库的数据质量和检索策略
MCP 能连接多少工具?取决于数据接口的标准化程度
Skill 能不能复用?取决于技能的数据结构化程度和检索能力
Memory 准不准?取决于记忆数据的提炼质量和召回策略
模型决定了 Agent 能“想多好”,数据决定了 Agent 能“做多好”。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐


 1
 0
- 0


 已为社区贡献1条内容

所有评论(0)