普通人也能训练机器人了:从一只399美元的机器鸭开始
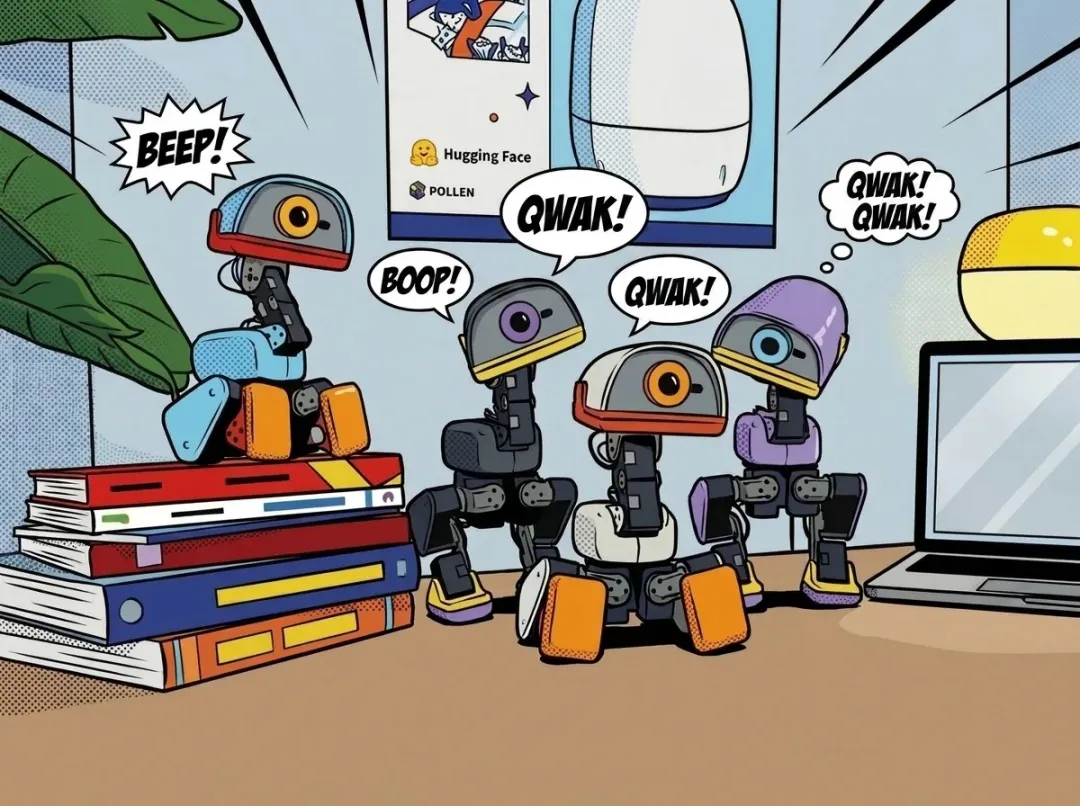
最近,Hugging Face 旗下 Pollen Robotics 开放双足机器人 Microduck 预购。产品售价 399 美元,高约 25 厘米,由 15 个舵机驱动,可以完成行走、起身、踢球等动作。
Microduck 的步态并非由固定动作代码控制,而是通过强化学习训练神经网络策略。项目的训练框架、仿真模型和部分预训练策略已经开源,开发者可以在 MuJoCo 仿真环境中运行社区动作,也可以使用 GPU 训练自己的策略。
一、社区已经训练了哪些动作
Microduck 发布后,社区开发者陆续上传了跑步、跳跃、单腿站立、鞠躬、旋转等动作策略。
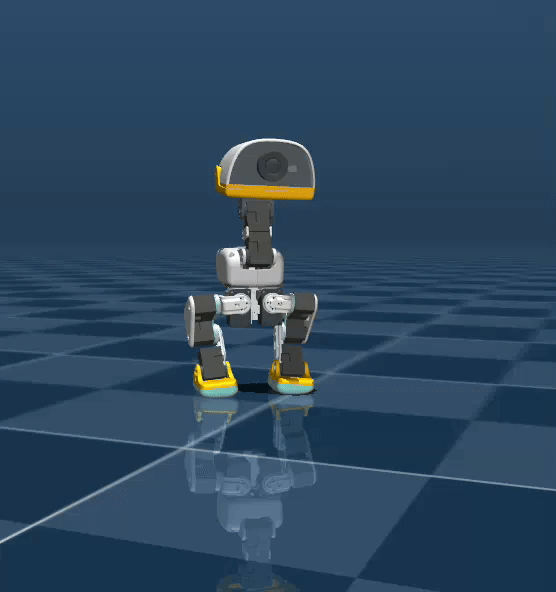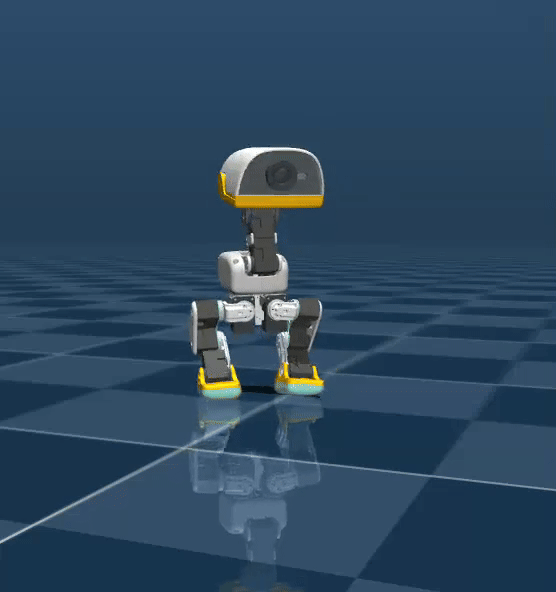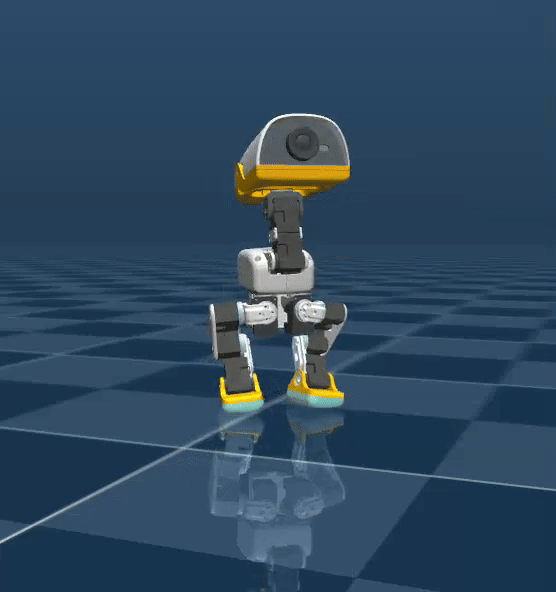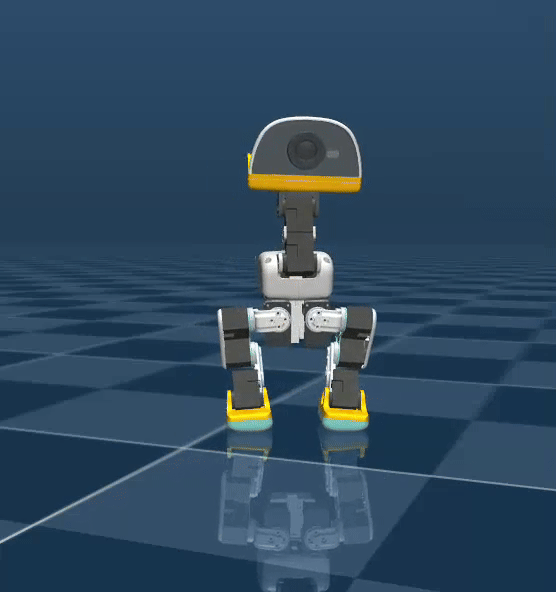
microduck跳跃-仿真
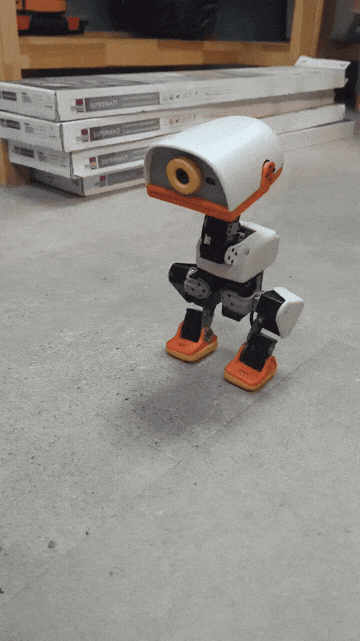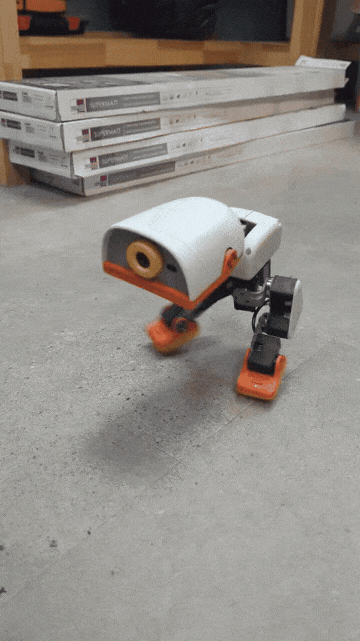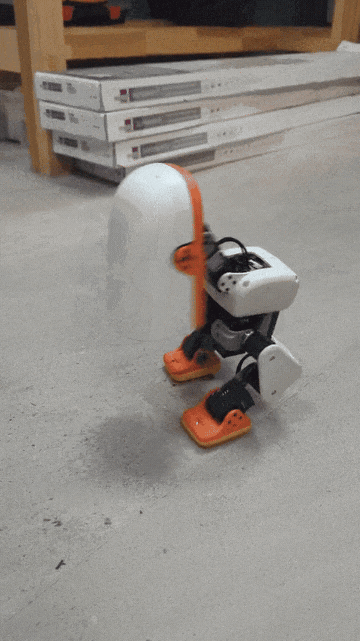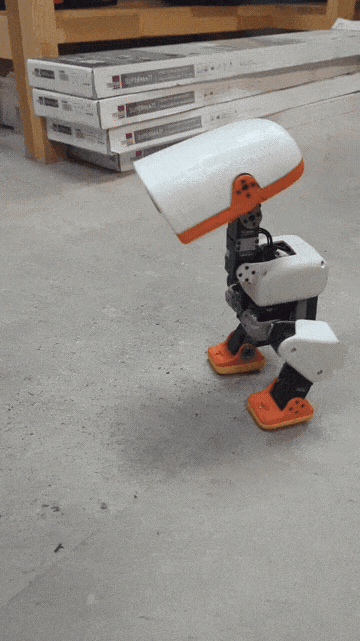
microduck跳跃-真机
其中,社区成员 HannesVonEssen 训练的跑步策略实现了约 1.65 米/秒的速度;joanfox 开发的跳跃策略已经由 Pollen Robotics 在真实硬件上完成测试。
其他公开策略还包括:
-
单腿站立
-
地面捡物
-
左右脚踢球
-
前滚翻
-
鞠躬
-
太空步
-
……
这些策略通常以 ONNX 文件发布在 Hugging Face。即使没有实体机器人,也可以先在电脑上通过 MuJoCo 查看运行效果。
二、训练一个动作需要什么
Microduck 的动作训练主要包含三个部分:仿真环境、奖励函数和强化学习算法。
以走路为例,奖励函数会鼓励机器人保持平衡并按照目标速度前进;如果训练跳跃动作,则需要提高双脚离地、身体姿态和落地稳定性等指标的权重。
项目支持同时运行数千个仿真环境,以提高数据采集和训练效率,这类训练通常需要 GPU。优刻得 GPU 云主机从单卡入门覆盖到多卡集群,具身智能训练是明确支持的方向。
GPU 选型参考:
|
训练需求
|
建议配置
|
适用场景
|
| — | — | — |
|
单个基础动作
|
V100S 32GB
|
可运行数千个并行环境,适合入门训练
|
|
多组参数并行测试
|
RTX 30/40 系列或同级 GPU
|
单卡计算速度较快,适合频繁迭代
|
|
多任务或大规模仿真
|
A800、H800 或同级 80GB GPU
|
适合多卡训练和较大规模实验
|
登录UCloud 控制台,进入云主机,即可创建 GPU 云主机。
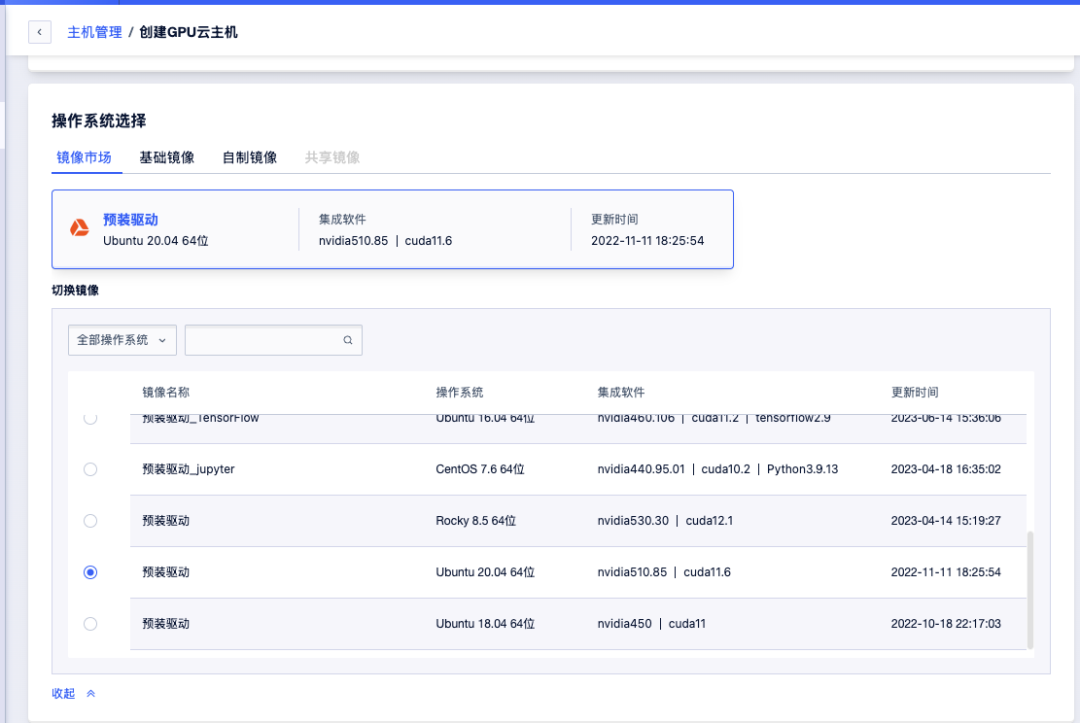
建议配置:
-
1 张 32GB 显存 GPU
-
10 核左右 CPU
-
32GB 内存
-
Ubuntu 20.04 或更高版本
-
至少 20GB 可用磁盘空间
-
已安装 NVIDIA 驱动和 CUDA
三、在优刻得 GPU 云主机上完成一次训练
连接服务器后,先检查 GPU:
nvidia-smi
能够正常显示 GPU 型号、显存和驱动版本,即可继续安装训练环境。
1. 安装项目
# 安装 uv
curl -LsSf https://astral.sh/uv/install.sh | sh
source ~/.bashrc

# 安装 Python 3.12
uv python install 3.12

# 下载训练框架
git clone https://github.com/pollen-robotics/microduck_rl
cd microduck_rl

# 安装依赖
export UV_HTTP_TIMEOUT=600
uv sync
项目首次安装会下载 CUDA 等依赖,需要一定时间和磁盘空间。
如果希望在线查看训练曲线,可以登录 Weights & Biases:
uv run wandb login
如果后续需要将模型发布到 Hugging Face,还需要登录 Hugging Face CLI:
uv run hf auth login
API Key 和访问令牌应通过环境变量或交互式登录提供,不要写入源码或公开日志。
2. 训练走路策略
官方框架已经提供基础走路任务,可以直接启动:
# 离线训练
WANDB_MODE=offline uv run train \
  Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 4096
如果已经登录 Weights & Biases,可以去掉离线参数:
uv run train \
  Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 4096
训练过程中,终端会输出迭代次数、奖励值和 GPU 使用情况。奖励值整体上升并逐渐稳定,通常表示策略正在收敛。
如果出现显存不足,可以减少并行环境:
uv run train \
  Mjlab-Velocity-Flat-MicroDuck \
  --env.scene.num-envs 2048
基础走路策略通常可以在数小时内完成初步训练,实际时间取决于 GPU、训练参数和收敛要求。
3. 导出 ONNX 策略
使用 Weights & Biases 记录训练时,可以根据 run path 导出模型:
uv run scripts/export.py \
  Mjlab-Velocity-Flat-MicroDuck \
  --wandb-run-path <用户名>/<项目名>/<run_id>
离线训练则使用本地 checkpoint:
uv run scripts/export.py \
  Mjlab-Velocity-Flat-MicroDuck \
  --checkpoint-file <checkpoint路径>
导出完成后会生成 ONNX 策略文件。
4. 在仿真环境中验证
Linux 环境下运行:
uv run scripts/infer_policy.py \
  --walking output.onnx \
  --new-cmd-obs
macOS 环境下运行:
.venv/bin/mjpython scripts/infer_policy.py \
  --walking output.onnx \
  --new-cmd-obs
如需保存观测数据,可以增加 --record:
uv run scripts/infer_policy.py \
  --walking output.onnx \
  --new-cmd-obs \
  --record recording.pkl
策略验证主要关注三个方面:机器人能否保持稳定、动作是否符合目标,以及面对初始姿态变化或外部扰动时是否容易失效。
5. 发布到 Hugging Face
完成验证后,可以将 ONNX 文件发布到 Hugging Face Hub:
uv run publish \
  --onnx output.onnx \
  --repo <HF用户名>/microduck-walk \
  --kind perpetual \
  --slot walk \
  --description "Microduck walking policy"
其他用户可以通过以下命令下载:
uv run hf download \
  <HF用户名>/microduck-walk \
  policy.onnx \
  --local-dir policies/my-walk
在实体 Microduck 上加载策略时,可以使用项目提供的机器人控制工具:
sudo robotctl policy load \
  walk <HF用户名>/microduck-walk

  robotctl robot do walk
在真机运行前,应先确认策略与当前硬件、固件和控制接口兼容,并预留安全空间进行低速测试。
四、从走路扩展到跑步
训练新动作通常不只是提高目标速度,还需要重新调整奖励函数和鲁棒性参数。
以跑步策略为例,常见调整包括:
-
提高目标速度和速度上限
-
增加前进奖励权重
-
对动作变化幅度进行约束
-
加入随机外力
-
随机改变躯干或头部重心
-
设置不同的初始倾斜角度
这些扰动可以降低策略对单一仿真条件的依赖,提高部署到真实硬件后的适应能力。
社区扩展项目 microduck-playground 提供了跑步任务示例:
git clone https://github.com/Vottivott/microduck-playground.git
cd microduck-playground

export UV_HTTP_TIMEOUT=600
uv sync

MICRODUCK_RUNNING_TARGET_MAX_SPEED=2.2 \
MICRODUCK_RUNNING_SPEED_CAP=2.4 \
MICRODUCK_RUNNING_FORWARD_PROGRESS_WEIGHT=5.0 \
MICRODUCK_RUNNING_ROBUST_PUSH_MPS=0.10 \
MICRODUCK_RUNNING_ROBUST_TRUNK_COM_M=0.008 \
MICRODUCK_RUNNING_ROBUST_HEAD_COM_M=0.006 \
MICRODUCK_RUNNING_ROBUST_INITIAL_TILT_DEG=2.0 \
WANDB_MODE=offline \
uv run train \
  Mjlab-Running-Flat-MicroDuck \
  --env.scene.num-envs 4096
跑步比基础行走更难收敛,训练时间可能从数小时增加到十小时以上。参数并非越大越好,需要同时观察速度、稳定性、动作平滑度和能耗等指标。
五、成本与注意事项
云端训练成本主要由 GPU 实例运行时间、系统盘和公网流量构成。按照文中示例价格估算,基础走路策略训练约需数十元;更复杂的跑步或跳跃策略由于训练时间更长,成本也会相应增加。
为避免额外费用,完成训练后可以:
-
保存 checkpoint 和导出的 ONNX 文件;
-
将需要的文件上传至对象存储或本地;
-
停止或释放 GPU 实例;
-
后续使用普通 CPU 环境完成部分仿真回放和数据分析。
Microduck 的开源框架降低了机器人动作开发的入门门槛,但从仿真运行到真机稳定执行,仍需要经过参数调整、鲁棒性训练和硬件验证。对于初次尝试的开发者,建议先复现官方走路策略,再逐步修改速度、奖励函数和扰动参数。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 1
 0
- 0


 已为社区贡献3条内容

所有评论(0)