【玩转VLA具身智能机械臂】(五):GraspNet 6-DoF 抓取——从网络提议到筛选执行
前言
- 最近 VLA(Vision-Language-Action,视觉-语言-动作)具身智能发展迅速,从谷歌的
RT-2、OpenVLA到π0,大模型开始直接输出机器人动作,而这一切的物理载体正是机械臂 - 因此本系列将逐步上手 VLA 具身智能机械臂。在正式开始 VLA 部署之前,我们用两期分别讲解传统方法与深度学习方法在夹取上的应用;这两期里运动学与动力学都由
MoveIt2代劳,所以先用一期Pinocchio把这层自己算一遍,再进入 OpenVLA 的部署 - 往期内容:
- 本期作为
MoveIt2+Gazebo的收官作,我们将换一条路线:不再手写几何,而是让网络直接从点云里预测 6-DoF 抓取位姿 - 本期的核心链路是:
/camera/depth/points点云送进GraspNet推理,得到一组候选抓取与各自的质量分,写进/best_grasp发布出去,最后交给执行节点触发一次真实抓取,最终效果如下
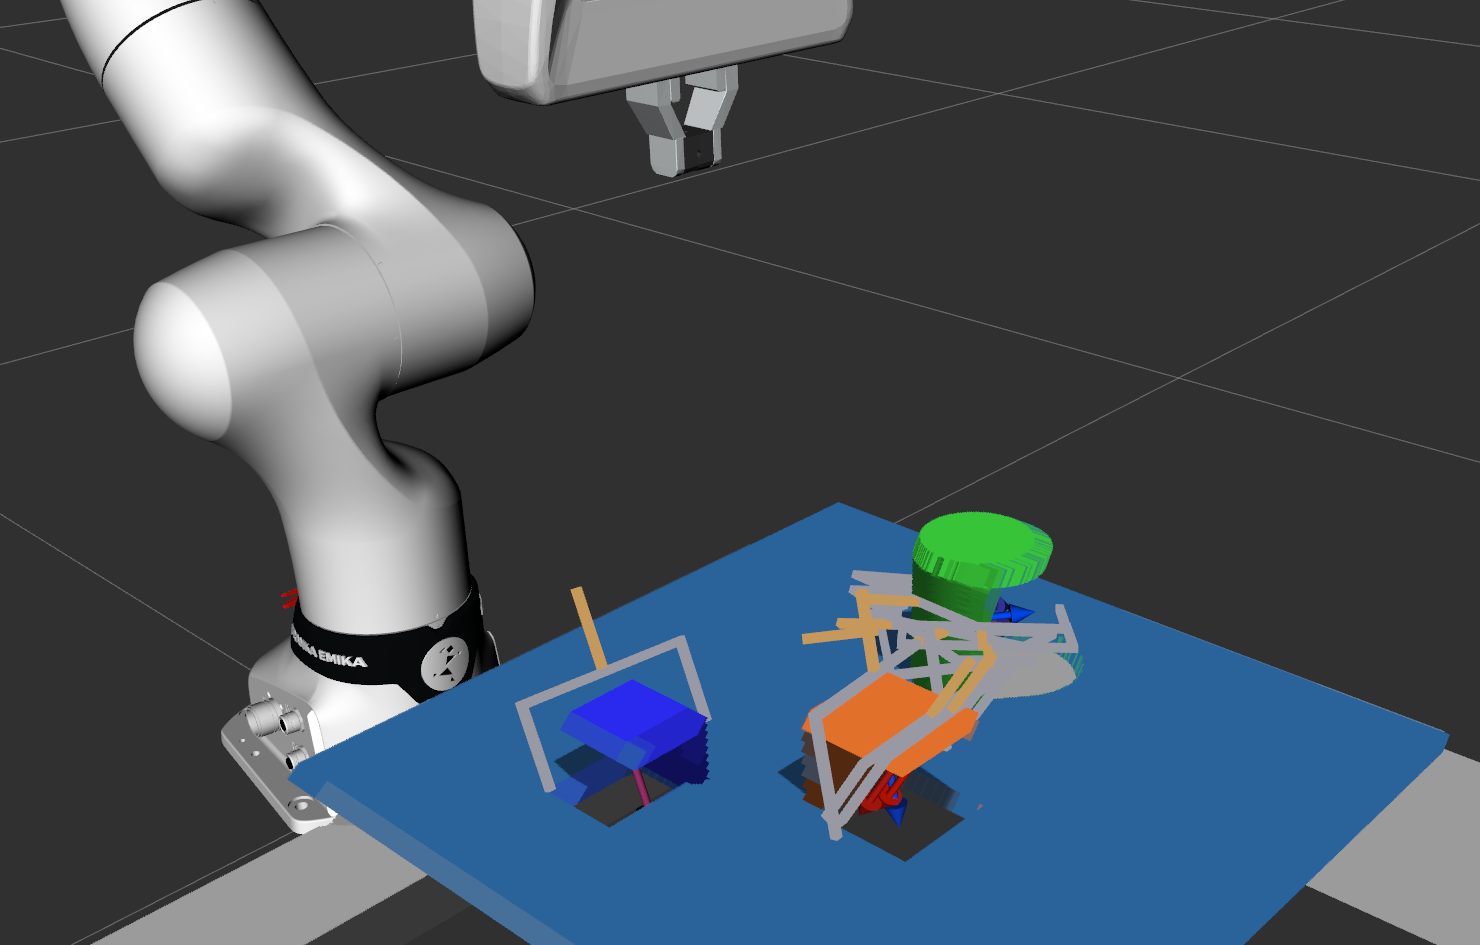
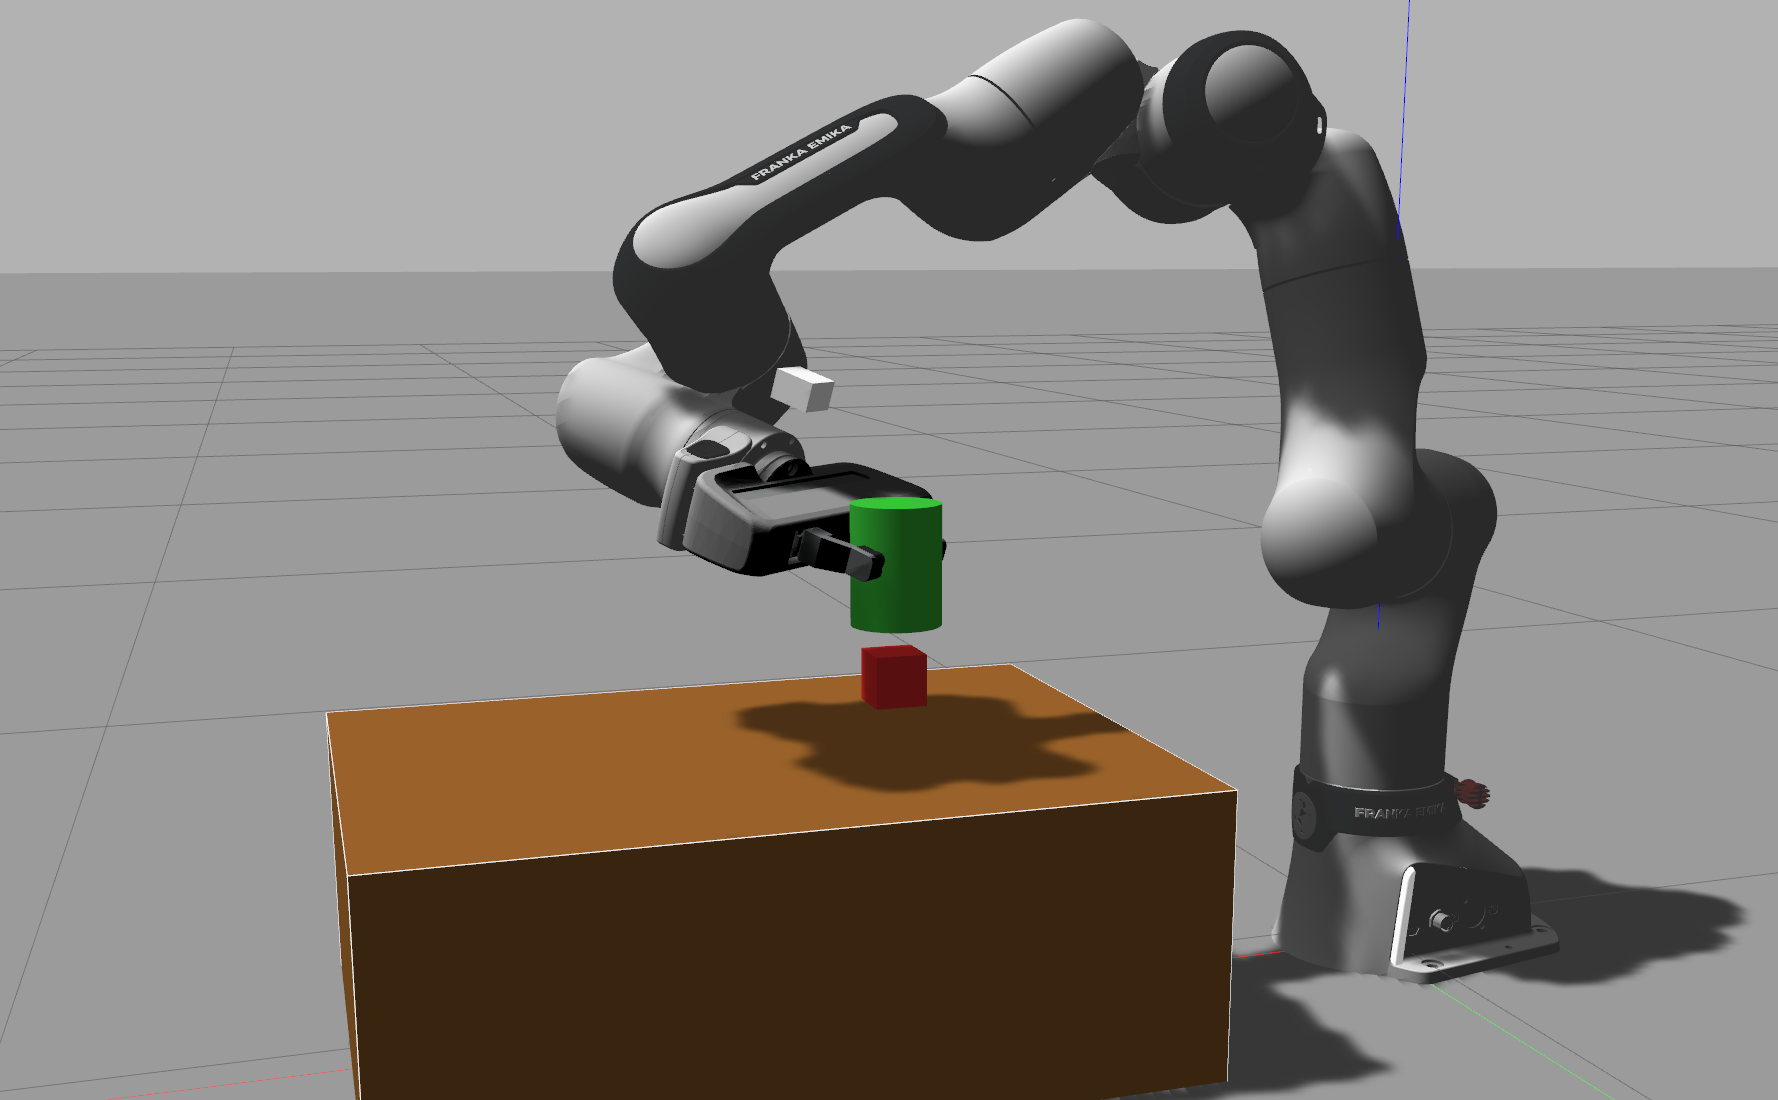
文章目录
0 修复
0-1 斜视点云估计
- 回顾上一期,传统
PCA+OBB方案失效的根因是斜视- 视角一倾斜,物体侧面的点就混进点云,把协方差从面内分布拉向竖直分布
- 最小方差轴因此偏离物体的竖直轴,指向点云缺失的背面方向
- 后来我回去查阅了一些资料,其实这个问题完全可以避免
- 办法有两个:一是把物体往机械臂方向挪一点,让相机接近正俯视;二是像上一期那样,让机械臂主动移到物体正上方再扫描
- 本期我们用前面一种,直接修改
Gazebo里物体的摆放
- 改动很小,三个物体整体沿 x 向机械臂方向内收
0.10 m,y、z 都不动:
# pick_place.world:三个物体整体内收 0.10 m,y 与 z 保持不变
# 红:0.46 -> 0.36    绿:0.52 -> 0.42    蓝:0.56 -> 0.46
sed -i \
  -e 's|<pose>0.46 -0.10 0.220 0 0 0</pose>|<pose>0.36 -0.10 0.220 0 0 0</pose>|' \
  -e 's|<pose>0.52 0.09 0.240 0 0 0</pose>|<pose>0.42 0.09 0.240 0 0 0</pose>|' \
  -e 's|<pose>0.56 -0.03 0.225 0 0 0</pose>|<pose>0.46 -0.03 0.225 0 0 0</pose>|' \
  src/panda_gazebo_bringup/config/pick_place.world

# 确认三个物体的位姿
grep -E '<pose>0\.(36|42|46)' src/panda_gazebo_bringup/config/pick_place.world
-
判断当前文件是新值还是旧值要看下面那条
grep的内容:输出三行0.36 / 0.42 / 0.46说明已经是新值(这一步可以跳过);输出三行0.46 / 0.52 / 0.56才需要跑上面的sed -
这个距离不是随便定的,两头都有约束:
- 下限:
panda_link8停在x = 0.307,夹爪就吊在那里,物体收到x < 0.35会被自己的手挡住 - 上限:相机在
x = 0.385,物体离光轴越远,斜视越明显
- 下限:
-
内收
0.10 m之后,离轴角从原来的11° ~ 26°降到4° ~ 12°,基本接近正俯视,物体在图像里几乎只剩顶面可见 -
改完记得重启一次
Gazebo,因为pick_place.world只在启动时读一次
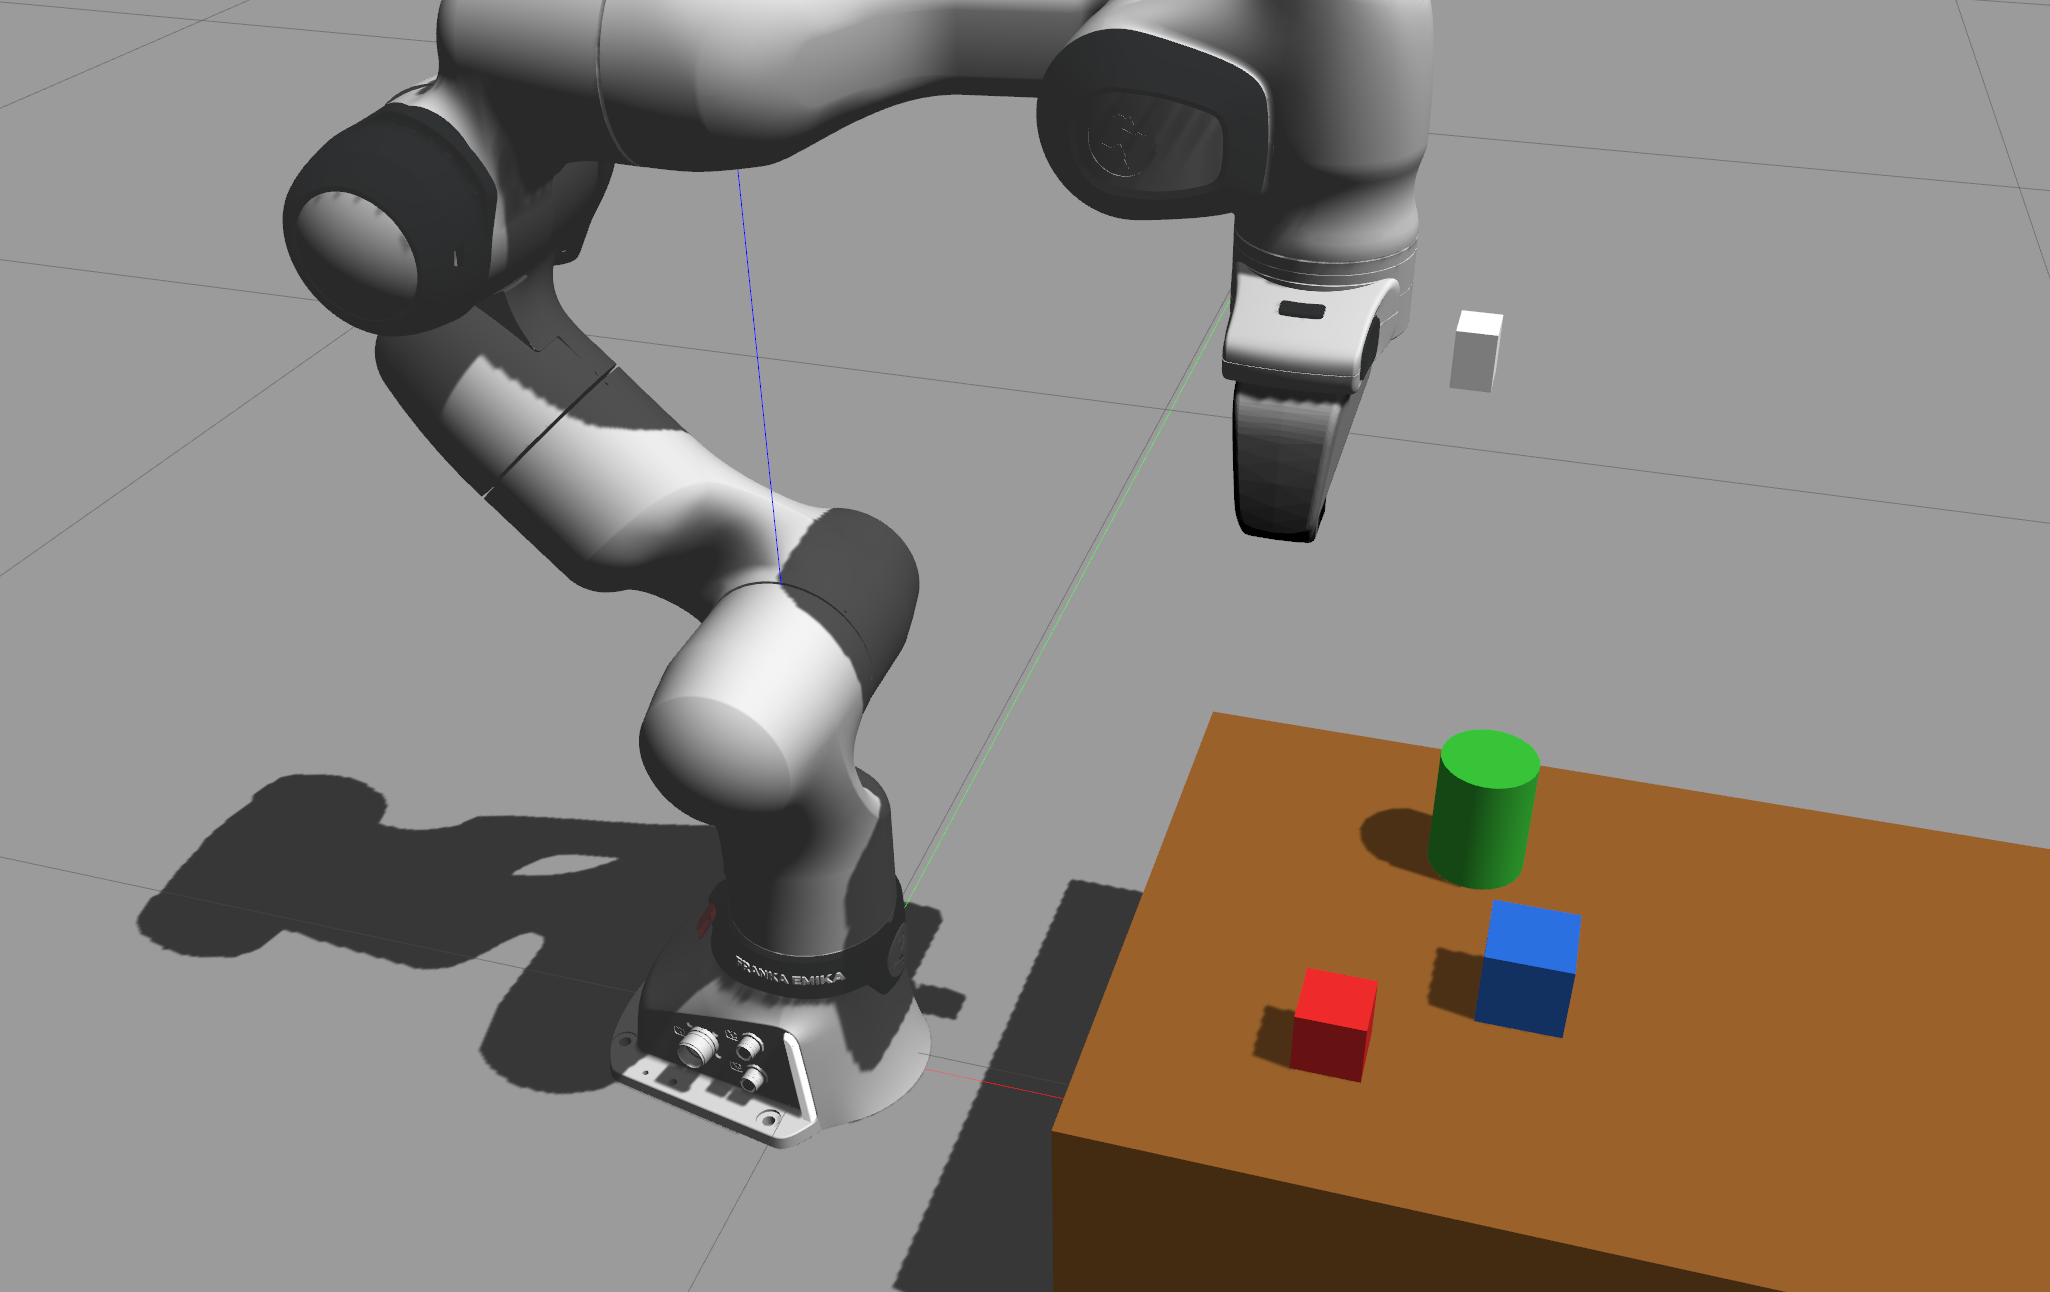
-
可以看到现在物体的点云更加明确了,
PCA+OBB的方案也更加清晰
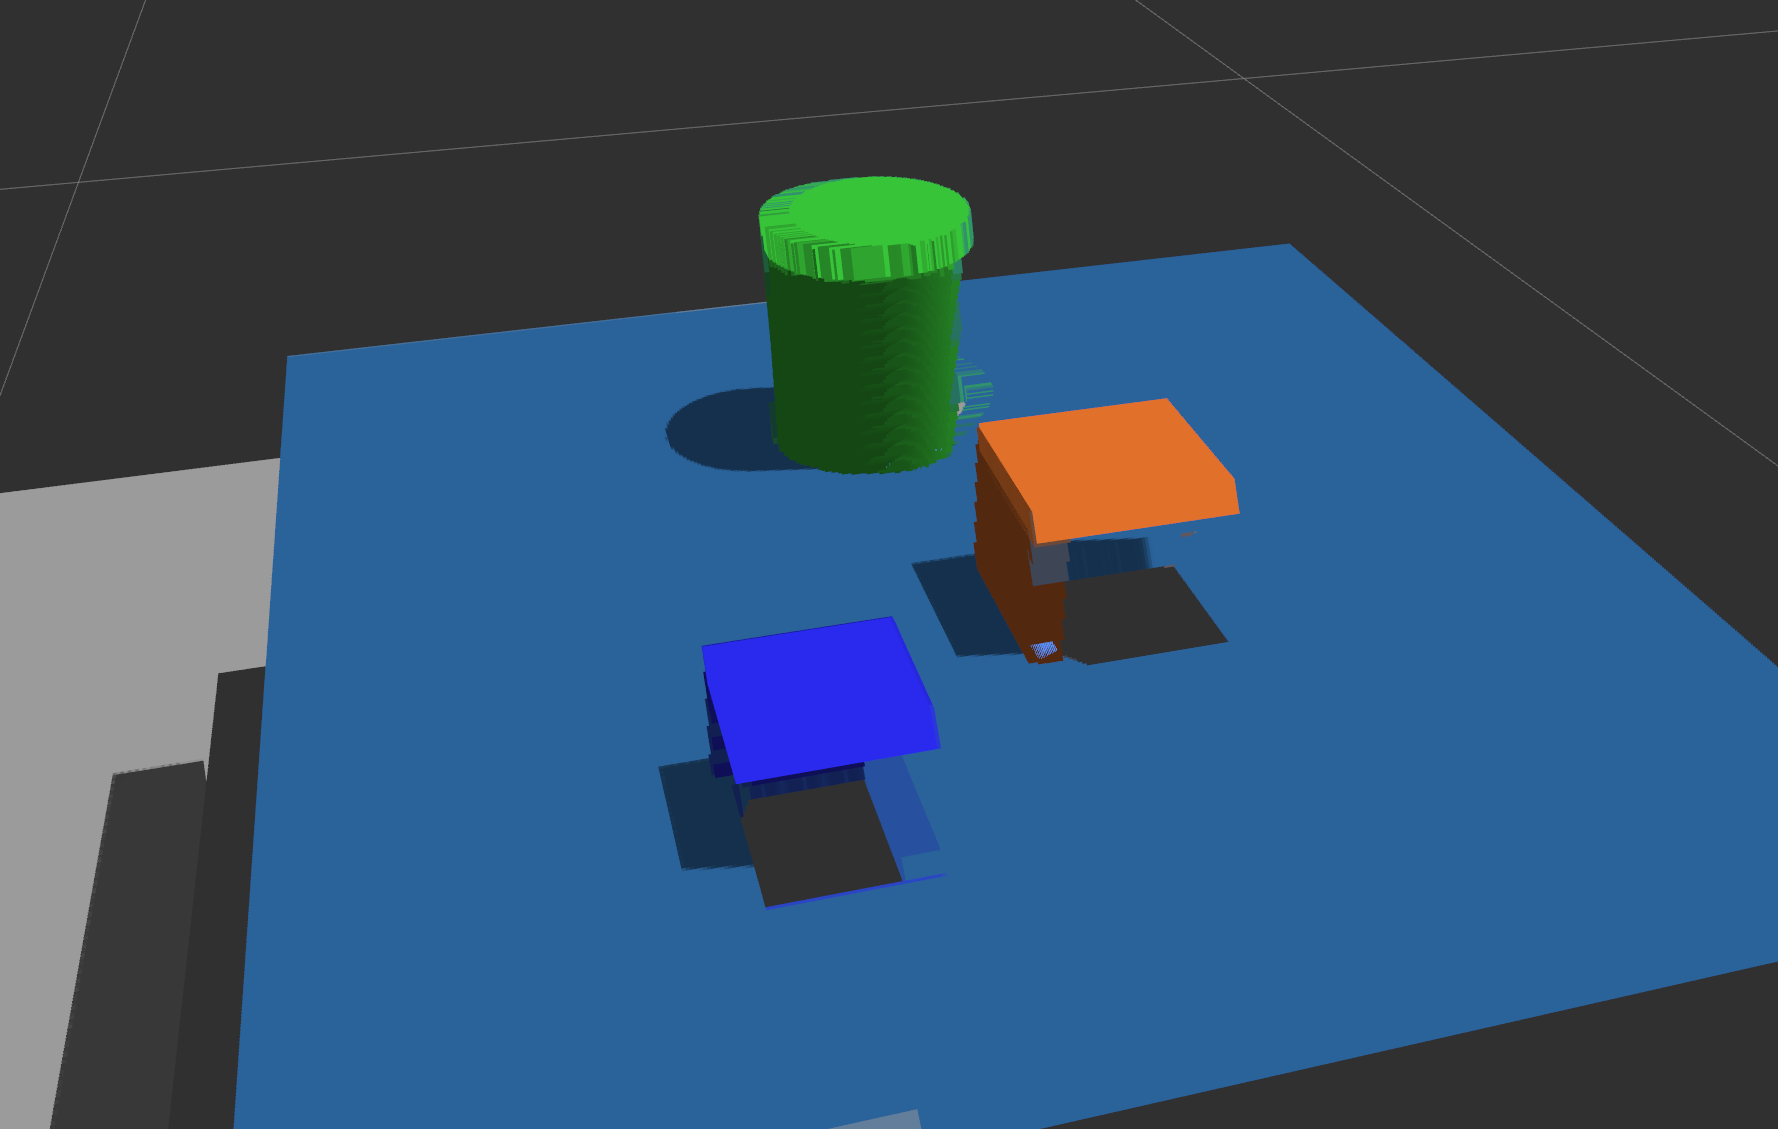
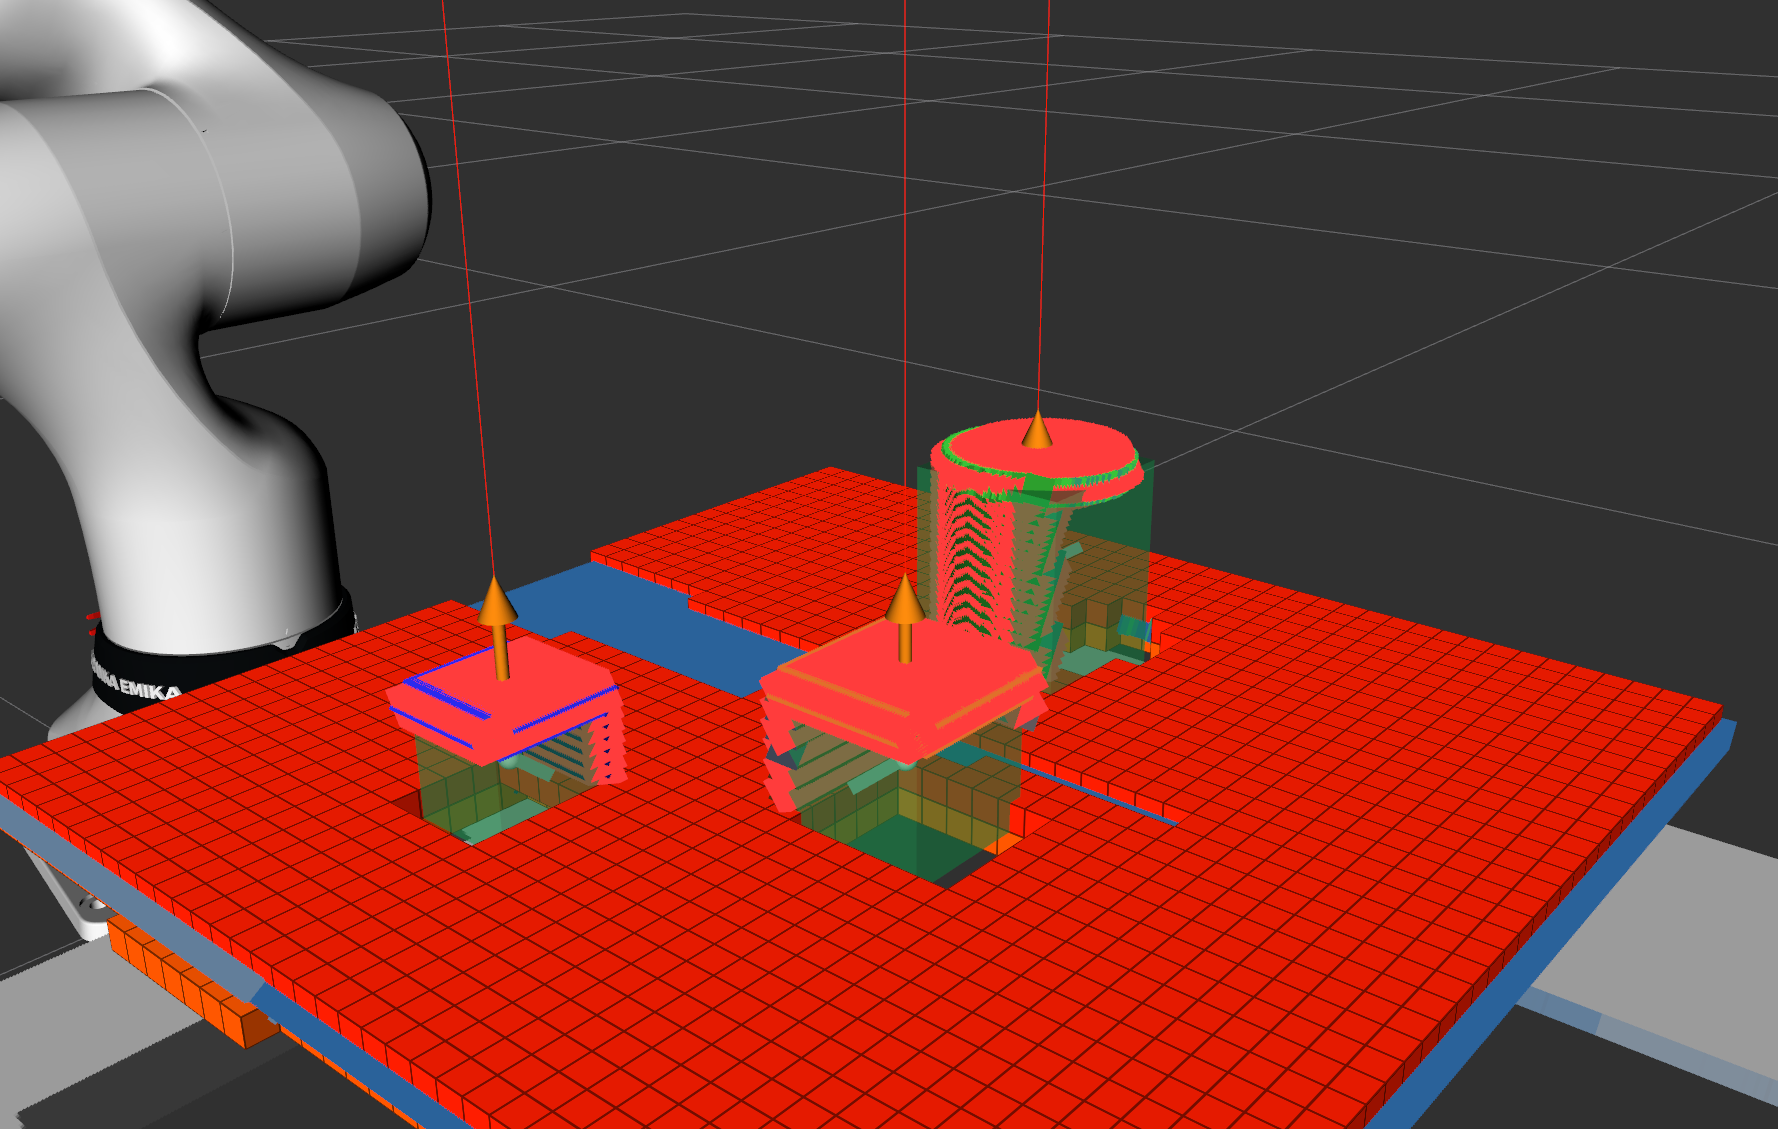
- 因为这个问题同样会影响到本期要使用的
GraspNet,所以必须先说明
0-2 moveit2默认规划器配置失误
- 由于我们前几期配置的问题,
panda_arm这个关节组其实一直没有配默认规划器 - 前几期的 launch 里都写了这一行,三条 pipeline 确实都装进来了:
.planning_pipelines(pipelines=['ompl', 'chomp', 'pilz_industrial_motion_planner'])
- 但"装进来"不等于"选对了"。每个关节组到底用哪条配置,写在
ompl_planning.yaml的default_planner_config里,而本工作区用的moveit_resources_panda里连这一项都没有 —— 整个文件搜不到这个键,不是"写了但是空值":
# moveit_resources_panda_moveit_config/config/ompl_planning.yaml
panda_arm:
  planner_configs:          # 这里列了二十多个可选项
    - SBLkConfigDefault
    - RRTConnectkConfigDefault
    - RRTstarkConfigDefault
    # ... 省略其余
  # 注意:下面没有 default_planner_config 这一行
- 缺了它,MoveIt 会自己补一个 —— 名字就叫
panda_arm,类型geometric::RRTConnect- 也就是说,前几期所有
setPoseTarget加plan()的动作,实际跑的都是RRTConnect - 而
RRTConnect是关节空间采样规划器,它的代价函数是关节空间里的路径长度,里面没有"末端走直线"这一项- 导致所有路径都是接出来的,不是优化出来的 —— 某些关节来回摆、肘部乱翻都是允许的,而且它是随机的:同样两个点,每次跑出来的关节轨迹都不一样
- 也就是说,前几期所有
- 所以我们替换为
PILZ的LIN。先简短介绍一下这个规划器:PILZ是 MoveIt 里的工业运动规划插件包,实现的是工业机器人常见的那几条运动指令,常用的有三种:PTP(点到点,不保证末端轨迹)、LIN(笛卡尔直线)、CIRC(圆弧)LIN的做法是:在两个位姿之间按直线插值出一串笛卡尔路点,再对每个路点求逆解,最后把逆解串成一条关节轨迹- 所以它的结果对"末端走什么形状"是有约束的,这正是我们要的
说人话:
RRTConnect只管"能不能到达",LIN还管"路上走成什么样"
- 因此我们要对这个做修改,核心部分就是把 pipeline 与 planner 从"靠默认值"改成"由调用方明确指定":
// grasp_run_node.cpp —— 一段运动跑哪条 pipeline、哪个 planner,由调用方传进来
// 不在这里按 stage 名字猜:一段运动只能有一个设置点,否则谁后设谁生效。
void selectPlanner(const std::string & pipeline, const std::string & planner)
{
  move_group_->setPlanningPipelineId(pipeline);
  move_group_->setPlannerId(planner);
}
- 配合参数文件里的两组选择:
# grasp_run_params.yaml
# 自由空间转移用的 pipeline/planner。
# free_planner 留空是故意的,不是漏填:planner_id 为空时 OMPL 会退回该组的默认配置,
# 也就是上面 MoveIt 自己补的那个 RRTConnect。
free_pipeline: ompl
free_planner: ""

# 推进/抬升用的 pipeline/planner。PILZ 的 LIN = 笛卡尔直线。
linear_pipeline: pilz_industrial_motion_planner
linear_planner: LIN
- 第 5 章新实现的
grasp_run从实现上就完全避免了这个问题:它不依赖组默认配置,每一段动作在发起规划前都显式设一次 pipeline 与 planner- 所以这条修复落在本节点自己身上:每一段运动都由它显式指定 pipeline 与 planner,
moveit_resources_panda的 yaml 则原样不动
- 所以这条修复落在本节点自己身上:每一段运动都由它显式指定 pipeline 与 planner,
- 详细的取舍(为什么只换这两段、为什么换
OMPL里别的 planner 没用)写在 5-3 节
1 6D Grasp Pose Estimation
1-1 介绍
- 6D Grasp Pose Estimation(6D 抓取位姿估计),指的是从 RGB-D 图像或点云中,直接预测出平行夹爪在三维空间里可执行的抓取位姿
- 对平行夹爪而言,一个 grasp 可以表示为四元组:
G = ( R , t , w , d ) G = (R, t, w, d) G=(R,t,w,d)
- 以防你忘记:
- R ∈ S O ( 3 ) R \in SO(3) R∈SO(3):夹爪的旋转,也就是"以什么姿态下爪"
- t ∈ R 3 t \in \mathbb{R}^3 t∈R3:夹爪的位置,也就是"在哪里下爪"
- w w w:夹爪张开宽度
- d d d:抓取深度,也就是手指能从接触面往里插多深
- 其中 ( R , t ) ∈ S E ( 3 ) (R, t) \in SE(3) (R,t)∈SE(3) 就是标准的刚体位姿
- 因此所谓的 6D,指的是:
3 D p o s i t i o n ⏟ t + 3 D o r i e n t a t i o n ⏟ R \underbrace{3D\ position}_{t} + \underbrace{3D\ orientation}_{R} t 3D position+R 3D orientation
注意:6D 指的是位姿的 6 个自由度,而不是说输入是 6 维数据。输入依然是一整片点云,输出才是 6D 位姿。
- 这里的 R R R 有一个必须提前讲清的约定,后面所有代码都按它来读:
| 列 | 含义 | 说明 |
|---|---|---|
| 第 0 列 | approach 轴 | 夹爪的进刀方向,指向物体内部 |
| 第 1 列 | closing 轴 | 两指闭合方向,张开宽度 w w w 量的就是这一轴 |
| 第 2 列 | 指厚方向 | 夹爪的厚度方向,与另两轴构成右手系 |
说人话: R R R 的第 0 列就是"从哪边下手",第 1 列就是"两个手指往哪个方向合拢",而位置 t t t 是接触点,不是法兰中心。
- 这三列是两两正交的。closing 和指厚这两列都垂直于 approach,且彼此垂直
- 如果这三列的顺序出错,会让"真夹爪绕 approach 轴滚 90 度
1-2 区别于 Object Pose
1-2-1 Object Pose
- 描述:物体自身坐标系相对于参考坐标系的位置和姿态
- 写成数学形式就是:
T o b j w o r l d ∈ S E ( 3 ) T_{obj}^{world} \in SE(3) Tobjworld∈SE(3)
- 它回答的是"物体在哪、朝哪",与用什么样的夹爪无关
说人话:
Object Pose描述的是"这个东西摆成什么样"
1-2-2 Grasp Pose
- 描述:机械夹爪应该以什么位置和姿态接近并抓取物体
- 它回答的是"手该往哪放",与物体自身的坐标系没有必然关系
说人话:
Grasp Pose描述的是"我的手该摆成什么样"
- 两者的区别可以列成一张表:
| 对比项 | Object Pose | Grasp Pose |
|---|---|---|
| 描述对象 | 物体自身的坐标系 | 夹爪的坐标系 |
| 数量 | 一个物体一个 | 一个物体通常有多个 |
| 是否依赖夹爪几何 | 不依赖 | 强依赖(指长、最大开口) |
| 由谁解出来 | 位姿估计 | 抓取检测 |
一个物体通常可以存在多个
Grasp Pose,也就是一个Object Pose可以对应多个可行的Grasp Pose
- 这一点在工程上很关键:物体只需要被定位一次,但抓取要反复挑,所以这两件事必须分开做
1-3 从物体几何到抓取位姿
- 上一期的做法可以概括为"先有几何,再算位姿":先用顺序
RANSAC加DBSCAN分出物体点云,再用PCA加扫描得到OBB,最后从OBB的三根轴里挑一根当作 approach 方向 - 这条链路有一个绕不开的代价:approach 被锁死在物体自身的对称轴上
- 圆柱就只能从正上方压下去,侧着夹这条路根本走不到
- 夹爪自身的几何(指长、最大开口)不参与决策,只有拿到位姿之后才在
grasp_execute里被发现"这个抓不了"
- 学习式方法换了个思路:不再显式恢复物体几何,而是把整片点云喂进网络,让网络逐点回归出"如果就在这里下爪,approach 朝哪、张开多大、这个抓取有多好"
说人话:传统法是"先量清楚物体的尺寸,再决定怎么夹";学习式是"看一眼点云,直接告诉你几个能夹的地方和各自的夹法"
2 GraspNet
2-1 介绍
GraspNet是 2020 年 CVPR 的工作,由上海交通大学发布,包含三部分:一个大规模数据集GraspNet-1Billion、一套评测 benchmark,以及一个 baseline 方法,它面向的是从 RGB-D 或点云中预测机器人抓取位姿的问题
核心目标可以概括为:输入一片点云,输出一组候选的 6-DoF 抓取位姿以及每个位姿的质量评分
- 本期部署的是官方 baseline(
graspnet-baseline)加 RealSense 版预训练权重,不重新训练
2-2 GraspNet的作用
- 输入输出可以讲得很具体,因为本期代码就是按这个格式对接的:
- 输入:相机帧下的一片点云,采到
20000个点,每个点是未归一化的 XYZ(单位米) - 输出:一个
GraspGroup,每一行 17 个数
- 输入:相机帧下的一片点云,采到
- 这 17 个数的排布(
graspnetAPI的约定)如下表:
| 序号 | 字段 | 含义 |
|---|---|---|
| 0 | score | 质量分 |
| 1 | width | 夹爪张开宽度(m) |
| 2 | height | 夹爪指厚,固定 0.02 |
| 3 | depth | 抓取深度(m) |
| 4 ~ 12 | rotation_matrix | R R R 按行展开的 9 个数 |
| 13 ~ 15 | translation | 接触点 t t t(m) |
| 16 | object_id | 物体编号,baseline 里恒为 -1 |
- 表里有三个字段值得单独说一句:
height恒为0.02—— 这是一个写死的常量,网络不预测它,因为平行夹爪的指厚本来就与物体无关object_id恒为-1,因为 baseline 做的是无物体标签的抓取检测,它根本不知道场景里有几个物体width不能当物体的真实宽度用:数据集里有一部分抓取的宽度是按夹爪的常用开口标注的,标注者并没有逐个去量物体,所以网络回归出来的是"标注习惯"而不是几何宽度(展开见 2-4-3 节)
- 在代码里,这 17 个数是
pred_decode拼出来的:
# models/graspnet.py —— pred_decode 的最后一步
grasp_height = 0.02 * torch.ones_like(grasp_score)
obj_ids = -1 * torch.ones_like(grasp_score)
grasp_preds.append(torch.cat([grasp_score, grasp_width, grasp_height, grasp_depth,
                              rotation_matrix, grasp_center, obj_ids], axis=-1))
2-3 为什么一个物体要预测很多 grasp
- 因为一个物体通常存在多个合理的抓取方式:
- 正方体六个面都能抓
- 圆柱既可以侧面夹,也可以从顶上压
- 同一个面上把夹爪转个角度,也还是能夹
- 这就是为什么
GraspNet输出的本质是 Grasp Proposal,而不是一个确定的答案 - 更实际的原因是:单点预测没有容错
- 网络在种子点上回归出的 approach 只保证几何上合理,不保证机械臂能到达、也不保证不撞桌子
- 给出一批候选,后面才有用碰撞检测、
NMS这些手段去筛的余地
说人话:一次只报一个答案,报错了就没得救;报一批,才有后面挑挑拣拣的机会
- 这里顺带说明一下
score的性质:它是grasp_score乘上归一化容差之后的回归值,可以大于 1,因此并不具备概率的含义- 概率不会超过
1,也不会由这样两项相乘得来;训练时它是拿去做回归的目标,不是分类层的输出
- 概率不会超过
- 更要紧的是,它的绝对水平取决于这一帧的输入分布:点云密度、物体大小、视角、遮挡,都会把这一帧的所有分数整体抬高或压低
- 所以排序、取 top-K 必须在同一帧内做,跨帧比大小没有意义
- 因此也不能设一个绝对阈值当门槛(比如"大于
0.8才抓"),这个数换一帧、换一个场景就不再成立 - 更不能把它当置信度去加权、去融合多帧
说人话:这一帧里的分数只在这一帧里能排座次;出了这一帧,
0.7与0.8谁高谁低说明不了什么
2-4 网络结构与抓取候选生成
- baseline 的网络分成两级,代码里对应
GraspNetStage1与GraspNetStage2:
| 级 | 模块 | 作用 |
|---|---|---|
| Stage 1 | Pointnet2Backbone + ApproachNet | 抽特征,逐点判断"这里能不能抓",并选一个 approach 视角 |
| Stage 2 | CloudCrop + OperationNet + ToleranceNet | 在种子点的局部圆柱里回归具体抓取参数 |
2-4-1 Point Cloud Feature Extraction
- 特征提取用的是
PointNet++,四层SA(Set Abstraction)逐级降采样:
| 层 | 点数 | 球半径(m) | 邻域点数 |
|---|---|---|---|
| sa1 | 2048 | 0.04 | 64 |
| sa2 | 1024 | 0.10 | 32 |
| sa3 | 512 | 0.20 | 16 |
| sa4 | 256 | 0.30 | 16 |
- 之后走一次
FP(Feature Propagation)把特征传回sa2的那1024个点,这1024个点就是后续的种子点- 为什么是
sa2而不是更浅的层:种子点要足够密才能覆盖小物体,但又要足够少,才不至于让后面的圆柱采样把显存撑爆
- 为什么是
说人话:这四层做的事就是"从两万个点里挑出一千个代表点,每个代表点带一段能描述它周围形状的特征"
2-4-2 Grasp Prediction
- 拿到种子点特征之后,网络在每个种子点上做两件事:
ApproachNet:输出objectness(这个点能不能抓)与view_score(300个候选视角各自的分数),取分数最高的那个视角当作 approach 方向CloudCrop:以种子点为中心,沿选中的 approach 方向划一个半径0.05 m的圆柱,按[0.01, 0.02, 0.03, 0.04]四个深度切成四层,每层采64个点
- 圆柱里采到的点再送进
OperationNet与ToleranceNet,输出:- 面内旋转角分成
12类,宽度、容差按角度一起回归 - 深度分成
4类,正对应上面那四个深度层
- 面内旋转角分成
说人话:先在每个点上选一个"从哪个方向伸手"的视角,再在这个方向的圆柱空间里量一下"手指张多开、伸多深、转多少度"
- 这一步也解释了网络输出为什么天然是"逐点一组"的:每个种子点先选出唯一一个最可信的视角,再在其中取角度与深度的最大值,所以每个种子点最后最多只留下一个候选 ——
1024个种子点,候选数的上限就是1024
2-4-3 Grasp Proposal Processing
pred_decode负责把这些分类与回归结果拼回成抓取,关键几行是:
# models/graspnet.py —— 角度、深度、宽度、分数的解码(以下每行都在 for i in range(batch_size) 内)
grasp_angle = grasp_angle_class.float() / 12 * np.pi      # 12 分类取弧度
grasp_depth = (grasp_depth_class.float() + 1) * 0.01      # 4 分类取 0.01~0.04 m
grasp_width = 1.2 * end_points['grasp_width_pred'][i]     # 宽度回归,带 1.2 倍修正
grasp_width = torch.clamp(grasp_width, min=0, max=GRASP_MAX_WIDTH)   # GRASP_MAX_WIDTH = 0.1
grasp_score = grasp_score * grasp_tolerance / GRASP_MAX_TOLERANCE    # 容差乘进分数
-
这几行在源码里不是平铺的,它们跨了三个阶段,顺序不能打乱:
- 先在
12个角度类上取argmax。源码写的是torch.argmax(grasp_angle_class_score, 0),这个dim=0指的是角度类 —— 因为grasp_angle_class_score上一步已经用[i]切掉了 batch 维 - 按选中的角度类
gather出分数、宽度与容差;深度档位同样是argmax出来的(用grasp_score在深度维上取,没有独立的深度分类头),再按它gather一次 - 用
objectness掩码把这一批里"不能抓"的点整体剔掉(grasp_score = grasp_score[objectness_mask]),然后才轮到"容差乘进分数"这一行
- 先在
-
上面这段代码省略了样本下标
[i](只有宽度那一行是源码里本来就有),因为源码是逐样本循环处理,其余几行的[i]在进入这一段之前就已经切掉了 -
到这里网络的事就做完了,它给出的是一大堆未经筛选的候选
2-5 抓取候选后处理
2-5-1 Grasp Candidates
- 上一步拿到的
GraspGroup数量上限由种子点数决定(1024),但其中大部分是不能用的 - 后处理按顺序做三件事:碰撞检测、
NMS、按分数排序 - 本项目里这一步对应
grasp_detector.py的detect()末尾这几行:
# graspnet_ros/grasp_detector.py
if self.run_collision and len(gg) > 0:
    from collision_detector import ModelFreeCollisionDetector
    mfcdetector = ModelFreeCollisionDetector(cloud_cam, voxel_size=self.collision_voxel_size)
    collision_mask = mfcdetector.detect(
        gg, approach_dist=self.approach_dist, collision_thresh=self.collision_thresh)
    gg = gg[~collision_mask]
if len(gg) > 0:
    gg.nms()
    gg.sort_by_score()
2-5-2 Collision Detection(核心)
- 这是三步里最关键的一步,因为它直接决定抓取能不能真的执行下去
- 判据可以写成:
G v a l i d = G p r e d ∩ G c o l l i s i o n - f r e e G_{valid} = G_{pred} \cap G_{collision\text{-}free} Gvalid=Gpred∩Gcollision-free
ModelFreeCollisionDetector的做法是"无模型"的,不需要物体的 mesh:- 先把场景点云按
voxel_size体素下采样 - 再对每个抓取,按夹爪的真实几何划出四块区域:左指、右指、指根,以及沿 approach 方向平移
approach_dist的那段进刀空间(四块都还要限定在指厚范围内) - 统计每块区域内落进了多少场景点,算出 IoU,超过
collision_thresh就判为碰撞
- 先把场景点云按
- 进刀空间这一块很容易被忽略,但它才是最有用的:夹爪在到达接触点之前要先沿 approach 方向平移一段,这段路上如果杵着别的东西,抓取照样执行不了
说人话:不光要看"手指合拢时会不会夹到别的",还要看"手伸过去的路上会不会撞到别的"
- 这几句话落到代码上,核心只有一步:把场景点搬到夹爪自己的坐标系里,然后数每块区域落进了几个点
# graspnet-baseline/utils/collision_detector.py —— detect() 的几何核心(注释已压缩)
approach_dist = max(approach_dist, self.finger_width)   # 进刀空间至少留一指宽
targets = self.scene_points[np.newaxis, :, :] - T[:, np.newaxis, :]
targets = np.matmul(targets, R)      # 局部 x = approach,y = 两指闭合轴,z = 指厚

mask1 = ((targets[:, :, 2] > -heights/2) & (targets[:, :, 2] < heights/2))                # 指厚范围内
mask2 = ((targets[:, :, 0] > depths - self.finger_length) & (targets[:, :, 0] < depths))  # 指长范围内
mask3 = (targets[:, :, 1] > -(widths/2 + self.finger_width))                              # 左指外沿
mask4 = (targets[:, :, 1] < -widths/2)                                                    # 左指内沿
mask5 = (targets[:, :, 1] < (widths/2 + self.finger_width))                               # 右指外沿
mask6 = (targets[:, :, 1] > widths/2)                                                     # 右指内沿
mask7 = ((targets[:, :, 0] <= depths - self.finger_length)                                # 指根
         & (targets[:, :, 0] > depths - self.finger_length - self.finger_width))
mask8 = ((targets[:, :, 0] <= depths - self.finger_length - self.finger_width)            # 进刀空间
         & (targets[:, :, 0] > depths - self.finger_length - self.finger_width - approach_dist))

left_mask     = (mask1 & mask2 & mask3 & mask4)
right_mask    = (mask1 & mask2 & mask5 & mask6)
bottom_mask   = (mask1 & mask3 & mask5 & mask7)
shifting_mask = (mask1 & mask3 & mask5 & mask8)
global_mask   = (left_mask | right_mask | bottom_mask | shifting_mask)

# 分母取每块区域按体素边长折算出来的等效点数(按包围盒体积算会偏大)
volume = left_right_volume*2 + bottom_volume + shifting_volume
global_iou = global_mask.sum(axis=1) / (volume + 1e-6)
collision_mask = (global_iou > collision_thresh)
-
有两点从这里能看得很清楚:
- 局部坐标系的
x就是 approach 轴、y就是两指闭合轴 —— 与第 1 章讲的列号约定是同一件事,只不过这里是第三方库自己的约定,那边是GraspNet输出的旋转矩阵 - IoU 的分子是"落进区域内的点数"、分母是"区域体积除以
voxel_size的三次方",两边都折算成点数,所以整套判断完全建立在点云计数上,不需要物体 mesh
- 局部坐标系的
-
还有一处细节值得留意:
mask2里手指沿 approach 轴的位置由预测出来的depths决定,mask3到mask6的张开宽度由预测出来的widths决定 —— 但手指自己有多长、多厚,仍然是写死的,见下 -
本项目取的参数是:
| 参数 | 取值 | 说明 |
|---|---|---|
collision_voxel_size | 0.01 | 场景点云体素边长(m) |
collision_thresh | 0.01 | 碰撞 IoU 阈值 |
approach_dist | 0.05 | 进刀平移距离(m) |
- 有一处要知道的近似:
ModelFreeCollisionDetector内部的指宽与指长是写死的(finger_width = 0.01、finger_length = 0.06),并不跟随抓取预测出来的width与depth
2-5-3 NMS
- 对深度学习熟悉的朋友应该不陌生,
NMS(Non-Maximum Suppression,非极大值抑制)一般用来去掉互相重叠的重复检测结果- 在目标检测里,"重叠"是用两个框的
IoU来量的:交并比超过阈值,就认为它们指的是同一个物体,只留分数高的那个 - 但抓取预测没有"框"这个几何量,算不了
IoU。所以抓取这边的"重叠"得换一种量法:接触点离得够近,同时姿态也够接近 - 网络是逐点预测的,相邻种子点会给出几乎一样的抓取,直接排序会让 top-10 里全是同一个位置的复制品
- 在目标检测里,"重叠"是用两个框的
graspnetAPI的nms用两个阈值判断"是不是同一个抓取":
| 参数 | 默认值 | 含义 |
|---|---|---|
translation_thresh | 0.03 | 接触点距离小于它就认为位置重复(m) |
rotation_thresh | 30° | 旋转差小于它就认为姿态重复 |
- 它是按分数从高到低遍历的贪心抑制:保留分数最高的那个,再把与它"位置够近且姿态够近"的其余抓取全部删掉
- 这一节没法像别处那样贴整段实现,因为
GraspGroup.nms()自己只有两行 —— 真正干活的是grasp_nms那个 C++ 扩展:
# graspnetAPI/grasp.py —— GraspGroup.nms
from grasp_nms import nms_grasp
return GraspGroup(nms_grasp(self.grasp_group_array, translation_thresh, rotation_thresh))
- 注意第二行:它
return的是一个新建的GraspGroup,self一个字节都没改。这一点与下一节的sort_by_score()恰好相反,两句连写的时候特别容易踩
2-5-4 Score Sorting
gg.sort_by_score()按score降序排列- 这一步看着平平无奇,但它是后面 top-1 能工作的前提 ——
GraspGroup的切片不会自动排序,不显式排一次,gg[0]拿到的就是任意一个候选
- 这一步看着平平无奇,但它是后面 top-1 能工作的前提 ——
- 它内部做的事情就是把那个
(M, 17)的大数组重排一遍:
# graspnetAPI/grasp.py —— GraspGroup.sort_by_score
score = self.grasp_group_array[:, 0]     # 第 0 列就是 score
index = np.argsort(score)
if not reverse:
    index = index[::-1]                  # 默认 reverse=False,从高到低
self.grasp_group_array = self.grasp_group_array[index]
return self
- 顺带一个容易踩的点:
sort_by_score()是原地改自己的数组并return self—— 它和nms()的方向正好相反。nms()返回新对象、不动self,sort_by_score()动self、返回的又是self- 所以
gg.sort_by_score()这两句怎么写都对(原地改生效了,返回值也是同一个对象);gg.nms()就必须写成gg = gg.nms(),不接返回值等于白算 return self的用处是链式调用,比如gg = gg.nms().sort_by_score()—— 拿nms()的新对象接着排序
- 所以
- 还有一点要留意:
score只在同一帧内有可比性,跨帧比大小没有意义,因为它是回归出来的量而不是概率
2-5-5 Top-K
- 最后取前
top_k个(本项目top_k = 10)发布出去,其中 top-1 单独作为/best_grasp- 为什么留 10 个而不是留 1 个:
GraspNet的排序里没有考虑机械臂的运动学可达性与当前位形,屏幕上同时看到几个候选,我们才知道"这一批里有没有能用的"
- 为什么留 10 个而不是留 1 个:
2-6 GraspNet 的评价指标
- benchmark 里用到的指标有四个:
| 指标 | 含义 |
|---|---|
| Grasp Success | 抓取执行之后,物体是否真的被抬了起来 |
| Collision | 夹爪与场景是否发生碰撞 |
| Grasp Quality | 用解析力闭合算出的抓取质量 |
| AP(Average Precision) | 不同摩擦系数、不同碰撞容忍度下的平均精度 |
- 其中
AP是主指标,官方会同时报告三个版本: AP μ \text{AP}_\mu APμ 对应摩擦系数、 AP α \text{AP}_\alpha APα 对应碰撞容忍度、 AP β \text{AP}_\beta APβ 对应是否允许使用物体的先验知识 - 本期不做重新训练,所以这些指标在这里的作用是理解 baseline 的能力边界,不参与本项目的流程
2-7 GraspNet 数据集
- 数据集叫
GraspNet-1Billion,规模如下:
| 项目 | 规模 |
|---|---|
| 采集场景 | 190 个杂乱堆叠场景 |
| RGB-D 图像 | 97,280 张 |
| 物体 | 88 类日常物体 |
| 抓取标注 | 超过 11 亿个 |
- 场景里的物体来自三部分:
32个YCB物体、13个DexNet 2.0的对抗性物体、以及43个新采集物体,在形状、纹理、尺寸、材质上都尽量拉开- 数据按
100个训练场景、90个测试场景划分,测试集又细分成三种:训练时完全没见过的物体、见过相似但不同实例的物体、以及见过的物体 - 至于为什么叫 1Billion:因为标注的抓取位姿总数超过十亿,比此前同类的抓取数据集高出好几个数量级
- 数据按
- 这些标注全部由解析力闭合对每个物体自动算出,无需人工标注,所以同一片点云里每个可抓的位置都有标注,密度极高
3 部署GraspNet
3-1 仓库介绍
- 需要三样东西,来源各不相同:
| 组件 | 来源 | 作用 |
|---|---|---|
graspnet-baseline | 官方 GitHub | 网络定义、pred_decode、碰撞检测器 |
graspnetAPI | 官方 GitHub | GraspGroup、Grasp、可视化与评测工具 |
checkpoint-rs.tar | 官方下载 | 预训练权重 |
- 三者的分工要分清楚,否则后面排错会很难:
graspnet-baseline提供的是模型代码,它不依赖 ROS,我们只把它当作只读的代码来源graspnetAPI提供的是数据结构与工具,GraspGroup这个类就在里面,pred_decode的输出要靠它才能变成能切片、能排序的对象- 权重文件是模型参数的快照,必须与代码版本对得上
- 三者的落点并不完全一样:
graspnet-baseline源码与权重文件要留在~/graspnet_ws下随时被引用(与moveit2_ws完全分开,这样 ROS 工作区重编译不会波及模型环境);graspnetAPI是pip install .装进 Python 环境的,装完之后那份 clone 下来的源码树留下来还是删掉都不影响运行 —— 代码里from graspnetAPI import GraspGroup找的是装好的包
3-2 下载与clone
- 按顺序执行,注意路径里不能有中文,
torch的 CUDA 扩展编译和加载都会炸:
mkdir -p ~/graspnet_ws && cd ~/graspnet_ws

# 1. 官方 baseline(模型代码 + 碰撞检测器)
git clone https://github.com/graspnet/graspnet-baseline.git

# 2. 官方 API(GraspGroup / Grasp / 评测工具)
git clone https://github.com/graspnet/graspnetAPI.git
cd graspnetAPI && pip install . && cd ..

# 3. 预训练权重 checkpoint-rs.tar,放到 ~/graspnet_ws 下
pip install gdown
gdown https://drive.google.com/uc?id=1hd0G8LN6tRpi4742XOTEisbTXNZ-1jmk
- 然后是编译两个 CUDA 扩展,这一步是本项目里最容易卡住的地方:
cd ~/graspnet_ws/graspnet-baseline

# torch 扩展要用 CUDA 12.1 编译,而 PATH 上默认的 nvcc 是 11.8,必须先切过来
export CUDA_HOME=/usr/local/cuda-12.1
export PATH=/usr/local/cuda-12.1/bin:$PATH
export LD_LIBRARY_PATH=/usr/local/cuda-12.1/lib64:$LD_LIBRARY_PATH

cd pointnet2 && python3 setup.py install && cd ..
cd knn && python3 setup.py install && cd ..
- 这里踩过一个坑:两个扩展装完之后,直接
import pointnet2._ext会报libc10.so: cannot open shared object file - 这其实与安装无关:
torch的.so还没被加载进来 - 因为
grasp_detector.py在文件开头就import torch,走正常链路时不会遇到这个问题,只有在单独写脚本验证扩展时才会撞上 —— 先import torch再导扩展即可
3-3 graspnet_ws/graspnet-baseline仓库结构说明
- 我们实际用到的只是其中一部分:
graspnet-baseline/
├── models/
│   ├── backbone.py              # PointNet++ 主干,四层 SA 加一次 FP
│   ├── graspnet.py              # GraspNet / Stage1 / Stage2 / pred_decode
│   ├── modules.py               # ApproachNet、CloudCrop、OperationNet、ToleranceNet
│   └── loss.py                  # 训练用,本项目不碰
├── utils/
│   ├── collision_detector.py    # ModelFreeCollisionDetector,本项目直接 import
│   ├── data_utils.py            # 数据集读取
│   ├── label_generation.py      # 标注生成
│   └── loss_utils.py            # GRASP_MAX_WIDTH 与 GRASP_MAX_TOLERANCE 在这里
├── pointnet2/                   # CUDA 扩展:SA 与 FP 的 ball query 和 group
├── knn/                         # CUDA 扩展:k 近邻
└── demo.py                      # 官方单帧推理示例,我们的 grasp_detector.py 对照它写
- 有两个细节值得说明:
models/graspnet.py内部会自己往sys.path里append上层目录,所以官方demo.py能直接from graspnet import GraspNet。我们自己的包不在那个目录下,就需要显式把models/、utils/、pointnet2/、knn/都加进去ModelFreeCollisionDetector在utils/collision_detector.py里,而不在graspnetAPI里。graspnetAPI的文档里会提到它,但实现是跟着 baseline 走的
3-4 预训练权重graspnet_ws/checkpoint-rs.tar
- 官方提供了两个权重,本项目用的是
checkpoint-rs.tar:checkpoint-rs.tar:用 RealSense 数据训练的版本,官方说明里迁移性更好checkpoint-kn.tar:用 Kinect 数据训练的版本
- 权重文件里存了四项内容:
| 键 | 含义 |
|---|---|
model_state_dict | 模型参数,162 个张量 |
optimizer_state_dict | 优化器状态,推理用不到 |
epoch | 训练到第 18 个 epoch |
loss | 训练损失 |
- 网络本体并不大,
1.03 M参数,权重文件12 MB左右 - 加载时有一处要处理:官方权重可能是用
DataParallel训练的,state_dict的键会带module.前缀。加载函数会先检查并剥掉这个前缀,剥不掉再退回strict=False
3-5 graspnetAPI
graspnetAPI是GraspNet官方的 Python 工具包,把数据集读取、抓取结果的数据结构、评测指标与可视化这四件事收在一处 —— 分别对应graspnet.py的GraspNet、grasp.py的GraspGroup、graspnet_eval.py的GraspNetEval、以及utils/vis.py的vis6D与visAnno- 本项目装的是
graspnetAPI 1.2.11,直接从源码pip install .装到~/.local下 - 它提供的东西里,我们实际用到的只有三样:
| 类/函数 | 位置 | 用途 |
|---|---|---|
GraspGroup | graspnetAPI/grasp.py | 承载 pred_decode 的输出,提供切片、nms()、sort_by_score() |
Grasp | graspnetAPI/grasp.py | 单条抓取,暴露 rotation_matrix、translation、width、depth、score |
plot_gripper_pro_max | graspnetAPI/utils/utils.py | 官方可视化里那个夹爪网格,本项目的 RViz 夹爪就是照它复刻的 |
GraspGroup与Grasp的分工是这样:GraspGroup内部就是一个 ( M , 17 ) (M, 17) (M,17) 的numpy数组,gg[i]按整数下标切出一行,交给Grasp包装
说人话:
GraspGroup是"一整张表",Grasp是"表里的某一行"的包装
-
但这一行是拷出来的,不是引用:
GraspGroup的__getitem__走的是Grasp(self.grasp_group_array[index]),而Grasp.__init__的第一件事就是self.grasp_array = copy.deepcopy(args[0])- 所以
translation、rotation_matrix这些属性确实是"在那 17 个数里按位取出来的视图",但那是它手里那份副本内部的视图 —— 改gg[i].translation不会回写到gg的表里 - 要改某一行的位姿,得直接在
gg.grasp_group_array上动那一行,或者把改好的 17 个数重新组装回表里;"取一条出来就地改"在这里不管用
- 所以
-
值得一提的是
plot_gripper_pro_max里的四个常量,它们是夹爪的模型尺寸,不是场景参数,所以照搬官方数值即可:
# graspnetAPI/utils/utils.py —— plot_gripper_pro_max
height = 0.004        # 指厚
finger_width = 0.004  # 指宽
tail_length = 0.04    # 腕部长度
depth_base = 0.02     # 指根到接触点的基准深度
4 graspnet-ros
4-1 介绍
- 官方代码不能直接跑在 ROS 里,中间要有一个桥接包,这就是
graspnet_ros - 整个包只有五个 Python 文件,其中四个是节点主循环用到的,分工如下:
| 文件 | 职责 |
|---|---|
graspnet_node.py | ROS 节点本体:订阅点云、裁剪、调推理、发结果 |
grasp_detector.py | 推理封装:加载 baseline 模型与权重,点云进、GraspGroup 出 |
pointcloud_utils.py | 四个纯函数:点云转 numpy、齐次变换、裁剪、降采样采样 |
grasp_marker.py | 把抓取位姿转成 RViz 能显示的夹爪网格与箭头 |
offline_test.py | 离线冒烟测试:不开 ROS 也能跑一次推理,验模型与权重是否可用 |
-
最后一个
offline_test.py不进主循环,它是排错用的入口:缺省喂一个合成立方体点云,也可以用--cloud指定一帧真实点云,跑完打印推理耗时、候选数与 top-3 分数。排错顺序上它该排在gazebo前面 —— 模型加载不了、权重对不上,在它这里一眼就能看出来,不必先起仿真- 它的两个参数
--baseline_dir与--checkpoint_path的缺省值是绝对路径,换机器要按 3-2 节自己 clone 的位置改,或者每次显式传参
- 它的两个参数
-
节点的主循环
_loop是六步,每一步都对应一个具体的坑:
| 步 | 做什么 |
|---|---|
| 1 | /camera/depth/points 转成 (N,3) 的 float32 数组,单位米 |
| 2 | 查 camera_optical_frame 到 world 的 TF,在 world 系里按包围盒裁出桌面工作区 |
| 3 | 把裁完的点云再变回相机系 |
| 4 | 推理 |
| 5 | top-K 变换到 world 系 |
| 6 | 发布 /best_grasp 与 /grasp_poses |
- 第 2 步与第 3 步为什么要来回换两次参考系,是这一步最容易被看漏的地方:
- 裁剪必须在 world 系做 —— 我们想留下的是"桌面上方那一块空间",这是世界系里的一个长方体;在相机系里它是个斜的、随手臂乱动的盒子,没法用一个固定包围盒表达
- 但网络的输入必须是相机系 —— baseline 是在相机系点云上训练的,喂 world 系的点云进去,网络看到的"上方向"就变了
说人话:先在世界的坐标系里把桌面那一块切出来,再切回相机的坐标系喂给网络。切的是同一片点,只是换了两次参考系
- 发布的两个话题分工明确:
| 话题 | 类型 | 给谁用 |
|---|---|---|
/grasp_poses | visualization_msgs/MarkerArray | 人看,RViz 里那一堆夹爪 |
/best_grasp | grasp_interfaces/BestGrasp | 程序看,执行节点消费 |
/best_grasp里装了两样东西,而且是从同一个元组填出来的:- 顶层四个字段
pose、width、depth、score:就是 top-1,给历史上就存在的grasp_execute与grasp_obb用 candidates[]:同一批 top-K,按分数降序,给第五章的候选筛选用
- 顶层四个字段
- 为什么要多给一批候选,而不是只留 top-1:
GraspNet的 top-1 常常运动学上够不着 —— 实测那根立着的绿圆柱,照 top-1 算出来的悬停点直接报GOAL_STATE_INVALID(-27),整趟抓取失败- 而网络本来就已经把 top-K 的分数算出来了,同一批还画在
/grasp_poses里,扔掉纯属浪费
- 为什么不另开一条话题发候选表:
- 执行节点的全部前提是"触发那一刻一次读全,之后不再看"。位姿与候选表若分两条消息到达,不可能同帧,快照就会撕裂成"位姿是这一帧的、候选是上一帧的"
- 挂在同一条消息里,结构上就不可能不一致。完整理由写在
BestGrasp.msg的注释里
- 为什么不把顶层那四个字段换成候选表:
grasp_execute与grasp_obb都读它们,新字段是加出来的而不是换出来的,老代码一行没动
4-2 grasp_detector.py
-
它把 baseline 那套模型代码接起来,是整包里最核心的一个,分三部分:把路径接上、建网络、跑推理
-
第一部分是把 baseline 的目录塞进
sys.path,不然import graspnet、import collision_detector全都找不到:
# graspnet_ros/grasp_detector.py
def _setup_syspath(baseline_dir):
    """把 baseline 的 models/utils/pointnet2/knn 加进 sys.path。

    与 demo.py 一致:models/graspnet.py 内部会再 append ROOT_DIR/pointnet2/utils,
    utils/label_generation.py 会 append ROOT_DIR/knn,这里显式加全最稳。
    """
    for d in (baseline_dir,
              os.path.join(baseline_dir, 'models'),
              os.path.join(baseline_dir, 'utils'),
              os.path.join(baseline_dir, 'pointnet2'),
              os.path.join(baseline_dir, 'knn')):
        if d not in sys.path:
            sys.path.append(d)
- 第二部分建网络。这里的参数必须与权重对得上,其中
num_view尤其不能改:
# graspnet_ros/grasp_detector.py
def _build_net(baseline_dir, device):
    """构建 GraspNet 模型。num_view 锁 300(baked into checkpoint,不可调)。"""
    _setup_syspath(baseline_dir)
    from graspnet import GraspNet, pred_decode
    net = GraspNet(input_feature_dim=0, num_view=300, num_angle=12, num_depth=4,
                   cylinder_radius=0.05, hmin=-0.02,
                   hmax_list=[0.01, 0.02, 0.03, 0.04], is_training=False)
    net.to(device)
    return net, pred_decode
-
这几个数正好对应第二章讲过的网络结构:
num_view=300是ApproachNet的视角分类数num_angle=12是面内旋转的分类数num_depth=4与hmax_list是那四个深度层
-
为什么
num_view不能改:ApproachNet最后一层的输出维度由它决定,改了就与权重里那一层的形状对不上,加载直接报错 -
权重加载要处理一个历史遗留问题:
# graspnet_ros/grasp_detector.py —— class GraspDetector 的方法(缩进照源码,下同)
    def _load_checkpoint(self, checkpoint_path):
        ckpt = torch.load(checkpoint_path, map_location='cpu')
        state_dict = ckpt['model_state_dict']
        # DataParallel 训练可能带 module. 前缀,strip 掉再加载
        if any(k.startswith('module.') for k in state_dict):
            state_dict = {k.replace('module.', '', 1): v for k, v in state_dict.items()}
        try:
            self.net.load_state_dict(state_dict)
        except RuntimeError as e:
            print(f"[grasp_detector] strict load failed ({e}); retry strict=False")
            self.net.load_state_dict(state_dict, strict=False)
-
官方权重是用
DataParallel训练的,state_dict的键会带一层module.前缀。本项目不用DataParallel,所以要先剥掉;剥不掉再退回strict=False -
第三部分就是
detect(),五步走完得到一张排好序的候选表:
# graspnet_ros/grasp_detector.py —— GraspDetector.detect
    def detect(self, cloud_cam, num_point=20000, voxel_size=0.005):
        from graspnetAPI import GraspGroup
        if len(cloud_cam) < 64:
            return GraspGroup()
        cloud_sampled = downsample_and_sample(cloud_cam, voxel_size, num_point)
        with torch.no_grad():
            end_points = {'point_clouds': torch.from_numpy(cloud_sampled)[None].to(self.device)}
            end_points = self.net(end_points)
            grasp_preds = self.pred_decode(end_points)
        gg_array = grasp_preds[0].detach().cpu().numpy()
        gg = GraspGroup(gg_array)

        if self.run_collision and len(gg) > 0:
            from collision_detector import ModelFreeCollisionDetector
            mfcdetector = ModelFreeCollisionDetector(cloud_cam, voxel_size=self.collision_voxel_size)
            collision_mask = mfcdetector.detect(
                gg, approach_dist=self.approach_dist, collision_thresh=self.collision_thresh)
            gg = gg[~collision_mask]
        if len(gg) > 0:
            gg.nms()
            gg.sort_by_score()
        return gg
-
这五步与第二章 2-5 节讲的后处理完全对应:下采样到
20000点、前向、pred_decode拼回 17 个数、ModelFreeCollisionDetector剔碰撞、nms()去重、sort_by_score()排序 -
有一处顺序值得留意:碰撞检测用的是下采样之前的原始点云(
cloud_cam,不是cloud_sampled)。碰撞判据是"这块空间里落进了多少场景点",点越密判得越准,所以用原云 -
这个函数的
docstring里特意记了一条列号约定,正是 1-1 节强调过的那个坑:
"""cloud_cam: (N,3) float32 相机帧点云(米),返回已 nms 并排序的 GraspGroup。

与 demo.py 一致:网络输入是相机帧原始 XYZ;输出行格式
[score, width, height, depth, R9(row-major), t3, object_id],
其中 R 列 0 = approach 轴,列 1 = 夹爪闭合轴。

列号是实测确认的(这里原来写的是列 2,是错的):graspnetAPI 的
plot_gripper_pro_max 把左右指的偏置写在局部 y 上
(`left_points[:,1] -= width/2 + finger_width`)再 `R @ v`,所以指间距量在 R 的
第 1 列上;grasp_marker.py 画出来的夹爪也另测过:两指质心连线与列 1 的点积
= ±1.000、与列 2 = 0.000。照列 2 去摆工具姿态会让真夹爪绕 approach 轴滚 90 度。
"""
- 这段
docstring先把结论写了,再把怎么确认的写在后面 —— 也就是 1-1 节说的那两条独立证据:官方绘制函数把左右指偏置加在局部 y 上,以及本项目自己画出来的夹爪两指质心连线与列 1 的点积为±1.000、与列 2 为0.000 - 顺带一提,
grasp_marker.py里还有两处旧docstring仍然写着"闭合轴是列 2"(是改列号之前留下的),以代码为准 —— 它里面的偏置同样加在局部 y 上
4-3 pointcloud_utils.py 与 grasp_marker.py
- 这两个是纯工具,一个管点云,一个管画图
pointcloud_utils.py只有四个函数,每个都是一次性转换:
| 函数 | 输入 | 输出 |
|---|---|---|
cloud_msg_to_numpy | sensor_msgs/PointCloud2 | (N,3) 的 float32 数组 |
transform_points | 点集与 4x4 齐次矩阵 | 变换后的点集 |
crop_points_world | world 系点云与包围盒 | 盒内的点 |
downsample_and_sample | 点云、体素边长、目标点数 | 恰好 num_point 个点 |
- 有两处实现细节值得说:
# graspnet_ros/pointcloud_utils.py
def cloud_msg_to_numpy(msg, fields=('x', 'y', 'z')):
    """sensor_msgs/PointCloud2 转 (N,3) float32,跳过 NaN/Inf。"""
    pts = point_cloud2.read_points(msg, field_names=list(fields), skip_nans=True)
    if pts.dtype.names:
        pts = np.stack([pts[f] for f in fields], axis=-1)
    return pts.astype(np.float32)
-
Humble 的
read_points返回的是结构化数组(按字段名组织),不是直接一个(N,3)矩阵,所以要按字段名逐列取出来再拼起来。这一步忘了写,后面所有维度操作都会莫名其妙地对不上 -
skip_nans=True会同时滤掉深度图里的无效像素。不滤的话NaN会一路传进网络,输出全变NaN,而且不报错 -
另一处是采样:
# graspnet_ros/pointcloud_utils.py
def downsample_and_sample(cloud, voxel_size, num_point, rng=None):
    """open3d 体素下采样后,随机采样到 num_point 点(不足则放回采样补齐)。"""
    if len(cloud) == 0:
        return np.zeros((num_point, 3), dtype=np.float32)
    pcd = o3d.geometry.PointCloud()
    pcd.points = o3d.utility.Vector3dVector(cloud.astype(np.float32))
    if voxel_size > 0:
        pcd = pcd.voxel_down_sample(voxel_size)
    pts = np.asarray(pcd.points, dtype=np.float32)
    rng = rng if rng is not None else np.random
    if len(pts) >= num_point:
        idx = rng.choice(len(pts), num_point, replace=False)
    else:
        idx1 = np.arange(len(pts))
        idx2 = rng.choice(len(pts), num_point - len(pts), replace=True)
        idx = np.concatenate([idx1, idx2])
    return pts[idx]
-
体素下采样是为了把点的分布拉均匀(深度图近处密、远处稀),随机采样是为了凑够网络要求的固定点数
-
点不够时用放回采样补齐,而不是补零:补零会造出一堆落在原点上的假点,网络会把它们当成真实几何去回归
-
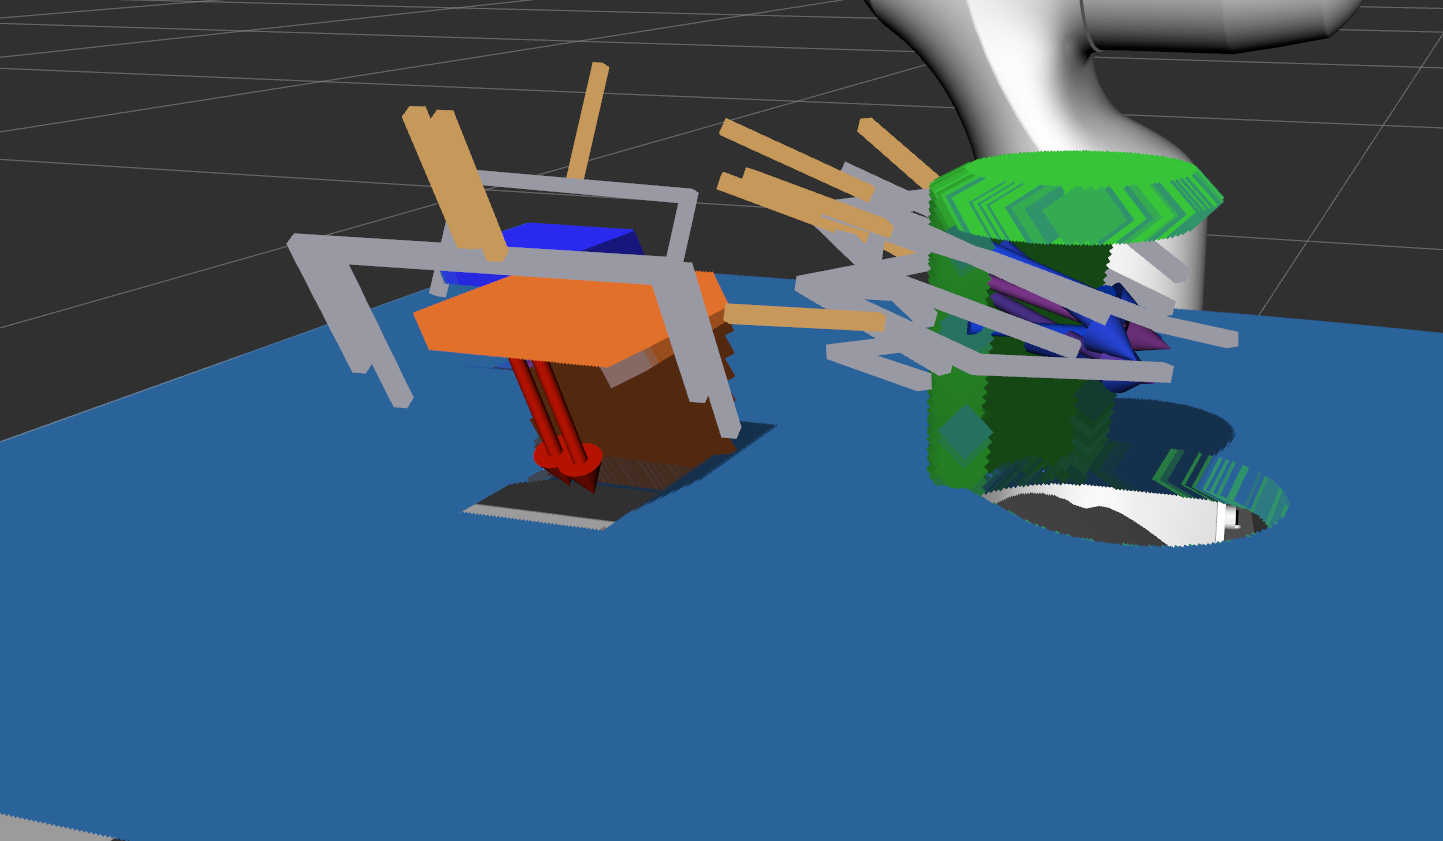
grasp_marker.py干的事是把一个抓取画成 RViz 里的两样东西:
| 命名空间 | 内容 |
|---|---|
gripper 与 gripper_best | 夹爪实体(TRIANGLE_LIST),4 个盒子拼出来 |
grasp 与 grasp_best | approach 箭头(ARROW,长 0.06 m) |
- 带
_best后缀的那两个单独装 top-1。分命名空间是为了在 RViz 的MarkerArray面板里按Namespaces单独勾选 —— 只留最佳,把其余候选关掉 - 夹爪实体照抄
plot_gripper_pro_max,用四个盒子(左指/右指/指根/腕部)拼出来 —— 拼出真实形状,才看得出夹爪会不会捅到桌面:
# graspnet_ros/grasp_marker.py —— 与 graspnetAPI.utils.utils.plot_gripper_pro_max 逐项一致
GRIPPER_HEIGHT = 0.004   # 指厚(局部 z)
FINGER_WIDTH = 0.004     # 指宽(局部 y)
TAIL_LENGTH = 0.04       # 腕部长度
DEPTH_BASE = 0.02        # 指根到接触点的基准深度
-
为什么值得一比一复刻:这个形状本身是有信息量的 —— 一眼就能看出手指会不会捅到桌面、指根离接触点有多深
-
颜色分工也定了规矩:分数只染箭头,不染夹爪
- 分数在当帧 top-K 的区间里归一化(蓝是低分、红是高分)。因为
score是回归值,top 几个常常全在0.9以上,直接映射会全部饱和成红色,看不出区分 - 夹爪用中性灰加部件深浅,指根单独给暖色。形状信息不该被分数色糊掉
- 分数在当帧 top-K 的区间里归一化(蓝是低分、红是高分)。因为
-
每一帧发之前都要先发一个
DELETEALL清场,否则上一帧的夹爪会一直堆在那里
4-4 参数配置
- 参数文件
config/graspnet_params.yaml:
# graspnet_ros 节点参数
# 用 /**: 前缀,任意节点名都可读到(launch 里节点名是 graspnet_node)
/**:
  ros__parameters:
    # graspnet-baseline 仓库根目录(必须 ASCII 路径,中文路径会炸 torch 扩展编译/加载)
    baseline_dir: /home/lzh/graspnet_ws/graspnet-baseline
    # 预训练权重:checkpoint-rs.tar(RealSense 版本,官方建议迁移性更好)
    checkpoint_path: /home/lzh/graspnet_ws/checkpoint-rs.tar

    # 网络输入点数(与训练一致,num_view 锁 300 由代码写死)
    num_point: 20000
    # 网络前体素下采样(米);0 = 不降采样
    voxel_size: 0.005

    # 发布的 top-K 抓取数量 / 推理循环频率(Hz)
    top_k: 10
    rate_hz: 1.0

    # 碰撞过滤(graspnetAPI ModelFreeCollisionDetector)
    run_collision: true
    collision_voxel_size: 0.01
    collision_thresh: 0.01
    approach_dist: 0.05

    # 桌面工作区裁剪盒(world 帧;pick_place.world:桌顶 z=0.20)
    crop_x_min: -0.10
    crop_x_max: 0.80
    crop_y_min: -0.35
    crop_y_max: 0.35
    crop_z_min: 0.19
    crop_z_max: 0.60
- 几组参数各自的用意:
| 参数组 | 用意 |
|---|---|
baseline_dir、checkpoint_path | 两个绝对路径,换机器必须改成自己 3-2 节 clone/下载的位置。路径里不能有中文,torch 的 CUDA 扩展编译与加载都会炸 |
num_point、voxel_size | 网络输入。num_point 必须与训练一致;voxel_size 是喂网络之前的体素下采样 |
top_k、rate_hz | 发多少个候选、多久推理一次 |
run_collision 及三个子参数 | 第二章 2-5-2 节那套 ModelFreeCollisionDetector 的取值 |
crop_* | world 系里的一个长方体,把桌面工作区框出来 |
-
有三样东西不在这个文件里,它们写死在
graspnet_node.py里:订阅的点云话题/camera/depth/points、可视化话题/grasp_poses、结果话题/best_grasp。要改话题名得改代码,改 yaml 是没用的 -
crop_*之所以做成参数、话题之所以写死,分界在于"换个场景要不要动它":裁剪盒跟着桌面与物体摆放走,换一张桌子就得重调;话题名跟的是这一期的固定数据流,写死反而少一处出错的地方 -
rate_hz: 1.0已经够用:相机不动时相邻帧的结果几乎一样,跑太快只是白烧 GPU -
裁剪盒的取值由场景决定,不是拍脑袋来的:
z_min: 0.19略低于桌顶z = 0.20,这样桌面本身也留在点云里 —— 网络需要看见支撑面,才知道"手伸到这儿会撞桌子"z_max: 0.60高于所有待抓物体,又不至于把远处的背景圈进来x与y的范围比桌面略大一圈,保证物体在边缘时也完整
-
z_min与桌顶只差1 cm这一条后面还会有用,它是第五章那套量宽度方法的前提之一
4-5 整体配置
- 最后是 launch 文件与总入口脚本。launch 很短,就是一个节点:
# graspnet_ros/launch/graspnet_demo.launch.py
import os

from ament_index_python.packages import get_package_share_directory
from launch import LaunchDescription
from launch_ros.actions import Node


def generate_launch_description():
    pkg_dir = get_package_share_directory('graspnet_ros')
    params_file = os.path.join(pkg_dir, 'config', 'graspnet_params.yaml')

    graspnet_node = Node(
        package='graspnet_ros',
        executable='graspnet_node',
        name='graspnet_node',
        output='screen',
        # use_sim_time 让 TF 按消息时间戳对齐(相机在仿真里)
        parameters=[params_file, {'use_sim_time': True}],
    )

    return LaunchDescription([graspnet_node])
-
use_sim_time在仿真里是必须的:点云的时间戳来自 Gazebo 的仿真时钟,TF 也是;节点自己的时钟若走的是墙钟,两边差着几十秒,lookupTransform会一直失败 -
总入口脚本
graspnet.sh多做了两件事,都是踩过坑之后加的:
#!/bin/bash
# 前置:./1_depth_gazebo.sh 已在跑(Gazebo + 眼在手相机 + octomap)
set -e

source /opt/ros/humble/setup.bash
source "$(dirname "$0")/install/setup.bash"
export LANG=C.UTF-8 LC_ALL=C.UTF-8

# 让 torch 扩展加载/运行找对 CUDA 12.1(PATH 上默认 nvcc 是 11.8)
export CUDA_HOME=/usr/local/cuda-12.1
export PATH=/usr/local/cuda-12.1/bin:$PATH
export LD_LIBRARY_PATH=/usr/local/cuda-12.1/lib64:$LD_LIBRARY_PATH

# 起之前先扫掉上一次留下的 graspnet_node。ros2 launch 被杀不会带走子进程,孤儿会被
# init 收养(父进程变 systemd --user)然后一直活着 —— 带着旧代码继续往 /best_grasp
# 上发。DDS 类型名相同时两个发布方并存,结构对不上的 payload 照样被订阅端接受,
# 于是新节点发的候选表被读成空的。
pkill -9 -f 'graspnet_ros/graspnet_node' 2>/dev/null || true

ros2 launch graspnet_ros graspnet_demo.launch.py
-
第一件是切 CUDA:本机
PATH上默认的nvcc是11.8,而两个 torch 扩展是用12.1编译的,不切过来加载会报版本不匹配 -
第二件是
pkill:ros2 launch被杀不会带走它的子进程,graspnet_node会被init收养然后一直活着,带着旧代码继续往/best_grasp上发 -
这个坑的现象很有迷惑性:DDS 的类型名相同,两个发布方并存不会报错,结构对不上的
payload照样被订阅端接受,于是新节点发的候选表被读成空的 —— 表现为"代码明明改了却不起作用",很容易怀疑到代码上去 -
编译与运行:
cd ~/postgraduate1/VLA/moveit2_ws      # 换成你自己的工作区路径
colcon build --packages-select graspnet_ros --symlink-install
source install/setup.bash
./1_depth_gazebo.sh     # 终端 1:Gazebo + 相机 + octomap
./graspnet.sh           # 终端 2:GraspNet 检测节点
4-6 测试与可视化
-
可视化部分不用手动配:
moveit_camera.rviz里已经加好了/grasp_poses的MarkerArray显示 -
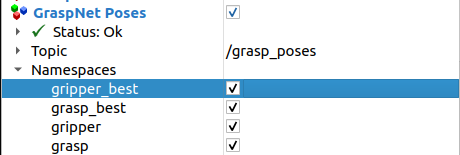
每个抓取画了两样东西,命名空间是分开的,可以在
MarkerArray的Namespaces面板里单独勾选:gripper与grasp:其余候选的夹爪实体与 approach 箭头gripper_best与grasp_best:top-1 的夹爪实体与 approach 箭头
-
可以勾选不同的
namespace -
-
默认情况下可以看到一对估计的爪子
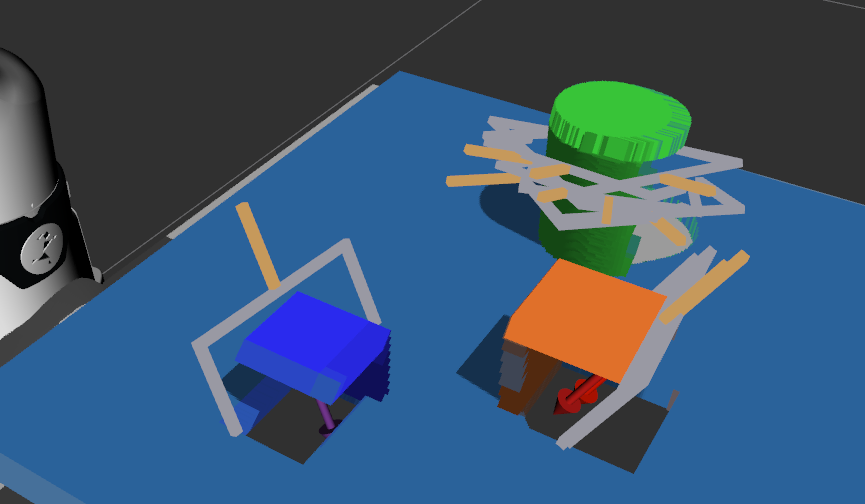
-
如果只勾选 best,我们就只会看到一个 grasp,本帧的 best 落在斜着的蓝色正方体上
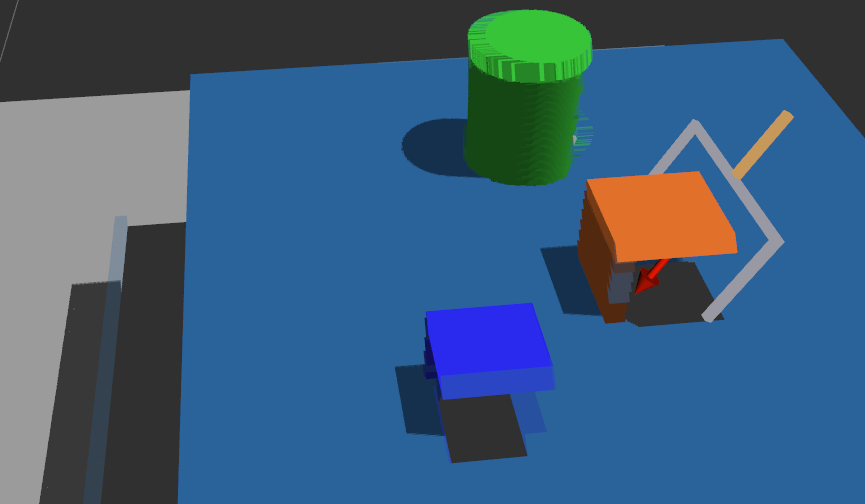
-
如果我们进一步删掉 Gazebo 里的蓝色正方体,best 就变成红色正方体了
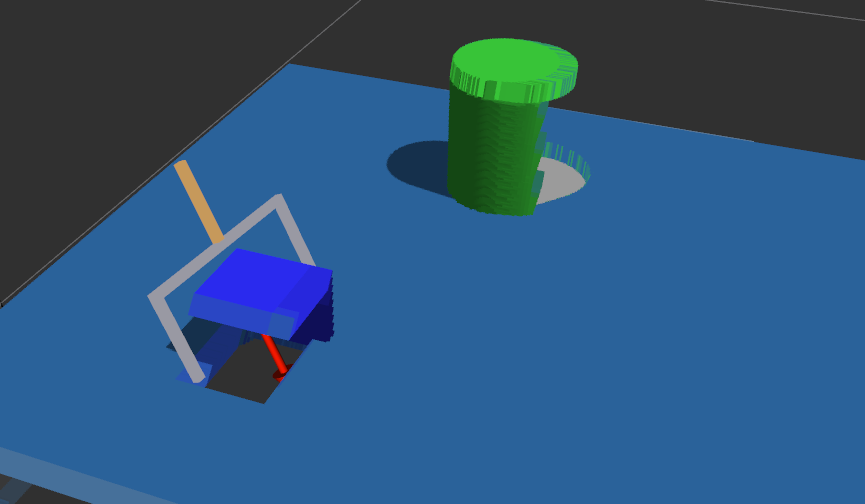
-
进一步删掉红色方块,只剩绿色圆柱,可以看到估计出的 best 是侧面抓取,这比我们上一期的 OBB 方案更科学
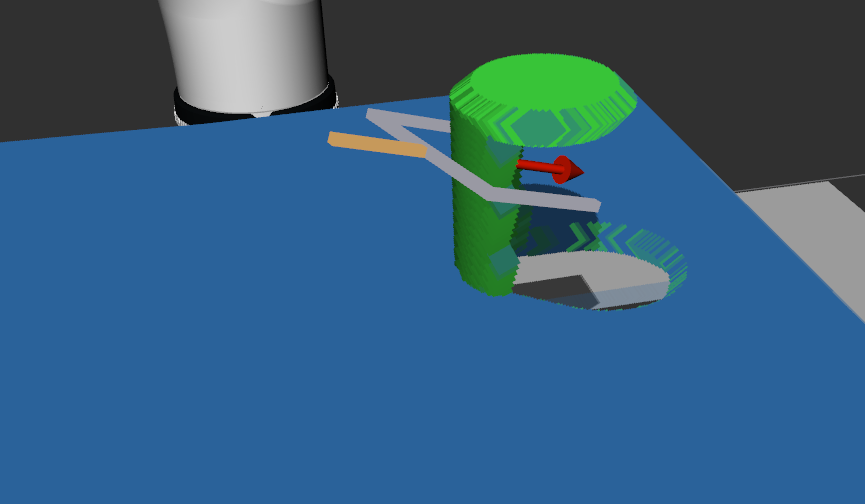
5 grasp-run对接夹取
5-1 点云不可观导致的best_grasp丢失问题
- 举个例子,如果是上面的绿色圆柱,可以看到估计出的 best 是侧面抓取,姿态是斜的
- 这时候如果复用之前的执行逻辑,机械臂一动起来,这个目标就会丢,整趟任务随之终止
- 根因在相机是眼在手的 —— 它硬挂在
panda_hand上,跟着手臂一起动:
| 时刻 | 相机看到的 | /best_grasp |
|---|---|---|
| 触发前(怠速位) | 桌面上的三个物体 | 稳定发着同一个抓取 |
| 手臂开始移动 | 视角持续在换 | 1 Hz 刷新,内容跟着变 |
| 手臂移到物体侧面 | 物体已经不在视野里 | 变成别的物体,或者干脆不发 |
graspnet_node是1 Hz不停刷新的,而一趟抓取要跑好几秒。这两个数字放在一起,结论就很清楚:边动边看在这个配置下根本不成立- 所以我们要做的第一件事,是在触发的那一刻把当前目标锁死。实现上就是两个独立的成员:
| 成员 | 含义 | 什么时候更新 |
|---|---|---|
best_ | 最新一次观测 | /best_grasp 每来一帧就更新 |
committed_ | 已提交的目标 | 只在服务被调用的那一刻,从 best_ 拷一次 |
- 快照的代码只有一行,但它是整个节点存在的理由:
// grasp_run_node.cpp —— startCb
// 快照。从这一刻起 best_ 再怎么变都与这一趟无关。
committed_ = best_;
committed_valid_ = true;
- 还有一个必须一起快照的东西:点云
- 执行宽度是从点云现量的(见 5-2),而量宽度靠的是"接触点周围那一块"
- 相机眼在手,机械臂一动视角就换,晚一点量出来的就不再是触发那一刻那个物体的展布了,板里会混进别的东西
- 而且量宽度与预演只读点云、只做规划、不动机器人,所以可以直接放在服务回调里、动手之前同步做完。失败就直接返回,机械臂一动不动 —— 比"先挪过去再发现不行"安全得多
// grasp_run_node.cpp —— startCb:点云跟目标位姿一起快照
committed_cloud_ = latest_cloud_;
has_committed_cloud_ = has_cloud_;
说人话:先把目标和解算它要用的那帧点云一起拍张照片,之后全程只看这张照片,眼睛再看到什么都不算数
- 顺带一个小的工程点:触发服务用的是
std_srvs/Trigger,而不是自定义类型ros2 service call在任何终端都能调,不必先source本工作区的install/- 自定义类型做不到这点 —— 终端只 source 过
/opt/ros/humble/setup.bash时会报 “The passed service type is invalid”,报的是"类型名不认识",很容易误判成节点没起来
5-2 宽度估计与实机抓取的问题
5-2-1 问题描述
- 同时我们需要注意
GraspNet发布的爪子宽度只是 1B 模型训练时设定的一个数值,它与物体的真实宽度没有对应关系- 它回归的是数据集里标注者当时的开口,
pred_decode又在上面乘了一个1.2的安全系数 - 而
GraspNet自己那套夹爪的开口上限是GRASP_MAX_WIDTH = 0.1 m—— 整条链路里没有任何东西知道本机器人的夹爪只开到0.08 m
- 它回归的是数据集里标注者当时的开口,
但是!!! 真机上这一步不需要宽度:夹爪直接合到顶住物体,靠力控判断"夹到了",开口最终停在哪儿无所谓
-
我们的仿真没有这个通道,只能反过来 (其实理论上是可以维修的,但是太懒了)—— 从
best_grasp的 6D 位姿自己去量物体有多宽,也就是用眼睛代替手感 -
仿真之所以没有这个通道,根源是手指关节运动学驱动:
gazebo_ros2_control在没有位置 PID 时走的是Joint::SetPosition,直接瞬移关节位置- 不能上 PID 是因为这是 mimic 夹爪,两边互相追会出极限环(警告写在
panda_hand.ros2_control.xacro里) - 所以
GripperCommand返回的stalled与reached_goal完全反映不出有没有接触到物体 —— 手指是瞬移过去的,被挡住和没被挡住,这两个字段长一个样
-
量法的出发点是抓取位姿本身: R R R 的第 0 列是 approach 轴、第 1 列是闭合轴,这已经是一个现成的局部坐标系
5-2-2 解决方法
-
先把问题说清楚:要夹住物体,得先知道物体沿"两指合拢方向"有多宽,才能命令夹爪张那么宽再合上。网络给的宽度不能信(原因见 2-4-3 节,展开在 6-3 节),只能从点云里现量
-
难点在于接触点周围那一片点里不只有要抓的物体,还有桌面、旁边的物体,无从分辨哪些点算数。最直觉的做法是"取接触点周围 r r r 米内的点,量它们在闭合轴上的最大跨度",但 r r r 没有正确答案:
-
r
r
r 给
20 mm,球只圈住物体一角,量出来偏窄 -
r
r
r 给
80 mm,桌面被圈进来,量出来偏宽
-
r
r
r 给
-
既然没有对的 r r r,就不选固定的 r r r:让 r r r 从
15 mm一格一格涨到80 mm(width_scan_r_min/width_scan_r_max,步长width_scan_r_step),每涨一格量一次跨度,把整条曲线画出来。定义接触点 t t t、approach 轴 a a a、闭合轴 c c c( R R R 的第 0、1 列),以及球内落在"两指之间"那一段的点:
B ( r ) = { p ∈ P ∣ ∥ p − t ∥ ≤ r , − ( δ 0 + f ) ≤ ( p − t ) ⋅ a ≤ max ( d , 0.005 ) } B(r) = \{\, p \in P \;\big|\; \|p - t\| \le r,\;\; -(\delta_0 + f) \le (p - t)\cdot a \le \max(d,\, 0.005) \,\} B(r)={p∈P ∥p−t∥≤r,−(δ0+f)≤(p−t)⋅a≤max(d,0.005)}
s ( r ) = max p ∈ B ( r ) ( p − t ) ⋅ c − min p ∈ B ( r ) ( p − t ) ⋅ c s(r) = \max_{p \in B(r)} (p - t)\cdot c \;-\; \min_{p \in B(r)} (p - t)\cdot c s(r)=p∈B(r)max(p−t)⋅c−p∈B(r)min(p−t)⋅c
* 两个界都取自夹爪自己的模型尺寸,没有一个是场景常量:$-\delta_0 - f$ 是手指根部(`DEPTH_BASE` 加 `FINGER_WIDTH`),$d$ 是这个候选的抓取深度即指尖。球本身是三维的,不补这一刀的话它还会圈到物体下面和后面的点,那些地方夹爪根本碰不到
- s ( r ) s(r) s(r) 的形状是固定的,分三段:
s(r)
 |                                              # 球够到桌面,跨度开始暴涨
 |                                    ●
 |                          ●────●────●
 |                ●                              # 平台:球刚好把物体裹住
 |        ●
 |   ●
 +──┬───┬───┬───┬───┬───┬───┬───┬──> r  (mm)
   15  20  25  30  35  40  45  50
- 球小了:球只圈住物体的一部分,球越大圈进越多,跨度跟着涨
- 涨到某一格:球刚好把物体整个裹住。再往大涨,多出来的是空的地方(物体旁边没东西),跨度不再变 —— 这一段就是平台
- 再涨:球够到桌面,桌面点被圈进来,跨度又开始暴涨
说人话:手张开得刚好抱住它时,量到的是它;手张得太大,就把桌沿也抱进来了
- 所以平台上的那个跨度值就是物体宽度。平台不是我们定义的,是几何自己长出来的。写成公式就是取平台的起点,其中 τ \tau τ 是判"不再明显长"的相对容差:
r ∗ = min { r k + 1 ∣ s ( r k + 1 ) ≤ s ( r k ) ( 1 + τ ) , s ( r k + 2 ) ≤ s ( r k + 1 ) ( 1 + τ ) } , w = s ( r ∗ ) r^* = \min \{\, r_{k+1} \;\big|\; s(r_{k+1}) \le s(r_k)(1+\tau),\;\; s(r_{k+2}) \le s(r_{k+1})(1+\tau) \,\}, \qquad w = s(r^*) r∗=min{rk+1 s(rk+1)≤s(rk)(1+τ),s(rk+2)≤s(rk+1)(1+τ)},w=s(r∗)
* 判据要**往后看两格**才能确认"连着两步都没长":只看一格的话,某一格碰巧因为点云稀疏而没长,就会误判成平台开始。确认之后取的是被确认在平台里的 $r_{k+1}$,不取判据里第一个出现的 $r_k$。差这一格不是小事:一格就是 `5 mm` 的宽度差,折到闭合命令上是 `2.5 mm`
* 用相对比例而不是绝对毫米数,是因为绝对阈值会随物体尺寸失效 —— `2 mm` 对 `20 mm` 的小件是 `10%`,对 `80 mm` 的大件只有 `2.5%`,而本节点不该对"物体多大"有先验
-
为什么取起点、不取末端:平台是一段,不是一个点
- 起点是球刚好把物体裹严实的那一格,此时球里几乎干干净净只有物体
- 末端是平台里最后那一格。它的跨度还没明显涨(
5%的判据说"涨这点还算平台"),但球已经胀到碰桌面的边上,混进了少量桌面点,量出来偏高
-
这一点差别在数值上不留情面。取
50 mm的物体:5%的容差允许浮动2.5 mm,末端那格51.7 mm正好顶满;按 q c l o s e = w / 2 − ϵ q_{close} = w/2 - \epsilon qclose=w/2−ϵ(穿透量 ϵ = 0.5 \epsilon = 0.5 ϵ=0.5mm)算,两指张开2 × (51.7/2 - 0.5) = 50.7 mm,比物体还宽0.7 mm,每根手指停在离物体面0.35 mm处 —— 两指根本没有接触物体,抬起来时物体留在桌上 -
可见容差是判平台边界用的尺子,不是能在平台里随便挑的额度。穿透预算只有
0.5 mm,容差允许的浮动是2.5 mm,把它当额度花,预算先见底 -
蓝方块实测的曲线(下表是从日志里抽的几行):
| 半径 r r r | 展布 s ( r ) s(r) s(r) | 说明 |
|---|---|---|
30 mm | 50.0 mm | 球刚圈满物体,展布已经等于真值 |
45 mm | 51.1 mm | 仍在平台内部,略高于真值 |
60 mm | 51.7 mm | 平台末端,污染最重的一格 |
65 mm | 60.1 mm | 越过末端,桌面点大量涌进来 |
-
平台内部几乎不动(
50.0到51.1 mm),越过末端才暴涨(51.7到60.1 mm)。这也是平台为什么到此为止:接触点在z = 0.250、桌面在z = 0.200,球长到50 mm就够到桌面了 -
修法就是把取值从平台末端改成平台起点,找平台的判据不动:
// grasp_run_node.cpp —— 修改后
// 取平台的起点,不是平台的末端。
// 平台的起点是"球刚好圈满物体"的那一格,展布在那里就等于物体宽度;
// 再放大球只会把桌面/邻居圈进来,只会偏大,不会更准。
const double base = valid[start].span;
const double width = base;
-
平台延伸到何处为止现在只用于日志:越过它的那一步就是球开始触及桌面或邻近物体的位置,打印出来是为了在后续出问题时能分辨"平台定位有误"还是"点云本身有误"
-
有了宽度,闭合命令是:
q c l o s e = c l a m p ( w 2 − ϵ , 0.008 , q o p e n − m ) q_{close} = \mathrm{clamp}\left(\frac{w}{2} - \epsilon,\;\; 0.008,\;\; q_{open} - m\right) qclose=clamp(2w−ϵ,0.008,qopen−m)
* $w$ 是刚量得的宽度,$\epsilon$ 是 `grip_penetration`(`0.0005 m`),$q_{open}$ 是 `kGripperOpen`(单指行程 `0..0.04`,两指相对故最大开口 `0.08 m`),$m$ 是 `kCloseMargin`。上界取 $q_{open} - m$ 而不是 $q_{open}$,是因为 $q_{open}$ 正是 `OPEN` 命令的位置:闭合停在那里,`CLOSE` 就退化为原地不动,`reached_goal` 立即为真、动作报成功,而两指并未移动
* $\epsilon$ 必须很小。$w/2$ 恰是物体半宽,只相切不挤压就形不成夹持,所以要越过表面少许;但原因仍是上面那条运动学驱动 —— **这里根本没有力,穿透就是每 `10 ms` 把一根刚性手指置入刚性方块内部**,ODE 每步都要解算这一穿透并推出去,下一步又被置回原处,等于持续向求解器注入能量,实测取 `0.005` 时仿真整体停滞
说人话:穿透量是留给"手指能压实"的预算,可这份预算在仿真里是靠穿模换来的,给多了求解器直接罢工
5-3 修复规划器代码
- 对应我们在 0-2 的说明,我们需要修改规划器的选择
- 先回顾问题:前几期配置里,
panda_arm这个关节组没有配默认规划器ompl_planning.yaml里没写default_planner_config,于是 MoveIt 自己补一个名为panda_arm、类型geometric::RRTConnect的配置RRTConnect是关节空间采样规划器,它的代价函数是关节空间里的路径长度,里面没有"末端走直线"这一项- 结果是路径是接出来的,不是优化出来的 —— 某些关节来回摆、肘部乱翻都是允许的,而且它是随机的:同样两个点,每次跑出来的关节轨迹都不一样
- 这对抓取是实质问题,不是好不好看:
APPROACH段的语义是"沿 approach 轴推进5 cm"。用采样规划器,末端会划弧,也就是指尖在接触物体之前就有横向位移,可能把物体推走LIFT段同理,划弧相当于给刚夹住的物体加横向加速度,最容易掉件
- 怎么修:把
APPROACH与LIFT换成PILZ的LIN,PRE_GRASP那段自由空间转移仍留给OMPL
| 段 | pipeline | planner | 为什么 |
|---|---|---|---|
PRE_GRASP | ompl | 组默认(RRTConnect) | 只要求"能到",不关心末端轨迹形状,采样规划器最稳 |
APPROACH | pilz_industrial_motion_planner | LIN | 语义就是沿一条直线的平移,必须走直线 |
LIFT | pilz_industrial_motion_planner | LIN | 同上 |
- 这里的关键是"换规划器",而不是"自己算直线":
- 换
OMPL里别的 planner(RRT*、PRM*、SBL)没用 —— 它们全家都是关节空间采样,代价函数里同样没有"末端走直线" CHOMP、STOMP也一样,它们优化的是关节轨迹,平滑不等于末端直线- 要末端直线,必须换成以笛卡尔轨迹为优化对象的规划器,也就是 PILZ 的
LIN
- 换
- 代码上的修改是让 pipeline 与 planner 变成入参,由调用方传进来:
// grasp_run_node.cpp
void selectPlanner(const std::string & pipeline, const std::string & planner)
{
  move_group_->setPlanningPipelineId(pipeline);
  move_group_->setPlannerId(planner);
}
- 于是定下一条规矩:一段运动只能有一个设置点。
planAndExecute与planToPoseOnly都把 pipeline 与 planner 收成入参,设置这件事只在它们内部做一次 - 两条 pipeline 都必须由
move_group装进来,检查 launch 里的这一行:
# grasp_run.launch.py
.planning_pipelines(pipelines=['ompl', 'chomp', 'pilz_industrial_motion_planner'])
- 三条 pipeline 都传了,运行时直接可用。同一条
pilzpipeline 里还有PTP(点到点,不保证直线)与CIRC(圆弧),本节点不用 - 参数文件里
free_planner留空是故意的,不是漏填:OMPL 那边请求里planner_id为空时会退回该组的默认配置,也就是上面那个RRTConnect。想比对别的采样规划器,在这里填RRTstarkConfigDefault即可,不必改代码
5-4 完整核心代码实现
- 这一节把
grasp_run的核心几段完整贴出来。原文件带注释约1900行,下面保留全部逻辑,把那些长篇推导压成了短注 - 第一段是候选归一与两个结构体。归一是为了让下游只有一种形状:
// grasp_run_node.cpp —— 候选表归一:发布方填了就用,没填(grasp_obb)就退化成单候选
std::vector<grasp_interfaces::msg::GraspCandidate>
candidateList(const grasp_interfaces::msg::BestGrasp & bg) const
{
  if (!bg.candidates.empty()) {
    return bg.candidates;
  }
  grasp_interfaces::msg::GraspCandidate c;
  c.pose = bg.pose.pose;
  c.width = bg.width;
  c.depth = bg.depth;
  c.score = bg.score;
  return {c};
}

// 一次尝试的全部几何与数值。集中成一个结构体之后,"位姿"与"宽度"在类型上就是同一个
// 候选的两半,不可能出现"用 A 候选的位姿配 B 候选的宽度"。
struct Attempt
{
  int index = -1;                       // 候选表下标(0 = top-1)
  geometry_msgs::msg::Pose pose;        // 候选自己的接触点位姿(画 marker 用)
  Eigen::Quaterniond q_tool;            // 法兰姿态
  Eigen::Vector3d approach;             // 指尖方向(单位向量,指向物体内部)
  Eigen::Vector3d contact;              // 接触点 t
  Eigen::Vector3d grasp_pose;           // 下探到位时法兰该在的位置
  Eigen::Vector3d hover;                // 悬停点(物体外侧)
  Eigen::Vector3d lift;                 // 抬升到位点
  double depth = 0.0;                   // 该候选的 depth
  double width = 0.0;                   // 点云现量的执行宽度
  double width_net = 0.0;               // 发布方给的宽度,仅日志对照
  float score = 0.0f;
  bool orientation_from_msg = false;    // false = 用了写死的顶视兜底
  std::string orientation_why;
};

// 一次选择的全部结果:被采用的候选 + 三条已经校验过的轨迹。
// 三条都要留着 —— 执行阶段只要重新规划,校验与执行就是两个不同的规划问题。
struct Selection
{
  Attempt attempt;
  moveit::planning_interface::MoveGroupInterface::Plan pre_grasp;   // OMPL 自由转移
  moveit::planning_interface::MoveGroupInterface::Plan approach;    // PILZ LIN 推进
  moveit::planning_interface::MoveGroupInterface::Plan lift;        // PILZ LIN 抬升
  bool have_linear_plans = false;
};
- 第二段由候选算出全部几何。位置全部沿 approach 轴推:
// grasp_run_node.cpp —— 候选转几何。contact = 接触点,approach 指向物体内部。
// finger_offset_ 是"法兰到指尖"沿工具轴的距离,所以要让指尖落在某点 p,法兰就摆在
// p - approach * finger_offset_。反推三处:
//   下探到位:指尖落在 contact + approach*depth,正是 RViz 里绿色夹爪画的位置
//   悬停点:  再从下探点沿 approach 轴退开 approach_dist_,即物体外侧
//   抬升点:  下探点的 z 加 lift_height_,方向是世界 +z(把物体搬离支撑面是场景语义)
bool prepare(const grasp_interfaces::msg::GraspCandidate & c, Attempt & out, std::string & why)
{
  out = Attempt();
  out.pose = c.pose;
  out.depth = graspDepth(c.depth);
  out.width_net = std::max(0.0, static_cast<double>(c.width));
  out.score = c.score;

  const geometry_msgs::msg::Pose & gp = c.pose;
  out.contact = Eigen::Vector3d(gp.position.x, gp.position.y, gp.position.z);

  Eigen::Quaterniond q_tool(0.0, 1.0, 0.0, 0.0);   // Rx(pi),指尖朝下
  Eigen::Vector3d approach(0.0, 0.0, -1.0);        // 与 Rx(pi) 一致:指尖方向 = world -z

  if (!hand_to_tip_ok_) {
    // 机器级问题:手相对法兰的变换量不到。每个候选都一样,退写死的顶视姿态。
    out.orientation_from_msg = false;
    out.orientation_why = "手相对法兰的变换未知(机器人模型里没量到)";
  } else {
    std::string owhy;
    if (!toolOrientation(gp.orientation, q_tool, approach, owhy)) {
      // 候选级问题:这个候选自己朝向退化。退顶视在这里是有害的 —— 那会让一个坏候选
      // 看起来"能用",还占掉一个名额。所以拒绝它,换下一个。
      why = "朝向退化(" + owhy + ")";
      return false;
    }
    out.orientation_from_msg = true;
  }

  out.q_tool = q_tool;
  out.approach = approach;
  out.grasp_pose = out.contact + approach * (out.depth - descend_gap_ - finger_offset_);
  out.hover = out.grasp_pose - approach * approach_dist_;
  out.lift = Eigen::Vector3d(out.grasp_pose.x(), out.grasp_pose.y(),
                             out.grasp_pose.z() + lift_height_);
  return true;
}
- 第三段是量宽度,也就是 5-2 那一整套几何的落地。它直接在点云自己那一帧里算,只把"接触点加两条轴"变换过去:
// grasp_run_node.cpp —— 从点云现量物体沿闭合轴的宽度
bool measureWidth(const sensor_msgs::msg::PointCloud2 & cloud, const std::string & world,
                  const grasp_interfaces::msg::GraspCandidate & cand, double & width_out,
                  std::string & why)
{
  if (cloud.data.empty()) {
    why = "点云是空的";
    return false;
  }

  // 相机眼在手,它相对 world 一直在动,所以这份 TF 必须查,不能写死。
  const std::string cam = cloud.header.frame_id;
  geometry_msgs::msg::TransformStamped tf;
  try {
    // 用点云自己的时间戳查:相机跟手臂固连,点云那一瞬间的相机位姿与"现在"不同。
    tf = tf_buffer_->lookupTransform(cam, world, cloud.header.stamp,
                                     tf2::durationFromSec(0.2));
  } catch (const tf2::TransformException & ex) {
    try {
      tf = tf_buffer_->lookupTransform(cam, world, tf2::TimePointZero);
    } catch (const tf2::TransformException & ex2) {
      why = "查不到 " + world + " -> " + cam + " 的 TF:" + ex2.what();
      return false;
    }
  }
  const geometry_msgs::msg::Quaternion & tq = tf.transform.rotation;
  const Eigen::Matrix3d R_cam_world =
    Eigen::Quaterniond(tq.w, tq.x, tq.y, tq.z).normalized().toRotationMatrix();
  const geometry_msgs::msg::Vector3 & tt = tf.transform.translation;
  const Eigen::Vector3d p_cam_world(tt.x, tt.y, tt.z);

  // 目标位姿进相机系:点是仿射(R*p + t),方向只转不平移。
  const geometry_msgs::msg::Pose & gp = cand.pose;
  const Eigen::Vector3d t_world(gp.position.x, gp.position.y, gp.position.z);
  const Eigen::Quaterniond gq(gp.orientation.w, gp.orientation.x, gp.orientation.y,
                              gp.orientation.z);
  const Eigen::Matrix3d Rg = gq.normalized().toRotationMatrix();
  const Eigen::Vector3d t_c = R_cam_world * t_world + p_cam_world;
  const Eigen::Vector3d a_c = (R_cam_world * Rg.col(0)).normalized();  // 接近轴
  const Eigen::Vector3d c_c = (R_cam_world * Rg.col(1)).normalized();  // 闭合轴

  // 板的两端是夹爪几何:下界是手指根部(比接触点还靠外一个指根长度),上界是指尖。
  const double depth = graspDepth(cand.depth);
  const double slab_lo = -(DEPTH_BASE + FINGER_WIDTH);
  const double slab_hi = std::max(depth, 0.005);

  // 一次遍历,把扫描要用的三个量先算好(半径扫描复用它们,反复遍历点云太浪费)。
  // NaN/Inf 是深度图的无效像素,它们参与的比较恒为 false,会被 !(...) 一起滤掉。
  struct Sample
  {
    double r2, da, dc;
  };
  std::vector<Sample> samples;
  samples.reserve(8192);
  const double r_max2 = width_r_max_ * width_r_max_;
  for (sensor_msgs::PointCloud2ConstIterator<float> ix(cloud, "x"), iy(cloud, "y"),
       iz(cloud, "z");
       ix != ix.end(); ++ix, ++iy, ++iz) {
    const Eigen::Vector3d d(*ix, *iy, *iz);
    const Eigen::Vector3d rel = d - t_c;
    const double r2 = rel.squaredNorm();
    if (!(r2 <= r_max2)) {continue;}  // !(...) 一次拦掉 NaN 与超球两种
    samples.push_back({r2, rel.dot(a_c), rel.dot(c_c)});
  }
  if (samples.empty()) {
    why = "点云在接触点周围 " + std::to_string(width_r_max_ * 1000.0) +
          " mm 内一个点都没有 —— 目标可能已经不在视野里";
    return false;
  }

  // 半径扫描。只记有效采样(点数够),后面找平台只在这串上做。
  struct Scan
  {
    double r, span;
    int cnt;
  };
  std::vector<Scan> valid;
  std::string table;
  char row[192];
  const int steps = static_cast<int>((width_r_max_ - width_r_min_) / width_r_step_) + 1;
  for (int i = 0; i < steps; ++i) {
    const double r = width_r_min_ + i * width_r_step_;
    const double r2 = r * r;
    double lo = std::numeric_limits<double>::max();
    double hi = std::numeric_limits<double>::lowest();
    int cnt = 0;
    for (const Sample & s : samples) {
      if (!(s.r2 <= r2)) {continue;}
      if (s.da < slab_lo || s.da > slab_hi) {continue;}
      lo = std::min(lo, s.dc);
      hi = std::max(hi, s.dc);
      ++cnt;
    }
    if (cnt >= width_min_points_) {
      const double span = hi - lo;
      valid.push_back({r, span, cnt});
      std::snprintf(row, sizeof(row), "\n    r=%5.1fmm  点数=%5d  展布=%6.1fmm",
                    r * 1000.0, cnt, span * 1000.0);
    } else {
      std::snprintf(row, sizeof(row), "\n    r=%5.1fmm  点数=%5d  (点太少,不计入)",
                    r * 1000.0, cnt);
    }
    table += row;
  }
  // 整张 r-表每次都打日志:出问题时看表就知道是平台没找对,还是点云本身就不对。
  RCLCPP_INFO(get_logger(), "    宽度扫描(沿闭合轴的展布):%s", table.c_str());
  if (valid.size() < 3) {
    why = "宽度扫描拿不到足够的有效采样(只有 " + std::to_string(valid.size()) +
          " 个),接触点周围点太稀 —— 看看上面那张表";
    return false;
  }

  // 找平台起点:第一个"连续两步的展布都基本没长"的位置。斜坡段每步都明显在长,
  // 只有到了平台才会连着两步几乎不动,所以这个判据能把两者分开。
  size_t start = valid.size();
  for (size_t k = 0; k + 2 < valid.size(); ++k) {
    if (valid[k + 1].span <= valid[k].span * (1.0 + width_plateau_tol_) &&
        valid[k + 2].span <= valid[k + 1].span * (1.0 + width_plateau_tol_)) {
      start = k + 1;
      break;
    }
  }
  if (start >= valid.size()) {
    why = "宽度扫描没出现平台(展布一路在长)—— 多半是物体比扫描半径 " +
          std::to_string(width_r_max_ * 1000.0) +
          " mm 还大,或这点云里的东西不是刚体一块。看看上面那张表";
    return false;
  }

  // 取平台的起点,不是平台的末端。理由完整写在 5-2 节:本场景里球半径到 50mm 就够到
  // 桌面了,平台的末端恰恰是污染最重的一格,而闭合命令只留了 0.5mm 的穿透预算。
  const double base = valid[start].span;
  // 平台延伸到哪儿为止,现在只用于日志:越过它的那一步就是球够到桌面/邻居的地方。
  size_t last = start;
  for (size_t k = start + 1; k < valid.size(); ++k) {
    if (valid[k].span > base * (1.0 + width_plateau_tol_)) {break;}
    last = k;
  }
  const double width = base;
  RCLCPP_INFO(get_logger(),
              "    量宽度 = %.1f mm:取平台起点 r=%.1fmm(展布 %.1f mm,%d 点);"
              "平台到 r=%.1fmm 为止(再往后球够到桌面/邻居,展布涨到 %.1f mm,那是污染)",
              width * 1000.0, valid[start].r * 1000.0, base * 1000.0, valid[start].cnt,
              valid[last].r * 1000.0, valid[last].span * 1000.0);

  if (width > 2.0 * kGripperOpen) {
    why = "量出的宽度 = " + std::to_string(width * 1000.0) + " mm 超过本夹爪最大开口 " +
          std::to_string(2.0 * kGripperOpen * 1000.0) + " mm,这个候选物理上夹不了";
    return false;
  }
  // 下限用夹爪自己的极限,不是场景常量:闭合命令的下界是 0.008,对应开口 16mm。
  if (width < 2.0 * 0.008) {
    why = "量出的宽度只有 " + std::to_string(width * 1000.0) + " mm,比本夹爪能闭合到的"
          "最小开口还小 —— 说明板里那些点不是物体表面,看看上面那张表的点数和展布";
    return false;
  }

  width_out = width;
  RCLCPP_INFO(get_logger(),
              "    -> 这个候选量得出宽度:执行用它 %.1f mm(网络给的 width=%.1f mm,"
              "仅作对照,不参与执行)", width * 1000.0, cand.width * 1000.0);
  return true;
}
- 第四段是候选筛选。按分数降序逐个试,取第一个"量得出宽度,且悬停可达,且推进与抬升两段笛卡尔预演都通"的:
// grasp_run_node.cpp —— 候选筛选。整趟筛选与预演都不动机器人。
bool selectCandidate(const grasp_interfaces::msg::BestGrasp & bg,
                     const sensor_msgs::msg::PointCloud2 & cloud, bool has_cloud,
                     Selection & sel, std::string & why)
{
  if (!has_cloud) {
    why = "还没收到点云(话题 " + cloud_topic_ + "),量不出宽度";
    return false;
  }
  if (!waitForJointStates()) {
    why = "no /joint_states yet";
    return false;
  }

  const std::vector<grasp_interfaces::msg::GraspCandidate> cands = candidateList(bg);
  const std::string world =
    bg.pose.header.frame_id.empty() ? std::string("world") : bg.pose.header.frame_id;
  const int n = std::min(static_cast<int>(cands.size()), std::max(1, max_candidates_));

  const auto t_start = std::chrono::steady_clock::now();
  std::string rejected;
  for (int k = 0; k < n; ++k) {
    const grasp_interfaces::msg::GraspCandidate & c = cands[k];
    RCLCPP_INFO(get_logger(),
                "  候选 #%d  score=%.3f  接触点 [%.3f %.3f %.3f]  msg宽度=%.1fmm  depth=%.3f",
                k, c.score, c.pose.position.x, c.pose.position.y, c.pose.position.z,
                c.width * 1000.0, c.depth);

    // 每轮重设起点:上一轮可能把起点串成了某条预演轨迹的末点。
    setStartFromJointStates();

    std::string w;
    auto reject = [&](const std::string & stage) {
      RCLCPP_WARN(get_logger(), "    -> 拒绝:%s(%s)", stage.c_str(), w.c_str());
      char line[512];
      std::snprintf(line, sizeof(line), "  #%d(score %.3f):%s —— %s\n", k, c.score,
                    stage.c_str(), w.c_str());
      rejected += line;
    };

    Attempt att;
    if (!prepare(c, att, w)) {reject("朝向不可用"); continue;}
    att.index = k;   // prepare 里 out = Attempt() 会清掉,所以在它之后设
    if (!measureWidth(cloud, world, c, att.width, w)) {reject("量宽度失败"); continue;}

    // 三条轨迹在这里一次性算出来。plan_b / plan_c 声明在 if 之外是必须的:
    // 预演打开时它们是执行阶段要原样放的东西,出了 if 就得还活着。
    moveit::planning_interface::MoveGroupInterface::Plan plan_a, plan_b, plan_c;
    if (!planToPoseOnly("PRE_GRASP", att.hover, att.q_tool, free_pipeline_, free_planner_,
                        plan_a, w)) {
      reject("悬停不可达");
      continue;
    }
    if (screen_linear_precheck_) {
      // 预演从悬停轨迹的末点出发,不是从当前关节状态出发 —— 理由见下一段说明。
      setStartFromTrajectory(plan_a.trajectory_);
      if (!planToPoseOnly("APPROACH", att.grasp_pose, att.q_tool, linear_pipeline_,
                          linear_planner_, plan_b, w)) {
        reject("推进段不可达");
        continue;
      }
      setStartFromTrajectory(plan_b.trajectory_);
      if (!planToPoseOnly("LIFT", att.lift, att.q_tool, linear_pipeline_, linear_planner_,
                          plan_c, w)) {
        reject("抬升段不可达");
        continue;
      }
    }

    sel.attempt = att;
    sel.pre_grasp = plan_a;
    sel.have_linear_plans = screen_linear_precheck_;
    if (screen_linear_precheck_) {
      sel.approach = plan_b;
      sel.lift = plan_c;
    }
    setStartFromJointStates();
    const double dt = std::chrono::duration<double>(
      std::chrono::steady_clock::now() - t_start).count();
    if (k == 0) {
      RCLCPP_INFO(get_logger(),
                  "  => 采用候选 #0(就是 top-1 本身,score %.3f);筛选总耗时 %.1fs",
                  c.score, dt);
    } else {
      RCLCPP_INFO(get_logger(),
                  "  => 采用候选 #%d(score %.3f,比 top-1 低 %.3f —— top-1 够不着,"
                  "退到它后面第一个可行的);筛选总耗时 %.1fs",
                  k, c.score, cands.front().score - c.score, dt);
    }
    return true;
  }

  setStartFromJointStates();
  why = "没有可行候选:试了 " + std::to_string(n) + " 个(快照共 " +
        std::to_string(cands.size()) + " 个),逐个被拒的原因是\n" + rejected +
        "(筛选全程只做规划与量宽度,机械臂一动不动)";
  return false;
}
- 第五段是执行。它只读
Selection,自己不算任何几何、也不重新规划:
// grasp_run_node.cpp —— 主流程(在服务回调线程上阻塞执行)
bool runSequence(const Selection & s, const Trigger::Response::SharedPtr & res)
{
  const Attempt & a = s.attempt;
  RCLCPP_INFO(get_logger(),
              "grasp target: [%.3f, %.3f, %.3f],采用候选 #%d(score %.3f);"
              "执行宽度=%.1f mm(网络给 %.1f mm),depth=%.3f",
              a.contact.x(), a.contact.y(), a.contact.z(), a.index, a.score,
              a.width * 1000.0, a.width_net * 1000.0, a.depth);

  // 1) 张开夹爪(在当前位置附近做,安全)
  if (!sendGripper(res, "OPEN", kGripperOpen, kGripperOpenEffort)) {
    return false;
  }

  // 2) 悬停到物体外侧(沿 approach 轴退开;顶视时就是正上方)。自由空间转移,
  //    这一段故意不用直线:从当前位姿到悬停点的直线方向是任意的,要求它走直线既没有
  //    语义上的好处,又很容易无解。执行的是筛选阶段预规划好的那条轨迹 —— OMPL 是采样的,
  //    同起点同一目标再 plan 一次会得到另一条路、甚至另一个 IK 分支。
  if (!executePlan(res, "PRE_GRASP", s.pre_grasp)) {
    return false;
  }

  // 3) 沿 approach 轴推进到 grasp_pose,指尖正好落在绿色夹爪画的位置。
  //    PILZ LIN 直线:划弧会把物体推走。执行的是预演过的那条。
  if (s.have_linear_plans) {
    if (!executePlan(res, "APPROACH", s.approach)) {
      return false;
    }
  } else if (!moveLinear(res, "APPROACH",
                         a.grasp_pose.x(), a.grasp_pose.y(), a.grasp_pose.z(), a.q_tool)) {
    return false;
  }

  // 4) 闭合握紧。闭合目标 = 量出的宽度/2 - grip_penetration,穿透量必须很小。
  //    宽度用 a.width(点云现量、属于这个候选),不是网络给的 width。
  //    上界用 kGripperOpen - kCloseMargin 而不是 kGripperOpen:后者正是 OPEN 命令的位置,
  //    一旦 close 被夹到那儿,CLOSE 就退化成"停在原地"、reached_goal 立刻为真、
  //    动作报成功而手指一动没动。
  const double close =
    std::clamp(a.width / 2.0 - grip_penetration_, 0.008, kGripperOpen - kCloseMargin);
  if (!sendGripper(res, "CLOSE", close, max_effort_)) {
    // 必须松手。CLOSE 失败时手指很可能正被命令压在物体里,咬着不放会让 Gazebo
    // 每 10ms 解算一次穿透,实测过一次整个仿真冻死。
    releaseGripperBestEffort();
    return false;
  }

  // 5) 抬升,方向是世界 +z,不是 approach 轴。这一段只沿 approach 轴走的话,顶视时
  //    碰巧就是竖直向上,斜着抓时就变成"把手指从物体侧面横着抽走",物体会被拖过桌面。
  //    这里失败不松手,跟第 4 步刻意不同:此时穿透量只有 0.0005,不会把求解器顶死,
  //    物体正被夹在空中,松手反而把它摔了。
  if (s.have_linear_plans) {
    if (!executePlan(res, "LIFT", s.lift)) {
      return false;
    }
  } else if (!moveLinear(res, "LIFT", a.lift.x(), a.lift.y(), a.lift.z(), a.q_tool)) {
    return false;
  }

  // 6) 停住。不回位、不松手 —— 本步骤没有失败路径,只是把状态说出来。
  RCLCPP_INFO(get_logger(),
              "HOLD: 已举起并停住于 [%.3f, %.3f, %.3f],夹爪保持闭合(不回位、不松手)",
              a.lift.x(), a.lift.y(), a.lift.z());
  return true;
}
- 这里有一条容易被改坏的设计,值得单独强调:预演出来的三条轨迹是被保留下来原样执行的,执行阶段一条都不重算
- 这不是省事,因为"预演通过"推不出"重规划也会通过",理由有两条:
- 起点不同。预演
APPROACH时起点取的是悬停轨迹的末点,真执行时起点是臂实际停住的状态,中间隔着控制器的跟踪误差。"PILZ LIN 是确定的"只保证同起点同目标得到同结果,管不了起点不同 - 规划场景会变。相机眼在手,走完
PRE_GRASP实测要3.85 s,这段时间视角一直在换、octomap 一直在长,而 MoveIt 2 在 Humble 上的 octomap 没有占位衰减,长进去的格子就是永久的
- 起点不同。预演
- 第二条是实测撞上的:预演时
APPROACH规划成功,几秒后真执行时报INVALID_MOTION_PLAN,move_group日志里是<octomap>撞上panda_link1,7个路点全废 - 留着重放就没有这个窗口 ——
execute()本身不做碰撞检查,它只比对轨迹首点与当前实际状态,所以"校验过的那条就是校验过的那条"
5-5 测试
我们分别启动三个终端:
# 终端 1:Gazebo + 眼在手相机 + octomap
./1_depth_gazebo.sh
# 终端 2:GraspNet 检测节点(要加载 430MB 权重,首次启动在 GPU 上要几十秒)
./graspnet.sh
# 终端 3:执行节点 + 触发一次抓取
./6_grasp.sh
-
可以看到顺利夹起来了
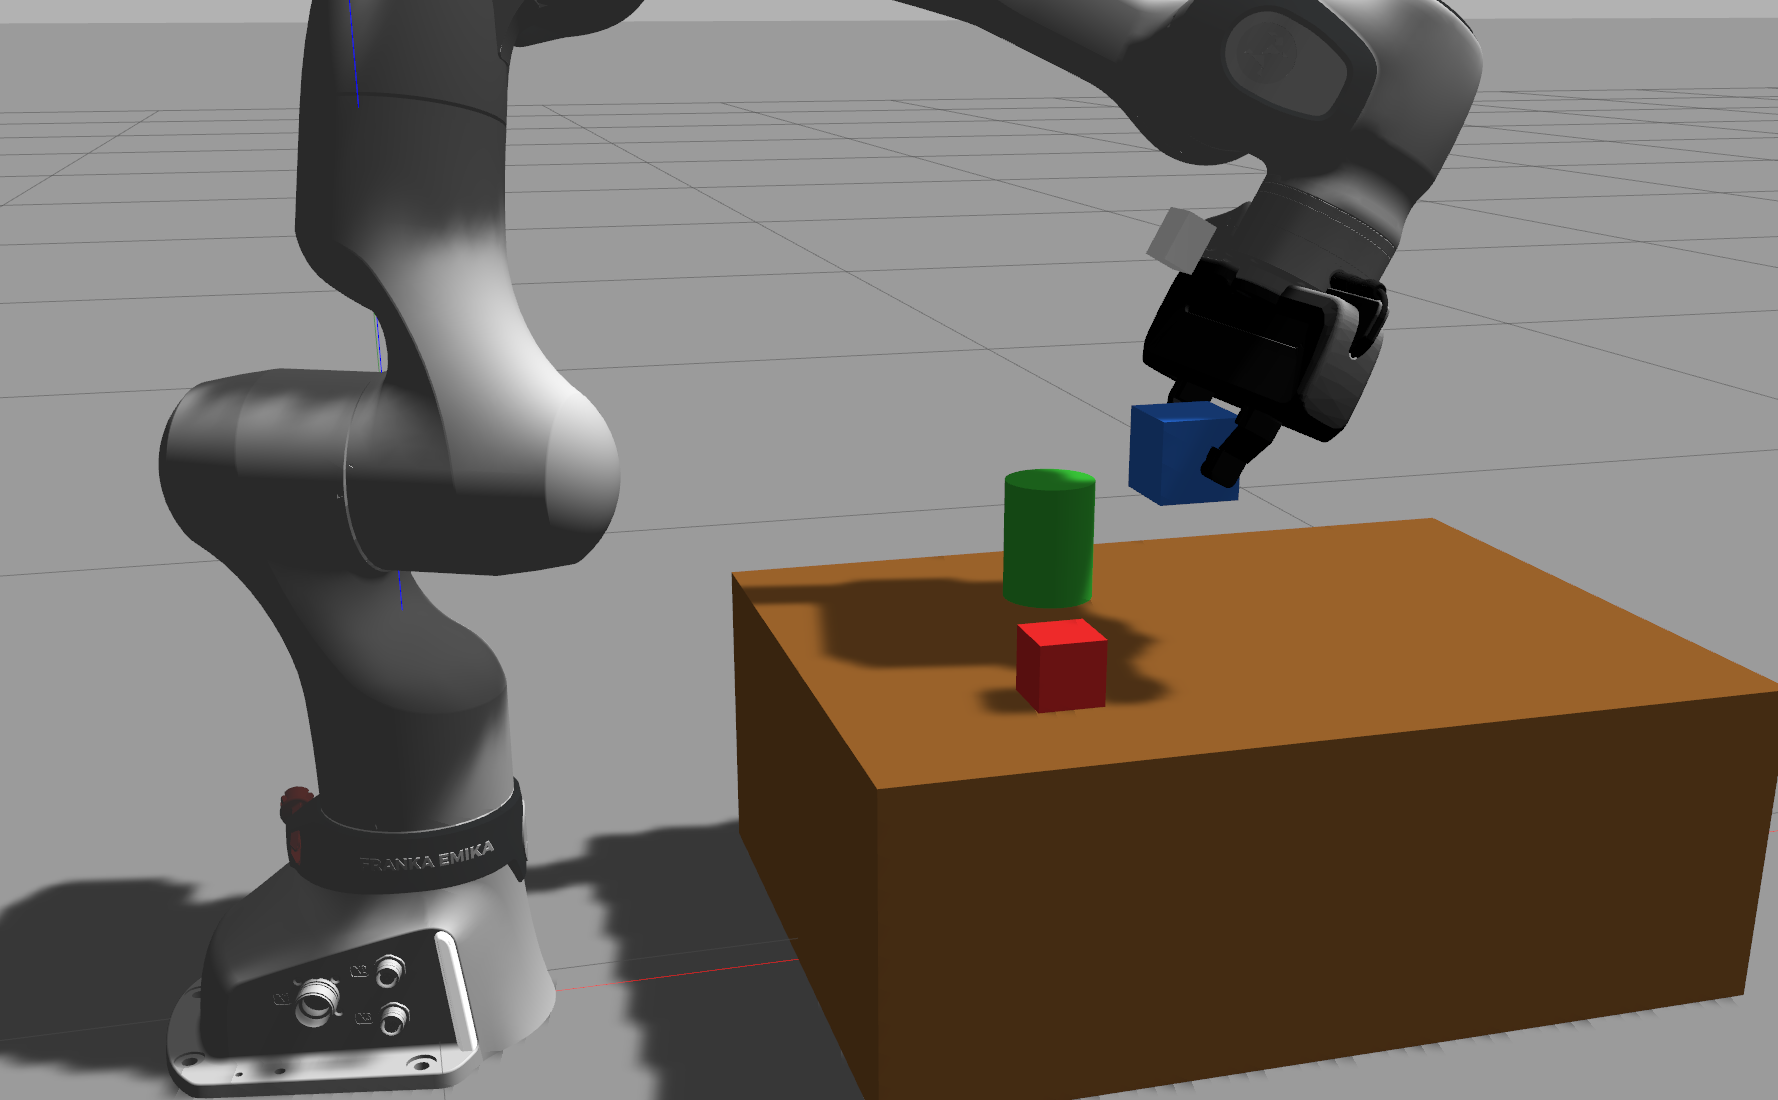
-
同样道理,如果我们删掉蓝色方块,就有圆柱,如你所见,圆柱是侧面抓取的
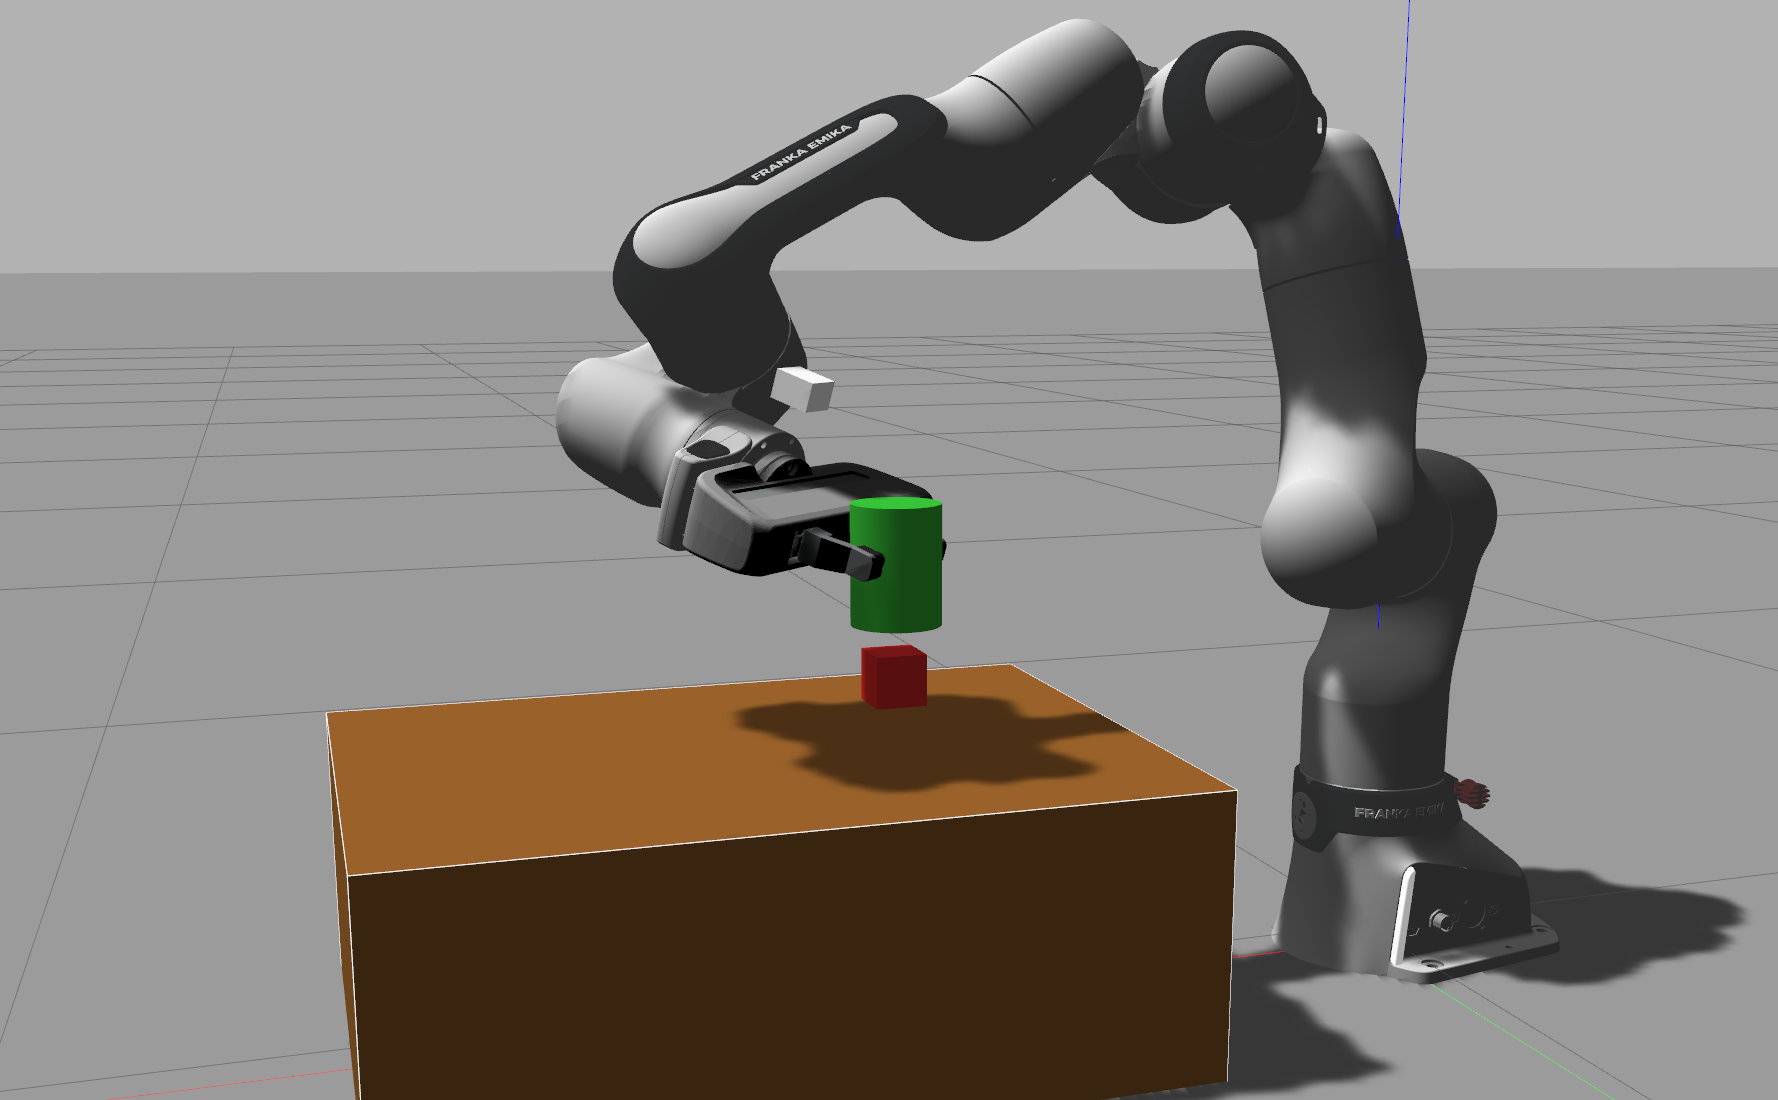
-
需要说明的是,下一次调用的时候,需要先回到初始位置,否则无法观测桌子平面。由于教学,本系统不实现这个功能
-
想再抓一次不必重启节点,另开一个终端发一次触发就行:
ros2 service call /grasp_run/start std_srvs/srv/Trigger
- 还有一点:
6_grasp.sh里的cleanup()里有一条按路径精确pkill的语句,它不是多余的kill掉ros2 launch不会带走它的子进程,grasp_run_node会被init收养继续活着,占着/grasp_run/start和那个MoveGroupInterface- 下次再起一个就变成两个节点抢同一个服务名,行为随 DDS 匹配结果而定 —— 与 4-5 节
graspnet.sh里那个坑是同一类
6 扩展-grasp-net的训练
- 这里我们只提供理论,由于我们的重心在后面的 vla 内容,故这里仅做扩展介绍
6-1 介绍
- GraspNet 的训练目标一句话能说完:给定一帧场景点云,让它对帧里的每一个种子点先选一个 approach 视角,再在这个视角的圆柱里给出面内角度、深度、宽度、容差与质量分;训练就是让这些输出逼近数据集里的解析标注
说人话:它学的是"点云上这个位置、朝这个方向、张这么宽,抓得好不好"这一句,跟"这是个什么物体、它该怎么抓"没有关系。换成没见过的物体、没见过的摆放,这句话照样成立,迁移性就是从这儿来的
6-2 数据集采集
- 2-7 节讲的是
GraspNet-1Billion的规模,这里讲它是怎么造出来的,因为标注怎么来的,决定了模型的能力边界在哪 - 整条流程分四步,前三步都在场景级做,只有最后一步回到帧级:
| 步骤 | 做什么 | 产出 |
|---|---|---|
| 采集 | 对同一个杂物堆叠场景,从多个视角扫 RGB-D | 每个场景一批带相机位姿的 RGB-D |
| 重建 | 按相机位姿把多帧融合成 TSDF 体素,再抽成网格 | 每个场景一份完整的点云与网格 |
| 标注 | 在完整网格上算解析力闭合抓取,同时标出每个物体的 6D 位姿 | 场景级的抓取集合 |
| 投影 | 把场景级抓取按相机位姿投回每一帧,并剔除该帧看不见的 | 每帧的抓取标注 |
- 每个场景采多少帧,代码里是写死的:
# dataset/graspnet_dataset.py
for x in tqdm(self.sceneIds, desc='Loading data path and collision labels...'):
    for img_num in range(256):
        self.colorpath.append(os.path.join(root, 'scenes', x, camera, 'rgb', str(img_num).zfill(4)+'.png'))
        self.depthpath.append(os.path.join(root, 'scenes', x, camera, 'depth', str(img_num).zfill(4)+'.png'))
        self.labelpath.append(os.path.join(root, 'scenes', x, camera, 'label', str(img_num).zfill(4)+'.png'))
        self.metapath.append(os.path.join(root, 'scenes', x, camera, 'meta', str(img_num).zfill(4)+'.mat'))
- 每套相机每个场景采
256帧,两套相机(realsense与kinect)合起来就是每个场景512帧- 于是
190 × 256 × 2 = 97,280—— 2-7 节那个"97,280张 RGB-D"就是这么来的 - 每帧配四个文件:
rgb、depth、label(实例分割图)、meta(内参矩阵与深度缩放因子),所以物体位姿、可见性判断全都有据可依
- 于是
- 四个关键设计,每一个都在解决一个具体问题:
- 为什么要在场景级标注,而不是逐帧标注:单帧点云永远看不全物体,背面被挡、自遮挡都在。只在单帧上算力闭合,会把大量本来可行的抓取误判成不可行,而且这个偏差是系统性的、不可能靠多训几个 epoch 补回来
- 为什么标注密度能到十亿量级:解析力闭合是对每个物体、每条采样方向都算一遍,算得动就全留下,中间没有人工取舍这一环。人工标注受限于人力,只能标"最优的那几个",这就是本数据集与早期抓取数据集数量级差距的来源
- 为什么要预先算碰撞标记:数据集里给每个场景单独存了一份
collision_labels.npz,形状(Np, V, A, D),把"这条抓取会不会撞到场景"提前算完 - 为什么要有
13个DexNet 2.0对抗物体:那批物体形状光滑、对称、缺纹理,专门用来压模型"靠纹理和局部特征猜"的习惯,逼它去学几何
说人话:先架着相机把一个场景从各个角度扫一遍,拼成一个完整模型,在完整模型上把能抓的地方全算出来,最后按每张照片的视角"看回去",照片里看得见的才算这一帧的标签
- 投影这一步落到代码上是这样,它同时解释了"碰撞"是怎么进到监督信号里的:
# dataset/graspnet_dataset.py —— 把场景级标注挂到这一帧上(注释已压缩,逻辑逐字)
points, offsets, scores, tolerance = self.grasp_labels[obj_idx]  # 物体系下的解析标注
collision = self.collision_labels[scene][i]                      # (Np, V, A, D)

# 剔除这一帧里看不见的抓取点:把物体系抓取点按物体位姿投到场景里,
# 与这一帧该物体的可见点云比最近距离,超过 1 cm 的判为看不见
visible_mask = remove_invisible_grasp_points(
    cloud_sampled[seg_sampled == obj_idx], points, poses[:, :, i], th=0.01)
points = points[visible_mask]
scores = scores[visible_mask]
collision = collision[visible_mask]

# 会碰撞的抓取,分数与容差直接置 0 —— 碰撞是被折进"分数"里学的
scores[collision] = 0
tolerance[collision] = 0
- 注意最后两行:碰撞直接改在标注里,不靠后处理规则去判 —— 一条会撞到桌面的抓取,在训练数据里分数就是
0,模型自然学会给它低分- 这也解释了为什么
grasp_detector.py里还要再挂一道ModelFreeCollisionDetector:训练侧学到的是"数据集那个场景里的碰撞",而我们现场场景是我们自己的桌面与障碍物,网络没理由知道
- 这也解释了为什么
- 这一套流程里还有一件事必须单独拎出来,它是第 5 章那个宽度问题的根本原因:
- 解析力闭合算的是"一个给定夹爪模型能在哪里闭合",标注里的宽度就是那个夹爪当时的开口
- 也就是说,数据集与夹爪几何是绑死的,换夹爪就得重算标注,不存在"换个夹爪凑合用"的可能
- 数据集侧把这件事写死在常量里:
# graspnet-baseline/utils/loss_utils.py
GRASP_MAX_WIDTH = 0.1          # 宽度回归的上限,同时也是宽度损失的归一化尺度
GRASP_MAX_TOLERANCE = 0.05
THRESH_GOOD = 0.7              # 0.7 以上算"好抓取",用于 view 软标签与评测
THRESH_BAD = 0.1               # 0.1 以上才进训练掩码
- 而我们的
panda夹爪最大开口只有0.08 m(panda_finger_joint行程0..0.04,两指合计0.08),这个数字在整条链路里没有任何一处知道 - 所以 5-2 节那张表里
60 mm的圆柱报出74.8 mm、比40 mm的方块还小,它答的本来就不是我们问的那个问题,与网络学得好不好无关
6-3 训练流程
- 训练目标是把 2-4 节列出的那几个输出头各自对齐到标注,所以损失是多任务加权求和。baseline 里就是这几行:
# models/loss.py
def get_loss(end_points):
    objectness_loss, end_points = compute_objectness_loss(end_points)
    view_loss, end_points = compute_view_loss(end_points)
    grasp_loss, end_points = compute_grasp_loss(end_points)
    loss = objectness_loss + view_loss + 0.2 * grasp_loss
    end_points['loss/overall_loss'] = loss
    return loss, end_points
- 各头的监督形式:
| 头 | 形式 | 损失 | 备注 |
|---|---|---|---|
objectness | 二分类,种子点级 | 交叉熵 | “这个位置能不能抓” |
view_score | 300 维回归 | MSE | 标签是软标签,不是 one-hot |
grasp_score | 每个角度与深度的组合各一个 | huber,delta=1 | 深度就藏在它里面 |
grasp_angle_cls | 12 类分类,在每个深度层上各做一次 | 交叉熵 | 一共 48 个 logits |
grasp_width | 回归 | huber,且先除以 GRASP_MAX_WIDTH | 误差按"几厘米"来衡量 |
grasp_tolerance | 回归 | huber,且先除以 GRASP_MAX_TOLERANCE | 容差 |
- 有三处设计值得单独说:
view_score用MSE而不是交叉熵:它的标签是"这个视角下有多大比例的抓取是好抓取",是一个[0, 1]的连续值。拿分类去拟合一个比例,会把0.9与0.95当成两个互斥的类别- 深度没有单独的回归头。标注张量是
(种子点, 12 角度, 4 深度)的网格,每格一个分数;推理时grasp_depth_class = argmax(grasp_score, dim=1),深度是被"哪个深度层分数最高"选出来的- 好处是深度误差天然被限制在那四个离散层上(
0.01 / 0.02 / 0.03 / 0.04 m),不会回归出物理上无意义的中间值 - 代价是深度精度上限就是
1 cm,需要更细的深度分辨率就必须加层,而加层意味着标注也要重算
- 好处是深度误差天然被限制在那四个离散层上(
- 第二级的权重是
0.2:先保证"能抓的地方被找出来",再保证"参数报得准"。反过来配权重,会让模型在大量本来就没希望的点上死抠宽度精度
- 训练与推理之间还有一处故意的不对称,看 Stage 2 的前向就知道了:
# models/graspnet.py —— GraspNetStage2.forward
if self.is_training:
    grasp_top_views_rot, _, _, _, end_points = match_grasp_view_and_label(end_points)
    seed_xyz = end_points['batch_grasp_point']      # 训练:圆柱中心用标注的抓取点
else:
    grasp_top_views_rot = end_points['grasp_top_view_rot']
    seed_xyz = end_points['fp2_xyz']                # 推理:圆柱中心用骨干网下采的种子点
- 也就是说,Stage 2 训练时是直接站在标注抓取点上学"这个点的参数是多少",而"哪些点值得站"这件事完全交给 Stage 1 的
objectness(损失里也是把objectness_label按fp2_inds聚到种子点上去监督的)- 这样切分的好处是任务解耦:Stage 2 不用去学"这里没东西",只管学参数回归,收敛更快
- 代价是两级之间留了一个隐含假设:
fp2种子点得落在标注抓取点附近,Stage 2 学到的东西才用得上。种子点密度不够时,精度掉在这里而不是掉在参数回归上
- 训练超参里有一条必须记住:
num_view = 300、num_angle = 12、num_depth = 4、cylinder_radius = 0.05、hmin与hmax_list这几个数训练与推理必须完全一致- 因为它们决定的是张量的形状与几何含义,不是可以两边各调各的旋钮
- 4-2 节的
_build_net里这几个数就是照抄训练配置的,注释里那句"num_view锁300(baked into checkpoint,不可调)"说的正是这件事
- 官方 baseline 的训练配置大致是这样:
| 参数 | 默认值 | 说明 |
|---|---|---|
--num_point | 20000 | 每帧采样点数,与推理侧一致 |
--batch_size | 2 | 小得反常,原因见下 |
--learning_rate | 0.001 | 初始学习率 |
--max_epoch | 18 | 训练总轮数 |
--lr_decay_steps | 8,12,16 | 在第 8、12、16 轮各降一次,每次乘 0.1 |
--bn_decay_step | 2 | 每 2 轮把 BN 动量乘 0.5 |
batch_size只用2不是笔误:单个样本的标注张量是(种子点, 12 角度, 4 深度)的网格,再叠上20000点的点云与圆柱采样,显存占用远大于常见的分类任务max_epoch = 18这个数也不是随手取的:学习率在第8、12、16轮各降一次,18恰好让最后两次降完还剩两轮收敛- 这一点能和 3-4 节对上:从
checkpoint-rs.tar里读出的epoch就是18,加载时打印的(epoch: 18, device: cuda:0)就是它
- 这一点能和 3-4 节对上:从
- 最后说如果真要用我们自己的夹爪微调,要做哪几件事、各自的代价是什么:
- 重跑解析标注:把夹爪模型换成
panda的(最大开口0.08 m),对重建出的场景网格重算一遍力闭合。这一步比训练本身贵得多,也是整件事真正的门槛 —— 训练只要一块显卡和十几个小时,重算标注要的是整套采集与重建流程 - 把
GRASP_MAX_WIDTH从0.1改成0.08:让宽度回归的上限与损失的归一化尺度都对齐到实际能力,否则网络仍然会预测出我们根本张不开的抓取 - 数据侧可以偷懒,但要小心:网络输入就是单帧点云,所以理论上拿单帧微调是可行的。但真实标注是场景级算完再投影的,只用单帧会系统性丢掉被遮挡的抓取,正样本偏少,微调容易把模型带向"只抓看得见的正面"
- 更省事的方向是绕开重训:在点云里现量宽度(5-2 节的做法),让网络的输出只当"抓取位姿的提议"用,所有数值量自己算。本期走的就是这条路
- 重跑解析标注:把夹爪模型换成
- 这一章的内容本期不落地执行,作为后面 vla 内容的前置储备
总结
- 本期我们从
GraspNet的原理出发,把官方 baseline 接进了 ROS,又自己写了执行节点把 6-DoF 抓取位姿变成机械臂真实的一串动作,最后在仿真里把方块夹起来并举起 - 核心要点回顾:
- 6D 抓取位姿的约定: R R R 的第 0 列是 approach 轴、第 1 列是闭合轴。弄错列号,真夹爪会绕 approach 轴滚 90 度,方块看不出来,立着的圆柱必然夹不住
- 一个物体要预测很多 grasp:网络给的是抓取提议,不是唯一答案。单点预测没有容错,给一批才有后面用碰撞检测、
NMS、可达性去筛的余地 - 桥接包的分工:
grasp_detector.py管模型,pointcloud_utils.py管点云,grasp_marker.py管可视化,graspnet_node.py把这几件事串成1 Hz的循环 - 观测与决策必须分开:相机眼在手,机械臂一动视角就换,所以触发那一刻要把目标和那帧点云一起快照下来,之后全程只认快照
- 网络给的宽度不能当物体宽度:它回归的是数据集标注者当时的开口再乘
1.2,上限还是0.1 m,实测三个物体报出来的顺序都是反的。执行宽度只能从点云沿闭合轴现量 - 量宽度取平台的起点:
5%的容差对50 mm的物体允许过估2.5 mm,而穿透预算只有0.5 mm。取末端会让两指悬在物体面外0.35 mm,一点接触都没有,物体抬不起来 - 穿透量必须极小:运动学驱动下"穿透"就是每
10 ms把刚性手指瞬移进刚性方块,整个过程与力无关,取大了会把整个仿真冻死 - 推进与抬升必须走笛卡尔直线:关节空间采样规划器会划弧,划弧会在接触物体之前把它推走。要换
PILZ的LIN,换OMPL里别的 planner 是没用的 - 预演过的轨迹要原样执行:只要执行阶段重新规划,校验与执行就是两个不同的规划问题,通过前者推不出后者
- 不盲取 top-1:网络的分本来就给出了,而 top-1 常常运动学上够不着,按分数降序取第一个可行的解
- 到这里,
MoveIt2加Gazebo这条传统链路就收官了:从上一期的手写几何,到这一期的网络预测,机械臂都能把物体抓起来 - 下一期我们进入
Pinocchio:前五期里正运动学、雅可比、逆运动学与动力学一直由MoveIt2代劳,把这层自己算一遍,后面让语言指令驱动这条链路时才有可用的动作接口 - 如有错误,欢迎指出!感谢观看!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献20条内容

所有评论(0)