企业微信二次开发外部群机器人,消息越来越多该怎么设计?
上个月底,一个做社区团购 SaaS 的客户直接把电话打到了我手机上,背景音里全是一线运营的疯狂输出:“系统又卡死了!客户发的消息机器人半小时才回!” 我拉着他们 DBA 一查,好家伙,他们在单台 MySQL 实例的一张 t_chat_record 表里,硬生生塞了 8000 多万条外部群聊天记录。每当 Webhook 接收到新消息执行 INSERT 时,光是更新那几个 B+ 树索引就能把 IOPS 彻底打满,整个数据库几乎处于半瘫痪状态。
作为每天在一线跟各类技术团队死磕 星云 API(xingyapi.com) 接口联调的销售客服,我发现绝大多数团队在刚起步做机器人时,为了图快,都是“一接一存”的单体思维。一旦业务跑通,外部群从 10 个扩张到 1000 个,消息体量呈指数级爆炸,系统绝对会原形毕露。
面对每天上百万条、甚至上千万条的群聊消息,今天咱们直接把底层架构掀开,聊聊怎么设计一套高吞吐、能横向扩展的“工业级”海量消息管线。
认清现实:你的数据库到底在扛什么?
如果你仔细拆解过 [接口文档](https://api.xingyapi.com/api-docs) 里的底层报文结构,你会发现企微推送过来的不仅是纯文本,还有极高频的系统事件(进群、退群、撤回)以及多媒体凭证。
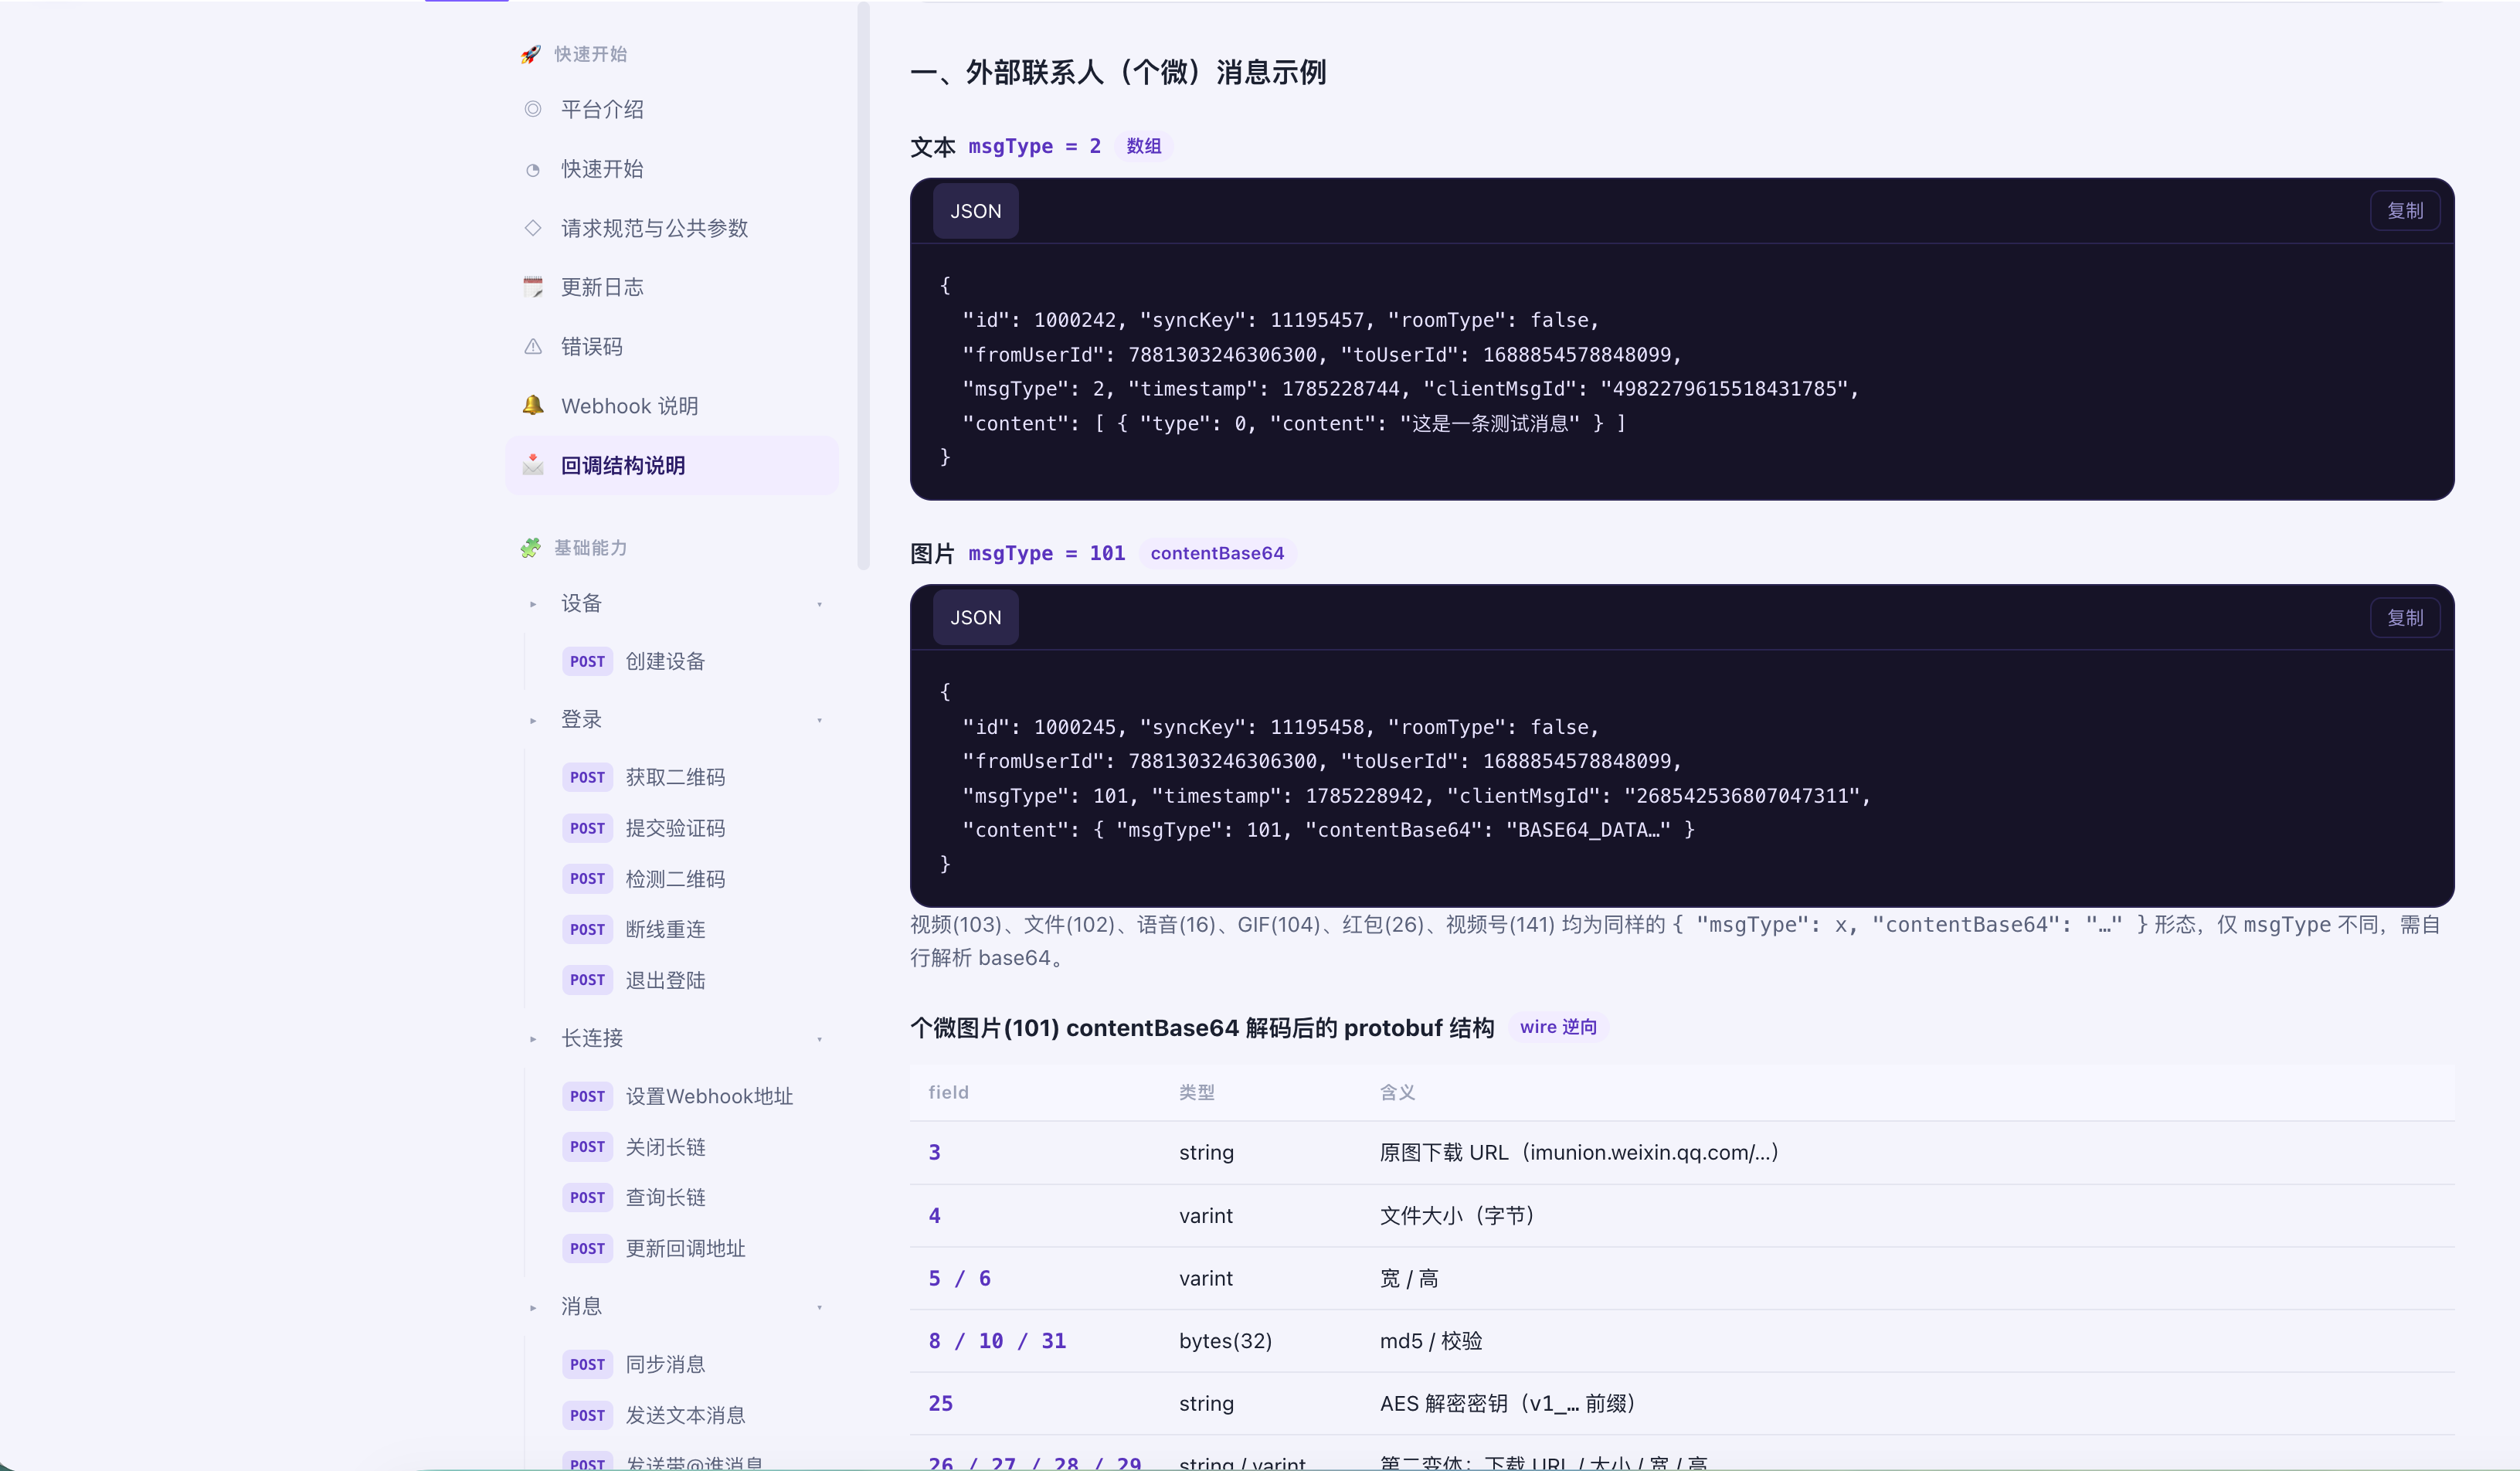
实战 JSON 载荷(典型的群聊报文):
JSON
{
    "MsgType": "text",
    "ChatId": "wr_xxxxxxxxxxxxxxxxxxxx",
    "FromUserName": "wm_xxxxxxxxxxxxxxxxxxxx",
    "CreateTime": 1700000000,
    "MsgId": "msg_xxx_唯一标识",
    "Content": "这个品今天还有库存吗?"
}
随着消息量爆炸,你的单体架构会面临两大绝境:
-
写并发写死:几百个群同时聊天,瞬时的并发写入会把数据库连接池榨干。
-
读检索读死:大模型或客服后台需要回溯上下文时,在几千万行数据里做
WHERE chat_id = ? ORDER BY time DESC的分页查询,查询极其缓慢。
工业级高吞吐架构演进(三步走)
要扛住消息洪峰,你必须彻底放弃“接收即入库”的玩具写法,拥抱“异步缓冲 + 异构存储”的分布式架构。
第一步:MQ 防洪大坝(解决写并发)
在 Webhook 接收网关的最前端,绝对不允许出现任何 JDBC 调用。 收到网关推来的密文后,立刻将其扔进 RabbitMQ、Kafka 或者是 Redis Stream(轻量级首选),然后光速向企微网关 return "success" 断开连接。把每秒几万次的并发,变成 MQ 里排队慢慢消费的平滑水流。
第二步:冷热分离与异构双写(解决存储与检索)
这是应对数据量爆炸的核心。在后台消费 MQ 时,不要把所有数据都往 MySQL 里塞,必须做“信封分离”:
-
热数据(关系与流水):MySQL 分库分表 不要用自增 ID,强制使用报文里的
MsgId作为主键(天然幂等)。表结构只存骨架:msg_id,chat_id,from_user,create_time,msg_type。 分表策略:以ChatId的 Hash 值做水平分表(比如分成 128 张表),这样同一个群的历史消息永远落在同一张表里,查询上下文时快如闪电,避免了跨表关联。 -
冷数据(全文检索):Elasticsearch 倒排索引 对于
Content里的长篇大论,直接落入 ES。当运营需要全局搜“谁在群里骂过脏话”或者“搜某款产品的询价记录”时,ES 能在几亿条文本中毫秒级返回匹配的MsgId,再拿着MsgId去 MySQL 反查关系,完美配合。
第三步:多媒体文件的“旁路降级”
群里除了文字,最多的是表情包、图片和视频。 消费者遇到 MsgType == "image" 时,千万别去同步拉取原图。把拉取任务扔进一个专门的“低优先级延迟队列”。由单独的 Worker 在凌晨或闲时,去调用获取素材接口,拉回二进制流并上传到你们的阿里云 OSS,最后只在数据库里存一个 OSS 的 CDN 链接。绝不让大文件的下载拖垮主力的聊天流转通道。
老兵避坑:用压测刺破你的架构幻觉
很多团队把分表和 ES 搭好了,觉得万事大吉,结果一上线,因为 MQ 消费者的参数没调好,消息依然大量积压。
架构设计完,必须用工具进行极限施压!
老规矩,打开你的 Apifox 或者 Apipost:
-
编写动态脚本,随机生成包含 1000 个不同
ChatId、带着长文本的模拟报文。 -
开启性能压测功能,设定 500 个并发线程,在 5 分钟内向你的 Webhook 接收网关持续轰炸。
-
观察你的监控大盘:
-
网关层的 HTTP 响应是不是始终在 20ms 以内?
-
MQ 的生产和消费速率能不能追平?
-
MySQL 的 128 张分表里的数据分布是否均匀(有没有数据倾斜导致的热点表)?
-
压测结束后,去 ES 查几个生僻词,看看命中率是不是 100%。
-
在企业微信生态做私域,数据量是一把双刃剑。存不下来是事故,存下来了不会用是浪费。把异构存储的管线铺好,你们的海量聊天记录才能从“拖垮系统的包袱”,真正变成“喂养大模型和风控画像的黄金语料”。
大家在设计分表路由时,如果遇到那种日消息量 10 万+ 的“超级活跃大群”,导致某个哈希分表严重倾斜,你们一般是怎么做热点打散的?欢迎在评论区甩出你的高招咱们切磋切磋!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献6条内容

所有评论(0)