【CoRL 2025】Enter the Mind Palace:长期主动具身问答的推理与规划|从机器人长期记忆视角
摘要
本文解读 CoRL 2025 论文《Enter the Mind Palace: Reasoning and Planning for Long-term Active Embodied Question Answering》。该论文提出 长期主动具身问答(LA-EQA) 这一新任务,通过融合分层场景图构成的「记忆宫殿」长期记忆表示、世界实例—区域—视点三层语义引导搜索与基于信息价值(VoI)的早停判据,让机器人既能回忆过去经历、又能主动探索当前环境,回答带时间约束的问题。实验表明 Mind Palace Exploration 取得 65.0% 的答案正确率,超出最强基线 12.1 个百分点;同时只检索 22.86 张图像,比多帧 VLM 方案少 77.14%,并在四足机器人于 1,000 平方米真实办公室的部署中平均节省 3–10 次房间搜索,为长期具身智能与机器人记忆系统提供了重要借鉴。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | Enter the Mind Palace: Reasoning and Planning for Long-term Active Embodied Question Answering |
| 标题(中文) | Enter the Mind Palace:长期主动具身问答的推理与规划 |
| 作者 | M. Fadhil Ginting, Dong-Ki Kim, Xiangyun Meng, Andrzej Reinke, Bandi Jai Krishna, Navid Kayhani, Oriana Peltzer, David D. Fan, Amirreza Shaban, Sung-Kyun Kim, Mykel J. Kochenderfer, Ali Agha, Shayegan Omidshafiei |
| 机构 | Field AI · Stanford University |
| 会议 | CoRL 2025(PMLR 305:5072–5106) |
| arXiv | https://arxiv.org/abs/2507.12846 |
| 项目网站 | https://mind-palace-laeqa.github.io/ |
长期主动具身问答为什么难?
具身问答(Embodied Question Answering, EQA)检验的是机器人对环境的语义理解。此前的设定只覆盖两端:主动式要求机器人从零开始探索环境来收集信息,情景式则要求机器人基于单段记录的轨迹作答。两者都有一个共同的天花板——它们只使用机器人当前的观测或单独一段情节记忆,无法利用跨越多天、多月积累的经验。
而现实中的机器人正在变得越来越"长寿"。当一台机器人连续运行数周甚至数月,它会自然积累起海量观测:作者指出,单次运行就能产生上千张来自不同视角的图像,而绝大多数问题其实只与其中少数几帧相关。把这些数据直接塞进模型上下文,既低效——受限于上下文窗口——在长期设置下往往根本不可行。
第二个难点来自搜索空间的组合爆炸。要回答问题,机器人既要判断"该回忆哪段历史",又要判断"该去环境里哪个地方看",于是过去的观测与当下待探索的位置共同构成了一个巨大的联合搜索空间。没有先验的搜索代价高昂。
论文由此提出 LA-EQA:机器人必须同时回忆过去经历并主动探索当前环境,环境本身还会随时间改变外观与物体状态。作者把该任务形式化为五元组 $(Q, M, E, x_0, A^)$——问题、情景记忆列表、当前环境、初始位姿与标准答案;每条情景记忆 $m_i = [m_{i,1}, \cdots, m_{i,L}]$ 由若干位姿—图像观测对 $m_{i,j} = (x_{i,j}, o_{i,j})$ 组成。机器人执行的策略 $\pi(a_k \mid x_k, h_k, Q)$ 在三种动作之间选择:检索(retrieve)、探索(explore)与作答(answer)*。
值得注意的是,论文对既有基线做了清晰的能力刻画:多帧 VLM 把 100 帧全量塞进上下文但不会主动探索;Socratic LLM 只用文本描述、完全不检索图像;ReMEmbR 用向量数据库做检索但仍然不探索;两种主动式基线虽然会探索,记忆表示却很粗糙。没有任何一个基线同时具备结构化的长期记忆与主动探索——这正是本文要填的空白。
研究主线:从问题到结论
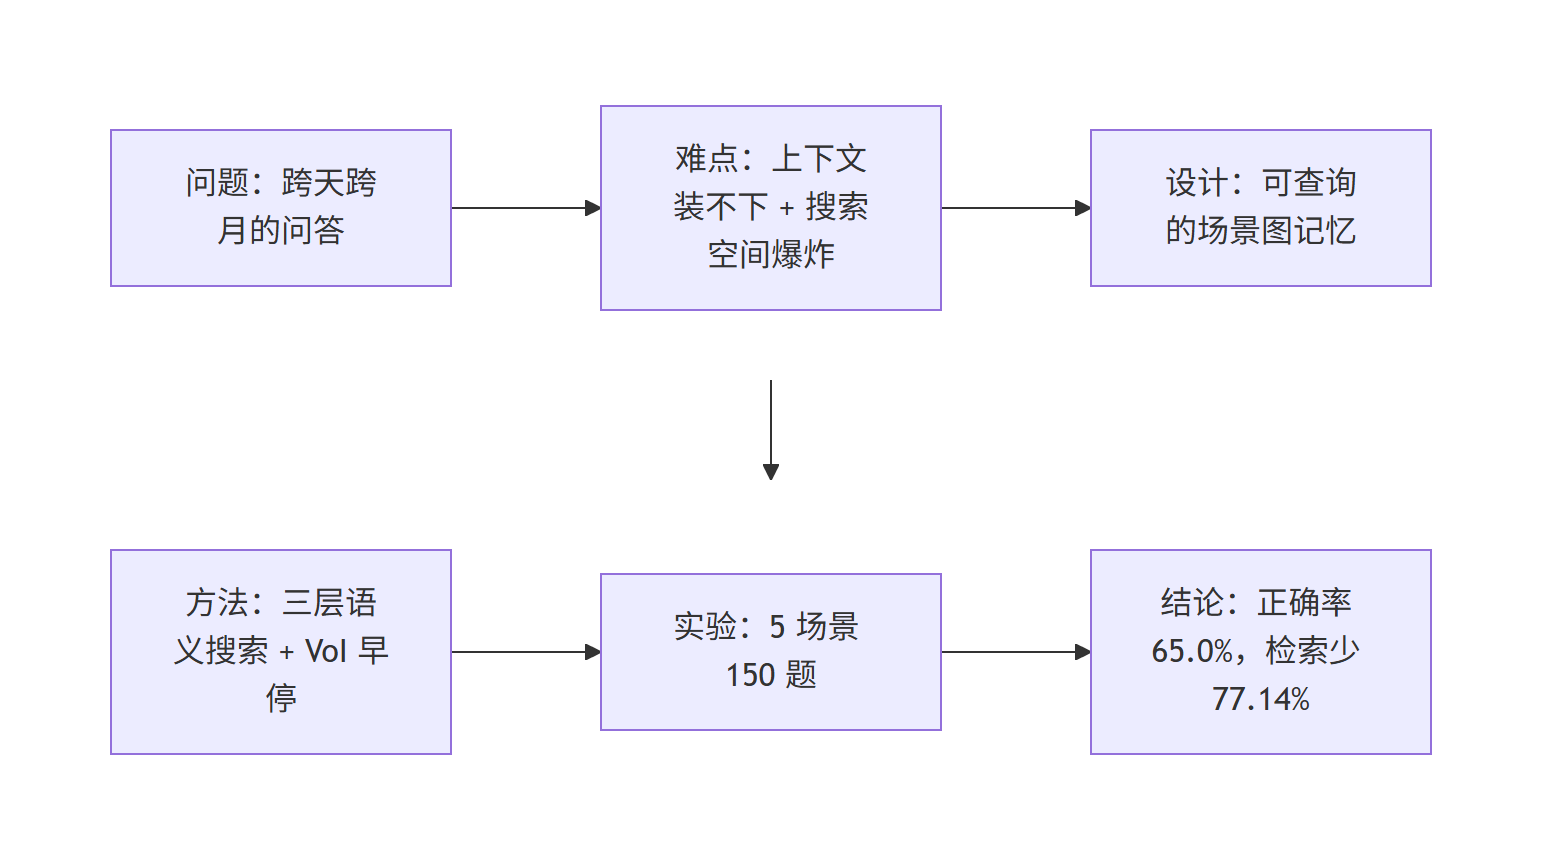
图 7:Mind Palace 论文的研究主线——从 LA-EQA 问题定义到 65.0% 正确率的结论(Mermaid 流程图)
基准/方法设计:把历史压成可查询的图
论文的核心主张来自一个认知科学类比:人类使用记忆宫殿(mind palace)技术,把需要记忆的信息与空间地标关联起来,从而高效且可追溯地回忆。作者把这个思路搬到机器人上——把长期观测组织成结构化的空间记忆。
具体地,系统按小时、时段或周这样的宏观时间把长期历史切分成若干情节,每个情节生成一个世界实例(world instance),用一张分层场景图 $G_i = (\mathcal{V}_i, \mathcal{E}_i)$ 表示。场景图有两层节点:
- 视点节点 $w$:从过去轨迹中采样的密集视点,保存机器人位姿 $x$、图像、图中检测到的物体列表以及帧描述。这三者共同充当语言模型的检索索引。
- 区域节点 $v$:视点按空间与上下文相似度聚类而成,带聚类质心与物体列表,使大空间可以被增量搜索。
全部世界实例构成记忆宫殿 $\mathcal{M} = [G_0, G_1, \cdots, G_N]$。其中 $G_1, \cdots, G_N$ 是过去的长期记忆,$G_0$ 是当下的世界实例——它在任务开始时只初始化区域节点(因为环境状态与物体摆放可能已经改变),并随机器人的探索实时更新。这一步的关键在于:过去与当下被放进同一套表示,因此检索和导航可以共用同一次图搜索。
论文同时构建了第一个 LA-EQA 基准:包含 3 个仿真场景与 2 个真实场景,每个仿真场景生成 5–10 个跨天的变化;真实数据来自一个工业场地和一间办公室,共 11 条 30–60 分钟的轨迹,时间跨度长达 6 个月。基准共 150 道题,由 7 个人标注,均匀覆盖 5 类时序推理:Past(回忆单次过去事件)、Present(只看当前环境)、Multi-past(综合多段历史)、Past-present(过去与当下联合推理)、Past-present-future(基于过去与当下预测未来)。
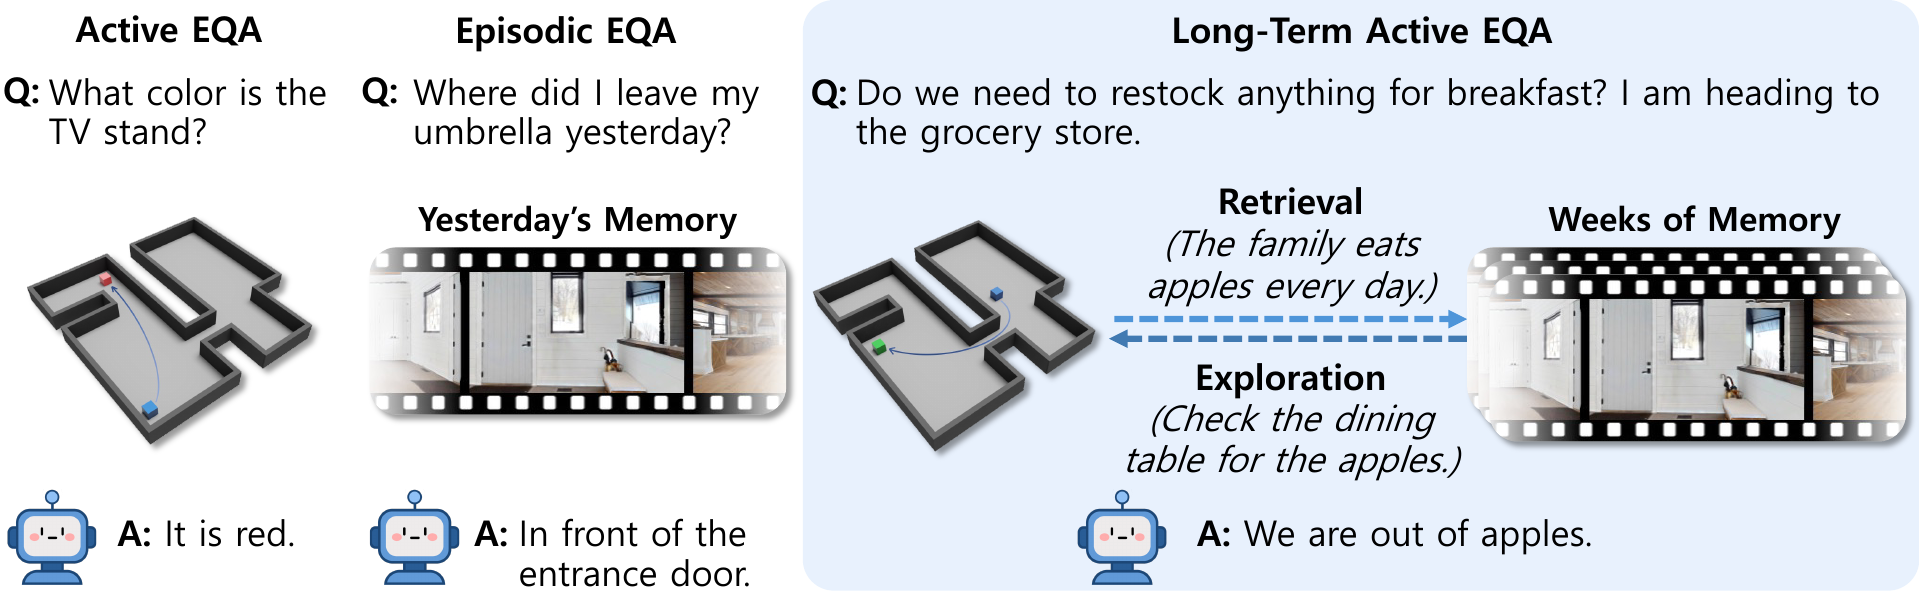
图 1:三种 EQA 设定——只看当下、只回忆单段轨迹,与本文的长期主动 EQA(主动探索 + 跨多段长期记忆)
分类全景:记忆宫殿的三个组件
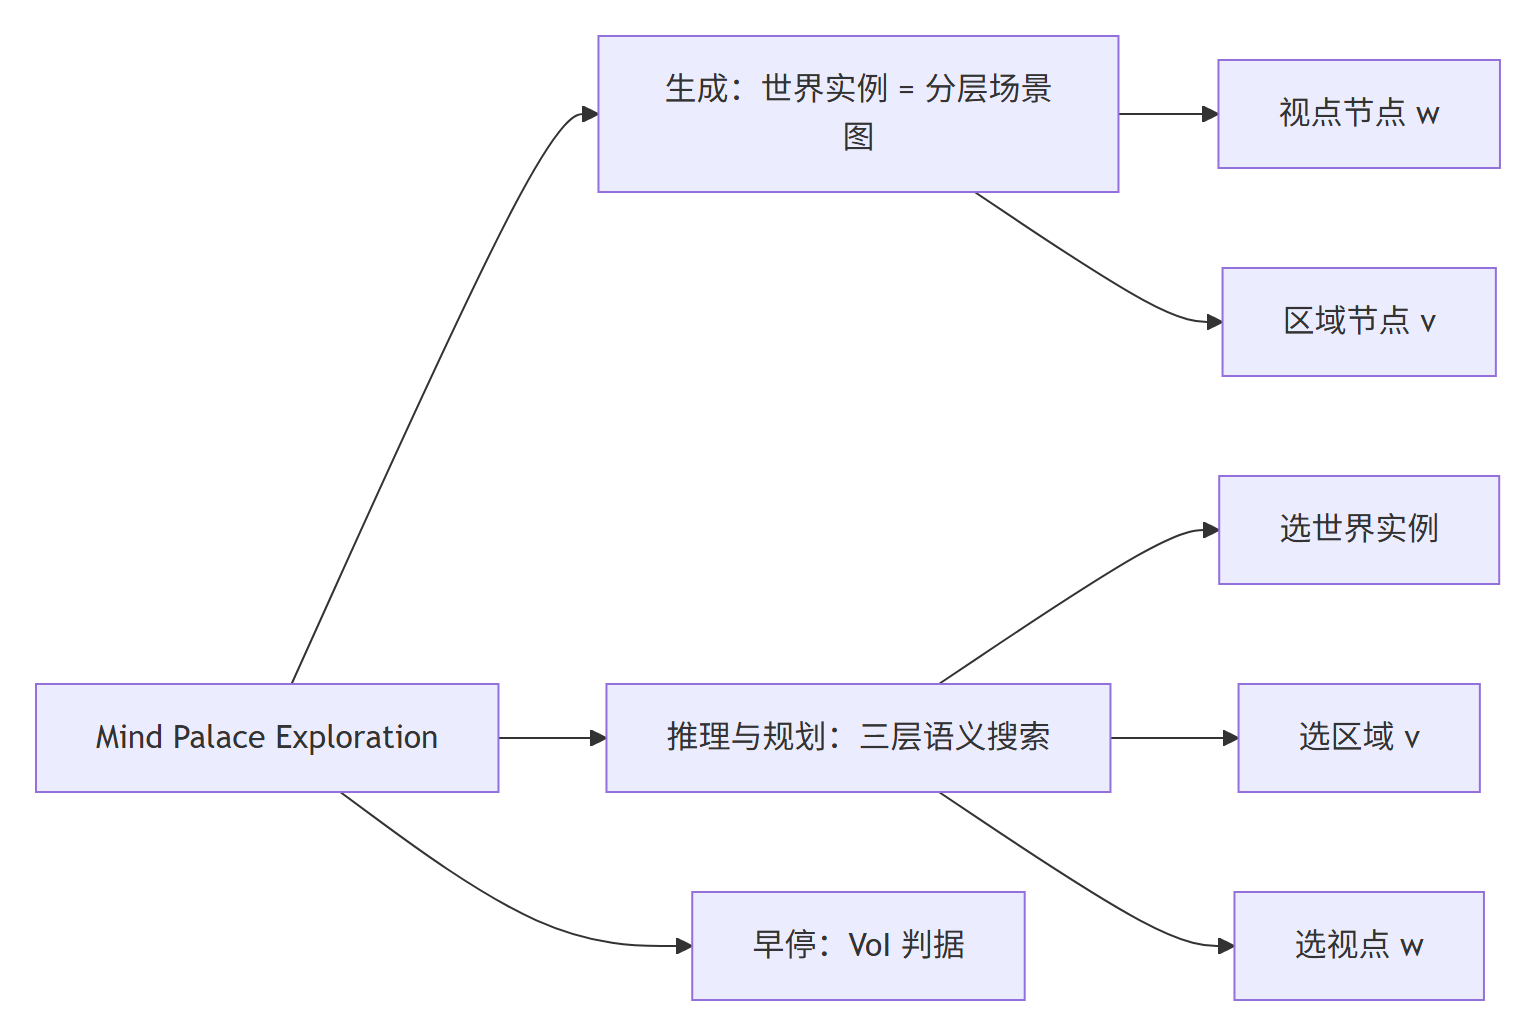
图 8:Mind Palace Exploration 的三个组件及其子模块(Mermaid 流程图)
方法细节:三层搜索与信息价值早停
推理与规划阶段在记忆宫殿上做三层递进的语义搜索,这三步交替进行:
- 推理(Reasoning over LA-EQA):先问视觉语言模型——用当前的工作记忆 $h_k$(存放动作、观测与先前推理步骤)能否回答问题?能则直接作答;不能,则由语言模型推理出目标物体或空间概念 $y$,例如问题里明说的物体,或"做咖啡需要什么"这类需要推断的线索。
- 世界实例规划:语言模型做两段式推理——先判断回答问题是否需要跨多个世界实例搜索,还是只涉及某一个实例;再据此选出并排序实例子序列。作者给了一个启发式引导:优先回忆过去实例,因为知道物体过去的位置能显著提高当下搜索的效率。
- 区域规划:在选定世界实例 $G_i$ 内规划区域序列,本质是一个物体目标导航问题。语言模型输出目标 $y$ 出现在每个区域 $v$ 的概率,再用前向搜索找出使搜索代价 $J$ 最小的区域序列。这里有一个巧妙的不对称设计:在过去实例中机器人可以"瞬移",探索任意区域代价相同;在当前实例中则按机器人当前位置到区域质心的路径长度计价。两种代价统一进入同一次搜索。
- 视点探索与重规划:语言模型依据场景图的文本信息挑选视点,机器人则通过回忆记忆中的图像或导航到该视点现场拍摄来获取观测,并把结果写回工作记忆,直到视觉语言模型在图像中检测到目标 $y$ 或触达探索上限。
方法同时给出了早停判据。给定一个包含当前实例的实例序列,系统先用语言模型在当前世界实例上形成一个区域预测集,即目标 $y$ 可能出现、且置信度高于阈值 $P(y) \geq 1-q$ 的区域集合,该阈值可用保形预测(conformal prediction)校准。随后有两个立即停止历史检索的条件:其一,预测集只剩下一个区域;其二,继续检索不会改变下一步计划。
第二个条件用信息价值(Value of Information, VoI)来量化——即检索一段额外记忆能带来的期望探索代价 $J$ 的下降量。如果新增观测不会改变最优动作,VoI 就等于零,此时继续检索纯属浪费。正是这条判据把平均检索图像数从 22.86 张进一步压到 15.73 张。
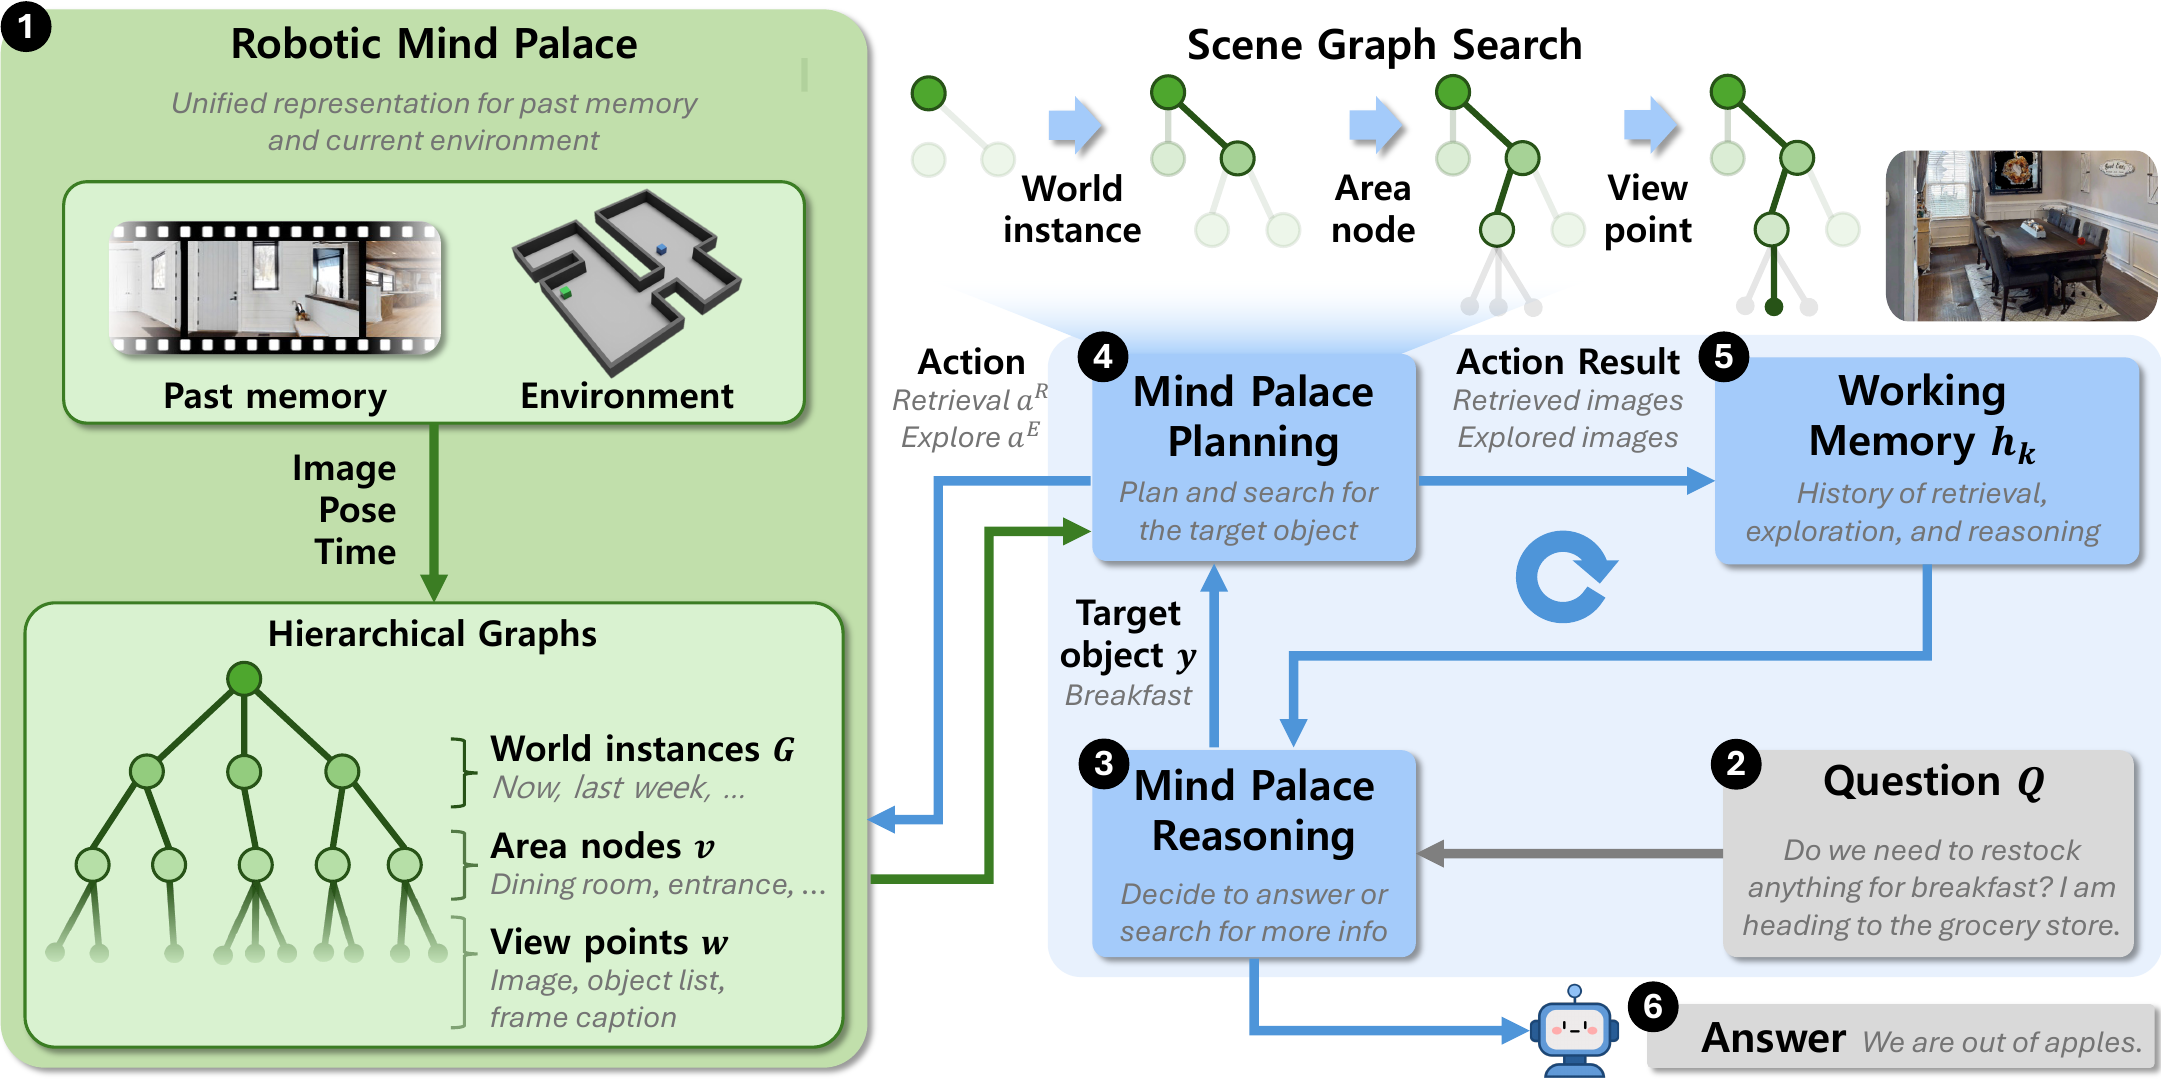
图 2:Mind Palace Exploration 的整体回路——(1) 统一过去记忆与环境表示;(2) 接收问题;(3) 推理出目标物体;(4) 规划检索与探索策略;(5) 更新工作记忆;(6) 信息足够后作答
实验设计与结果
评测使用三个指标:答案正确率(与人工标注答案比对,由语言模型打分)、探索效率(实际路径长度与 oracle 路径长度之比,并按答案正确率加权,可理解为 EQA 版的成功率加权路径长度)以及记忆检索效率(为回答问题而检索的过去图像张数)。对照的五个基线是 Multi-Frame VLM、Socratic LLM、ReMEmbR、Active EQA(以帧为记忆)与 Active Socratic EQA。
基准覆盖的场景包括两套仿真住宅(HM3D)、一个 Isaac Sim 仓库,以及真实的办公室与工业场地——后两者由四足机器人长期巡检采集。
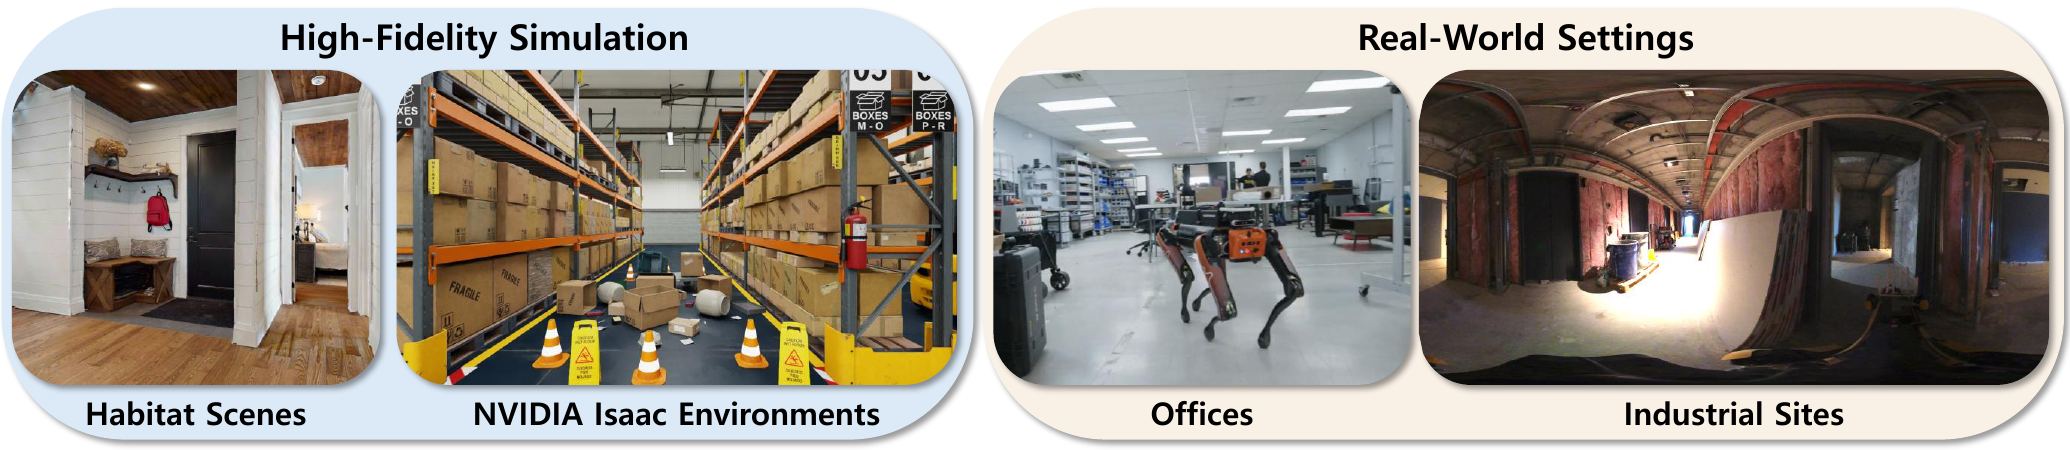
图 3:LA-EQA 基准的仿真与真实场景——模拟环境跨多天,真实场景跨多个月
主结果如下表所示:
| 方法 | 答案正确率 | 探索效率 | 检索图像数 |
|---|---|---|---|
| Mind Palace(本文) | 65.0% | 0.45 | 22.86 |
| Mind Palace + 早停 | 61.8% | 0.42 | 15.73 |
| Multi-Frame VLM | 52.9% | — | 100 |
| ReMEmbR | 46.1% | — | 0 |
| Socratic LLM | 44.3% | — | 0 |
| Active EQA(Frames) | 43.7% | 0.29 | 100 |
| Active Socratic EQA | 36.8% | 0.19 | 0 |
按题型拆开看,本文的优势集中在需要过去信息的类别上。作者指出这主要因为图像比文字描述携带更丰富的视觉上下文,能够回答关于物体属性、状态与摆放位置的问题——而这些恰恰是纯 caption 方案答不好的。在需要过去—当下联合推理的题型上,本文的探索效率优势也最明显,因为过去的记忆能帮助更准确地估计物体在各区域出现的概率。
按记忆规模看,本文的可扩展性同样突出:随着情景数量增加,它相对其它方法的优势持续扩大;多帧 VLM 在相同的检索上限下性能明显下降(图像覆盖度被摊薄),而 ReMEmbR 保持稳定,印证了检索式路线在长期问题上的价值。
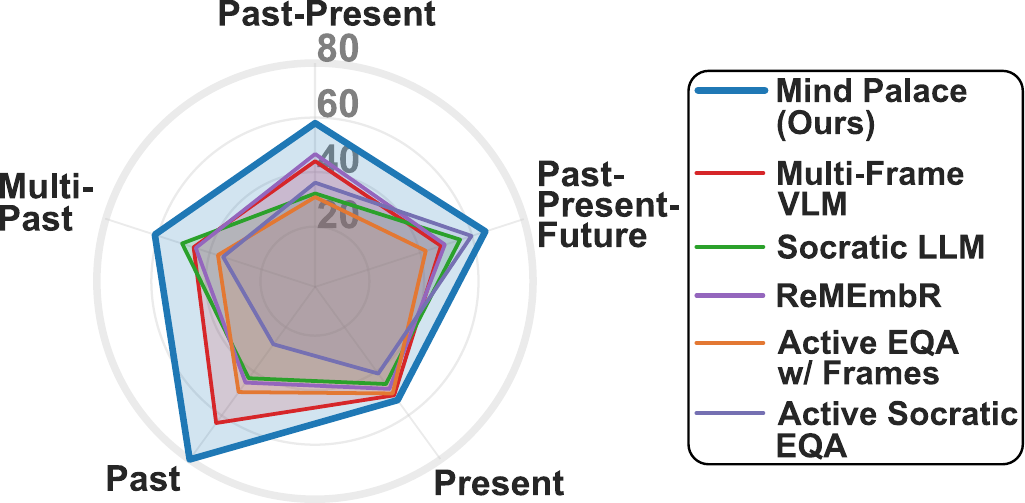
图 4:五类时序推理问题上的表现——优势集中在 Past 与 Multi-past 题型
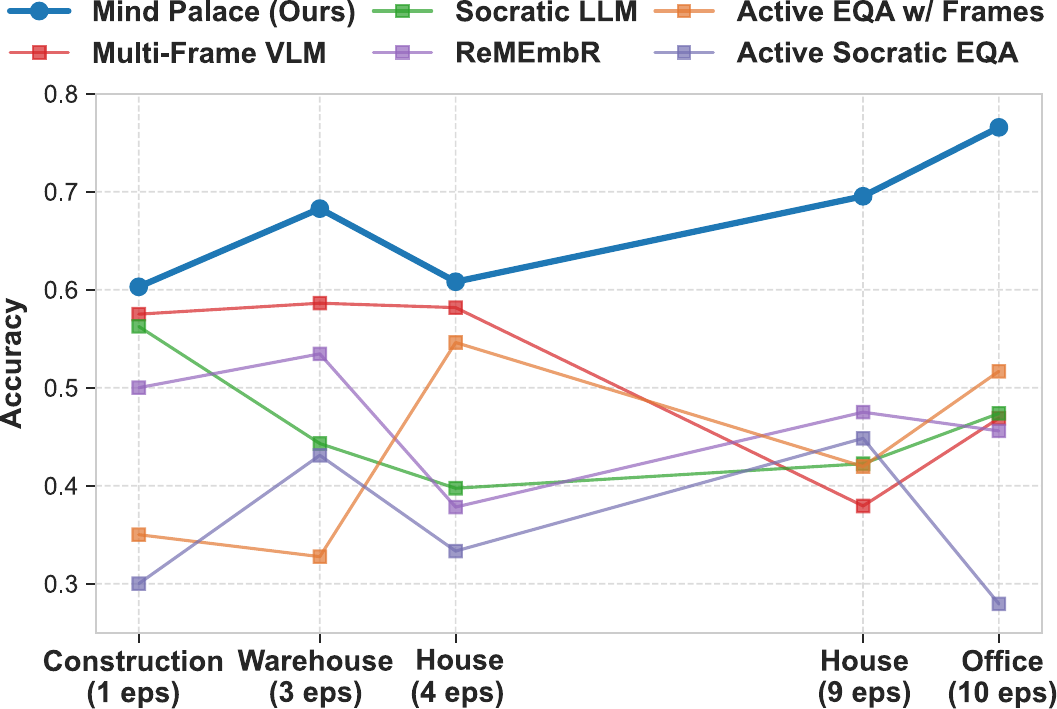
图 5:五个环境中随情景数(episode)变化的性能——本文优势随记忆规模单调增长
真实世界硬件实验提供了最后的验证。一台四足机器人作为办公室助理,覆盖 1,000 平方米、27 个区域;它的可用记忆包括过去 4 天的 10 段巡检,以及 2024 年 10 月至 2025 年 3 月的 6 次月度巡检,轨迹总长约 2,645 米。在 7 道需要主动探索的题目上(寻找工具、追踪包裹、识别连续多日无人使用的工位、解释办公室布局变化),它相比没有记忆的机器人平均节省 3–10 次房间搜索。除了语言模型查询之外,记忆存储与规划全部在机器人本地完成,用户通过电脑远程提问,机器人完成后回报答案。
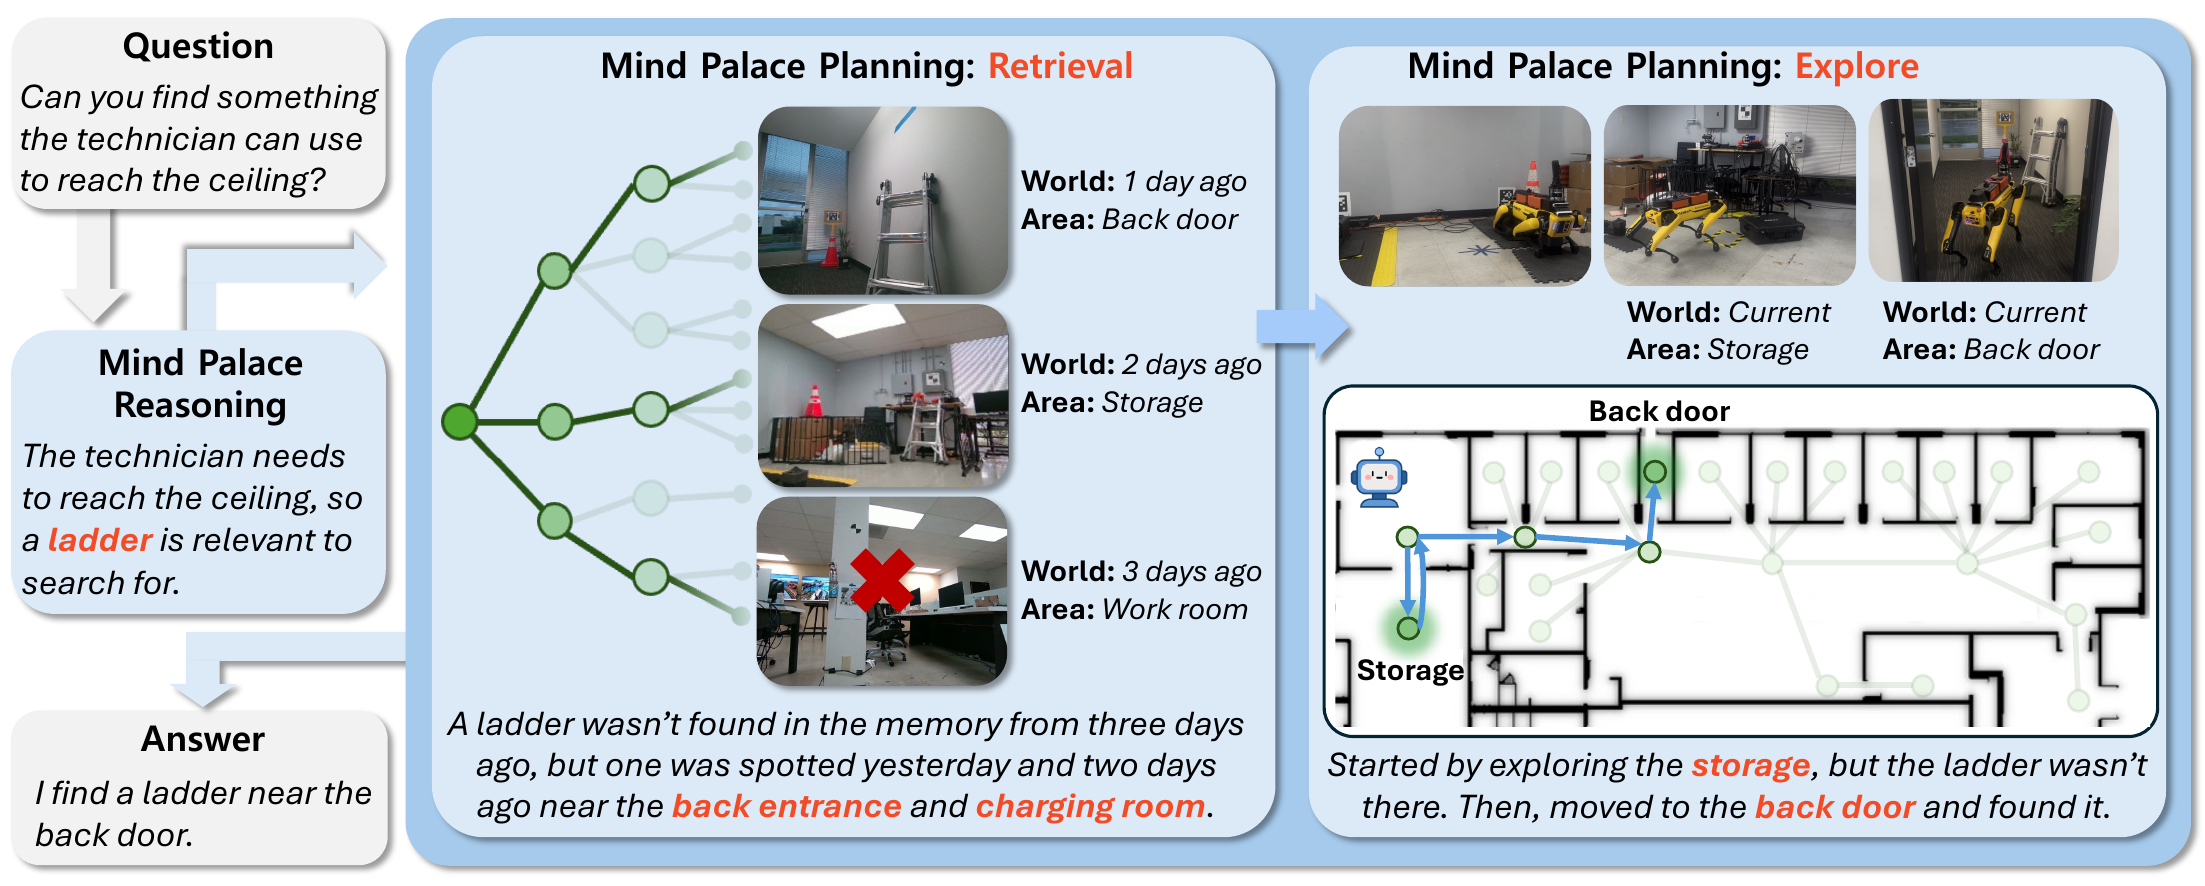
图 6:真实办公室中的长期主动 EQA 硬件实验——检索过去记忆、导航探索、给出答案
结果对比总结
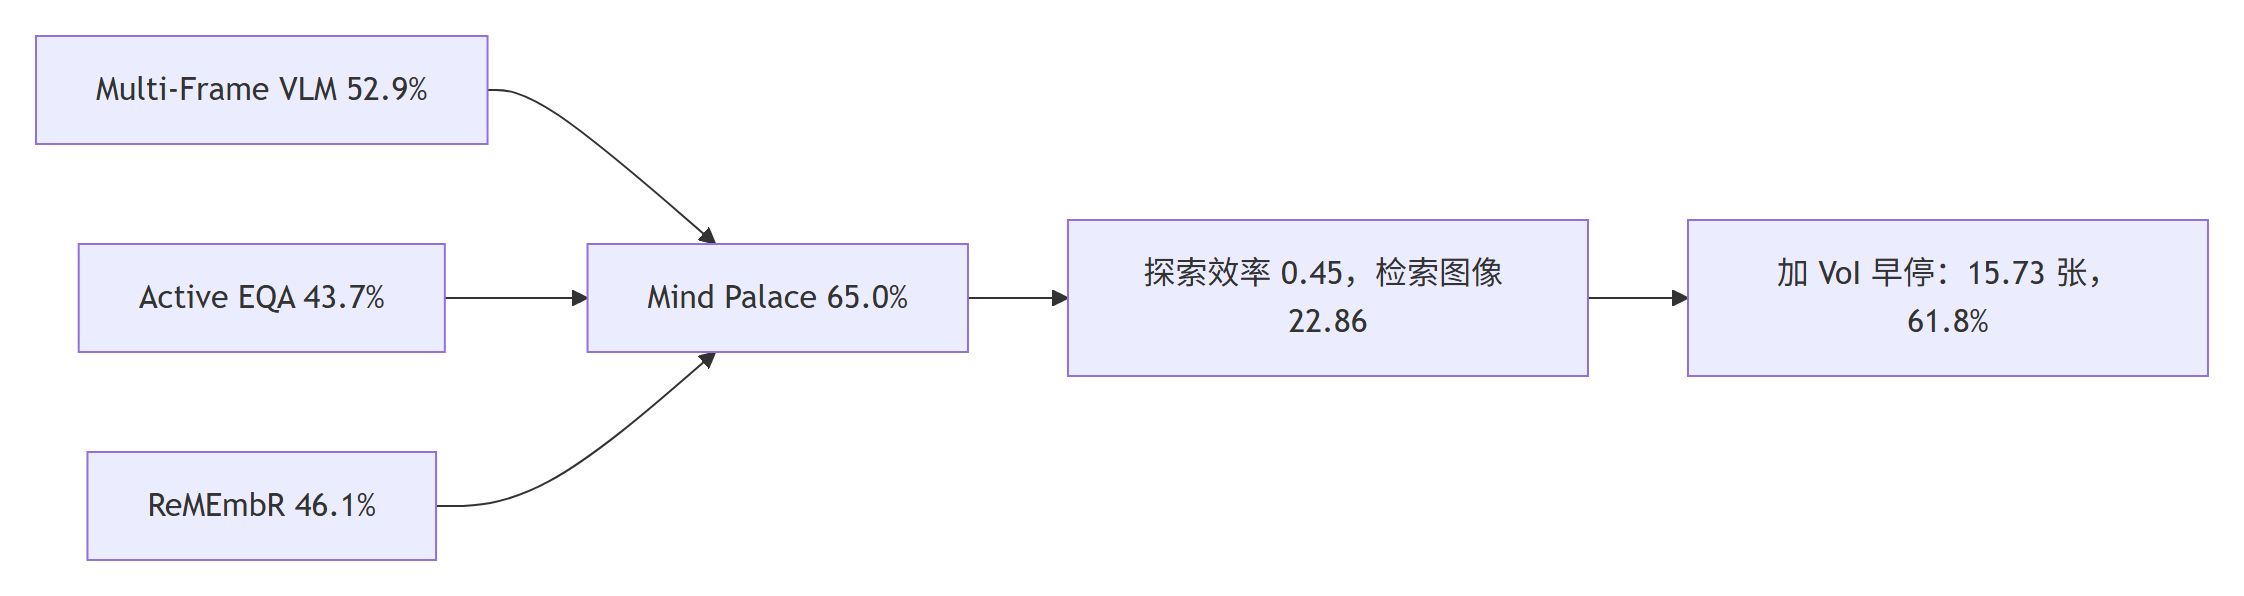
图 9:结果对比总结——基线正确率、本文方法与 VoI 早停的检索开销(Mermaid 流程图)
关键发现
- 正确率提升 12.1 个百分点:本文 65.0% 对比最强基线 Multi-Frame VLM 的 52.9%;相比最弱的 Active Socratic EQA(36.8%)高出 28.2 个百分点。
- 检索效率提升 77.14%:本文平均只检索 22.86 张过去图像,而多帧 VLM 方案需要 100 张,且后者的正确率更低——说明 EQA 问题通常只需要少量与问题强相关的帧。
- 探索效率 0.45:为最强主动式基线 Active EQA(0.29)的 1.55 倍,也远高于 Active Socratic EQA 的 0.19。
- 早停几乎无损:加入 VoI 早停后检索图像从 22.86 张降到 15.73 张(减少 31.2%),答案正确率仅从 65.0% 降到 61.8%。
- 优势随记忆规模增长:情景数越多,本文相对基线的方法优势越大;多帧 VLM 明显下降而 ReMEmbR 稳定。
- 真实部署可行:四足机器人在 1,000 平方米办公室、27 个区域、跨度 6 个月的真实数据上运行,平均节省 3–10 次房间搜索。
局限性
作者诚实地列出了三条主要限制:
第一,长期理解受限于过去轨迹的覆盖范围。 真实实验中有一道题要求找出连续多日无人使用的工位,但机器人每天只巡检一小时,在未被覆盖的时间段里桌子其实被用过,而记忆里它一直是空置的,于是机器人选错了答案。这暴露出记忆的时间覆盖率问题——不是推理能力的缺陷,而是数据覆盖的缺陷。作者认为这是一个有价值的方向:让智能体意识到"我的信息不足",并主动向人类或其它智能体请求补充信息。
第二,瓶颈也在视觉语言模型本身。 未能拿到满分的题目主要源于 VLM 的语义与空间理解能力:漏检物体、计数错误、对物体功能属性的判断错误;此外 VLM 常把机器人在同一区域拍到的所有物体都归到该区域,而画面中其实含有其它区域的视角。作者指出更强的 VLM 或专用视觉模型可以直接替换进框架,性能会随之提升。
第三,基准目前依赖专家手工设计。 场景变化与题目均由团队人工构建,限制了基准的规模化。作者尝试用语言模型生成题目,但效果仍远不够好;要在长期设置下自动化场景生成与题目生成,还需要更多研究。
常见问题(FAQ)
什么是长期主动具身问答(LA-EQA)?
LA-EQA 是论文提出的新任务:机器人必须同时回忆过去经历与主动探索当前环境,才能回答带时间约束的问题。它把"主动式 EQA"(只探索、无长期记忆)与"情景式 EQA"(只用单段轨迹、无探索)统一成一个更难的设定,并用五元组 $(Q, M, E, x_0, A^*)$ 形式化。
Mind Palace Exploration 和已有的记忆检索方法(如 ReMEmbR)有什么不同?
ReMEmbR 用向量数据库存储位姿、时间与图像描述并做检索,但不支持主动探索,也没有跨世界实例的结构化组织。Mind Palace Exploration 把长期记忆切成多个分层场景图世界实例,让检索与导航共用同一次图搜索,并用 VoI 判据决定何时停止回忆。结果是正确率 65.0% 对 46.1%,优势达 18.9 个百分点。
记忆宫殿为什么能同时提高正确率和效率?
关键在于过去与当下被放进同一套表示。视点节点携带的位姿、图像与帧描述充当检索索引,区域节点让大空间可以被增量搜索;而因为检索与探索共享同一张图,机器人能用过去的物体位置先验来指导当下的搜索路径。因此它只用 22.86 张图像就达到了 65.0% 的正确率,而多帧 VLM 需要 100 张却只有 52.9%。
VoI 早停是怎么工作的?
系统先用语言模型在当前世界实例上形成区域预测集,阈值 $P(y) \geq 1-q$ 可用保形预测校准;随后有两个立即停止检索的条件——预测集只剩一个区域,或继续检索不会改变下一步计划。第二个条件用信息价值衡量:如果新增观测不会改变最优动作,VoI 为 0,检索就是浪费。实测把检索图像从 22.86 张降到 15.73 张,正确率只下降约 3 个百分点。
这个方法在真实机器人上跑得动吗?
论文给出了正面证据:四足机器人在 1,000 平方米、27 个区域的真实办公室中作为助理运行,使用过去 4 天的巡检记忆与 6 个月的月度巡检记录,在 7 道需要主动探索的题目上平均节省 3–10 次房间搜索。除语言模型查询外,记忆存储与规划全部在机器人本地完成。
这个工作的主要局限是什么?
三条:其一,长期理解受限于过去轨迹的时间覆盖率,未被巡检覆盖的时段发生的事情机器人无从得知;其二,答案正确率的缺口主要来自 VLM 的语义与空间理解能力,如漏检、计数错误与区域归属错误;其三,基准的场景变化与题目仍依赖专家手工设计,语言模型自动生成题目的效果尚不理想。
参考链接
- 论文 arXiv 摘要页:https://arxiv.org/abs/2507.12846
- 项目主页(含论文、视频与代码入口):https://mind-palace-laeqa.github.io/
- 基准代码仓库:https://github.com/mind-palace-laeqa/benchmark
- 论文正式出版页(PMLR 305):https://proceedings.mlr.press/v305/ginting25a.html
- 关键基线 OpenEQA(CVPR 2024)项目页:https://open-eqa.github.io/
- 关键基线 OpenEQA 代码与基准:https://github.com/facebookresearch/open-eqa
- 关键基线 ReMEmbR(ICRA 2025):https://arxiv.org/abs/2409.13682
- 同团队前作 SEEK(RSS 2024):https://arxiv.org/abs/2405.09822
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献56条内容

所有评论(0)