【ICLR 2026】ELMUR:长时程部分可观测决策,给每一层 Transformer 装上可重写的外部记忆|从智能体记忆与具身决策视角
摘要
本文解读 ICLR 2026 论文《ELMUR: External Layer Memory with Update/Rewrite for Long-Horizon RL Problems》。该论文提出 ELMUR——一种在 Transformer 的每一层外挂结构化外部记忆的架构,通过融合层内局部记忆嵌入、双向 token–memory 交叉注意力与基于 LRU 的替换/凸混合重写规则,让智能体在部分可观测的长时程任务中仍能记住很久之前出现过的关键线索,其特别之处在于记忆容量有界、开销与序列长度解耦,且完全不改动注意力本身。实验表明在上下文只有 10 步的前提下,ELMUR 在长达一百万步的 T-Maze 走廊上仍保持 100% 成功率,在 MIKASA-Robo 的 32 个操作任务上把聚合成功率从 5.42 提升到 9.24(相对提升约 70%),并在 POPGym-48 上以 10.41 的总分居首,为长时程记忆与具身决策提供了重要借鉴。
视频讲解:点击观看 B 站视频
论文基本信息
| 项目 | 内容 |
|---|---|
| 标题(英文) | ELMUR: External Layer Memory with Update/Rewrite for Long-Horizon RL Problems |
| 标题(中文) | 长时程部分可观测决策:给每一层 Transformer 装上可重写的外部记忆 |
| 作者 | Egor Cherepanov$^{1,2}$, Alexey K. Kovalev$^{1,2}$, Aleksandr I. Panov$^{1,2}$ |
| 机构 | 俄罗斯人工智能研究院(AIRI)· 莫斯科物理技术学院(MIPT) |
| 会议 | ICLR 2026 |
| arXiv | arXiv:2510.07151 |
| 项目网站 | elmur-paper.github.io |
背景与动机
论文用了一个非常具体的场景开场:机器人煮意面时把盐加了一遍又一遍,因为盐溶进汤里看不见,它无法确认自己是否已经加过。这正是部分可观测的日常形态——世界不会把所有必要信息同时呈现出来。
在强化学习的形式化里,这类任务被建模为 POMDP:$(\mathcal{S}, \mathcal{A}, \mathcal{O}, T, Z, R, \rho_0, \gamma)$,其中状态空间与观测空间分离,最优策略必须依赖整段历史 $h_t = (o_0, a_0, \dots, o_t)$ 而不是当前观测 $o_t$。一个实用的替代方案是把历史压缩成一个学到的记忆状态,即 $\pi(a_t \mid m_t)$,其中 $m_t$ 由某种更新规则递推得到。
问题在于,关键线索往往出现在决策之前很久。该团队在前序工作中把这件事量化成「相关性视界」$\xi = t_r - t_e - \Delta t + 1$:它衡量一次事件结束到需要回忆它的决策点之间隔了多少步。只要 $\xi > 1$,纯反应式的策略就不够用。而现有路线各有硬伤:
- 扩大注意力窗口:代价随长度平方增长,长时程任务直接不可承受。
- 截断历史:直接遗忘,线索一旦滑出窗口就再也找不回来。
- 隐式循环(LSTM、xLSTM、Mamba 等):把历史压进隐藏动态,效率高但对「存什么、什么时候忘」几乎没有控制权。
- 可寻址外部记忆(NTM、DNC):容量可控,但寻址与优化复杂,在长时程决策上难以稳定训练。
- 序列模型改造(RATE、GTrXL、AMAGO-2、DMamba):把循环记忆重新接回决策 Transformer,但记忆通常拼接在序列层面,仍受上下文长度牵制。
作为对照,本文选择的基线覆盖了完整的谱系:决策 Transformer(DT)、带记忆的循环动作 Transformer(RATE)、状态空间模型(DMamba)、行为克隆(BC-MLP、BC-LSTM)、离线强化学习(CQL)与生成式策略(Diffusion Policy)。论文明确说明不比较在线强化学习,因为其交互式探索预算不可比;也不做真机实验,以避免延迟、复位与安全约束带来的混淆。
从历史脉络看,这条技术线相当清晰:2019 年的 Transformer-XL 用段级循环加激活缓存迈出第一步;随后压缩缓存与可检索外部键值对让「容量」成为显式问题;2023 年的 POPGym 与同期工作把「记忆长度」与「信用分配长度」解耦,证明 Transformer 在强化学习里的优势主要来自记忆——需求第一次被量化;到 2026 年,RATE 把循环记忆接回决策 Transformer,而本文把记忆下沉到每一层,并用 LRU 显式规定覆盖策略,同时给出半衰期与有界性证明。
研究主线:从问题到结论
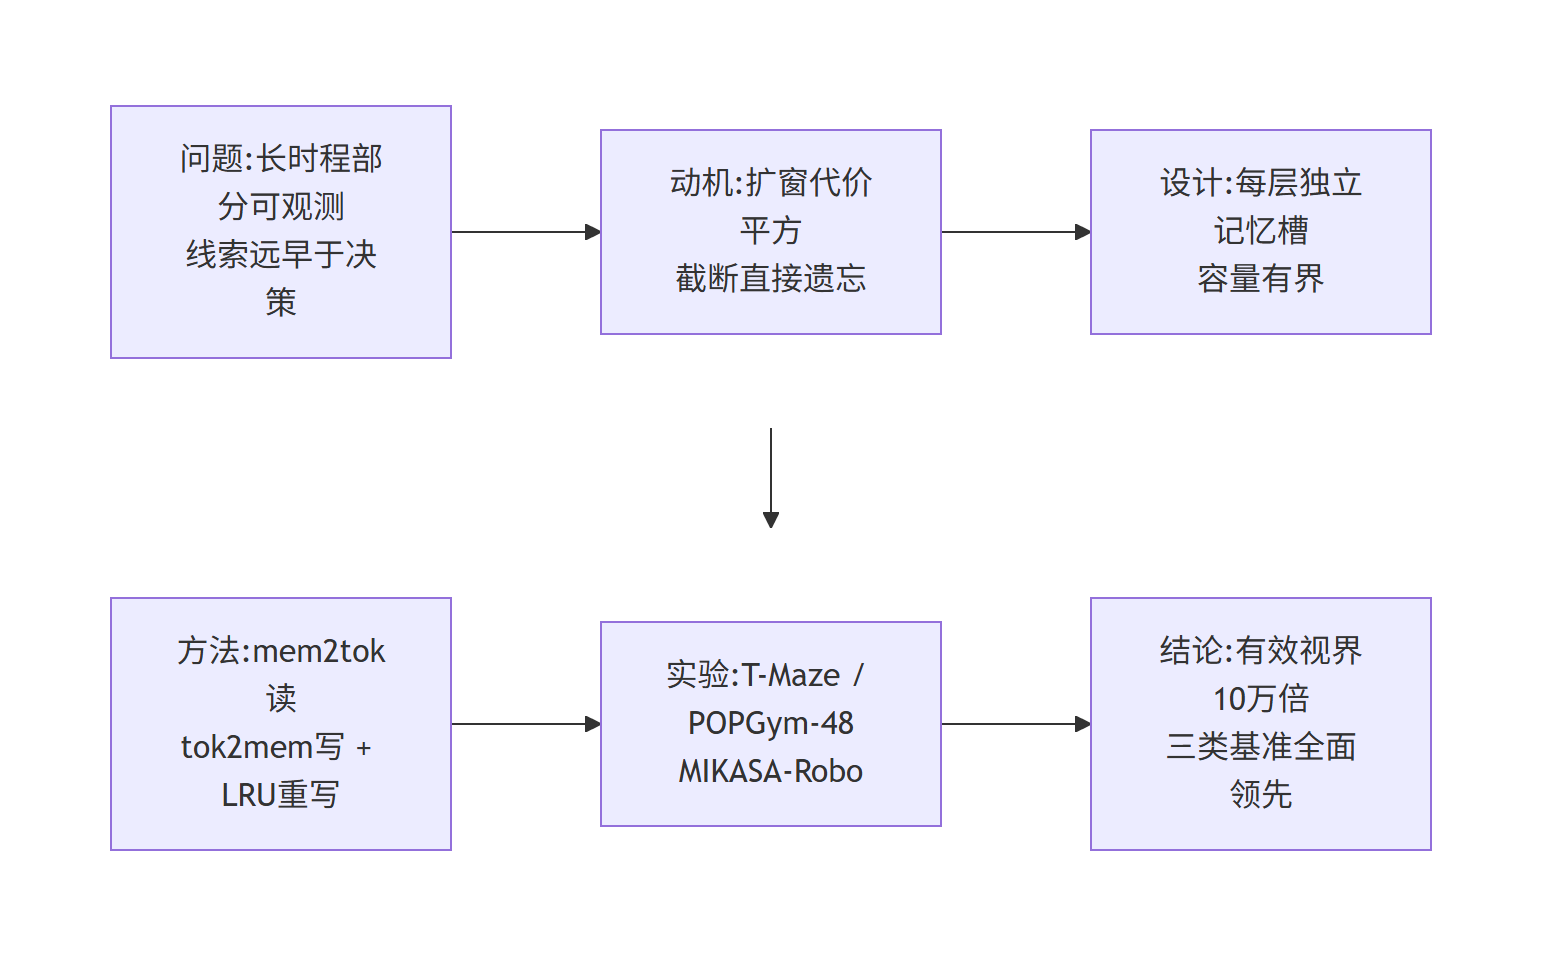
图 13:ELMUR 的研究主线——从部分可观测下「线索远早于决策」的问题出发,指出扩大窗口与截断历史这两条现成路线的失效模式,进而设计出每层独立、容量有界的记忆槽,用双向交叉注意力读写并由 LRU 规则决定覆盖谁,最终在合成、棋盘控制与视觉操作三类基准上验证,得到有效记忆视界达注意力窗口十万倍量级的结论。(Mermaid 流程图)
基准/方法设计
ELMUR 的出发点是:不要让注意力去装历史,而是给它配一条旁路。整体架构仍是 GPT 式的 Transformer 解码器,但每个层里都有两条并行轨道——token 轨道负责把观测变成动作,记忆轨道负责跨段持久。两条轨道通过交叉注意力交换信息。
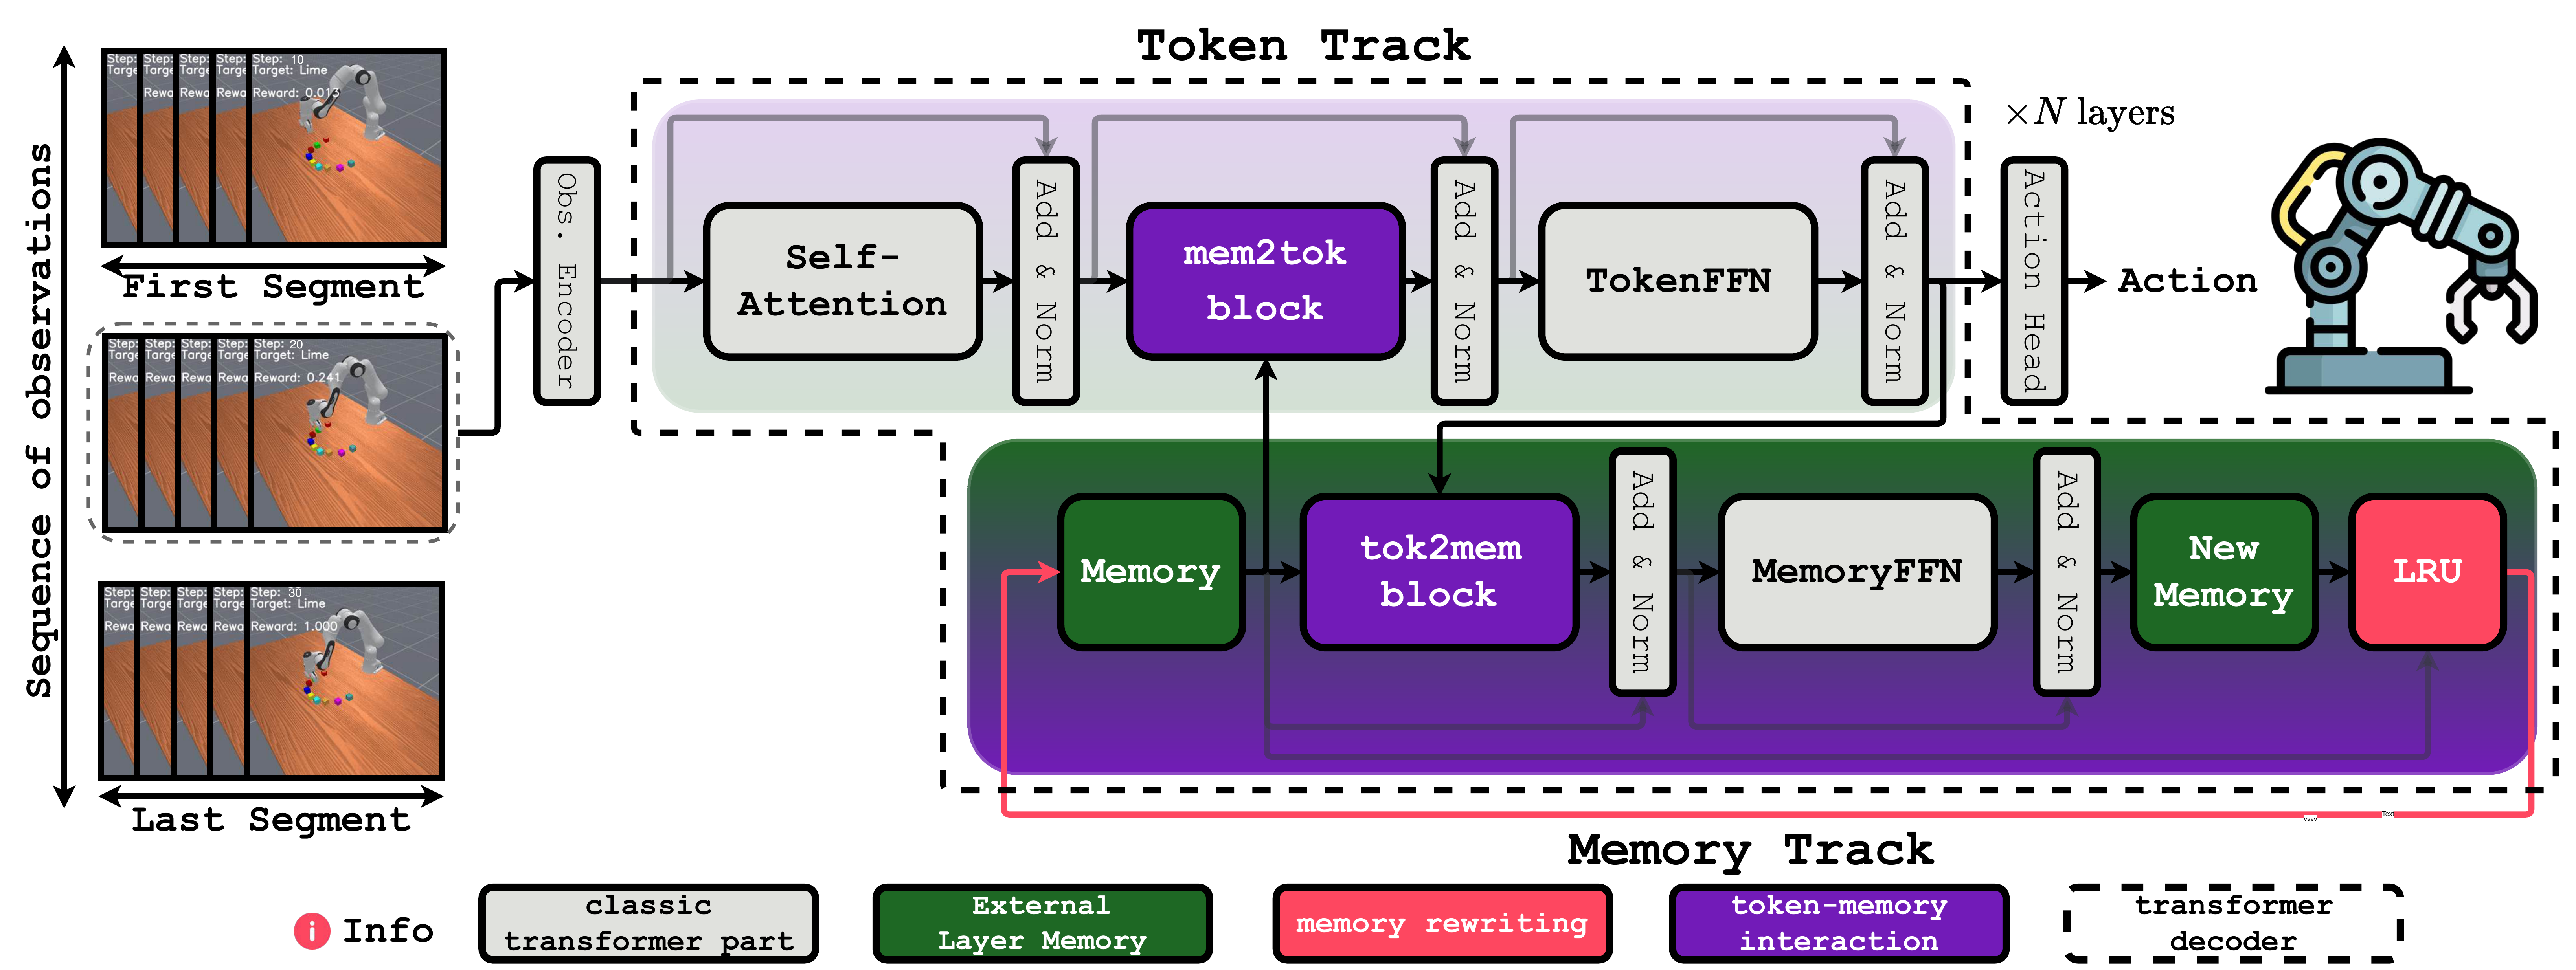
图 1:ELMUR 的总体设计。每个 Transformer 层在 token 轨道之外并行维护一条记忆轨道;token 通过 mem2tok 从记忆读取信息,记忆通过 tok2mem 从 token 吸收新内容,LRU 块决定用替换还是凸混合来重写某个槽——容量有界,但信息可以跨任意多的段延续。
设计上有三个必须同时成立的要素:
- 层内局部记忆嵌入:每一层各自持有一组记忆向量,而不是全网络共享一个记忆池。消融实验显示,把每层独立记忆改为共享记忆,成功率会从 1.00 直接掉到 0.45,说明层内局部性是负载要素而非实现细节。
- 双向读写交叉注意力:读路径 mem2tok 让 token 以记忆为键和值取信息;写路径 tok2mem 在段末让记忆从 token 吸收新内容。
- LRU 重写规则:记忆槽在填满之前整槽替换,填满之后只刷新最久未使用的那个槽,并与新内容做凸混合。
这个设计还带来一个容易被忽略的好处:记忆的开销随槽数增长,而不是随序列长度增长。在 T-Maze 上 ELMUR 有 2.1M 参数(RATE 为 1.7M、DT 为 1.8M),但每一步反而更快:单步耗时 $6.8 \pm 0.5$ 毫秒,优于 RATE 的 7.2 毫秒与 DT 的 10.7 毫秒。
分类全景
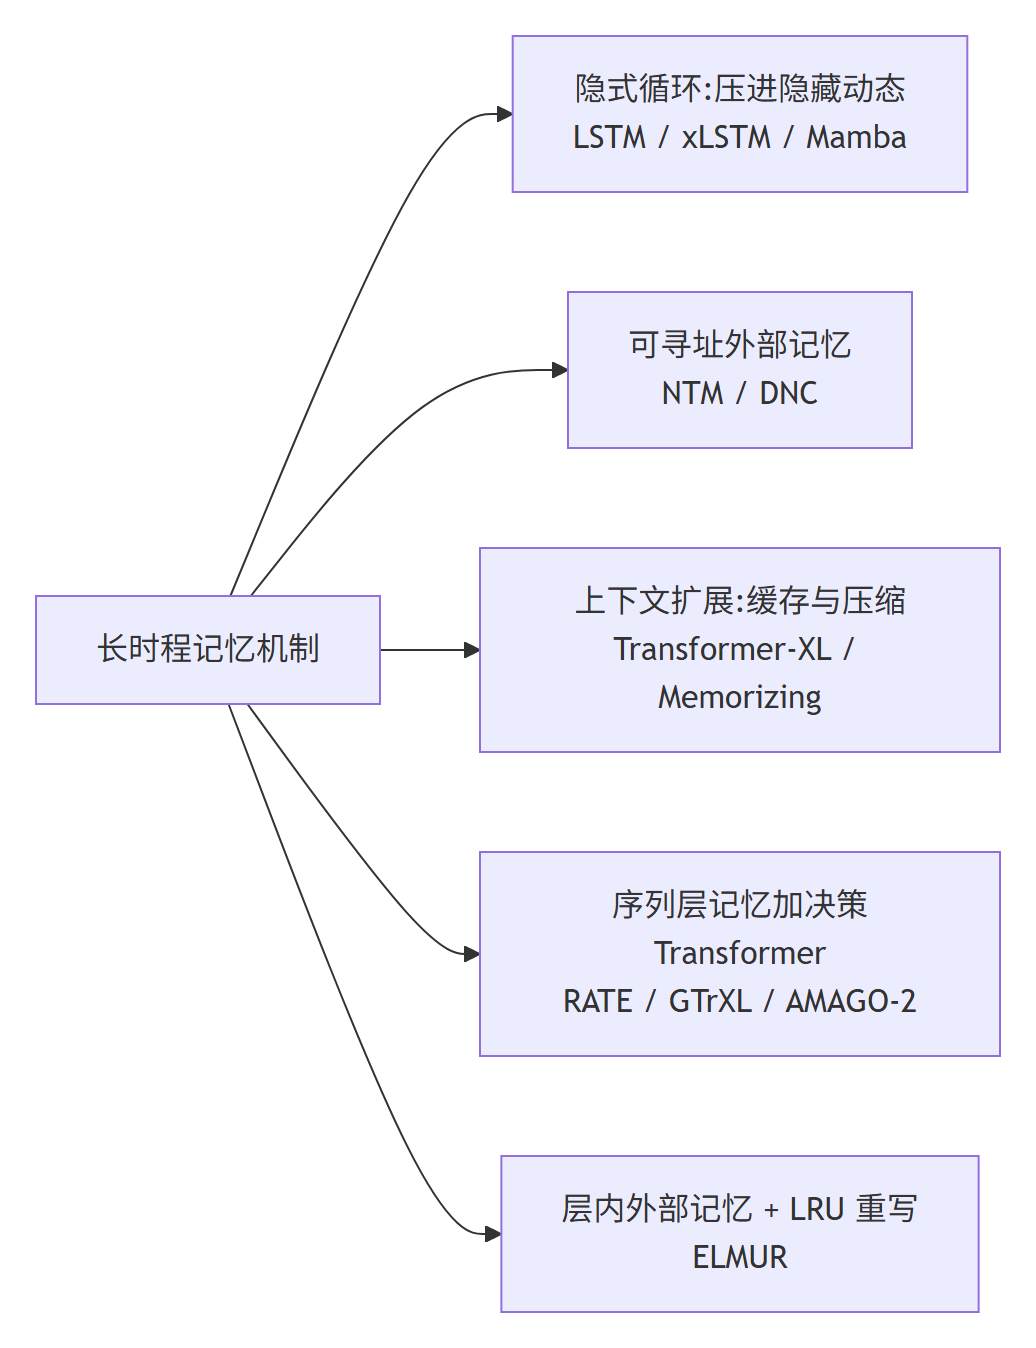
图 14:长时程记忆机制的分类。横轴按「记忆存在哪里、由谁控制遗忘」划分:隐式循环把历史压进隐藏动态但几乎不控制遗忘;可寻址外部记忆容量可控但优化复杂;上下文扩展把缓存放在核心计算之外;序列层记忆把它拼接进输入;ELMUR 则把记忆放进每一层,并用 LRU 显式决定覆盖谁。(Mermaid 分类图)
方法细节
LRU 记忆管理是整套机制的核心。每一层维护 $M$ 个记忆槽,每个槽持有一个向量和一个锚点(该槽最后一次被更新的时刻)。初始化时槽内是随机向量并被标记为空。
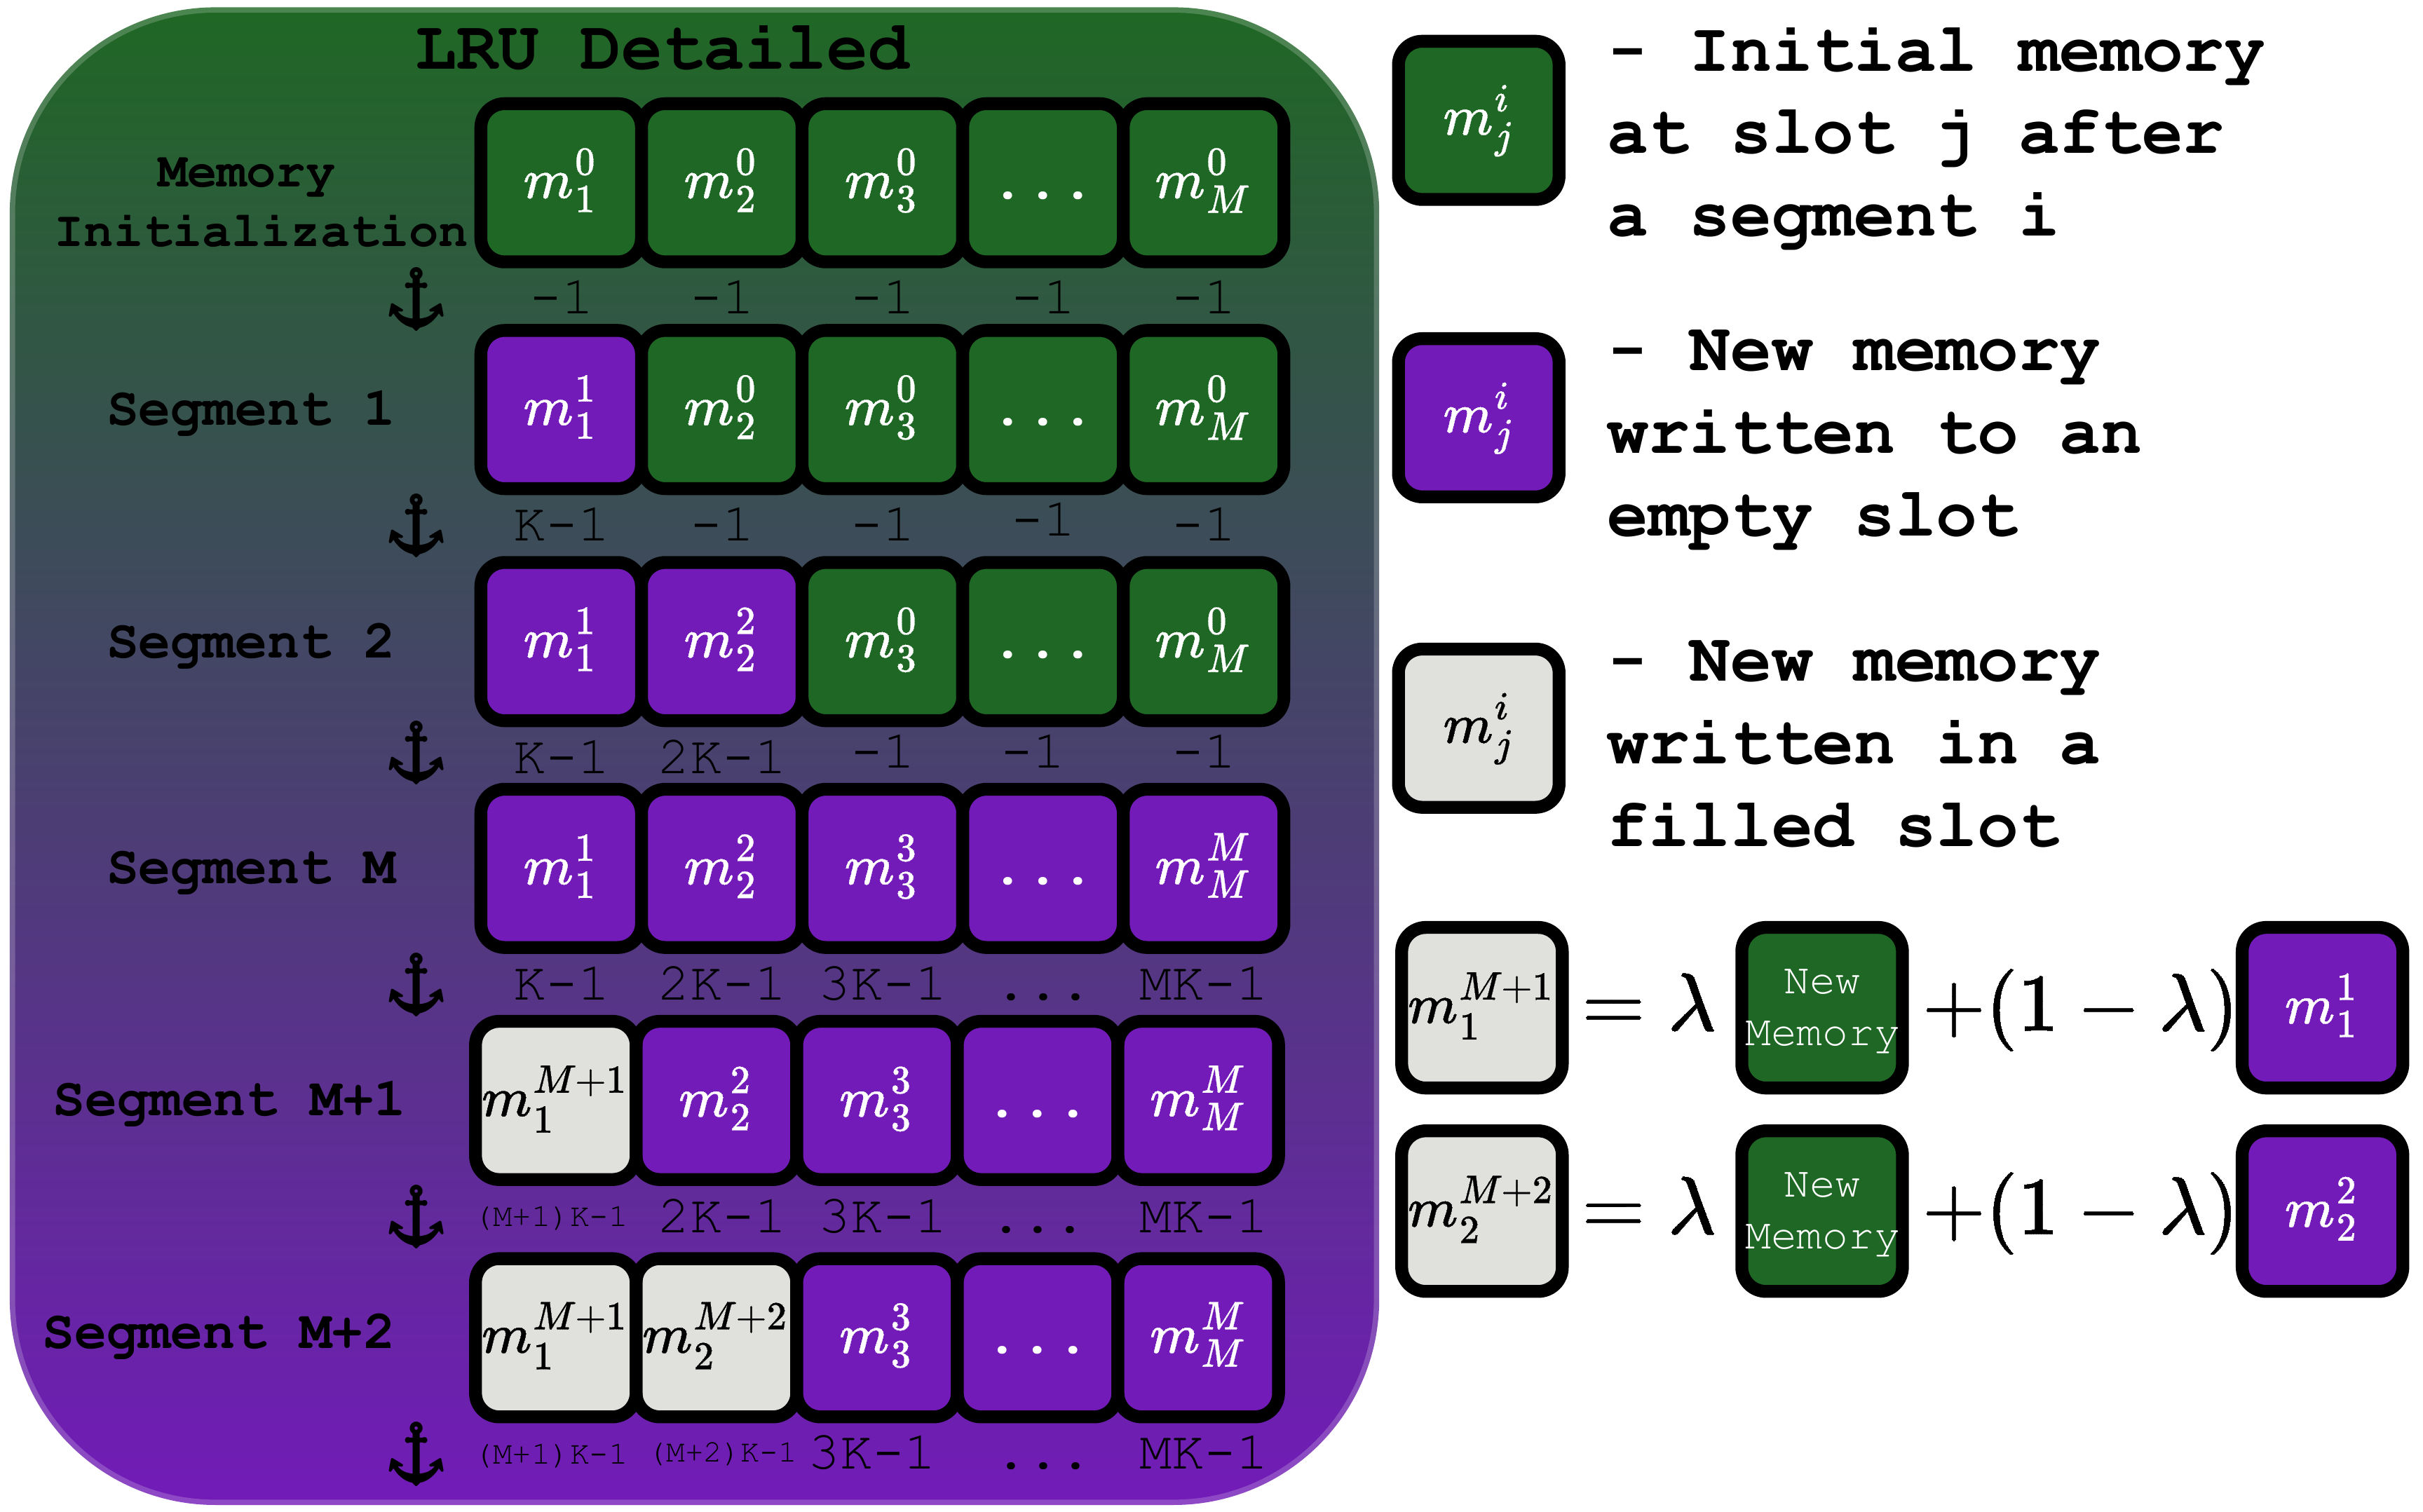
图 2:LRU 记忆管理。新内容先填满空槽(整槽替换);全部填满后,只刷新最久未使用的槽,并与新内容做凸混合。槽下的锚点记录最近一次更新时间——这条规则让容量有界,同时保住长时程信息。
当所有槽被占满后,写入不再是整槽替换,而是凸混合。若把第 $j$ 个槽在第 $i$ 段之后的更新写成 $\mathbf{m}j^{(i+1)} = \lambda\,\mathbf{m}{\text{new}}^{(i+1)} + (1-\lambda)\,\mathbf{m}_j^{(i)}$,其中 $\lambda \in [0,1]$ 是唯一的混合系数,那么它同时给出了两个可推导的性质:
- 指数遗忘:同一槽在连续重写 $k$ 次之后,初始内容的系数是 $(1-\lambda)^k$,而所有系数之和恰好为 1——这是一条凸组合,因此可以正当地称之为「贡献占比」。由此得到半衰期 $k_{0.5} = \ln 2 / (-\ln(1-\lambda))$,当 $\lambda \to 0$ 时近似为 $\ln 2 / \lambda$。
- 有效视界:由于每 $M$ 段才会轮到某个槽被重写一次,环境步尺度上的保持视界为 $H(\epsilon) = M L \ln(\epsilon) / \ln(1-\lambda)$——它与槽数 $M$ 和段长 $L$ 的乘积成正比。作者特别说明这是一个保守下界,实测视界通常显著更长。
- 有界性:若每次写入的范数不超过常数 $C$ 且初值满足同样约束,凸组合保证任意段、任意槽都满足 $|\mathbf{m}| \le C$,激活尺度不会随轨迹变长而漂移。
还有一个与循环网络的关键区别:没有被选中的槽,其内容完全不动。RNN 每一步都在改写状态,而 ELMUR 的槽在下一次被选中之前逐字保留原值。
时间信号的处理同样值得注意。跨段之后绝对位置失去意义,只有 token 时刻 $t$ 与记忆锚点 $p$ 的相对偏移有意义,于是模型用一张可学习的嵌入表按偏移给出注意力偏置,偏移截断在 $[-D_{\max}+1, D_{\max}-1]$ 区间内;读写两条路径共用同一张表,但可以学出不同的模式(读取用正偏移,写入用反向偏移)。训练时记忆在段之间 detach,不做沿时间的反向传播,损失在每一段上就地计算。
各任务的关键超参如下表——可以看到所需记忆容量随任务变化非常大:
| 参数 | RememberColor | TakeItBack | T-Maze | POPGym-Autoencode |
|---|---|---|---|---|
| $d_{\text{model}}$ | 128 | 32 | 128 | 64 |
| 层数 | 4 | 2 | 2 | 12 |
| 注意力头数 | 16 | 16 | 2 | 4 |
| 记忆槽数 $M$ | 256 | 32 | 2 | 8 |
| 记忆初始化标准差 | 0.1 | 0.001 | 0.001 | 0 |
| LRU 混合系数 | 0.40 | 0.20 | 0.05 | 0.80 |
| 上下文长度 $L$ | 20 | 60 | 10 | 35 |
| 批大小 | 64 | 64 | 128 | 128 |
| 学习率 | 2.05e-4 | 2.57e-4 | 2.06e-4 | 1.16e-4 |
| 训练轮数 | 200 | 300 | 1000 | 800 |
读表提示:原表把混合系数命名为 $\alpha$,而正文与算法用 $\lambda$ 表示同一个量,这是一处符号不一致,数值本身可信。
实验设计与结果
实验覆盖三类基准,共同点是奖励稀疏、观测不完整,因此必须靠记忆而不是靠反应。
- T-Maze:走廊尽头二选一,出发时随机亮出目标;训练时上下文只有 $L=10$、只用 $S=3$ 段,评测时走廊最长到 $10^6$ 步;数据是 6000 条 oracle 成功轨迹。
- MIKASA-Robo:7-DoF 机械臂桌面操作,双路 RGB 观测($3\times128\times128$)加 7 个关节与夹爪,成功才给奖励。其中 RememberColor 要求在延迟与干扰之后回忆隐藏方块的颜色,TakeItBack 要求目标改变后把物体拿回原处;每个环境 1000 条 PPO 专家示范。
- POPGym-48:33 个记忆谜题(copy、reverse、n-back、长走廊)加 15 个部分可观测控制任务,每环境 3000 条 PPO-GRU 专家轨迹。
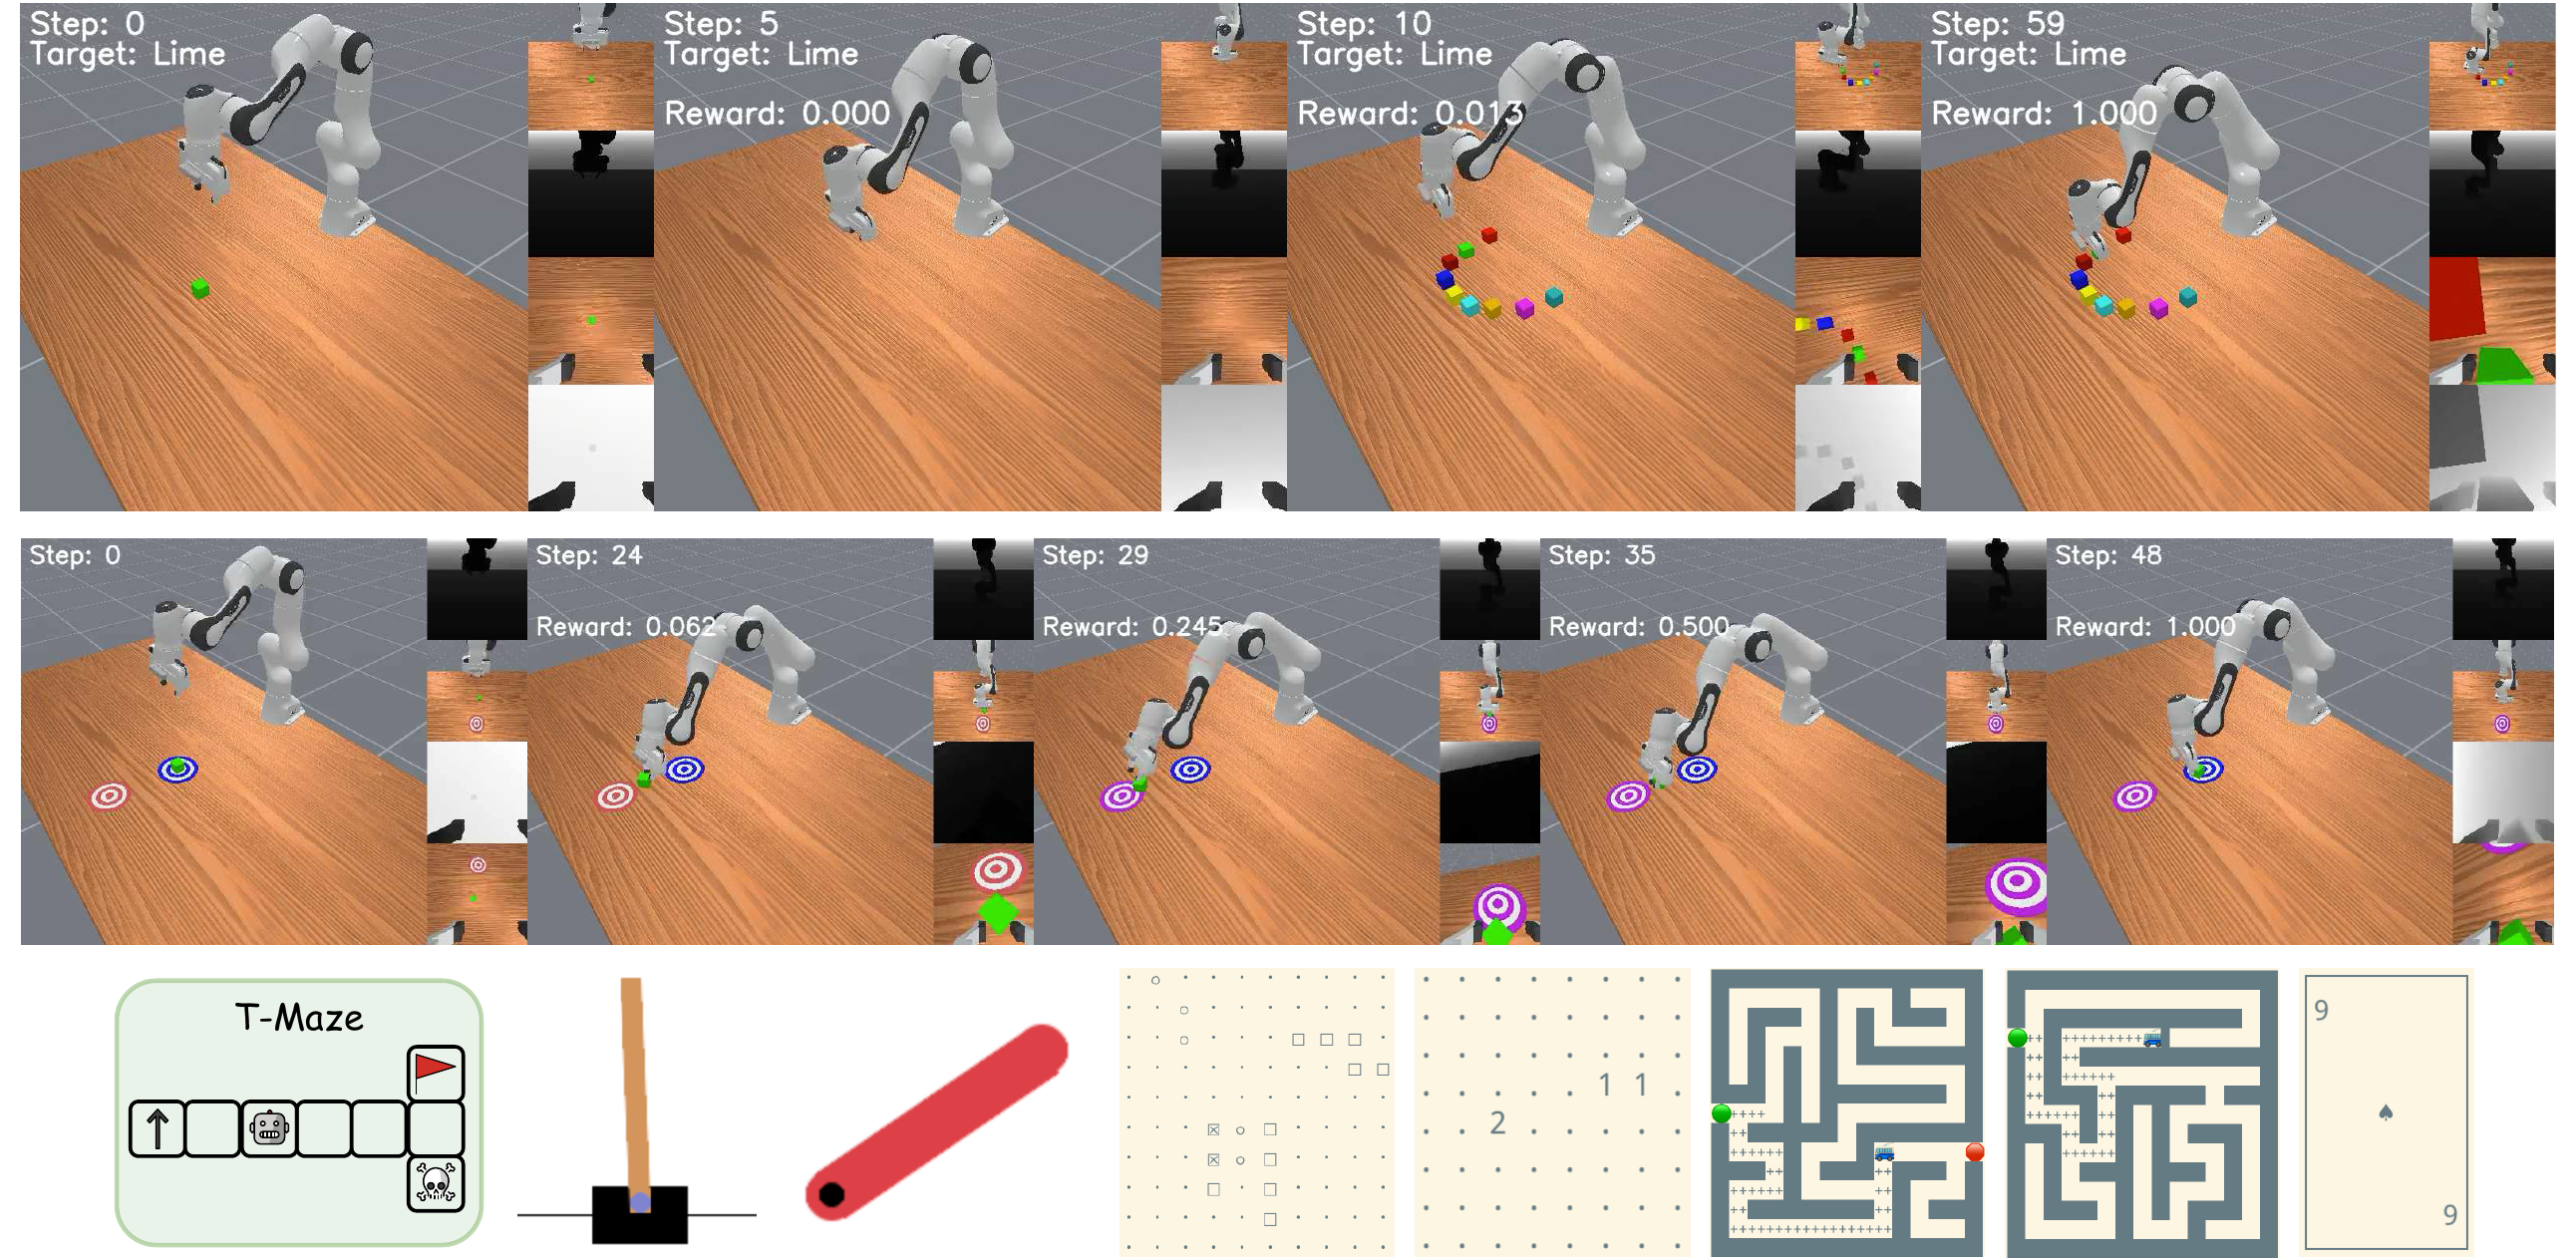
图 3:三类基准的环境。上两条是 MIKASA-Robo 的操作轨迹(RememberColor9 要求延迟后回忆隐藏方块颜色,TakeItBack 要求目标改变后把物体拿回原处),左下是 T-Maze,右下为 POPGym 的棋盘与控制任务。奖励都只在成功时给出。
评测协议是:每个模型跑 3 次独立运行(T-Maze 为 4 次),每次 100 个不同环境种子,报告运行均值的总均值与标准误;所有模型从头训练、使用相同数据预算与预处理;单卡 A100 80GB 承担一个任务。
最关键的结论来自 T-Maze 的外推实验:
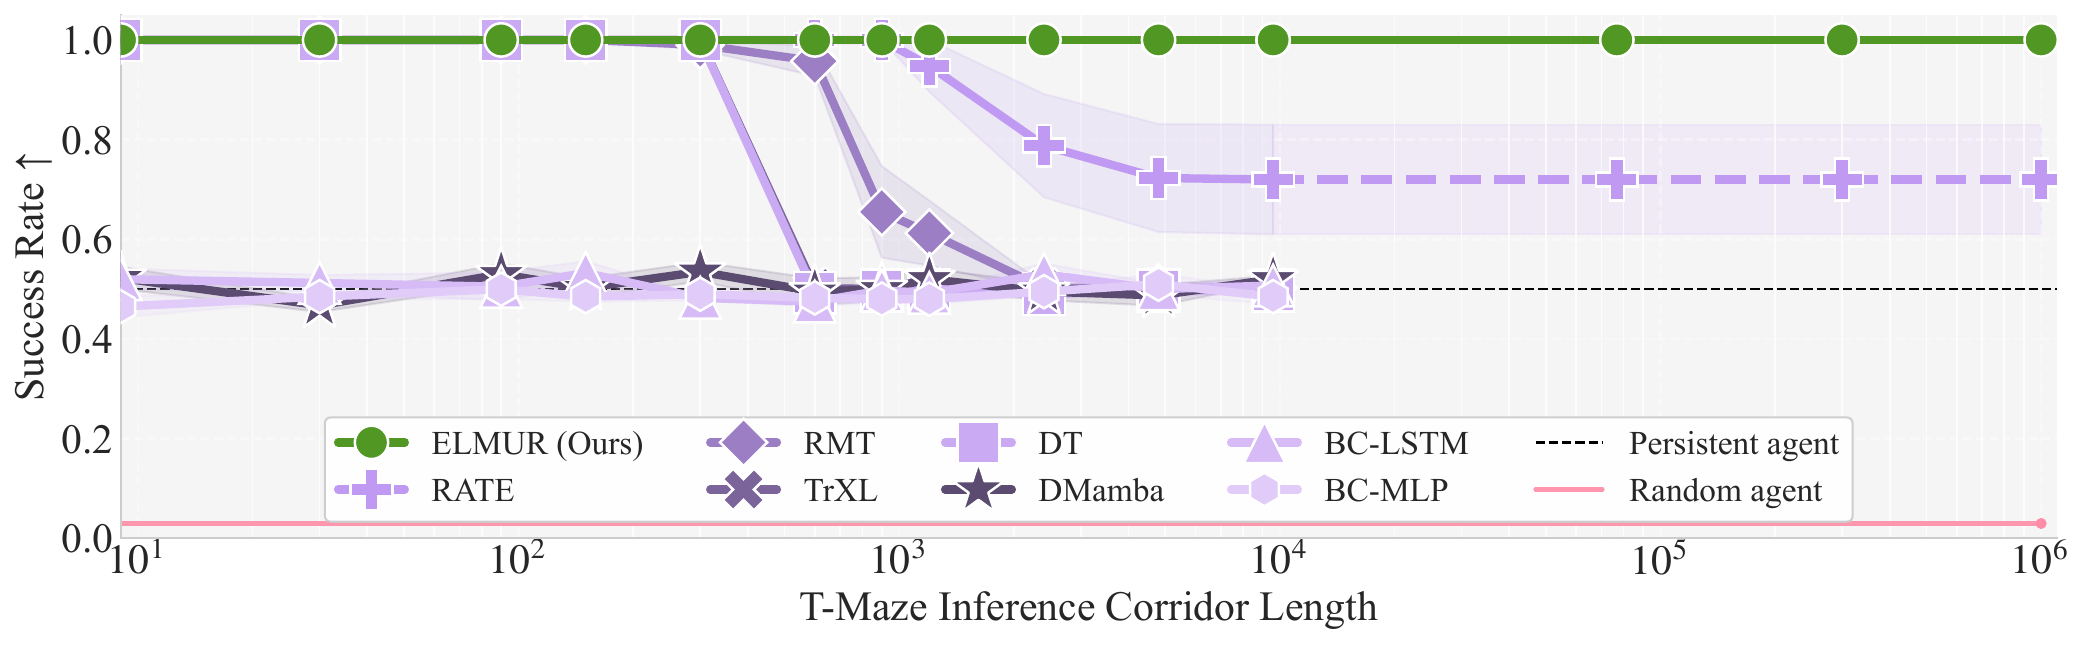
图 4:RQ1 的结果——推理走廊长度与成功率的关系。上下文只有 $L=10$、训练时只用了 $S=3$ 段,但 ELMUR 在一百万步走廊上仍保持 100% 成功率,有效记忆跨度达到注意力窗口的约十万倍。这是全文最强的单条证据。
泛化方向上的表现同样干净:训练长度只覆盖 9 到 900 步,而验证铺开到 9 到 9600 步,所有训练与验证组合都保持满分——向更短的任务迁移不过拟合,向更长的任务迁移不衰减。
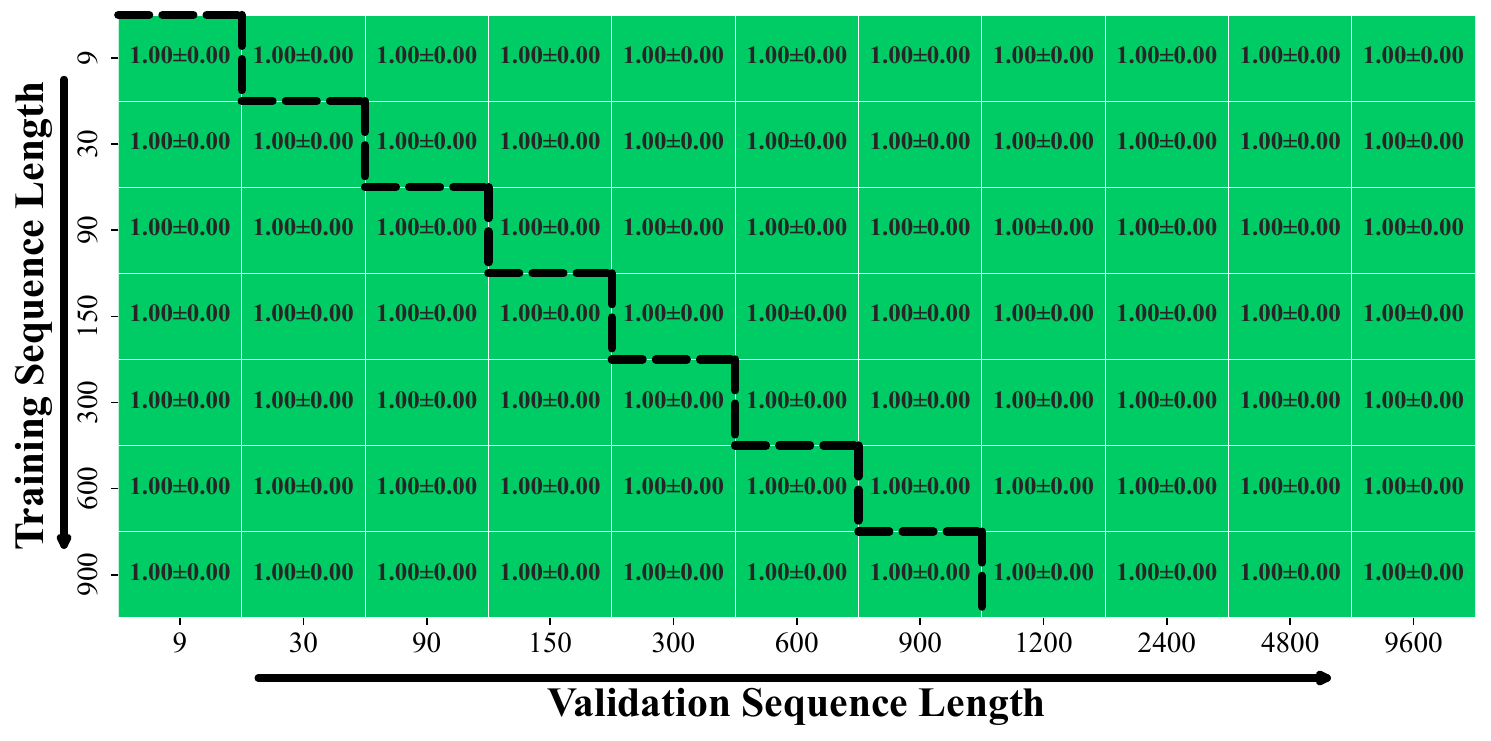
图 5:RQ2 的泛化热力图。训练只用 9–900 步,验证铺到 9–9600 步,所有训练与验证组合都保持 100%,两个方向同时成立。
在 POPGym 上,逐任务对比更能说明改进的分布:
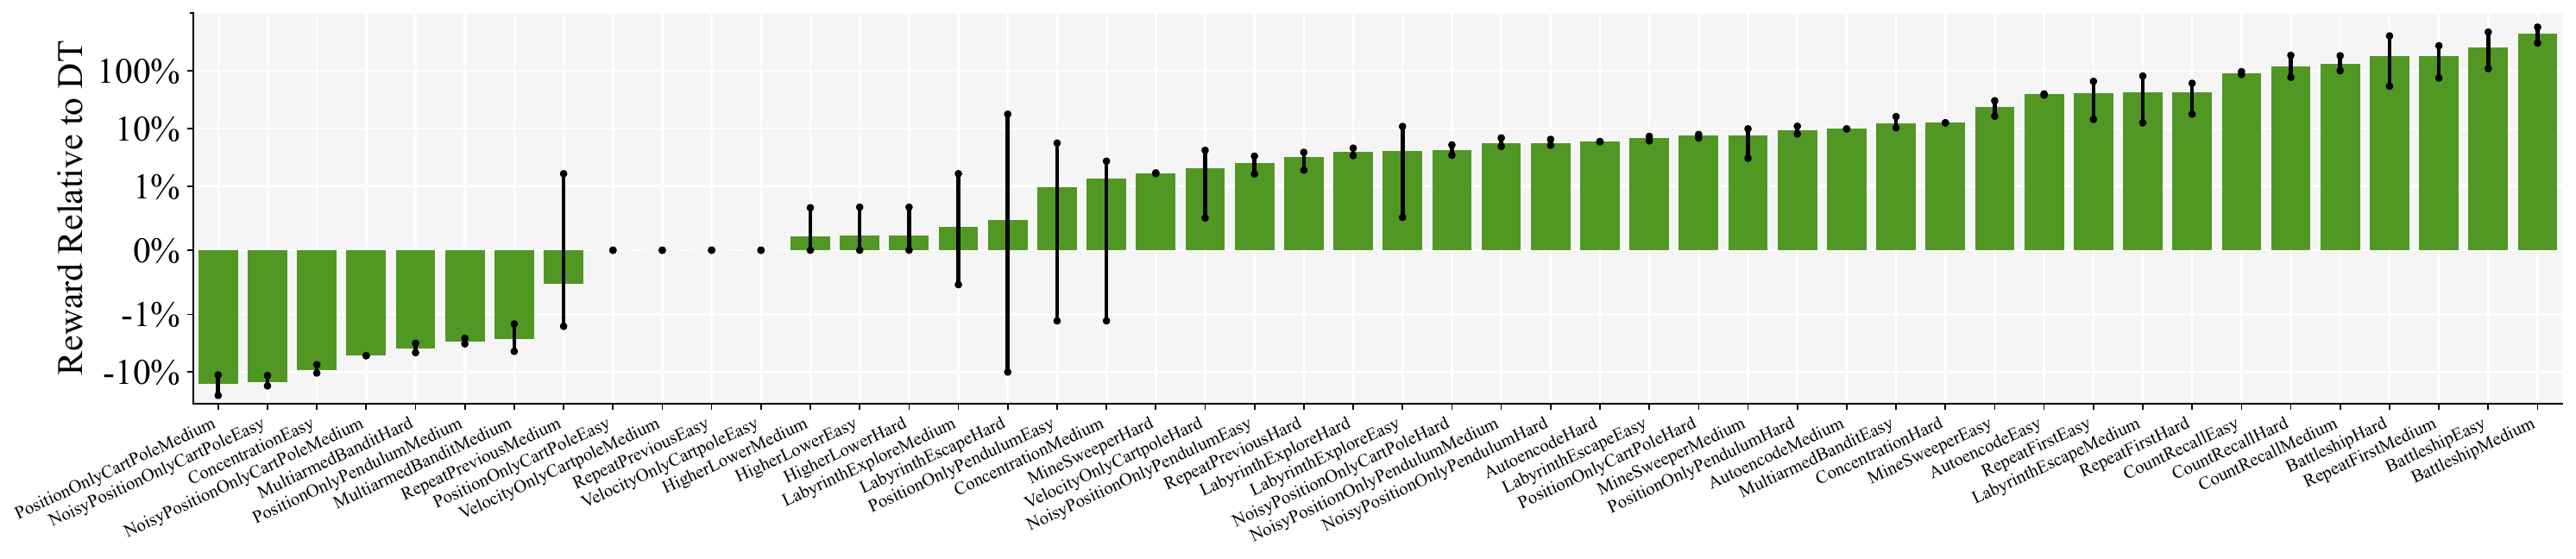
图 6:RQ4 的逐任务对比。对称对数刻度下比较 ELMUR 与 DT 在 48 个 POPGym 任务上的表现,误差条为 3 次运行均值的 95% 置信区间;增益集中在记忆密集型谜题上,控制类任务没有付出代价。
汇总到表格里,三类基准的关键数字如下:
| 基准 | 关键指标 | 最强基线 | ELMUR | 结论 |
|---|---|---|---|---|
| T-Maze($10^6$ 步) | 成功率 | 随长度衰减 | 100% | 超窗口十万倍 |
| MIKASA-Robo(32 任务) | 聚合成功率 | RATE 5.42 | 9.24 | 相对提升约 70% |
| POPGym-48 | 总分 | RATE 9.54 | 10.41 | 24/48 个任务第一 |
| POPGym 记忆谜题(33) | 聚合回报 | RATE 0.45 | 1.2 | 记忆类增益最大 |
| TakeItBack-v0 | 成功率 | RATE 0.42 ± 0.24 | 0.78 ± 0.03 | 延迟反转近乎翻倍 |
消融实验给出了清晰的组件排序:
| 设置 | 得分 |
|---|---|
| 基线 ELMUR | 1.00 ± 0.00 |
| 共享记忆(各层共用一个记忆池) | 0.45 ± 0.03 |
| 去掉相对偏置 | 0.95 ± 0.05 |
| 去掉 LRU | 0.43 ± 0.22 |
| 去掉相对偏置与 LRU | 0.22 ± 0.11 |
| MoE 前馈换回 MLP | 1.00 ± 0.00 |
超参消融进一步显示,记忆容量是硬阈值:当槽数 $M$ 大于任务所需的段数 $N$ 时,几乎所有设置都能达到满分;一旦 $M<N$,准确率断崖式下跌,而且对混合系数、初始化标准差与分段方式都高度敏感——容量不足会把其他所有设计选择都变成陷阱。
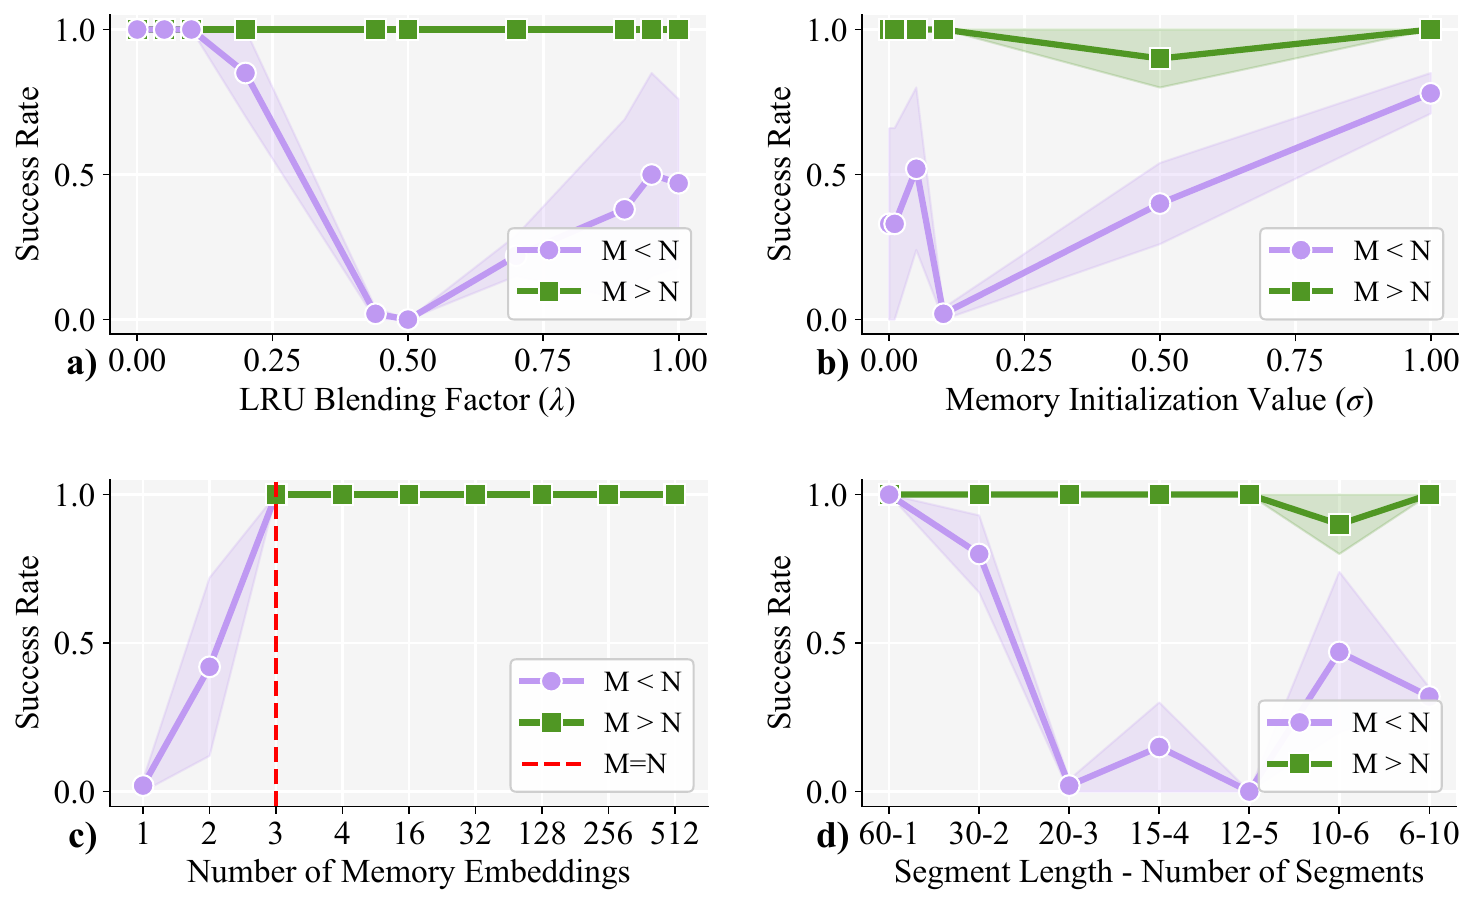
图 10:记忆超参在 RememberColor3-v0 上的消融。曲线分「容量不足($M N$)」两组:容量充足时几乎处处满分,容量不足时对混合系数、初始化与分段高度敏感。
为了回答「信息到底是写在记忆里,还是仅仅因为参数更多」,论文做了一组记忆探测实验。做法是:先把策略训练到专家水平,再跑 1000 个成功回合,逐时刻抽出每一层的记忆向量与真值颜色标签;对每个「层 × 时刻」组合单独训练一个三层 MLP 探针(隐藏维度 512,交叉熵,Adam 200 轮,80/20 划分)。探针是事后训练的,不参与策略更新。
| 探针时刻 $t$ | 第 0 层 | 第 1–2 层 | 第 3 层 |
|---|---|---|---|
| $t=0$(记忆仍随机) | 约 33% | 约 33% | 约 33% |
| $t=1$(首次写入后) | 已可解码 | 逐渐下降 | 最弱 |
| $t=5$(线索已消失) | 100% | 高 | 高 |
| $t=10$ / $t=20$ | 基本满分 | 基本满分 | 略低 |
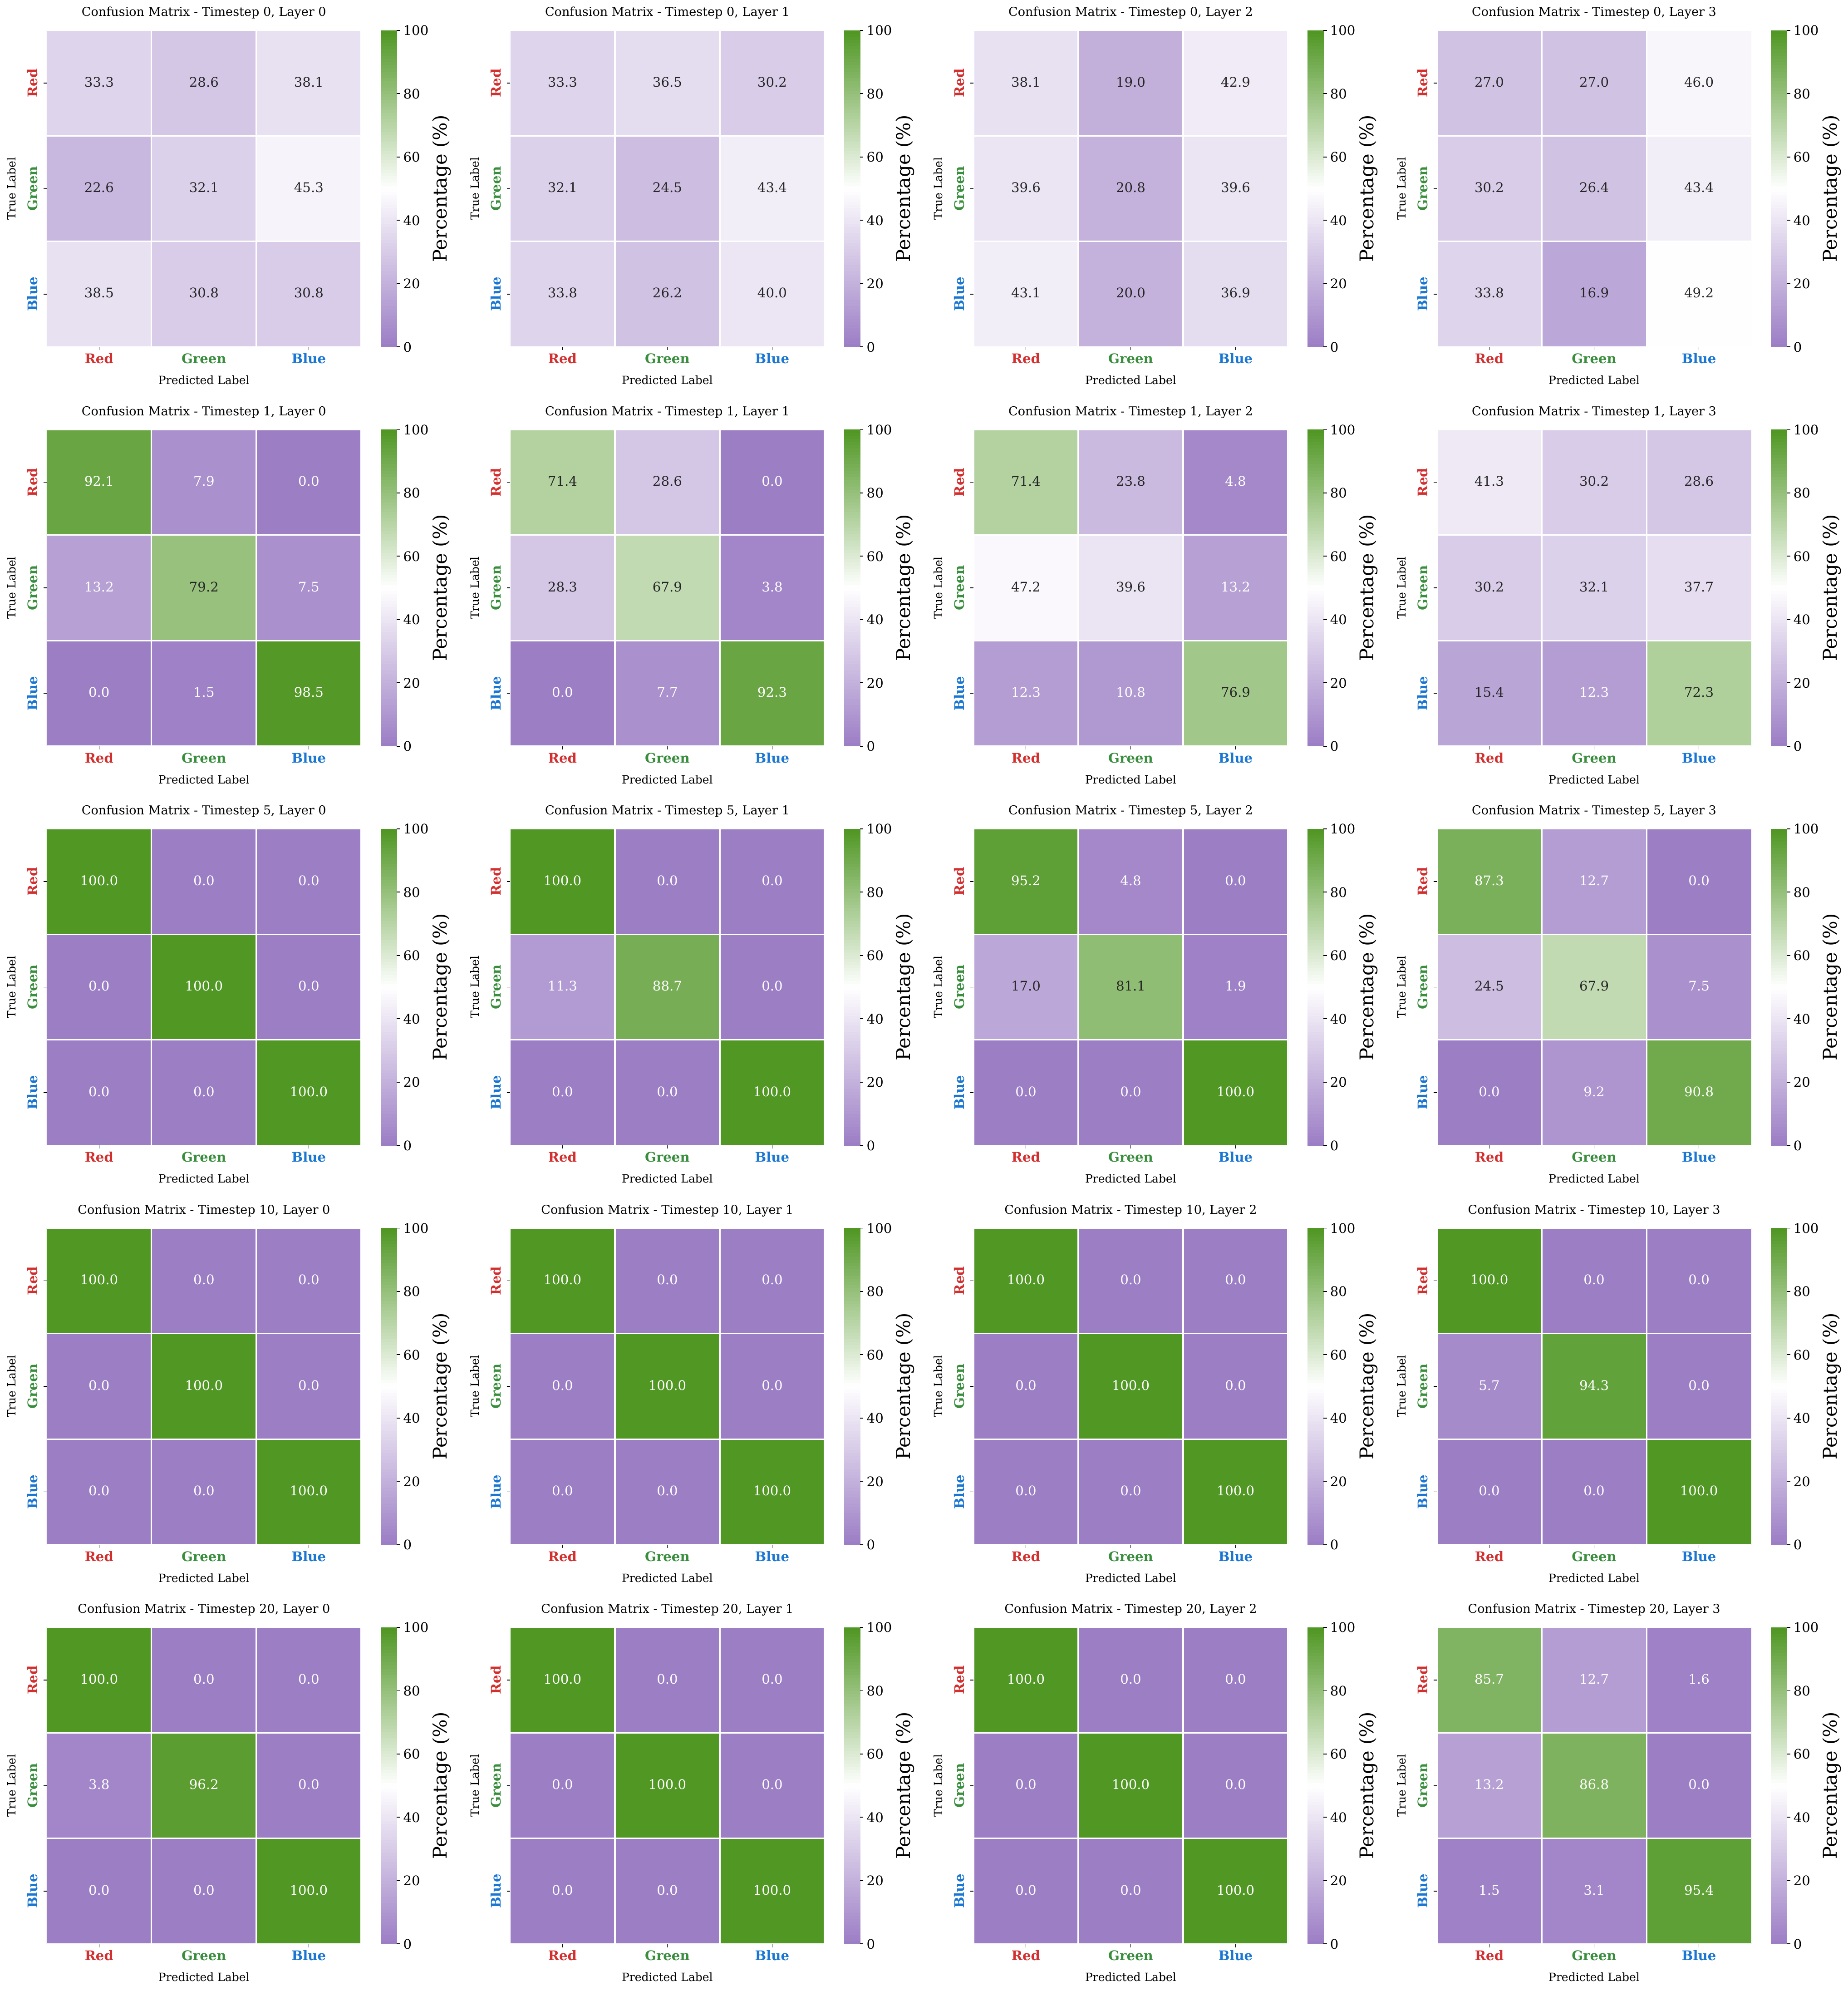
图 7:记忆探测的混淆矩阵(行为 $t \in {0,1,5,10,20}$,列为第 0–3 层)。$t=0$ 时各层都接近三分类随机水平;$t=1$ 第 0 层已能可靠解码;$t=5$ 线索已从画面消失却达 100%;到 $t=10$ 与 $t=20$,前几层接近满分,只有最深层略低。
写入的时机同样高度结构化。各层呈现同一套轮转表:早期只有槽 0 被写,随后职责转到槽 1,再到槽 2;一个槽一旦失去职责就再也不被修改,因此整段回合只有零星几次写入,而不是持续翻搅。
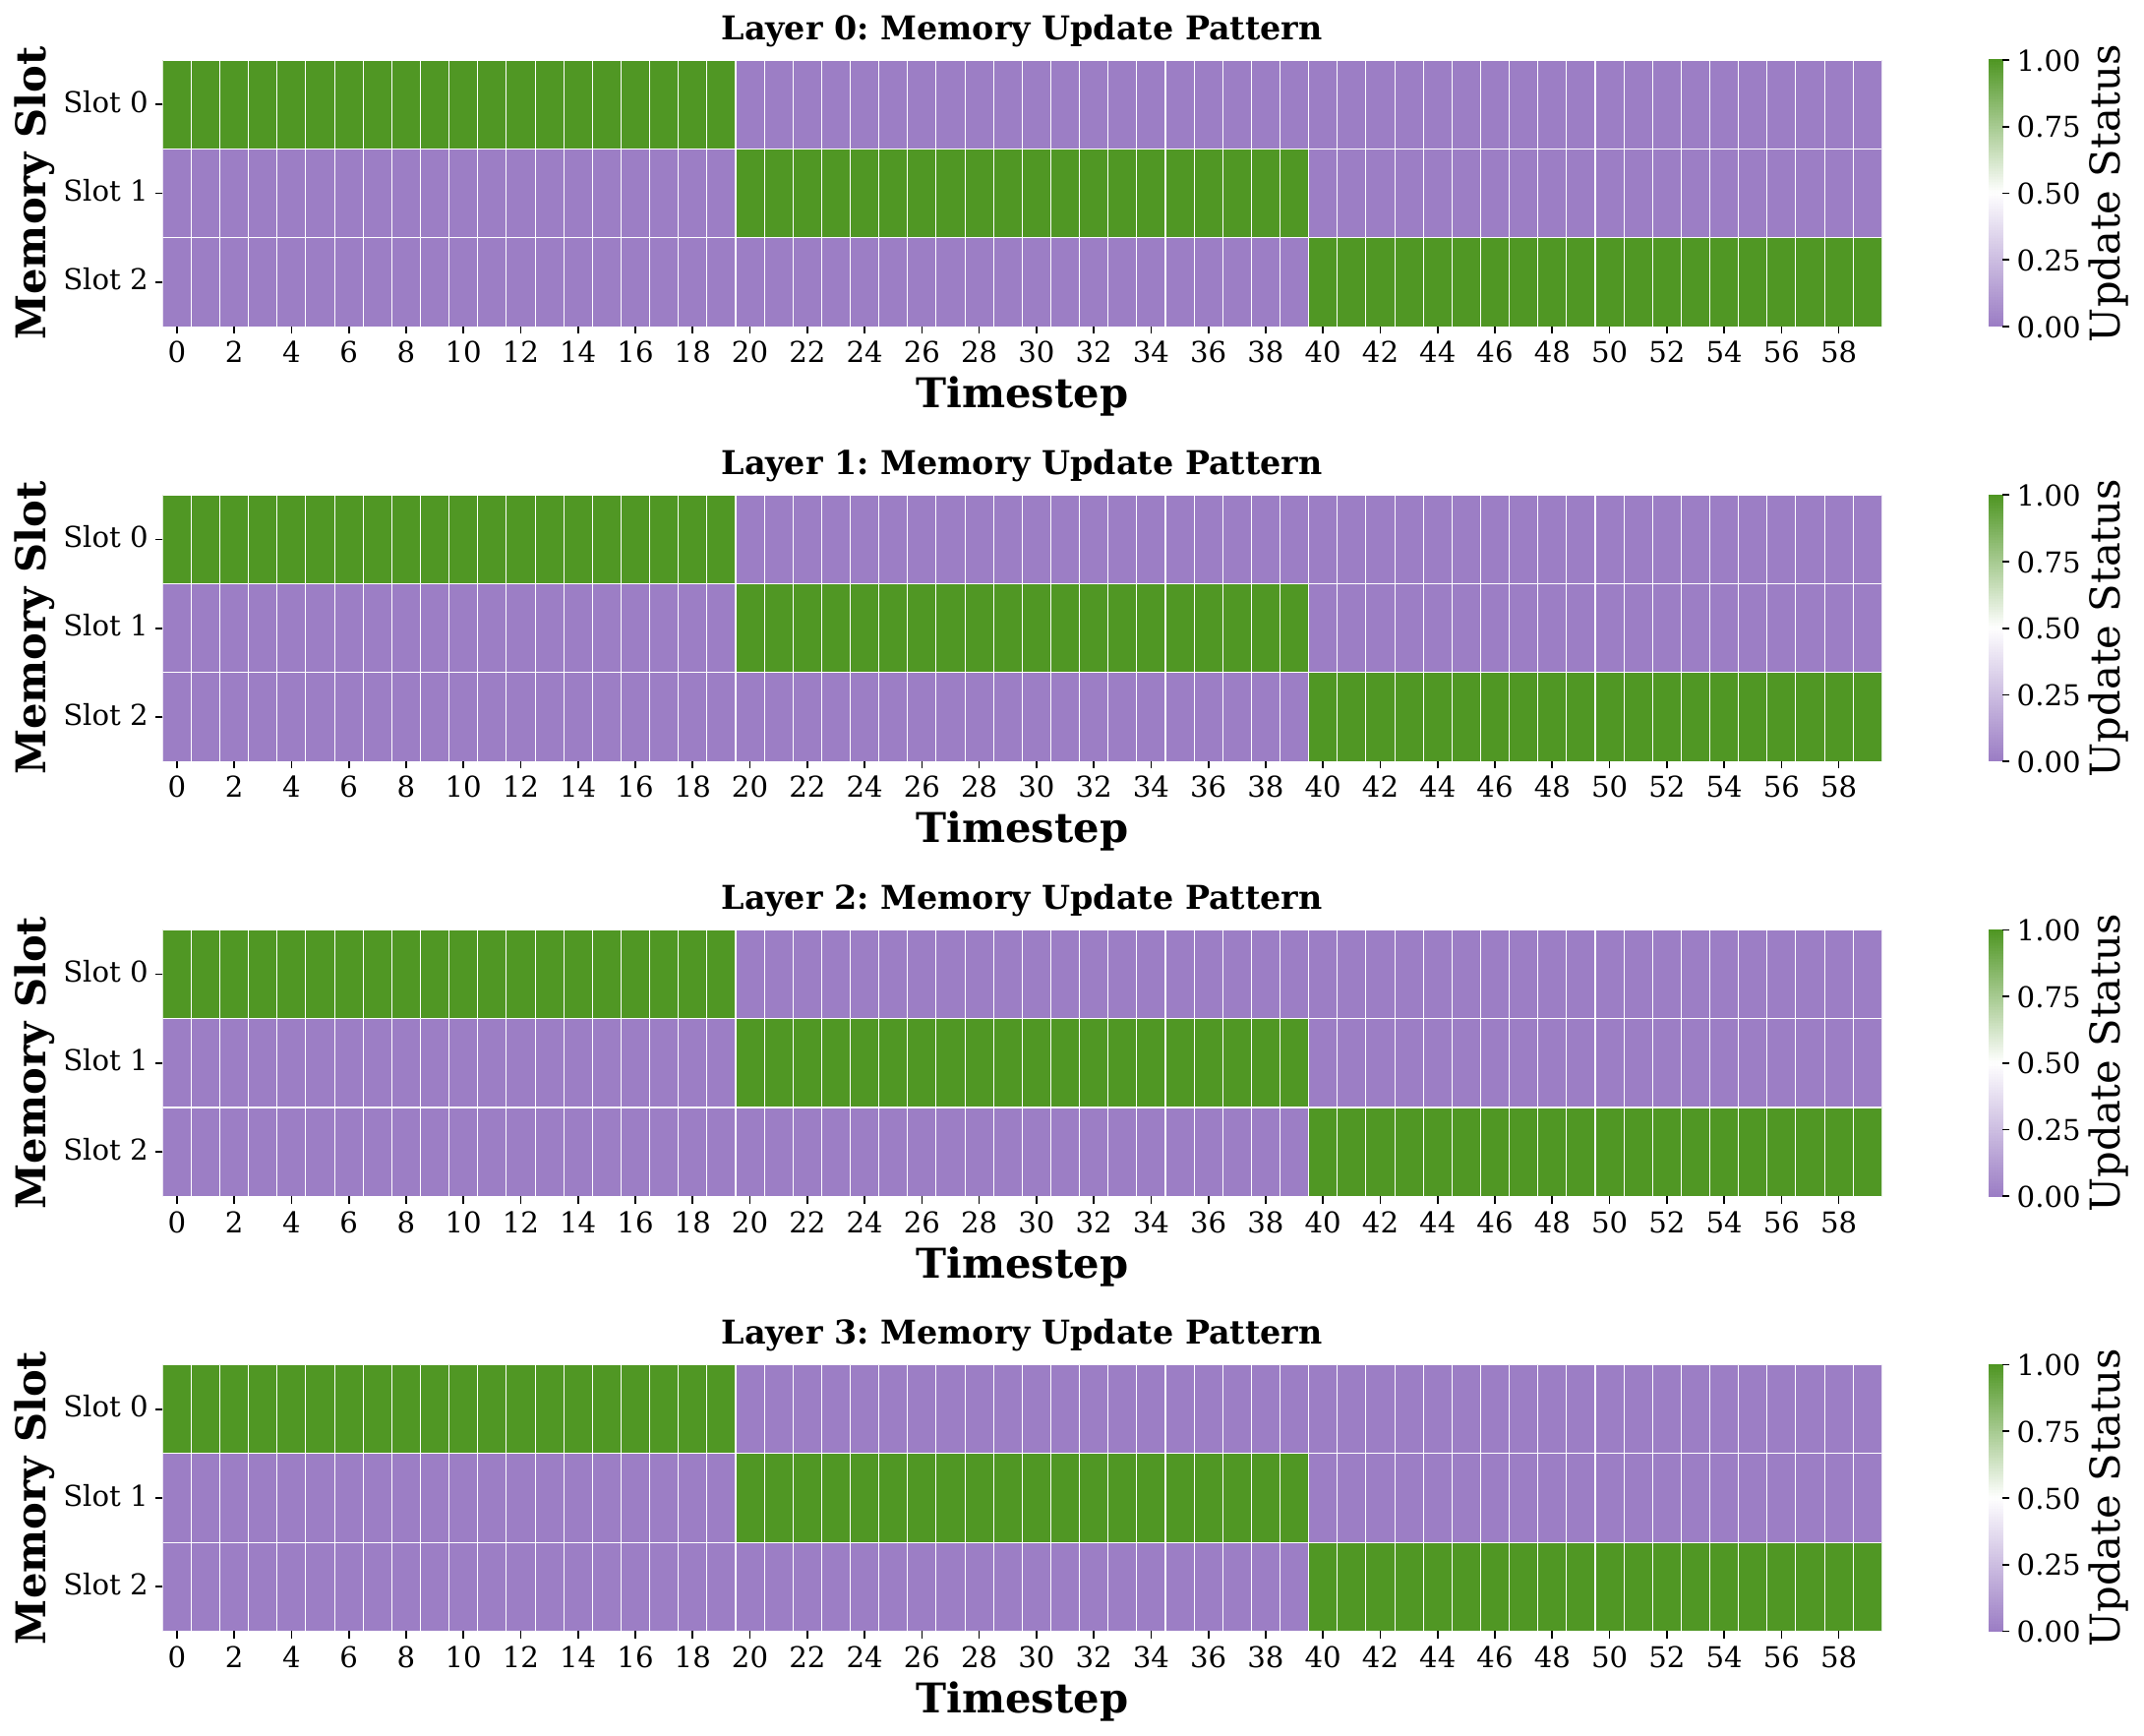
图 8:各层的记忆写入时刻表(横轴为 $t \in [0,60]$,纵轴为槽 0–2,绿色表示该步发生写入)。槽一旦失活就不再被修改——线索写入专用槽后,其内容在整个回合内被完整保留。
从嵌入层面的演化看,结论一致:
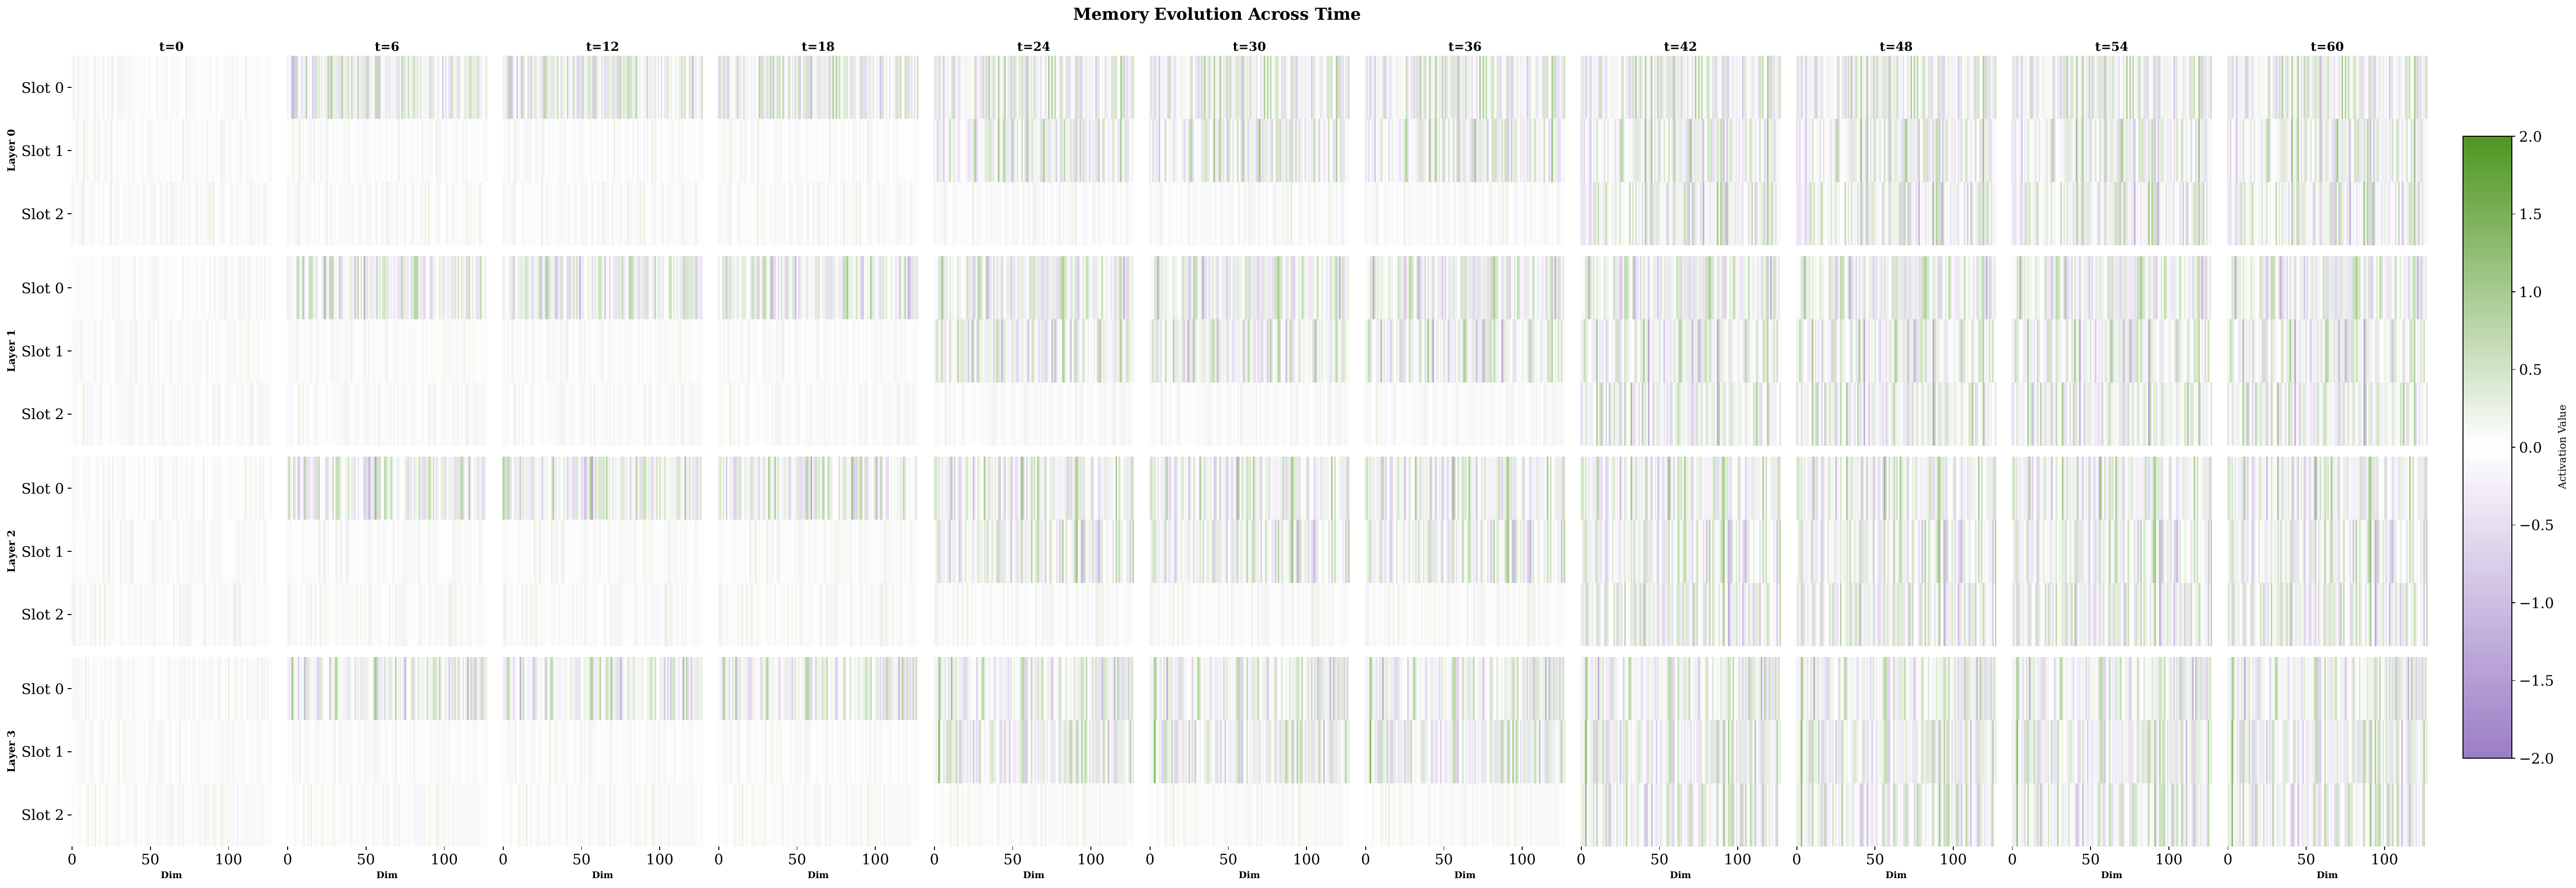
图 9:记忆随层、槽与时间演化的快照。早期是接近随机的小幅值;线索出现后每层只有一个槽变成强结构化并长期保持不变。
读写两条路径的注意力模式则显示出明显的不对称:
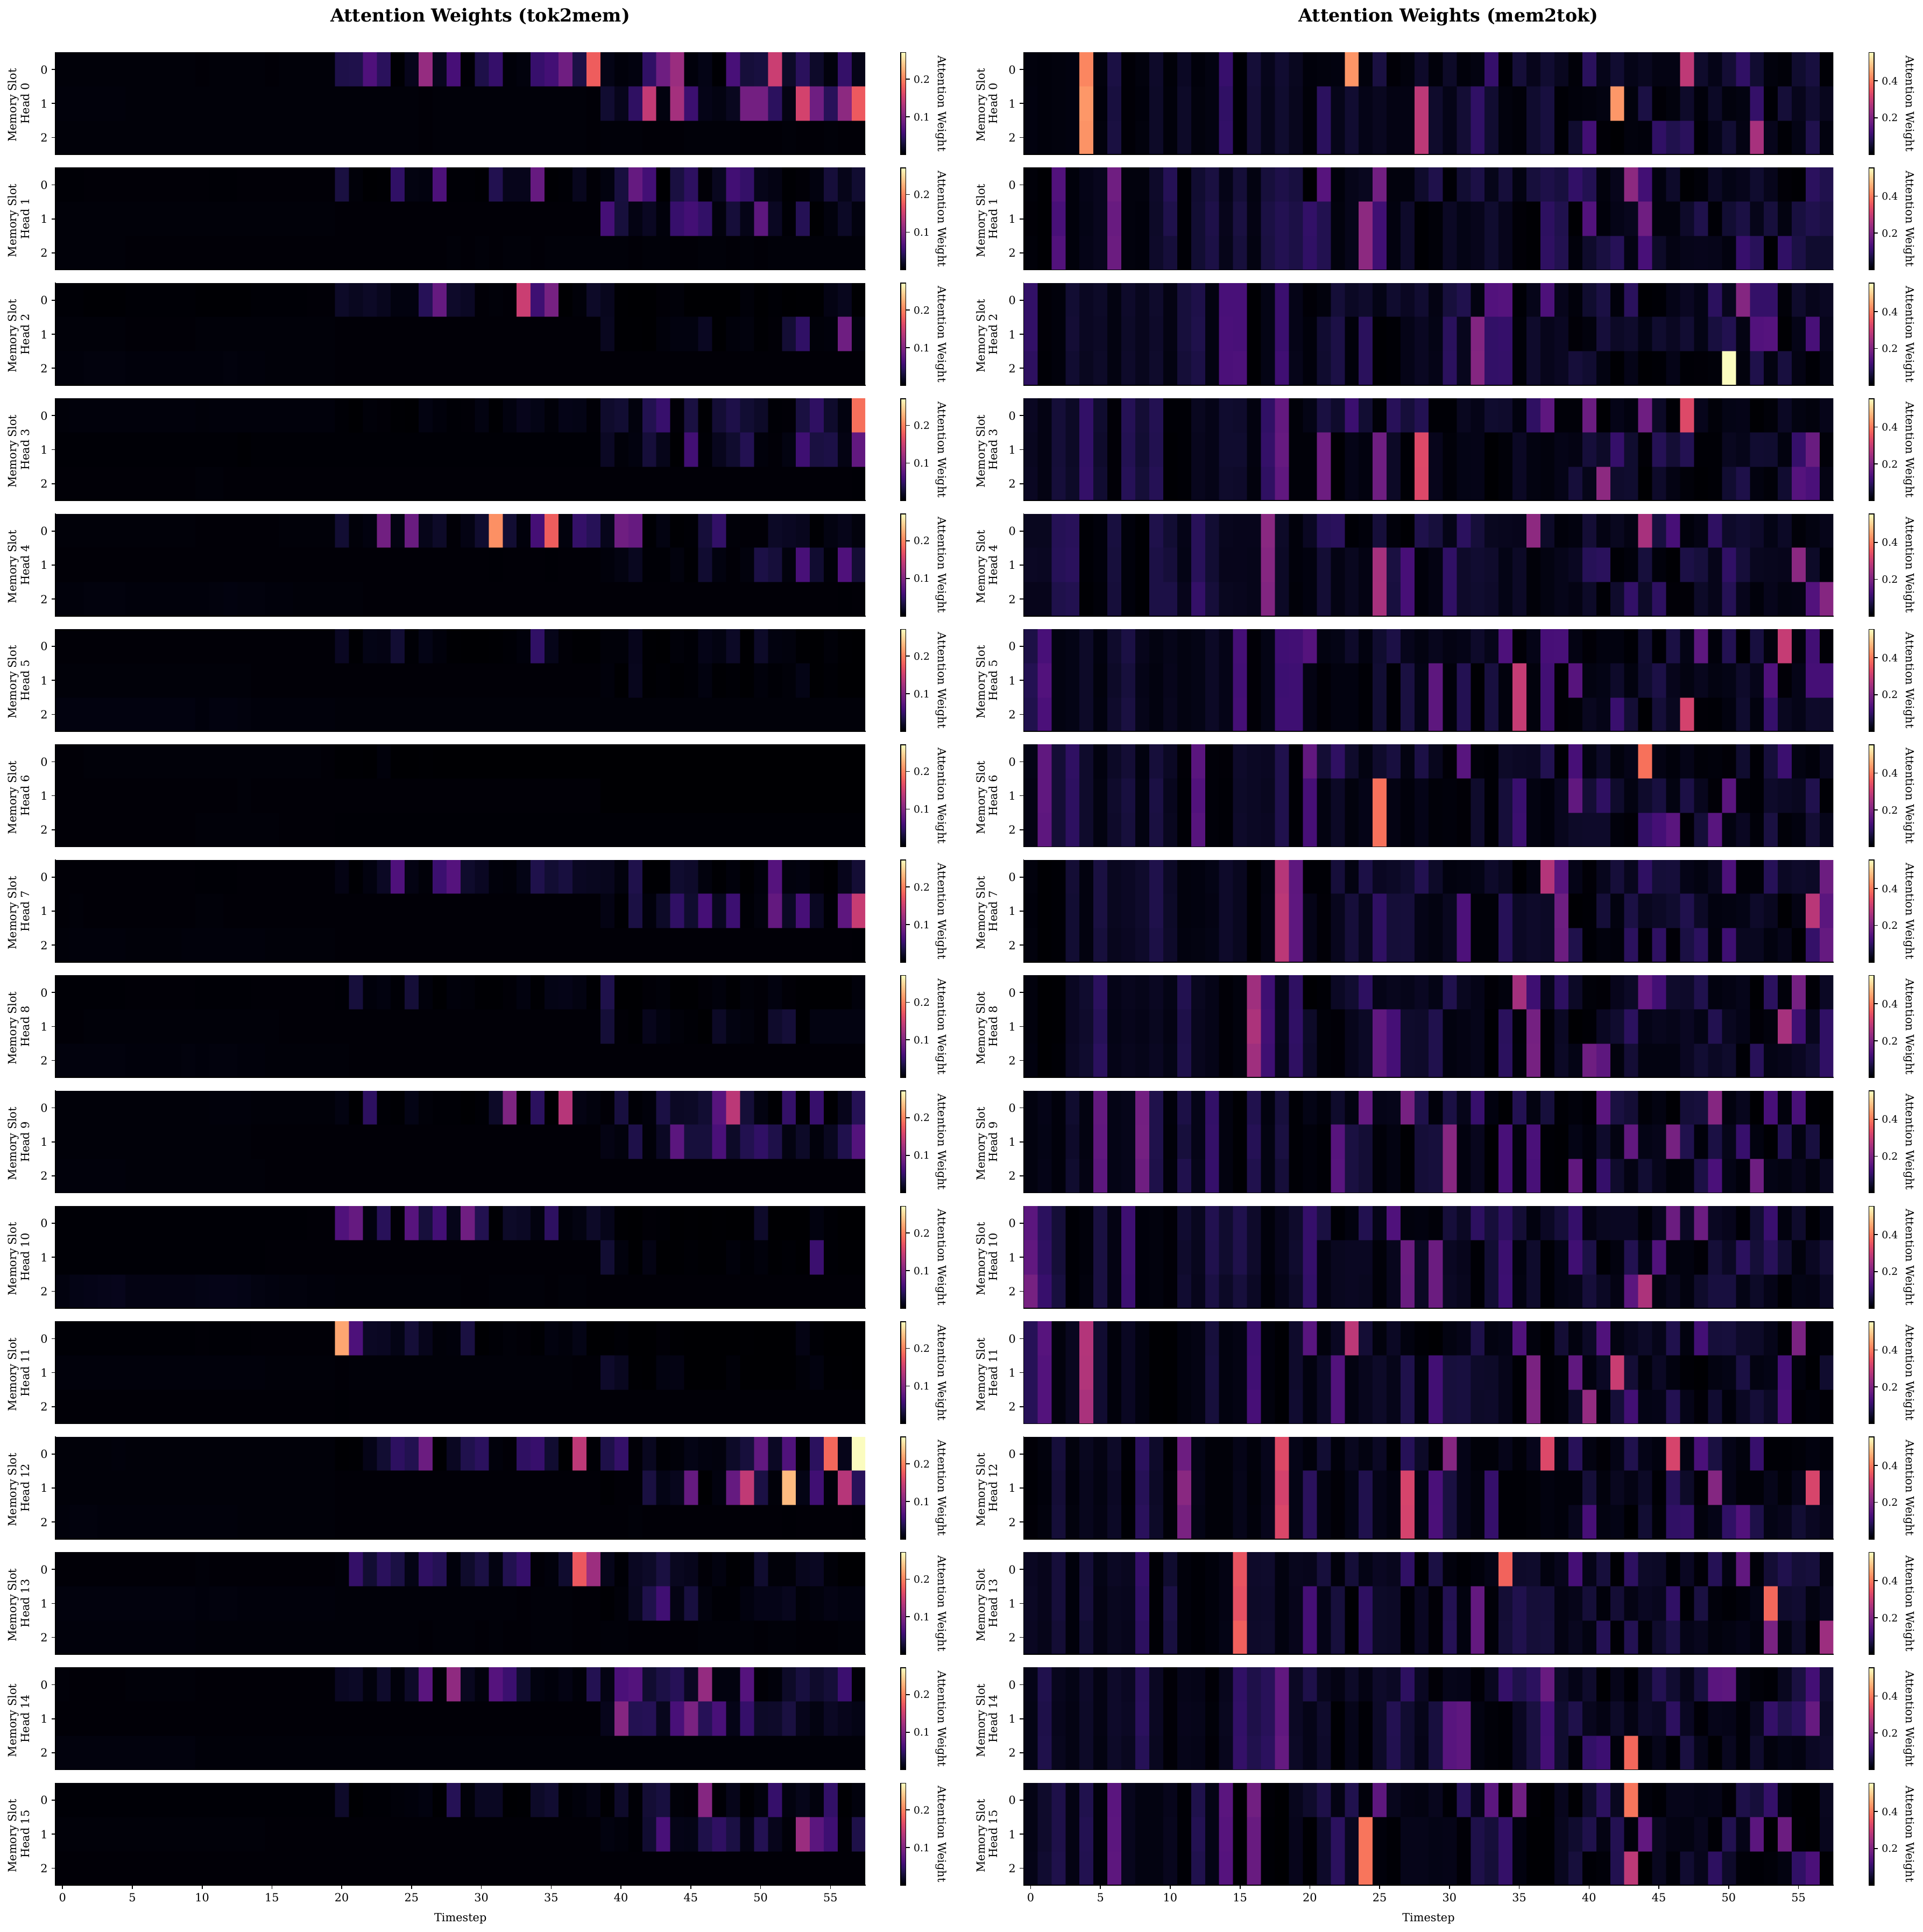
图 11:读写两条路径的交叉注意力图(左为写入,右为读取)。写入几乎只在线索出现时出现短促高强度的脉冲并集中在单个槽;读取则在空白期与决策期持续而结构化地回到同一个槽,其余注意力头近乎静默。
几何结构上,记忆从初始化的弥散云迅速收敛到少数低维流形,并在此后停留在那里;不同槽共享同一个内容空间,并不与特定颜色绑定。
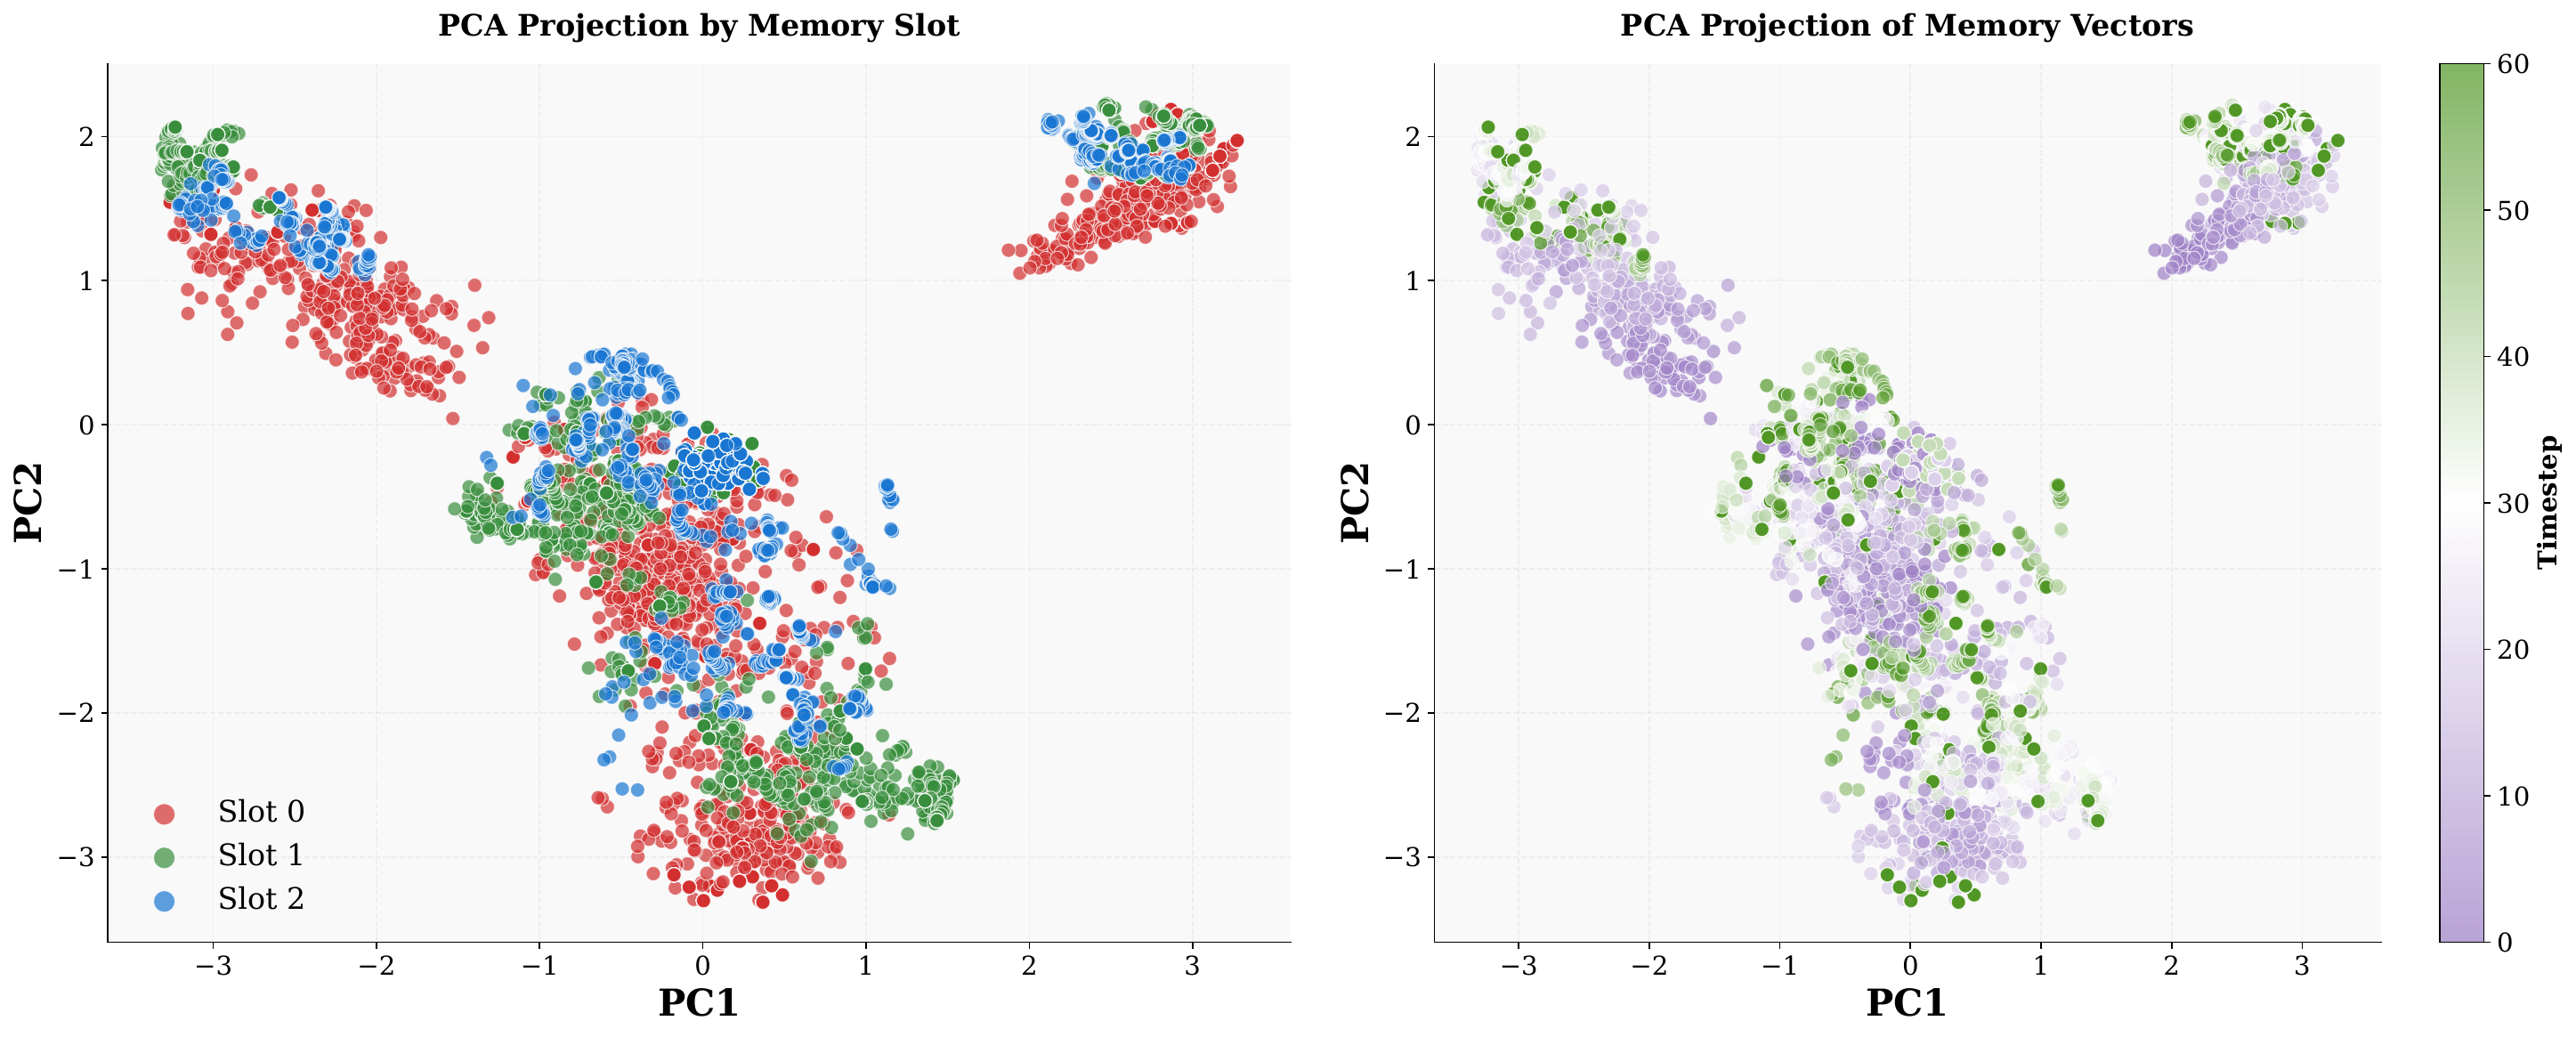
图 12:记忆嵌入的 PCA 结构。左图按槽着色,说明槽并不与特定颜色绑定,而是共享一个内容空间;右图按时刻着色,显示记忆从初始化附近的弥散云迅速收敛到少数低维流形。
最后,论文还检验了两件容易被忽略的事。第一,记忆机制在完全可观测任务上是否会造成损失:CartPole-v1 上所有模型都拿到满分 500,在 D4RL MuJoCo 的 D4RL 数据上 ELMUR 与强基线同级(用 $(R,o,a)$ 条件化得平均 76.4,只用观测得 74.7,差距仅约 2%,说明它不依赖回报或动作标签这类额外条件也能工作)。第二,它并非在所有任务上都赢——在 ViZDoom-Two-Colors 的 3D 视觉导航上,ELMUR 的回报是 55.28 ± 0.94,落在 RATE 的 59.21 ± 1.19 之后。
结果对比总结
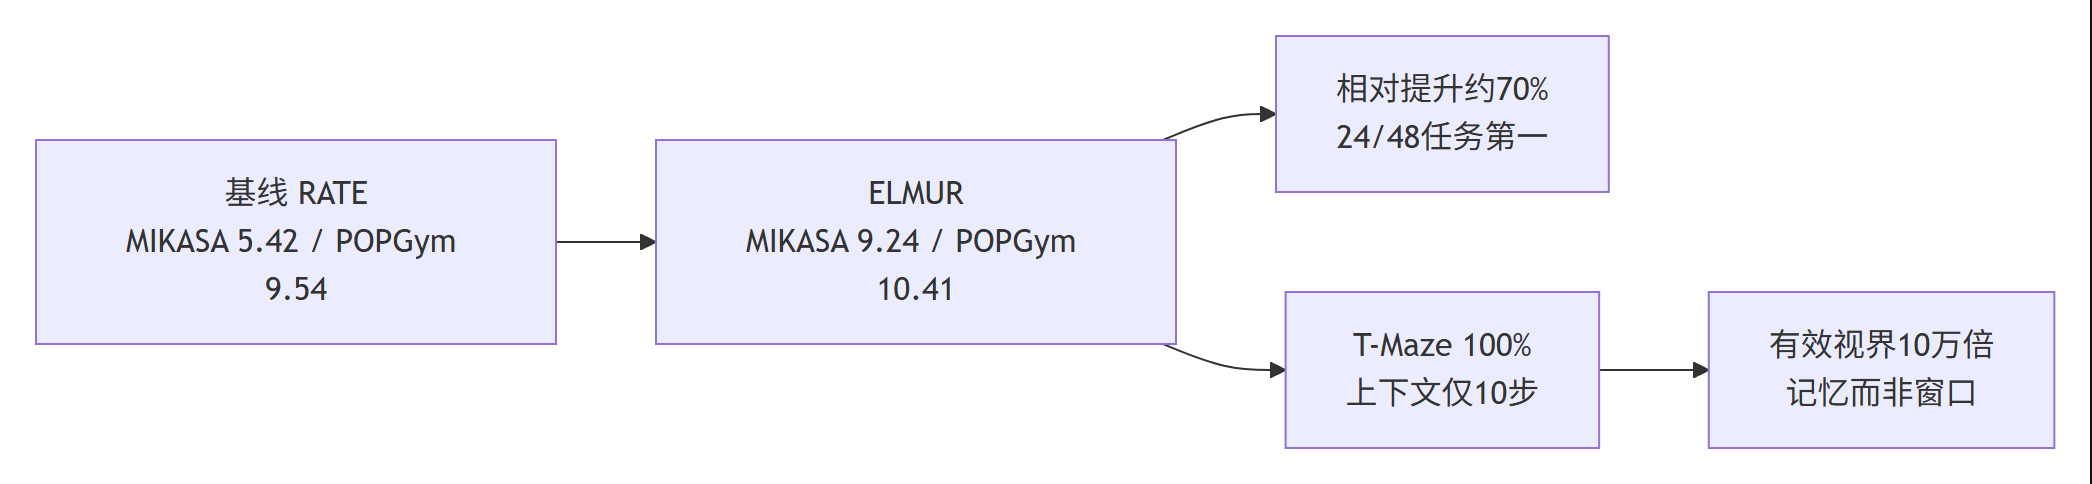
图 15:结果对比总结。最强基线 RATE 在 MIKASA-Robo 上的聚合成功率是 5.42、POPGym-48 总分 9.54;ELMUR 分别达到 9.24 与 10.41,相对提升约 70%,并在 24 个任务上排名第一,同时在上下文只有 10 步的条件下于一百万步 T-Maze 上保持 100% 成功率。(Mermaid 结果对比图)
关键发现
- 有效记忆跨度达注意力窗口的约十万倍:训练时上下文只有 10 步、只用 3 段,推理时走廊最长 $10^6$ 步,成功率始终 100%;而理论给出的保持下界只是保守估计,实测视界通常更长。
- 容量是硬阈值,不是可调参数:槽数 $M$ 大于任务所需段数 $N$ 时接近满分;$M<N$ 时准确率断崖式下跌,且 $M \approx N$ 附近最敏感,无法靠调混合系数弥补。
- LRU 与层内局部性是负载组件:去掉 LRU 得分从 1.00 掉到 0.43,共享记忆掉到 0.45,两者与相对偏置一起去掉只剩 0.22;而单独去掉相对偏置只掉到 0.95,说明它是放大器而非地基。
- 信息确实写在记忆里:初始时刻探针约 33%(三分类随机水平),首次写入后第 0 层即可解码,线索消失后第 0 层达到 100%;写入热力图、嵌入演化与 PCA 从三个独立角度给出同一结论。
- 机制是稀疏且可解释的:整个回合只有零星几次写入,每层每回合通常只做一次「一次性写入 + 长期只读」,槽一旦失活就不再被修改。
- 跨域一致且代价可控:谜题类回报 1.2(DT 为负分),反应类保持 9.2 与最强持平;T-Maze 上参数 2.1M、单步 6.8 ± 0.5 毫秒,比 RATE(7.2 毫秒)与 DT(10.7 毫秒)更快。
从创新模式的角度看,这篇论文同时命中三条被验证过的高价值模式:刻画极限然后超越(先给出指数遗忘与有效视界的形式化下界,再在实验上跨过它)、设计混淆隔离诊断工具(用逐层逐时刻的探针把「记忆真的存了任务变量」与「参数更多所以更强」这两个解释拆开)、以及异构分解差异化处理(每层各自持有记忆,显著优于全网络共享)。三者都用可量化的消融或探测结果支撑,这也是它执行质量最扎实的地方。
局限性
- 记忆规则本身不学习:LRU 与混合系数都是固定的,自适应重写策略被作者明确留作未来工作,论文只给出这套规则的透明性与可分析性。
- 额外成本不是零:段级循环让每层多一次交叉注意力;成本虽然随槽数而非序列长度增长,但依然是实打实的开销。
- 评测范围限定在仿真与模仿学习:只在仿真环境、只做模仿与离线设定,不比较在线强化学习、不做真机部署,延迟、复位与安全性都未经验证。
- 并非所有任务都赢:32 个 MIKASA 任务里有 9 个成功率仍为 0,全部集中在 BunchOfColors、SeqOfColors 与 ChainOfColors 这三族颜色序列任务上——记忆容量解决不了需要组合推理的问题;ViZDoom 上也落在 RATE 之后,论文用「matches the previous best baseline」来描述,措辞比表格数字更乐观。
- 超参仍有敏感性:中等混合系数(约 0.4–0.6)反而不稳定,初始化标准差太小会崩,分段越细越需要同步扩大记忆容量。
- 阅读时值得留意的几处细节:论文称贡献为「twofold」却列了三条;混合系数在正文与超参表里符号不同;超参段落有一句重复的残句;POPGym 的任务口径在正文(24/48)与附录表注(12 个任务)之间不一致;最后版本仍保留着投稿期的匿名机构占位符。
常见问题(FAQ)
ELMUR 和 Transformer-XL 有什么本质区别?
Transformer-XL 用段级循环缓存上一段的激活,缓存内容由网络自己产生、无法选择保留什么。ELMUR 把缓存换成每层独立的显式记忆槽,并在填满之后用 LRU 规则决定覆盖哪一个槽、以多大比例覆盖。区别在于:前者是「被动缓存」,后者是「带策略的存储」,因此可以给出半衰期与有界性的形式化刻画。
为什么不直接把上下文窗口做得更长?
因为代价。自注意力的开销随上下文长度平方增长,而长时程任务需要的是「记住几千步前的一个线索」,不是「同时关注几千个 token」。ELMUR 的额外开销随记忆槽数而非序列长度增长,于是把「更长的历史」和「更贵的注意力」这两件事解开了。
记忆槽数要设多大?
论文的经验是至少不小于任务所需的段数。槽数 $M$ 大于所需段数 $N$ 时,几乎所有超参设置都能达到满分;而 $M<N$ 时准确率断崖式下跌,且对混合系数、初始化与分段方式都高度敏感。实践中可以从「预期需要保留的事件数」反推 $M$。
ELMUR 会损害反应式任务的性能吗?
不会。在完全可观测的 CartPole-v1 上,ELMUR 与所有基线一样拿到满分 500;在 D4RL MuJoCo 上与强基线同级;在 POPGym 的反应类任务上保持 9.2 分,与最强基线持平。这说明加记忆并没有用反应速度去换。
混合系数应该怎么选?
它控制稳定性与塑性的平衡:$\lambda$ 越小保留越久(半衰期近似为 $\ln 2 / \lambda$),越大覆盖越快。论文中不同任务的最优值从 0.05(T-Maze)到 0.80(POPGym-Autoencode)不等,而且要避开 0.4–0.6 这段反而不稳定的中间区间。
这套机制能迁移到视觉语言动作模型上吗?
从设计上看很有机会:它不改变注意力本身,只是在每一层加一条并行的读写旁路,对骨干网络几乎没有侵入性。事实上论文的多数实验已经在带视觉输入的机器人操作任务上完成,而相关团队也一直在做 VLA 的记忆扩展,这是值得关注的方向。
参考链接
- 论文 arXiv 摘要页:arXiv:2510.07151
- 项目主页(含代码与更多结果):elmur-paper.github.io
- 段级循环与激活缓存的起点:Transformer-XL (arXiv:1901.02860)
- 可检索外部记忆的代表作:Memorizing Transformers (arXiv:2203.08913)
- 评测基准:POPGym (arXiv:2303.01859) 与 MIKASA-Robo(ICLR 2026)
- 把记忆与信用分配解耦的关键分析:Ni et al., NeurIPS 2023 (arXiv:2307.03864)
- 主要决策基线:Decision Transformer (arXiv:2106.01345)、Diffusion Policy (arXiv:2303.04137)
给大家推荐一款自用写文献综述、无虚构文献的 AI:
🌟 复旦大学 FudanNLP 团队自研 切问学术
覆盖 3.6 亿篇可溯源真实中英文文献,能自动整合文献观点生成规范综述
还能挖掘研究创新点、复现实验,配合视频教学,新手快速上手文献综述写作
🍀后记🍀
博客的关键词集中在编程、算法、机器人、人工智能、数学等等,持续高质量输出中。
🌸讨论QQ群:白拾的小屋 (750365700)
⭐B站账号:白拾的物理AI组会(活跃于知识区和动画区)
✨GitHub主页:YhbCode000(工程文件)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献56条内容

所有评论(0)