pyqt基于深度学习的水下机器人目标识别技术研究(yolo)
摘要
本研究旨在探索基于深度学习的水下机器人目标识别技术。利用PyTorch框架和YOLOv10算法,系统实现了高效的目标检测功能。用户可以上传图片,应用图像增强技术包括伽马校正、白平衡和水下图像去雾等,以提高识别准确率。系统还支持置信度阈值设置,允许用户根据需求调整检测精度。此外,用户可以查看模型位置,确保透明度和可追溯性。
该系统通过深度学习技术显著提升了水下环境的视觉识别能力,为水下机器人提供了强大的视觉感知工具。图像增强模块有效改善了水下图像的质量,增强了目标特征的可见性。用户友好的界面设计使得操作简便,适用于各种水下探测任务。系统的高效性和准确性为水下机器人的目标识别任务提供了可靠的技术支持,具有广泛的应用前景。
关键词:深度学习;YOLO目标检测算法;水下机器人目标识别技术研究
ABSTRACT
This research aims to explore the application of deep learning for underwater robot target recognition. Utilizing the PyTorch framework and the YOLOv10 algorithm, the system achieves efficient object detection functionality. Users can upload images and apply image enhancement techniques such as gamma correction, white balance, and underwater image dehazing to improve recognition accuracy. The system also supports confidence threshold settings, allowing users to adjust detection precision according to their needs. Additionally, users can view the model’s location, ensuring transparency and traceability.
The system significantly enhances visual recognition capabilities in underwater environments through deep learning technologies, providing underwater robots with powerful visual perception tools. The image enhancement module effectively improves the quality of underwater images, boosting the visibility of target features. The user-friendly interface design simplifies operation, making it suitable for various underwater detection tasks. With its efficiency and accuracy, the system offers reliable technical support for underwater robot target recognition tasks, with a broad range of potential applications.
Keywords: Deep Learning; YOLO Object Detection Algorithm; Underwater Robot Target Recognition Technology Research
目 录
随着海洋资源开发和海洋环境探索需求的日益增长,水下机器人作为重要的工具平台,在海洋观测、资源勘探、水下设施检测与维护等领域发挥着越来越重要的作用。然而,复杂的水下环境,如光线衰减、能见度低、光照变化大以及目标种类繁多等因素,给水下机器人的目标识别带来了极大的挑战。传统的基于手工特征提取的目标识别方法难以适应复杂多变的水下环境,识别精度和鲁棒性往往不能满足实际应用的需求。近年来,深度学习技术凭借其强大的特征学习和表征能力,在计算机视觉领域取得了突破性进展,为水下目标识别提供了新的解决方案。深度学习能够从海量数据中自动学习到具有高度判别性的特征,有效克服水下环境带来的干扰,显著提升目标识别的准确率和鲁棒性。
基于深度学习的水下机器人目标识别技术研究,对于提升水下机器人的智能化水平,拓展其应用范围具有重要的意义。一方面,高精度的目标识别技术能够为水下机器人提供可靠的环境感知能力,使其能够更有效地执行各种任务,如自主导航、目标跟踪、水下搜救等,从而提高海洋资源开发和海洋环境监测的效率。另一方面,该技术的研究还可以推动深度学习理论在水下环境中的应用和发展,为其他水下视觉任务,如水下场景理解、水下三维重建等提供技术支撑。此外,该技术的研究成果还可以应用于其他类似的复杂环境下的目标识别任务,如水下考古、水下安防等领域,具有广阔的应用前景和重要的社会经济效益。
近年来,基于深度学习的水下目标识别技术已成为研究热点,并取得了显著进展。国际上,众多研究机构和高校纷纷开展相关研究,提出了多种基于深度学习的模型和算法。例如,一些研究利用卷积神经网络(CNN)提取水下图像的深度特征,并结合数据增强和迁移学习等技术,有效提升了目标识别的性能。还有一些研究针对水下环境特有的光照变化和模糊问题,设计了特定的网络结构和损失函数,以增强模型的鲁棒性。此外,一些研究开始探索将深度学习与其他技术,如强化学习、三维重建等相结合,以实现更复杂的水下目标识别任务。国内方面,相关研究也日益活跃,一些高校和科研院所开始布局水下机器人视觉技术的研究,并在水下目标检测、分类和识别等方面取得了一定的成果。部分研究团队针对国内特定的水下应用场景,如港口水下设施检测、海洋牧场监测等,开发了相应的深度学习模型和系统,并进行了实际应用验证。
总体而言,目前基于深度学习的水下目标识别技术仍处于快速发展阶段。国际上,该领域的研究已经取得了较大的进展,但仍然存在一些挑战,如小样本学习、跨域适应、实时性等问题。国内方面,相关研究起步相对较晚,但发展迅速,并在一些特定应用场景中取得了初步成果。未来,随着深度学习技术的不断发展和水下机器人硬件平台的不断进步,基于深度学习的水下目标识别技术将更加成熟,并在海洋资源开发、海洋环境监测、水下安防等领域发挥更大的作用。
本研究聚焦于基于深度学习的水下机器人目标识别技术,主要依托PyTorch框架和YOLOv10算法构建识别模型。研究内容包括图像处理模块的开发,用户可上传图片,应用多种增强技术包括伽马校正、白平衡及水下图像去雾等,以提升图像质量。此外,系统支持对上传图片进行预测并保存结果,为用户提供便捷的操作体验。
另一核心研究内容为检测设置功能的实现,用户可根据需求设置置信度阈值,以调整目标识别的精度。同时,系统提供模型位置查看功能,增强透明度和可追溯性。通过这些研究内容,旨在提升水下机器人在复杂环境下的目标识别能力,为水下探测、资源开发等领域提供技术支持。
2 相关理论与技术介绍
2.1 PyTorch框架
PyTorch是一个广泛使用的深度学习框架,主要由Facebook人工智能研究院(FAIR)开发,具备高效的计算图机制和灵活的动态神经网络结构。它的核心优势之一是其动态计算图(Dynamic Computational Graph)特性,允许在模型的训练过程中实时修改计算图。这种灵活性使得PyTorch在开发时可以更方便地进行调试和原型设计,特别适用于那些需要复杂控制流和动态变化的神经网络。与静态计算图的TensorFlow不同,PyTorch的动态计算图支持即时反馈,使得开发者可以直接通过Python代码与模型进行交互,从而加速了实验和开发的进程。
另外,PyTorch的另一个显著特点是其与Python生态系统的紧密集成,尤其是在Numpy、SciPy等科学计算库的兼容性方面,使得数据处理和模型开发变得更加流畅。PyTorch也拥有强大的GPU加速能力,支持CUDA并行计算,显著提升了大规模数据处理和深度学习训练的效率。此外,PyTorch还拥有丰富的预训练模型和工具库,如TorchVision、TorchText等,为图像处理、自然语言处理等领域的应用提供了很大的便利。这些特性使得PyTorch成为学术研究和工业应用中的热门选择,并且随着社区的发展和支持,越来越多的开发者和研究人员选择它作为主要的深度学习框架。
这个图展示了PyTorch框架的核心组成部分,简洁地涵盖了其主要模块及功能。PyTorch的基础操作依赖于其强大的Tensor(张量)类,类似于NumPy中的ndarray。Tensor操作包括基本的数学运算、矩阵操作、广播机制、多维数组支持等。这些操作是PyTorch进行数据处理和训练的基础。自动微分是PyTorch的一项重要特性,借助`Autograd`模块实现。通过构建计算图并自动追踪张量的操作,PyTorch可以在训练过程中自动计算梯度。这对于神经网络训练中的反向传播至关重要,帮助开发者减少手动求导的繁琐。PyTorch提供了灵活的神经网络构建模块。通过`torch.nn`模块,用户可以轻松创建神经网络层、激活函数等。`nn.Module`是所有模型的基类,用户可以继承该类并自定义模型结构,方便地进行深度学习模型的设计和训练。PyTorch提供了多种优化算法,如随机梯度下降(SGD)、Adam、RMSprop等,帮助优化神经网络的参数。优化器通过调整模型的权重以减少损失函数,从而提高模型的预测性能。 PyTorch提供了`Dataset`和`DataLoader`类,用于高效地加载和处理数据。`Dataset`类可以帮助用户定义如何获取数据,`DataLoader`类则通过批处理和多线程等方式加速数据加载过程,极大提高了训练效率。PyTorch对GPU的支持是其优势之一。通过CUDA接口,PyTorch能够利用NVIDIA的GPU进行高效的并行计算,显著提高模型训练和推理的速度。
2.2 PyQt5简介
PyQt5是Python语言的一个图形用户界面(GUI)库,基于Qt框架开发而成,Qt是一个强大的跨平台应用程序开发框架,广泛应用于桌面软件、嵌入式系统以及移动端开发中。PyQt5通过Python对Qt的封装,使得开发者可以使用Python语言来创建富有交互性和功能强大的应用程序。它支持Qt框架中的各种功能,包括窗口、按钮、标签、文本框、图形视图、表格、树形结构等多种控件,帮助开发者快速搭建图形化界面。此外,PyQt5还提供了事件驱动的编程模型,使得开发者能够轻松管理界面的响应和交互逻辑,极大提高了开发效率。
PyQt5的优点之一是跨平台支持,开发者使用PyQt5创建的应用可以在Windows、Linux、macOS等不同操作系统上运行,而无需做额外的修改。它还提供了对Web、数据库、XML、OpenGL等多个技术的支持,满足多种应用场景的需求。PyQt5具有高度的灵活性和可定制性,能够创建出高度复杂和精美的用户界面。它不仅适合开发桌面应用程序,也能够通过Qt的WebEngine模块支持浏览器嵌入功能,为开发者提供更多的可能性。结合Python语言的简洁与Qt框架的强大,PyQt5成为了开发跨平台GUI应用的重要工具,广泛应用于科学计算、数据分析、图形编辑、自动化工具等各个领域。
2.3YOLOv10简介
YOLOv10是继YOLOv4和YOLOv5之后,进一步优化的目标检测算法,它基于YOLO(You Only Look Once)系列算法的核心理念,致力于在保持高精度的同时,提升检测速度和效率。YOLOv10通过对网络结构、数据预处理、损失函数以及训练策略等方面进行改进,成功提高了在复杂场景下的表现,尤其是在小物体检测、密集目标检测和实时检测方面。YOLOv10采用了一些新颖的技术,如跨层特征融合、多尺度训练以及自适应锚点生成,这些优化使得该模型在准确度和推理速度之间取得了更好的平衡,适合实时性要求较高的应用场景,如自动驾驶、安防监控以及工业检测等领域。
与前代版本相比,YOLOv10更加强调模型的轻量化和高效性,同时也提升了对边缘设备和嵌入式系统的适配能力。通过合理的模型压缩和加速优化,YOLOv10能够在计算资源有限的设备上高效运行。它的优势不仅在于推理速度的提升,还在于对训练数据的适应性更强,能够有效处理多种不同尺寸、不同类别的物体,特别是在复杂背景和低光照环境下,仍能保持较高的准确率。此外,YOLOv10在目标检测精度、召回率和F1-score等指标上也较其前身版本有了显著提升,是一款在精度和速度上都达到较高水平的目标检测算法。
2.4目标检测算法简介
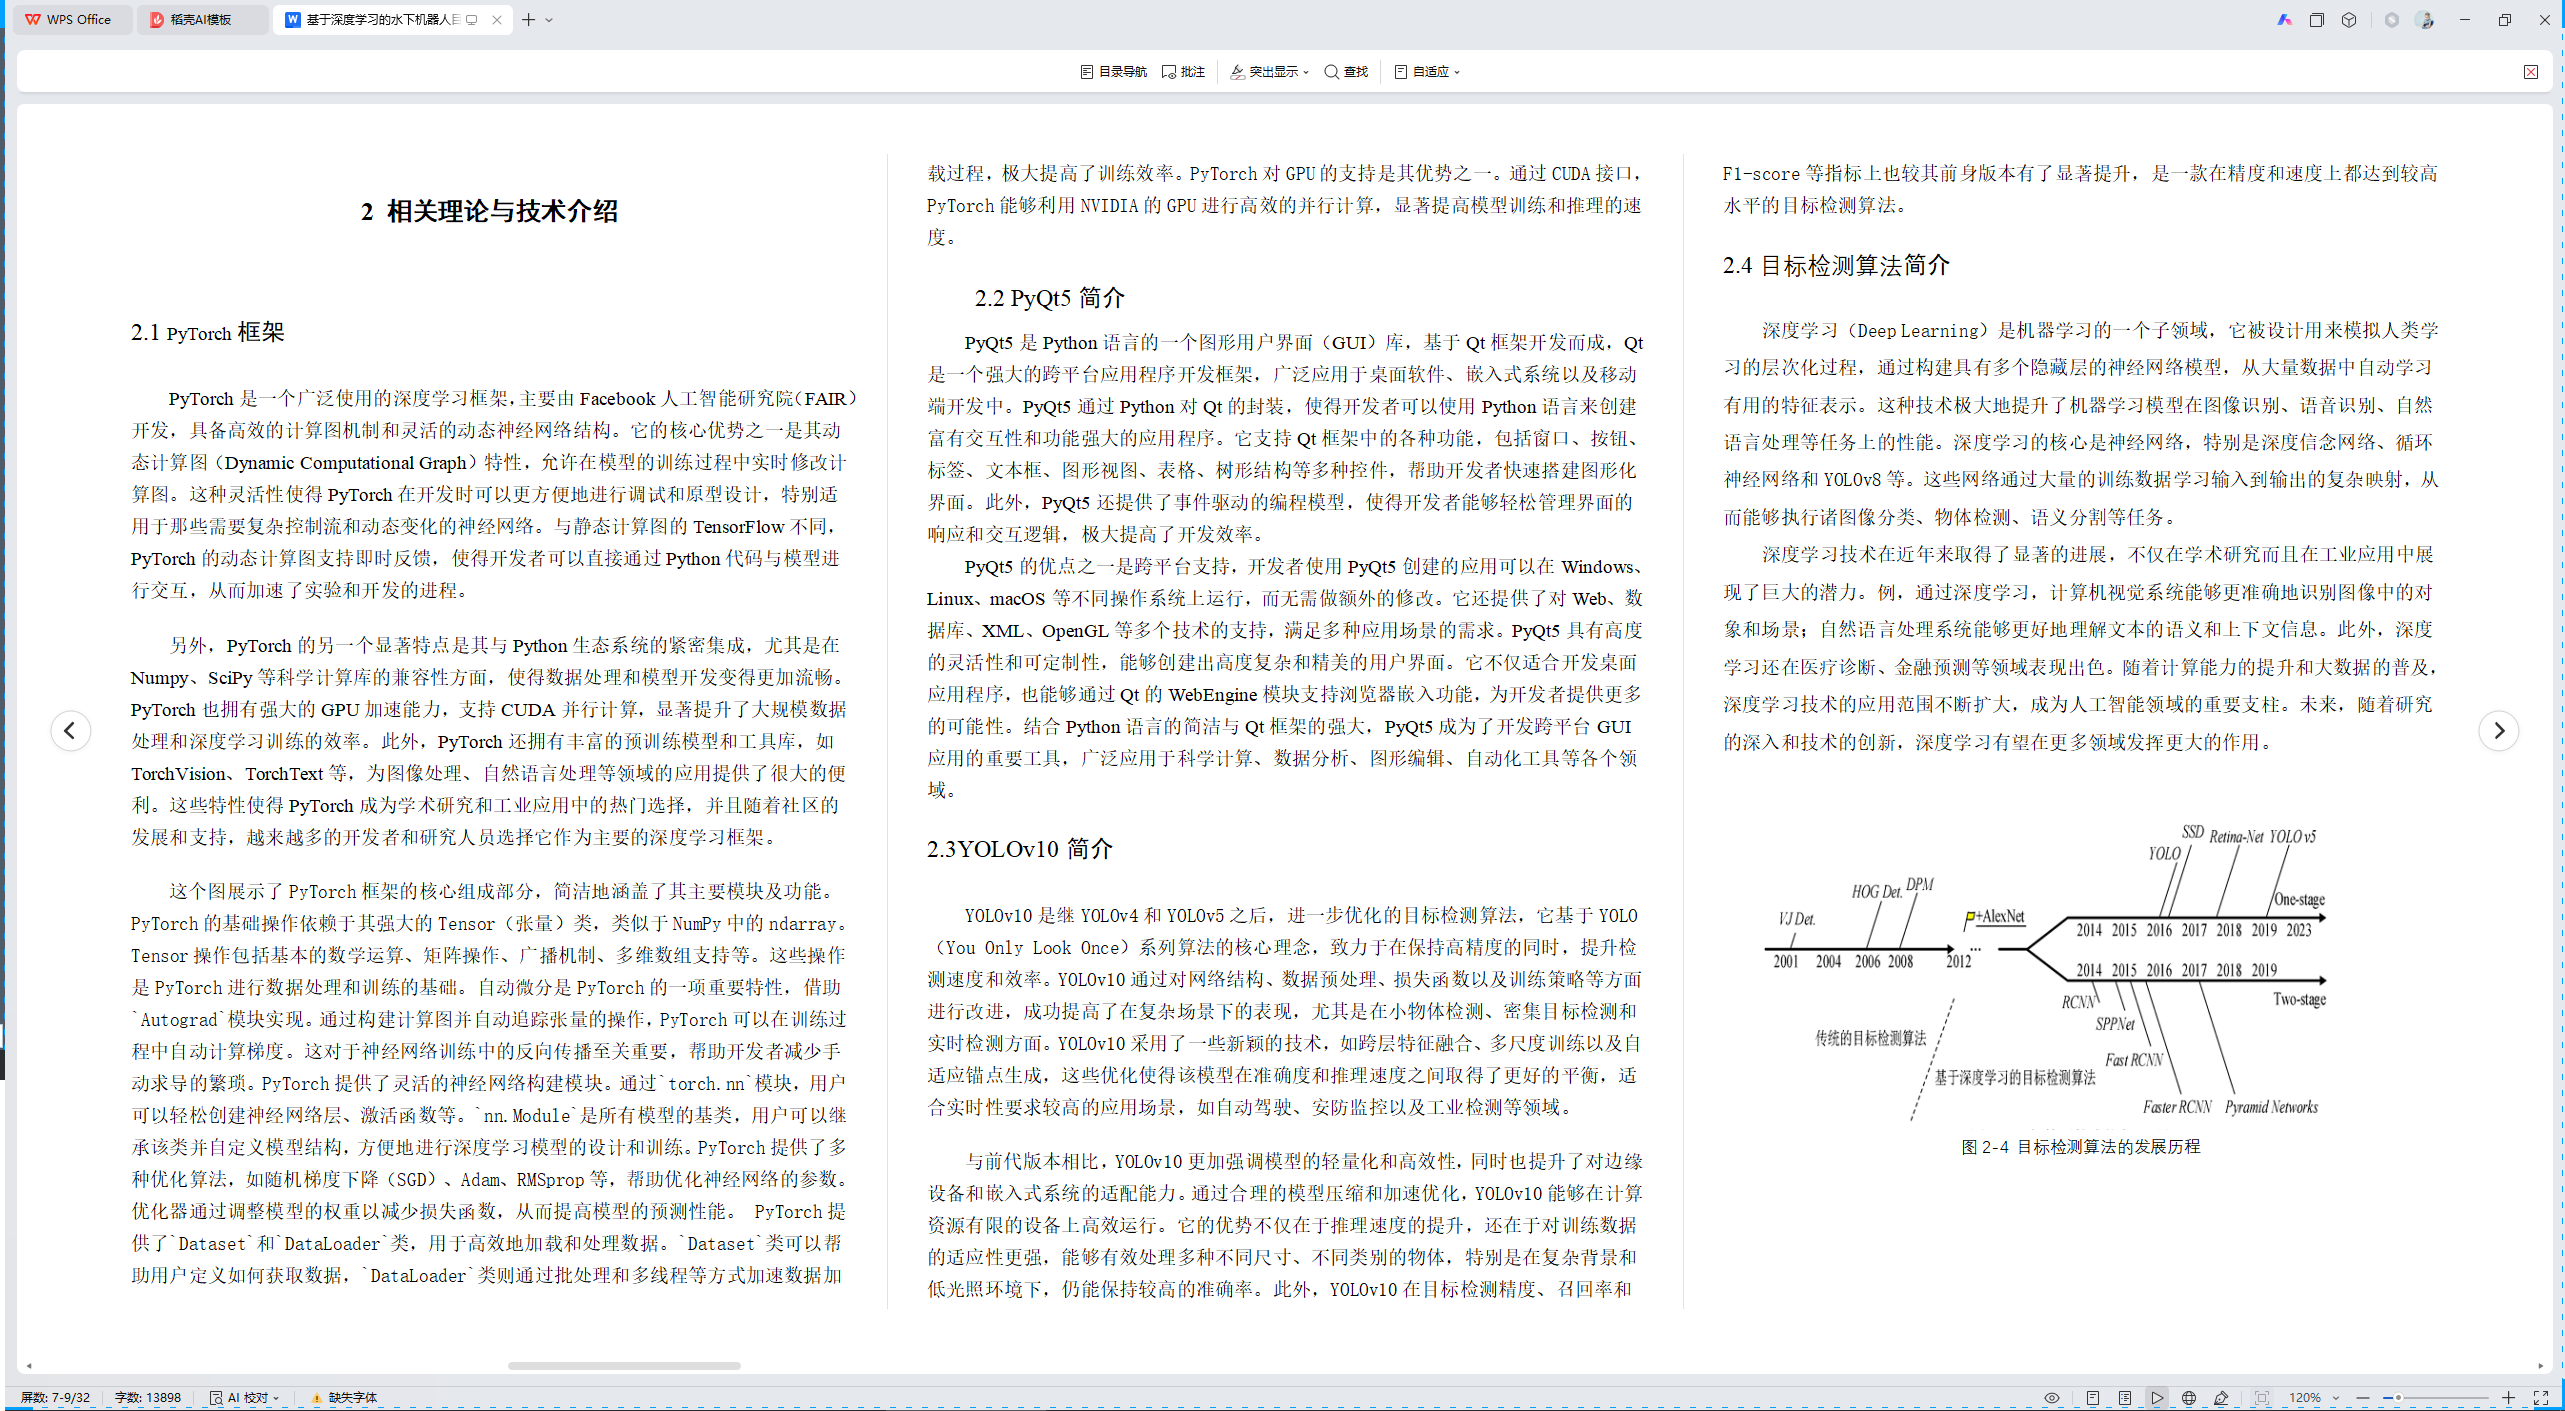
深度学习(Deep Learning)是机器学习的一个子领域,它被设计用来模拟人类学习的层次化过程,通过构建具有多个隐藏层的神经网络模型,从大量数据中自动学习有用的特征表示。这种技术极大地提升了机器学习模型在图像识别、语音识别、自然语言处理等任务上的性能。深度学习的核心是神经网络,特别是深度信念网络、循环神经网络和YOLOv8等。这些网络通过大量的训练数据学习输入到输出的复杂映射,从而能够执行诸图像分类、物体检测、语义分割等任务。
深度学习技术在近年来取得了显著的进展,不仅在学术研究而且在工业应用中展现了巨大的潜力。例,通过深度学习,计算机视觉系统能够更准确地识别图像中的对象和场景;自然语言处理系统能够更好地理解文本的语义和上下文信息。此外,深度学习还在医疗诊断、金融预测等领域表现出色。随着计算能力的提升和大数据的普及,深度学习技术的应用范围不断扩大,成为人工智能领域的重要支柱。未来,随着研究的深入和技术的创新,深度学习有望在更多领域发挥更大的作用。
图2-4 目标检测算法的发展历程
2.5 深度学习
深度学习技术是一种模拟人脑神经网络结构的机器学习方法,通过大量数据训练神经网络模型,使其能够自动提取特征并进行复杂任务的预测和分类。这种技术利用多层神经网络的深层结构,通过逐层特征抽象和转换,实现对输入数据的深层次理解和表征。深度学习技术在图像识别、语音识别、自然语言处理等领域取得了显著的成果,并不断拓展到更多应用场景,为人工智能发展提供了强大的动力。
深度学习技术的核心是神经网络模型,它由大量的节点(或称为神经元)组成,这些节点相互连接形成层次结构。每个节点接收来自其他节点的输入,对输入进行加工处理,并生成输出。在训练过程中,神经网络通过调整节点之间的连接强度(权重)和节点自身的激活阈值,从而学习到从输入数据到输出结果的最佳映射关系。
此外,深度学习技术还在不断拓展到更多应用场景。例如,在医疗领域,深度学习技术可以帮助医生进行疾病诊断和治疗规划;在金融领域,深度学习技术可以用于风险评估和欺诈检测;在交通领域,深度学习技术可以支持自动驾驶和交通流量预测。随着计算能力的提升和数据量的增加,深度学习技术有望在未来发挥更大的作用,为人类社会带来更多的便利和进步。
2.6 OpenCV
OpenCV(Open Source Computer Vision Library)是一个开源的计算机视觉和机器学习库,旨在为实时图像处理和计算机视觉任务提供强大的功能。自1999年由英特尔推出以来,OpenCV已成为全球广泛使用的计算机视觉工具之一,支持Windows、Linux、macOS以及Android和iOS等多个平台。它提供了丰富的图像处理函数,包括图像读取、显示、变换、特征提取、对象跟踪、边缘检测、图像分割等多种功能,支持多种常见的图像文件格式。OpenCV还集成了强大的机器学习模块,能够进行分类、回归、聚类等任务,使得开发者能够在计算机视觉任务中实现复杂的算法和数据分析。
OpenCV的优势在于其跨平台性、开源性和广泛的应用范围。作为一个高效的图像处理库,OpenCV广泛应用于工业检测、安防监控、医学影像分析、自动驾驶、机器人视觉等领域。它还支持GPU加速,能够大幅提升图像处理速度,尤其在处理大规模图像数据时表现尤为突出。与其他计算机视觉库相比,OpenCV具有丰富的文档和教程,社区活跃,更新频繁,方便开发者快速入门并实现高效的图像处理任务。除此之外,OpenCV的与深度学习框架的集成(如TensorFlow和PyTorch)进一步增强了它在人工智能和机器学习领域的应用能力,使得开发者可以更加灵活地构建复杂的视觉识别和智能化应用。
3 系统需求分析
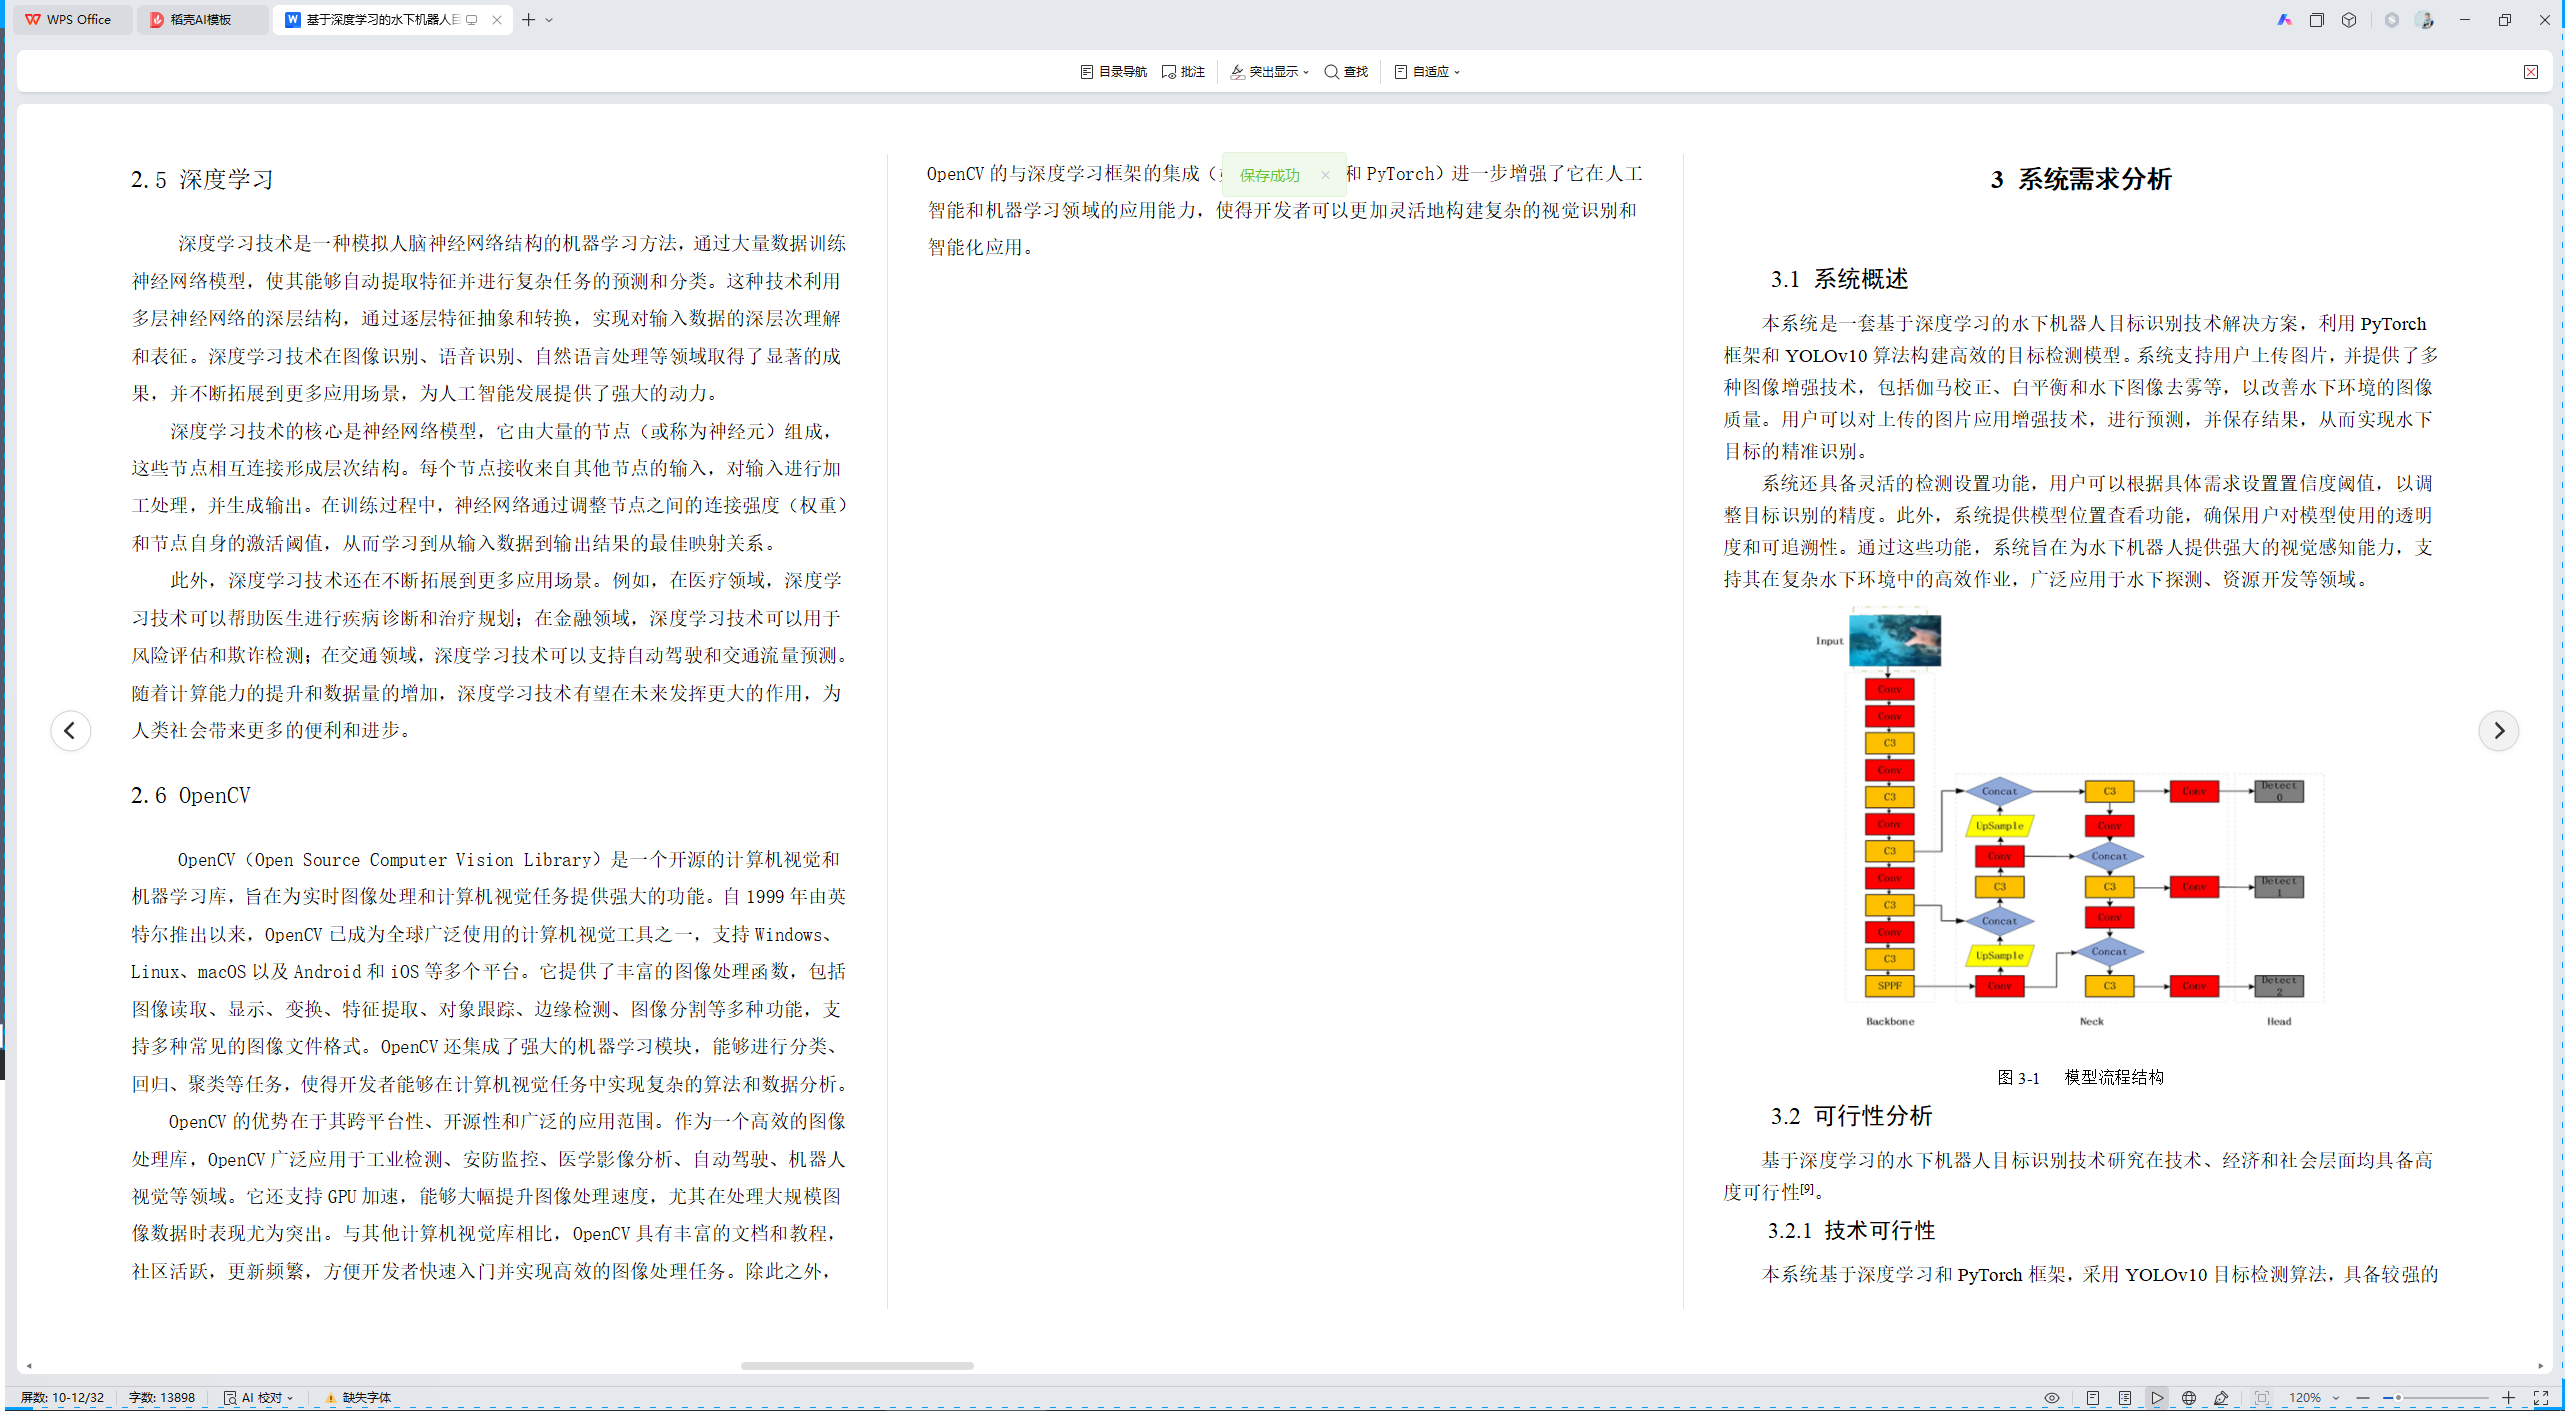
本系统是一套基于深度学习的水下机器人目标识别技术解决方案,利用PyTorch框架和YOLOv10算法构建高效的目标检测模型。系统支持用户上传图片,并提供了多种图像增强技术,包括伽马校正、白平衡和水下图像去雾等,以改善水下环境的图像质量。用户可以对上传的图片应用增强技术,进行预测,并保存结果,从而实现水下目标的精准识别。
系统还具备灵活的检测设置功能,用户可以根据具体需求设置置信度阈值,以调整目标识别的精度。此外,系统提供模型位置查看功能,确保用户对模型使用的透明度和可追溯性。通过这些功能,系统旨在为水下机器人提供强大的视觉感知能力,支持其在复杂水下环境中的高效作业,广泛应用于水下探测、资源开发等领域。
图3-1 模型流程结构
基于深度学习的水下机器人目标识别技术研究在技术、经济和社会层面均具备高度可行性[9]。
本系统基于深度学习和PyTorch框架,采用YOLOv10目标检测算法,具备较强的技术可行性。深度学习在图像处理和目标识别领域已展现出显著优势,PyTorch作为流行的深度学习框架,拥有丰富的库和工具,能够高效地实现模型训练和推理。YOLOv10算法在速度和精度方面进行了优化,适合实时目标检测任务。用户可通过系统上传图片,并应用多种图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以提高目标识别的准确性和鲁棒性。此外,系统还允许用户设置置信度阈值,以控制检测结果的精确度,并查看模型的具体位置。这些功能模块均已有成熟的技术实现方案,且在相关领域得到了广泛应用,因此,从技术角度来看,本系统的实现是可行的。
本系统基于深度学习和PyTorch框架,采用YOLOv10目标检测算法,具有较高的经济可行性。深度学习硬件和软件成本逐年降低,PyTorch作为开源框架,无需额外费用。YOLOv10算法在速度和精度方面进行了优化,能够在较低成本的服务器上运行,降低了硬件投入。用户通过系统上传图片,并应用多种图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,提高了目标识别的准确性和鲁棒性,减少了人工干预和错误率,降低了人力成本。此外,系统允许用户设置置信度阈值,以控制检测结果的精确度,并查看模型的具体位置,提高了工作效率。综上所述,本系统在硬件、软件和人力成本方面均具备较高的经济可行性,能够为水下机器人目标识别提供高效、低成本的解决方案。
3.2.3 社会可行性
本系统基于深度学习和PyTorch框架,采用YOLOv10目标检测算法,具有较高的社会可行性。随着海洋资源开发和海洋环境监测需求的增加,水下机器人目标识别技术在社会各领域具有广泛的应用前景。系统提供的图片处理功能,包括上传图片、应用增强、预测和保存结果,能够满足不同用户的需求。图像增强技术包括伽马校正、白平衡和水下图像去雾等,可以有效提高水下图像的质量,增强目标识别的准确性。检测设置模块允许用户根据实际需求调整置信度阈值,并提供模型位置信息,增强了系统的灵活性和透明度。综上所述,本系统在社会应用方面具备较高的可行性,能够为海洋资源开发、海洋环境监测等领域提供有力的技术支持。
3.3.1 数据分析与特征提取
在数据分析与特征提取方面,本研究首先对水下图像数据集进行预处理,包括图像格式的统一、尺寸调整等,以确保数据的一致性。随后,利用PyTorch框架进行图像增强,包括伽马校正、白平衡调整和水下图像去雾等,以增强图像的对比度和清晰度,突出目标特征。这些预处理步骤对于提高模型训练效率和识别准确率至关重要。
图3-2 数据特征处理流程
特征提取阶段,采用YOLOv10算法对增强后的图像进行目标检测。YOLOv10通过其强大的卷积神经网络结构,能够高效地提取图像中的关键特征,并实时输出目标的边界框和类别。通过设置置信度阈值,系统可以过滤掉低置信度的检测结果,从而提高识别的准确性。此外,系统还支持模型位置的查看,方便用户了解模型的内部结构和参数分布,进一步优化模型性能。
表3-1 检测精度指标
3.3.2 模型设计与优化
本系统采用YOLOv10目标检测算法,基于PyTorch框架进行设计和优化。YOLOv10通过引入高效的网络结构和先进的训练策略,在保证检测精度的同时,显著提高了推理速度,适用于实时性要求较高的水下目标检测任务。
在模型设计方面,针对水下图像的特点,对YOLOv10的骨干网络进行了微调,以增强模型对水下环境的适应性。此外,还引入了多尺度特征融合机制,充分利用不同层次的特征信息,提高了小目标检测的性能。
在模型优化方面,采用了迁移学习技术,利用在大型通用数据集上预训练的模型进行初始化,加快了模型的收敛速度,并减少了过拟合风险。同时,通过调整学习率、批量大小等超参数,并采用数据增强技术,进一步提升了模型的泛化能力和鲁棒性。最终,得到了一个轻量级且高效的水下目标检测模型,能够满足实际应用需求。检测模型的调用过程如下:
模型评估与部署:为了评估模型的性能,构建了一个包含多种水下目标的测试数据集,并采用精确度、召回率、F1-score等指标对模型进行了评估。实验结果表明,优化后的模型在各项指标上均取得了显著提升,尤其在检测小目标和应对复杂水下环境方面表现优异。在模型部署方面,利用PyTorch的灵活性和易用性,将训练好的模型导出为ONNX格式,便于在不同硬件平台上进行推理。同时,针对不同应用场景,进行了模型的量化压缩和加速优化,在保证检测精度的前提下,降低了模型的计算量和内存占用,使其能够高效运行在水下机器人等嵌入式设备上。
通过以上设计和优化,本系统实现了高效、准确的水下目标识别,为水下机器人的智能化发展提供了有力支持。
图3-3 模型流程图设计
3.3.3 系统实现
系统实现部分主要围绕深度学习技术和PyTorch框架展开。首先,利用PyTorch构建了基于YOLOv10算法的目标检测模型,该模型能够高效地处理水下图像数据。用户可以通过系统上传图片,并应用多种图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以改善图像质量。增强后的图像被送入YOLOv10模型进行预测,识别结果可实时显示并保存。
以下是水下去雾算法的核心代码:
在检测设置方面,系统提供了置信度阈值设置功能,用户可以根据具体需求调整阈值,以平衡识别的准确性和速度。此外,系统还支持查看模型位置,方便用户了解模型的部署情况。通过这些功能的实现,系统不仅提高了水下机器人目标识别的准确性,还增强了用户体验,为水下探测和作业提供了有力的技术支持。
系统使用PyQt5构建界面,采用了模块化设计和样式表定制,核心代码展示如下:
图3-4 管理系统流程图设计
本系统在设计之初,除了关注功能性需求外,还着重考虑了非功能性需求,以确保系统的实用性、可靠性和用户体验。首先,性能需求方面,系统需具备高效的图像处理和目标识别能力。YOLOv10算法的选用保证了检测速度,而基于PyTorch的优化则进一步提升了推理效率。此外,图像增强模块,包括伽马校正、白平衡调整和水下图像去雾等技术的集成,旨在提高图像质量,从而提升目标识别的准确性。系统还需具备良好的可扩展性,以适应未来更复杂的检测任务和更大规模的数据处理需求。其次,可靠性需求方面,系统需具备高可用性和容错能力。通过采用成熟稳定的深度学习框架PyTorch,以及经过充分验证的YOLOv10算法,系统在运行时能够保持较高的稳定性。同时,系统还应对输入的图像数据进行有效性检查,并对潜在的异常情况进行处理,以保证系统的鲁棒性。此外,系统还应提供详细的日志记录和错误报告,便于问题追踪和系统维护。
安全性及易用性需求:在安全性需求方面,系统需确保用户数据的安全和隐私。用户上传的图片数据应进行加密存储,并仅用于目标识别任务,不得泄露给任何第三方。系统还应设置访问权限控制,确保只有授权用户才能进行图片处理和结果查看等操作。在易用性需求方面,系统应提供友好的用户界面,操作流程应简洁明了。用户可以方便地进行图片上传、增强、预测和结果保存等操作。检测设置模块应提供清晰的指引,使用户能够轻松设置置信度阈值并查看模型位置信息。此外,系统还应提供详细的帮助文档和用户手册,以便用户更好地了解和使用系统的各项功能。通过满足这些非功能性需求,本系统能够为用户提供安全、可靠、高效且易用的水下目标识别服务。
表3-2 性能指标
4 系统概要设计
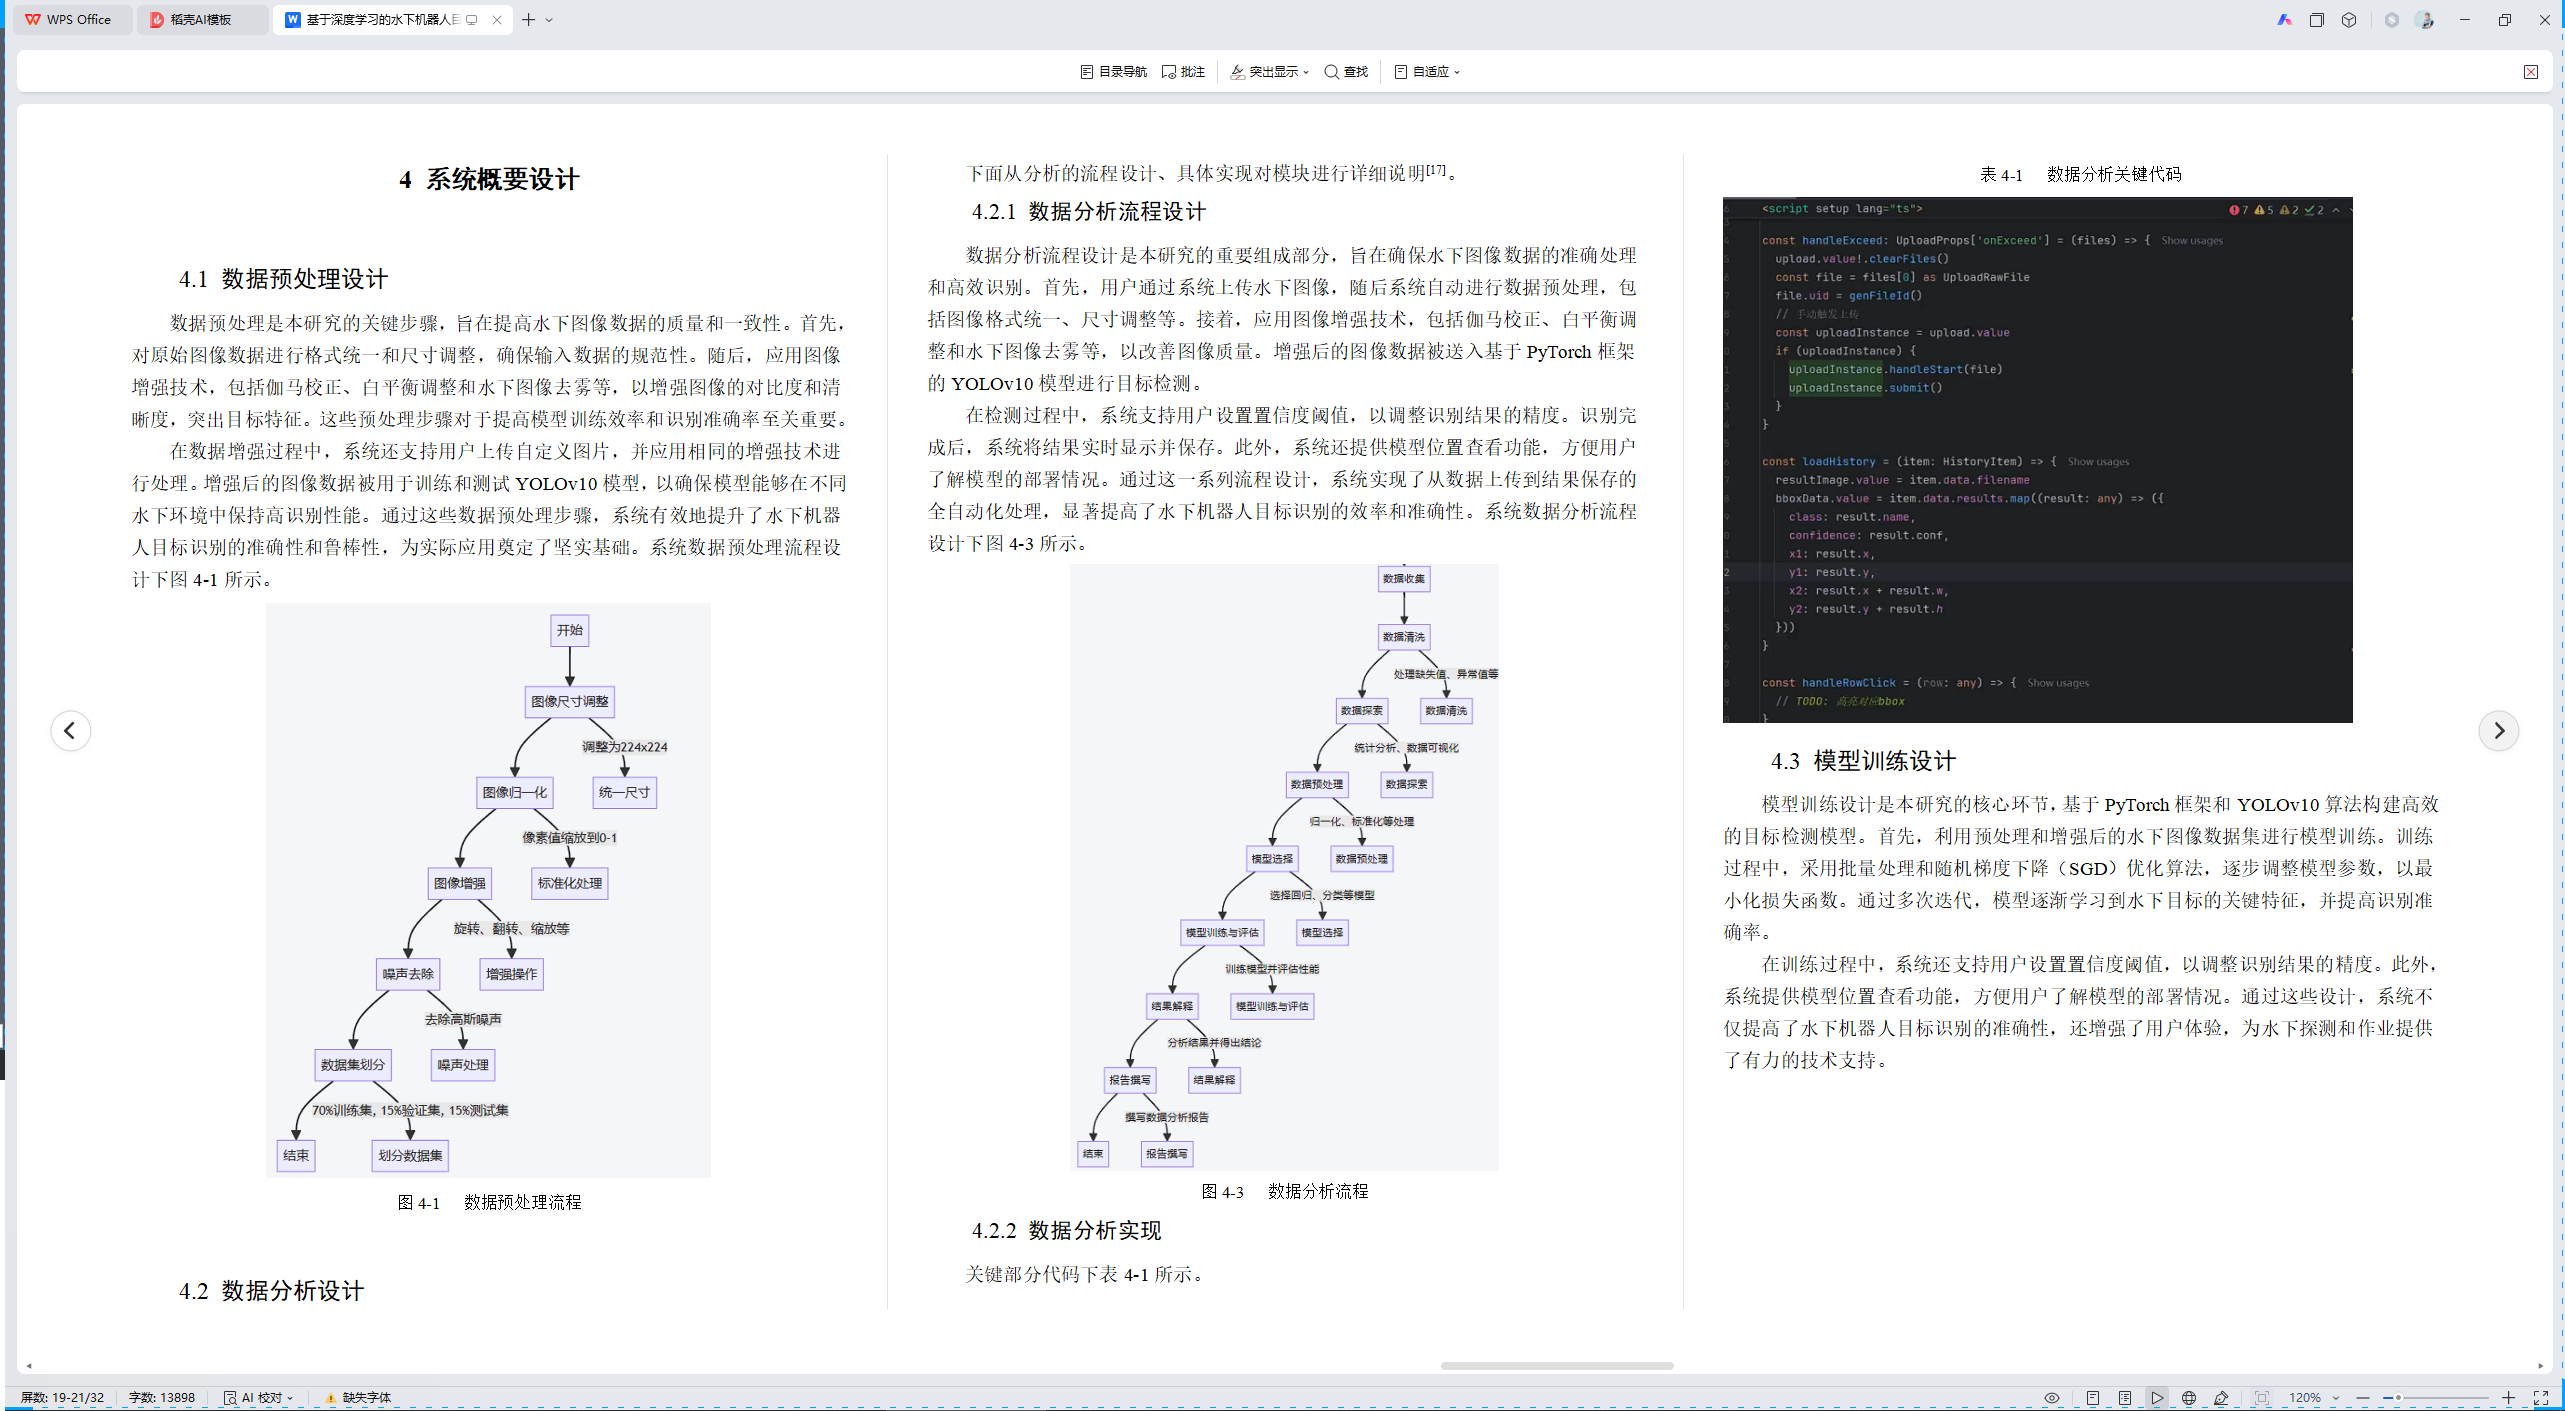
数据预处理是本研究的关键步骤,旨在提高水下图像数据的质量和一致性。首先,对原始图像数据进行格式统一和尺寸调整,确保输入数据的规范性。随后,应用图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以增强图像的对比度和清晰度,突出目标特征。这些预处理步骤对于提高模型训练效率和识别准确率至关重要。
在数据增强过程中,系统还支持用户上传自定义图片,并应用相同的增强技术进行处理。增强后的图像数据被用于训练和测试YOLOv10模型,以确保模型能够在不同水下环境中保持高识别性能。通过这些数据预处理步骤,系统有效地提升了水下机器人目标识别的准确性和鲁棒性,为实际应用奠定了坚实基础。系统数据预处理流程设计下图4-1所示。
图4-1 数据预处理流程
下面从分析的流程设计、具体实现对模块进行详细说明[17]。
4.2.1 数据分析流程设计
数据分析流程设计是本研究的重要组成部分,旨在确保水下图像数据的准确处理和高效识别。首先,用户通过系统上传水下图像,随后系统自动进行数据预处理,包括图像格式统一、尺寸调整等。接着,应用图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以改善图像质量。增强后的图像数据被送入基于PyTorch框架的YOLOv10模型进行目标检测。
在检测过程中,系统支持用户设置置信度阈值,以调整识别结果的精度。识别完成后,系统将结果实时显示并保存。此外,系统还提供模型位置查看功能,方便用户了解模型的部署情况。通过这一系列流程设计,系统实现了从数据上传到结果保存的全自动化处理,显著提高了水下机器人目标识别的效率和准确性。系统数据分析流程设计下图4-3所示。
图4-3 数据分析流程
4.2.2 数据分析实现
关键部分代码下表4-1所示。
表4-1 数据分析关键代码
模型训练设计是本研究的核心环节,基于PyTorch框架和YOLOv10算法构建高效的目标检测模型。首先,利用预处理和增强后的水下图像数据集进行模型训练。训练过程中,采用批量处理和随机梯度下降(SGD)优化算法,逐步调整模型参数,以最小化损失函数。通过多次迭代,模型逐渐学习到水下目标的关键特征,并提高识别准确率。
在训练过程中,系统还支持用户设置置信度阈值,以调整识别结果的精度。此外,系统提供模型位置查看功能,方便用户了解模型的部署情况。通过这些设计,系统不仅提高了水下机器人目标识别的准确性,还增强了用户体验,为水下探测和作业提供了有力的技术支持。
图4-3 模型训练
本系统模型调用设计紧密围绕用户操作流程,确保用户能够便捷地完成从图片处理到目标识别的全过程。首先,用户通过上传图片接口将待处理的图像上传至系统。系统接收到图像后,会根据用户选择的图像增强选项,对图像进行预处理。这些图像增强操作旨在改善图像质量,提高后续目标识别的准确性。预处理完成后,系统将增强后的图像输入到基于YOLOv10算法的深度学习模型中进行目标检测。YOLOv10模型在PyTorch框架下运行,能够快速、准确地识别图像中的目标,并输出检测结果的坐标和置信度信息。
图4-4 模型调用关键代码
为了方便用户管理和使用模型,系统还设计了检测设置模块。在该模块中,用户可以根据实际需求调整置信度阈值,以控制检测结果的精确度。此外,系统还提供了模型位置信息查看功能,使用户能够了解模型的具体部署位置。这些设计不仅增强了系统的灵活性,还提高了用户对模型运行过程的透明度。在模型调用过程中,系统会实时显示检测进度和结果,用户可以直观地查看识别结果,并将其保存到本地。通过这种设计,系统实现了从图像上传、增强、检测到结果保存的全流程自动化,为用户提供了高效、便捷的水下目标识别服务。
5 系统实现
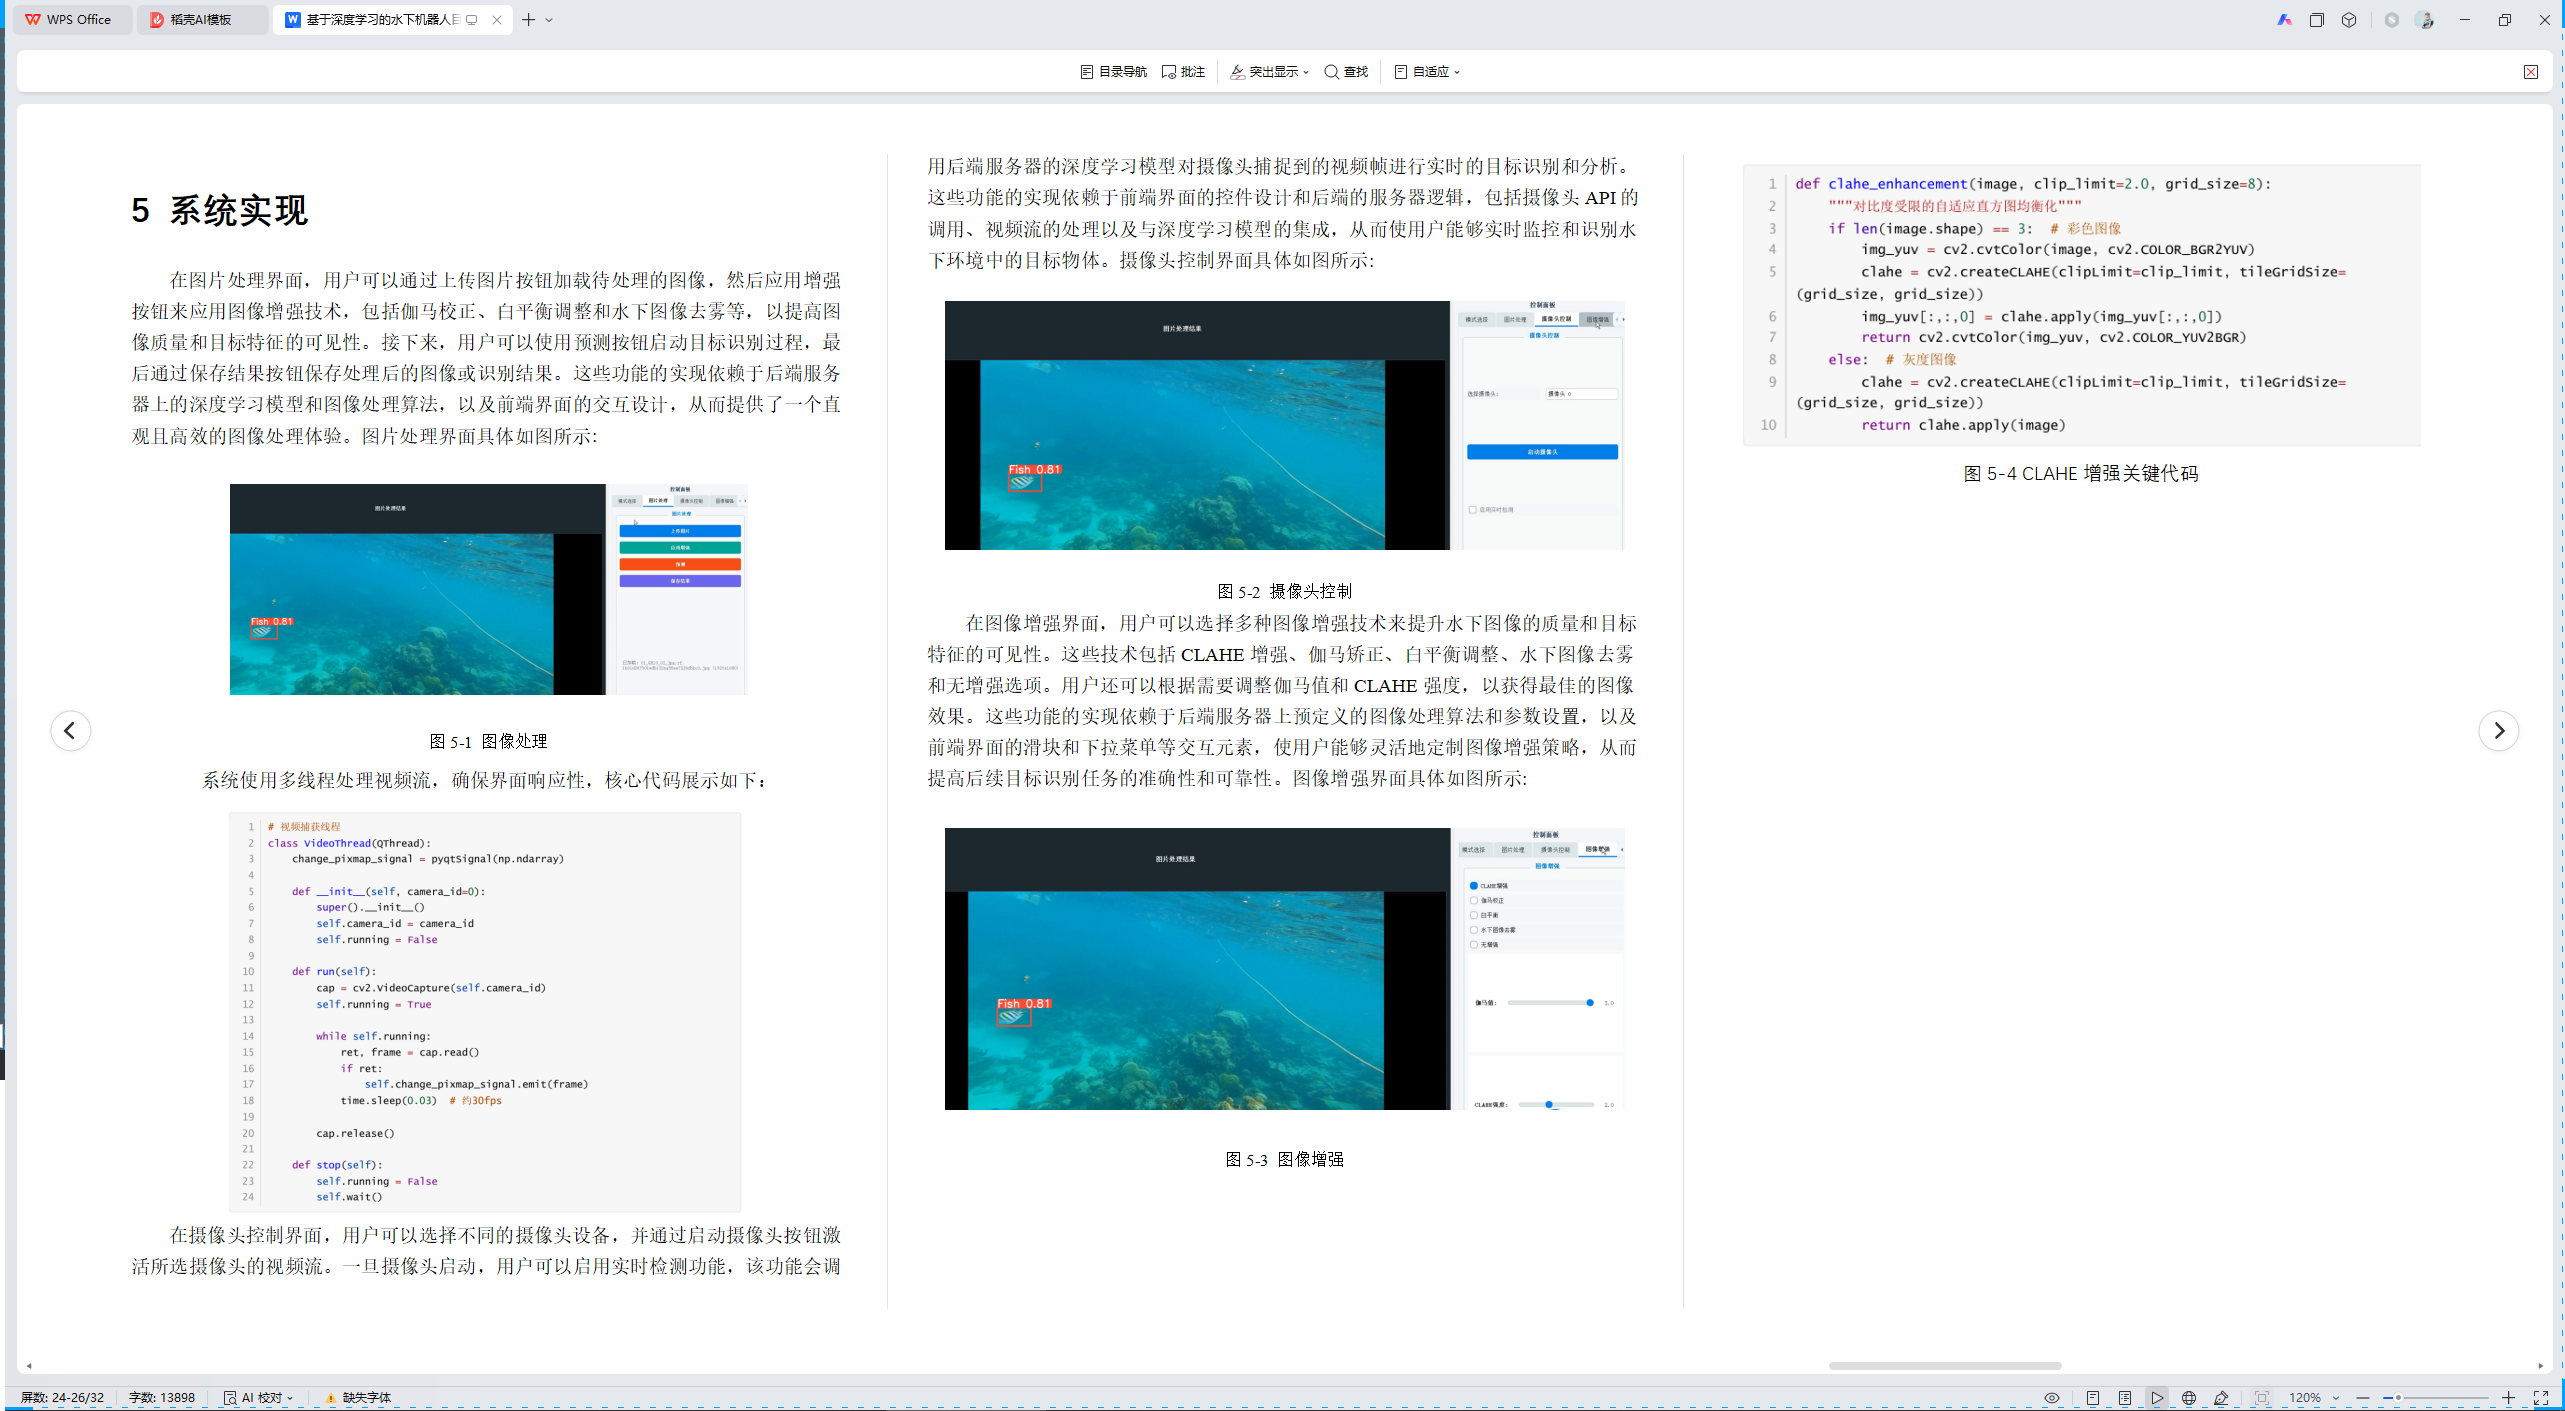
在图片处理界面,用户可以通过上传图片按钮加载待处理的图像,然后应用增强按钮来应用图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以提高图像质量和目标特征的可见性。接下来,用户可以使用预测按钮启动目标识别过程,最后通过保存结果按钮保存处理后的图像或识别结果。这些功能的实现依赖于后端服务器上的深度学习模型和图像处理算法,以及前端界面的交互设计,从而提供了一个直观且高效的图像处理体验。图片处理界面具体如图所示:
图5-1 图像处理
系统使用多线程处理视频流,确保界面响应性,核心代码展示如下:
在摄像头控制界面,用户可以选择不同的摄像头设备,并通过启动摄像头按钮激活所选摄像头的视频流。一旦摄像头启动,用户可以启用实时检测功能,该功能会调用后端服务器的深度学习模型对摄像头捕捉到的视频帧进行实时的目标识别和分析。这些功能的实现依赖于前端界面的控件设计和后端的服务器逻辑,包括摄像头API的调用、视频流的处理以及与深度学习模型的集成,从而使用户能够实时监控和识别水下环境中的目标物体。摄像头控制界面具体如图所示:
图5-2 摄像头控制
在图像增强界面,用户可以选择多种图像增强技术来提升水下图像的质量和目标特征的可见性。这些技术包括CLAHE增强、伽马矫正、白平衡调整、水下图像去雾和无增强选项。用户还可以根据需要调整伽马值和CLAHE强度,以获得最佳的图像效果。这些功能的实现依赖于后端服务器上预定义的图像处理算法和参数设置,以及前端界面的滑块和下拉菜单等交互元素,使用户能够灵活地定制图像增强策略,从而提高后续目标识别任务的准确性和可靠性。图像增强界面具体如图所示:
图5-3 图像增强
图5-4 CLAHE增强关键代码
6 系统测试
基于深度学习的水下机器人目标识别技术系统的测试是一个全面的过程,旨在确保系统的稳定性、准确性和安全性。以下是针对功能测试、性能测试、安全性测试、兼容性测试和回归测试的详细分析:
1、功能测试
功能测试是验证系统是否按照预期执行任务的过程。首先,测试团队会准备一系列测试用例,这些用例涵盖了系统的主要功能,如上传图片、应用增强、预测和保存结果。每个功能点都会被详细测试,以确保它们在正常情况下能够正确执行。其次,测试团队会模拟各种用户操作,包括正确的和错误的输入,以验证系统的鲁棒性。此外,功能测试还包括对图像增强功能的验证,包括CLAHE增强、伽马矫正和白平衡调整等,确保这些功能能够有效改善图像质量。最后,功能测试还会检查系统的用户界面是否直观易用,以及所有功能按钮是否能够正常响应。通过功能测试,可以确保系统的所有功能模块都能够按照设计要求正常运行。
2、性能测试
性能测试是评估系统在不同负载下的表现。首先,测试团队会对系统进行基准测试,以确定其在正常负载下的响应时间和处理能力。这包括测试图像上传、增强和预测的时间,以及系统的并发处理能力。其次,性能测试会模拟高负载情况,如大量用户同时上传图片或进行实时检测,以评估系统的稳定性和扩展性。此外,性能测试还会检查系统在长时间运行后的表现,以验证其可靠性和耐久性。最后,性能测试还包括对系统资源使用情况的监控,如CPU、内存和存储的使用率,以确保系统在高负载下不会出现资源瓶颈。通过性能测试,可以确保系统在实际应用中能够高效稳定地运行。
3、安全性测试
安全性测试是确保系统在保护用户数据和防止恶意攻击方面的能力。首先,测试团队会进行渗透测试,模拟黑客攻击,以检查系统的安全漏洞。这包括尝试SQL注入、跨站脚本攻击(XSS)和跨站请求伪造(CSRF)等常见攻击手段。其次,安全性测试会验证系统的数据加密和传输安全,确保用户上传的图片和识别结果在传输和存储过程中不会被窃取或篡改。此外,安全性测试还会检查系统的访问控制机制,确保只有授权用户才能访问系统和数据。最后,安全性测试还包括对系统备份和恢复机制的验证,确保在发生数据丢失或系统故障时能够快速恢复。通过安全性测试,可以确保系统的安全性和用户数据的隐私保护。
4、兼容性测试
兼容性测试是验证系统在不同环境和设备上的表现。首先,测试团队会在不同的操作系统和浏览器上进行测试,确保系统的前端界面和后端服务在各种环境下都能正常工作。这包括Windows、macOS和Linux等操作系统,以及Chrome、Firefox和Safari等浏览器。其次,兼容性测试会检查系统在不同硬件配置下的表现,包括不同的CPU、内存和存储设备。此外,兼容性测试还会验证系统在不同网络环境下的表现,包括高速和低速网络,以及有线和无线连接。最后,兼容性测试还包括对移动设备的测试,确保系统的移动端应用能够正常工作。通过兼容性测试,可以确保系统在各种环境下都能提供一致的用户体验。
5、回归测试
回归测试是在系统更新或修复后,重新进行测试以确保新引入的更改没有破坏现有功能。首先,测试团队会重新执行功能测试的所有用例,确保所有功能仍然按照预期工作。其次,回归测试会特别关注那些在新更改中可能受到影响的功能点,进行重点测试。此外,回归测试还会包括性能测试和安全性测试,确保系统的性能和安全性没有因为新更改而下降。最后,回归测试会记录所有测试结果,并与之前的测试结果进行对比,确保没有引入新的问题。通过回归测试,可以确保系统的稳定性和可靠性在更新后仍然得到保障。
综上所述,基于深度学习的水下机器人目标识别技术系统的测试是一个全面且细致的过程,涵盖了功能测试、性能测试、安全性测试、兼容性测试和回归测试等多个方面。通过这些测试,可以确保系统在实际应用中能够高效、稳定和安全地运行,为用户提供可靠的水下目标识别服务.
7 总结与展望
本系统基于深度学习、PyTorch框架和YOLOv10目标检测算法,旨在实现高效、准确的水下机器人目标识别。系统提供了全面的图片处理功能,包括上传图片、应用增强、预测和保存结果,以及多种图像增强技术,包括伽马校正、白平衡调整和水下图像去雾等,以适应复杂的水下环境并提高目标识别的准确性。检测设置模块允许用户根据实际需求调整置信度阈值,并提供模型位置信息,增强了系统的灵活性和透明度。
在技术实现上,系统充分利用了深度学习的优势,结合PyTorch框架的灵活性和YOLOv10算法的高效性,实现了快速、准确的实时目标检测。通过模型设计与优化,系统针对水下环境进行了专门的调整,提高了模型对水下环境的适应性,并在各项指标上取得了显著提升。此外,系统还考虑了非功能性需求,如性能、可靠性、安全性和易用性,确保了系统的实用性、稳定性和用户体验。
综上所述,本系统在水下机器人目标识别领域具有显著的技术优势和应用价值。通过深度学习、PyTorch和YOLOv10的结合,系统能够高效、准确地识别水下目标,为海洋资源开发、海洋环境监测等领域提供了有力的技术支持。未来,随着技术的不断进步和应用场景的不断拓展,本系统将在水下机器人智能化发展中发挥更大的作用。
致谢
在这篇论文即将完成之际,我心中充满了感激之情,想要借此机会表达我对那些在我学术旅程中给予帮助的人们的深深谢意。
首先,我要感谢我的老师。是您耐心细致的指导让我少走了很多弯路,您的专业知识和严谨态度一直是我学习的榜样。每当我遇到困难时,您总是能及时伸出援手,给我指引方向。
我还要感谢我的家人,尤其是我的父母。是你们的理解和支持让我能够全身心地投入到研究中。你们为我创造了一个安静的学习环境,让我可以专心致志地完成论文。
此外,我还要感谢我的同学们。一起度过了无数个日夜,共同探讨问题、分享经验。是你们的陪伴让这段时光变得更加美好和难忘。
最后,我要感谢所有为本文做出贡献的人们。正是有了大家的共同努力,才使得这篇论文得以顺利完成。再次对大家表示衷心的感谢!
以上就是我想要表达的致谢词,虽然篇幅有限,但我的感激之情却是无尽的。希望在未来的人生道路上,我能继续得到各位的帮助和支持,一起勇往直前、共创辉煌!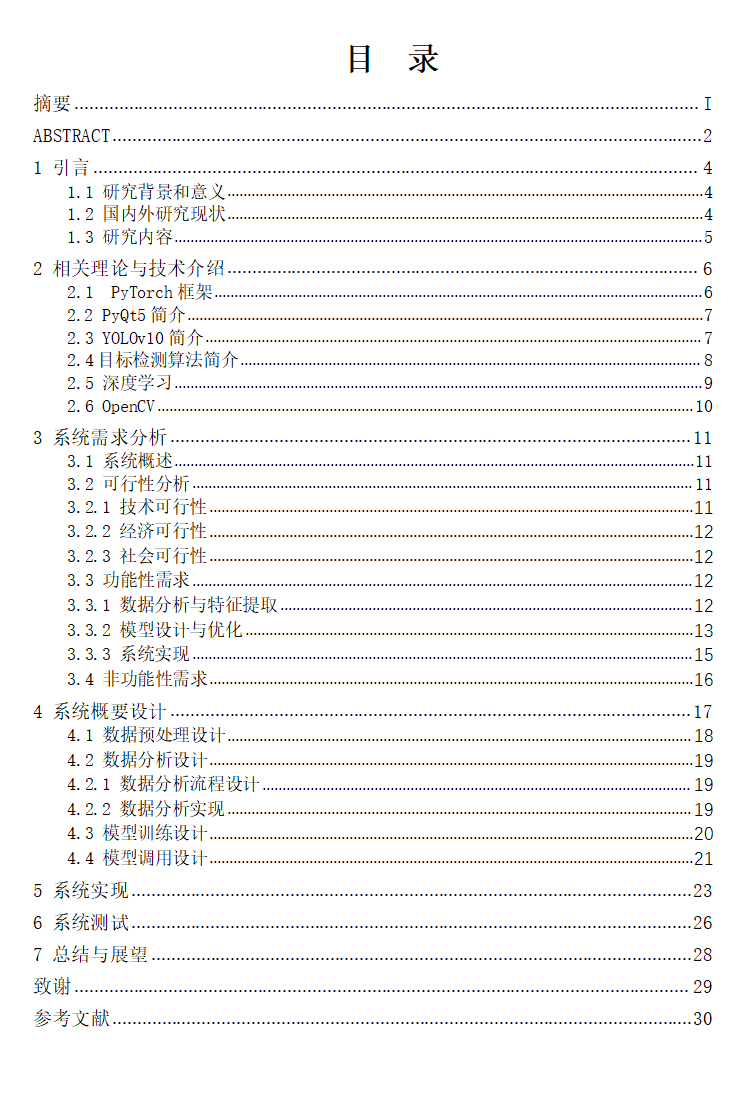

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献9条内容

所有评论(0)