高阶智驾进入深水区,谁在重新定义体验上限?
城市NOA的战火,已经从“开城数量”烧到了“体验深度比拼”的深水区。
根据高工智能汽车研究院发布报告称,2026年1-7月,中国市场(不含进出口)乘用车前装标配NOA交付新车351.22万辆,同比增长46.78%,前装搭载率升至35.22%。其中支持城区NOA占比接近50%,同比大增100.30%。
然而,伴随着城区NOA加速向主流市场下探,复杂城市路况下的体验短板开始集中暴露。在面对车辆近距离cut-in加塞、鬼探头、异形障碍物等高频危险场景,大量智驾系统还存在反应滞后、决策低效、通行丝滑度不足等问题,人工接管频发。行业实测数据显示,城市NOA平均每8.7公里就需要一次人工接管,安全性与实用性仍难以满足用户高频通勤需求,“能用、不好用”正成为制约高阶智驾普及的核心桎梏。
过去几年,智驾算法范式经历了前所未有的跃迁,从传统规则驱动到模块化端到端,快速演进至一段式端到端、VLA与世界模型等全新技术路线。
然而,算法迭代持续拉高智驾体验的下限,真正决定高阶智驾落地体验上限与量产天花板的核心,却是底层智驾芯片的系统性硬件能力。
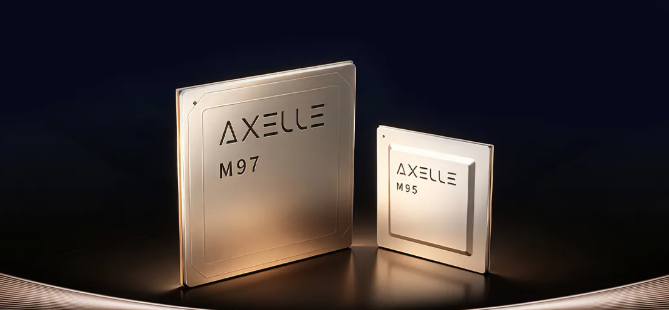
近日,已实现160万颗智驾芯片规模化出货的爱芯元智,正式推出全新M9系列5nm车规高阶智驾芯片,包含旗舰级M97和主流级M95双芯产品。该系列产品采用5nm先进制程,AI算力最高达到720TOPS,为城区NOA的规模化下沉、新算法范式量产落地提供全新硬件底座,并系统性破解了大模型智驾落地的底层瓶颈。
01
城区NOA距离“好用”,卡在哪里?
决定城区NOA赛道终局的核心,不止于算法够不够聪明,更为关键的还有芯片够不够快。
众所周知,传统智驾系统可以精准识别路边行人、车辆、障碍物等具象物体,却无法判断路况主体的行为意图,看不懂复杂场景下的潜在风险。
过去几年,国内智驾行业迎来了颠覆性的算法范式迭代,从传统规则驱动,到BEV+Transformer摆脱地图依赖,再到一段式端到端大模型;如今,VLA(视觉-语言-动作大模型)和世界模型已成为头部玩家的共同押注方向。而这两类全新技术路线的核心目标,正是让智驾系统从“识别场景”升级为“理解场景、预判意图”,真正贴近人类驾驶的思考逻辑。
然而,值得注意的是,算法范式的跨越式升级,也对底层硬件提出了前所未有的严苛要求。不同于传统算法仅需处理车道线、车辆检测框等结构化信息,VLA、世界模型等新一代算法,需要实时处理海量、高维、多模态的原始传感数据,模型参数量从百万级暴涨至十亿、百亿级别,对硬件的需求不再只是纸面算力数字,而是一整套稳定、低延迟、高吞吐的数据处理能力。
于是,高阶智驾就出现了尴尬的局面:算法一直在拉高智驾体验的下限,但用户的实际体验并没有同步变好。
从用户真实用车场景来看,用户对城区NOA的不满,最终都能归为两类核心问题,且每一类问题,都对应着行业普遍存在的硬件短板。
第一类是用户不敢用,安全接管。日常行车频繁出现的近距离加塞、鬼探头等突发危险场景,是人工接管的高频场景。当前,多数主流智驾芯片的感知帧率仅维持在15-20fps,从感知到决策的闭环延迟可能超过200ms,在120km/h车速下相当于车辆多出近7米的无效制动距离,大幅压缩安全冗余时间。
第二类是不爱用,效率接管。很多用户反馈智驾通行效率低、行驶质感差,具体表现为路口犹豫停滞、跟车左右偏移、车速顿挫不稳。其核心根源,是行业多数芯片方案全链路运算延时偏高、响应速度不足,导致系统“算得慢、决策滞后”。毫秒级的延时持续累积,就会出现车辆通行时迟疑不前、该减速时响应滞后的问题,无法平滑适配车流动态变化,极大破坏通勤舒适性与通行效率。
上述两类接管,核心都指向同一个病根——系统反应不够快。有业内人士将其拆解为三道由芯片硬件锁定的硬坎,外加一项长期被行业忽视的隐性瓶颈——帧率、延时、ISP画质、带宽,四项共同决定了高阶智驾的体验天花板。
第一道坎:帧率不足,场景捕捉滞后。感知帧率是智驾系统捕捉路况动态的核心基础,帧率高低直接决定系统对突发场景的敏感度。行业主流低帧率方案,无法实时跟进瞬息万变的城市路况,面对突发加塞、行人横穿等场景极易慢半拍,是智驾系统安全接管频发的核心诱因。
第二道坎:链路延时偏高,决策响应迟钝。从图像采集、数据处理到最终输出车辆控制指令,全链路延时决定智驾系统的动态反应能力。行业大量芯片方案存在数据搬运、运算调度低效问题,微小延时层层叠加,最终转化为路口迟疑、跟车不稳等体验问题,大幅拉低智驾流畅度。
第三道坎:ISP画质偏弱,复杂场景看不清。城市通勤普遍存在隧道明暗切换、夜间逆光、车库出入口强光刺激等复杂光照场景,行业多数芯片的ISP图像处理能力薄弱,极易出现画面过曝、噪点过多、画质失真等问题。而新一代大模型对输入图像质量敏感度极高,劣质的原始画面,即便搭载高性能NPU算力,也无法输出精准的感知结果,陷入“垃圾进、垃圾出”的行业通病。
第四道坎,也是最隐蔽的一道:内存带宽受限,算力空转浪费。现阶段,VLA、端到端大模型推理均属于访存受限场景,在车端 batch 受限的硬实时条件下,,带宽已经决定大模型能否跑起来的关键瓶颈。《高工智能汽车》了解到,当前,很多高算力芯片看似TOPS参数亮眼,但内存带宽配置滞后,导致海量数据无法及时输送至计算单元。就像一个工厂,流水线上有足够多的工人(算力),但传送带太窄(带宽),原料送不到工位,工人只能等着。
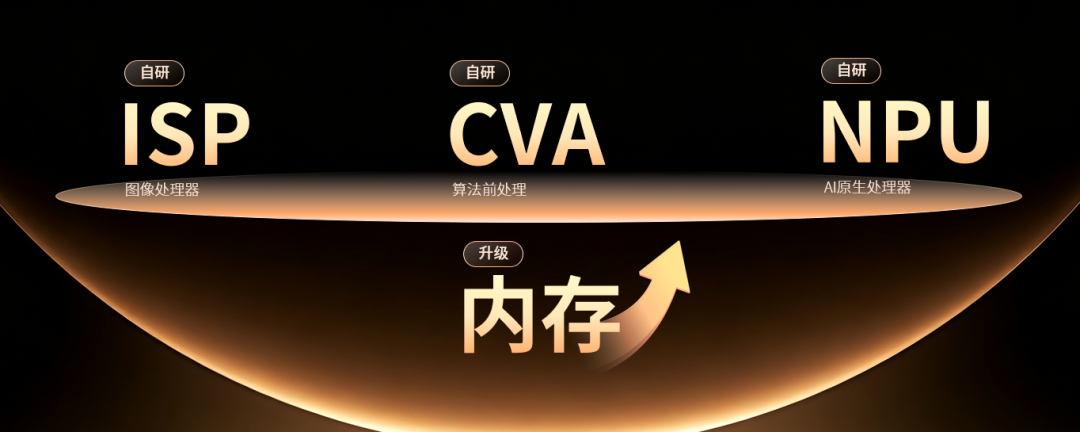
从完整数据链路来看,车辆感知流程贯穿图像与雷达数据采集、ISP图像处理、CVA硬件前置处理、NPU大模型推理全流程,而内存带宽贯穿每一个核心环节。这就意味着,芯片任一硬件模块存在短板,都会形成性能瓶颈,导致后续算力资源全部无效空转。
这正是当前高阶智驾系统“反应慢、效率低”的底层技术根因。不是算法不够聪明,而是芯片底座的系统性能力,跟不上算法的进化速度。
这也标志着,智驾芯片行业的竞争逻辑已经彻底转变,从单纯比拼TOPS峰值算力的粗放内卷,进入以高帧率、低延时、优画质、大带宽为核心的系统效率之争。这正是爱芯元智M9系列双芯产品的核心切入逻辑,精准直击行业痛点,补齐大模型智驾量产落地的硬件短板。
02
爱芯M9系列,重构大模型智驾的量产底座
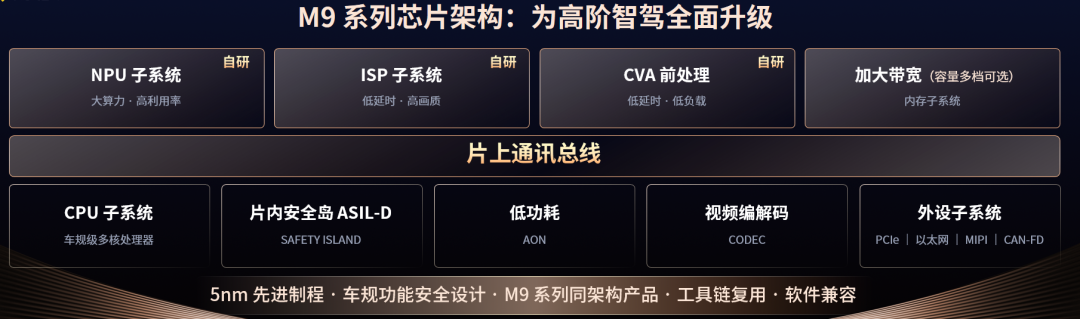
面对帧率、延时、画质、带宽四大行业共性瓶颈,爱芯元智选择自研NPU/ISP/CVA(Computer Vision Accelerator)前处理等核心IP,打通整条硬件链路,系统性补齐行业短板,为大模型智驾规模化量产打造全新底座。
1、自研高利用率NPU,让AI算力真正用起来
传统芯片处理突发加塞、行人横穿等场景时,常因通用算力“平均化”导致延迟。爱芯M9系列采用面向车规功能安全设计的多核多集群NPU架构,片上缓存规模相比国产同级产品提升30%以上,芯片内部拥有TB/s级高速互联带宽。矩阵与向量计算单元可以共享片上缓存,中间计算结果无需反复进出内存,大幅提升算力实际利用率。
芯片原生支持 FP4、INT8、FP8、BF16多精度混合计算,CPU与NPU之间实现硬件级零拷贝,减少数据搬运带来的延迟。此外,还搭配自研全套工具链,算法移植适配周期从传统方案的“按月迭代”压缩至“按周落地”,大幅降低车企落地新一代大模型的开发成本。
2、 自研低延时高画质ISP:同源双通路,兼顾识别与显示
爱芯元智自研智眸AI-ISP采用业界首创的超低延时架构,处理时延小于10毫秒,支持16路摄像头接入、4.5G Pixels/s吞吐(M95为14路、2.6G Pixels/s),同时能够座舱和智驾的感知需求。
它的独到之处是同源输入双通路处理:一路CV机器视觉通路,专为AI感知算法优化;一路HV通路,为人眼观感优化。两路同源却互不干扰——机器要看清的,和人眼要看舒服的,本来就不是同一件事。
极端光照下的表现,因此有了硬件级解法:地下车库出入口、夜间逆光、隧道明暗剧变,不再是感知的盲区。
3、CVA硬件前处理单元,进一步释放核心算力。
图像预处理、计算机视觉算子、激光雷达点云处理全部交由硬件单元加速完成,多传感器时间同步直接在硬件层面实现,无需占用CPU与NPU资源,也无需反复读写内存,最大限度减轻系统负载,让NPU算力全部集中用于大模型核心推理任务。
4、M97带宽高达460GB/s,是业界旗舰智驾芯片的2倍。
这是最容易被忽视、却最致命的一环。在大模型推理下,带宽是真正的天花板。M97等效内存带宽460GB/s,提供36/48/64/96GB四档可选容量;而面向主流车型的M95带宽为260GB/s,可选12/18/24GB三档内存。相较于行业普遍重算力、轻带宽的设计思路,M9系列超大带宽搭配多档容量选择,可让车企根据搭载模型的规模灵活选型,精准平衡性能与成本,大幅降低端到端、VLA大模型移植与调优的难度,让纸面算力真正转化为落地体验。
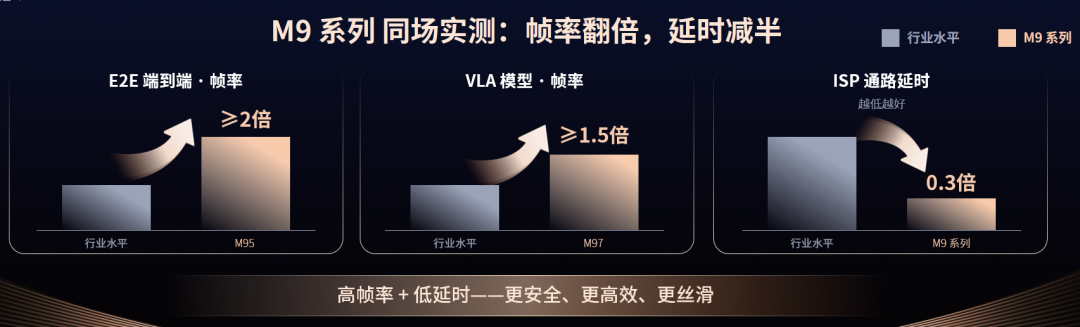
依托以上四大核心模块的自研与升级,爱芯元智M9系列实现了芯片性能的全维系统优化,可以充分释放VLA、世界模型的场景理解优势,让硬件速度匹配算法智商。
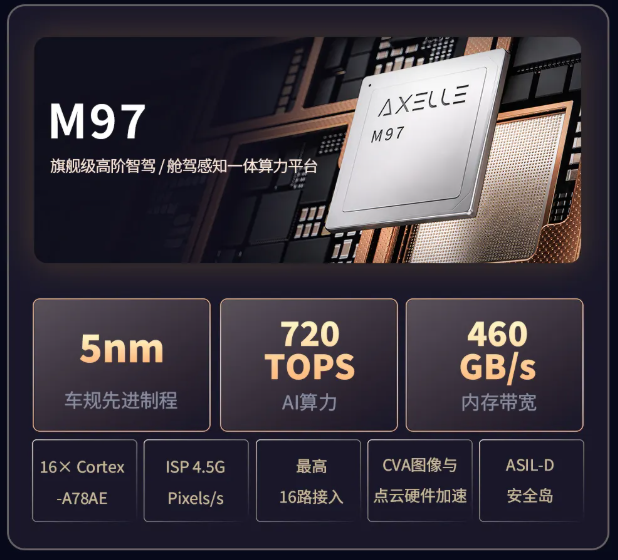
具体来看,M97核心定位为“旗舰级高阶智驾/舱驾感知一体算力平台”,基于5nm车规先进制程打造,拥有720TOPS等效AI算力、460GB/s行业顶级内存带宽,搭配16个Cortex-A78AE车规安全大核(400KDMIPS算力)、顶配ISP与CVA硬件单元,可全面支撑VLA、世界模型、舱驾融合等高阶方案落地。
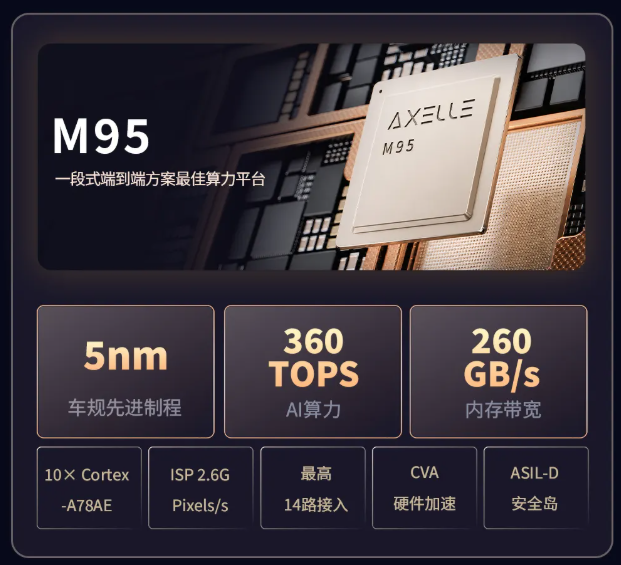
而主流级M95定位一段式端到端智驾最优算力平台,延续同款5nm制程与统一硬件架构,360TOPS等效AI算力、260GB/s带宽搭配10核Cortex-A78AE大核(257KDMIPS算力),均衡的硬件配置完美适配20万级主流车型城区NOA规模化下沉需求,让高阶端到端智驾不再局限于高端车型。
基于同源同模型的原生实测数据显示,M9系列综合性能大幅领先行业主流方案:整体系统帧率达到行业均值1.5倍以上,其中M95端到端智驾帧率为行业2倍,M97运行VLA大模型帧率领先行业1.5倍;ISP通路延时较行业水平降低70%,实现极致低延迟感知响应。
与此同时,爱芯元智M9系列不仅满足AEC-Q100车规认证,还内置了ASIL-D等级片内锁步安全岛,芯片整体达ASIL-B等级。双芯片间通信速率可达64GB/s,支持双芯冗余架构,为L3/L4提供失效可运行硬件基础。
03
智驾芯片市场开始重构
众所周知,特斯拉以封闭自研模式实现了从芯片到算法的全链条自主掌控,构建起难以复制的技术闭环,长期占据全球高阶智驾的标杆地位。因此,以蔚来、小鹏、理想为代表的中国头部车企纷纷跟进“重软硬一体化”路线,试图通过自研芯片复刻这一路径。
然而,对于大多数车企来说,自研芯片的门槛极高,无论是芯片设计、流片、车规验证、量产,还是工具链建设等,每一项投入都是数亿级别的投入。所以对绝大多数车企而言,自研芯片既不现实,也不经济。
因此,第三方专业供应商依旧是行业主流选择,牢牢占据国内智驾芯片市场核心份额。根据《高工智能汽车研究院》数据显示,2026年上半年,中国市场(不含进出口)自主品牌乘用车支持城区NOA芯片平台(含硬件预埋)中,英伟达、地平线、华为三家占接近80%的市场份额,其中英伟达稳居行业榜首。
在整体市场格局趋于稳定的同时,行业结构性痛点依旧突出,核心矛盾集中于销量最大、潜力最高的主流家用市场——20万级主流家用车型,是城区NOA规模化普及最大的增量市场,但却长期面临“上不去、下不来”的产业困境:OEM自研成本无法承受,英伟达方案BOM成本居高不下,而市场传统入门级芯片又缺乏支撑VLA、一段式端到端等新算法范式的全链路硬件能力。
在这样的背景下,行业亟需一套兼顾大算力、高带宽、全维度安全且不干涉车企算法自主权的智驾芯片方案。
在此前,爱芯元智已经推出了M55、M57等芯片,精准聚焦基础L2、AEB法规驱动的刚需市场,并且凭借高智价比、强合规与稳定可靠的产品表现,快速实现了规模化上量。数据显示,从2023年6月首颗芯片量产上车,到2026年8月,爱芯元智智驾芯片累计全球出货量突破160万颗。
M9系列的推出,意味着爱芯元智的产品战略从"普惠型法规市场"向"高阶智驾市场"完成了关键一跃。凭借“统一架构、双芯全域覆盖”的差异化产品策略,爱芯元智M9系列精准卡位行业空白,形成“高端对标国际旗舰、主流支撑全民智驾”的国产全新算力矩阵。
其中,旗舰级M97主打极致性能与高阶上限,面向高端车型与舱驾感知一体场景,原生支撑世界模型、VLA大模型、全场景高阶NOA与L3/L4冗余架构落地,对标行业顶级旗舰算力平台。而主流级M95精准锚定20万级走量家用市场,以均衡的NPU算力、超低延时ISP、硬件预处理CVA与高带宽体系,成为一段式端到端城市NOA规模化下沉的最优解。
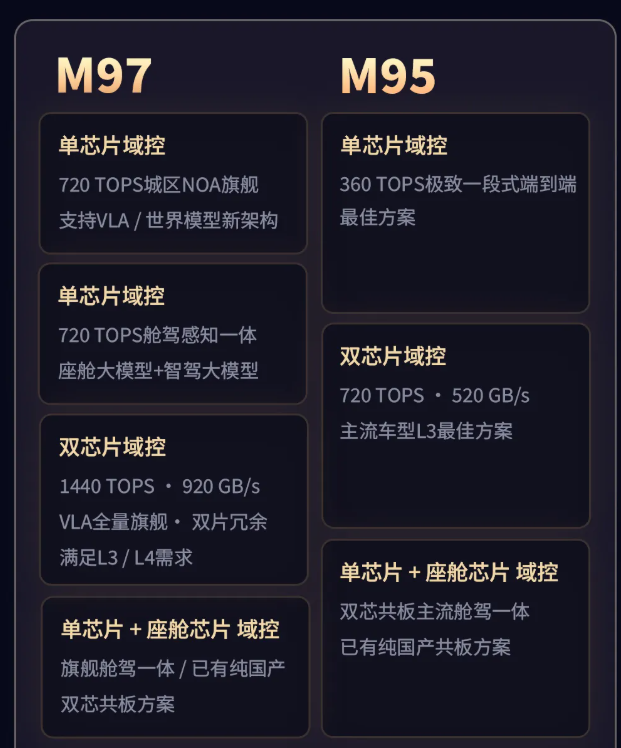
与此同时,M9系列具备极强的硬件拓展能力,可实现多元丰富硬件组合:从单芯片一段式端到端,到双芯冗余L3/L4,再到搭配座舱芯片的双芯共板方案,丰富的硬件组合形态能够全面覆盖主流家用、中高端、旗舰高端等各类车型的差异化需求。该系列芯片的推出,也补齐了国产大模型智驾算力底座,推动VLA、端到端、城区NOA真正走向大规模量产。
更为关键的是,M97与M95双芯共享统一硬件架构与全套开发工具链,车企一套算法资产可无缝迁移、复用至旗舰与主流全系车型,无需多平台重复开发,大幅压缩研发周期、降低迭代成本,在性能、安全、功耗与量产成本之间实现了产业级最优平衡。
在商业模式上,爱芯元智一直坚持Tier2的商业定位,坚持不涉足上层智驾算法业务,专注为车企提供高可靠芯片和全套工具支持。爱芯元智创始人兼董事长仇肖莘博士表示:“我们负责搭好算力台子,让合作伙伴来唱好戏。”这种中立开放的合作模式,完美契合当下车企对标准化、高适配、自主可控的算力底座的核心需求。
当前,城区NOA市场竞争,已经从“功能有无”迈入“体验优劣”的深水区,行业竞争逻辑正在发生根本性颠覆。过去以纸面TOPS论高低的算力内卷已经失效,曾经被忽略的帧率、时延、内存带宽、ISP画质、算力利用率、工具链效率等全链路指标,正在替代单纯算力参数,成为决定大模型智驾落地效果、用户体验上限、车型差异化竞争力的核心变量。
算法决定智驾体验的下限,芯片决定高阶智驾产业的量产上限。当行业不再盲目比拼TOPS,智驾芯片市场竞争将进一步被重塑。依托差异化的产品布局、中立开放的生态理念与成熟稳定的量产能力,爱芯元智有望持续受益于全民高阶智驾的普及红利,在国产算力替代与大模型智驾落地的浪潮中持续突破、潜力无限。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献68条内容

所有评论(0)