吴恩达 MCP 教程(Model Context Protocol)
导读:本文是对吴恩达与 Anthropic 联合推出的 MCP 实战课(共 11 集)的系统性总结,涵盖课程总览、为什么需要 MCP、核心架构、问答机器人示例、创建 MCP 服务器等核心内容。课程由吴恩达与 Anthropic 技术教育负责人 Elie Schoppik 联合讲授,约 100 分钟讲透从原理到部署的完整链路。文中配有可视化速览卡片与可运行的 FastMCP 代码示例,建议读者先浏览速览卡片建立整体认知,再结合代码示例动手实践,可显著提升学习效率。
本文目录:
- 导读
- 第 1 集|课程总览:MCP 模型上下文协议实战课
- 第 2 集|为什么需要 MCP:终结 M×N 集成地狱
- 第 3 集|MCP 架构:Host · Client · Server 三层解剖
- 第 4 集|问答机器人示例:模型点菜、代码炒菜的工具调用循环
- 第 5 集|创建 MCP 服务器:把论文工具搬进公共能力层
李沐深度学习191集课程全解析:模块拆解、学习路径-CSDN博客
吴恩达《面向开发者的提示词工程》-CSDN博客
吴恩达 MCP 教程(Model Context Protocol)-CSDN博客
一句话总结《MCP 模型上下文协议实战课:给 AI 应用装上「USB-C 接口」》
—— 这门由吴恩达与 Anthropic 技术教育负责人 Elie Schoppik 联合讲授的约 100 分钟课程,教你用开放协议 MCP 标准化连接 GitHub、Google Docs、本地文件等工具与数据,从架构原理到服务器 / 客户端开发与部署一次讲透。
详细总结
这是 MCP 首席讲师亲自带练的官方课程,逻辑上分为「是什么 → 怎么用 → 动手建 → 上线」四层递进,上方已生成可视化速览卡片,内容如下:
- 📡 MCP 是什么:一个开放协议,标准化了 LLM 应用获取上下文(工具 + 数据资源)的方式,采用客户端-服务器架构,且模型无关、易于集成到多种应用。它由 Anthropic 于 2024 年 11 月推出并开源,最初是让 Claude 桌面版能读写本地文件系统等外部系统的内部项目。如今生态里已有大量开源服务器可供直接接入。
- 🏗️ 核心架构:MCP 客户端驻留在你的 AI 应用(Host,如聊天机器人、代理或 Claude Desktop)内部,每个客户端与一个 MCP 服务器保持 1 对 1 连接;服务器对外提供三类能力——工具(Tools)、提示模板(Prompts)与资源(Resources)。你的应用无需自己开发定制工具,把代理接到 GitHub、Google Drive、文件系统等服务器即可完成工具执行。
- 💻 课程实战路线(共 11 课):① 简介 / ② 为什么选择 MCP(解决以往连接的痛点)→ ③ 架构原理 → ④ 构建兼容 MCP 的问答机器人、⑤ 创建 MCP 服务器、⑥ 创建 MCP 客户端 → ⑦ 连接引用服务器、⑧ 添加提示与资源 → ⑨ 为 Claude Desktop 配置服务器、⑩ 创建并部署远程服务器、⑪ 总结。
- 🎯 适合人群:想给应用快速接入外部工具的开发者(免于为每个数据源重复造轮子),以及拥有工具/数据、希望被更多开发者复用的团队——这正是吴恩达在片尾强调 MCP 值得学的两个方向。
在线链接:MCP 课程速览:吴恩达 × Anthropic 模型上下文协议 —— 一句话总结 + MCP 核心概念 + 客户端-服务器架构图 + 11 课学习路线,可直接分享。
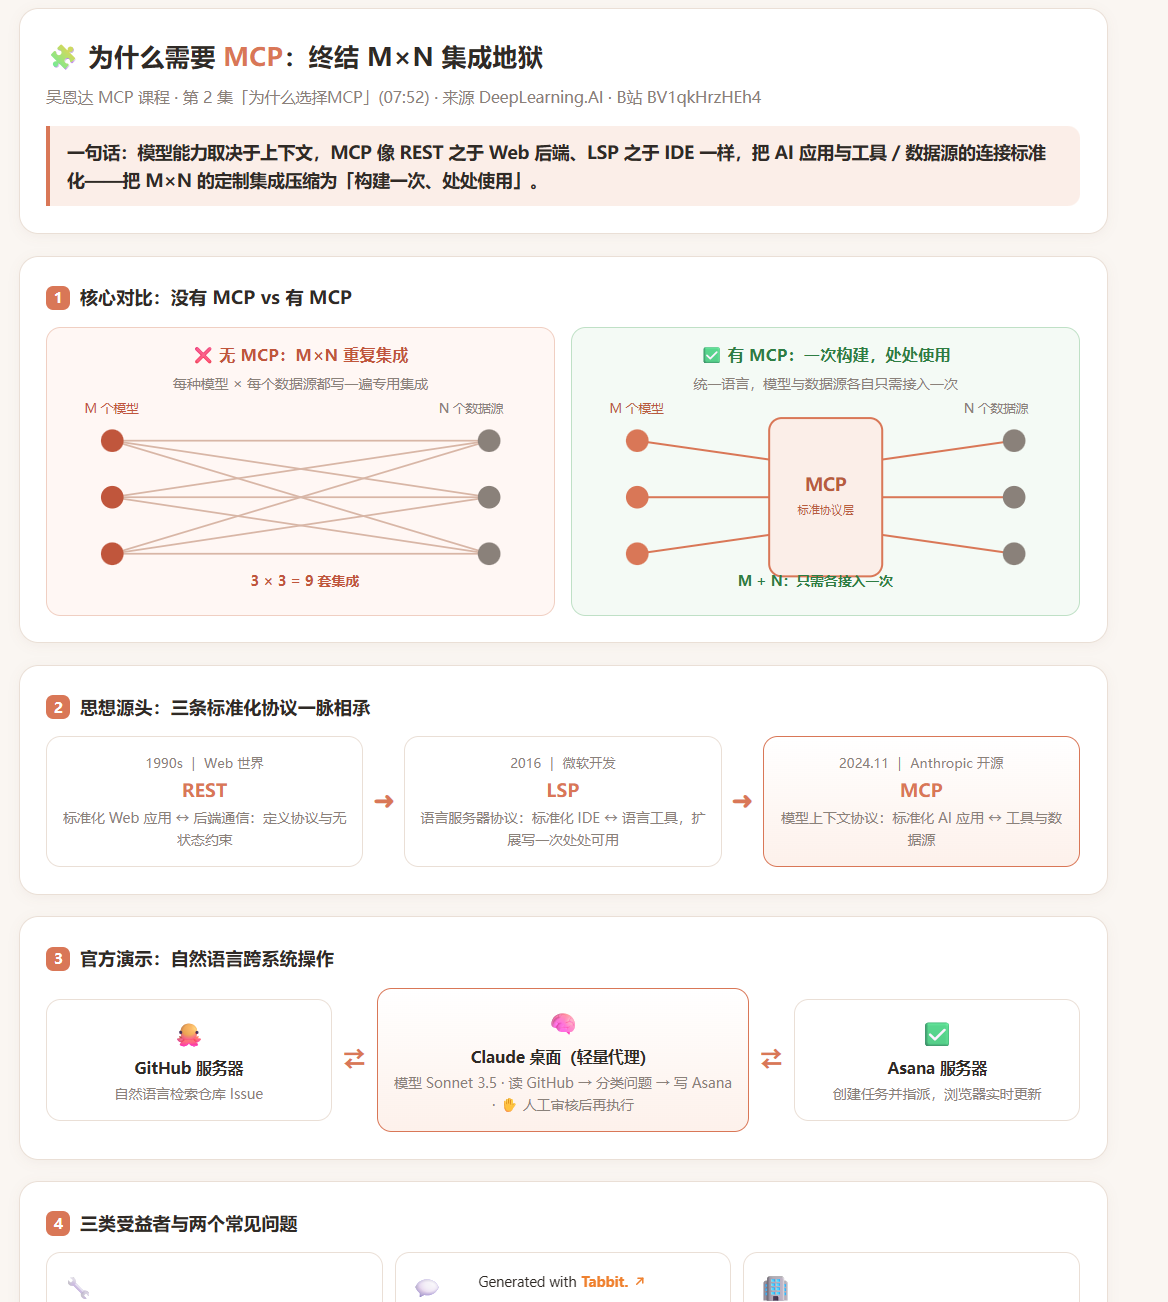
一句话总结《为什么需要 MCP:用「构建一次、处处使用」终结 M×N 集成地狱》
—— 本集指出模型能力取决于上下文,MCP 像 REST 之于 Web 后端、LSP 之于 IDE 一样,把 AI 应用与工具 / 数据源的连接方式标准化,并现场演示了用自然语言「读 GitHub Issue → 分类 → 写入 Asana」的跨系统操作。
详细总结
可视化速览已生成,在线链接:为什么需要 MCP:终结 M×N 集成地狱(第 2 集速览)。以下按「问题 → 类比 → 演示 → 生态 → 受益者 → 常见问题」的顺序展开。
1️⃣ 出发点:模型再强,接不上数据也白搭
Elie 开篇给出本集的底层逻辑:模型的能力取决于为它提供的上下文。即便拥有前沿的「超级智能」模型,如果无法连接外部世界、获取所需的数据和上下文,其实用性也会大打折扣。因此问题不是模型不够聪明,而是 AI 应用与数据源之间的连接方式太碎片化——每个团队都在重复造轮子:工具存哪里、自定义提示模板存哪里、数据访问层与认证逻辑怎么写,不同 AI 应用访问相似数据源却各写一套。
2️⃣ 核心思想:不重新发明轮子,只统一「语言」
MCP 是一个开源协议,标准化了大型语言模型与工具、数据源的连接与协作方式。一个关键澄清是:MCP 能做的所有事,不用 MCP 也能实现——它的价值不在于解锁新能力,而在于统一交互方式。设想一个多种模型与多种数据源相互通信的世界,如果没有统一语言,就是 M×N 的定制集成矩阵(3 个模型 × 3 个数据源 = 9 套集成);有了 MCP,模型与数据源各自只需实现一次,即为 M+N 模式,构建一次、处处使用。可视化卡片里的左右对比图直观展示了这一点。
这一思想并非凭空创新,而是站在前人肩膀上:REST 协议标准化了 Web 应用与后端系统的通信(定义协议与无状态约束);微软 2016 年开发的**语言服务器协议(LSP)**标准化了 IDE 与语言工具的交互——否则每做一种语言的扩展都要为每个开发环境重复编码。MCP 借鉴了这些协议的标准化理念,把同样的思路带进 AI 世界。
3️⃣ 现场演示:几行代码,自然语言跨系统操作
课程演示了一个「读 + 写」的完整链路:左侧是 Claude 桌面应用,通过 MCP 服务器连接 GitHub,用自然语言即时检索仓库 Issue;随后又接入第二个 MCP 服务器(Asana,流行的项目管理工具),把 GitHub 中读到的问题进行分类,在 Asana 中创建工单并指派给特定人员。整个过程从 GitHub「读」、往 Asana「写」,浏览器中的任务列表实时更新,还能继续用自然语言迭代(比如改派负责人)。背后是一个由 Sonnet 3.5 驱动的轻量级代理,配合 MCP 提供的若干工具,且界面中设有人工审核环节——执行前先确认要做的操作。这正是 MCP 的威力:少量代码 + 自然语言 + 人工把关,就能打通外部系统。
4️⃣ 关注点分离与生态现状
MCP 把责任重新划分:应用侧构建或使用「MCP 兼容应用」,服务器侧提供所需的数据访问——数据存储类服务器如 CRM 工具 HubSpot、Salesforce,甚至版本控制系统,都可以用自然语言交互。服务器最美妙之处在于可跨多个应用复用:同一台 Google Drive 服务器,AI 助手、代理、桌面应用都能用,只要它们兼容 MCP。协议本身与模型无关、完全开源,服务器可来自官方参考实现、开源社区或企业内部自建共享。生态正在快速增长:大公司与前沿初创公司均有参与,多语言 SDK 由开源社区开发、多家公司和 AI 开发者共同主导,MCP 兼容应用已覆盖 Web 应用、桌面应用乃至代理类产品。
5️⃣ 对你的三点启示(结合 AI 工程师视角)
- 集成架构选择:当应用要接多个数据源时,优先评估现成 MCP 服务器而非自写 API 层;接入只需提供一个服务器 URL。
- 工程性价比:为团队构建的任何 MCP 服务器都是可复用资产——一次构建,所有 MCP 兼容应用受益,这正是企业「关注点分离」的价值。
- 安全边界:演示中的人工审核提示了一个工程范式——对写操作(创建工单、改数据)保留确认环节,读操作可以放行。
❓ 本集两个常见问题
一是这些服务器(GitHub、Asana、Google Drive 等)由谁编写?答案是任何人都可以:开发者自建、用官方参考服务器或社区采纳版本均可,后续课程将亲手构建多个。二是 MCP 服务器是否就等于 API 调用?可以说它是 API 的封装层或网关——不想直接调 API 时,由 MCP 服务器代劳并用自然语言驱动;但工具使用只是其功能的一部分,服务器还会提供函数与模式(schema),下一集将深入主机、客户端、服务器概念及资源、工具、提示等底层组件。
一句话总结《MCP 架构:Host · Client · Server 三层解剖与一次工具调用的完整旅程》
—— 本集(14:53,全课最长)讲透 MCP 的三层架构:Host 是掌控全局的 AI 应用,Client 是 Host 内部与服务器 1 对 1 连接的通信管理员,Server 对外提供工具、提示、资源;客户端与服务器之间用 JSON-RPC 2.0 通信,本地走 stdio、远程走 HTTP+SSE。
详细总结
可视化已生成并发布,在线链接:MCP 架构:Host · Client · Server 全解析(第 3 集速览)。小说明:B 站该分集字幕未能直接抓取,以下内容依据课程公开课件与 MCP 官方规范整理,与本集「MCP架构」大纲一致。
1️⃣ MCP 三层架构是什么?Host、Client、Server 三种角色
- 🏠 Host(主机) = 你的 AI 应用本体(聊天机器人、Claude Desktop、IDE、代理)。它负责编排一切:决定连接哪些服务器、把哪些工具暴露给模型、权限如何审批——安全与控制的入口。
- 🔌 Client(客户端) = 驻留在 Host 内部的「连接管理器」,每个客户端只与一台服务器保持 1 对 1 连接;接了 3 台服务器就有 3 个客户端。这与第 1 集总览中「hosting 多个客户端」的架构呼应。
- ⚙️ Server(服务器) = 独立进程或远程服务,暴露工具 / 提示 / 资源,模型无关、可跨应用复用。
一个直观类比:Host 像浏览器,Client 像浏览器里的每个标签页连接,Server 就是 Web 服务器——浏览器掌控安全与沙箱,连接各自独立 Kinda Technical。
2️⃣ MCP 用什么协议通信?JSON-RPC 2.0 与两种传输方式
客户端与服务器之间统一使用 JSON-RPC 2.0 消息(请求 / 响应 / 通知)Model Context Protocol。传输层两种模式:stdio(本地:Host 把服务器作为子进程拉起,通过标准输入输出通信,简单高效)与 HTTP + SSE(远程:走 Web 连接,服务器可主动推送消息)。工程上注意:两者连接生命周期不同,本地切远程并非无缝替换,传输层的差异是常见踩坑点。
3️⃣ MCP 服务器三大原语:Tools、Prompts、Resources 谁控制?
- 🛠️ Tools(工具)· 模型控制:LLM 自主决定何时调用,可执行、有副作用(如查 GitHub、写文件)。
- 📝 Prompts(提示)· 用户控制:预置提示模板,由用户主动选用,标准化常见任务。
- 📂 Resources(资源)· 应用控制:文件、数据等上下文材料,由应用决定附加给模型,偏只读。
这个「控制权三角」是 MCP 设计最精髓的区分,直接决定权限模型与交互设计。
4️⃣ 一次工具调用怎么走?五步旅程拆解
① 用户提问,Host 汇总各服务器的工具清单 → ② 模型决策是否调用、调用哪个 → ③ 对应客户端经 JSON-RPC 转发请求 → ④ 服务器真正执行(调 API / 读数据)→ ⑤ 结果回传 Host,模型据此生成最终回答。
🎯 AI 工程师视角的三点启示
为方便快速对照,下面用两张表格分别梳理三层角色与三大原语。
| 角色 | 职责 | 控制权 | 示例 |
|---|---|---|---|
| Host(主机) | AI 应用本体,负责编排一切:决定连接哪些服务器、把哪些工具暴露给模型、权限如何审批 | 安全与控制的入口,掌控全局 | 聊天机器人、Claude Desktop、IDE、代理 |
| Client(客户端) | 驻留在 Host 内部的「连接管理器」,每个客户端与一台服务器保持 1 对 1 连接 | 负责与服务器的通信转发,不直接决定工具暴露 | Host 内与 GitHub 服务器、Asana 服务器分别连接的客户端 |
| Server(服务器) | 独立进程或远程服务,对外暴露工具、提示、资源 | 提供能力清单,模型无关、可跨应用复用 | GitHub 服务器、Google Drive 服务器、arXiv 论文服务器 |
再看三大原语的控制方与用途:
| 原语 | 控制方 | 用途 | 典型场景 |
|---|---|---|---|
| Tools(工具) | 模型控制 | 可执行、有副作用的操作,由 LLM 自主决定何时调用 | 查 GitHub Issue、写文件、创建 Asana 工单 |
| Prompts(提示) | 用户控制 | 预置提示模板,由用户主动选用,标准化常见任务 | 一键生成周报、按固定模板总结论文 |
| Resources(资源) | 应用控制 | 文件、数据等上下文材料,由应用决定附加给模型,偏只读 | 把本地文档、数据库查询结果作为上下文喂给模型 |
权限收敛在 Host 层(写操作务必加人工确认,延续第 2 集演示的安全范式);工具清单随连接数增长会挤占上下文窗口,需管理暴露数量;理解「原语 = 控制权」能帮你快速判断一个功能该做成 Tool、Prompt 还是 Resource。
一句话总结《问答机器人示例:模型点菜、代码炒菜的工具调用循环》
—— 本集先用纯 API(尚未 MCP 化)搭建一个能查 arXiv 论文的聊天机器人:定义 search_papers(搜论文)与 extract_info(提取论文信息)两个工具,模型只负责「决定调用哪个工具 + 给什么参数」,由应用代码执行后回传结果,循环往复直到生成最终回答。
详细总结
可视化已生成并发布,在线链接:问答机器人示例:模型 × 工具协作循环(第 4 集速览)。
1️⃣ 本集任务:怎么搭一个「会用工具」的机器人?
本集进入代码实战部分的第一课。Elie 用 Anthropic 的 Claude API 构建一个命令行聊天机器人,让它能完成超出模型自身知识范围的任务:搜索 arXiv 上的学术论文并提取信息。项目由一个聊天循环 + 两个工具组成:search_papers(按关键词搜论文,返回论文列表与 ID)和 extract_info(按 ID 提取标题、作者、摘要等详情)。工具的核心价值是扩展模型能力、避免幻觉。
2️⃣ 工具使用循环:本集的核心机制
这是理解后面所有 MCP 课程的关键模式:模型收到用户提问后,并不直接执行任何函数,而是返回一个特殊结构(tool_use 块),指明「我要用哪个工具 + 参数是什么」;你的应用代码监测到该结构后真正执行函数,把结果附加到消息历史中再发给模型;模型基于结果生成回答,若还需要更多信息就继续发起工具调用,如此往复,直到模型给出纯文本回复。整个过程就是一个 while 循环,输入 quit 退出。 BibiGPT 课程摘要
3️⃣ 三个关键要点
- 工具定义三要素:每个工具需要清晰的名称、描述和参数模式,模型才能正确理解和调用——描述写得越准,模型调用越可靠。
- 「模型点菜、代码炒菜」:模型与工具的交互是编排式的——模型只输出调用意图,执行权在应用代码手里,这也是所有安全审核(如第 2 集人工确认)能存在的根本原因。
- 无持久记忆:当前机器人每次对话相互独立,上一轮查到的论文 ID 想在下一轮使用,需要手动传递。
4️⃣ 本集定位:MCP 化之前的基线
这版机器人把工具直接「焊」在应用里,换个应用就得重写、无法复用——正是 MCP 要解决的问题。第 5 集「创建MCP服务器」(08:57)将把同样的论文工具搬进 MCP 服务器,工具定义不再属于某一个应用,而是任何 MCP 兼容应用都能调用的公共能力。
一句话总结《创建 MCP 服务器:把论文工具搬进公共能力层》
—— 本集(08:57)把第 4 集「焊」在应用里的 search_papers 与 extract_info 两个工具,迁移进一个独立的 MCP 服务器:工具定义不再属于某一个应用,而是任何 MCP 兼容应用都能调用的公共能力,并用 Claude Desktop 现场验证调用。
详细总结
本集是「动手建」阶段的关键一步,承接第 4 集的基线机器人,演示如何把工具从应用内部抽离成标准化的 MCP 服务器。
1️⃣ 本集任务:把工具从应用里「搬」出来
第 4 集的机器人把 search_papers 和 extract_info 直接写在应用代码里,换个应用就得重写。本集的目标是:把这两个工具封装进一个独立的 MCP 服务器进程,让任何 MCP 兼容应用(Claude Desktop、IDE、代理等)都能直接调用,实现「构建一次、处处使用」。
2️⃣ 服务器骨架:FastMCP 快速搭建
课程使用 Python 的 FastMCP 框架搭建服务器,核心代码非常简洁:创建一个 MCP 服务器实例,用装饰器把普通函数注册为工具,最后启动服务器。工具函数本身与第 4 集几乎一致(调用 arXiv API 搜索论文、按 ID 提取信息),区别在于它们现在暴露在 MCP 协议层,而非某个应用内部。
3️⃣ 关键转变:工具定义与调用方解耦
这是本集最核心的认知升级:工具不再属于应用,而是属于服务器。应用侧只需通过 MCP 客户端连接服务器、获取工具清单,就能像调用本地函数一样使用远程工具。模型看到的工具描述、参数模式都由服务器统一提供,调用方无需关心实现细节。
4️⃣ 验证方式:Claude Desktop 直连调用
课程最后把服务器接入 Claude Desktop,用自然语言直接提问「帮我搜一下最近关于 MCP 的论文」,模型自动触发 search_papers 工具、拿到结果后再调用 extract_info 提取详情,完整复现了第 4 集的工具使用循环——但这次工具来自外部服务器,而非应用内嵌代码。
5️⃣ 本集定位:从「焊死」到「可复用」
下面给出一个完整的 FastMCP 服务器示例,把第 4 集的 search_papers 与 extract_info 两个工具封装进独立服务器,任何 MCP 兼容应用都能直接调用。
from mcp.server.fastmcp import FastMCP
import urllib.request
import urllib.parse
import json
1. 创建 MCP 服务器实例:name 会作为服务器标识暴露给客户端
mcp = FastMCP("arxiv-server")
2. 用 @mcp.tool() 装饰器把普通函数注册为 MCP 工具
函数名、docstring 与类型注解会自动生成工具描述与参数模式
@mcp.tool()
def search_papers(query: str, max_results: int = 5) -> list[dict]:
"""按关键词搜索 arXiv 论文,返回论文列表与 ID。
Args:
    query: 搜索关键词,如 "MCP" 或 "model context protocol"
    max_results: 最多返回的论文条数,默认 5
"""
# 调用 arXiv API:把关键词拼进查询 URL
base = "http://export.arxiv.org/api/query?"
params = urllib.parse.urlencode({
    "search_query": f"all:{query}",
    "max_results": max_results
})
with urllib.request.urlopen(base + params) as resp:
    data = resp.read().decode("utf-8")
用简单字符串解析提取论文 ID 与标题(生产环境建议用 feedparser)
papers = []
for entry in data.split("<entry>")[1:]:
paper_id = entry.split("<id>")[1].split("</id>")[0].strip()
title = entry.split("<title>")[1].split("</title>")[0].strip()
papers.append({"id": paper_id, "title": title})
return papers
3. 第二个工具:按论文 ID 提取标题、作者、摘要等详情
@mcp.tool()
def extract_info(paper_id: str) -> dict:
"""按 arXiv 论文 ID 提取标题、作者与摘要详情。
Args:
paper_id: 论文 ID,例如 "2401.12345"
"""
拼接单篇论文的 API 地址
url = f"http://export.arxiv.org/api/query?id_list={paper_id}"
with urllib.request.urlopen(url) as resp:
data = resp.read().decode("utf-8")
解析标题、作者与摘要
title = data.split("<title>")[1].split("</title>")[0].strip()
authors = [a.split("<name>")[1].split("</name>")[0].strip()
for a in data.split("<author>")[1:]]
summary = data.split("<summary>")[1].split("</summary>")[0].strip()
return {"id": paper_id, "title": title, "authors": authors, "summary": summary}
4. 启动服务器:默认走 stdio 传输,供本地 Host(如 Claude Desktop)拉起
if name == "main":
mcp.run()运行前先安装依赖:pip install mcp。启动后,Claude Desktop 等 Host 即可通过 MCP 客户端连接本服务器,用自然语言触发 search_papers 与 extract_info,实现「构建一次、处处使用」。
对比第 4 集,本集完成了从「应用内嵌工具」到「独立 MCP 服务器」的跃迁:同样的工具,第 4 集只能给一个应用用,第 5 集能被所有 MCP 兼容应用共享。这正是 MCP 的核心价值——工具与数据源的一次构建、处处复用。下一集「创建MCP客户端」将站在应用侧,演示如何连接并使用这类服务器。
第 5 集
MCP 生态对比:MCP 与 REST、LSP、Function Calling
为帮助读者快速建立坐标系,下面用两张表格分别对比 MCP 与 REST、LSP 的定位差异,以及 MCP 与 Function Calling 的能力边界。
| 协议 | 定位 | 标准化对象 | 典型应用场景 |
|---|---|---|---|
| MCP | 标准化 AI 应用与工具、数据源的连接方式,让模型按统一协议获取上下文 | LLM 应用与外部工具 / 数据源之间的交互(工具、提示、资源三类原语) | Claude Desktop 连接 GitHub、Google Drive、arXiv 论文服务器;跨应用复用同一套工具 |
| REST | 标准化 Web 应用与后端系统的通信方式,定义资源与无状态约束 | HTTP 接口的资源表示与操作(GET / POST / PUT / DELETE) | 浏览器 / 移动端调用后端 API、微服务之间的数据交换 |
| LSP | 标准化 IDE 与语言工具的交互,避免为每种语言重复开发编辑器扩展 | 编辑器与语言服务器之间的诊断、补全、跳转等能力协议 | VS Code 等 IDE 接入 Python、TypeScript 等语言的智能提示与错误检查 |
再看 MCP 与 Function Calling 的差异:
| 维度 | MCP | Function Calling |
|---|---|---|
| 本质 | 开放协议,标准化 AI 应用与工具 / 数据源的连接,模型无关、可跨应用复用 | 模型 API 的一种能力:让 LLM 输出调用某个函数的意图与参数 |
| 作用范围 | 覆盖工具、提示、资源三类原语,并定义传输层(stdio / HTTP+SSE)与服务器生命周期 | 仅覆盖「模型决定调用哪个工具 + 给什么参数」这一环,执行仍由应用代码完成 |
| 复用性 | 工具定义属于服务器,任何 MCP 兼容应用都能调用,构建一次、处处使用 | 工具定义通常写死在某个应用里,换个应用就得重写 |
| 典型关系 | 可以理解为 Function Calling 的「协议化 + 服务化」升级:把工具调用从应用内嵌提升为公共能力层 | 是 MCP 化之前的基线骨架,第 4 集问答机器人即用此方式实现 |

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献2条内容

所有评论(0)