农场畜牧目标检测数据集:5类别、15,000张图像 | 目标检测
农场畜牧目标检测数据集:5类别、15,000张图像 | 目标检测
源码数据分享
通过网盘分享的文件:农场畜牧目标检测数据集
链接: https://pan.baidu.com/s/11OMmlNX4K_LbUvGl6xjlzg?pwd=q34s
提取码: q34s
一、引言:畜牧业数字化转型的视觉基础设施
在精准农业与智慧养殖蓬勃发展的时代背景下,畜牧业的数字化转型已成为不可逆转的行业趋势。从传统的人工经验管理到数据驱动的智能决策,计算机视觉技术正在深刻改变畜牧养殖的生产方式和管理模式。通过对畜禽个体的自动识别、精准定位与行为分析,可以实现数量统计、健康监测、异常预警等多项关键功能,从而推动传统养殖模式向自动化、精细化、智能化方向全面转型。
然而,在实际应用中,农场环境复杂多变——光照条件随昼夜更替剧烈变化、动物个体密集分布导致严重遮挡、畜禽姿态变化大且运动不可预测——这些因素对目标检测模型的泛化能力提出了极高要求。因此,构建一个规模充足、场景多样、标注规范的数据集,成为实现高性能畜牧检测模型的核心前提。
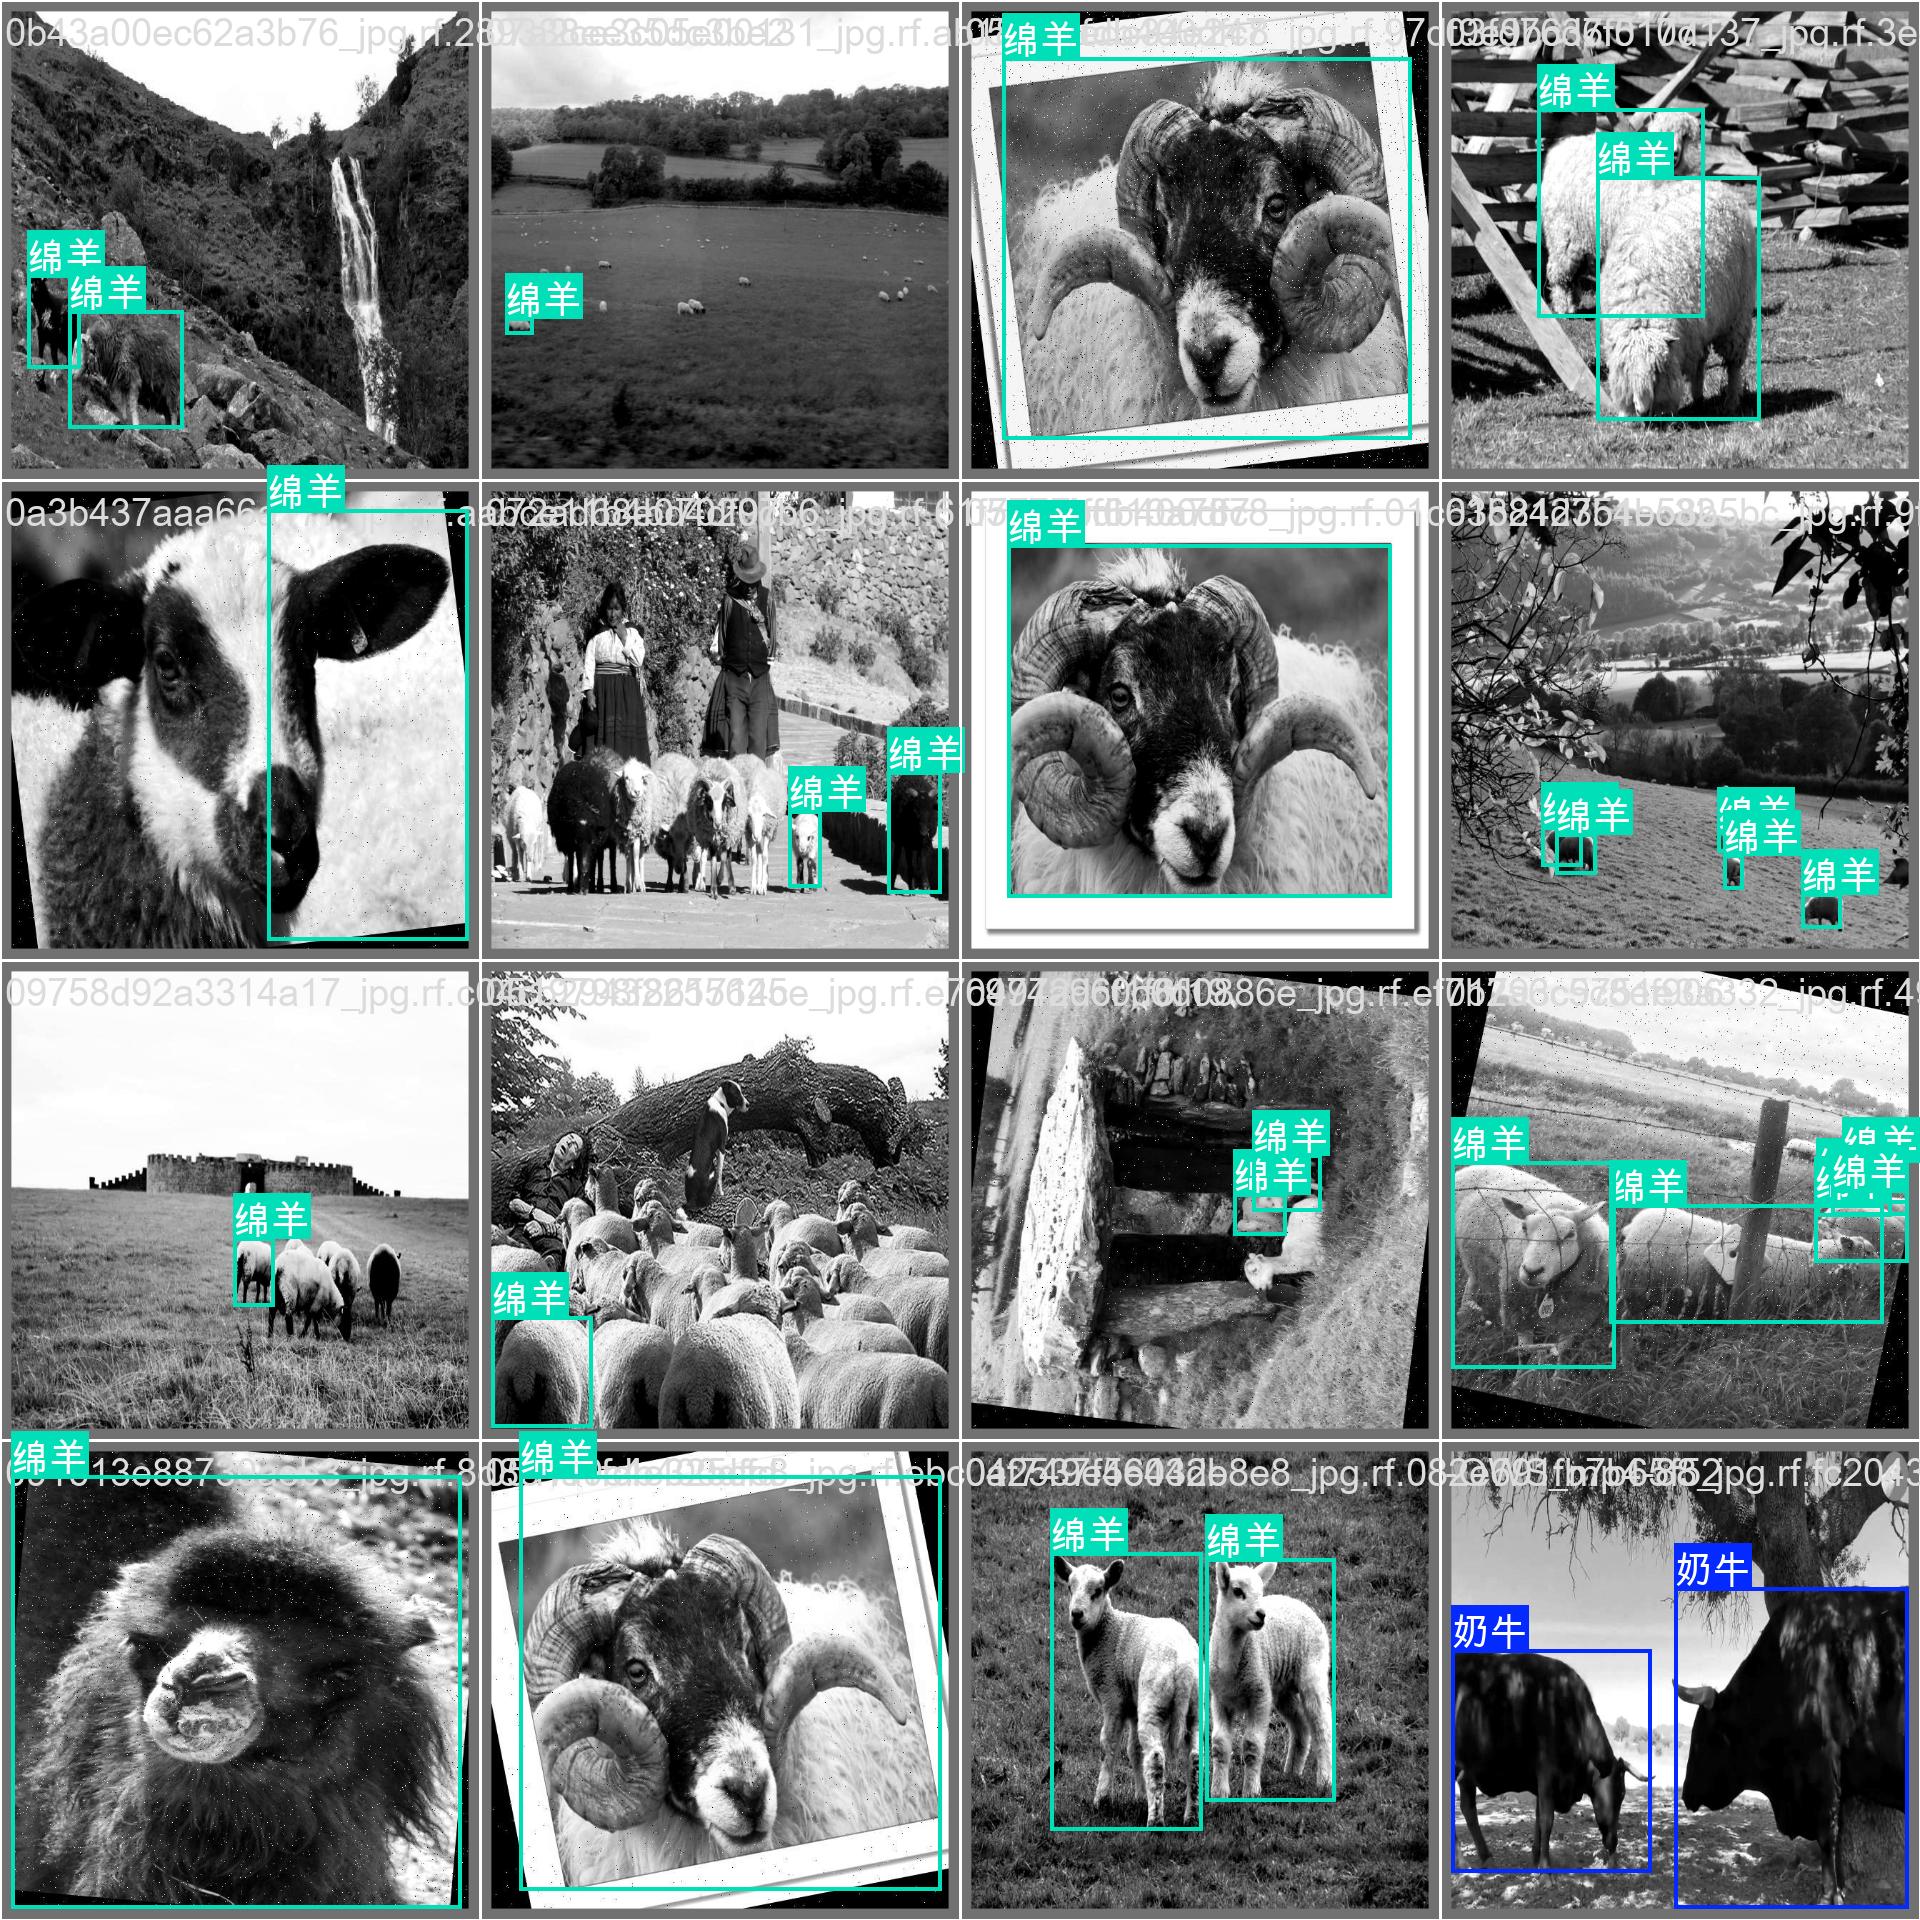
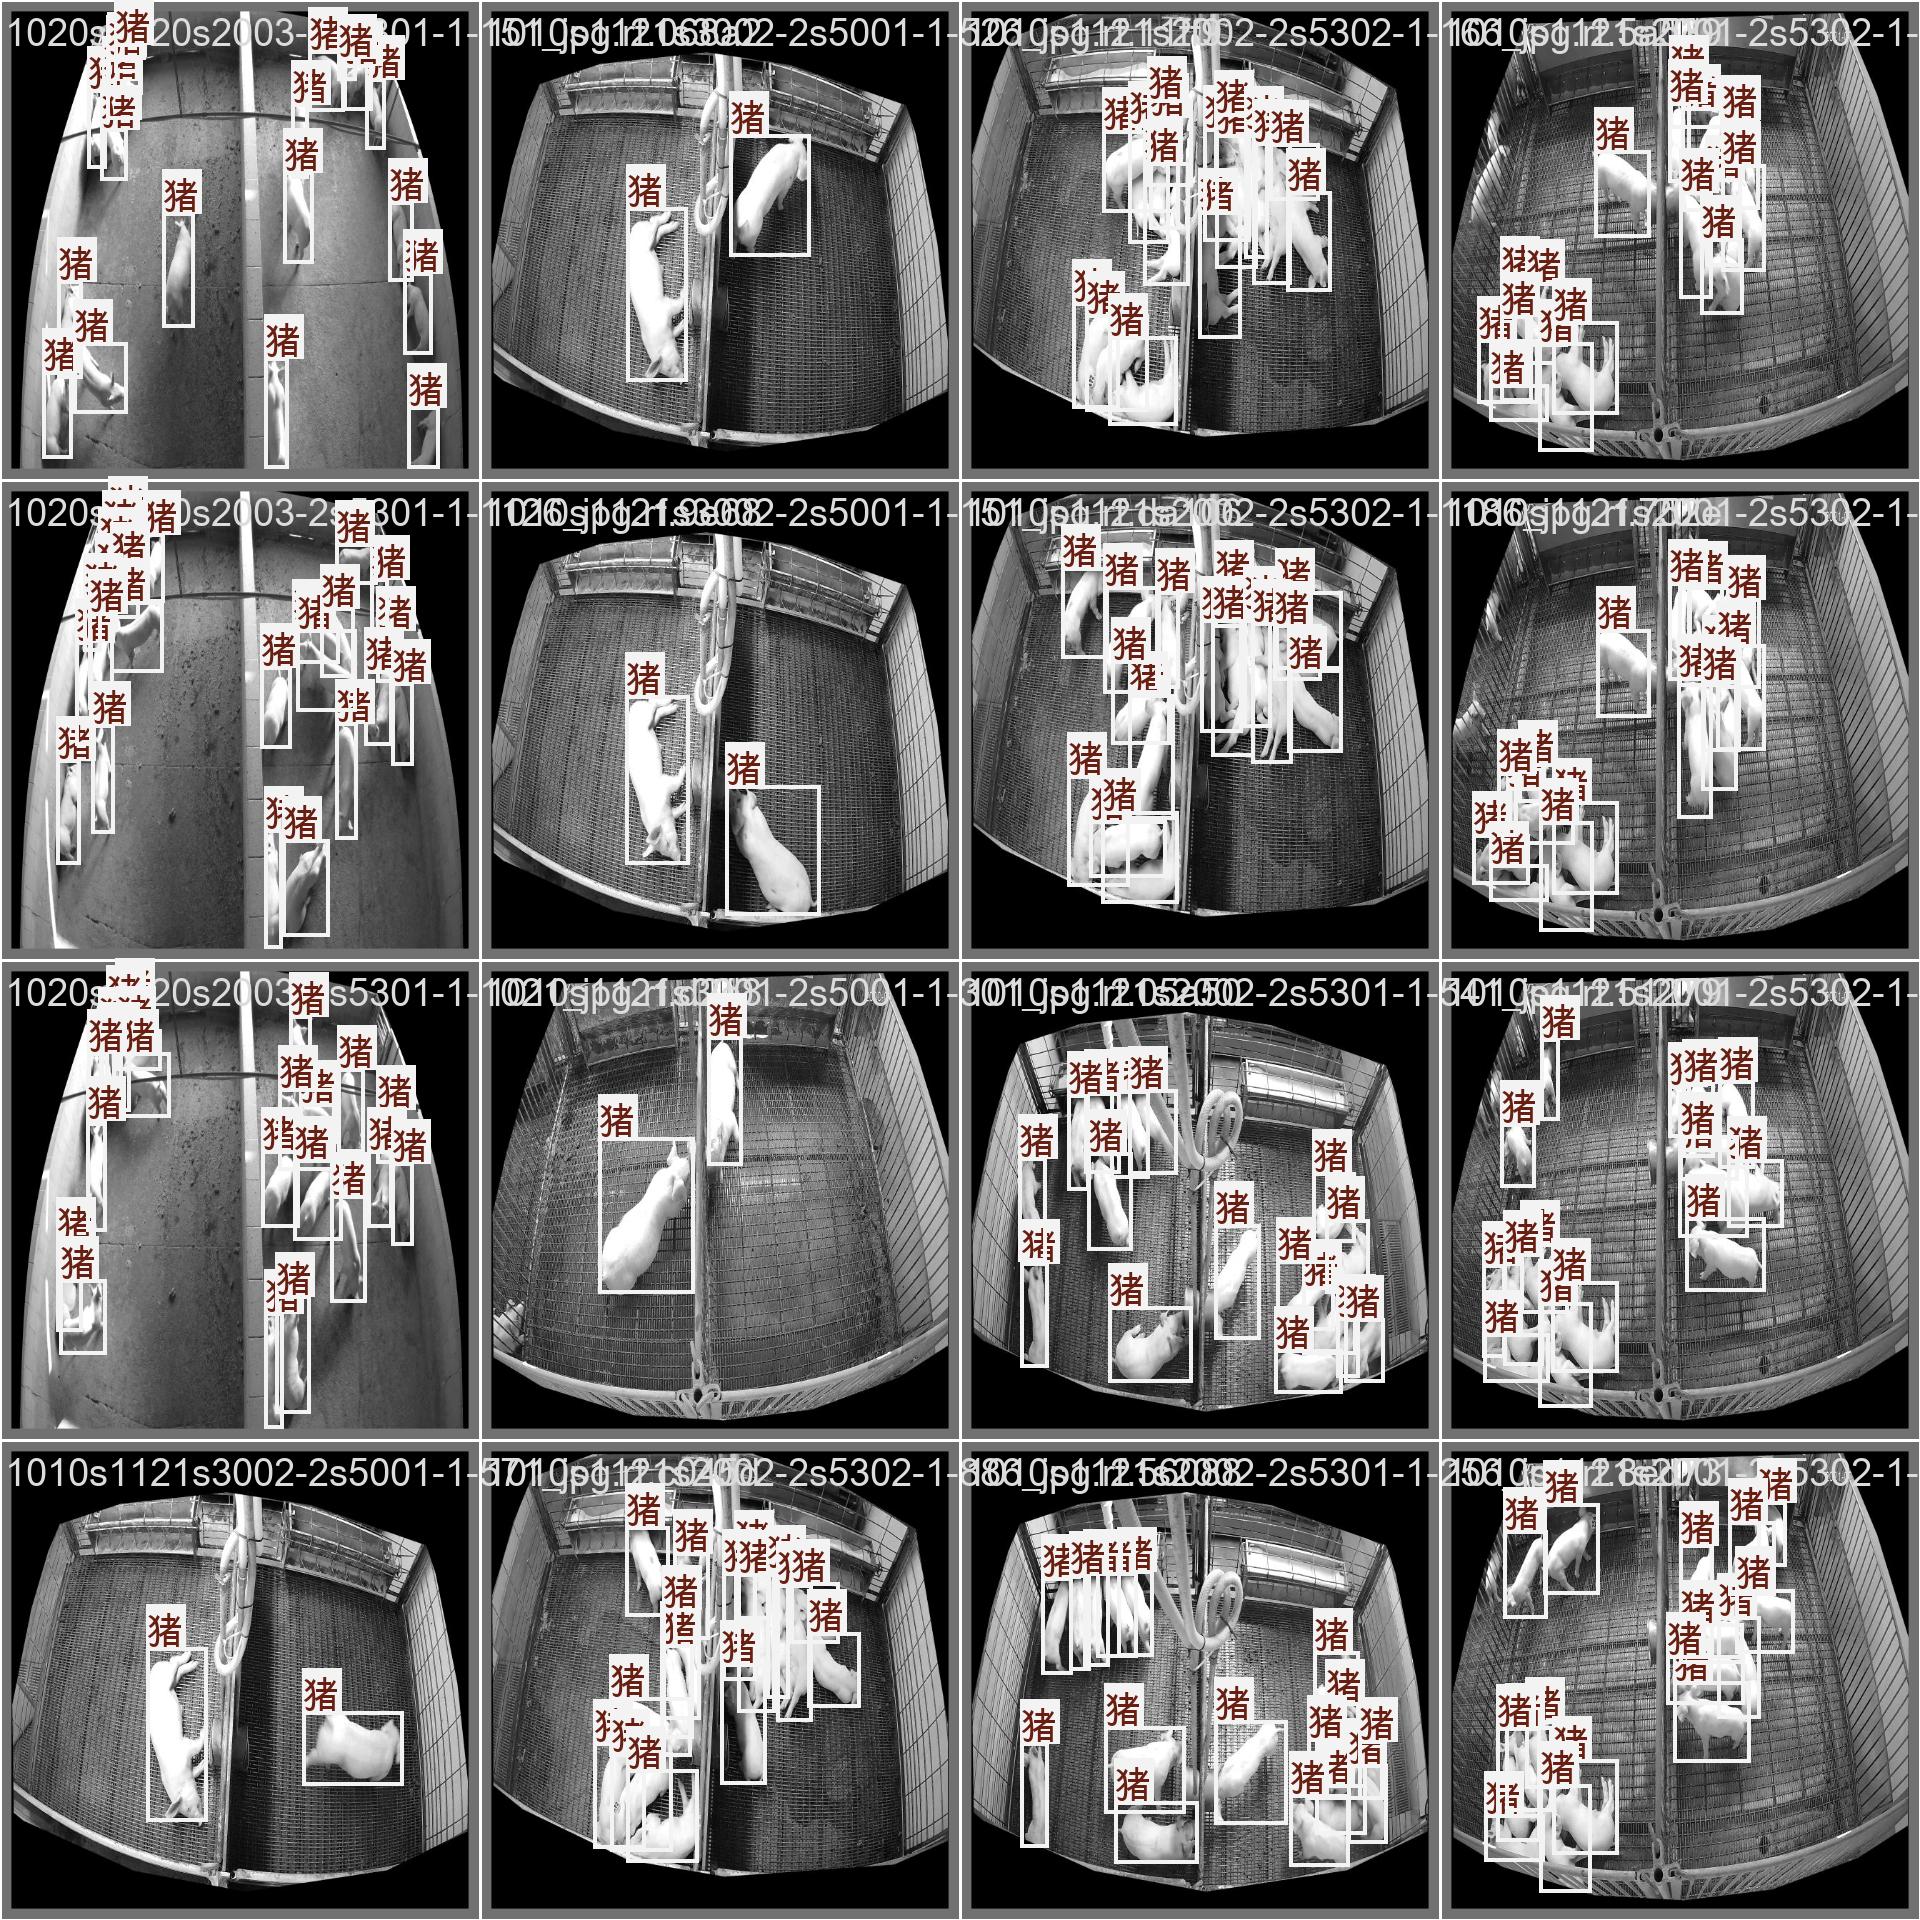
本文将围绕一套农场畜牧目标检测数据集(15000张高质量标注图像),从数据构建、类别设计、标注规范、训练实战到部署落地的全链路进行深度解析,为智慧养殖视觉系统的开发提供完整的技术方案。
二、行业背景:畜牧业的视觉智能化需求
2.1 传统畜牧管理的痛点
在现代畜牧养殖中,传统人工管理方式存在诸多问题:
| 痛点维度 | 具体表现 | 影响程度 |
|---|---|---|
| 效率瓶颈 | 人工统计耗时长、误差大 | 严重影响规模化养殖效率 |
| 实时性差 | 难以实现7×24小时持续监测 | 异常情况发现滞后 |
| 一致性低 | 不同人员判断标准不一 | 管理数据可靠性不足 |
| 精细化不足 | 无法实现个体级别的精准管理 | 养殖决策缺乏数据支撑 |
| 人力成本高 | 需要大量巡检人员 | 运营成本居高不下 |
2.2 视觉智能化的技术价值
基于目标检测的视觉系统可以赋能以下核心能力:
- 自动识别不同畜种:实现牛、马、猪、羊等不同畜牧种类的精准识别
- 实时统计养殖数量:通过视频流实时分析,自动完成牲畜计数
- 监测个体行为与健康状态:通过姿态分析和行为识别,判断动物健康状况
- 支持智能决策:密度调控、异常预警、饲喂优化等数据驱动的管理决策
2.3 畜牧场景的核心挑战
然而,畜牧场景具有以下特殊挑战,使得目标检测难度显著提升:
- 多目标密集分布:圈舍环境下动物紧密聚集,目标重叠严重
- 动物姿态变化大:站立、卧躺、行走、奔跑等多种姿态
- 遮挡严重:动物之间、动物与围栏之间的遮挡频繁发生
- 环境复杂:泥地、草地、围栏、棚舍等多变背景
- 光照变化剧烈:白天强光与夜间弱光的巨大差异
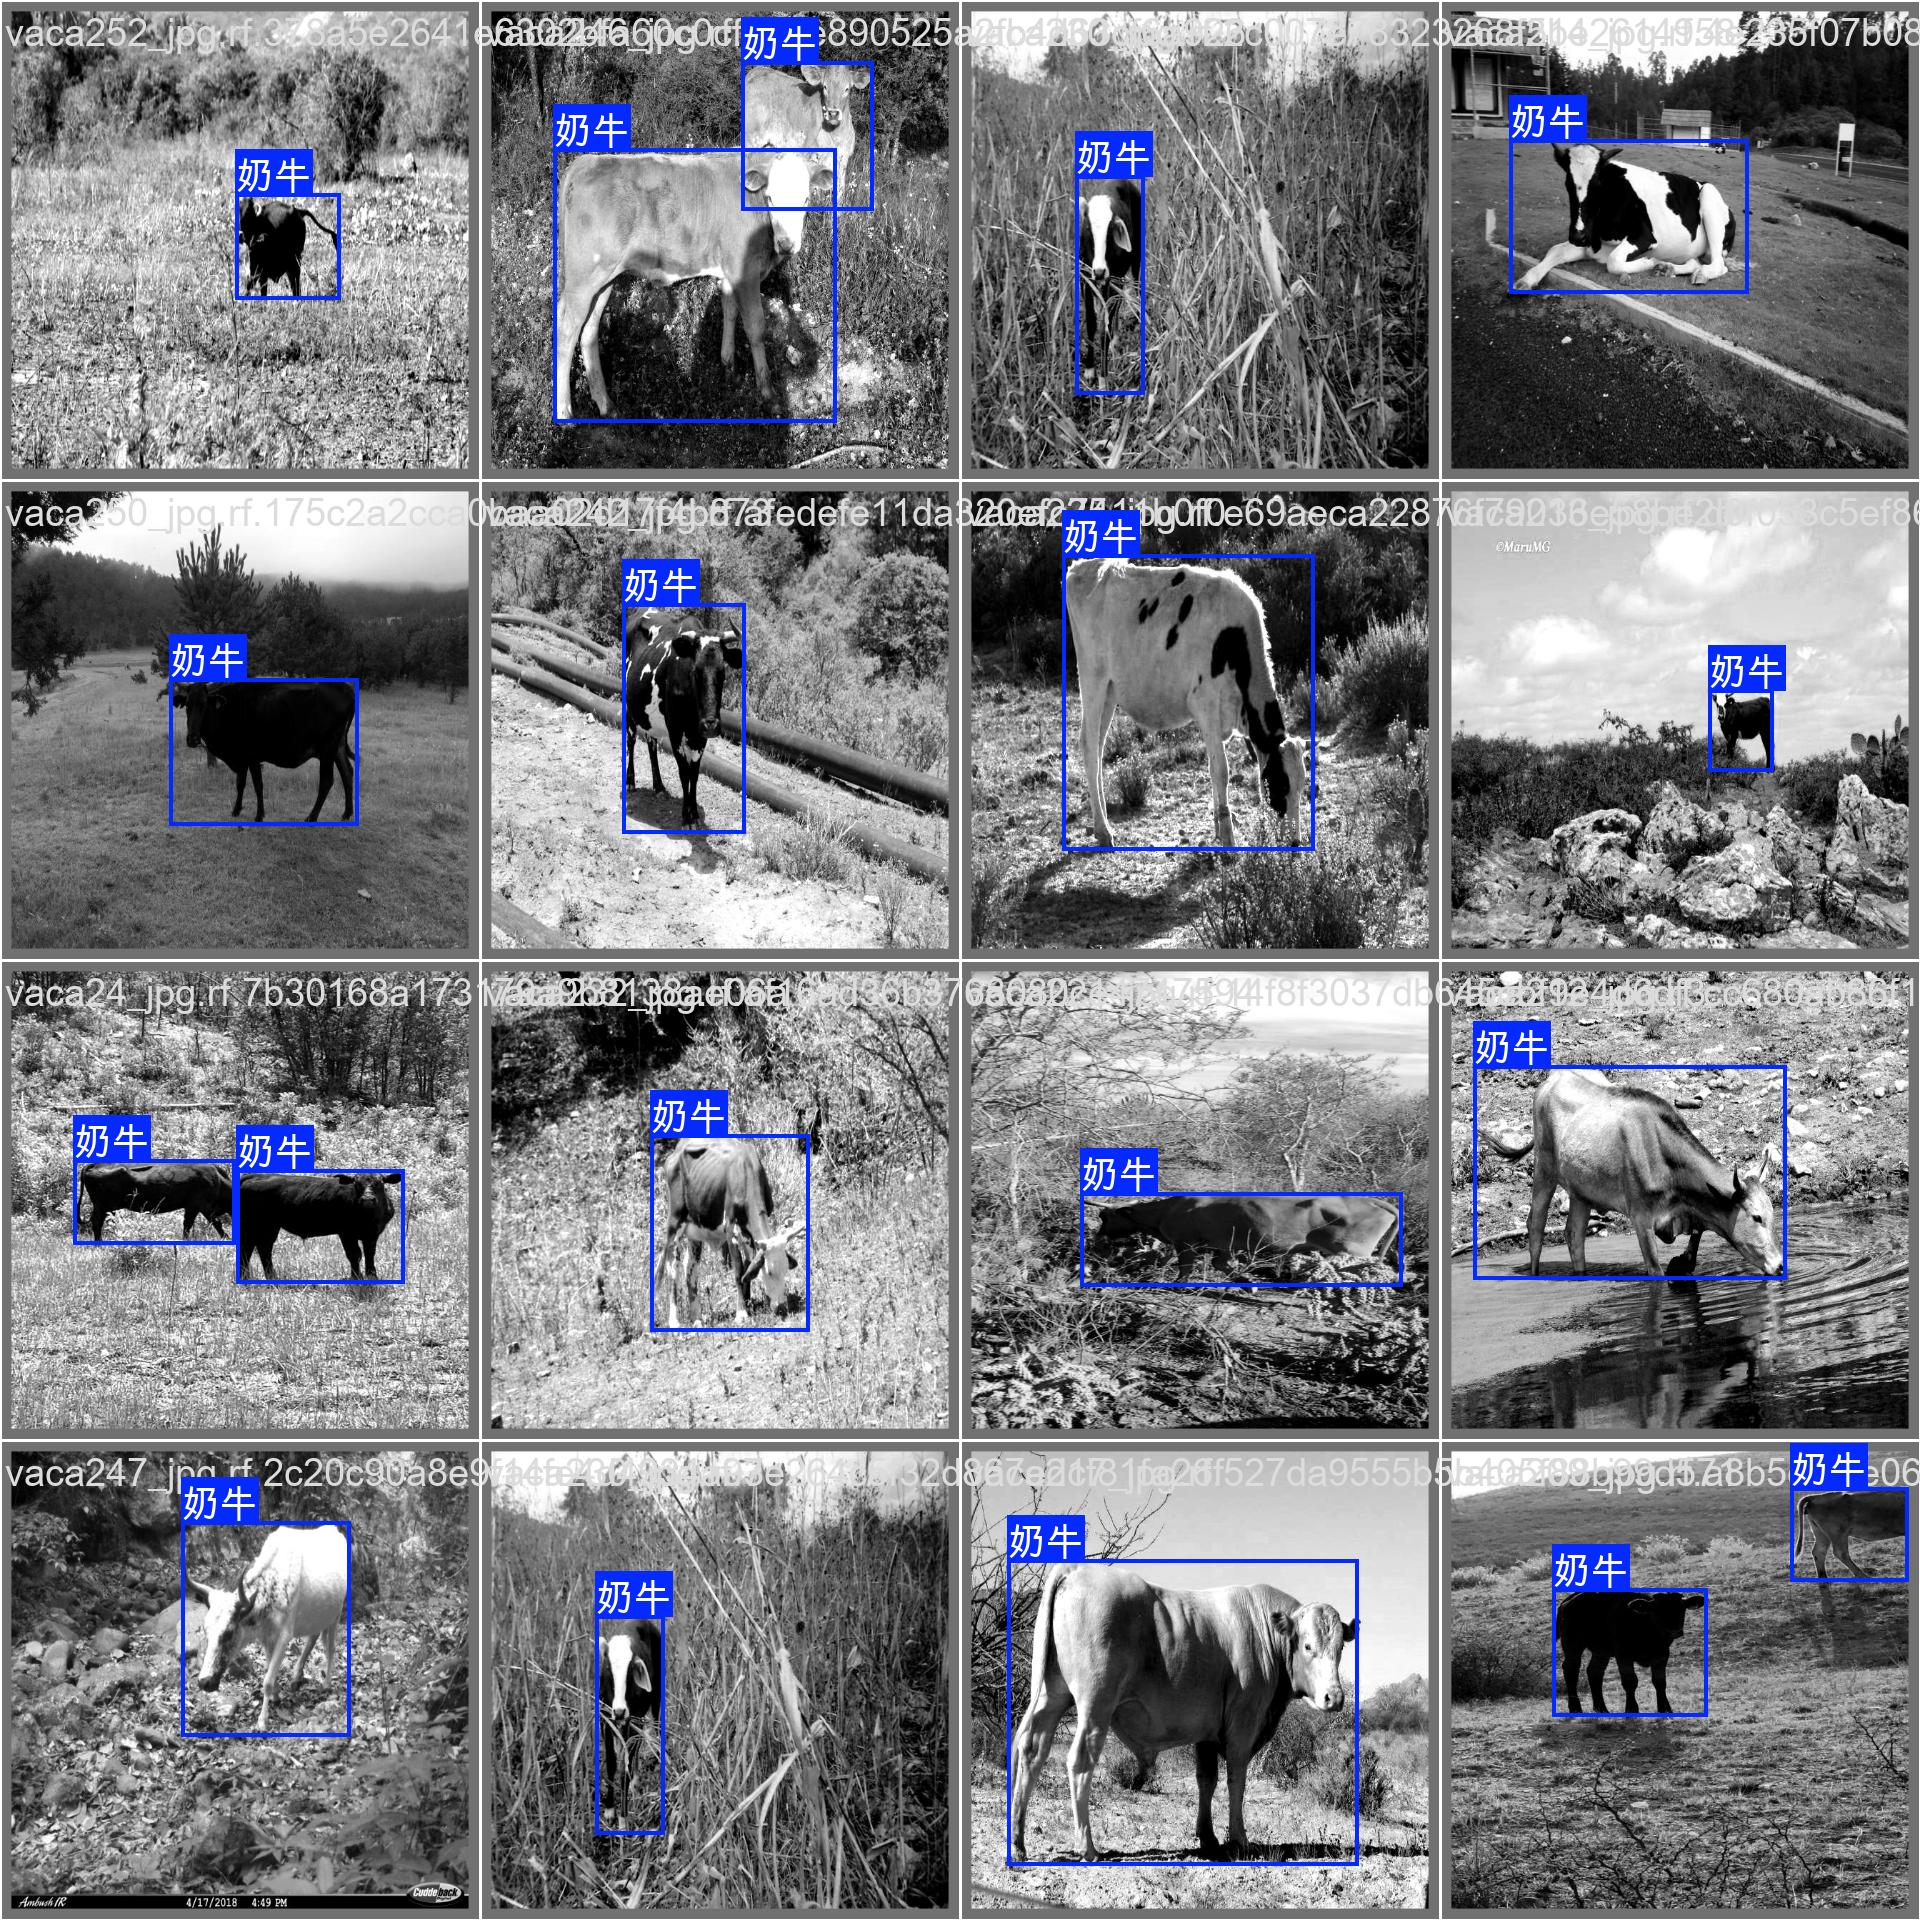
三、数据集全景解析
3.1 核心信息概览
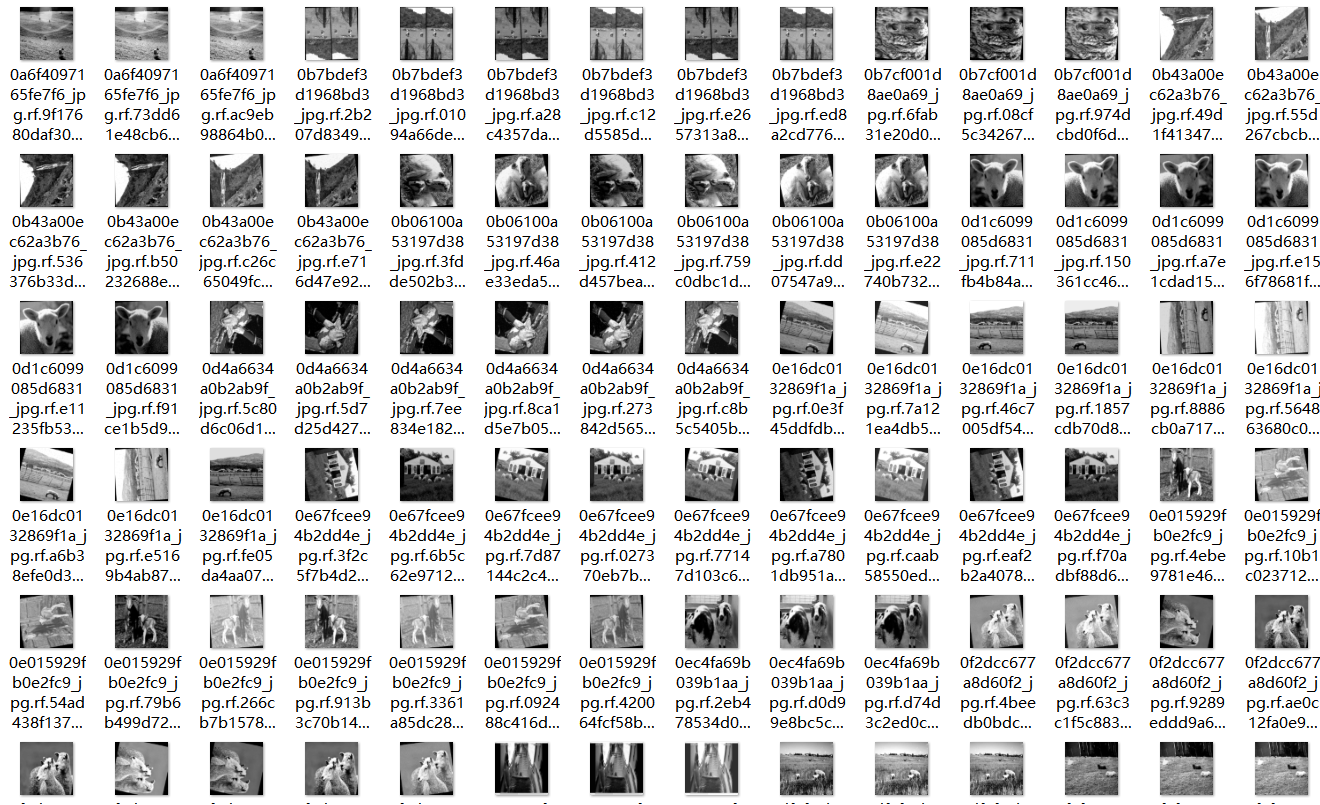
本数据集为农场畜牧目标检测专用数据集,面向多种常见养殖动物的检测与识别任务,提供高质量、标准化的数据支持。
| 参数项 | 详细说明 |
|---|---|
| 数据规模 | 约15000张图像 |
| 标注类型 | 目标检测(Bounding Box) |
| 标注格式 | YOLO标准格式(Ultralytics规范) |
| 类别数量 | 5类(nc = 5) |
| 数据路径 | database/农场畜牧目标检测数据集 |
| 数据划分 | 训练集 / 验证集 / 测试集 |
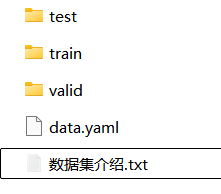
3.2 数据集目录结构
数据集采用标准YOLO目录结构:
database/农场畜牧目标检测数据集/
├── train/images
├── valid/images
├── test/images
图像与标签文件一一对应,标签文件为.txt格式,可直接用于训练。
3.3 类别定义与设计理念
数据集包含5个类别,具体定义如下:
| 类别ID | 类别名称 | 描述 |
|---|---|---|
| 0 | 奶牛 | 常见奶牛个体 |
| 1 | 马 | 农场或牧场中的马 |
| 2 | 猪 | 养殖猪 |
| 3 | 绵羊 | 羊类个体 |
| 4 | 未定义目标 | 其他干扰目标或非核心动物 |
设计理念解析:
"未定义目标"类别是本数据集设计的一大亮点。在实际农场环境中,除了核心畜种外,还可能出现牧羊犬、野生动物、车辆、人员等非核心目标。如果不设置"未定义目标"类别,模型容易将这些干扰物误检为核心畜种,降低检测稳定性。通过引入"未定义目标"类别,模型可以学会将非核心目标归类到该类别,从而有效减少误检,提高整体检测精度和鲁棒性。
四、数据集深度特征分析
4.1 多场景覆盖
数据来源于真实农场环境,包括:
- 露天牧场:大范围放牧场景,目标分布相对稀疏
- 圈舍环境:密集养殖场景,目标高度密集且遮挡严重
两种场景的结合使模型能够适应从稀疏到密集的不同分布情况。
4.2 多条件变化
数据覆盖多种复杂情况:
- 光照变化:白天强光 / 夜间弱光 / 阴天散射光
- 目标密度变化:稀疏分布(放牧场景)/ 密集分布(圈舍场景)
- 拍摄角度差异:正面 / 侧面 / 俯视 / 远距离 / 近距离
这种多样化的条件覆盖有效提升了模型在不同环境下的泛化能力。
4.3 姿态多样性
动物目标包含多种状态:
- 站立:动物静止站立,特征最为完整
- 卧躺:动物躺卧休息,部分身体特征被遮挡
- 行走或移动:动物处于运动状态,姿态变化丰富
多姿态数据的覆盖能够有效提升模型对动态行为的适应能力。
4.4 标注质量保证
- 边界框贴合目标主体
- 标注一致性高
- 多轮人工校验
- 无明显漏标或误标
高质量标注能够显著提升模型训练效果,减少标注噪声对模型学习的干扰。
4.5 标注格式详解
采用YOLO标准格式:
class_id x_center y_center width height
示例:
0 0.45 0.60 0.30 0.40
3 0.70 0.50 0.25 0.35
说明:
- 坐标为归一化值(0~1),与图像分辨率无关
- class_id从0开始,对应类别表中的定义
- 一张图可能包含多个标注框,每个框占一行
五、YOLOv8训练实战
5.1 数据配置文件
path: database/农场畜牧目标检测数据集
train: train/images
val: valid/images
test: test/images

nc: 5
names:
  0: cow
  1: horse
  2: pig
  3: sheep
  4: other
5.2 训练命令
yolo detect train \
  data=livestock.yaml \
  model=yolov8n.pt \
  epochs=150 \
  imgsz=640 \
  batch=16 \
  lr0=0.01 \
  patience=30
5.3 训练参数建议
| 参数 | 推荐值 | 说明 |
|---|---|---|
| model | yolov8n / yolov8s | 轻量化选n,精度优先选s |
| epochs | 150~300 | 根据收敛曲线调整 |
| imgsz | 640 | 标准分辨率 |
| batch | 8~16 | 根据GPU显存调整 |
5.4 训练策略优化
- Mosaic数据增强:有效提升小目标和密集目标的检测能力
- 多尺度训练:增强模型对不同大小目标的适应能力
- 学习率策略:推荐Cosine退火策略,训练更稳定
- Early Stopping:设置patience参数防止过拟合
- 类别加权:针对类别不平衡问题,可使用类别权重或Focal Loss
六、实践中的核心问题与解决方案
6.1 多目标密集检测问题
在拥挤场景中,动物目标密集分布,容易出现目标重叠和漏检。
解决方案:
- 调整NMS的IoU阈值,降低抑制力度(如从0.45降至0.35)
- 使用更强模型(YOLOv8s或YOLOv8m)
- 增加密集场景的训练样本比例
- 使用Soft-NMS替代标准NMS
6.2 类别不平衡问题
不同畜种数量可能差异较大,如奶牛样本可能远多于马或绵羊。
解决方案:
- 使用类别权重(Class Weight),为少数类赋予更高权重
- 对少数类进行过采样或针对性数据增强
- 使用Focal Loss替代标准交叉熵损失
6.3 小目标检测问题
远距离拍摄时,动物目标较小,检测难度显著增加。
解决方案:
- 提高输入分辨率(768或1024)
- 使用多尺度训练策略
- 引入FPN/BiFPN等特征融合结构
- 针对小目标增加切片增强策略
6.4 干扰目标处理
"未定义目标"类别的设计是处理干扰目标的有效手段。建议在训练中保留该类别,使模型能够学会将非核心目标归类到"其他"类别,而非误检为核心畜种。
6.5 模型部署建议
- 导出ONNX / TensorRT模型以加速推理
- 部署至边缘设备(如NVIDIA Jetson系列)或服务器
- 接入RTSP视频流实现实时检测
- 结合追踪算法(如DeepSORT)实现个体追踪与计数
七、适用场景全面解析
7.1 智慧养殖系统
- 畜禽自动识别与分类
- 实时数量统计与密度监测
- 异常行为预警(如离群、打斗等)
7.2 行为分析系统
- 活动状态分析(站立/卧躺/运动的时间分布)
- 异常行为检测(如跛行、嗜睡等)
- 健康状况评估(通过行为模式变化判断)
7.3 农业数字化管理
- 数据化养殖管理平台
- 决策支持系统(饲喂优化、密度调控)
- 提升养殖效率与经济效益
7.4 科研与教学
- 目标检测算法研究与对比
- 多类别检测实验
- 农业AI项目实践与教学
八、从数据到系统:工程落地的关键思考
8.1 数据规模的工程价值
15000张图像的规模在畜牧检测领域属于中大型数据集,具备以下工程价值:
- 足够的样本多样性:覆盖多种畜种、姿态、场景
- 可靠的统计意义:训练和评估结果具有统计可信度
- 工程落地的数据基础:满足实际系统部署的精度要求
8.2 标注质量对模型的影响
从工程角度出发,标注质量对模型性能的影响远超数据规模:
- 精准标注可以显著减少训练噪声
- 一致的标注规范有利于模型收敛
- 漏标和误标会直接降低模型精度
- 多轮审核机制是保证标注质量的关键
8.3 从检测到系统的扩展路径
一个完整的智慧畜牧系统不仅需要目标检测,还需要:
目标检测(本数据集核心)
    ↓
目标追踪(个体ID关联)
    ↓
行为分析(姿态识别 + 时序分析)
    ↓
决策支持(数据汇总 + 规则引擎)
    ↓
执行控制(自动饲喂 + 环境调控)
九、未来展望
随着AI技术在畜牧领域的深入应用,数据集和模型的发展将呈现以下趋势:
- 更大规模:从万量级扩展至十万甚至百万量级
- 更细粒度:从种类识别延伸至个体识别和健康评估
- 多模态融合:结合可见光、红外热成像、声音等多模态数据
- 时序信息整合:从单帧检测到视频级行为分析
- 边缘智能:轻量化模型在嵌入式设备上的实时推理
本数据集能够为智慧养殖与农业AI领域提供可靠的数据支撑,具有较高的应用价值。在实际使用中,建议结合具体业务需求对数据进行扩展与细化(如增加行为标签),进一步提升模型在复杂农场环境中的表现能力,推动畜牧养殖向智能化方向发展。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 4
 0
- 0


 已为社区贡献44条内容

所有评论(0)