第32篇:MyBatis进阶:动态SQL+分页+缓存,优化数据库操作
在Java后端开发中,MyBatis作为一款优秀的持久层框架,凭借其灵活的SQL定制能力和高效的数据库交互性能,成为了开发人员的首选工具。但在实际项目开发中,单纯的基础CRUD操作远不能满足业务需求,我们需要借助动态SQL、分页查询、缓存机制等进阶特性,进一步优化数据库操作,提升系统性能和开发效率。本文将从核心进阶特性入手,结合实战案例,详细解析MyBatis优化技巧,同时补充注解开发和MyBatis-Plus入门知识,帮助大家全面掌握MyBatis进阶用法。
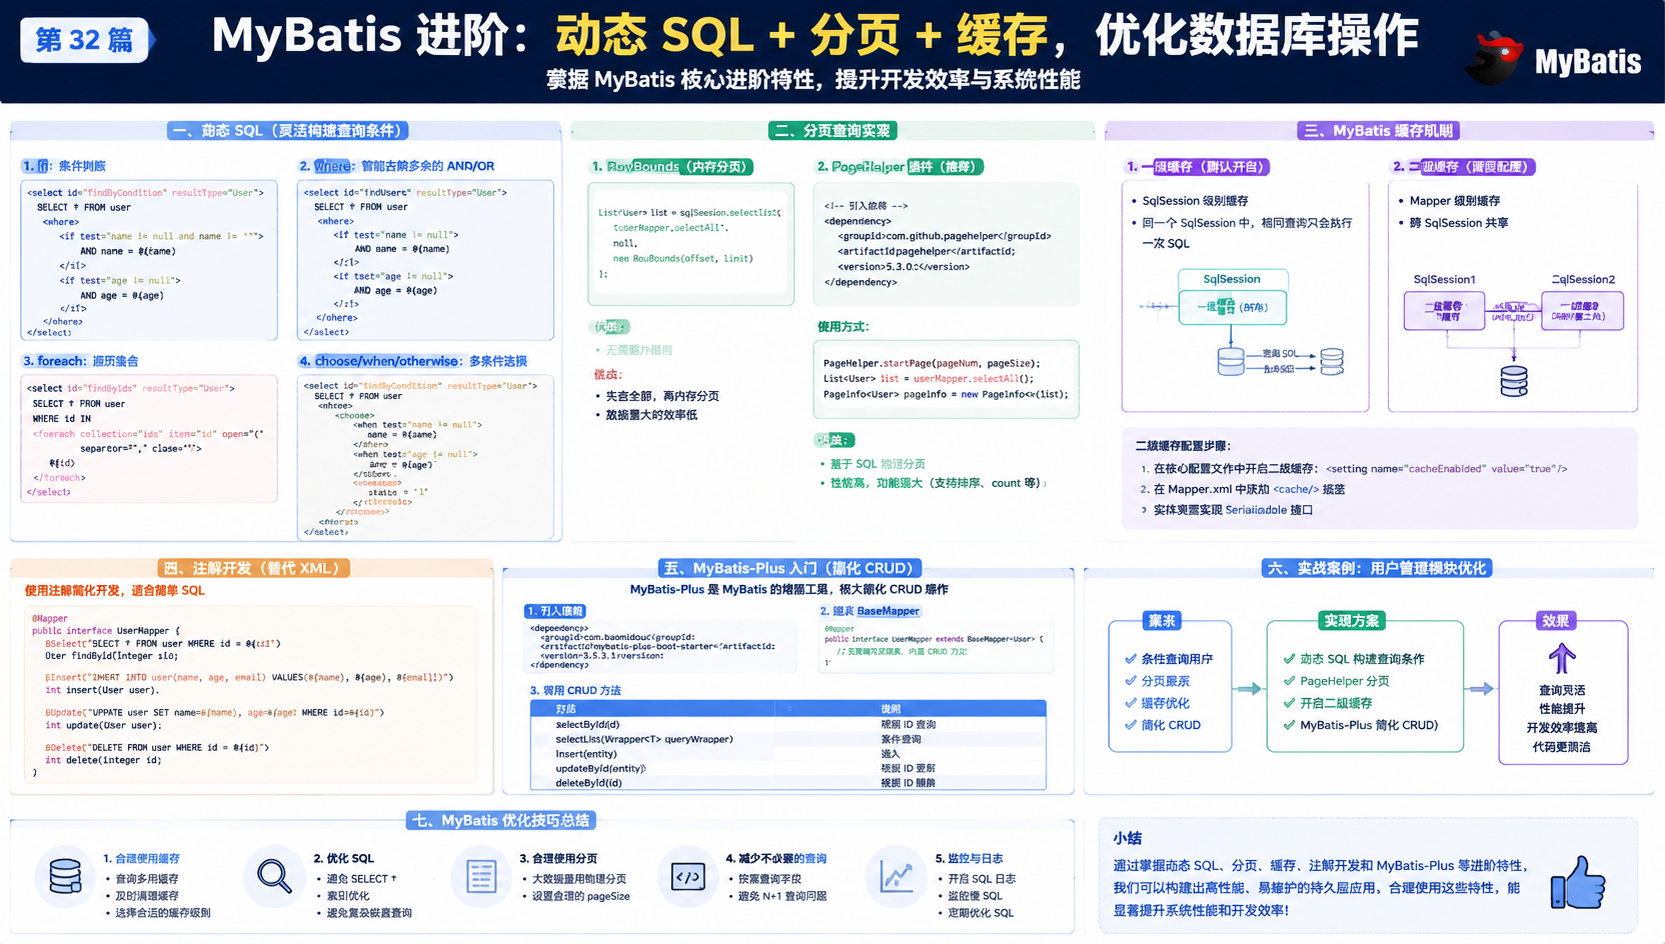
一、动态SQL:灵活拼接SQL,适配复杂业务场景
动态SQL是MyBatis的核心亮点之一,它允许我们根据不同的业务条件,动态拼接SQL语句,避免了编写大量重复、冗余的SQL代码。MyBatis提供了多种动态SQL标签,常用的有if、where、foreach、choose等,下面结合实战案例逐一讲解。
1. if标签:单条件判断,按需拼接SQL
if标签是最基础的动态SQL标签,用于根据条件判断是否拼接某段SQL语句。常用于多条件查询、动态更新等场景,核心属性是test,用于指定判断条件(使用OGNL表达式)。
实战案例:根据用户姓名和年龄查询用户信息,姓名和年龄为可选条件,若参数为空则不参与查询。
<!-- UserMapper.xml -->
<mapper namespace="com.example.mapper.UserMapper">
    <select id="selectUserByCondition" resultType="com.example.entity.User">
        SELECT id, username, age, email FROM t_user
        WHERE 1=1
        <!-- 判断姓名是否为空,不为空则拼接姓名查询条件 -->
        <if test="username != null and username != ''">
            AND username LIKE CONCAT('%', #{username}, '%')
        </if>
        <!-- 判断年龄是否为空,不为空则拼接年龄查询条件 -->
        <if test="age != null">
            AND age = #{age}
        </if>
    </select>
</mapper>
注意:使用if标签时,通常会在WHERE后添加“1=1”作为基础条件,避免因所有if条件都不满足,导致拼接出“WHERE”后无内容的语法错误。
2. where标签:自动处理多余的AND/OR,简化条件拼接
where标签可以替代手动添加的“1=1”,它会自动判断内部拼接的SQL片段,若有内容则自动添加WHERE关键字,同时去除开头多余的AND或OR,避免SQL语法错误。
改造上述案例,使用where标签优化:
<select id="selectUserByCondition" resultType="com.example.entity.User">
    SELECT id, username, age, email FROM t_user
    <where>
        <if test="username != null and username != ''">
            AND username LIKE CONCAT('%', #{username}, '%')
        </if>
        <if test="age != null">
            AND age = #{age}
        </if>
    </where>
</select>
此时,若两个条件都为空,SQL语句会自动变为“SELECT id, username, age, email FROM t_user”,无多余的WHERE关键字;若有一个条件满足,会自动去除条件前的AND,拼接正确的SQL。
3. foreach标签:遍历集合,实现批量操作
foreach标签用于遍历集合(List、Set、Map等),常用于批量查询、批量插入、批量删除等场景。核心属性包括:collection(指定要遍历的集合)、item(遍历的元素别名)、index(索引别名,可选)、open(拼接的开头字符)、close(拼接的结尾字符)、separator(元素之间的分隔符)。
实战案例1:批量查询用户(根据用户ID集合)
<select id="selectUserByIds" resultType="com.example.entity.User">
    SELECT id, username, age, email FROM t_user
    <where>
        id IN
        <foreach collection="ids" item="id" open="(" close=")" separator=",">
            #{id}
        </foreach>
    </where>
</select>
对应的Mapper接口方法:
List<User> selectUserByIds(@Param("ids") List<Long> ids);
实战案例2:批量插入用户
<insert id="batchInsertUser">
    INSERT INTO t_user (username, age, email) VALUES
    <foreach collection="users" item="user" separator=",">
        (#{user.username}, #{user.age}, #{user.email})
    </foreach>
</insert>
对应的Mapper接口方法:
int batchInsertUser(@Param("users") List<User> users);
4. choose标签:多条件分支,类似Java中的switch-case
choose标签用于实现多条件分支判断,它包含when和otherwise子标签:when标签用于指定满足的条件,otherwise标签用于指定所有when条件都不满足时的默认操作。常用于“优先按某条件查询,若不满足则按另一条件查询”的场景。
实战案例:优先按用户ID查询,若ID为空则按姓名查询,若姓名也为空则查询所有用户
<select id="selectUserByChoose" resultType="com.example.entity.User">
    SELECT id, username, age, email FROM t_user
    <where>
        <choose>
            <when test="id != null">
                AND id = #{id}
            </when>
            <when test="username != null and username != ''">
                AND username LIKE CONCAT('%', #{username}, '%')
            </when>
            <otherwise>
                AND 1=1
            </otherwise>
        </choose>
    </where>
</select>
二、分页查询:高效处理大量数据,提升查询性能
在实际项目中,数据库中的数据量往往较大,若一次性查询所有数据,会导致内存占用过高、查询速度变慢,甚至引发系统异常。此时,分页查询就显得尤为重要。MyBatis实现分页的方式主要有两种:原生RowBounds和PageHelper插件,其中PageHelper插件因使用简单、功能强大,成为主流选择。
1. 原生RowBounds:简单分页,无需修改SQL
RowBounds是MyBatis提供的原生分页方式,它通过在查询时指定起始行和查询条数,实现分页效果,无需修改SQL语句。但需要注意的是,RowBounds是基于内存分页(即先查询所有数据,再在内存中截取),数据量较大时性能较差,仅适用于小数据量场景。
实战案例:使用RowBounds实现分页查询用户列表
第一步:编写Mapper接口和XML查询语句(无需添加分页条件)
// Mapper接口
List<User> selectAllUser();
二步:在Service层使用RowBounds实现分页
@Service
public class UserServiceImpl implements UserService {
    @Autowired
    private UserMapper userMapper;

    @Override
    public List<User> selectUserByPage(int pageNum, int pageSize) {
        // pageNum:页码,pageSize:每页条数;起始行 = (页码-1)*每页条数
        int offset = (pageNum - 1) * pageSize;
        RowBounds rowBounds = new RowBounds(offset, pageSize);
        // 使用SqlSession调用查询方法,传入RowBounds
        return userMapper.selectAllUser(rowBounds);
    }
}
2. PageHelper插件:物理分页,高效适配大量数据
PageHelper是一款基于MyBatis的分页插件,它采用物理分页(即通过在SQL语句后添加LIMIT子句,直接从数据库中查询分页数据),性能远优于原生RowBounds,同时支持多种数据库(MySQL、Oracle、SQL Server等),使用简单、配置方便。
实战案例:使用PageHelper实现分页查询
第一步:引入PageHelper依赖(Maven)
<dependency>
    <groupId>com.github.pagehelper</groupId>
    <artifactId>pagehelper-spring-boot-starter</artifactId>
    <version>1.4.6</version>
</dependency>
第二步:配置PageHelper(Spring Boot项目可省略,默认配置即可,如需自定义可在application.yml中配置)
pagehelper:
  helper-dialect: mysql # 指定数据库方言
  reasonable: true # 分页合理化,页码小于1时查第一页,大于总页数时查最后一页
  support-methods-arguments: true # 支持通过Mapper接口参数传递分页参数
第三步:在Service层使用PageHelper实现分页
@Service
public class UserServiceImpl implements UserService {
    @Autowired
    private UserMapper userMapper;

    @Override
    public PageInfo<User> selectUserByPage(int pageNum, int pageSize) {
        // 开启分页,紧跟在该方法后的第一个查询会自动分页
        PageHelper.startPage(pageNum, pageSize);
        // 查询所有用户(会自动添加分页条件)
        List<User> userList = userMapper.selectAllUser();
        // 封装分页结果,包含总条数、总页数、当前页数据等信息
        PageInfo<User> pageInfo = new PageInfo<>(userList);
        return pageInfo;
    }
}
PageInfo封装了丰富的分页信息,常用属性有:total(总记录数)、pages(总页数)、list(当前页数据)、pageNum(当前页码)、pageSize(每页条数)等,可直接返回给前端使用。
三、MyBatis缓存机制:减少数据库查询,提升响应速度
缓存是提升系统性能的重要手段,MyBatis提供了一级缓存和二级缓存,通过缓存查询结果,避免重复查询数据库,从而减少数据库压力,提升系统响应速度。
1. 一级缓存:SqlSession级别的缓存,默认开启
一级缓存也称为本地缓存,是SqlSession级别的缓存,每个SqlSession都有自己的一级缓存,不同SqlSession之间的缓存相互独立。一级缓存的工作机制是:当通过SqlSession执行查询操作时,MyBatis会先从一级缓存中查询,若存在则直接返回结果;若不存在则查询数据库,并将结果存入一级缓存。当执行增、删、改操作或关闭SqlSession时,一级缓存会被清空。
实战案例:验证一级缓存效果
@Test
public void testFirstLevelCache() {
    // 获取第一个SqlSession
    try (SqlSession session1 = MyBatisUtil.getSqlSession()) {
        UserMapper mapper1 = session1.getMapper(UserMapper.class);
        // 第一次查询,从数据库获取数据,并存入一级缓存
        User user1 = mapper1.selectUserById(1L);
        System.out.println(user1);

        // 第二次查询,同一SqlSession,直接从一级缓存获取数据,不查询数据库
        User user2 = mapper1.selectUserById(1L);
        System.out.println(user2 == user1); // 输出true,说明是同一个对象

        // 执行更新操作,清空一级缓存
        User user = new User();
        user.setId(1L);
        user.setUsername("test_cache");
        mapper1.updateUser(user);
        session1.commit();

        // 第三次查询,缓存已清空,重新从数据库获取数据
        User user3 = mapper1.selectUserById(1L);
        System.out.println(user3 == user1); // 输出false
    }

    // 获取第二个SqlSession,与第一个SqlSession的缓存相互独立
    try (SqlSession session2 = MyBatisUtil.getSqlSession()) {
        UserMapper mapper2 = session2.getMapper(UserMapper.class);
        // 第四次查询,新的SqlSession,从数据库获取数据
        User user4 = mapper2.selectUserById(1L);
        System.out.println(user4 == user1); // 输出false
    }
}
注意:一级缓存默认开启,无需额外配置;若需要禁用一级缓存,可在查询标签中添加flushCache="true"属性。
2. 二级缓存:Mapper级别的缓存,需手动开启
二级缓存也称为全局缓存,是Mapper级别的缓存,多个SqlSession可以共享同一个Mapper的二级缓存。二级缓存的工作机制是:当SqlSession执行查询操作并提交事务后,查询结果会存入二级缓存;其他SqlSession查询相同的语句时,会先从二级缓存中查询,若存在则直接返回结果,无需查询数据库。二级缓存的作用范围比一级缓存更广,适用于查询频率高、数据变更频率低的场景。
注意:执行增、删、改操作时,会自动清空当前Mapper的二级缓存,确保缓存数据与数据库数据一致;若需要禁用某条查询的二级缓存,可在查询标签中添加useCache="false"属性。
四、MyBatis注解开发:替代XML,简化开发流程
MyBatis不仅支持XML配置开发,还提供了注解开发方式,通过在Mapper接口方法上添加注解,直接指定SQL语句,无需编写XML文件,简化了开发流程,适用于简单的CRUD操作场景。常用的注解有@Select、@Insert、@Update、@Delete、@Results等。
1. 基础CRUD注解使用
@Mapper
public interface UserMapper {
    // 查询:根据ID查询用户
    @Select("SELECT id, username, age, email FROM t_user WHERE id = #{id}")
    User selectUserById(Long id);

    // 插入:新增用户
    @Insert("INSERT INTO t_user (username, age, email) VALUES (#{username}, #{age}, #{email})")
    @Options(useGeneratedKeys = true, keyProperty = "id") // 自动生成主键,并赋值给实体类的id属性
    int insertUser(User user);

    // 更新:修改用户信息
    @Update("UPDATE t_user SET username = #{username}, age = #{age}, email = #{email} WHERE id = #{id}")
    int updateUser(User user);

    // 删除:根据ID删除用户
    @Delete("DELETE FROM t_user WHERE id = #{id}")
    int deleteUserById(Long id);

    // 多条件查询,结合动态SQL注解
    @Select({
        "<script>",
        "SELECT id, username, age, email FROM t_user",
        "<where>",
        "<if test='username != null and username != \"\"'>",
        "AND username LIKE CONCAT('%', #{username}, '%')",
        "</if>",
        "<if test='age != null'>",
        "AND age = #{age}",
        "</if>",
        "</where>",
        "</script>"
    })
    List<User> selectUserByCondition(@Param("username") String username, @Param("age") Integer age);
}
注意:使用注解开发动态SQL时,需要用<script>标签包裹SQL语句,内部标签用法与XML一致;对于复杂的SQL语句,建议还是使用XML开发,可读性更高。
2. 结果映射注解@Results
当实体类属性名与数据库表字段名不一致时,可使用@Results注解实现结果映射,替代XML中的resultMap标签。
@Select("SELECT id, user_name, user_age, user_email FROM t_user WHERE id = #{id}")
@Results({
    @Result(column = "id", property = "id"),
    @Result(column = "user_name", property = "username"), // 表字段user_name映射到实体类username
    @Result(column = "user_age", property = "age"), // 表字段user_age映射到实体类age
    @Result(column = "user_email", property = "email") // 表字段user_email映射到实体类email
})
User selectUserById(Long id);
五、MyBatis-Plus入门:简化CRUD,提升开发效率
MyBatis-Plus(简称MP)是基于MyBatis的增强工具,在MyBatis的基础上做了无侵入增强,提供了通用的CRUD方法、分页查询、条件构造器等功能,无需编写基础CRUD的SQL语句,极大地提升了开发效率。
1. 快速入门:配置与基础使用
第一步:引入MyBatis-Plus依赖(Maven)
<dependency>
    <groupId>com.baomidou</groupId>
    <artifactId>mybatis-plus-boot-starter</artifactId>
    <version>3.5.3.1</version>
</dependency>
第二步:配置数据库连接(application.yml),与MyBatis配置一致
spring:
  datasource:
    url: jdbc:mysql://localhost:3306/mybatis_demo?useUnicode=true&characterEncoding=utf8&useSSL=false&serverTimezone=UTC
    username: root
    password: root
    driver-class-name: com.mysql.cj.jdbc.Driver

mybatis-plus:
  configuration:
    map-underscore-to-camel-case: true # 开启驼峰命名自动映射
  mapper-locations: classpath:mapper/*.xml # 若有自定义XML,指定路径
第三步:编写实体类,使用注解指定表名和主键
@Data
@TableName("t_user") // 指定对应的数据库表名
public class User {
    @TableId(type = IdType.AUTO) // 指定主键,自增策略
    private Long id;
    private String username;
    private Integer age;
    private String email;

    // 无参、有参构造方法可省略,使用@Data注解自动生成getter/setter、toString等方法
}
2. 核心亮点:条件构造器QueryWrapper
MyBatis-Plus提供了QueryWrapper条件构造器,用于动态拼接查询条件,替代传统的动态SQL,使用更加简洁。
实战案例:根据姓名模糊查询、年龄大于指定值的用户
@Override
public List<User> selectUserByCondition(String username, Integer age) {
    // 创建条件构造器
    QueryWrapper<User> queryWrapper = new QueryWrapper<>();
    // 姓名模糊查询
    queryWrapper.like(StringUtils.isNotBlank(username), "username", username);
    // 年龄大于指定值
    queryWrapper.gt(age != null, "age", age);
    // 执行查询
    return userMapper.selectList(queryWrapper);
}
六、MyBatis优化技巧总结
结合以上进阶特性,总结MyBatis优化数据库操作的核心技巧,帮助大家在实际项目中提升系统性能和开发效率:
-
合理使用动态SQL:根据业务场景选择合适的动态SQL标签(if、where、foreach等),避免编写冗余SQL,同时注意SQL拼接的语法正确性。
-
优先使用物理分页:对于大量数据的分页查询,优先使用PageHelper插件或MyBatis-Plus的分页功能,避免使用原生RowBounds的内存分页,提升查询性能。
-
合理配置缓存:一级缓存默认开启,无需额外配置;二级缓存适用于查询频率高、数据变更频率低的场景,开启后可减少数据库查询次数,但需注意缓存的清空策略,确保数据一致性。
-
注解与XML结合使用:简单的CRUD操作使用注解开发,简化流程;复杂的SQL语句(如多表关联查询、复杂动态SQL)使用XML开发,提升可读性和维护性。
-
使用MyBatis-Plus简化开发:对于基础CRUD操作,优先使用MyBatis-Plus的通用方法和条件构造器,减少重复代码,提升开发效率;同时可结合MyBatis的原生特性,实现复杂业务需求。
-
优化SQL语句:避免使用SELECT *,只查询需要的字段;合理使用索引,提升查询速度;减少多表关联查询的复杂度,必要时可使用分步查询。
七、总结
本文详细讲解了MyBatis的进阶特性,包括动态SQL、分页查询、缓存机制,同时补充了注解开发和MyBatis-Plus入门知识,并结合实战案例进行了演示。这些进阶特性是优化数据库操作、提升系统性能和开发效率的关键,希望大家在实际项目中灵活运用,结合业务场景选择合适的技术方案。
MyBatis的学习是一个循序渐进的过程,基础CRUD是入门,进阶特性是提升,而真正的精通需要结合实际项目,不断总结和优化。后续我将继续分享MyBatis的高级用法(如多表关联查询、存储过程调用等),欢迎大家持续关注!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献1条内容

所有评论(0)