破解工业 AI 落地数据困局:多模融合时序数据库赋能工业智能实战解析
一、工业智能落地核心痛点:数据碎片化与时序分析短板
当前工业物联网、能源电力、轨道交通等场景下,AI智能诊断、预测性维护、实时态势感知等应用普遍面临落地瓶颈,核心症结并非算法模型缺陷,而是多源数据割裂、时序数据处理能力不足、业务上下文缺失三大数据层问题。
传统AI知识问答场景以静态结构化、文档化数据检索为主,而工业场景的智能分析具备强时序、强关联、强实时特性。以设备故障诊断场景为例:单一的实时温度阈值无法判定设备异常,温度升高可能是负载正常波动,也可能是故障前兆。精准的AI推理需要串联多维数据:设备历史温度变化时序曲线、同周期振动/电流联动数据、设备台账属性、近期检修工单、同型号设备故障案例等多模态信息。
目前企业数据架构普遍存在“数据孤岛”问题:时序运行数据、设备关系属性数据、GIS空间位置数据、故障向量知识库、运维工单数据分散在监控、资产、地理信息、运维管理等多套独立系统中。传统方案需通过多层ETL抽取、转换、拼接数据,存在链路冗长、数据更新滞后、维度缺失、一致性差等问题,无法支撑毫秒级实时分析与AI在线推理,成为工业智能化落地的核心卡点。
针对上述行业痛点,人大金仓KES融合数据库原生时序能力(KES TimeSeries),以一库多模、库内计算、高性能时序处理、业务数据联动为核心,打通时序、关系、空间、向量多模态数据壁垒,从底层数据架构解决工业AI落地难题。
二、核心架构:原生多模融合,重构工业数据组织方式
2.1 架构核心优势:时序能力内核原生集成
市面上多数时序数据库为独立组件,需与关系型数据库、GIS系统、向量数据库对接,依赖外部中间件实现数据关联,架构复杂、运维成本高、实时性差。而KES TimeSeries并非外挂模块,是深度集成于KingbaseES融合数据库内核的原生能力,基于自主可控的数据库内核重构优化,适配国产软硬件生态。
该架构实现同一数据库内核下多模态数据统一存储、统一检索、统一计算,可围绕设备、产线、站点等核心业务对象,将四类核心数据实时关联:
- 时序数据:设备温度、振动、电流、电压等实时/历史运行指标,刻画设备状态动态变化;
- 关系数据:设备型号、参数、所属产线、归属车间、运维责任人等静态业务属性;
- GIS空间数据:设备安装位置、管网拓扑、站点地理分布等空间信息;
- 向量数据:历史故障案例、检修知识库、异常特征模型等AI语义知识数据。
通过原生多模融合架构,彻底摒弃多系统对接、外部ETL拼接的传统模式,实现业务数据的一体化治理,为AI精准推理提供完整、实时、多维的数据底座。
2.2 底层核心优化:适配工业海量时序场景
针对工业物联网高频写入、海量存储、高并发查询、设备基数大的业务特征,KES从写入、存储、计算全链路做专项内核优化,兼顾性能、存储成本与数据可用性。
2.2.1 高并发写入优化:千万级指标秒级入库
工业场景下,成千上万台终端设备会持续上报时序指标,对数据库写入吞吐、稳定性要求极高。KES TimeSeries通过Append追加写入、无锁化并发控制、异步IO调度、批量数据合并四大机制,规避高并发场景下的线程竞争、IO阻塞、资源抢占问题,大幅降低写入延迟。
基准测试数据显示,单节点KES时序写入能力可达千万级指标点/秒,可稳定支撑超大规模工业设备集群的实时数据入库,无数据积压、无丢包、无时序错乱问题。
2.2.2 高压缩存储优化:90%存储成本削减
工业时序数据具备数值连续、波动平缓、采样频率固定的特征,传统通用存储压缩算法适配性差、压缩率低。KES采用自适应行列混合存储架构,搭配时序专属压缩算法:Delta-of-Delta增量编码、Gorilla浮点数压缩、整型差分压缩,可根据数据类型、波动特征自动匹配最优压缩策略。
针对工业主流数字型时序指标,数据压缩比可达10:1,最高可削减90%存储空间,在极致压缩的同时完整保留原始数据精度,不丢失细微异常特征,保障后续AI建模、故障追溯、趋势分析的数据准确性。
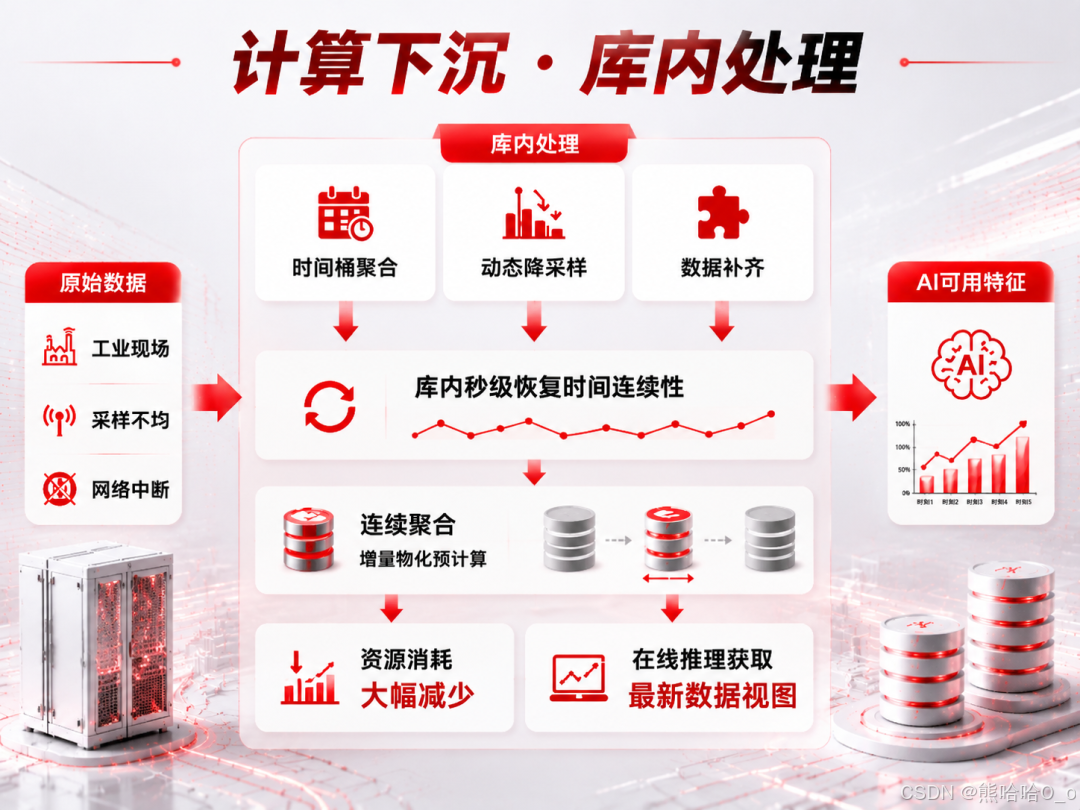
三、核心技术能力与代码实操讲解
KES支持标准SQL语法,兼容PostgreSQL生态,无需重构技术栈即可快速落地时序数据治理、库内清洗、多维关联分析、聚合计算,以下结合工业设备监测场景提供核心代码实操案例。
3.1 时序数据表创建(绑定设备业务属性)
区别于传统时序库仅存储指标数据,KES可在同一张表中融合时序指标与设备关系属性,实现数据天然关联,无需跨库联表。
-- 创建工业设备时序监测表(多模融合:时序+关系属性)
CREATE TABLE device_ts_monitor (
    ts TIMESTAMPTZ NOT NULL,       -- 时序时间戳(核心时序字段)
    device_id VARCHAR(64) NOT NULL,-- 设备唯一ID(业务关联主键)
    workshop_id VARCHAR(32),       -- 所属车间(关系属性)
    device_type VARCHAR(32),       -- 设备型号(关系属性)
    temperature FLOAT8,            -- 温度时序指标
    vibration FLOAT8,              -- 振动时序指标
    current FLOAT8,                -- 电流时序指标
    status INT2                    -- 设备运行状态标签
) WITH (
    timescale = true,              -- 开启KES原生时序存储引擎
    compress_type = 'gorilla',     -- 浮点数指标启用Gorilla压缩算法
    partition_by = 'device_id'     -- 按设备ID分片,优化查询并发
);

-- 创建时序索引,加速时间范围+设备维度检索
CREATE INDEX idx_ts_device ON device_ts_monitor(ts, device_id);
代码解析:通过 timescale=true 开启原生时序引擎,自动适配时序数据存储、压缩、分片规则;将设备静态属性与时序指标同表存储,规避后续关联查询的跨表开销,适配业务快速迭代。
3.2 库内数据自愈:补齐缺失、统一采样频率
工业现场普遍存在网络抖动、设备离线导致的数据缺失、采样频率不一致问题,原始数据无法直接用于AI建模。KES内置库内数据清洗能力,无需外部ETL即可完成数据修复。
-- 按1分钟粒度重采样,补齐缺失数据,生成连续可分析时序曲线
SELECT
    time_bucket('1 minute', ts) AS minute_ts,  -- 时间桶聚合,统一采样粒度
    device_id,
    avg(temperature) AS avg_temp,              -- 分钟级温度均值
    avg(vibration) AS avg_vib,
    avg(current) AS avg_current,
    fill_missing(avg(temperature)) AS fill_temp  -- 自动补齐缺失值
FROM device_ts_monitor
WHERE ts >= now() - INTERVAL '1 hour'
GROUP BY minute_ts, device_id
ORDER BY minute_ts;
代码解析:time_bucket 实现动态降采样与时间粒度归一,解决多设备采样频率不一致问题;fill_missing 内置函数自动修复短时数据缺失、网络中断导致的断点,输出连续完整的时序曲线,满足AI建模的数据完整性要求。
3.3 预聚合加速:毫秒级历史趋势查询
传统方案每次查询均扫描全量原始明细数据,海量历史数据场景下查询延迟高达分钟级。KES支持增量连续聚合,预计算多粒度历史数据,实现毫秒级响应。
-- 创建小时级、天级自动聚合任务,增量更新聚合数据
CREATE CONTINUOUS AGG device_hour_agg
ON device_ts_monitor
BUCKET INTERVAL '1 hour'
AS SELECT
    device_id,
    min(temperature) AS min_temp,
    max(temperature) AS max_temp,
    avg(temperature) AS avg_temp,
    stddev(temperature) AS temp_std  -- 标准差,用于异常判定
GROUP BY bucket, device_id;

-- 查询近7天设备异常趋势(毫秒级响应)
SELECT * FROM device_hour_agg
WHERE device_id = 'DEV_001'
  AND bucket >= now() - INTERVAL '7 days'
  AND temp_std > 2.5;  -- 基于波动标准差筛选异常时段
代码解析:连续聚合任务后台增量计算,无需重复扫描原始海量数据,查询时直接读取预计算结果。在分钟级滑动窗口分析场景下,查询响应可降至毫秒级,支撑实时状态监测、在线AI异常推理。
3.4 多模数据关联:时序+业务属性联动分析
依托KES一库多模能力,可直接在库内完成时序运行数据、设备台账、运维记录的关联查询,精准定位异常根因,解决AI“只知异常、不知原因”的问题。
-- 关联时序数据与设备运维台账,追溯异常诱因
SELECT
    m.ts, m.device_id, m.avg_temp, m.avg_vib,
    d.maintain_time, d.fault_type, d.repair_content  -- 维修记录数据
FROM (
    -- 筛选近2小时异常时序数据
    SELECT time_bucket('5 minute', ts) AS ts, device_id, avg(temperature) AS avg_temp, avg(vibration) AS avg_vib
    FROM device_ts_monitor
    WHERE ts >= now() - INTERVAL '2 hours'
    GROUP BY ts, device_id
    HAVING avg(temperature) > 80
) m
LEFT JOIN device_maintain d ON m.device_id = d.device_id
  AND d.maintain_time BETWEEN m.ts - INTERVAL '1 day' AND m.ts;
四、落地实践:轨道交通场景性能实测升级
金仓KES多模时序能力已在千行百业核心场景落地,其中北京轨道交通应急指挥调度平台落地效果极具代表性,彻底解决原有系统时序数据处理低效、存储冗余、分析滞后的问题。
项目落地后核心性能指标大幅升级:
- 写入性能:时序数据整体写入吞吐较原系统提升10倍以上,完美承载轨道交通全线路设备高频上报数据;
- 查询性能:历史趋势分析、故障追溯统计从原有分钟级延迟缩短至秒级响应,满足应急调度实时决策需求;
- 存储成本:依托专属压缩算法,时序数据存储空间占用降低70%-80%,大幅减少海量历史数据存储开销;
- 智能支撑:多模融合的数据架构,为平台AI故障预测、智能调度、异常溯源模型提供完整、实时、多维的数据支撑,大幅提升AI推理准确率。
五、总结与行业价值
工业AI落地的核心瓶颈不在于算法迭代,而在于底层数据架构无法适配时序化、关联化、实时化的业务需求。传统分散的数据架构导致数据治理成本高、AI模型输入维度缺失、推理精度不足,是行业普遍痛点。
金仓KES TimeSeries以原生多模融合架构为核心,通过内核级写入、存储、计算优化,搭配库内一站式数据治理能力,打通时序、关系、空间、向量数据壁垒。无需搭建多套异构系统、无需复杂ETL开发,即可为工业监测、故障诊断、预测性维护、智能调度等场景,提供高吞吐、低成本、强关联、实时可建模的标准化数据底座。
对于工业、能源、交通等传统行业数字化转型而言,基于KES构建多模时序数据架构,可快速补齐AI落地的数据短板,是适配未来工业智能化迭代的轻量化、高可靠、低成本最优方案。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 3
 0
- 0


 已为社区贡献19条内容

所有评论(0)