【数据分析|Day03】RFM 客户分群实战笔记
文章目录
RFM 客户分群实战
📁 配套代码:rfm_project.ipynb| sales.xlsx
📅 更新日期:2026-07-16
🔗 前置知识:Series、DataFrame 讲解篇 | 数据收集、数据清洗、数据分析讲解篇 | Matplotlib 数据可视化讲解篇
一、什么是 RFM?
想象一个场景:你是电商平台的运营,手上有 20 万条订单记录,老板说"给我分一下哪些客户值得投钱,哪些不用管了"。你怎么回答?
这时候 RFM 模型就是答案。它用三个维度给每个客户打分:
| 维度 | 全称 | 含义 | 本项目计算方式 |
|---|---|---|---|
| R | Recency | 最近一次消费距今多久 | 订单日期距当年年底的天数 |
| F | Frequency | 一段时间内买了多少次 | 年内订单数 |
| M | Monetary | 总共花了多少钱 | 年内订单金额总和 |
三个维度各打 1-3 分,拼成一个三位数标签。比如
333= 最近买过、买得多、花得多 → 高价值客户;111= 很久没买、只买一次、花得少 → 基本流失。
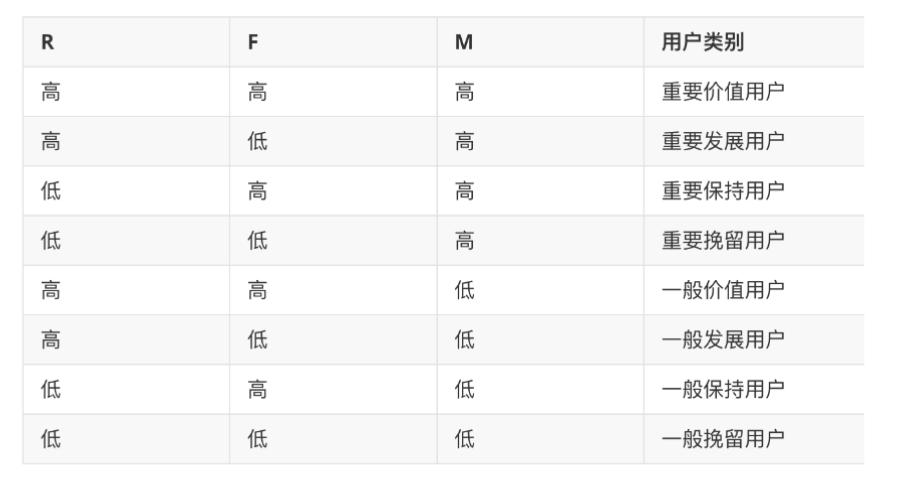
类似如图组合,一张表就能把 20 万用户分成 几个群体,运营策略一目了然。
💡 整个分析流程依然是之前学过的四步走:数据读取 → 数据清洗 → 数据分析 → 数据可视化,只不过每一步都用到了比之前更进阶的技巧。下面我们一步步来。
二、数据读取
这次的数据源是Excel,并且是一个文件里有五张 Sheet,2015 到 2018 四年的订单数据,外加一张会员等级表。
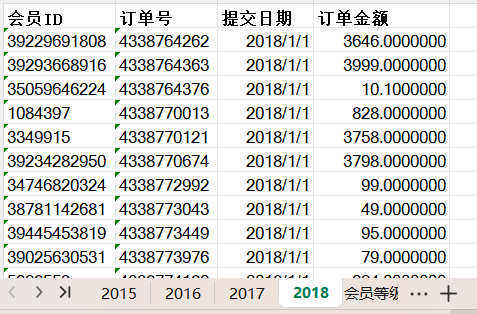
2.1 多 Sheet 读取:read_excel 的 sheet_name 参数
pd.read_excel() 和之前学的 read_csv() 用起来几乎一样,核心区别就在这个 sheet_name 参数上:
- 传一个 Sheet 名列表 → 返回
dict[sheet名 → DataFrame],一个变量装下五张表。使用场景:Excel 里 Sheet 很多,但我只需要其中某几张,并且希望之后能按名字快速取用。这是最常用、最明确的方式。
# 只读取需要的几张表,结果装在一个字典里
sheet_names = ['2015', '2016', '2017', '2018', '会员等级']
sheet_dict = pd.read_excel('sales.xlsx', sheet_name=sheet_names)

# sheet_dict 是一个字典:{'2015': DataFrame, '2016': DataFrame, ...}
df_2015 = sheet_dict['2015']        # 像查字典一样取出某一年
df_vip  = sheet_dict['会员等级']    # 取出会员等级那张表
- 传
None→ 读取所有 Sheet(效果类似,但如果只需要其中几个,传列表更明确)使用场景:Excel 里有什么就读什么,一次性看全貌。
# 不管 Excel 里有多少 Sheet,全读进来
all_sheets = pd.read_excel('sales.xlsx', sheet_name=None)

# all_sheets 也是字典,键是所有 Sheet 的名字
for name, df in all_sheets.items():
    print(f"Sheet 名:{name},形状:{df.shape}")
- 传单个字符串 → 只读那一张 Sheet,返回单个 DataFrame(不是 dict)使用场景:如果你只需要分析某一张表,这种方式最直接,省去一层字典取值。
# 直接读取名为 '2018' 的那一张表,返回的就是一个 DataFrame,不是字典
df_2018 = pd.read_excel('sales.xlsx', sheet_name='2018')

# 也可以传数字索引,比如第一个 Sheet
df_first = pd.read_excel('sales.xlsx', sheet_name=0)
拿到 sheet_dict 后,用熟悉的 shape、dtypes、info()、describe() 快速扫一眼各表规模,确定数据清洗方向。
sheet_dict['2015'].shape     # (30774, 4)          — 数据有多大?
sheet_dict['2015'].dtypes    # 每列 Dtype          — 类型对不对?
sheet_dict['2015'].info()    # Non-Null + 内存     — 有没有缺失?
sheet_dict['2015'].describe() # 8 个统计量          — 数值分布正常吗?
| 方法 | 关键看什么 |
|---|---|
shape | 数据有多大? 行数是否和预期一致(差太多 = 读取可能出了问题) |
dtypes | 每列是什么类型? 日期列是不是 datetime64(不是 = 后面日期运算会报错);金额列是不是数值(是 object = 混了脏字符如 ¥100) |
info() | 有没有缺失值? Non-Null Count ≠ 总行数 → 有缺失,后面需要 dropna 或 fillna |
describe() | 数值分布正常吗? min 有没有负数/0;max 有没有离谱的极端值;mean 和 50%(中位数)差距大 = 偏态分布,少数大单拉高了均值 |
三、数据清洗
3.1 基础清洗
for i in sheet_names[:-1]:          # 只处理四张年表,会员等级表不参与
    sheet_dict[i] = sheet_dict[i].dropna()                    # 1. 删缺缺失值
    sheet_dict[i] = sheet_dict[i].drop_duplicates(keep="last") # 2. 删除重复值(保留最后)
    sheet_dict[i] = sheet_dict[i][sheet_dict[i]['订单金额'] > 1]  # 3. 布尔过滤异常值
💡 这里
keep="last"是之前学过的参数,保留最后出现的重复行,删掉之前的。选择last还是first取决于业务:如果你认为最新数据更可靠,就用last。
通过之前的dtypes分析,确定这次数据集无需数据类型转换处理。
3.2 构造"时间距离"字段
RFM 第一个指标 R(Recency)需要算"最近一次消费距今多久"。但直接算"距今"有个问题:2015 年的客户和 2018 年的客户,距今的天数天然不同,混在一起没有可比性。
更合理的做法是:每年独立计算 R,以该年最后一天为截止节点,看每笔订单离年底有多远。这样每年的 R 都在 0-365 天之间,四年可以公平比较。
代码:
sheet_dict[i]['max_year_date'] = sheet_dict[i]['提交日期'].max()          # ① 每年最大日期
sheet_dict[i]['date_interval'] = sheet_dict[i]['max_year_date'] - sheet_dict[i]['提交日期']  # ② 日期减法
sheet_dict[i]['date_interval'] = sheet_dict[i]['date_interval'].dt.days   # ③ 转整数天数
这里藏着三个新知识点:
① .max() 对日期列求最大值
pandas 的 datetime64[ns] 列支持和数值一样的聚合操作。对日期列 .max() 返回的就是"最晚的日期",对每年来说就是 12 月 31 日。
② 两个 datetime 列相减 → Timedelta
这是 pandas 日期处理最优雅的地方。两个 datetime64 列相减,pandas 自动返回一个 Timedelta 对象(而不是一堆秒数让你自己换算)。你不用管什么时间戳、秒数,pandas 帮你处理好了,结果就是一个"时间差"。
③ .dt.days 把 Timedelta 转成整数天数
.dt 叫做 datetime 访问器,专门用来从 datetime 或 Timedelta 列中提取年月日等信息。常用的有:
| 访问器 | 含义 | 示例 |
|---|---|---|
.dt.year | 提取年份 | 2023-06-15 → 2023 |
.dt.month | 提取月份 | 2023-06-15 → 6 |
.dt.day | 提取日 | 2023-06-15 → 15 |
.dt.days | Timedelta 转天数 | 365 days → 365 |
.dt.total_seconds() | Timedelta 转总秒数 | 1 days 02:00:00 → 93600.0 |
💡 避坑笔记:
.dt.days只能用于 Timedelta 类型。如果你对普通 datetime 列用.dt.days(比如df['日期'].dt.days),pandas 会报AttributeError。正确的用法是先减法得到 Timedelta,再用.dt.days。另一个易混点:df['日期'].dt.day(单数)是提取"日"(1-31),而dt.days(复数)是提取 Timedelta 的天数,两者完全不一样。
四、计算 R、F、M
4.1 合并四年数据
清洗完四张年表后,用 pd.concat() 纵向拼成一张大表:
df_merge = pd.concat(list(sheet_dict.values())[:-1], ignore_index=True)
ignore_index=True 不写的话,四张表的原始行索引(都是 0, 1, 2…)会重复,后续按索引操作可能翻车。加上它就重新排成 0 到 20 万,干净。
- concat 的第一个参数:可迭代对象
pd.concat()的第一个参数objs接收一个可迭代对象(如list、tuple、dict_values)
但我们这里为什么要包一层
list()?原因是sheet_dict.values()返回的dict_values对象虽然可迭代,但不支持切片你不能对它写[:-1]。而我们只需要前四张年表,不要最后一个「会员等级」Sheet。所以:list(sheet_dict.values())[:-1]
- concat 的核心参数
| 参数 | 默认值 | 含义 |
|---|---|---|
objs | 必填 | 要拼接的 DataFrame/Series 序列(list、tuple、dict 等可迭代对象都行) |
axis | 0 | 0 = 纵向堆叠(行数增加),1 = 横向拼接(列数增加) |
ignore_index | False | True = 忽略原始索引,重新排成 0, 1, 2... |
join | 'outer' | 'outer' = 并集(列不同时保留所有列,缺失填 NaN);'inner' = 交集(只保留共有列) |
keys | None | 传入标签列表,给每条数据打上来源标记,生成 MultiIndex 的最外层 |
4.2 groupby + agg
先想清楚一个关键问题:合并后的 df_merge 是订单级别的数据,一行是一条订单。但 RFM 分析需要的是客户级别的数据,一行是一个客户一年内的汇总。
比如会员 ID 为 267 的客户,2015 年可能下了 2 单:
- 第 1 单:1 月 1 日,499 元 → 距年底 364 天
- 第 2 单:6 月 15 日,105 元 → 距年底 199 天
我们需要把这两单"压缩"成一行:
R = 最近一次购买 = min(364, 199) = 199 天
F = 购买次数 = count(第1单, 第2单) = 2 次
M = 消费总额 = sum(499, 105) = 604 元
我们需要对不同的列做不同的聚合, agg() 的字典模式就派上用场了:
rfm_gb = df_merge.groupby(['year', '会员ID'], as_index=False).agg({
    'date_interval': 'min',    # R: 最近一次购买
    '订单号': 'count',          # F: 购买次数
    '订单金额': 'sum'           # M: 消费总额
})
💡
agg()的参数可以是一个函数名字符串(如'min'),也可以是一个函数对象(如np.min),还可以是一个函数列表(如['min', 'max'])。传字典时,key 是列名,value 是要用的聚合函数,pandas 就会"对号入座",对每列执行对应的操作。
- as_index 参数
as_index=True(默认):分组键(year 和 会员ID)会变成 DataFrame 的行索引(而且是 MultiIndex)。之后你想访问year这一列,写rfm_gb['year']会报 KeyError,因为year根本不在列里,它在行索引里。你得用rfm_gb.index.get_level_values('year')才能拿到。as_index=False:分组键保留为普通数据列,和其他列一样用rfm_gb['year']就能访问。对后续的数据清洗、筛选、合并都友好得多。
| 特性 | as_index=True | as_index=False |
|---|---|---|
| 分组键位置 | 行索引(MultiIndex) | 普通列 |
df['year'] 访问 | ❌ KeyError | ✅ 正常 |
| 列名复杂度 | 只有聚合列 | 分组键列 + 聚合列 |
| 适用场景 | 单纯看结果、不需要后续操作 | 推荐,方便链式操作 |
还有一个坑:agg(dict) 后的列名是多级元组,形如 ('date_interval', 'min')、('订单号', 'count')。不管 as_index 怎么设,这都是固定的。所以需要额外一步手动打平:
rfm_gb.columns = ['year', '会员ID', 'r', 'f', 'm']
💡 避坑笔记:
as_index=False+agg(dict)+ 手动打平列名 → 这三个操作配合起来,能得到一个列名干净、访问正常的 DataFrame。
4.3 pd.cut 分箱打分
R、F、M 三个指标量纲完全不同,R 是天数(0-365),F 是次数(1-100+),M 是金额(1-100000+)。它们不能直接比较,更不能直接相加。需要把它们统一到一个尺度上,打分 1-3 分。
这里用到的是 pd.cut() 方法:
r_bins = [-1, 79, 255, 365]       # 三个区间: [-1,79], (79,255], (255,365]
rfm_gb['r_label'] = pd.cut(rfm_gb['r'], bins=r_bins, labels=[3, 2, 1])
cut 是什么?
pd.cut() 是 pandas 的分箱/离散化函数,把连续的数值按你指定的边界,切成一段段的"箱子",每个箱子贴一个标签。经典用途就是 RFM 打分、成绩分档(优/良/中/差)、价格分档(低/中/高)。
pd.cut(x, bins, right=True, labels=None, include_lowest=False)
| 参数 | 类型 | 默认值 | 说明 |
|---|---|---|---|
x | array-like | 必填 | 要分箱的数据(通常是一列) |
bins | int / list | 必填 | 传 int = 等宽分成 N 段;传 list = 自定义边界 |
right | bool | True | True = 区间左开右闭 (left, right];False = 左闭右开 [left, right) |
labels | list | None | 每段的标签。不传则返回区间字符串如 (0, 79] |
include_lowest | bool | False | True = 第一个区间包含最小值(配合 right=True 时常用) |
bins 和 labels 的数量关系:N 个边界产生 N-1 个区间 → N-1 个标签。
- 通用例子 1:等宽分箱(传整数)
import pandas as pd

scores = pd.Series([93, 85, 72, 58, 44, 67, 81, 39])
pd.cut(scores, bins=3)   # 自动把 39~93 等宽分成 3 段
# → [(43.946, 62.667], (80.333, 98.0], (62.667, 80.333], ...]
- 通用例子 2:自定义边界 + 标签(传列表)
# 边界:[0, 60, 80, 100] → 三个区间
# 区间:(0,60] 不及格, (60,80] 良好, (80,100] 优秀
pd.cut(scores,
       bins=[0, 60, 80, 100],
       labels=['不及格', '良好', '优秀'])
# → ['优秀', '优秀', '良好', '不及格', '不及格', ...]
- 通用例子 3:right=False 改区间开闭
# right=False → 左闭右开 [0, 60), [60, 80), [80, 100)
# 和日常习惯更接近:"60-79是良好,80+是优秀"
pd.cut(scores,
       bins=[0, 60, 80, 100],
       labels=['不及格', '良好', '优秀'],
       right=False)
💡 避坑笔记:
bins传 int 时,pandas 自动算等宽范围,边界可能是小数(如43.946)。如果想控制边界,用 list 手动指定,RFM 这种有业务含义的分箱所以就手动定义了。
理解了上面的基础,再看我们的代码就清楚了:
# R(天数 0-365):越小越好 → 标签倒过来写 [3, 2, 1]
r_bins = [-1, 79, 255, 365]
rfm_gb['r_label'] = pd.cut(rfm_gb['r'], bins=r_bins, labels=[3, 2, 1])

# F(次数 1-130):越多越好 → 标签正着写 [1, 2, 3]
f_bins = [0, 2, 5, 130]
rfm_gb['f_label'] = pd.cut(rfm_gb['f'], bins=f_bins, labels=[1, 2, 3])

# M(金额 1-206252):越多越好 → 标签正着写 [1, 2, 3]
m_bins = [1, 69, 1199, 206252]
rfm_gb['m_label'] = pd.cut(rfm_gb['m'], bins=m_bins, labels=[1, 2, 3])
① 为什么 bins 从 -1 / 0 / 1 开始,而不是从数据的最小值?
默认区间是左开右闭 (left, right]。以 R 为例,如果写 [0, 79, 255, 365],第一个区间是 (0, 79],0 值被排除在外。当天购买的客户(距年底 0 天)就丢了。写成 [-1, 79, 255, 365] 后,(-1, 79] 完美兜底。
同理,F 用 [0, 2, 5, 130] 兜住 F=1 的客户,M 用 [1, 69, 1199, 206252] 兜住最低消费。
💡 通用规律:边界列表的第一个值应略小于数据的最小值,确保最小值落在第一个区间内。
② 为什么 R 的标签是 [3, 2, 1] 降序,F 和 M 是 [1, 2, 3] 升序?
分箱的方向取决于"什么是好":
- R(Recency)越小越好:0 天前买过 = 刚刚来过 → 好客户 → 3 分。所以第一段(最近)= 3 分,最后一段(最远)= 1 分
- F 和 M 越大越好:买得多花得多 → 好客户 → 3 分。所以第一段(最少)= 1 分,最后一段(最多)= 3 分
分箱方向是业务逻辑决定的,不是技术问题。
③ 分箱边界怎么定?
| 指标 | 边界 | 业务含义 |
|---|---|---|
R: [-1, 79, 255, 365] | 0-79 / 80-255 / 256-365 | ≈ 近3个月 / 3-9个月 / 9个月以上 |
F: [0, 2, 5, 130] | 1次 / 2-5次 / 6+次 | 新客 / 有复购 / 忠诚 |
M: [1, 69, 1199, 206252] | 低 / 中 / 高 | 需要结合具体业务定价来定 |
没有标准答案,需要用 describe() 看数据分布 + 和业务方讨论。
五、3D 柱状图可视化
之前博客里画过折线图、柱状图,都是二维的。这次要展示的数据有两个维度:RFM 组合(22 种)× 年份(4 年),用平面图要么太挤要么看不清。于是第一次尝试了 3D 柱状图。
bar3d 的参数模型
ax.bar3d(x, y, z, dx, dy, dz, color=colors)
6 个核心参数可以理解为"在三维空间里摆砖块":
| 参数 | 含义 | 本项目取值 |
|---|---|---|
x, y | 柱子底面的位置 | 类别编号(0, 1, 2…) |
z | 柱子底部的高度 | 全部为 0(从地面开始) |
dx, dy | 柱子在 x、y 方向的宽度 | 0.6(柱子间留点空隙) |
dz | 柱子的高度(你要展示的值) | 客户数量 |
- 坐标映射:字符串类别 → 数值坐标
bar3d 的 x 和 y 坐标必须是数值,不能直接传 ["111", "112", ...] 这样的字符串。所以需要手动做一层映射:
rfm_labels = sorted(display_data['rfm_group'].unique())     # ["111", "112", ..., "333"]
rfm_to_num = {label: i for i, label in enumerate(rfm_labels)} # {"111": 0, "112": 1, ...}
x = display_data['rfm_group'].map(rfm_to_num).values         # 字符串 → 数字
这个套路很通用:unique() → sorted() → enumerate 生成编号 → dict → map 映射。之后用 ax.set_xticks() + ax.set_xticklabels() 把坐标轴标签改回原始字符串,柱子摆对了,标签也是对的。
- 配色映射:让颜色也传递信息
plt.cm.coolwarm 是一个颜色映射器,给它 0-1 之间的值,它返回对应的颜色。这里用客户数 / 最大值做归一化:
colors = plt.cm.coolwarm(dz / max(dz))
客户数越多 → 值越接近 1 → 颜色越红;越少 → 接近 0 → 颜色越蓝。这样柱子的高度和颜色双重编码了客户数量的信息,比只看高度更直观。
💡 避坑笔记:3D 图的视角很重要。默认视角(elev=30, azim=-60)可能正好被前面的柱子挡住后面的。
ax.view_init(elev=25, azim=-55)可以调俯仰角和水平旋转角,多试几个角度找到最佳观察位置。
六、数据保存与导出
分析做完了,结果不能只活在 Jupyter Notebook 里。这里我们做了两种导出:Excel 文件和 MySQL 数据库。
6.1 导出到 Excel:df.to_excel()
rfm_gb.to_excel(r'D:\iscode\AI应用\数据分析\data\sale_rfm_group.xlsx', index=False)
💡 和之前学过的
to_csv()套路完全一样,只是改了个后缀。index=False的道理也一样,不想把默认的0, 1, 2...行索引写进文件里占一列。
常用参数速查:
| 参数 | 默认值 | 说明 |
|---|---|---|
excel_writer | 必填 | 文件路径 或 ExcelWriter 对象 |
sheet_name | 'Sheet1' | 写到哪个 Sheet |
index | True | 是否写入行索引(一般都设 False) |
columns | None | 只写指定列 |
header | True | 是否写入列名 |
6.2 导出到 MySQL:to_sql() + SQLAlchemy
to_sql() 和 to_csv/to_excel 的名字对称,但它不是直接写文件,它需要通过 SQLAlchemy 引擎连接到数据库,然后把 DataFrame 写进去。
- 第一步:创建数据库引擎
from sqlalchemy import create_engine

engine = create_engine('mysql+pymysql://root:123456@localhost:3306/rfm_db?charset=utf8')
这个连接字符串拆开来就是:
mysql+pymysql:// 用户名:密码 @ 主机地址 : 端口 / 数据库名 ? 参数
💡 避坑笔记:数据库
rfm_db必须提前在 MySQL 中创建好(CREATE DATABASE rfm_db;),to_sql不会自动建库,它只会建表。另外pymysql需要通过pip install pymysql安装。
- 第二步:写入数据库
rfm_gb.to_sql('rfm_table', engine, index=False, if_exists='replace')
核心参数:
| 参数 | 默认值 | 说明 |
|---|---|---|
name | 必填 | 要写入的表名 |
con | 必填 | SQLAlchemy 引擎 或 数据库连接对象 |
index | True | 是否写入行索引(还是设 False) |
if_exists | 'fail' | 'fail' = 表存在就报错;'replace' = 删旧建新;'append' = 追加数据 |
chunksize | None | 分批写入,每批写多少行(大数据量时避免内存爆) |
💡 if_exists 怎么选? 第一次写入用
'replace'(建表 + 覆盖),后续追加新数据用'append'。生产环境一般先用'replace'建表,日常增量更新用'append'。
- 第三步:读取验证
pd.read_sql('select * from rfm_table', engine)
read_sql 是 read_csv、read_excel 的同系列方法,把 SQL 查询结果直接读到 DataFrame。第一个参数可以是一条 SQL 语句(如 'select * from rfm_table'),也可以是一个表名('rfm_table',等效于查全表)。
Excel 适合临时分享、给运营同事看;数据库适合接 BI 工具(Tableau、Power BI)、Web 后台做实时查询、或者和其它业务表做 JOIN。分析结果进了数据库,才算真正"能用起来"。
以上为个人学习总结,旨在梳理个人理解。如有疏漏或不当之处,欢迎指正与交流。如果文章对你有帮助,别忘了点个赞、留个言~ 我们下篇再见!

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 7
 0
- 0


 已为社区贡献3条内容

所有评论(0)