文件名搜不到内容怎么办:用摘要、关键词和问题元数据增强 RAG
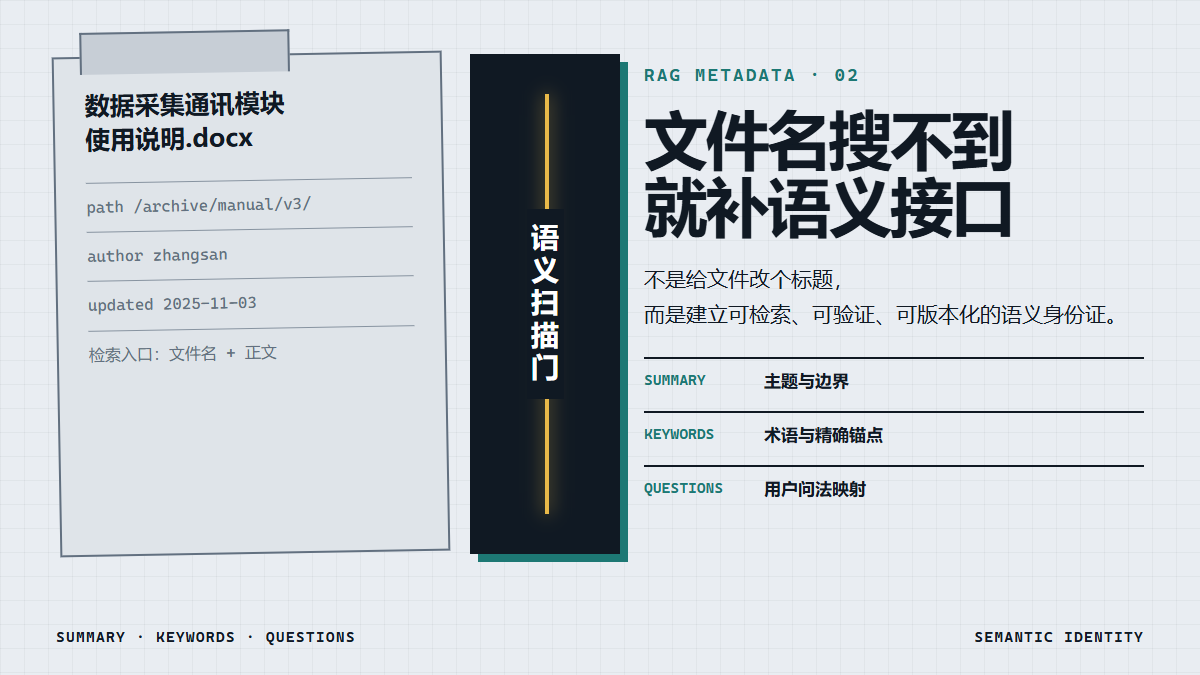
这类问题的关键不是再给文件名改一个“更 SEO”的名字,而是给文档补上一层可检索的语义接口:一句话摘要告诉系统“它总体讲什么”,关键词提供稳定术语锚点,可回答问题则把文档语言映射成用户更可能使用的问法。
参考企业案例中,团队为文档生成摘要、技术术语和若干可回答问题,再把这些字段用于检索增强。案例中的规模和效果数字属于原作者;这篇只讨论可以被验证的机制、Java 实现和质量控制,不把案例数据当成我们的实测结果。
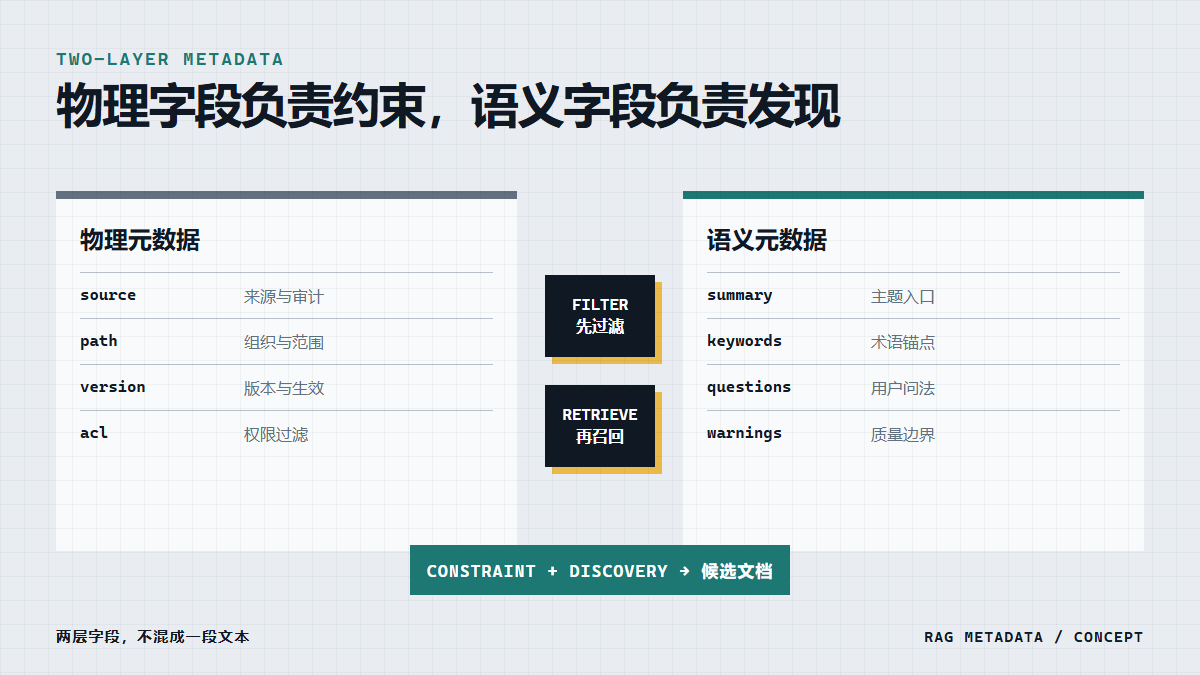
一、物理元数据与语义元数据
一份文件天然带有不少元数据:
filename = 数据采集通讯模块使用说明.docx
path     = /archive/manual/v3/
author   = 张三
updated  = 2025-11-03
这些字段回答的是“文件是谁、放在哪里、何时更新”,属于物理元数据。它们对权限、版本、过滤和审计非常重要,但不一定能回答“文件能解决什么问题”。
语义元数据面向检索:
summary  = 介绍 MQTT 采集通道、心跳、重连和认证参数的配置方法
keywords = [MQTT, 心跳, 重连, TLS, 采集通道]
questions = [
  MQTT 设备如何设置心跳间隔?
  连接断开后如何配置自动重连?
  MQTT 通道如何启用 TLS 认证?
]
物理元数据与语义元数据不是替代关系。前者负责范围和约束,后者负责发现和匹配。生产检索通常需要二者共同参与:先用租户、权限、版本等物理字段过滤,再用正文和语义字段计算相关性。
二、三类语义字段分别解决什么问题
摘要:为长文档建立稳定入口
摘要压缩整篇文档的主题,适合解决标题过宽、正文过长的问题。它应该包含文档对象、核心任务和边界,而不是生成一句空泛的“本文介绍了相关配置方法”。
好的摘要:
说明 MQTT 采集通道的连接参数、心跳与自动重连策略,以及 TLS 双向认证配置,不包含 Broker 部署教程。
这里最后一句边界也很重要。没有边界的摘要会让文档在更多无关问题中被召回。
关键词:为术语和精确检索提供锚点
关键词适合保存产品名、协议名、错误码、配置项和领域术语。它们不应该只是摘要里出现频率最高的普通词。
例如“配置”“系统”“使用”几乎没有区分度;keepAliveSeconds、TLS、QoS、自动重连 才是能帮助检索和过滤的术语。
可回答问题:缩短“用户问法”和“文档写法”的距离
文档通常使用陈述句和章节标题,用户则使用疑问句。预生成可回答问题,相当于为每份文档建立几个面向用户语言的入口。
它最适合以下场景:
- 标题使用内部术语,用户使用业务口语;
- 一个文档覆盖多个具体任务;
- 关键答案只占长文档中的一小节;
- 用户问题经常以“怎么配”“为什么失败”“是否支持”出现。
但问题列表不是越多越好。如果给每份文档生成几十个宽泛问题,不同文档会共享大量相似问法,反而造成召回污染。
三、设计一个可版本化的 Metadata Schema
语义元数据不是塞进一个 Map<String, Object> 就结束。至少要记录生成来源、模型、提示词版本和内容版本,否则以后很难回答“这个关键词是谁生成的”“模型升级后哪些文档需要重跑”。
public record SemanticMetadata(
        String documentId,
        String sourceHash,
        String summary,
        List<String> keywords,
        List<String> answerableQuestions,
        String modelId,
        String promptVersion,
        String schemaVersion,
        Instant generatedAt,
        MetadataStatus status,
        List<String> warnings) {
}
推荐使用下面的幂等键:
idempotencyKey = SHA-256(
  sourceHash + modelId + promptVersion + schemaVersion
)
源文档没有变化、模型和提示词也没有变化时,批任务可以直接复用结果;任何一项变化,都能明确触发重新生成,而不是凭更新时间猜测。
字段本身也要有约束:
| 字段 | 建议约束 | 主要风险 |
|---|---|---|
summary | 1–3 句,包含主题与边界 | 空泛、过度推断 |
keywords | 5–10 个,去重并规范大小写 | 普通词、同义词堆积 |
answerableQuestions | 3–6 个,必须能由原文回答 | 生成原文不存在的问题 |
warnings | 保存缺少上下文、内容过短等问题 | 静默接受低质量结果 |
四、用 Spring AI 构建增强流水线
Spring AI 的 ETL 把文档处理拆为 Reader、Transformer 和 Writer。官方还提供 KeywordMetadataEnricher 与 SummaryMetadataEnricher,说明元数据增强本身就是一个转换步骤,而不是检索时临时拼接的字符串。
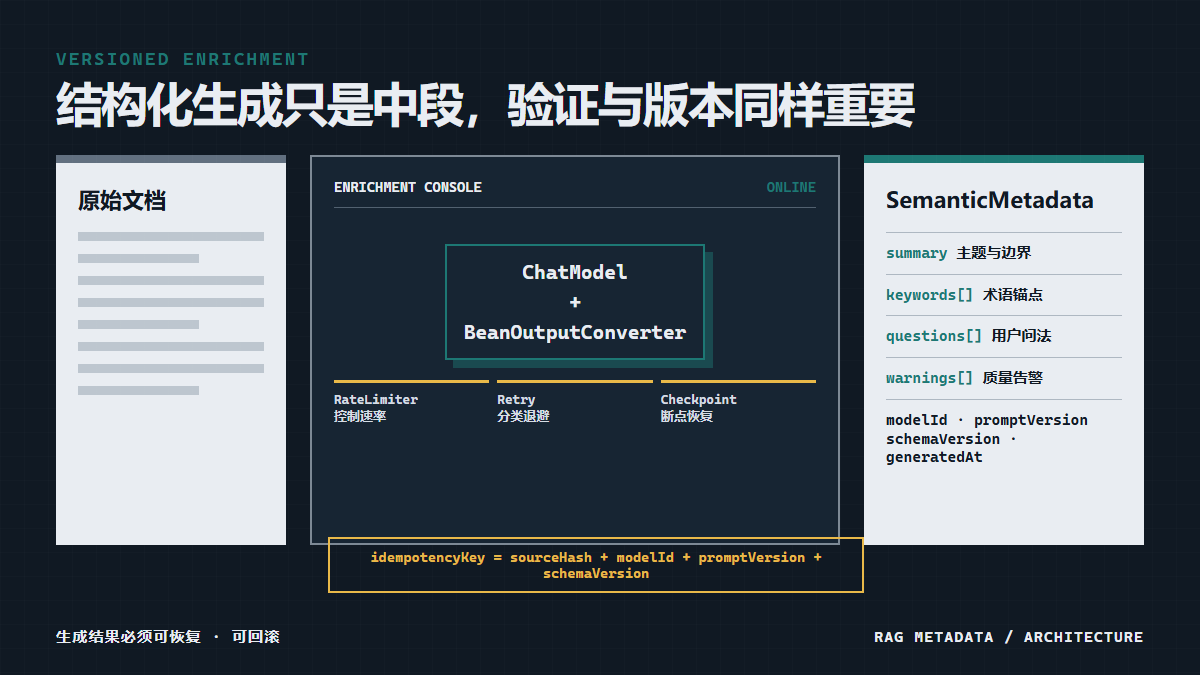
如果需要同时输出摘要、关键词和问题列表,最好使用结构化输出,让模型响应能够直接映射为 Java 类型:
public record EnrichmentResult(
        String summary,
        List<String> keywords,
        List<String> answerableQuestions,
        List<String> warnings) {
}
调用层的核心不是写一段特别长的 Prompt,而是把输入、输出和证据边界写清楚:
String instruction = """
你是企业文档检索元数据生成器。
只能依据给定文档生成结果,不补充外部事实。

要求:
1. summary 用 1-3 句话说明主题、任务和边界;
2. keywords 输出 5-10 个有区分度的术语;
3. answerableQuestions 输出 3-6 个原文能够直接回答的问题;
4. 原文无法支持的内容不要生成,并写入 warnings。

%s
""".formatted(converter.getFormat());

EnrichmentResult result = chatClient.prompt()
        .system(instruction)
        .user(documentText)
        .call()
        .entity(EnrichmentResult.class);
StructuredOutputConverter 或 BeanOutputConverter 能提供结构化格式说明并完成映射,但它不等于业务验证。JSON 能成功反序列化,只说明格式合法,不说明问题真的能由原文回答。
因此增强后还要做一层确定性检查:
public ValidationResult validate(EnrichmentResult value, ParsedDocument source) {
    var warnings = new ArrayList<String>();

    if (value.summary().length() < 20) warnings.add("summary_too_short");
    if (value.keywords().size() < 5) warnings.add("keywords_too_few");
    if (value.answerableQuestions().stream().distinct().count()
            != value.answerableQuestions().size()) {
        warnings.add("duplicate_questions");
    }
    return new ValidationResult(warnings.isEmpty(), warnings);
}
更严格的系统还可以增加“答案证据校验”:让模型为每个问题返回原文证据片段,再检查证据是否确实存在于源文档。这样能挡住“问题听起来合理,但原文其实没有答案”的情况。
五、批量生成必须解决的六个工程问题
逐份调用模型看起来只是一个循环,真正跑到成百上千份文档时,会立刻遇到六个问题。
1. 限流
模型服务通常有请求频率和 Token 配额。并发线程数不等于可用吞吐量,盲目开线程只会制造大量 429。Resilience4j RateLimiter 可以按周期发放许可,把服务端限制显式写进客户端。
2. 重试分类
网络抖动、服务暂时不可用可以退避重试;输入超长、鉴权失败、Schema 校验失败通常不应原样重试。Resilience4j Retry 支持按异常类型和结果决定是否重试,也支持指数退避。
RetryConfig config = RetryConfig.custom()
        .maxAttempts(3)
        .intervalFunction(IntervalFunction.ofExponentialBackoff(500, 2.0))
        .retryExceptions(IOException.class, TimeoutException.class)
        .ignoreExceptions(InvalidDocumentException.class,
                AuthenticationException.class)
        .build();
3. 断点续传
不要把“每处理 10 条写一次进度”当成固定答案。更稳的方式是每份文档都持久化状态:PENDING/RUNNING/SUCCEEDED/FAILED/QUARANTINED,批任务从未完成状态恢复。提交粒度可以批量,但状态必须可追踪。
4. 幂等
任务重启可能让同一文档再次执行。以 sourceHash + 生成配置版本 建唯一键,写入时使用 upsert 或唯一约束,避免重复记录和重复向量。
5. 成本预算
入库前先统计文档长度分布,估算输入 Token、输出 Token 和调用次数。超长文档需要先按章节生成局部摘要,再合成文档级摘要;不能把所有内容直接塞给模型后祈祷不超窗。
6. 可观测性
至少记录模型 ID、提示词版本、输入长度、输出长度、耗时、重试次数、状态和错误类型。只保存最终摘要,出了问题几乎无法排查。
六、Question Metadata、HyDE 与 Query Rewrite 的边界
这三个概念经常混在一起,实际上发生时间和处理对象不同。
Question Metadata:入库时预计算
它从文档生成“该文档能回答的问题”,保存到索引中。查询时可以把用户问题与这些预计算问题做相似度匹配。优点是查询延迟低,缺点是问题覆盖范围受入库时生成质量限制。
HyDE:查询时生成假设文档
HyDE 原始论文的做法是:根据用户查询生成一段假设文档,再将这段假设文档编码,用它在真实语料的向量空间中检索。论文明确指出假设文档可能含有虚构细节,因此它的作用是提供检索表示,不是作为最终答案证据。
Query Rewrite:查询时改写用户问题
它把带指代、口语化或上下文不完整的问题改写成自包含问题。例如把“它的心跳怎么配”改写成“MQTT 采集通道如何配置心跳间隔”。它仍然是查询,不会生成一篇假设答案文档。
可以这样记:
Question Metadata:文档 → 可能的问题(离线)
Query Rewrite:用户问题 → 更清晰的问题(在线)
HyDE:用户问题 → 假设文档 → 检索向量(在线)
三者可以组合,但不应该默认全部开启。Question Metadata 会增加入库成本,Rewrite 和 HyDE 会增加查询延迟。是否启用必须由评测结果决定。
七、如何证明增强真的有效
语义元数据是否有效,不能靠挑几个成功例子。先固定一组问题,并标注每个问题应该命中哪些文档,然后比较不同索引方案。
下面只是一张评测设计示例,不是本文实测数据:
| 实验组 | 索引内容 | 观察指标 |
|---|---|---|
| A | 正文 | Recall@5、MRR、索引大小 |
| B | 正文 + 摘要 | Recall@5、主题型问题变化 |
| C | 正文 + 关键词 | 精确术语问题变化 |
| D | 正文 + 问题元数据 | 用户问法差异大的问题变化 |
| E | 多字段加权组合 | 总体 Recall、误召回与延迟 |
建议把问题按类型分桶:配置步骤、错误码、概念解释、版本差异、跨文档问题。总体 Recall 提升可能只来自某一类简单问题,分桶后才能看出策略真正解决了什么。
还要同时看副作用:
- 索引体积是否明显增加;
- 宽泛摘要是否让无关文档更容易入榜;
- 问题元数据是否出现同质化;
- 模型升级后重建成本是否可接受;
- 元数据与正文冲突时以谁为准。
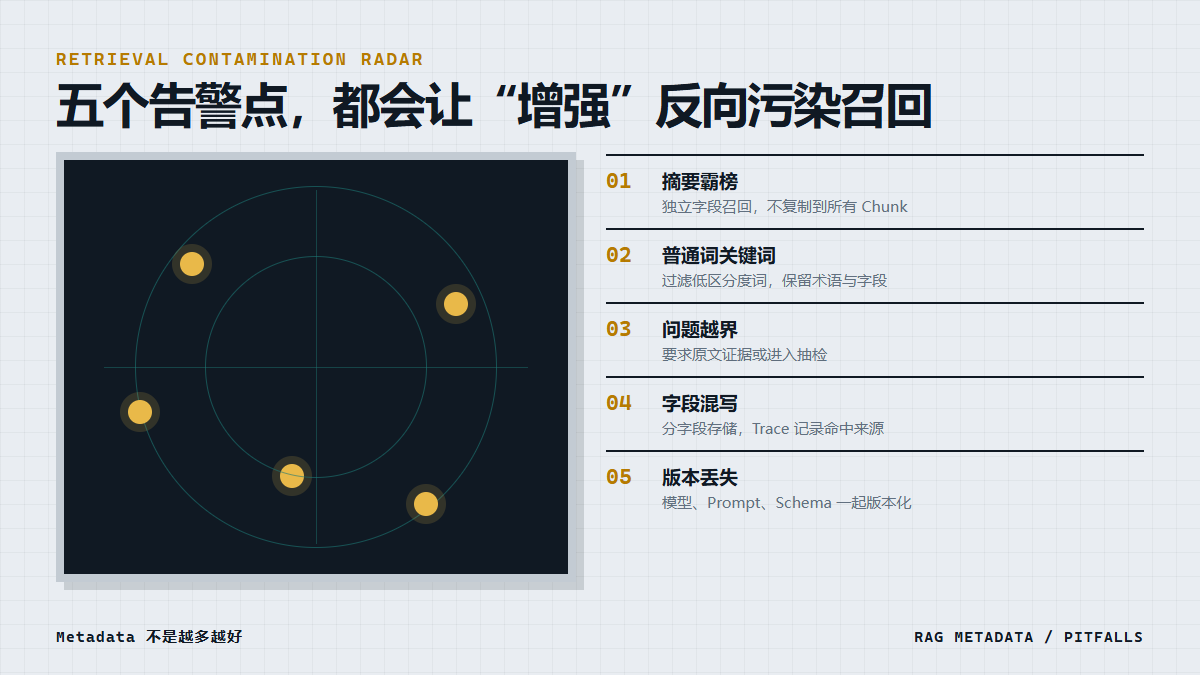
八、最容易踩的五个坑
坑一:把摘要直接拼到每个 Chunk 前面
摘要语义过强,可能在 Top-K 中反复霸榜,把真正含答案的正文块挤出去。摘要适合作为独立字段或独立向量,检索时分路召回和加权,而不是无脑复制到所有块。
坑二:关键词只有热门普通词
“系统、配置、使用、功能”看似正确,实际区分度极低。应过滤停用词,优先保留协议、产品、字段、错误码和动作短语。
坑三:生成的问题超出原文
模型可能根据常识补出“这份文档应该能回答”的问题。必须要求证据,或至少抽样检查问题能否在原文中定位答案。
坑四:混合字段却不记录来源
正文、摘要、关键词和问题混成一段后,检索命中时无法知道究竟是哪一部分起作用,也无法单独调权重。不同字段应分别存储,并在 Trace 中记录召回来源。
坑五:模型和 Prompt 升级没有版本
没有 modelId/promptVersion/schemaVersion,就无法判断新旧元数据是否混用,也无法安全回滚。元数据也要像代码和数据库 Schema 一样版本化。
九、面试时怎么讲这个设计
一个有工程含量的回答可以这样组织:
文件名、路径等物理元数据主要用于权限、版本和过滤,不能覆盖用户问法。我在入库阶段增加摘要、领域关键词和可回答问题三个语义字段,并记录模型、Prompt、Schema 与源文档 Hash。批任务通过限流、分类重试、断点状态和幂等键保证可恢复;效果通过固定问题集比较正文索引与多字段索引的 Recall@K,同时监控误召回和索引成本。
如果面试官继续追问,就可以展开:为什么摘要不能复制到所有 Chunk、Question Metadata 和 HyDE 有什么区别、模型输出如何验证、元数据升级如何重建。每个问题都有明确的数据结构和流程,而不是停留在“调用大模型生成标签”。
落地检查表
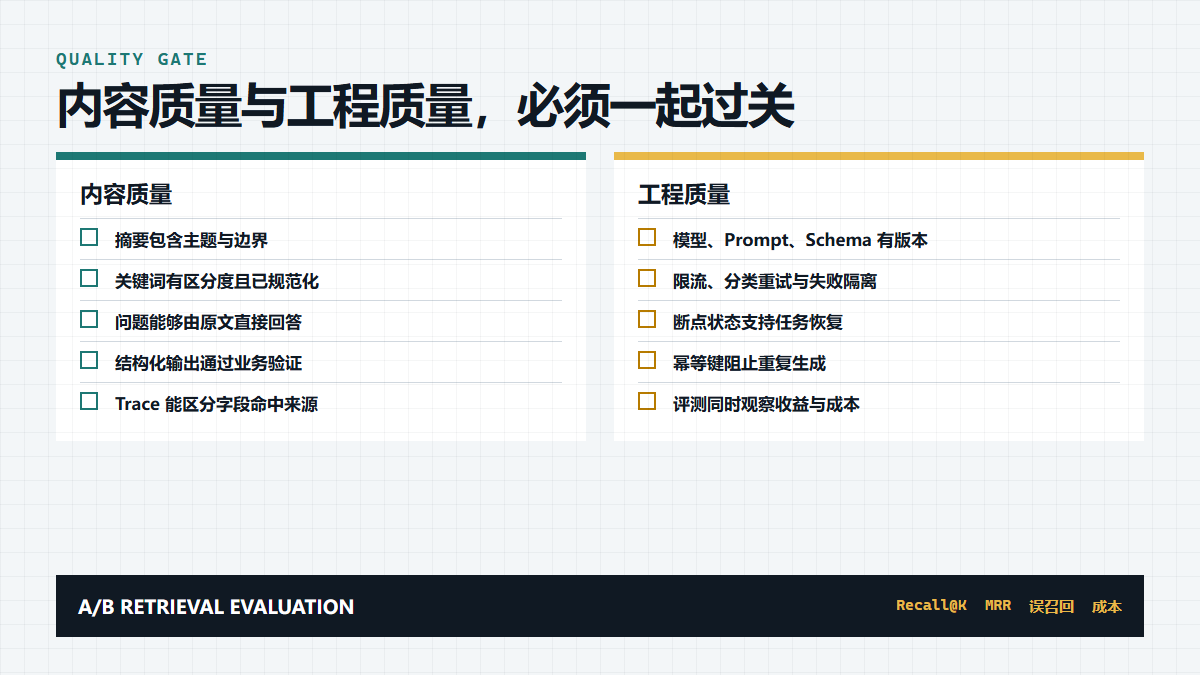
- 物理字段与语义字段分开存储、分开追踪;
- 摘要包含主题和边界,不写空泛套话;
- 关键词去重、规范化并过滤普通词;
- 每个可回答问题都有原文证据或抽检记录;
- 结构化输出还要经过业务规则验证;
- 模型、Prompt、Schema 和源文档均有版本标识;
- 批任务具有限流、分类重试、断点和隔离状态;
- 幂等键能够阻止重复生成与重复写入;
- 用固定评测集比较 Recall@K、误召回、延迟和索引成本;
- Trace 能区分命中正文、摘要、关键词还是问题字段。
总结
语义元数据的价值,是在文档和用户之间增加一层稳定、可管理的检索接口。摘要负责主题入口,关键词负责术语锚点,可回答问题负责用户问法映射;物理元数据则继续承担权限、版本和范围过滤。
真正困难的部分不是生成三组字符串,而是让它们结构化、可验证、可版本化、可批量恢复,并通过评测证明收益大于成本。做到这些,元数据增强才是检索系统的一部分,而不是给文档贴几张看起来聪明的标签。
参考资料

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 11
 0
- 0


 已为社区贡献1条内容

所有评论(0)