X-AnyLabeling 软件数据标注使用指南
本文以「暹罗猫」目标检测任务为例,介绍如何使用 X-AnyLabeling 完成图像数据集的 手动标注 与 AI 自动标注,并导出为主流训练框架所需的 YOLO 或 Pascal VOC 格式。
目录
一、手动标注暹罗猫
1. 打开待标注的图片文件夹
启动 X-AnyLabeling 后,点击左侧菜单 「Open Dir」,选择需要标注的图片所在文件夹,软件会自动加载文件夹下的全部图片。
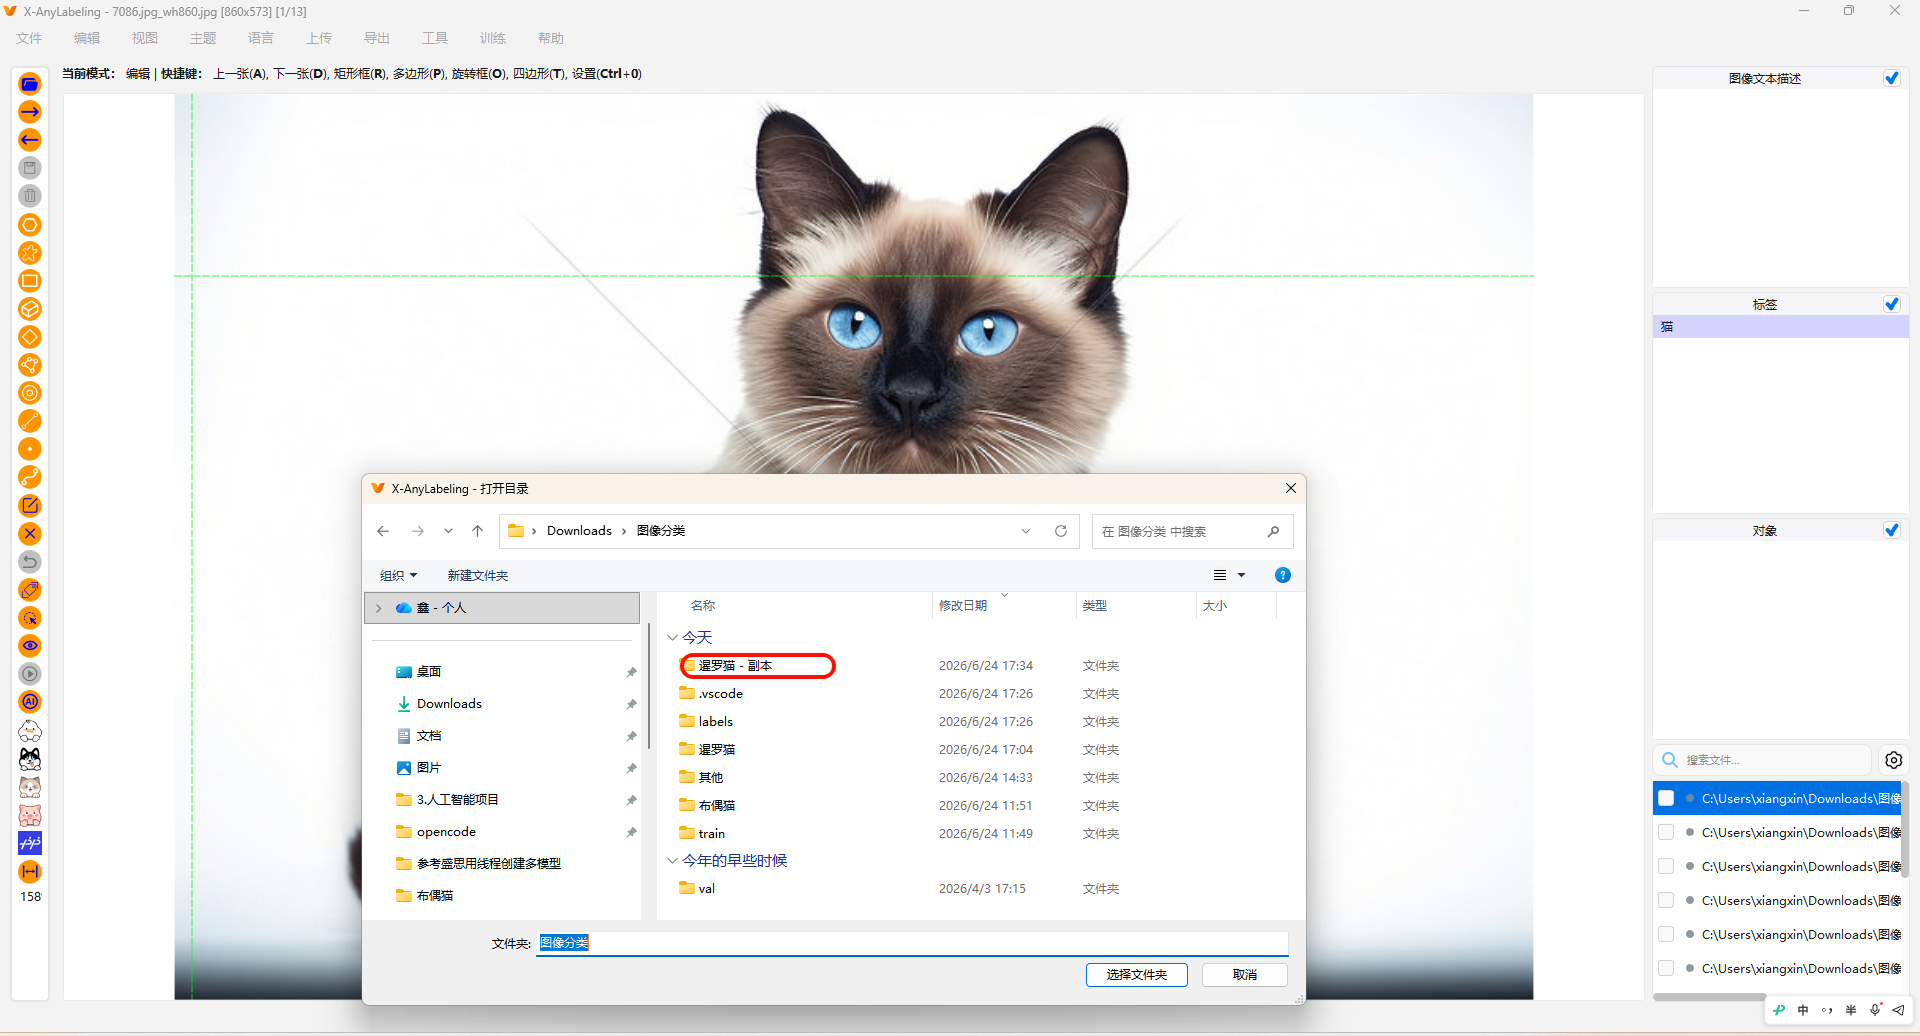
图 1-1 打开待标注的图片文件夹
2. 使用快捷键进行框选标注
X-AnyLabeling 提供了丰富的快捷键,常用的有:
| 功能 | 快捷键 |
|---|---|
| 上一张图片 | A |
| 下一张图片 | D |
| 矩形框标注 | R |
| 多边形标注 | P |
| 旋转框标注 | O |
| 四边形标注 | T |
| 打开设置 | Ctrl + 0 |
操作流程:
- 按下
R进入 矩形框标注 模式; - 用鼠标拖拽框选出猫的身体区域,并填写类别名称(如
cat); - 按
D切换到下一张图片,重复以上步骤。
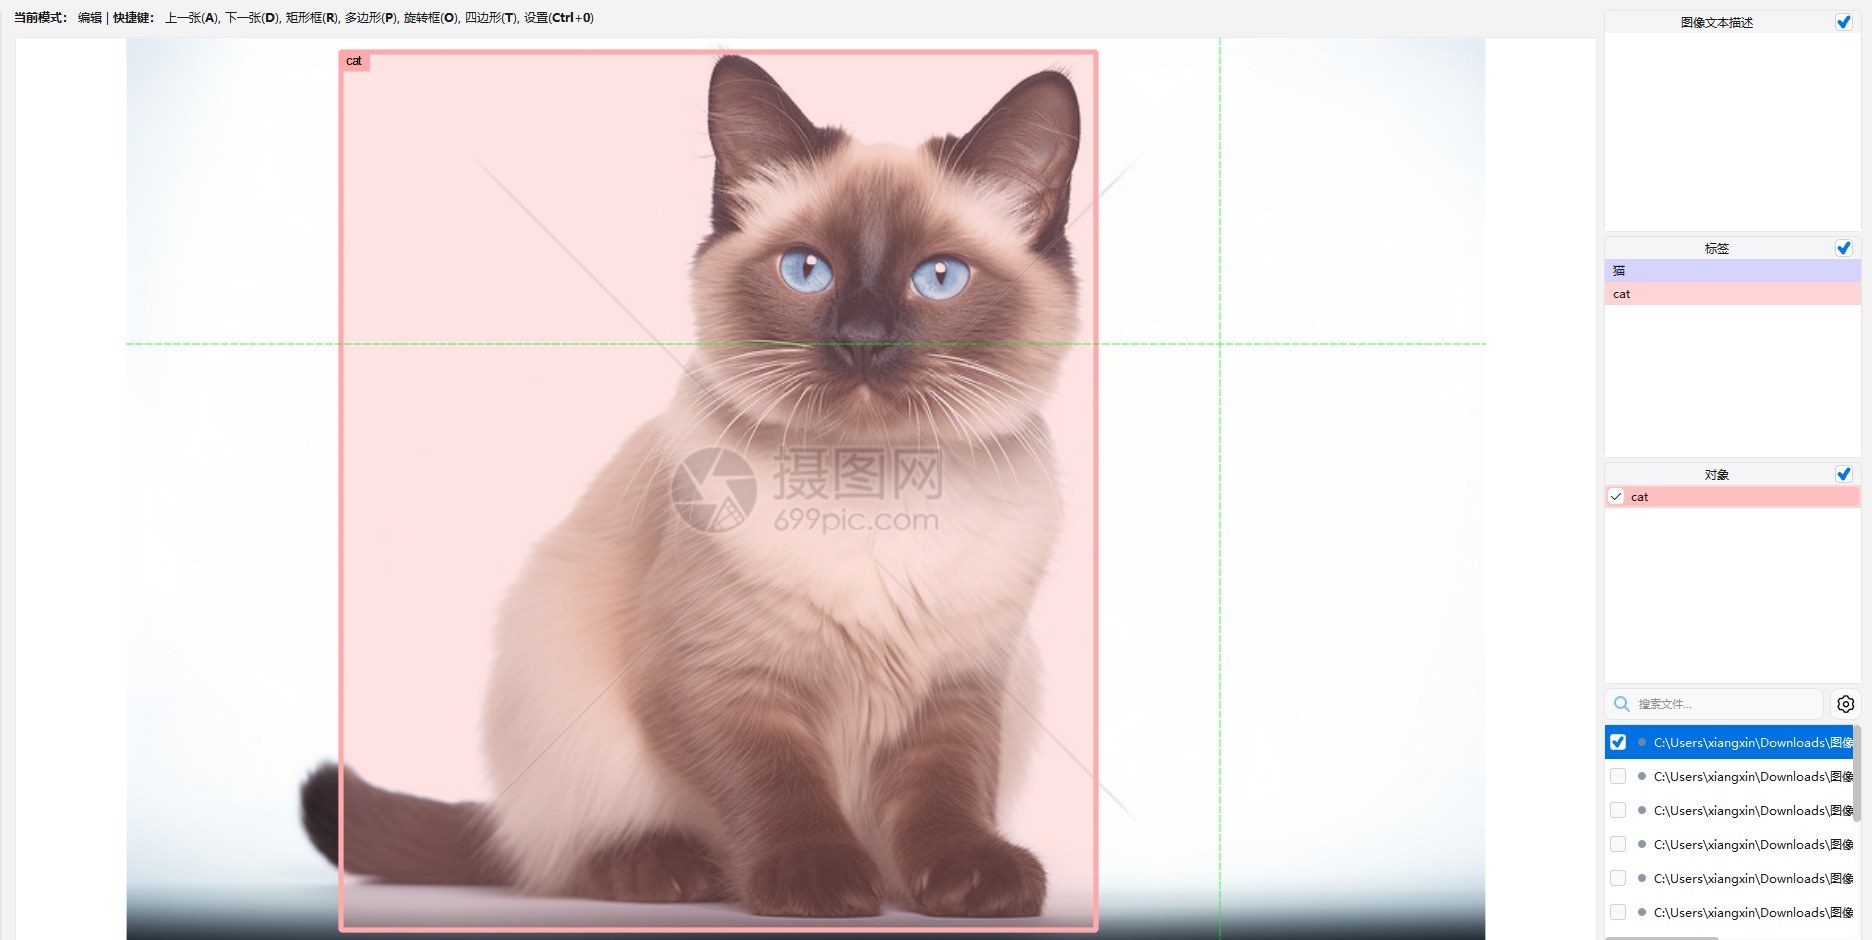
图 1-2 使用矩形框标注暹罗猫
3. 准备类别文件 classes.txt(关键步骤 ⚠️)
在导出 YOLO 或 VOC 格式之前,务必先准备一个 classes.txt 文件:
- 每行写入一个类别名称;
- 顺序必须与标注时使用的类别顺序完全一致,否则导出的标签索引会错乱;
- 该文件在导出时会被引用,也可以提前导入到软件中。
本示例中类别只有 猫 和 cat,因此 classes.txt 内容如下:
猫
cat
💡 提示:建议英文类别名优先,避免训练框架在读取中文时出现编码问题。
4. 导出标注结果
X-AnyLabeling 支持导出主流标注格式,常用的两种结构如下:
📁 Pascal VOC 格式(.xml)
📦 my_dataset
├── 📁 images
│   ├── 0.jpg
│   ├── 1.jpg
│   └── ...
├── 📁 xml
│   ├── 0.xml
│   ├── 1.xml
│   └── ...
└── labels.txt(可选)
📁 YOLO 格式(.txt)
📦 dataset
├── 📁 images
│   ├── 📁 train
│   │   ├── image1.jpg
│   │   ├── image2.jpg
│   │   └── ...
│   └── 📁 val
│       ├── image3.jpg
│       ├── image4.jpg
│       └── ...
├── 📁 labels
│   ├── 📁 train
│   │   ├── image1.txt
│   │   ├── image2.txt
│   │   └── ...
│   └── 📁 val
│       ├── image3.txt
│       ├── image4.txt
│       └── ...
└── data.yaml
导出操作步骤
Step 1. 点击菜单栏的 「Export」,选择 YOLO 格式,并加载刚刚准备好的 classes.txt 文件:
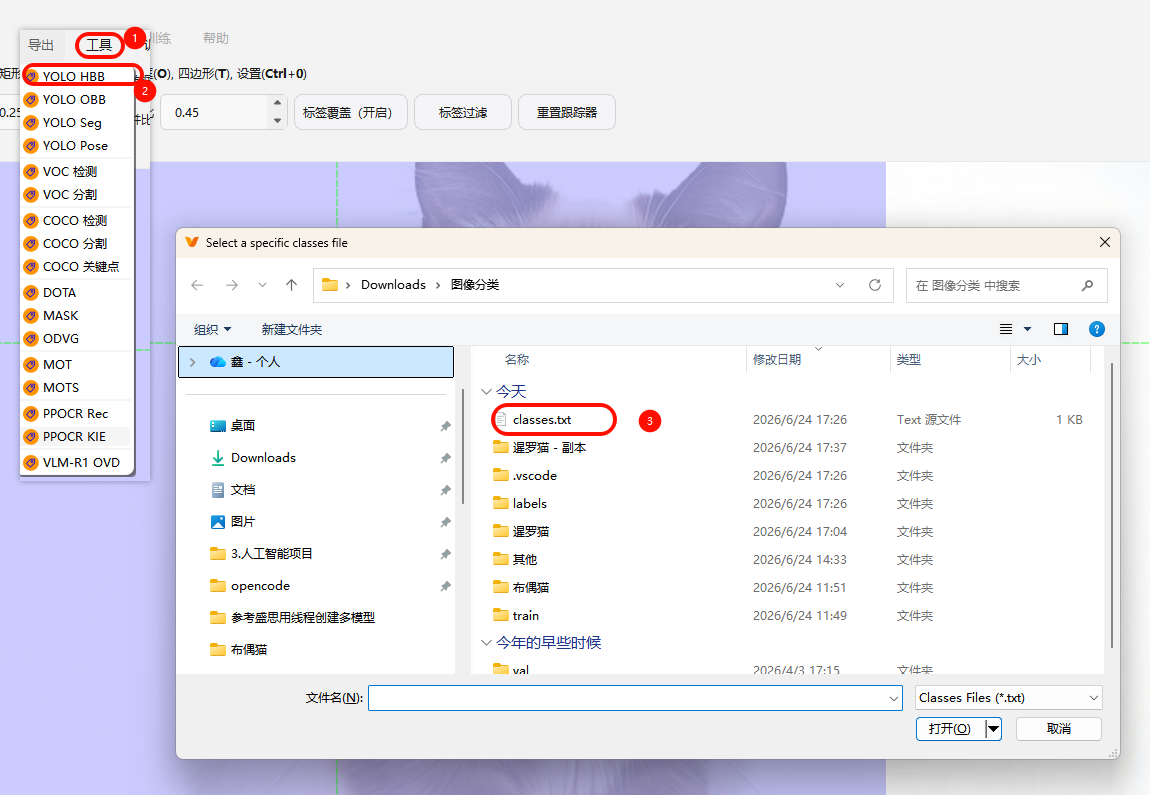
图 1-3 选择 YOLO 格式并加载 classes.txt
Step 2. 选择导出目录,点击 「确认」:
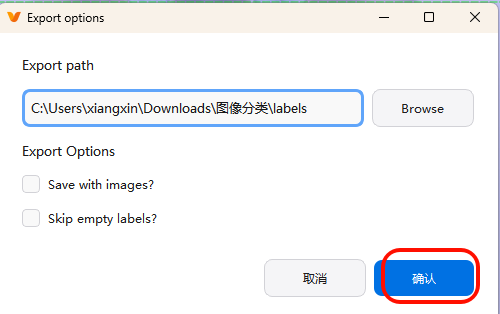
图 1-4 选择导出文件夹
Step 3. 导出成功后,目标文件夹下将生成与图片同名的 .txt 标注文件,每个文件中保存了 YOLO 训练所需的标签信息(类别索引 + 归一化坐标):
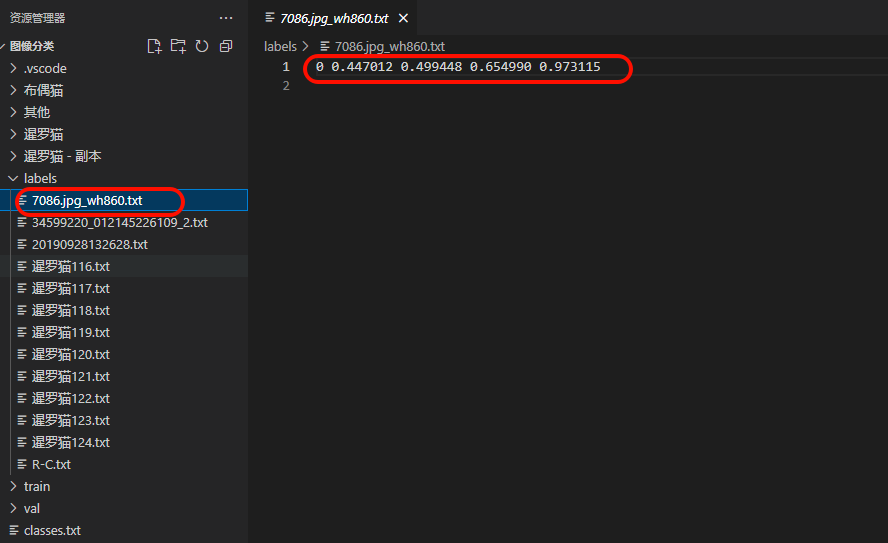
图 1-5 导出成功的 YOLO 标注文件
✅ 至此,手动标注流程全部完成,可以将该数据集直接用于 YOLO 系列模型的训练。
二、AI 自动标注暹罗猫
对于数据量较大的场景,手动标注效率较低。X-AnyLabeling 集成了多种预训练模型,支持 一键 AI 自动标注,可极大地提升效率。
1. 下载 AI 模型
点击工具栏中的 「AI」 按钮,在模型列表中选择 YOLOv9c,点击下载并等待加载完成:
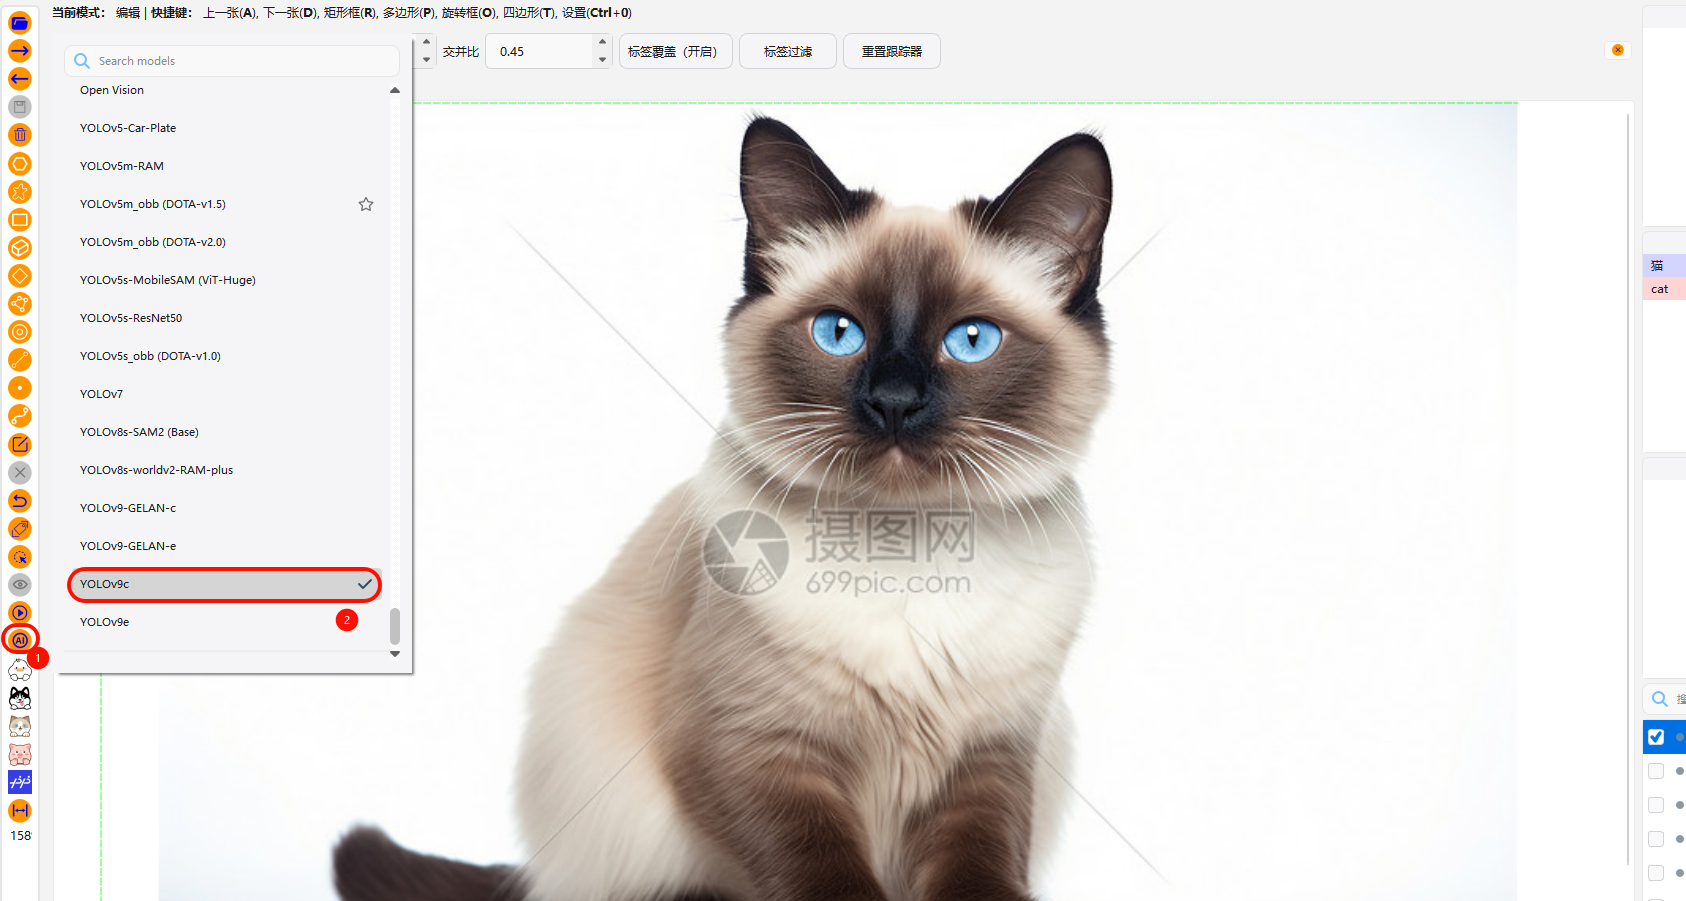
图 2-1 下载 YOLOv9c 预训练模型
2. 运行自动标注
模型加载完成后,点击 「Run (i)」 按钮,软件会自动对当前图片进行推理并生成标注框,效果如下:
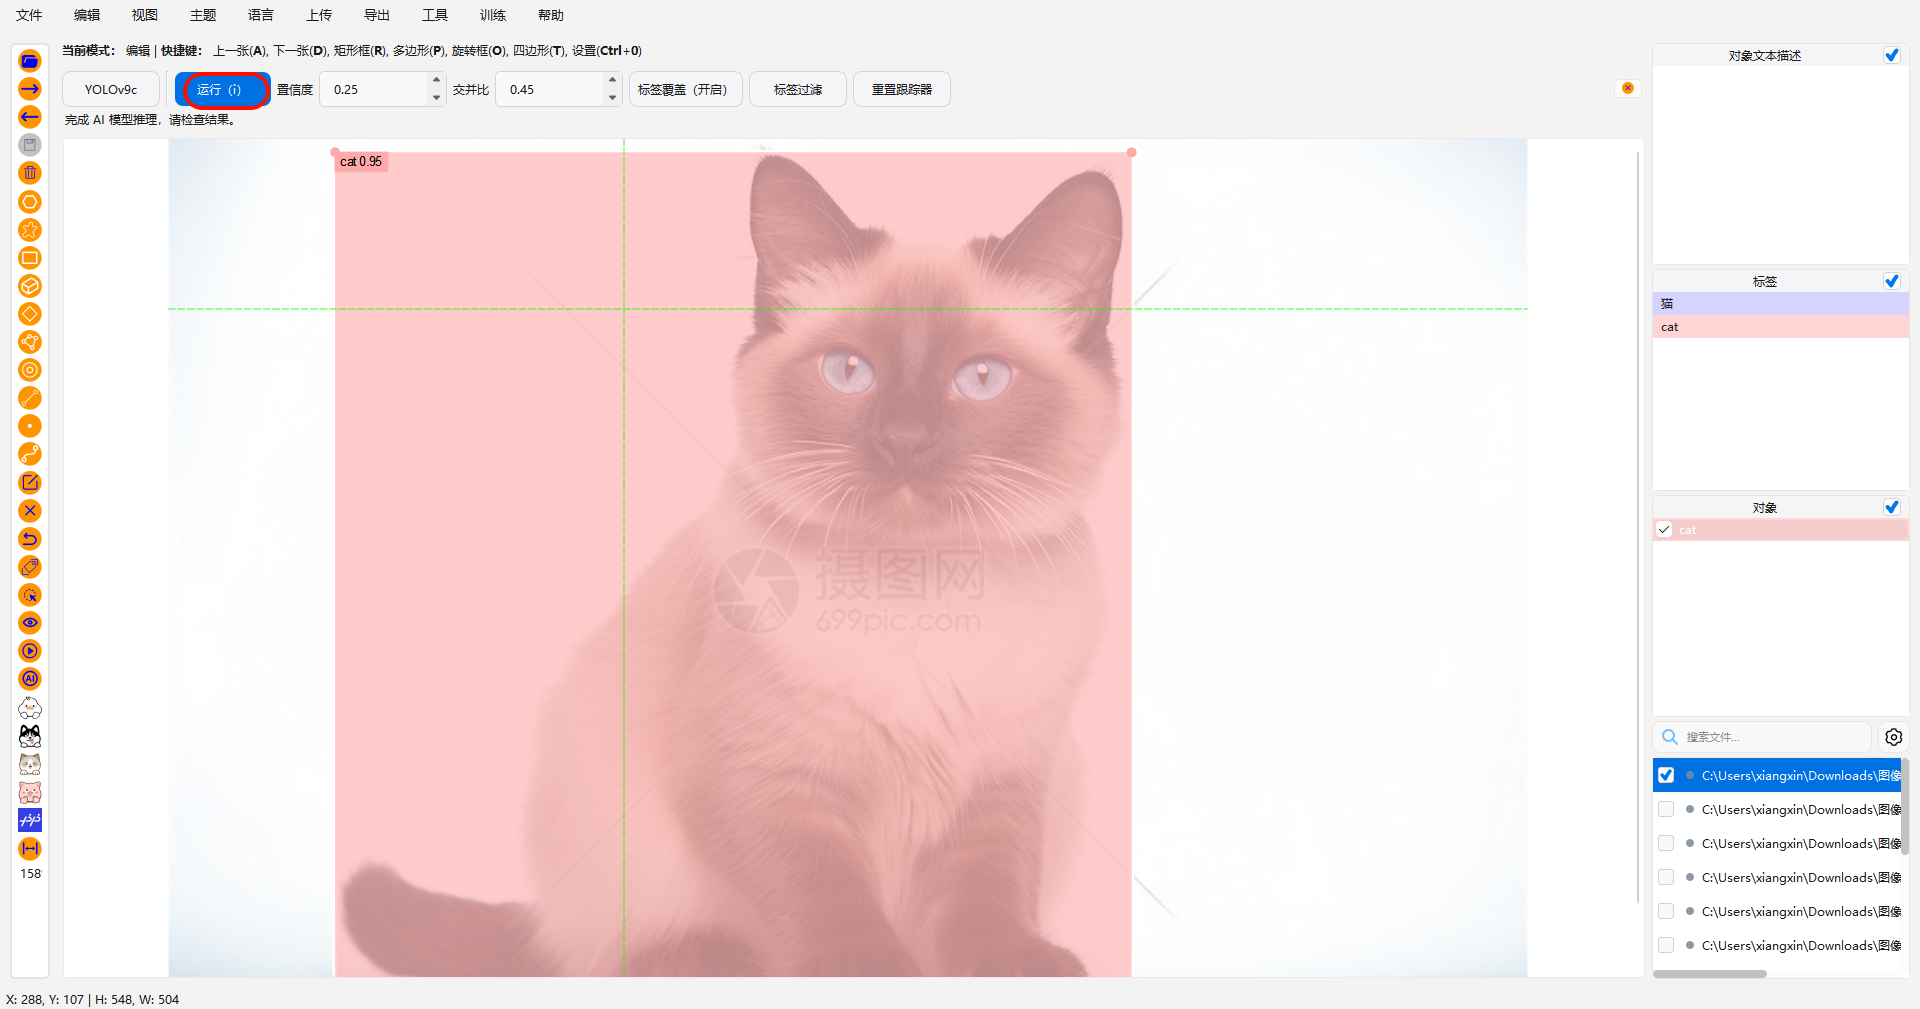
图 2-2 AI 自动标注结果
💡 建议:AI 自动标注的结果可能存在误检或漏检,建议在自动标注完成后人工复核与微调,以确保数据集质量。
三、常见问题与建议
- 类别顺序错乱:导出后训练时类别错位,多数是因为
classes.txt顺序与标注顺序不一致,请务必核对。 - 中文类别问题:部分训练框架(如官方 YOLO)对中文支持较弱,推荐使用英文类别名(例如
cat)。 - 批量自动标注:如需对整个文件夹批量自动推理,可在 AI 模型设置中开启「Run All Images」选项。
- 数据划分:导出 YOLO 数据集后,建议按 8 : 1 : 1 的比例划分
train / val / test,并维护好data.yaml。 - 备份原始标注:建议保留 X-AnyLabeling 默认生成的
.json标注文件,方便后续重新导出为其他格式。
📌 结语:X-AnyLabeling 同时兼具 手动标注的精准性 和 AI 标注的高效性,是构建高质量目标检测数据集的优秀工具。结合 AI 预标注 + 人工复核的工作流,可以显著降低数据标注成本。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 6
 0
- 0


 已为社区贡献2条内容

所有评论(0)