从手动搜集到自动化管道:我的数据基建演进之路
去年团队决定做一个垂直领域的内容分析产品,核心功能是聚合特定行业的公开资讯和动态,然后用自然语言处理技术提供摘要和洞察。听起来是个不错的方向,但实际开发的头两周全耗在了一件事上——数据从哪里来。
我们需要的不是一两个网站的数据,而是覆盖几十个信源、多语种、并且持续更新的信息流。手动搜集显然不现实,写脚本去挨个请求页面也面临几个很现实的问题:
- 很多网站对请求频率有严格控制,频繁访问很容易出现问题
- 页面结构各不相同,解析规则需要逐个适配
- 有些站点限制了非本地网络的访问,直接请求拿不到完整内容
- 数据格式不统一,后续清洗处理的工作量巨大
开始的时候,我们采用了比较原始的方式:团队成员分工,每天手动从各个网站复制粘贴关键信息到共享文档里。这种方式在数据量很小的时候还能勉强应付,但信源增加到十几个之后,根本吃不消。每天光整理数据就要花掉一个全职人力,而且出错率很高。
后来我写了一个简单的采集脚本,跑在自己的开发机器上,定时抓取配置好的 URL 列表。但问题接踵而至——运行几天后 IP 就被限制了,频繁出现验证页面和连接超时。又花了好几天时间折腾各种解决方案,试了轮换策略、加了延迟控制、换了好几种网络出口,效果依然不理想。
找到合适的工具组合
转机出现在我开始认真看待"数据基础设施"这件事之后。之前总觉得数据获取是开发中不值一提的环节,随便写个脚本就行了。但实际经验告诉我,当你需要持续、稳定地获取多源公开信息时,这件事的复杂度和开发一个普通接口几乎不同。
我重新梳理了需求,发现核心痛点集中在三个层面:
1、是网络层。请求来源的 IP 属性会影响目标平台的响应——住宅属性的节点更容易通过访问策略,而数据中心 IP 则容易被不允许通过。
2、是解析层。每个网站的页面结构不同,而且可能随时变化,维护解析逻辑的代价很高。
3、是管理层面。数据量大了之后,需要有任务调度、失败重试、数据格式统一这些功能。
针对这三个痛点,我逐步搭了一套组合方案:
网络层,使用了 Dataify 的动态住宅网络。它的节点池覆盖了全球多个国家和地区,而且节点来自真实的住宅网络环境,请求看起来和普通用户访问没有区别,大大降低了被限制的概率。同时我配合了他们的静态 ISP 网络来处理需要保持登录态的任务,两种资源的差异化配置让整体稳定性提升了不少。
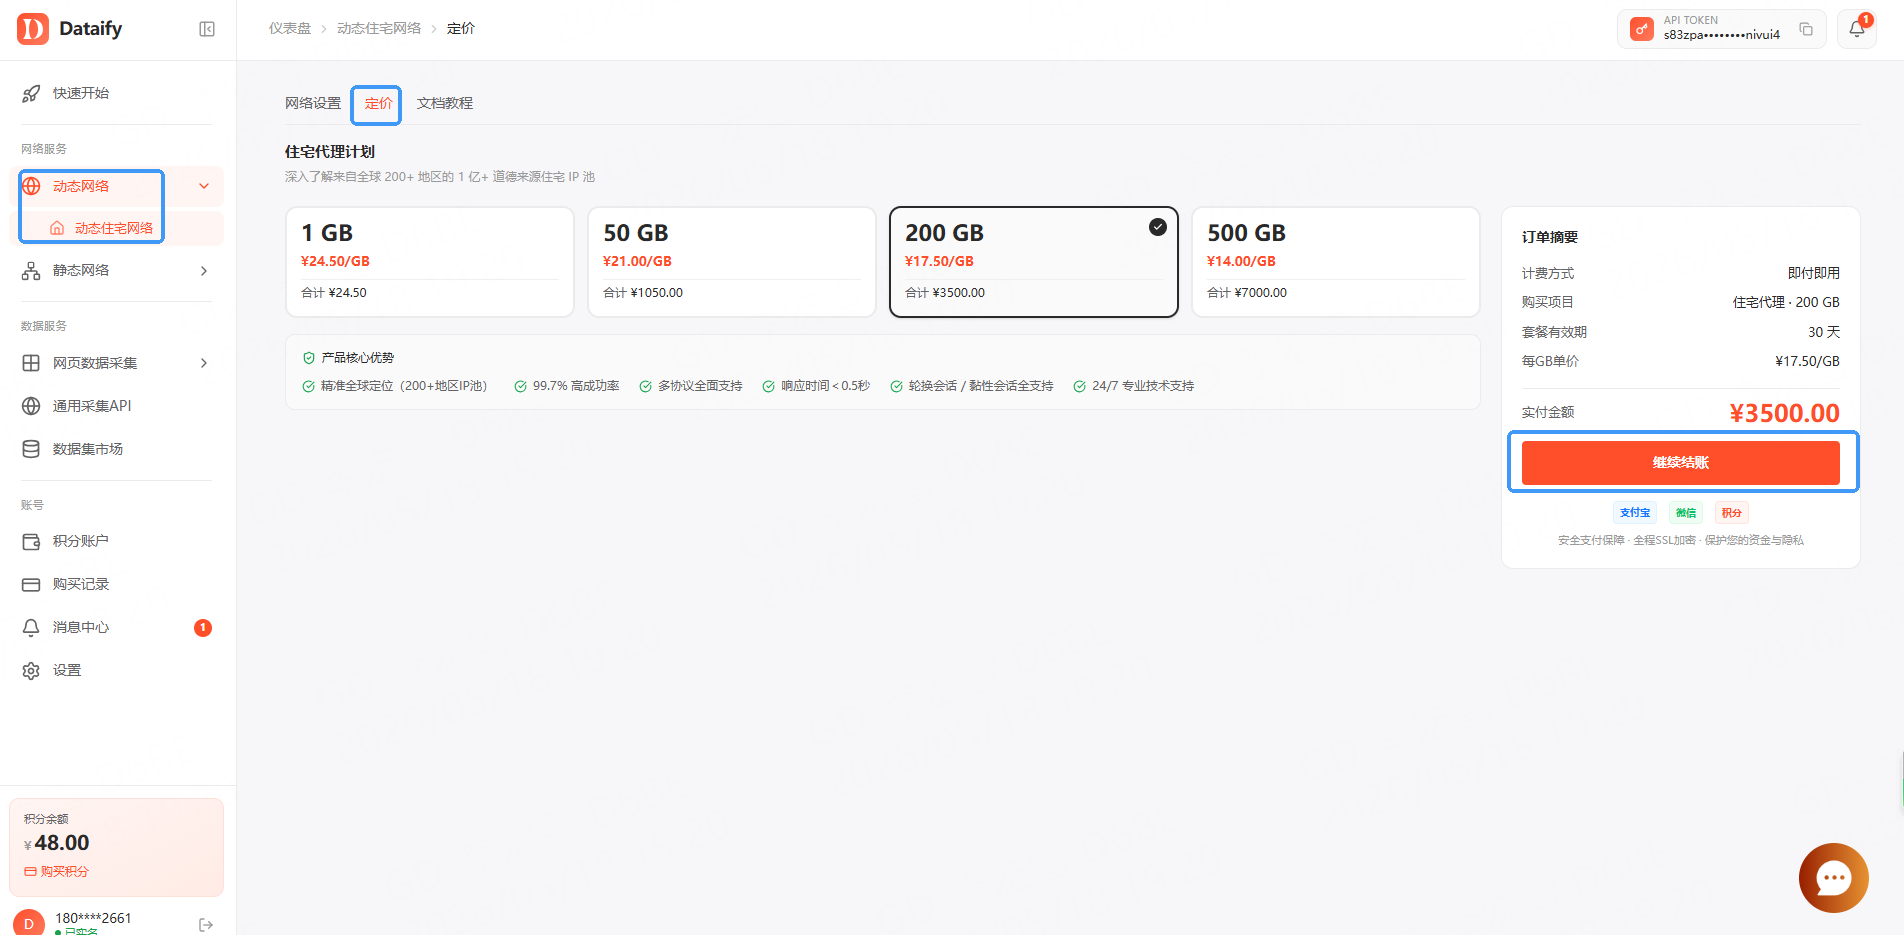
解析层,对于结构比较固定的信源,直接用了 Dataify 的网页采集 API。只需要传递目标 URL 和想要提取的字段,API 会返回结构化的 JSON 数据,省去了自己写页面解析逻辑的工作量。
管理层,在 API 之上封装了一层简单的调度服务,管理任务队列、定时触发和结果存储。流程图大概是这样的:
任务配置(YAML/JSON)
      ↓
任务调度器(定时触发 + 失败重试)
      ↓
   Dataify API 层
   ├── 网页采集 API(结构化提取)
   ├── 搜索引擎 API(关键词监控)
   └── 住宅网络/ISP(基础设施)
      ↓
   数据存储(数据库 + 对象存储)
      ↓
   业务层(摘要生成、趋势分析…)
一点具体的配置参考
这里分享一个简化的任务配置示例,供有类似需求的朋友参考:
sources:
  - name: "tech_news_us"
    url: "https://example-tech-news.com/latest"
    api_type: "web_scraper"
    fields: ["title", "content", "publish_date", "author"]
    schedule: "0 */6 * * *"   # 每6小时
    network:
      type: "residential"
      country: "US"
  - name: "market_trends_jp"
    url: "https://example-market-jp.com/trends"
    api_type: "universal"
    schedule: "0 0 * * *"     # 每天一次
    network:
      type: "static_isp"
      country: "JP"
这套方案跑起来之后,日处理信源从开始的 5 个扩展到后面的 40 多个,数据获取的成功率保持在 98% 以上,几乎没有因为网络问题导致采集中断。以前需要一个人专门整理数据,现在这部分工作全自动化了,团队可以把精力放在更核心的内容分析和产品功能开发上。
回过头来看,这次经历让我对"数据基础设施"有了新的理解。以前总觉得做数据获取是低技术含量的事情,能跑就行。但实际上,当你需要长期维护一个稳定、高质量的数据管道时,工具选型的合理性和基础设施的可靠性,直接决定了你能多快把想法变成产品。
如果你也在做类似的内容聚合、行业分析或者数据驱动的产品开发,有几点经验可以参考:
一是尽早把网络接入方案纳入技术栈考量,而不是出了问题再补救。二是善用成熟的 API 服务来降低维护成本。三是注重数据源的多样性和质量,单一信源的风险很大。
Dataify 的灵活之处在于,它把网络资源和数据获取 API 打包在了一起,不需要对接多个供应商。对于中小型团队来说,少维护一个第三方就少了一个故障点。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 5
 0
- 0


 已为社区贡献1条内容

所有评论(0)