金仓数据库超过最大连接数处理步骤
问题描述
中午在外面刚吃完饭,就收到客户发来的告警信息,以为只是普通的告警,就没放到心上,结果到办公室登录服务器发现主节点主节点状态不对 。正常的状态下,主节点(primary)的状态应显示为 * running,备节点(standby)的状态应显示为 running。只要不是failed就问题不大。
推测是超过最大连接数,超过最大连接数经常出现的2种场景:
- FATAL: remaining connection slots are reserved for non-replication superuser connections
- sorry, too many clients already
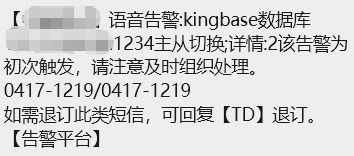
得亏是中午,业务没反馈,只是监控平台推送告警信息。
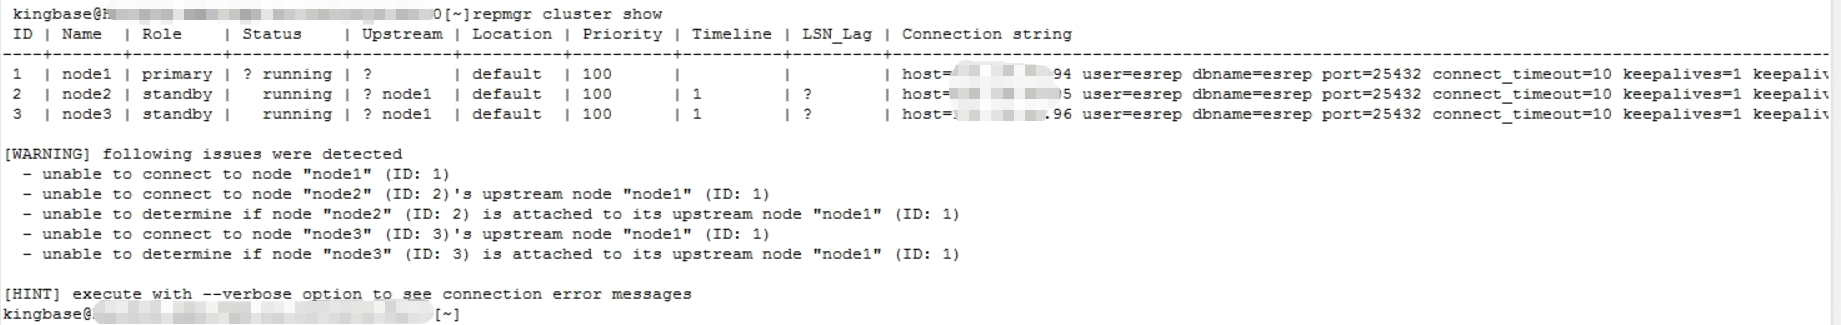
问题原因
金仓数据库(KingbaseES)中与连接数相关的核心参数有两个:
max_connections:数据库允许的最大总连接数(默认 100)。superuser_reserved_connections:为超级用户(如system)预留的连接数(默认 3)。
数据库可用的普通用户连接数计算公式为:
普通用户最大连接数 = max_connections - superuser_reserved_connections
当所有连接(普通用户 + 超级用户)占满 max_connections 时,新连接会收到错误:sorry, too many clients already。
当普通连接数占满了 max_connections 中除预留槽位外的所有名额(即 max_connections - superuser_reserved_connections 已满),但总连接数还没到 max_connections 时,就会收到报错:FATAL: remaining connection slots are reserved for non-replication superuser connections
分析过程
查看集群详细状态(正常节点操作)
强烈建议加上 --verbose参数,可以显示详细报错信息。部分场景下就用不去看数据库日志了。
正常节点操作,故障节点无法查看。
repmgr cluster show --verbose
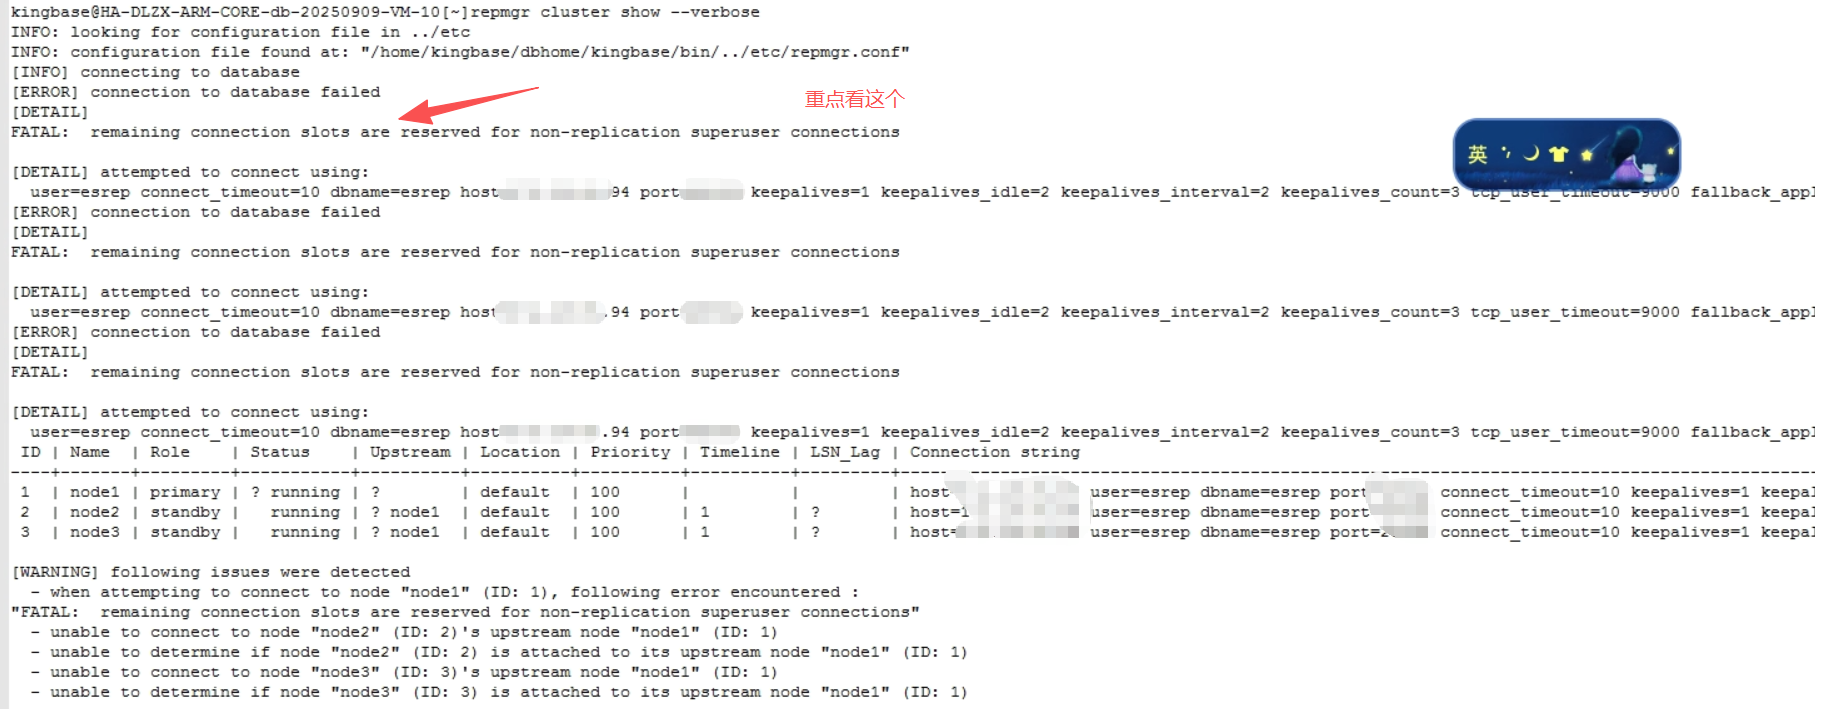
FATAL: remaining connection slots are reserved for non-replication superuser connections
中文翻译是:
“剩余连接槽位已保留,仅供非复制的超级用户连接使用。”
更通俗地解释:
“数据库的普通连接数已满,剩下的连接名额只留给超级用户使用。”
意思是数据库的普通连接数已经达到了上限,无法再接受新的普通用户连接,当前剩余的连接数是专门预留给超级用户使用的。
简单来说,就是连接池“满了”
查询故障节点数据库状态(故障节点)
sys_ctl status -D $DATA
时间关系没有截图,显示running,正常,但是system用户访问还是可以的。暂时未出现所有连接(普通用户 + 超级用户)占满 max_connections 时,新连接会收到错误:sorry, too many clients already。
查询会话数量(正常节点操作)
--使用超级用户连接 因为预留了超级用户连接槽位,即使连接数满了,超级用户也应该能登录成功。
ksql test system

--查看max_connections
show max_connections; --1000

--查会话总数
select count(*) from sys_stat_activity;  ---1003
查询会话状态(正常节点操作)
重点关注 state 为 idle(空闲)的连接。
--查看长会话,发现只有3条记录
select usename,client_addr,pid,pg_blocking_pids(pid) as lock,now()::timestamp-query_start as wait,xact_start,query,state from sys_stat_activity  where state<>'idle'  order by wait desc;

--查看idle会话,共有998条记录,且sql都是重复的的3条记录
select count(*) from sys_stat_activity  where state='idle';

select usename,client_addr,pid,pg_blocking_pids(pid) as lock,now()::timestamp-query_start as wait,xact_start,query,state from sys_stat_activity  where usename='' and query and state='idle'  ;
发现都是select会话,且是重复的3类sql
决定先批量杀会话
批量杀idle状态的会话(正常节点操作)
这个操作会比较“暴力”,请谨慎执行。
批量kill select会话 发现释放的idle会话发现又很快涨上来。
批量杀会话指定业务用户和库和select类的,避免杀掉dml类的sql。若业务同意可以杀掉dml类sql。
尽量用后台脚本,因为记录数太多,规避堡垒机页面容易卡住。
如果批量杀idle状态的会话后会话不再增,可省略后面步骤。
尽量后台跑,效率高一些

nohup ksql test system -p 25432 -c "select sys_terminate_backend(pid) from sys_stat_activity where state='idle' and usename='og_recommand_platform' and datname='recommand_platform' and query like 'select%' and pid<> pg_backend_pid();"
业务变更沟通
和业务沟通得知应用节点新扩容了40个节点,代码中mybatisplus默认连接池最大10个,最小5个
解决办法
为确保生产尽快恢复,将连接数扩容一倍,即从1000扩容到2000。
注意:这个参数修改后需要重启数据库服务才能生效
扩容最大连接数(所有节点)
和客户沟通可以将最大连接数由1000改成2000,并强调需重启集群才生效,应允后开始操作
--使用超级用户登录
ksql test system

--执行以下命令修改参数
ALTER SYSTEM SET max_connections = 2000;

--查询后依然是1000,需要重启集群后生效
SHOW max_connections;
或
更改所有节点数据目录下的es_rep.conf中的max_connections参数 ,如果文件中有多个更改最后一个,排在最后的生效
重启集群
本场景采用主节点即故障节点上操作,先执行批量杀idle状态的会话脚本,然后再重启集群
sys_monitor.sh restart
补充:如果是单点场景,启动数据库步骤是:
# 在数据库服务器上,以 kingbase 用户执行 ,注意将 /path/to/data/directory 替换为你的金仓数据库实际的数据目录路径。

sys_ctl -D /path/to/data/directory restart
查看集群状态
正常的状态下,主节点(primary)的状态应显示为 * running,备节点(standby)的状态应显示为 running。
# 查看集群节点状态
repmgr cluster show

# 查看集群守护进程状态
repmgr service status
确认最大连接数已更改
--使用超级用户登录
ksql test system

查看最大连接数
SHOW max_connections;

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐

 8
 0
- 0


 已为社区贡献8条内容

所有评论(0)