5分钟部署YOLO26镜像,零基础实现目标检测训练与推理
5分钟部署YOLO26镜像,零基础实现目标检测训练与推理
你是否还在为配置深度学习环境而头疼?安装PyTorch版本不对、CUDA不兼容、依赖冲突频发……这些问题让很多刚接触目标检测的新手望而却步。今天,我们带来一个真正“开箱即用”的解决方案——最新 YOLO26 官方版训练与推理镜像。
只需5分钟,无需任何前置知识,你就能在GPU环境下完成模型推理和自定义数据集的训练任务。无论你是学生、开发者还是AI爱好者,这篇文章将手把手带你从启动镜像到跑通完整流程,全程无坑、高效落地。
1. 镜像简介与核心优势
1.1 什么是YOLO26?
YOLO26是Ultralytics团队推出的最新一代目标检测框架,基于YOLO系列持续演进而来。它继承了“一次前向传播完成检测”的高效架构,并在模型结构、损失函数和标签分配机制上进行了多项创新。相比早期版本,YOLO26具备更强的小目标检测能力、更高的精度(mAP)以及更快的推理速度。
更重要的是,YOLO26支持多任务统一建模:不仅可以做目标检测,还能无缝扩展至实例分割、姿态估计等场景,极大提升了工程复用性。
1.2 为什么选择这个镜像?
本镜像基于 YOLO26 官方代码库 构建,预装了完整的深度学习开发环境,集成了训练、推理及评估所需的所有依赖,真正做到“一键部署、立即使用”。
核心亮点:
- 预装PyTorch + CUDA环境:避免手动安装驱动和框架
- 内置常用依赖库:OpenCV、NumPy、Pandas、Matplotlib等一应俱全
- 自带预训练权重文件:无需额外下载即可开始推理或微调
- 支持GPU加速:充分利用显卡算力,提升训练效率
- 结构清晰、操作简单:适合零基础用户快速上手
2. 快速部署与环境准备
2.1 启动镜像
假设你已通过平台(如CSDN星图)成功拉取并运行该镜像,启动后你会看到类似如下界面:
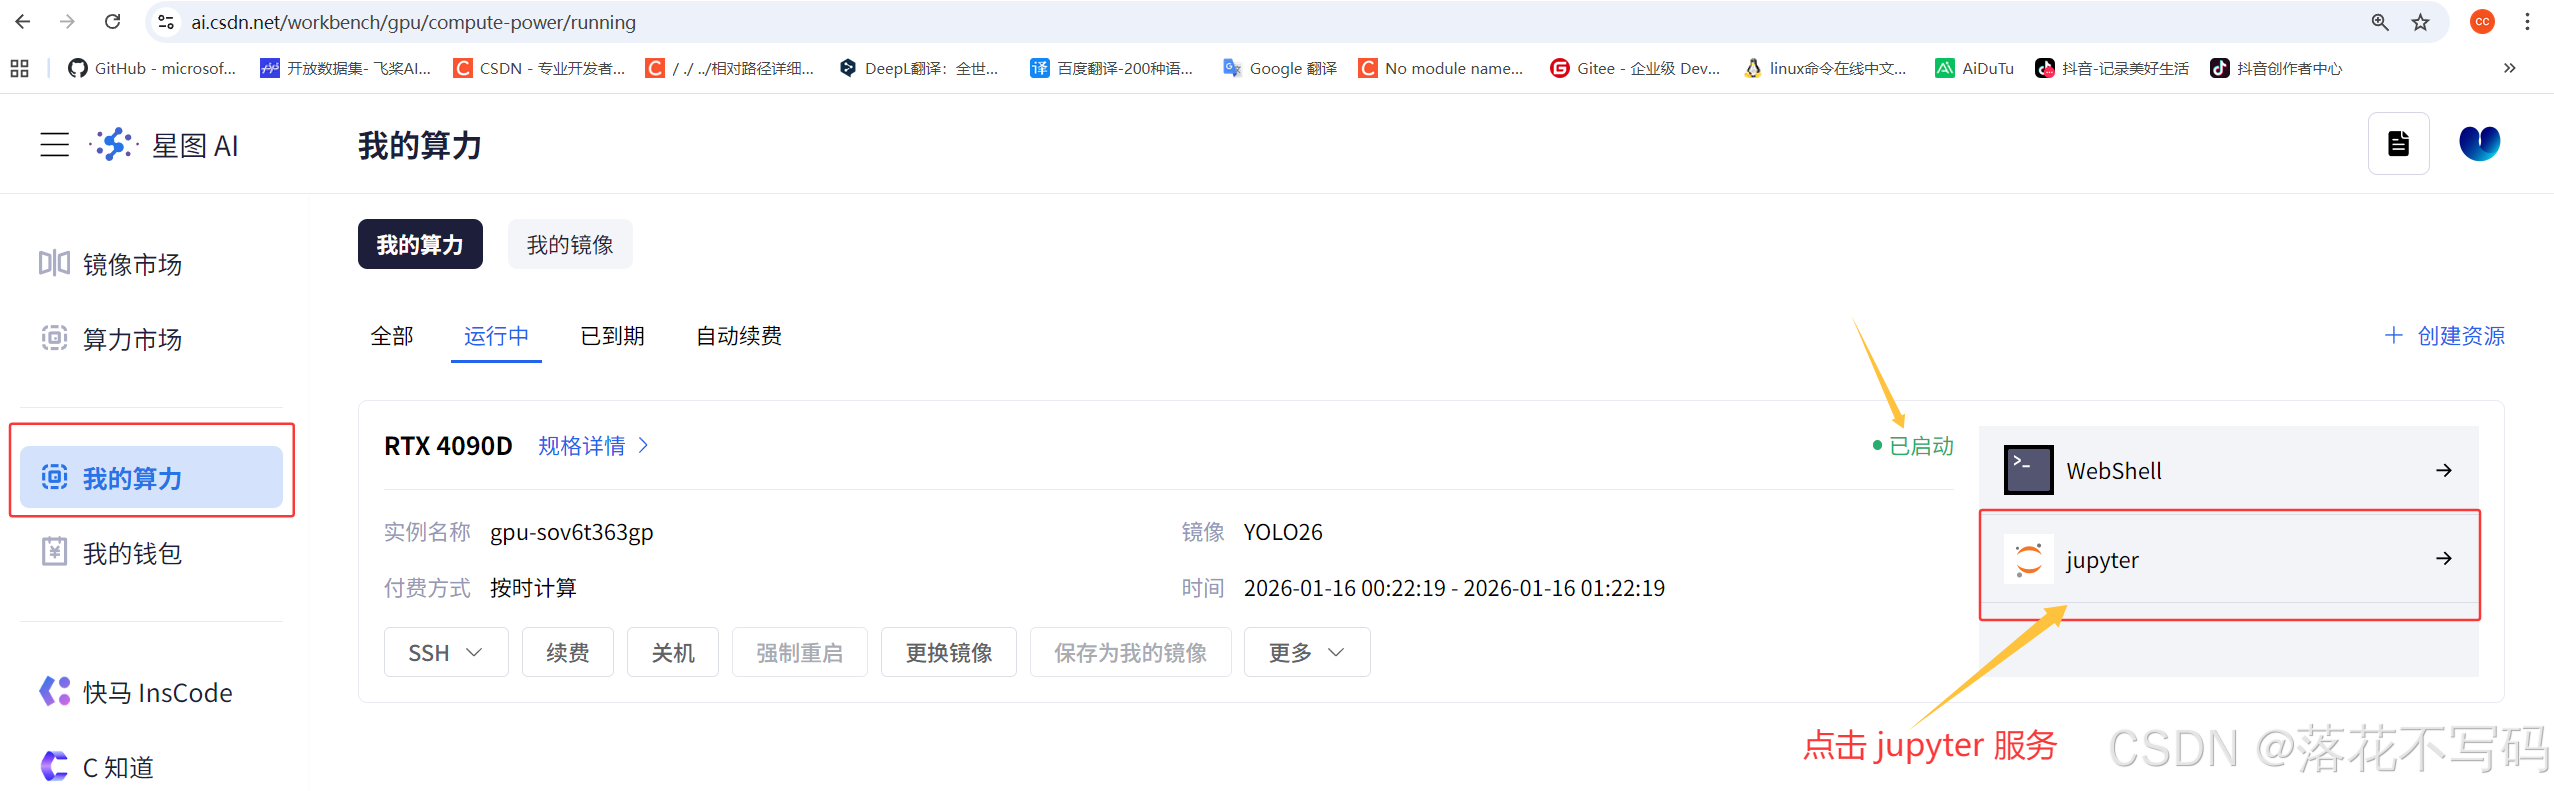
此时系统已经准备好,接下来只需几步即可进入工作状态。
2.2 激活Conda环境
镜像默认进入 torch25 环境,但实际项目需要切换到专为YOLO26配置的 yolo 环境。执行以下命令激活:
conda activate yolo
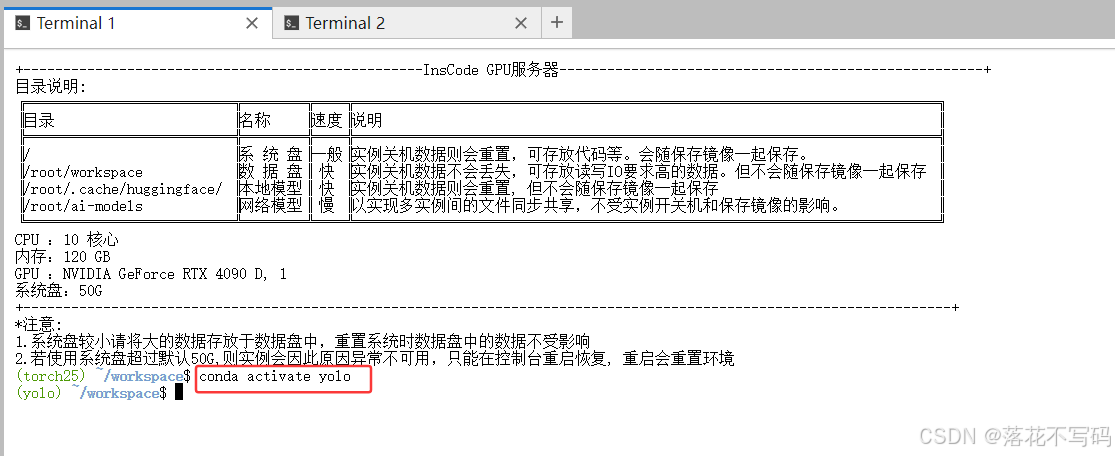
注意:如果不激活此环境,可能会因缺少依赖导致运行失败。
2.3 复制代码到工作目录
镜像中的原始代码位于系统盘 /root/ultralytics-8.4.2,为了方便修改和保存,建议将其复制到数据盘 workspace 目录下:
cp -r /root/ultralytics-8.4.2 /root/workspace/
然后进入项目根目录:
cd /root/workspace/ultralytics-8.4.2
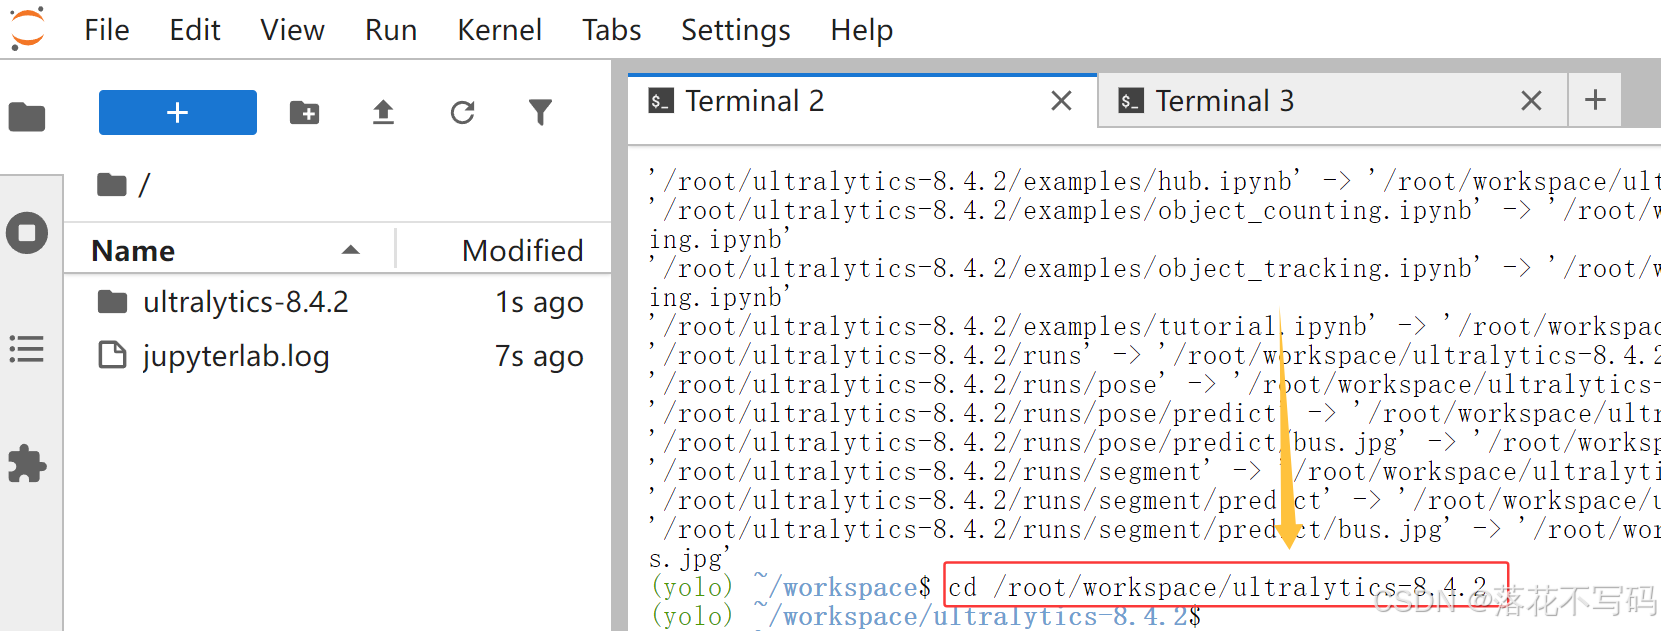
现在你的开发环境已经准备就绪,可以开始进行推理或训练任务。
3. 模型推理:让图片“说话”
3.1 修改 detect.py 文件
在项目目录中找到 detect.py 文件,替换为以下内容:
# -*- coding: utf-8 -*-
"""
@Auth :落花不写码
@File :detect.py
@IDE :PyCharm
@Motto :学习新思想,争做新青年
"""

from ultralytics import YOLO

if __name__ == '__main__':

    # Load a model
    model = YOLO(model=r'yolo26n-pose.pt')
    model.predict(source=r'./ultralytics/assets/zidane.jpg',
                  save=True,
                  show=False,
                  )
3.2 参数说明
| 参数 | 说明 |
|---|---|
model | 指定模型权重路径,可替换为你想加载的 .pt 文件 |
source | 输入源,支持本地图片、视频路径,或摄像头编号(如 0 表示默认摄像头) |
save | 是否保存结果,默认 False,建议设为 True |
show | 是否弹窗显示结果,默认 True,服务器环境下建议关闭 |
示例中使用的是
yolo26n-pose.pt,这是一个轻量级姿态估计模型。如果你只想做普通目标检测,可换为yolov8n.pt。
3.3 执行推理
在终端运行:
python detect.py
程序会自动处理图像并在 runs/detect/predict/ 目录下生成带标注框的结果图。
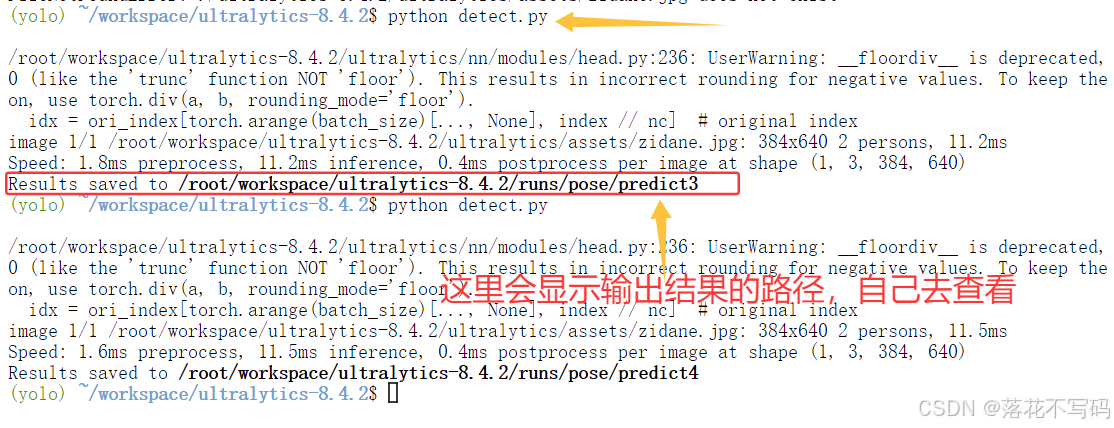
你可以打开结果图片查看检测效果:人物、车辆、宠物等都被准确识别出来,响应速度极快。
4. 自定义模型训练:打造专属检测器
4.1 准备你的数据集
要训练自己的模型,首先需要准备符合 YOLO 格式的数据集。基本结构如下:
dataset/
├── images/
│   ├── train/
│   └── val/
├── labels/
│   ├── train/
│   └── val/
└── data.yaml
每张图片对应一个 .txt 标注文件,格式为:
<class_id> <x_center> <y_center> <width> <height>
所有数值归一化到 [0,1] 区间。
4.2 配置 data.yaml
在项目根目录创建或修改 data.yaml 文件,内容如下:
train: ./dataset/images/train
val: ./dataset/images/val

nc: 2
names: ['cat', 'dog']
nc: 类别数量names: 类别名称列表
确保路径正确指向你的训练和验证集。
4.3 修改 train.py 开始训练
编辑 train.py 文件,填入以下代码:
# -*- coding: utf-8 -*-
"""
@Auth :落花不写码
@File :train.py
@IDE :PyCharm
@Motto :学习新思想,争做新青年
"""
import warnings
warnings.filterwarnings('ignore')
from ultralytics import YOLO

if __name__ == '__main__':
    model = YOLO(model='/root/workspace/ultralytics-8.4.2/ultralytics/cfg/models/26/yolo26.yaml')
    model.load('yolo26n.pt')  # 加载预训练权重
    model.train(data=r'data.yaml',
                imgsz=640,
                epochs=200,
                batch=128,
                workers=8,
                device='0',
                optimizer='SGD',
                close_mosaic=10,
                resume=False,
                project='runs/train',
                name='exp',
                single_cls=False,
                cache=False,
                )
关键参数解释:
| 参数 | 作用 |
|---|---|
imgsz | 输入图像尺寸,常用 640 |
epochs | 训练轮数,一般设为 100~300 |
batch | 批次大小,根据显存调整 |
device | 使用 GPU 编号,'0' 表示第一块 GPU |
project/name | 模型保存路径为 runs/train/exp |
4.4 启动训练
保存文件后,在终端执行:
python train.py
训练过程会实时输出 loss、mAP 等指标:
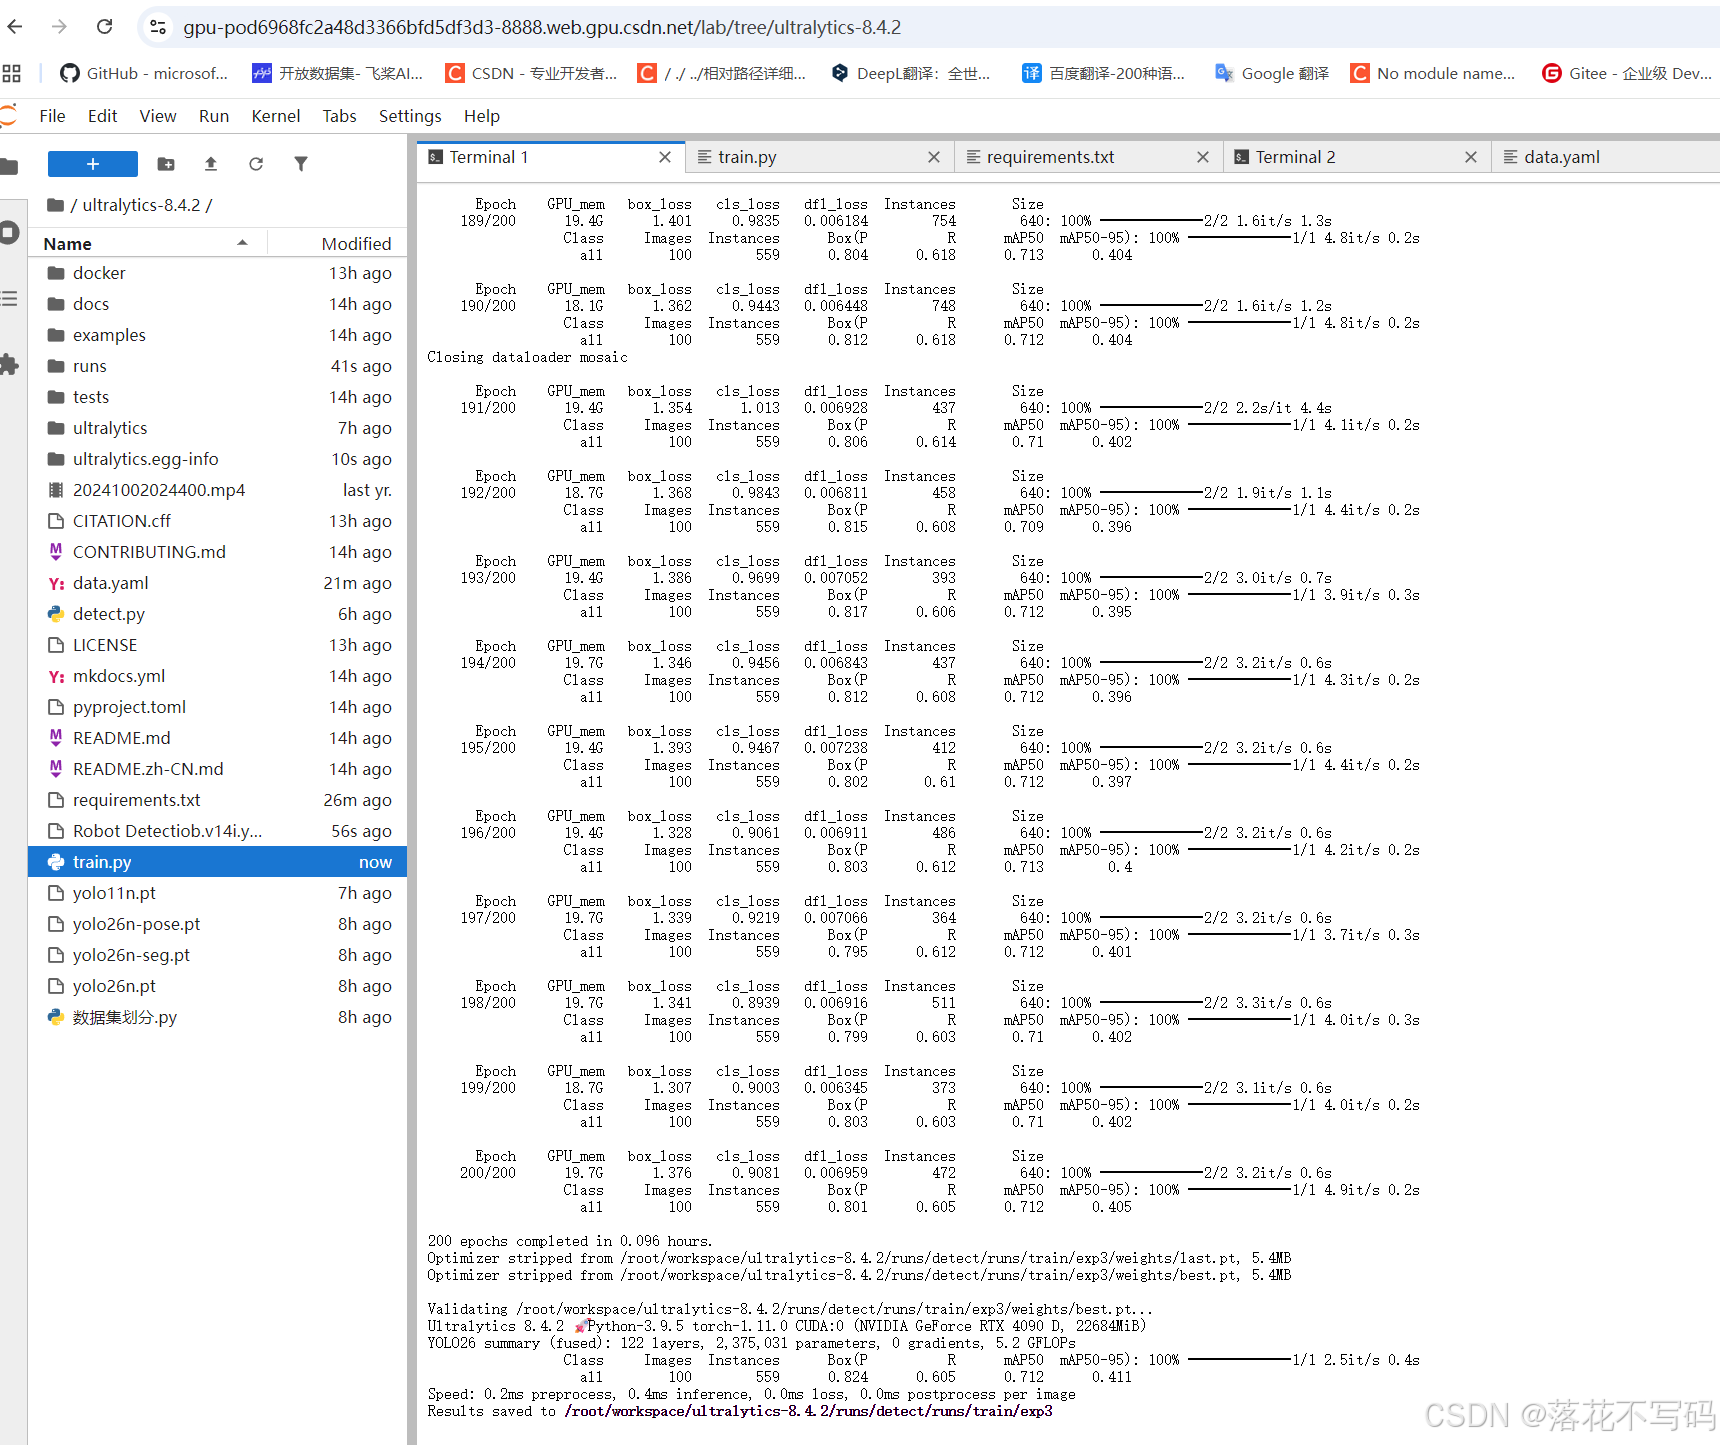
训练完成后,最佳模型将保存在 runs/train/exp/weights/best.pt,可用于后续推理或部署。
5. 模型结果下载与本地使用
5.1 下载训练好的模型
训练结束后,你可以通过 XFTP 工具将模型文件下载到本地:
- 打开 XFTP,连接当前服务器
- 在右侧找到
runs/train/exp/weights/目录 - 双击
best.pt或整个文件夹拖拽至左侧本地路径
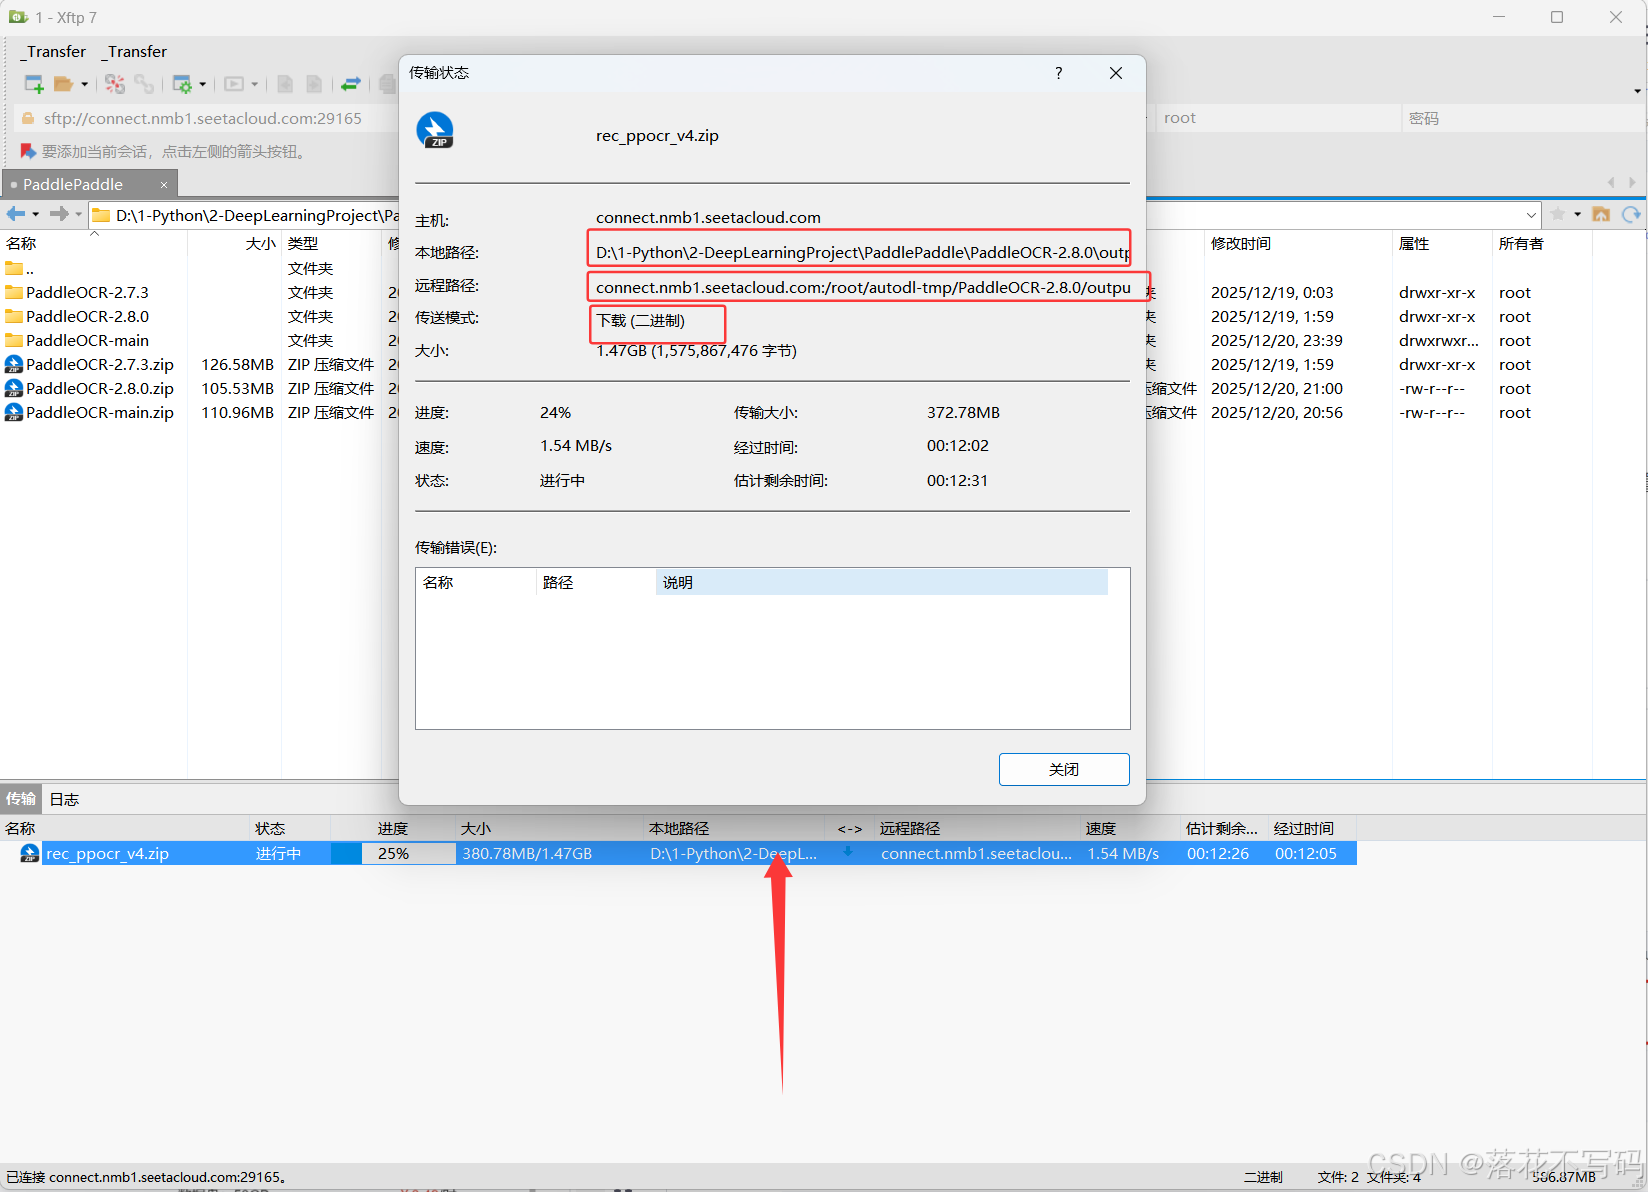
提示:大文件建议先压缩再下载,节省时间。例如:
zip -r best_model.zip runs/train/exp/
5.2 本地推理测试
将模型下载到本地后,只需几行代码即可调用:
from ultralytics import YOLO

model = YOLO('best.pt')  # 加载自定义模型
results = model('test.jpg', save=True)
无论是PC端、边缘设备还是Web服务,都可以轻松集成。
6. 镜像内置资源一览
6.1 已包含的预训练权重
镜像已在根目录预置多个常用模型权重,无需手动下载:
yolo26n.ptyolo26s.ptyolo26n-pose.ptyolo26m.pt等
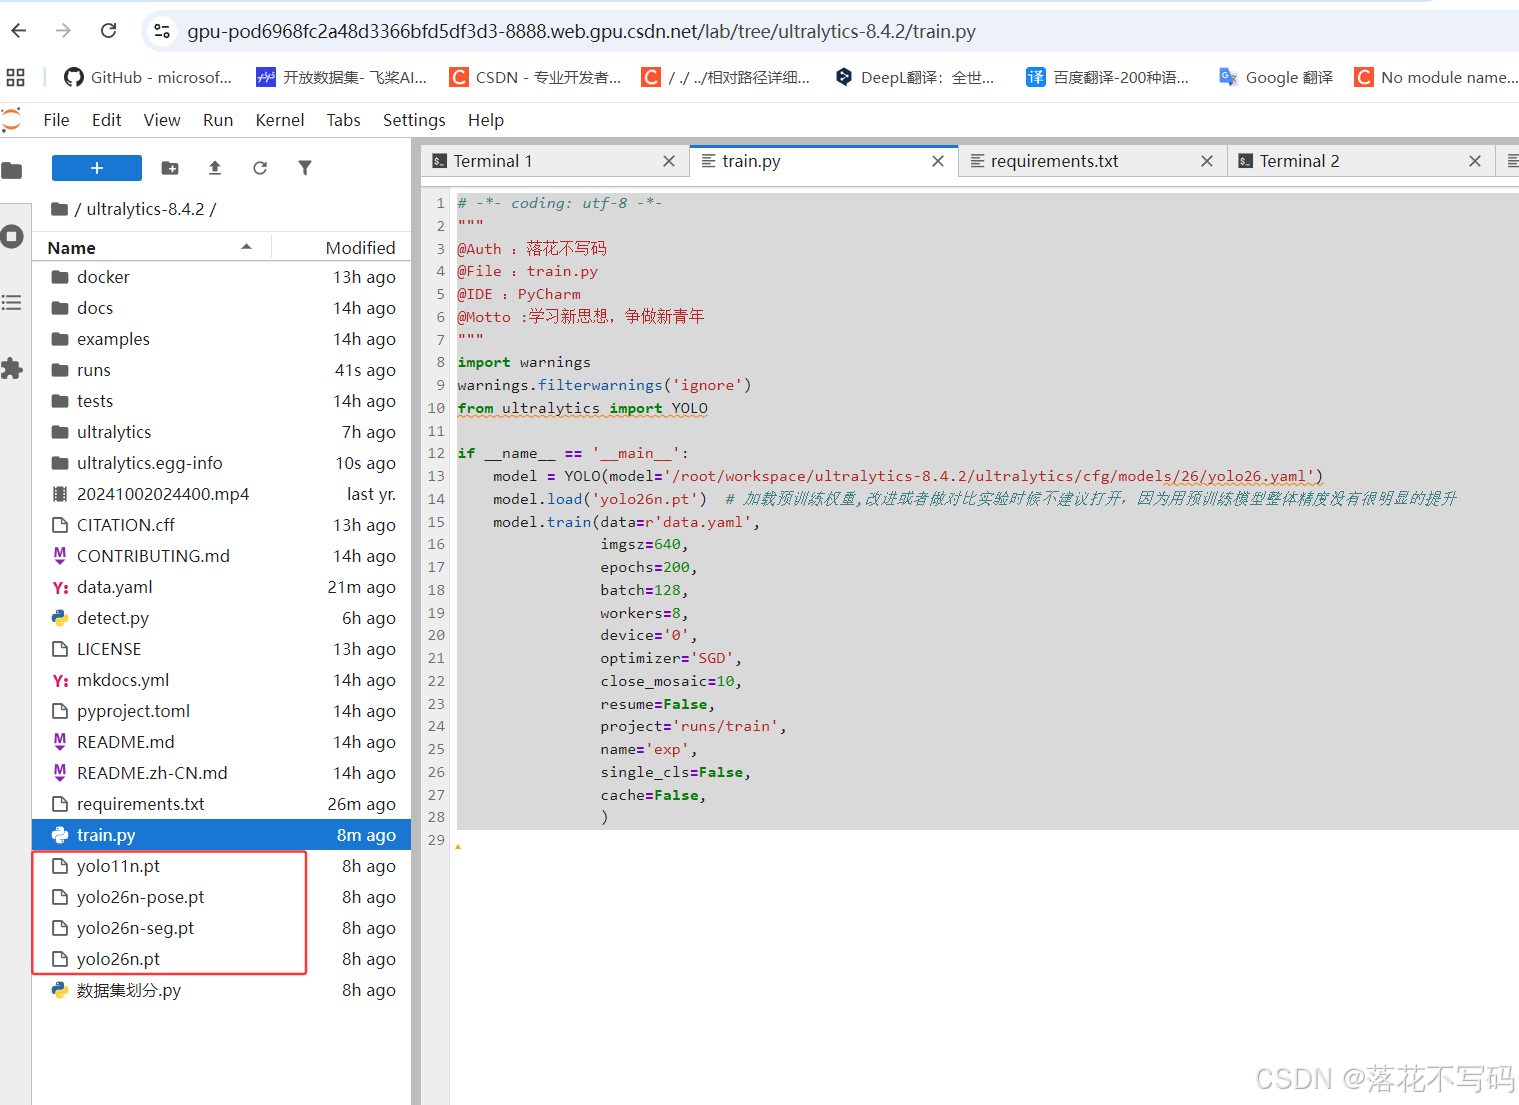
这些模型覆盖不同规模需求,从小型嵌入式设备到高性能服务器均可适配。
6.2 支持的任务类型
| 模型类型 | 支持任务 |
|---|---|
yolo26*.pt | 目标检测 |
yolo26*-pose.pt | 姿态估计 |
yolo26*-seg.pt | 实例分割 |
只需更换模型文件,即可快速切换任务模式,无需重写代码。
7. 常见问题与解决方法
7.1 环境未激活导致报错
现象:运行时报错 ModuleNotFoundError: No module named 'ultralytics'
原因:未激活 yolo Conda 环境
解决:
conda activate yolo
7.2 数据集路径错误
现象:提示 Data not found 或路径不存在
原因:data.yaml 中路径配置不正确
建议:
- 使用绝对路径或相对于项目根目录的相对路径
- 检查文件夹权限和拼写
7.3 显存不足(Out of Memory)
现象:训练时崩溃或提示 CUDA out of memory
解决方法:
- 降低
batch大小(如从 128 → 64) - 减小
imgsz(如从 640 → 320) - 使用更小的模型(如
yolo26n而非yolo26x)
7.4 如何继续训练?
若需从中断处恢复训练,只需设置 resume=True:
model.train(..., resume=True)
模型会自动读取上次保存的检查点继续训练。
8. 总结
通过本文,你应该已经完成了从镜像部署到模型训练的全流程实践。回顾一下关键步骤:
- 启动镜像并激活环境:
conda activate yolo - 复制代码到可写目录:避免系统盘无法修改
- 运行 detect.py 进行推理:快速验证模型能力
- 准备数据集并修改 data.yaml:构建自己的训练任务
- 运行 train.py 开始训练:利用GPU加速模型学习
- 下载 best.pt 到本地使用:实现闭环应用
这套方案的最大价值在于:把复杂的环境配置交给镜像,让你专注于模型训练和业务创新。无论你是想做一个智能安防系统、工业质检工具,还是参加AI竞赛,都可以基于这个镜像快速起步。
更重要的是,整个流程对新手极其友好——不需要懂CUDA、不用研究依赖版本兼容性,甚至连Python基础要求都不高,只要跟着步骤走,5分钟内就能看到第一个检测结果。
获取更多AI镜像
想探索更多AI镜像和应用场景?访问 CSDN星图镜像广场,提供丰富的预置镜像,覆盖大模型推理、图像生成、视频生成、模型微调等多个领域,支持一键部署。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 14
 0
- 0


 已为社区贡献19条内容

所有评论(0)