Yolo目标检测及yolo v1
目录
一.Yolo系列
目标检测核心概念
- 目标检测的任务是识别图像中物体的身份,同时定位其在图像中的具体位置,涵盖了图像分类和定位两个方面。
- 检测分为one-stage(单阶段/端到端)和two-stage(双阶段)两种方式。One-stage(如YOLO系列)速度快,适合实时应用;Two-stage(如Faster R-CNN)准确率高,适合对精确度要求高的场景。
1. YOLO框架介绍与原理
YOLO(You Only Look Once)是一种基于深度学习的目标检测算法,由Joseph Redmon等人于2016年提出。它的核心思想是将目标检测问题转化为一个回归问题,通过一个神经网络直接预测目标的类别和位置。YOLO算法将输入图像分成SxS个网格,每个网格负责预测该网格内是否存在目标以及目标的类别和位置信息。此外,YOLO算法还采用了多尺度特征融合的技术,使得算法能够在不同尺度下对目标进行检测。
- YOLO(You Only Look Once)是一个主流的视觉识别框架,用于实现图像分类、物体识别及目标检测。
- 其核心思想是将目标检测问题转化为回归问题,模型直接输出目标的类别和位置坐标,属于“单阶段”检测算法。
- 相比于传统依赖多阶段处理的传统目标检测算法(如Faster R-CNN),YOLO迭代版本速度快、准确率高,得益于其端到端的训练方式,适合实时检测任务。
2.经典的检测方法
①单阶段检测方法(one-stage):
YOLO系列
②多阶段检测方法(two-stage):
Faster-rcnn和mask-Rcnn系列
③检测模型对比
- 高效模型 (One-Stage, 如YOLO):速度极快,但准确率略低。适用于需要在短时间内处理大量图像的场景,如无人驾驶、工业产品检测。
- 高精模型 (Two-Stage, 如Faster R-CNN):准确率高,但速度较慢(约每秒5帧)。适用于对识别准确性要求极高,对处理速度要求不严格的场景,如医学图像分析
3.Yolo与传统算法的比较
相比于传统的目标检测算法,如R-CNN、Fast R-CNN和Faster R-CNN等,YOLO算法具有更快的检测速度和更高的准确率。这得益于其端到端训练方式和单阶段检测的特性,使其可以同时处理分类和定位任务,避免了传统方法中的多阶段处理过程。因此,YOLO算法广泛应用于实时目标检测和自动驾驶等领域。
4.one-stage的优缺点
优点:识别速度非常快,适合做实时检测任务
缺点:正确率相比较低
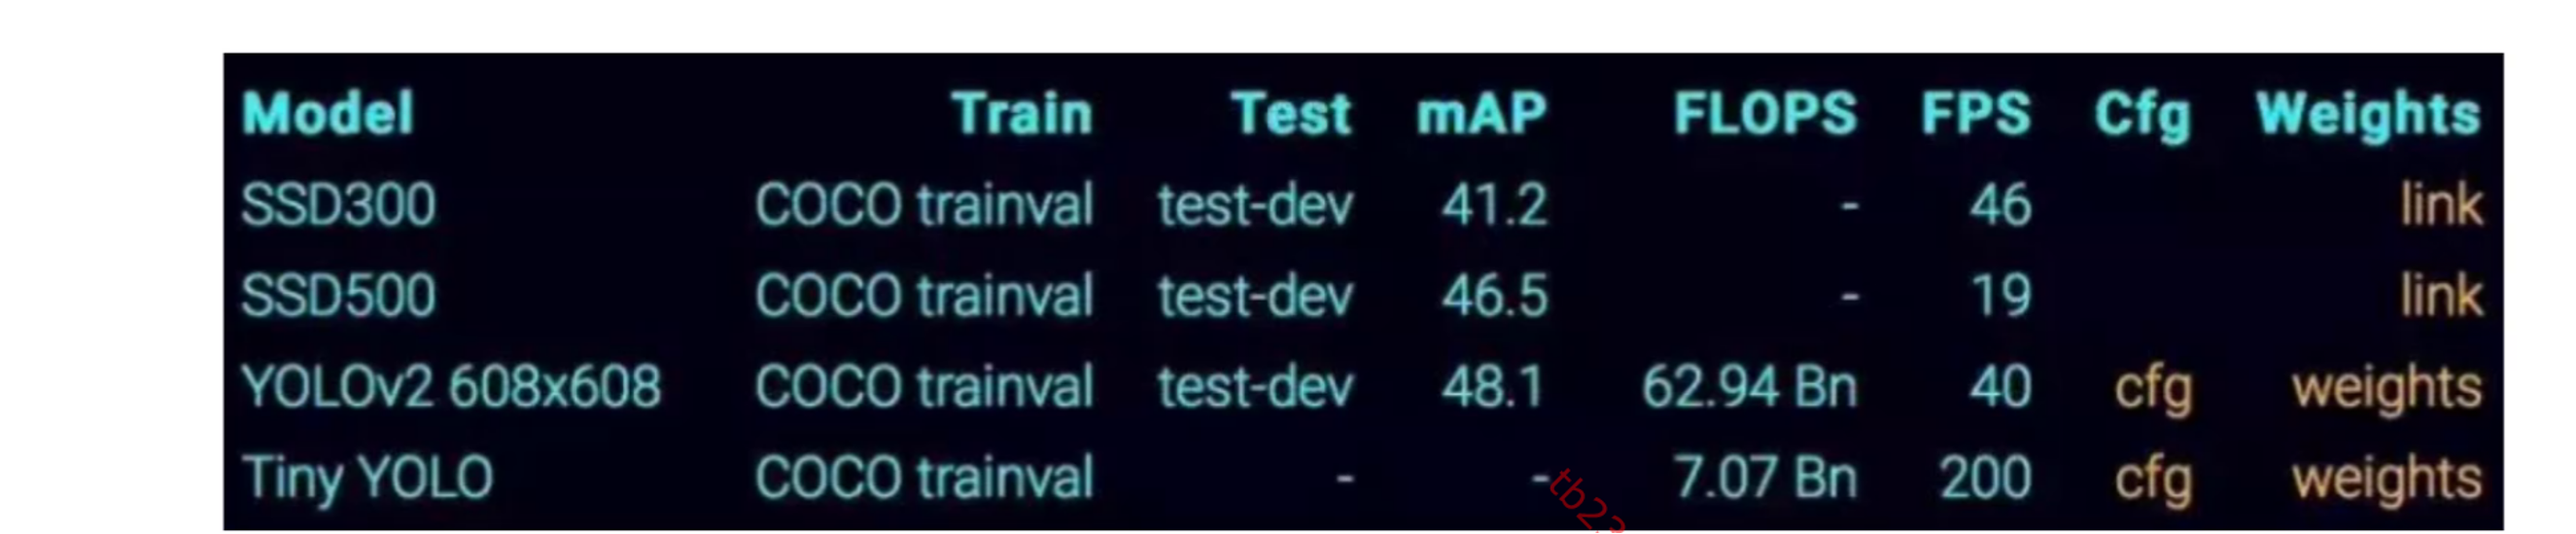
FLOPs表示模型进行一次前向传播(即处理一张图像)所需要的浮点运算次数。它是一个衡量算法效率的关键指标,与模型的计算量和推断速度密切相关。 FPS:每秒可以处理的图像数量
5.two-stage的优缺点
优点:正确率比较高,识别效果理想
缺点:识别速度比较慢,通常达到5FPS
两阶段目标检测器是一种先生成候选框,然后对候选框进行分类和回归的检测方法。这种方法主要包括两个阶段:
第一阶段:生成候选框。这通常通过一个类似于Selective Search或EdgeBoxes等区域提名算法来实现,该算法从输入图像中生成多个候选框。每个候选框都会经过一个CNN模型进行特征提取,然后通过分类器进行过滤,保留与目标物体更相似的候选框。
第二阶段:在保留的候选框上进行精细的分类和回归。这个阶段通常使用另一个CNN模型或类似SVM的分类器来进行分类和回归。对于每个候选框,可能需要预测物体的类别、位置和大小等。 代表性的两阶段目标检测器包括R-CNN系列,以及其改进版本Fast R-CNN、Faster R-CNN和Mask R-CNN等。
6.模型评估核心指标
- FPS: 指模型每秒可以处理的图像帧数,是衡量模型速度(效率)的关键指标。数值越高,速度越快。
- FLOPS: 指模型一次前向传播所需的浮点数运算次数,也是衡量计算开销的指标,FLOPS越大,模型越复杂。
- MAP (平均精度均值):用于综合评估模型的正确率。其值越高,模型表现越好。通常关注mAP@0.5和mAP@0.5:0.95这两个指标。
7.预测与评估的具体统计指标
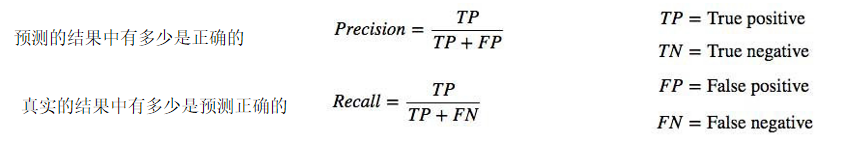
- IOU (交并比): 用于评估预测框与真实框的重合程度。当预测框的置信度满足阈值(如≥0.5)且与真实框的IOU也满足阈值(IOU ≥ 0.5)时,才算预测正确。这也是计算精确率和召回率的基础。
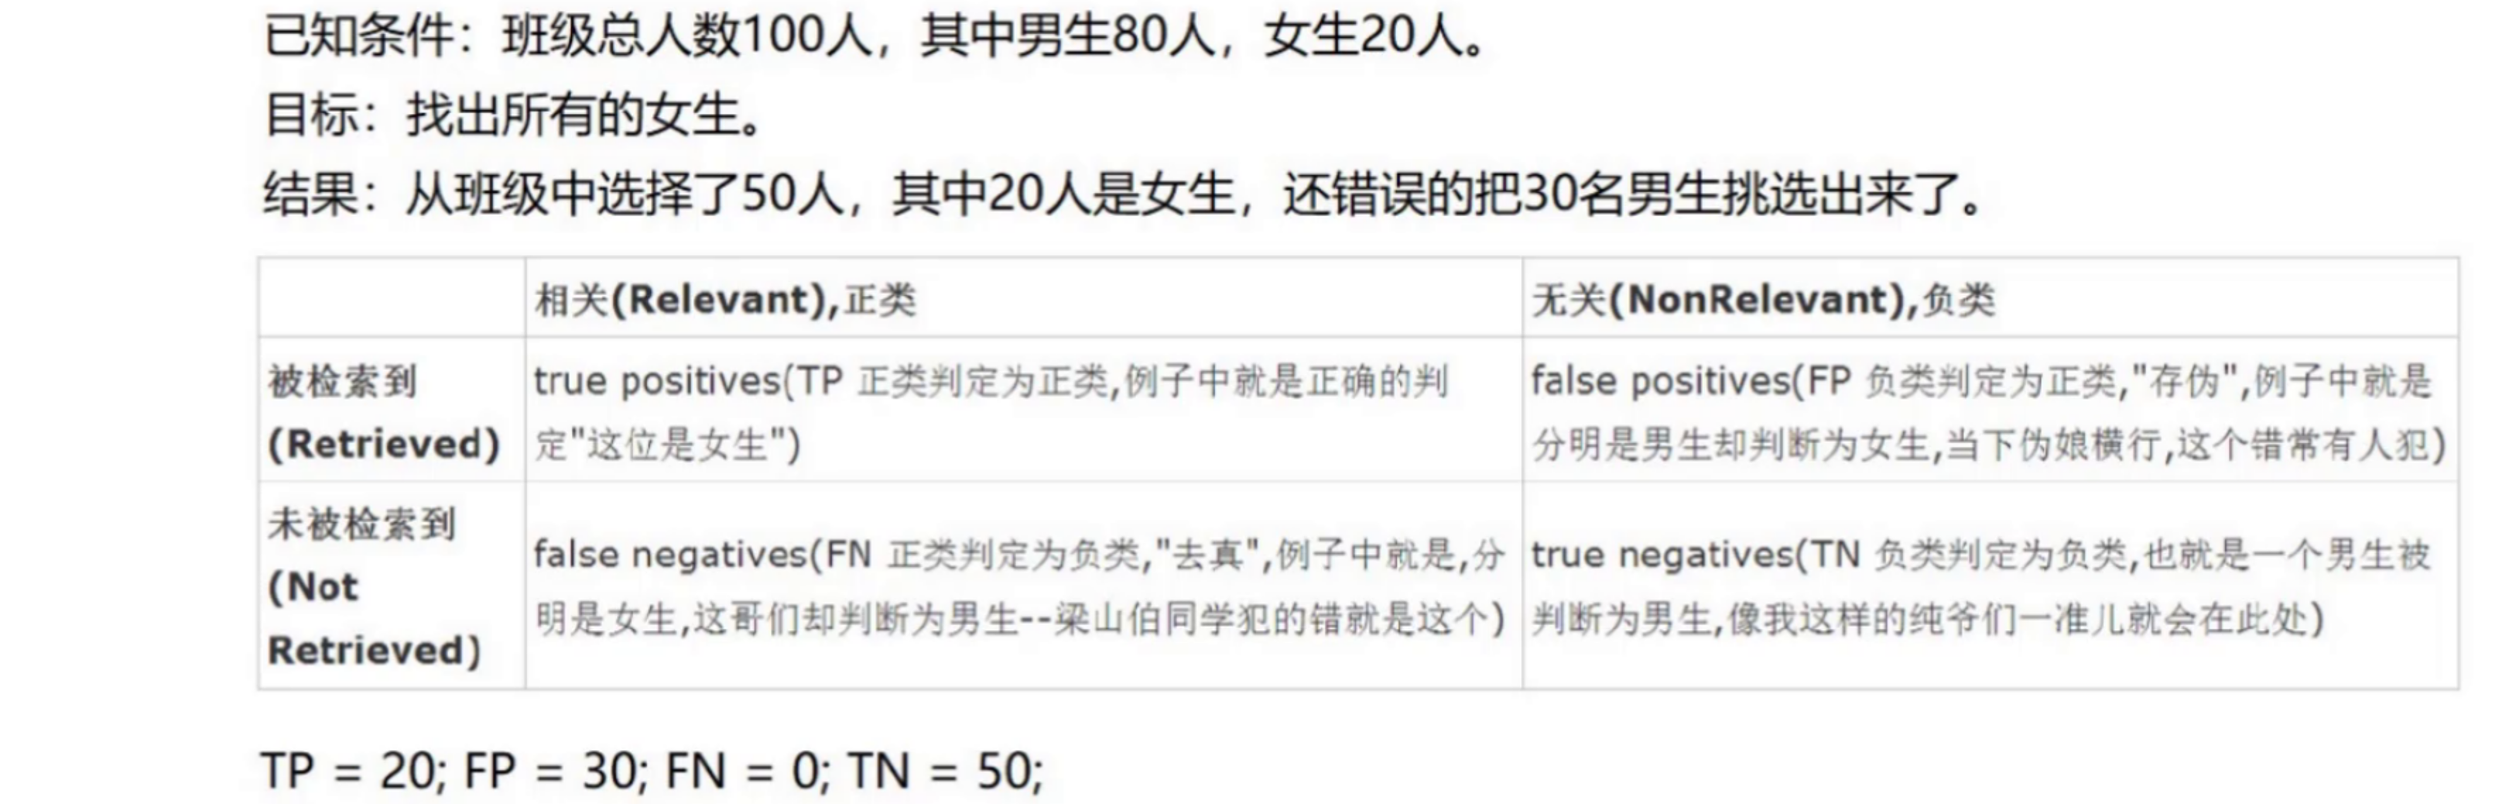
- 精确率(Precision): 反映模型预测正确的占所有预测出“正类(有目标)”的比率。
- 召回率(Recall): 反映模型成功检测到的实际“正类样本”占所有真实正类的比率。
- 置信度 (Confidence Score):模型对某个检测结果可靠性(如该区域存在目标)的评分,范围在0到1之间。
(1)置信度
表示某个预测框中存在目标的可能性大小,是一个介于 0 到 1 之间的数值。例如,一个预测框的目标存在置信度为 0.8,意味着模型有 80% 的把握认为该预测框中包含一个目标。
(2)IOU

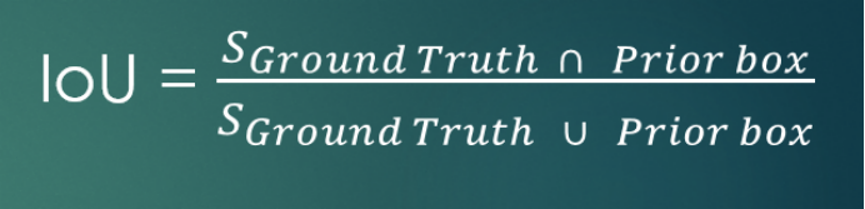
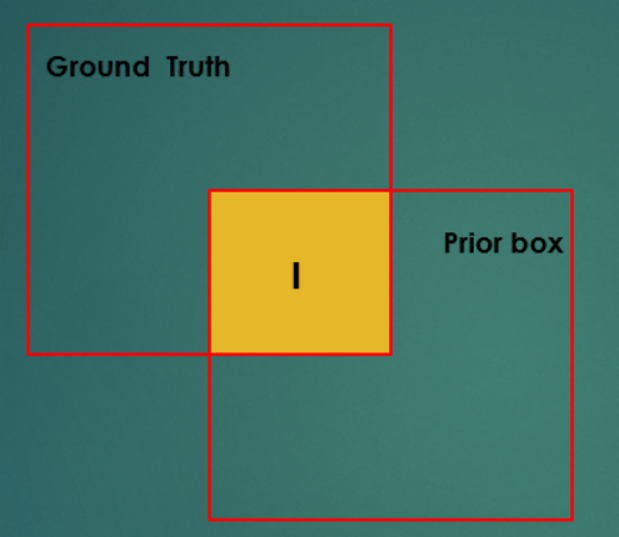
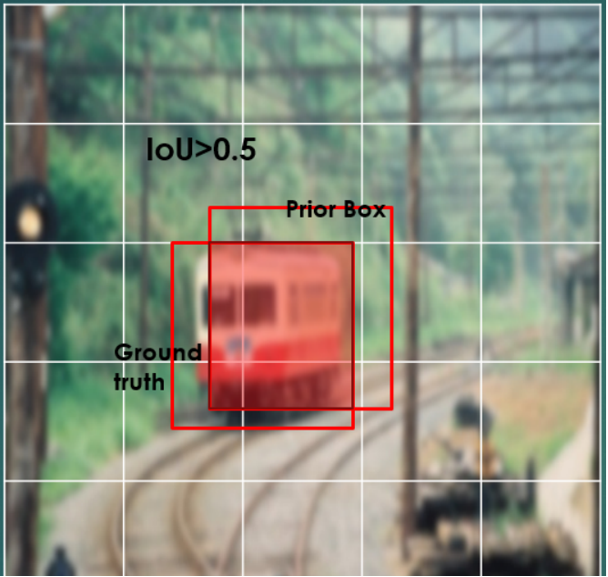
(3)TP,FP,TN,FN
(4)MAP
根据不同的阈值,绘制出召回率和精确率的曲线,将曲线以下的面积作为MAP值。当MAP值越大,则表示指标越好 。
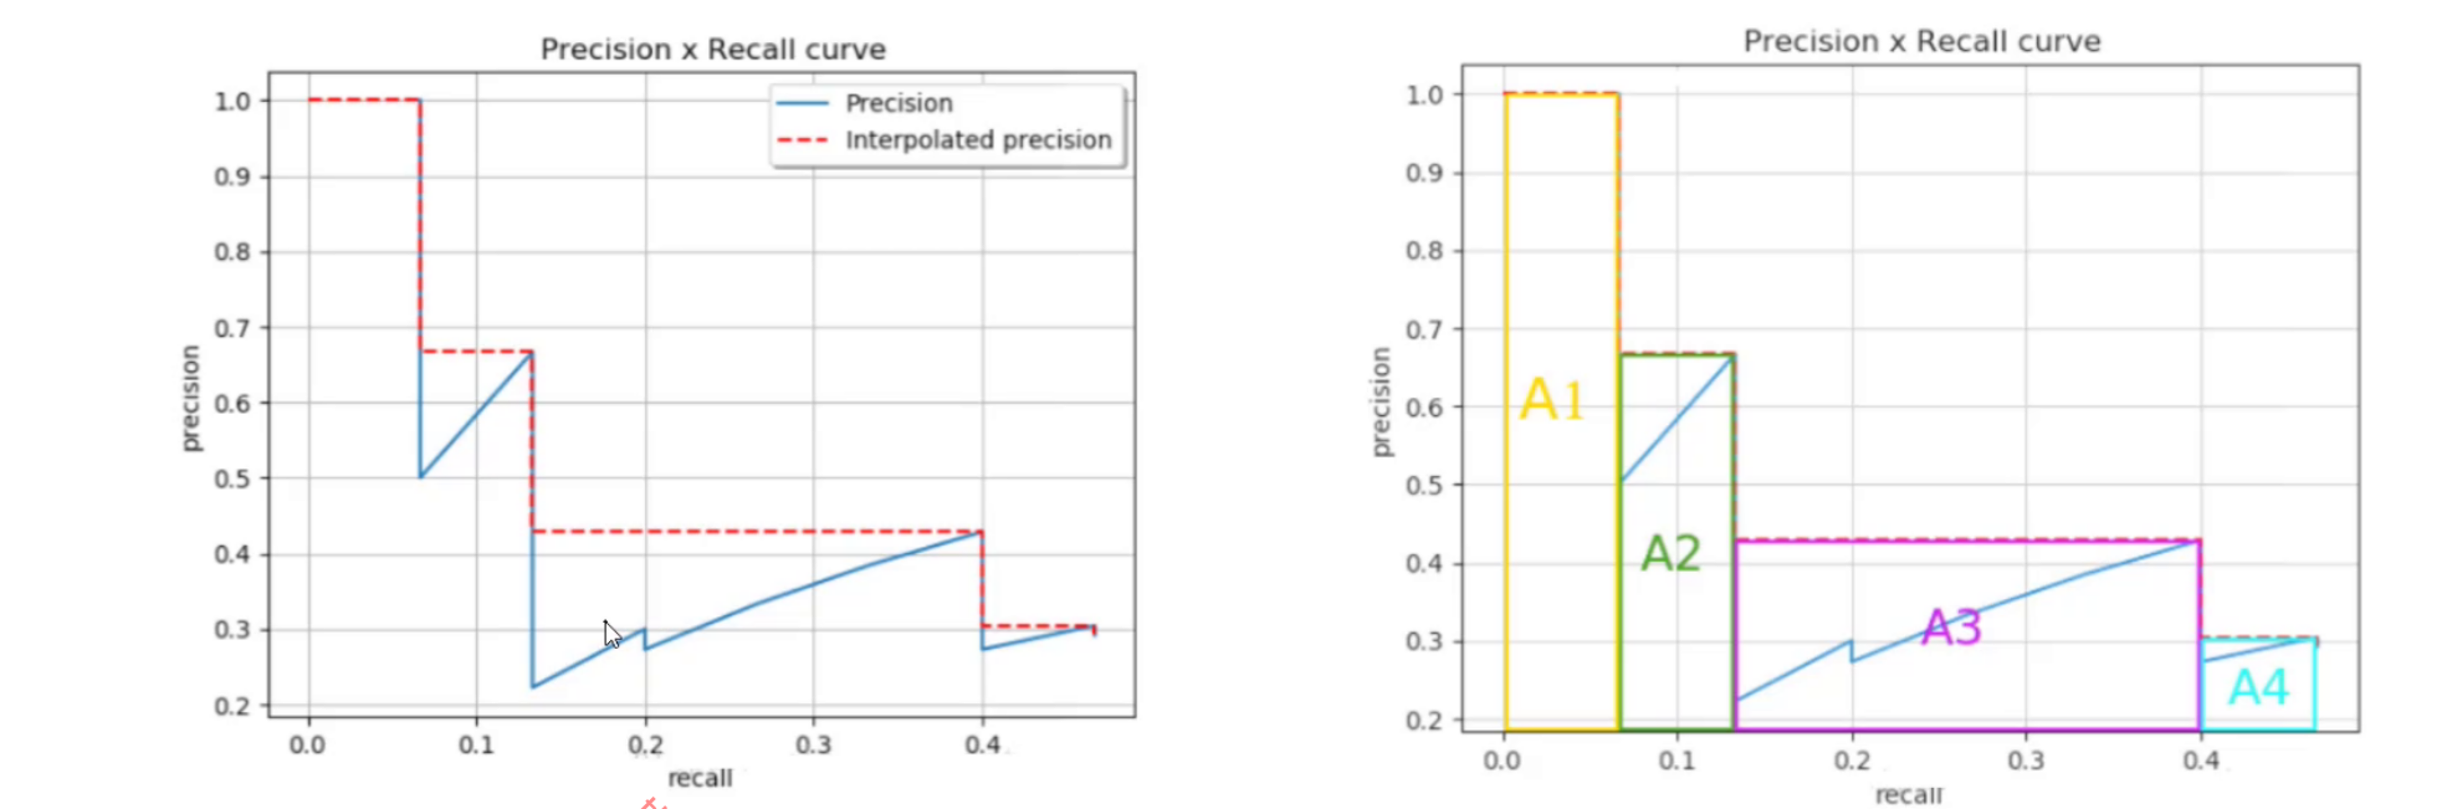 mAP50:表示当 IoU 阈值为 0.5 时模型的平均精度。即只考虑预测框与真实框的重叠部分达到 50% 及以上的情况,计算所有类别的 AP(Average Precision)的平均值,AP 衡量的是随着不同置信度阈值的召回率变化,精度是如何变化的。mAP50 是一个固定的评估标准,仅关注 IoU 为 0.5 这一特定阈值下的模型性能。
mAP50 - 95:衡量的是模型在 IoU 阈值从 0.5 到 0.95 范围内的平均精度。计算的是所有类别的 AP 的平均值,其中 AP 是在 IoU 阈值从 0.5 到 0.95 的每个 0.05 步长上计算的。mAP50 - 95 考虑了更广泛的 IoU 范围,能够评估模型在不同重叠程度下的性能,提供了更全面的模型性能评估,是一个更严格的评估指标,其值通常比 mAP50 要低。
二.Yolo系列 v1
核心原理
- 网络结构: 采用GoogLeNet 网络作为基础骨干网络,经20层卷积后,增加全连接层,并重塑输出,为后续的网格化输出做准备。
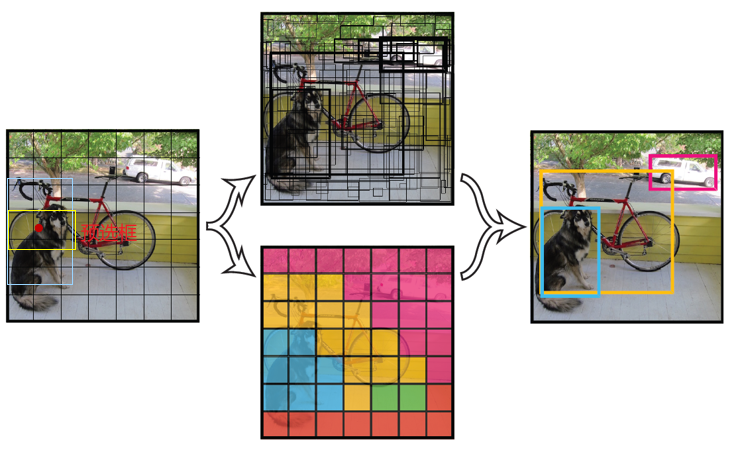
- 网格化输出: 将图像划分为网格(如7x7),每个网格负责预测一个区域内物体的信息。
- 多预测框(Multiple Prediction Boxes): 为保证较高准确率,每个网格内设置多个(如YOLOv1为2个)预测框,用于适应不同形状的物体。
- 输出格式: 每个网格输出30个值,分为两部分:
- 前五个值:第一个预测框的中心坐标(X,Y)、宽高(W,H)及置信度(C)。
- 后五个值:第二个预测框的中心坐标、宽高及置信度。
- 剩余的20个值:用于预测包含20类别的概率(非二元分类)。
1.核心思想
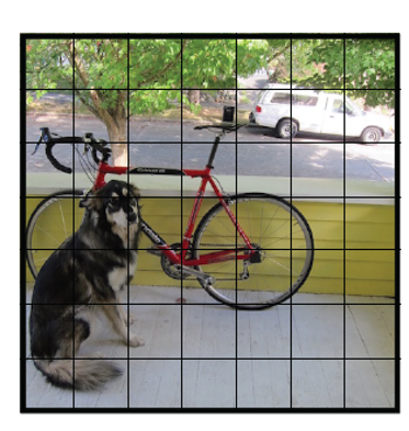
将一幅图像分成SxS个网格(grid cell),如果某个object的中心 落在这个网格中,则这个网格就负责预测这个object。
2.网络架构
网络结构借鉴了 GoogLeNet 。24个卷积层,2个全链接层。(用1×1 reduction layers 紧跟 3×3 convolutional layers 取代Goolenet的 inception modules )
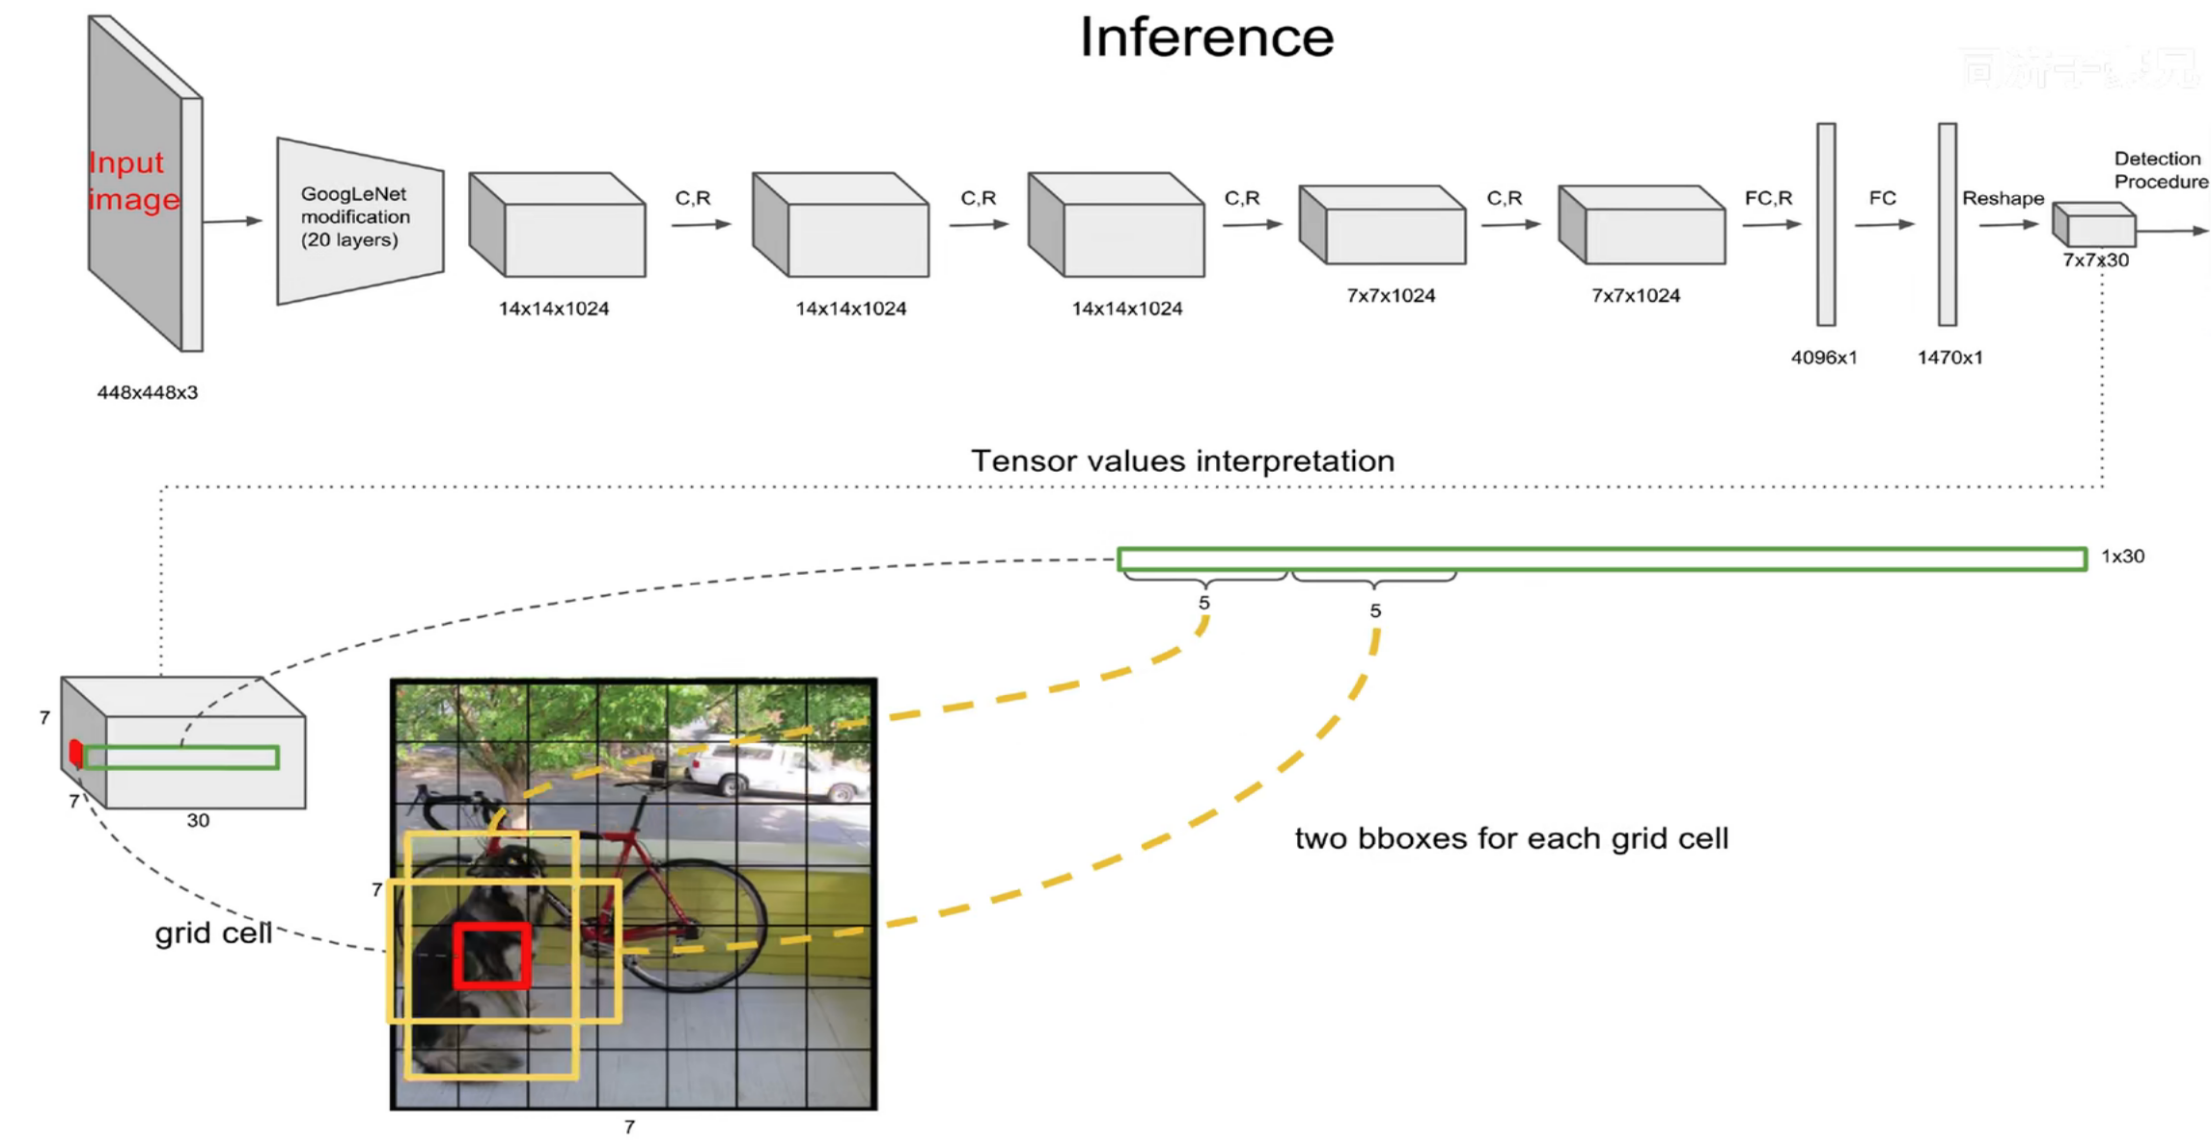
7×7意味着7×7个grid cell,30表示每个grid cell包含30个信息,其中2个预测框,每个预测框包含5个信息(x y w h c),分别为中心点位置坐标,宽高以及置信度,剩下20个是针对数据集的20个种类的预测概率(即假设该grid cell负责预测物体,那么它是某个类别的概率)。
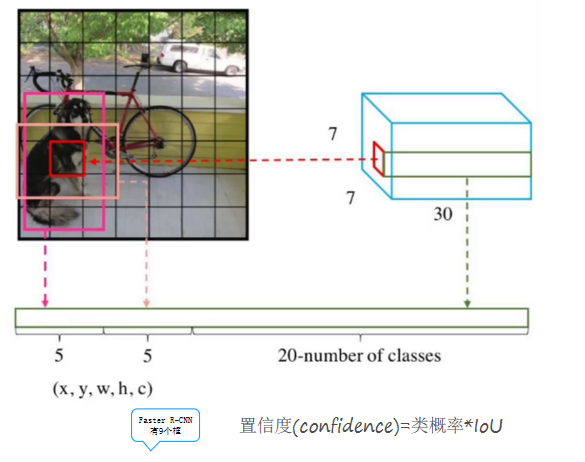
其中坐标的x,y(相对于网格单元格边界的框的中心)用对应网格的归一化到0-1之间,w,h用图像的width和height归一化到0-1之间。
3.损失函数
YOLO-V1算法最后输出的检测结果为7x7x30的形式,其中30个值分别包括两个候选框的位置和有无包含物体的置信度以及网格中包含20个物体类别的概率。那么YOLO的损失就包括三部分:位置误差,confidence误差,分类误差。 损失函数的设计目标就是让坐标(x,y,w,h),confidence,classification这个三个方面达到很好的平衡。
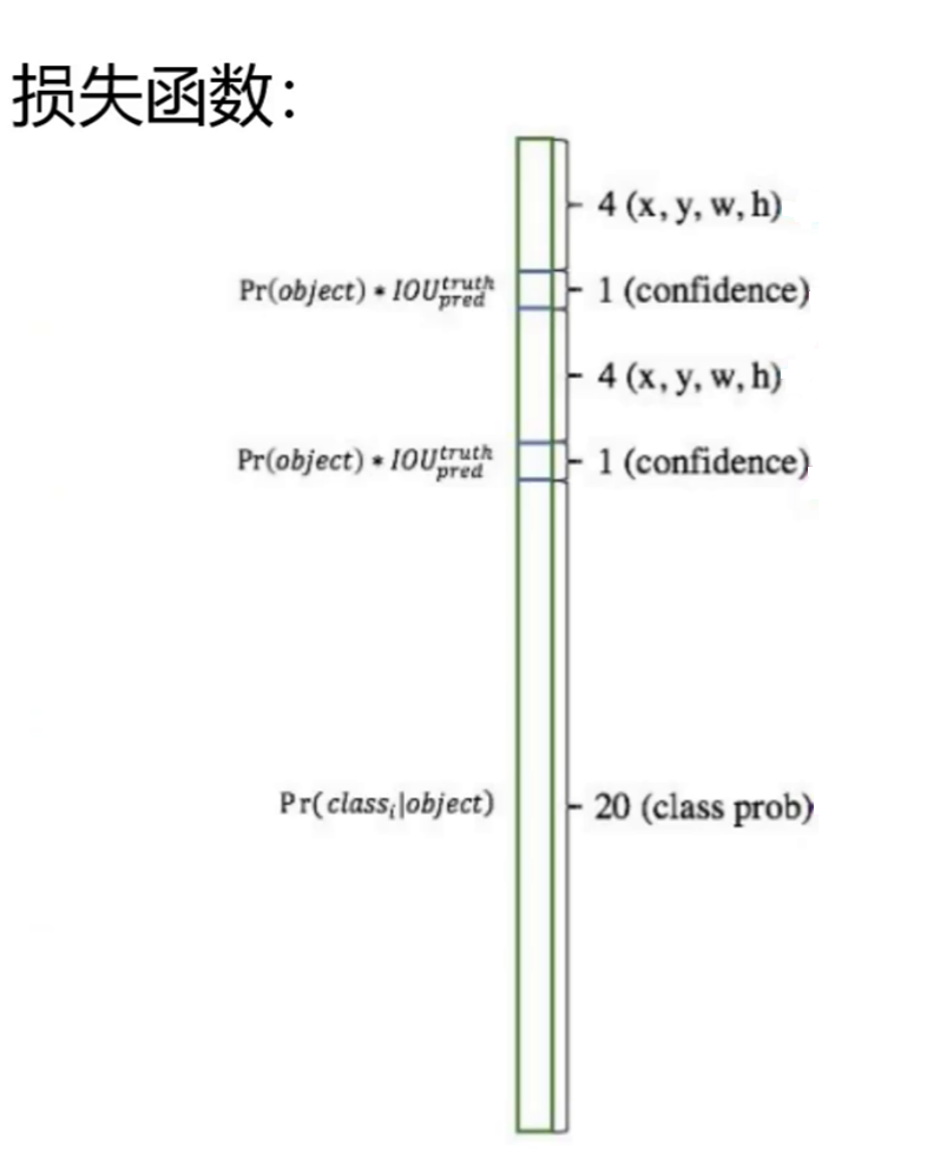
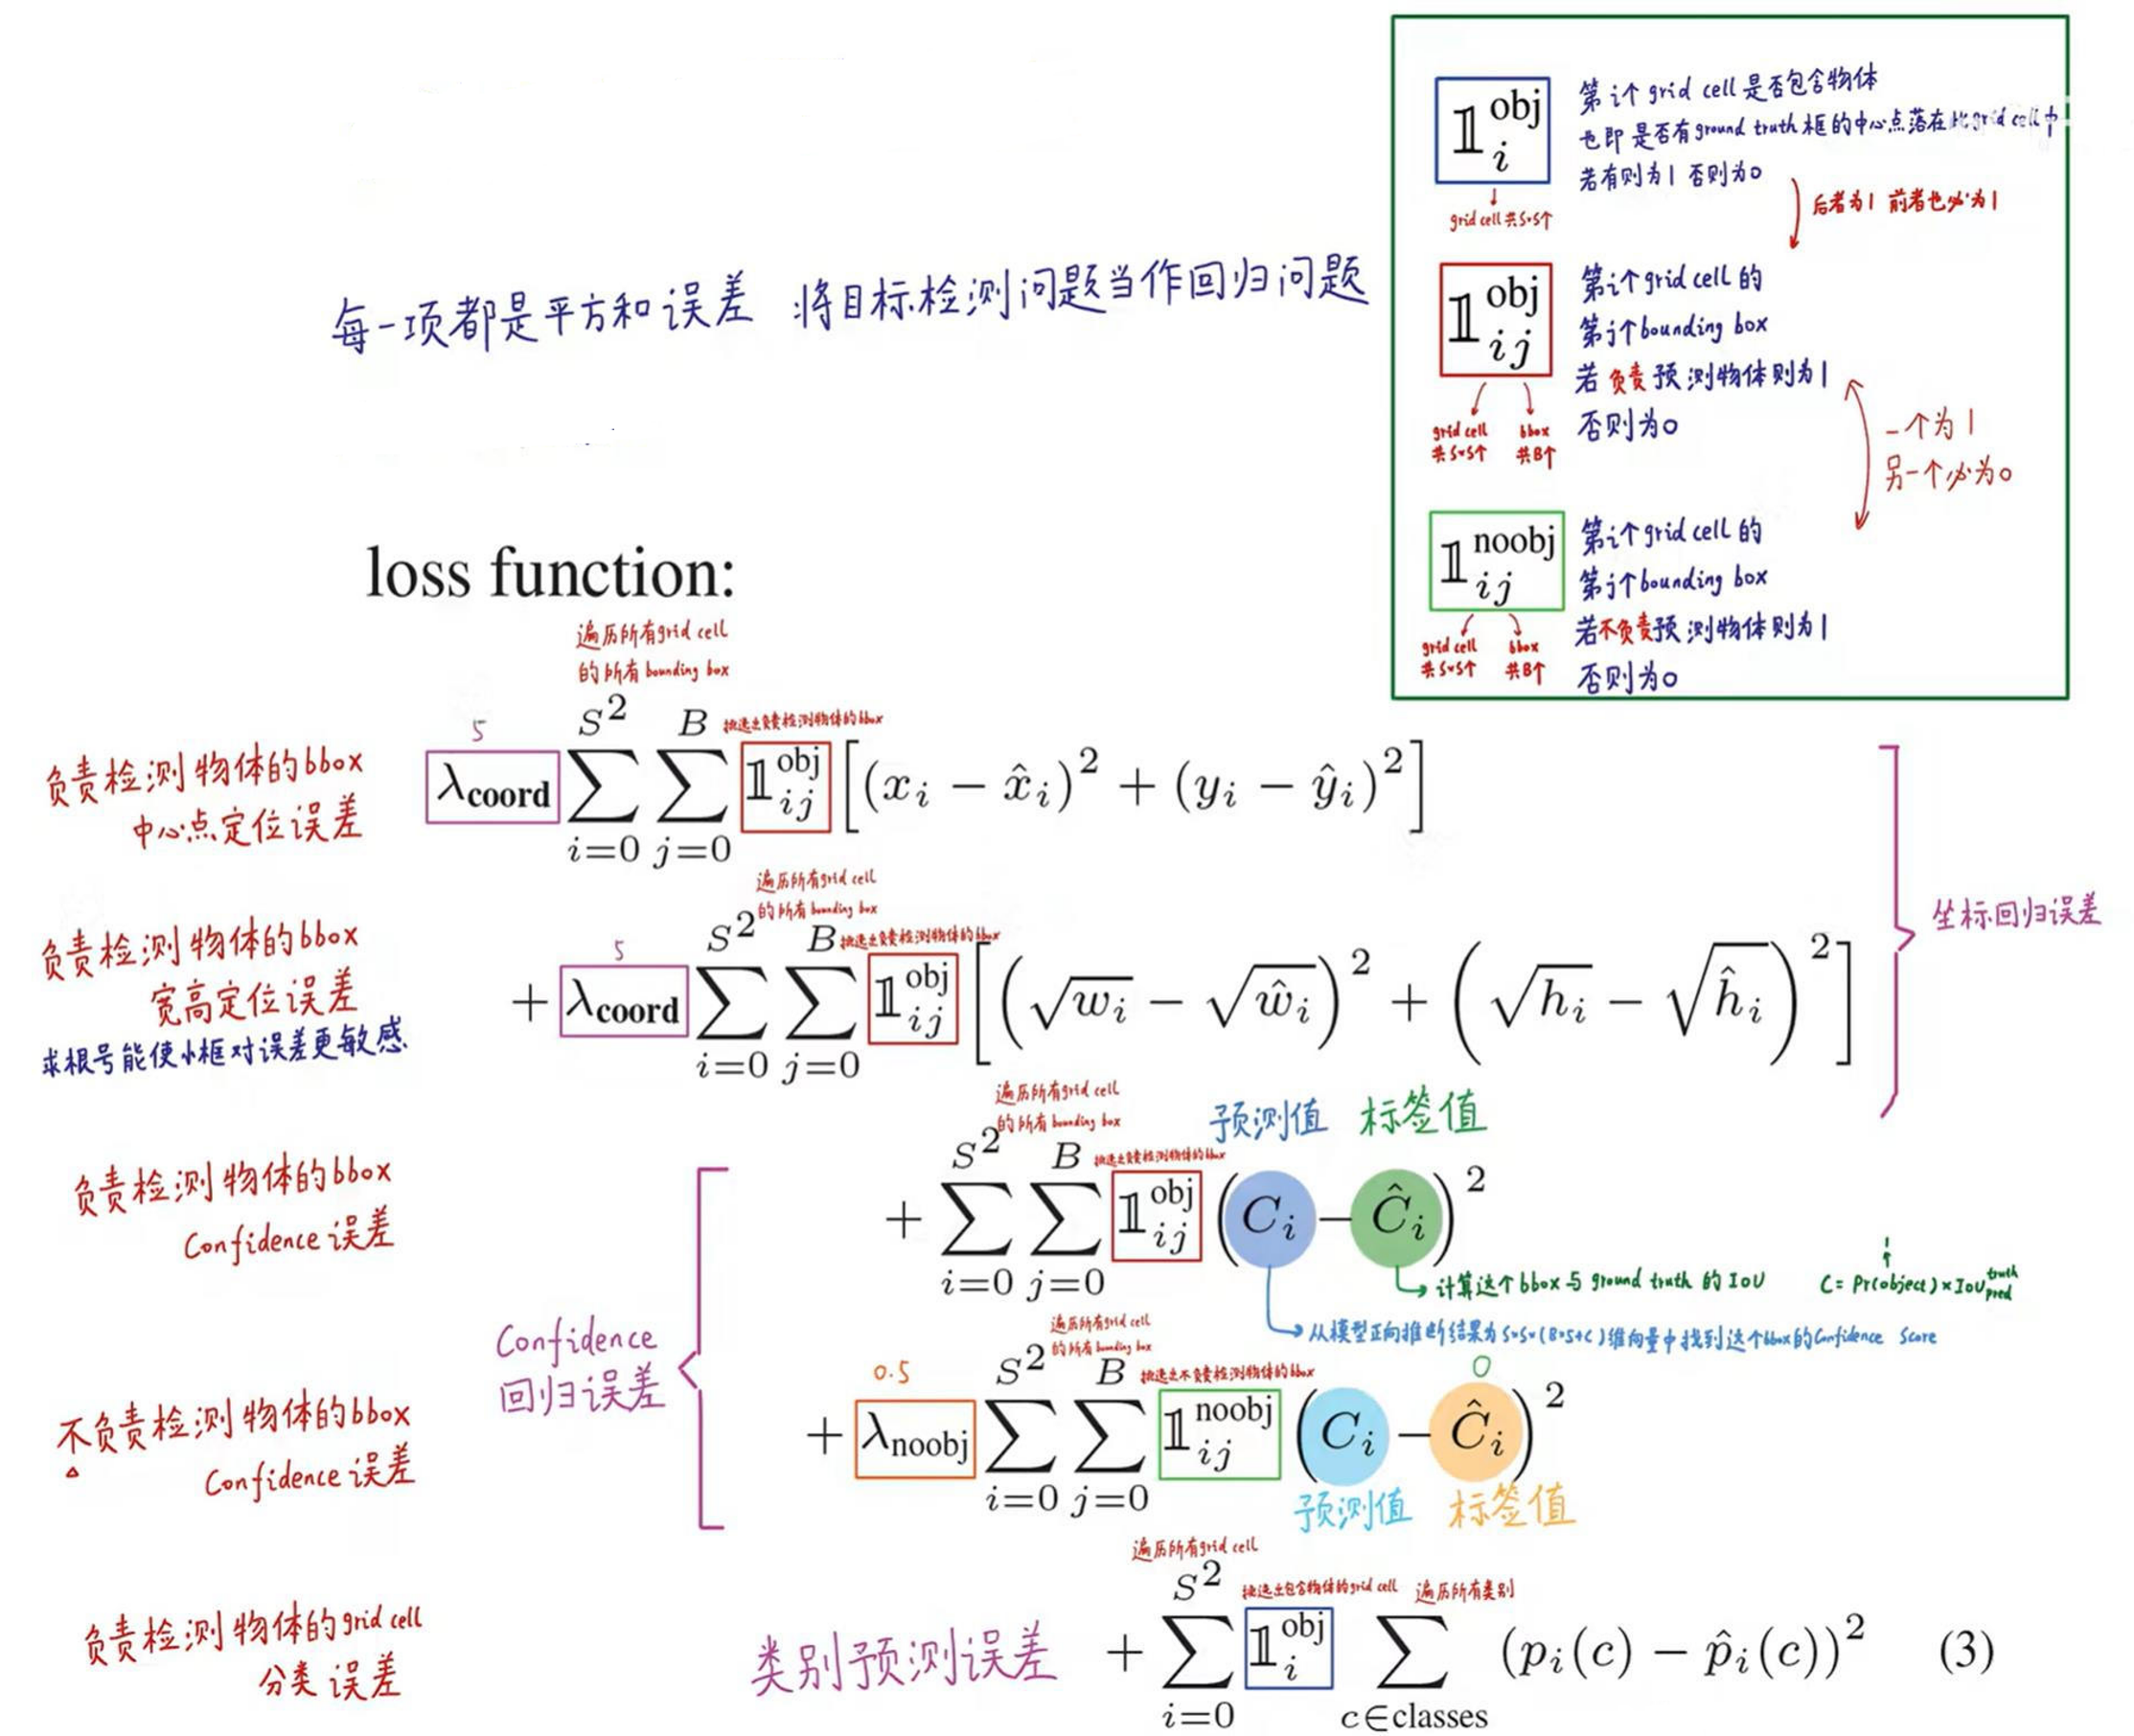
YOLOv1损失函数详解
- 损失函数目标: 通过计算预测结果与真实标签之间的差距,利用梯度下降等方法更新模型参数,以优化预测精度。
- 位置损失 (Loss Position):
- 计算公式为预测框与真实框中心点坐标以及宽高的平方差,使用均方差(MSE)作为基础损失函数。
- 采用中心点坐标而非四个顶点,便于计算网格归属。
- 在损失计算前会为宽高项进行开根号处理,以平衡不同尺度的误差。
- 置信度损失 (Loss Confidence):
- 区分为“有物体”和“无物体”两种情况下的独立计算。
- “有物体”的情况:损失由预测的置信度与真实值的平方差计算,真实置信度通过预测框与真实框的交并比(IOU)和对应类别的概率相乘得到。
- “无物体”的情况:旨在强制模型让距离真实物体较远的预测框置信度降低至接近零,以抑制误检。
- 类别损失 (Loss Category):
- 计算公式为模型输出的各类别概率与真实标签(one-hot编码)的平方差。
- 类别损失被设计为同时服务于置信度的评估,在官方计算中,类别损失项与置信度损失项挂钩(如同样是y=1代表负样本)。
4.YOLO V1模型优缺点总结:
- 优点:
- 速度快、模型简单:结构清晰,推理速度较快。
- 缺点:
- 无法解决目标重叠问题:每个网格(cell)的每个预测框只能识别一个物体,因此不适用于同一网格内存在多个目标(如一个怀抱另一只小动物的场景)的情况。
- 小物体检测效果一般:相较于较大的物体,对尺寸较小的物体的检测准确率较低。
- 长宽比可选范围较窄:物体的形状(长宽比)多样性不足。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 14
 0
- 0


 已为社区贡献7条内容

所有评论(0)