还在用收费 OCR?试试这款开源免费开源的OCR,离线也能精准识别
Umi-OCR 是什么
Umi-OCR 是一个开源的、可离线运行的 OCR(光学字符识别)工具。它由 GitHub 社区维护,以 “免费、开源、离线” 为核心定位。
主要特点如下:
- 离线识别:不依赖网络即可完成 OCR 识别,这对于隐私敏感或网络不稳定的场景非常有价值。
- 开箱即用 / 轻量部署:通常通过下载压缩包即可使用,无需复杂安装过程。
- 多语言支持 & 插件扩展能力:内置常用语言模型,同时支持插件机制,用户可以引入额外语言包或识别引擎扩展。(
- 调用方式多样:支持命令行、HTTP 接口、本地 GUI 操作等多种方式使用。
- 适用平台:主要在 Windows(Windows 7 / 10 / 11 的 64 位系统)和 Linux 平台上有支持。
Umi-OCR 适合希望在本地实现 OCR 能力、避免网络依赖、并且愿意掌握一定技术部署的开发者或用户。

备用下载链接https://pan.quark.cn/s/0f2f2341be9f
核心功能详解
下面从具体功能维度展开,介绍 Umi-OCR 的实际能力和局限点,以帮助你判断是否适合自己的场景。
1. 截图 OCR / 屏幕文字识别
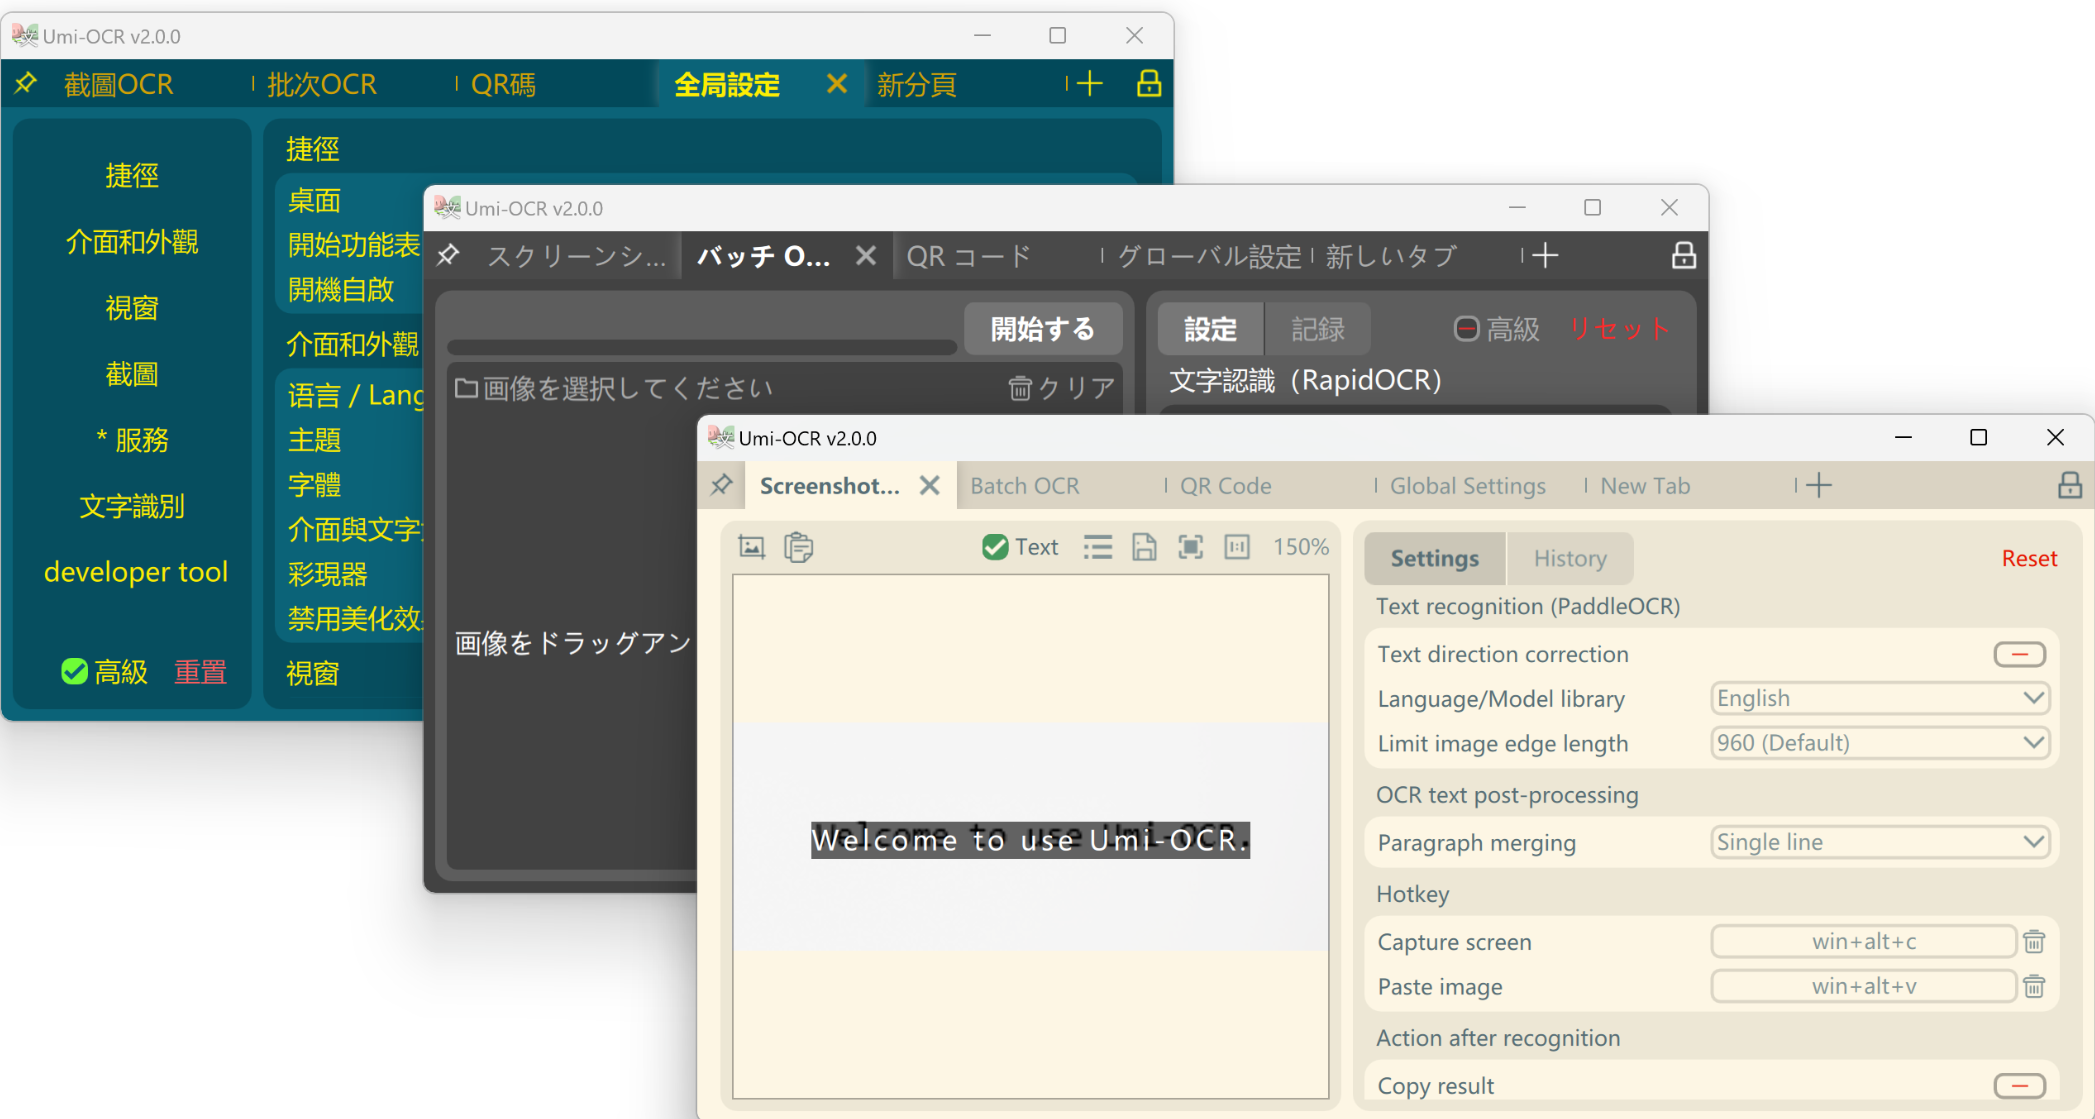
最典型的功能之一,是用户可以用快捷键或选区截屏,把屏幕上的文字直接识别为文本。适合于办公场景、截图复制文字、网页图片文字提取等。
截图识别时,Umi-OCR 通常会在文字区域定位后提取文字,并输出为可复制文本。界面上会展示识别结果,用户可以复制 / 编辑 / 保存。([火山引擎开发者社区][5])
对于复杂排版(例如多栏、混合文字图片)时,Umi-OCR 还具备一定的段落合并或排序处理逻辑,以尽量还原原文排版顺序。
不过要注意:对于极端复杂的图文排版、深度扭曲、低分辨率文字等情形,其效果可能受限。
2. 批量图片 / 文档 OCR
对于大量图片或文档需要一次性识别的场景,Umi-OCR 支持批量导入进行 OCR 处理。
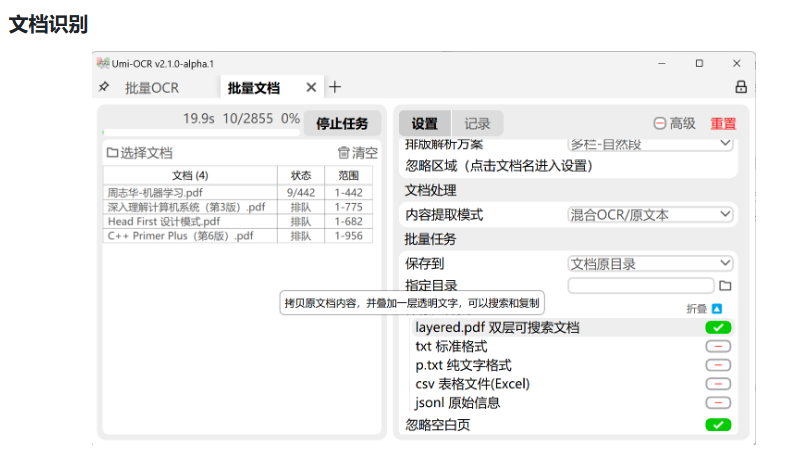
用户可以将一批图片或扫描文档导入,软件会逐张运行识别,并将识别文本输出为文件(如 TXT、MD、JSON 等格式)。
此外,批量识别模块常提供“忽略区域”功能——用户可以预先指定图片中的某些区域不参与识别(如水印、图标、UI 元素等干扰物)。这样可提高识别的准确性和可读性。
对于文档格式如 PDF,在某些版本或借助插件时,Umi-OCR 也支持从 PDF 中提取文字或转为可搜索的双层 PDF。
3. 二维码 / 扫码 / 生成二维码
Umi-OCR 除了文字识别外,也具备二维码 / 扫码功能。有些版本支持识别图片中的二维码,甚至将其还原为内容。
此外,它还可能支持将文本转为二维码(即二维码生成)功能,以便将识别内容进一步封装。
二维码识别功能相对基础,一般适合作为附加功能使用,不是其主要竞争力。
4. HTTP 接口 / 命令行调用
对于开发者,Umi-OCR 提供 HTTP 接口,使得它可以成为一个局部服务,被其它程序调用(如 Web 服务、后端任务脚本等)。
例如,将本地运行的 Umi-OCR 服务启动后,可通过 HTTP POST 请求上传图片 / 文件,得到 JSON 格式的识别结果。
命令行调用使其可被自动化脚本 / Jenkins 等工具整合。用户可以在脚本中写命令执行 OCR,而不依赖图形界面。
这种方式增强了其在工程化、自动化场景中的适用性。
5. 插件 / 扩展机制
Umi-OCR 支持插件机制,用户可以安装第三方插件,以扩展识别能力或引擎类型。([GitHub][3])
常见插件包括 RapidOCR、TesseractOCR 插件、Pix2Text 插件、WechatOCR 插件等,不同插件适合不同识别场景 / 语言 /性能取舍。([GitHub][3])
例如 TesseractOCR 插件可用于处理某些语言 / 排版复杂文档,Pix2Text 插件支持数学公式 / 混排识别等。
插件机制使得 Umi-OCR 在基础功能之外具备可扩展性,用户可以依据自己需求定制识别引擎组合。
6. 性能与准确率
在实际社区反馈中,Umi-OCR 在通用印刷体文字识别上表现稳定且速度较快。([知乎专栏][8])
对于中英文混排、常规版式文档,它的识别率在多数情况下可满足日常使用。但对于手写体、极度模糊、复杂背景插图混排等场景,可能仍有识别错误或遗漏。
插件、模型版本、图像清晰度、预处理方式(如去噪、裁剪、倾斜校正)等,对准确率有重大影响。
安装指南与快速上手
下面给出从零开始安装与使用 Umi-OCR 的步骤说明,适合对初心者技术友好。
一、下载与准备
- 前往 Umi-OCR 的 GitHub Release 页面或源码库,获取最新版本。
- 根据系统下载对应版本的压缩包(例如 Windows 版
.7z、Linux 可执行、或源码包)。 - 若有多国语言识别包(DLC / plugin 资源包),一并下载备份。
- 解压压缩包至某个目录(例如
C:\Umi-OCR或/opt/umi-ocr)。
注意:如果选择源码版本,还需要安装依赖环境(Python、库、编译工具等)。
二、初次运行 / 配置
- 对于免安装版本,通常解压后直接运行主程序(如
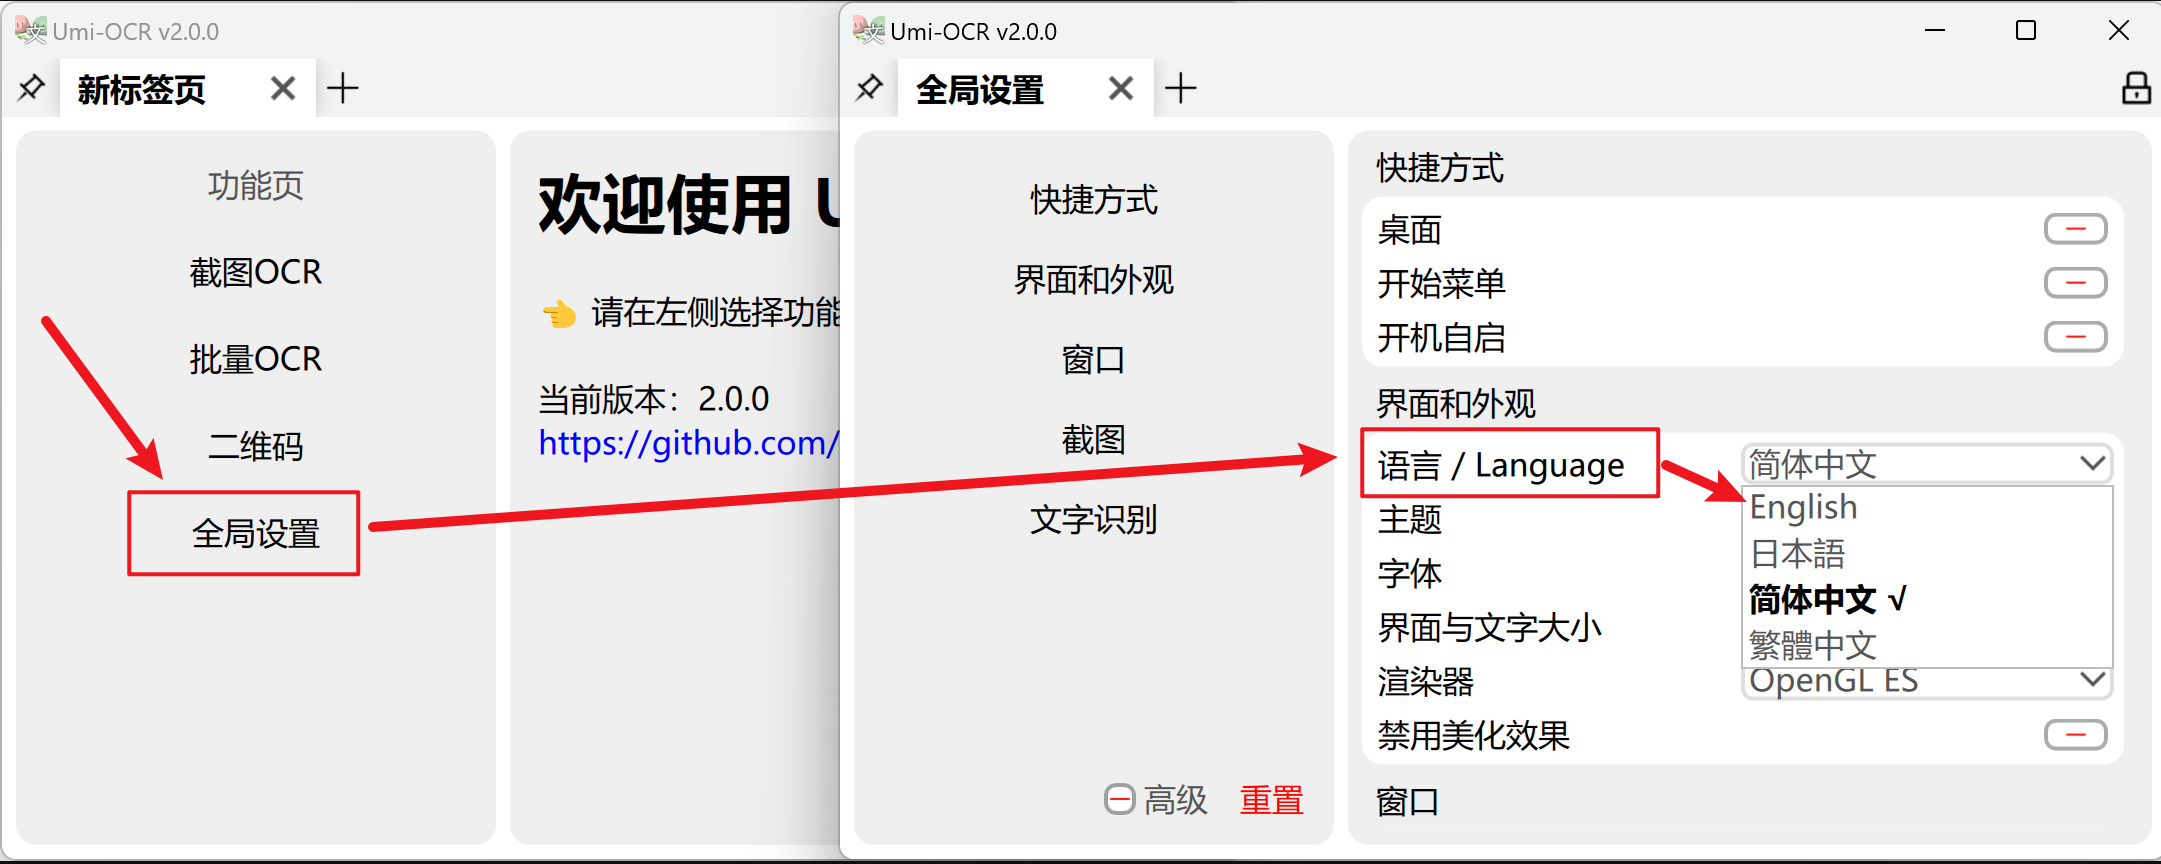
Umi-OCR.exe或对应可执行文件)。 - 打开程序后,推荐先检查 “全局设置 / 语言 / 模型路径 / 插件路径” 等选项,确保程序能找到语言模型与插件。
- 若下载了插件或外部语言包,要将其解压 /复制到指定目录,程序启动时加载。
- 如果使用 HTTP 接口或命令行调用方式,检查相应的端口、接口参数、启动脚本是否正确。可参考项目 README 或接口文档配置。
三、使用示例
下面列出几种典型使用方式示例,帮助快速上手。
示例 1:GUI 界面截图识别
- 启动 Umi-OCR GUI 界面。
- 进入 “截图 OCR” 模式(或相应标签页)。
- 使用快捷键或鼠标框选屏幕中要识别的区域。
- 程序会自动识别文字并在界面右侧 / 下方显示结果。
- 用户可以复制 / 编辑 / 保存识别结果文本。
示例 2:批量图片识别
- 切换到 “文件 OCR / 批量识别” 模式。
- 添加待识别的图片文件或整个文件夹。
- 设置输出格式、忽略区域(若有)等选项。
- 点击 “开始识别” → 等待处理完成后查看导出文本。
示例 3:通过 HTTP 接口调用
假设你在本地启动了 Umi-OCR 服务,暴露 /ocr 接口,可以用 Python 示例代码调用:
import requests

url = "http://127.0.0.1:12345/ocr"
with open("test.jpg", "rb") as f:
    files = {"file": f}
    r = requests.post(url, files=files)
res = r.json()
print(res["text"])
你可以按需把这个 HTTP 接口整合到后端服务、自动化脚本、批量任务等。
示例 4:命令行调用
如果 Umi-OCR 附带命令行版本或脚本,可以在终端调用:
umi-ocr --input path/to/image_folder --output output.txt
具体参数名称可能依版本不同,建议查看 --help 或 README 文档。
四、插件与模型管理
- 在 Umi-OCR 设置界面,可以切换当前 OCR 引擎 / 排版方案 / 插件。
- 若安装插件(如 TesseractOCR 插件、Pix2Text 插件),需要将插件文件放到插件目录,并在设置中启用。
- 对于语言模型、识别库更新,也需要替换模型文件 / 拷贝到指定目录。
- 使用插件或不同引擎时,要注意识别效果、性能占用、兼容性等参数调整。
五、故障排查 & 常见问题
- 如果启动失败或报 “模型不可用 / 文件缺失” 错误,请检查模型 / 插件路径配置是否正确。
- 若 HTTP 接口无法访问,检查程序是否成功启动服务、端口是否被占用、防火墙是否阻止。
- 当识别效果差或遗漏,建议尝试更清晰的原图、裁剪区域、预处理(如去噪、纠偏)等。
- 插件冲突或兼容性问题较少见,但在使用多个插件时要确保它们不会互相覆盖模型资源。
使用场景 & 应用建议
下面列出 Umi-OCR 在实际中的几个典型使用场景与建议,以帮助你评估它是否适合你的项目 / 工作流程。
- 文档数字化:将扫描版合同、票据、书籍等图片/PDF 转为可编辑或可检索文本。
- 界面文字提取:对于无法复制文字的界面 / 截图 / UI 文本,可以快速提取。
- 自动化流程:如发票识别、批量报表 OCR、后台系统 OCR 任务等,通过 HTTP 接口或命令行集成。
- 离线环境 / 隐私场景:在不能联网或希望避免外部服务风险的场景下使用。
- 多语言 / 混排文本识别:如果你处理跨语言文档或混排版式文档,可以结合插件 / 模型探索最优识别策略。
需要注意的是,如果你的需求是极高精度、极端复杂排版或手写文字识别,可能要和专业 OCR 解决方案(付费服务、自己训练模型)搭配使用。Umi-OCR 在通用印刷体识别场景下表现比较稳定,是一个性价比很高的开源选择。
总结
Umi-OCR 是一款定位清晰、功能实用、开源且支持离线运行的 OCR 工具。它适合那些既有一定技术能力、又希望掌握 OCR 能力控制权的开发者或高级用户。通过其截图 OCR、批量处理、HTTP 接口、插件机制等功能,可以构建出适合自己业务场景的识别服务。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 21
 0
- 0


 已为社区贡献18条内容

所有评论(0)