StableMoFusion:基于扩散的运动生成框架-方法详解
论文:
StableMoFusion: Towards Robust and Efficient Diffusion-based Motion Generation Framework
1 相关工作
之前在基于扩散模型的人体动作生成领域的工作可以主要分为两大类,它们分别关注通用动作生成和特定伪影修复,但都存在各自的局限性。
第一类是通用的动作扩散模型,其做法是探索不同的网络架构和训练策略来提升生成质量。例如,MotionDiffuse使用交叉注意力机制来融合文本信息,MDM探索了Transformer和GRU作为去噪网络,MLD则通过在压缩的隐空间中进行扩散来加速生成,而ReMoDiffuse则引入了检索机制来增强效果。这类工作的核心缺点是“碎片化”和缺乏系统性分析。其背后的深层原因是,这些工作各自为战,采用了五花八门且互不兼容的网络结构、训练流程和推理采样器。
这导致了两个严重问题:首先,无法进行公平的横向比较,我们无从得知一个模型的成功究竟是归功于其新颖的架构还是特殊的训练技巧;其次,这阻碍了领域的整体进步,因为一个模型的优秀设计很难被方便地借鉴和整合到其他工作中,使得整个领域的发展显得零散且效率低下。
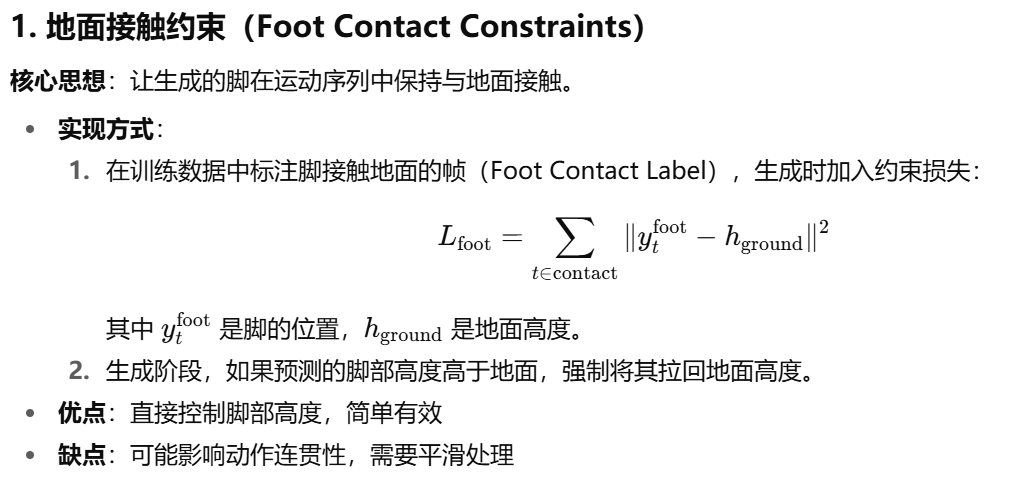
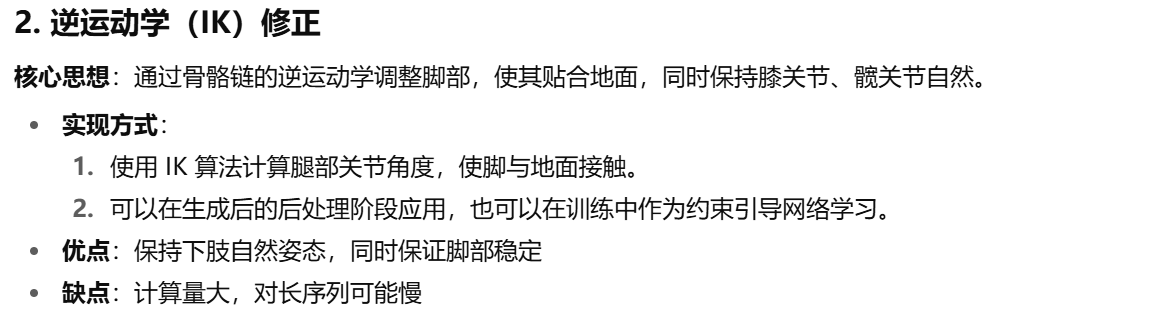
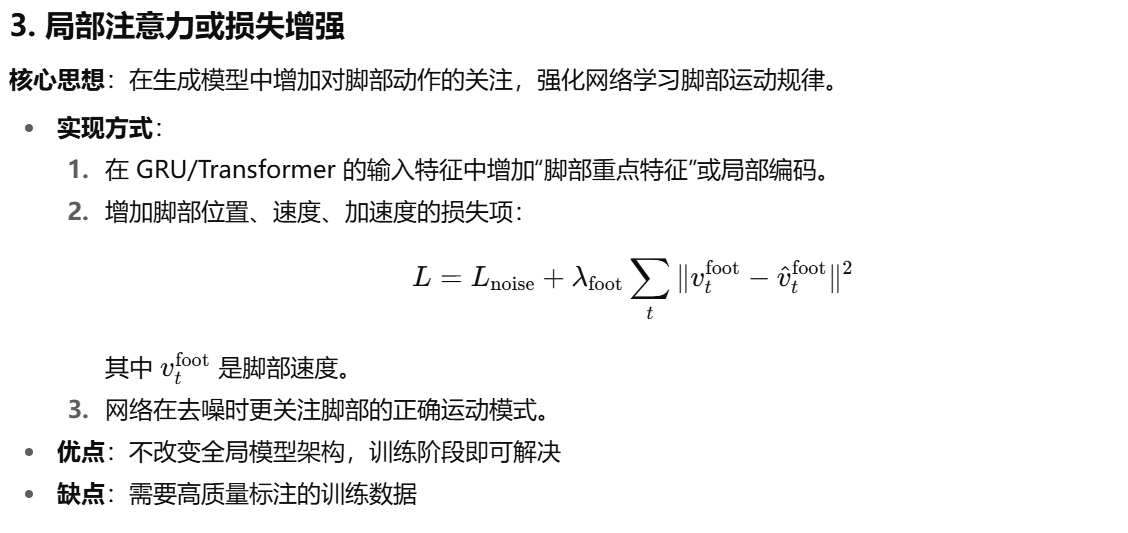
第二类是专门针对“浮冰脚”(Footskate)问题的修复工作,即生成的角色脚部在非走动时会在地面上不自然地滑动。之前的做法主要有三种:一是将脚部接触信息作为额外约束加入训练损失中(如Edge);二是利用强化学习来惩罚不符合物理规律的动作(如Physdiff);三是利用带有地面反作用力信息的特殊数据集进行训练(如UnderPressure)。这类工作的缺点在于效果有限或通用性不强,导致“浮冰脚”问题至今仍是一个“普遍存在”的难题。其原因在于,简单的损失约束可能不足以对抗强大的扩散模型产生的平滑但不真实的倾向;强化学习方法训练复杂且不稳定;而依赖特定数据集的方法则难以泛化到没有这些特殊标注的、更广泛的动作数据上,限制了其实用性。
1.1 MotionDiffuse的交叉注意力机制
MotionDiffuse 是一种 基于扩散模型(diffusion model)的动作生成框架,主要用于从文本条件(如 “a person is walking”)生成连续的 3D 骨架动作序列。
它的关键思想是:
-
用扩散模型处理动作序列(把动作当作高维时序信号)。
-
使用 交叉注意力(cross-attention) 将文本嵌入对动作生成进行条件约束。
1.扩散模型
什么是扩散模型?
扩散模型有两个过程,前向加噪过程和后向去噪过程。比如,对于前向过程,有一张清晰的图片,不断加噪声,最后变成一张“纯噪声”图片;对于去噪过程,就是我们训练的部分,从噪声一点点去噪,还原出原始图片。
数学上的扩散模型
给定一个真实数据 x0(比如一张图片或一段动作序列)
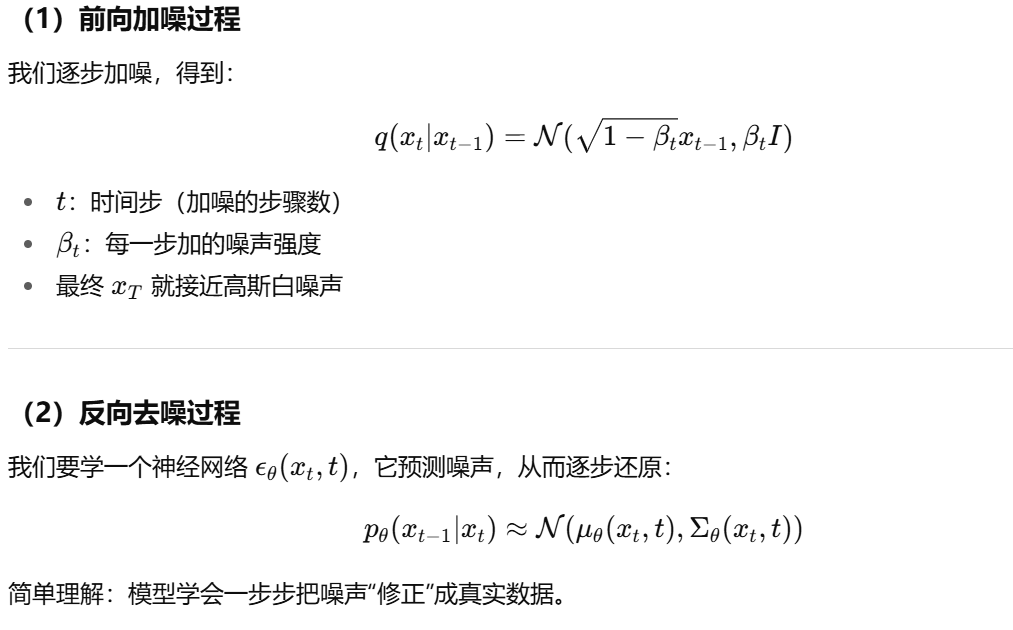
在动作生成中,数据不再是图片,而是 动作序列(3D 骨架随时间变化的数据)。
前向过程:把动作序列逐步加噪,直到完全是随机运动。
反向过程:从随机运动开始,逐步去噪,生成一个真实、自然的动作。在在每一步的去噪过程中,动作序列被切成时间片,每一帧动作作为 Transformer 的一个 token。
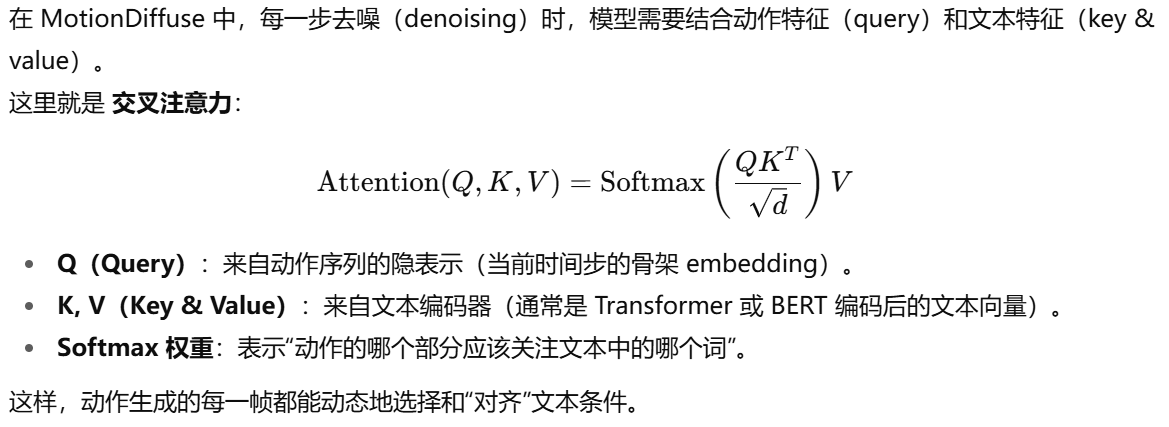
条件控制:在去噪的过程中,通过 交叉注意力 引入文本信息,让生成的动作符合“a man is walking”之类的描述。文本条件通过 cross-attention 注入:在每一层的 Transformer block 里,除了自注意力(动作序列内部时序建模),还会有一层 cross-attention,把动作 token 和文本 token 交互。这样可以捕捉到 动作与语言的对应关系(例如文本的 “jump” 就会驱动动作序列生成跳跃的模式)。
2.交叉注意力
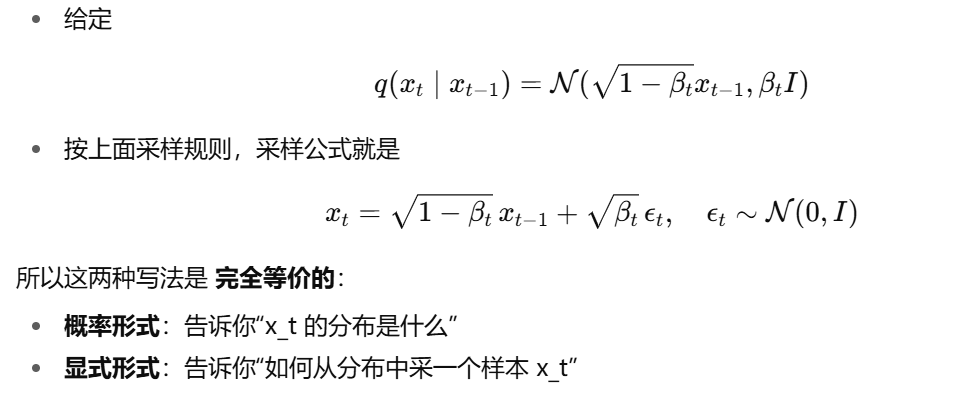
3.加噪过程的两种写法
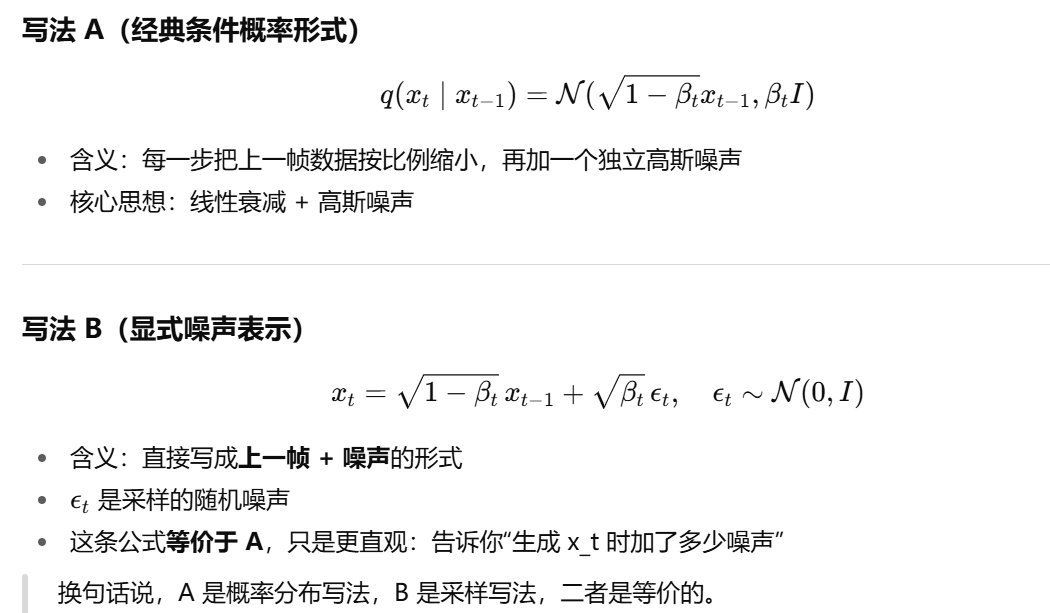
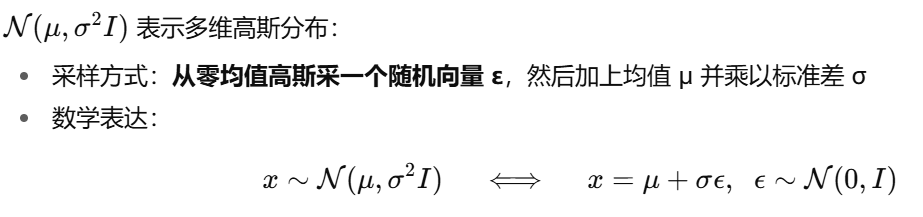
应用到扩散模型
1.2 MDM:GRU作为去噪网络
(motion diffusion model)
为什么用GRU?
动作序列是 典型的时序数据(每帧动作依赖前一帧),Transformer 擅长建模长程依赖,但参数量大、计算复杂;GRU 轻量、对连续时间序列自然建模,能高效捕捉动作随时间变化的连续性
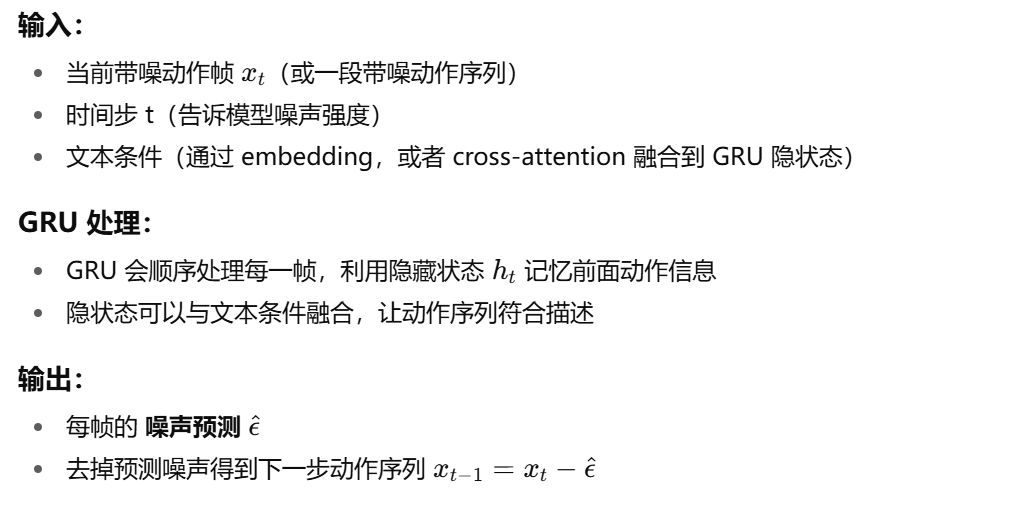
在GRU中常见的文本融合方式:
1.条件向量加到输入:每帧动作 token xt 与文本 embedding 拼接,作为 GRU 输入
2.条件注入到隐藏状态:GRU 隐状态 ht 加上文本向量,模型可以参考文本控制去噪
1.3 MLD在隐空间中扩散
(Motion Latent Diffusion)
为什么在隐空间扩散?
直接在动作序列的原始骨架空间做扩散:数据维度很高,比如每帧 24 个关节 × 3 坐标 × 60 帧,扩散模型需要预测高维噪声 → 计算量大、训练慢
MLD 的思路:用一个编码器把动作序列映射到 低维隐空间 z,在隐空间做扩散和去噪,最后再用解码器把隐表示还原回原始动作
这样降低计算量,提高建模效率,还能捕捉动作的全局结构
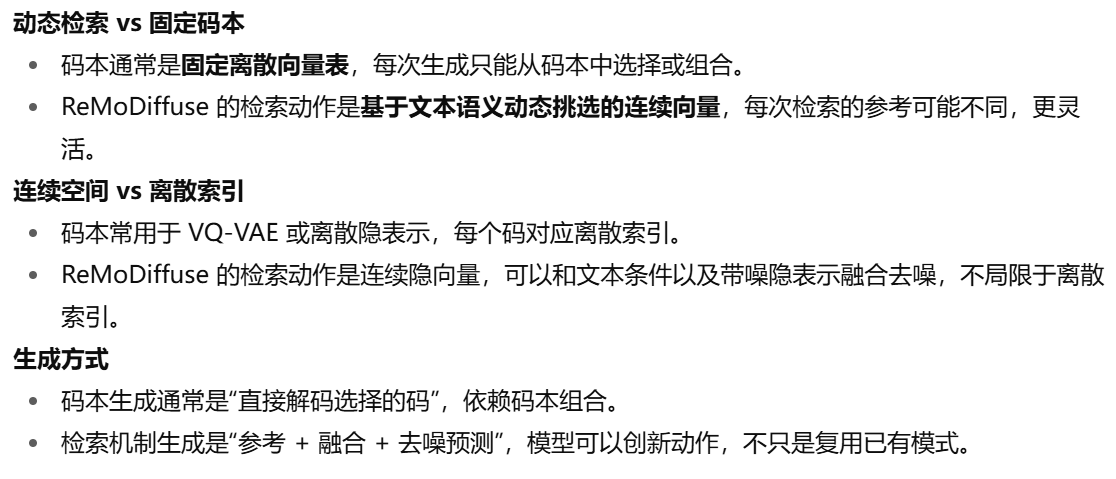
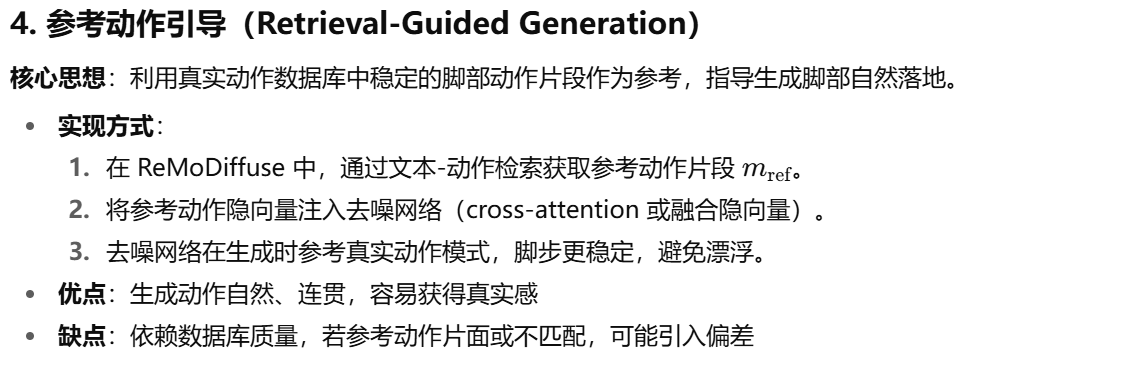
1.4 ReMoDiffuse引入检索机制
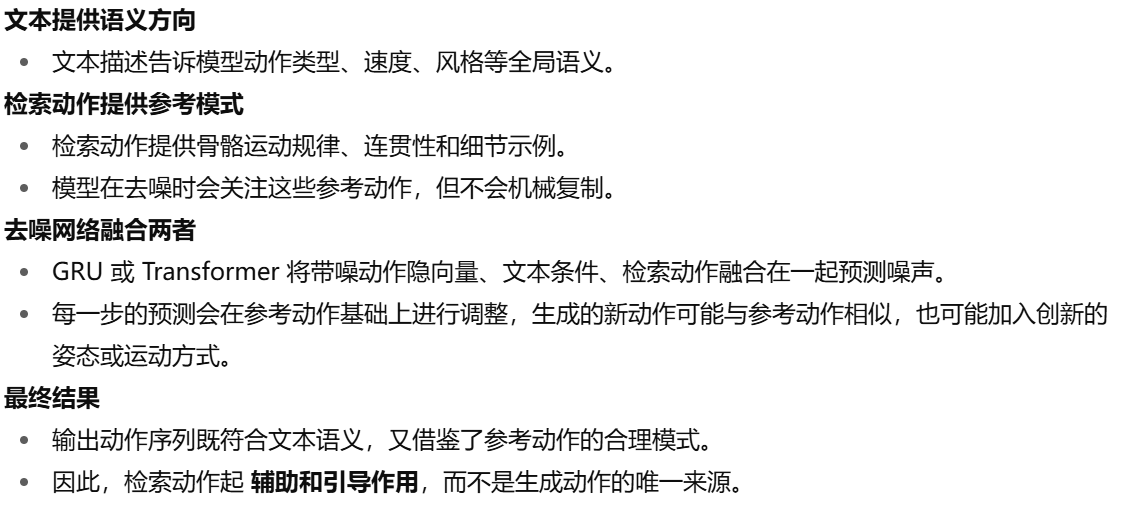
思路:利用已有 动作数据库(动作库) 来补充信息,通过检索机制找到与文本描述最匹配的参考动作,然后引导生成
文本编码是检索机制的第一步。系统将用户提供的文本描述输入文本编码器,例如 CLIP 文本编码器,通过编码器将文本信息映射为一个向量 c。这个向量捕捉了文本的语义特征,用于后续与动作数据库中动作向量的匹配,从而为生成动作提供语义参考。
接下来是动作库编码与检索。动作库中的每段动作也通过动作编码器映射为向量 mi,形成一个完整的动作向量库 [m1,m2,...,mN]。系统计算文本向量 c 与动作库中每个向量 mi 的相似度,例如通过余弦相似度来衡量匹配程度,然后选出最相似的 K 个动作片段作为参考,为生成动作提供具体模式和细节信息。
最后是检索信息注入生成过程。检索得到的动作参考可以通过两种方式与去噪网络融合:一种是 cross-attention 注入,将参考动作向量作为 Key/Value,当前动作 token 或文本作为 Query,使网络在去噪时能够关注参考动作以修正预测;另一种是隐向量融合,将参考动作隐向量与当前带噪隐表示 zt拼接或加权平均,输入去噪网络以预测噪声。这一机制使生成动作不仅符合文本语义,还能借鉴真实动作模式,使动作更自然、连贯且细节丰富
原因:文本描述往往信息有限,例如“走路”或者“跳跃”,并不能完全约束动作的每一个细节。检索机制会在已有动作数据库中找到与文本语义最匹配的真实动作片段,把这些动作作为参考输入模型。在去噪或隐向量生成过程中,模型可以借助这些参考动作学习到合理的动作模式、骨骼运动规律和时序变化,从而生成的动作既符合文本描述,又更自然、连贯,避免生成过于模糊或不真实的动作
生成动作并不是直接复制检索出的动作,而是 参考检索动作并结合文本条件生成新的动作序列
与码本的区别
1.5 浮冰脚问题
描述:生成的动作序列中,角色的脚在空中“漂浮”或“滑动”,看起来像踩在冰面上一样,而不是自然着地。具体表现为:脚步没有与地面接触的物理约束走路、跑步等动作中脚没有停稳,动作显得不自然、缺乏真实感。这种问题在生成模型(如 MotionDiffuse、MLD、ReMoDiffuse)中尤其明显,因为模型可能过度关注骨架整体形状或上肢动作,而没有足够的约束去保证下肢与地面的接触。
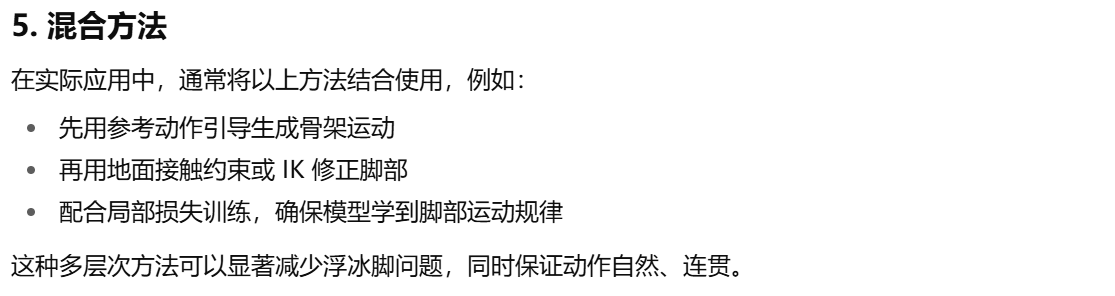
常用解决方法
2 动机
这篇论文的核心动机(Motivation)是解决当前扩散模型在人体动作生成领域面临的三个关键性瓶颈,旨在构建一个既鲁棒又高效的统一框架,即StableMoFusion。这三个瓶颈分别是:
1)由于现有工作方法各异(即“碎片化”),领域内缺乏对各个组件(如网络结构、训练策略)如何影响最终性能的系统性认知;
2)扩散模型漫长的推理时间,这使得它们在需要实时响应的虚拟角色或机器人等应用中不切实际;
3)普遍存在的“浮冰脚”伪影,严重损害了生成动作的真实感和可用性。
为了解决这些问题,文章对整个流程进行了系统性的解构与建模。
首先,针对“碎片化”问题,它对模型架构进行了建模和对比实验,系统评估了Conv1D UNet、Transformer (DiT) 和 RetNet三种主流结构,并对内部模块进行调整,最终选择了表现最优的Conv1D UNet并进行了针对性优化,以此为基础建立了一个清晰、高效的基准。
其次,针对“推理效率”问题,它对推理过程进行了建模和优化,整合了四种无需重新训练的加速技巧:采用更高效的采样器(DPM-Solver++)以减少迭代步数、缓存文本嵌入以避免重复计算、并行化计算条件和无条件分支,以及使用低精度计算(FP16)。这套组合拳式的方法建模,旨在最大化地压缩计算开销。
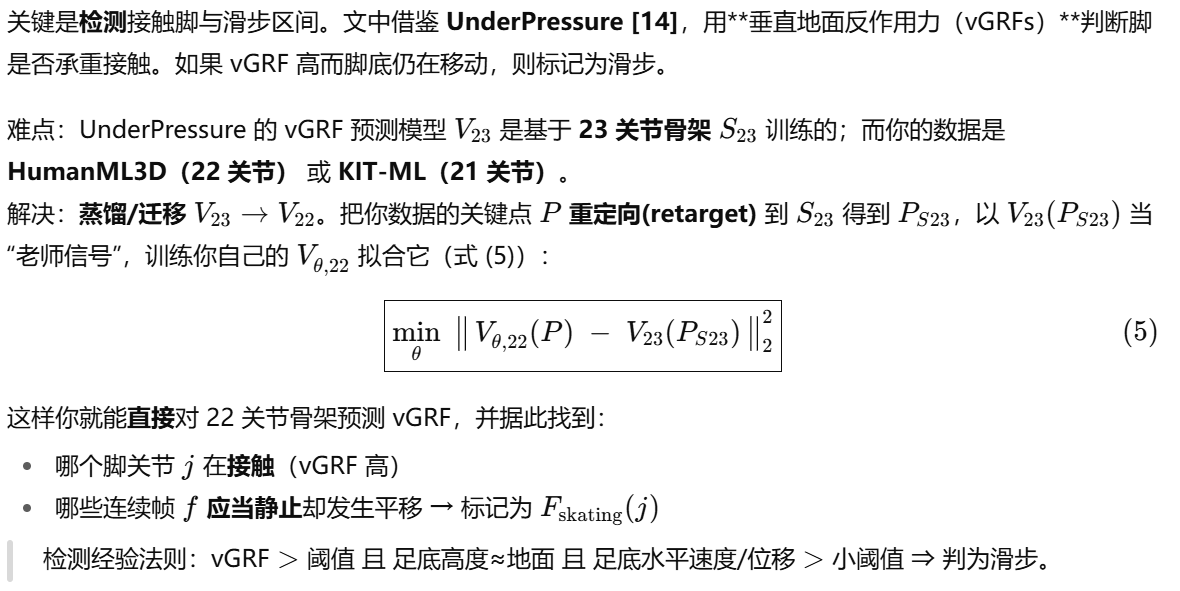
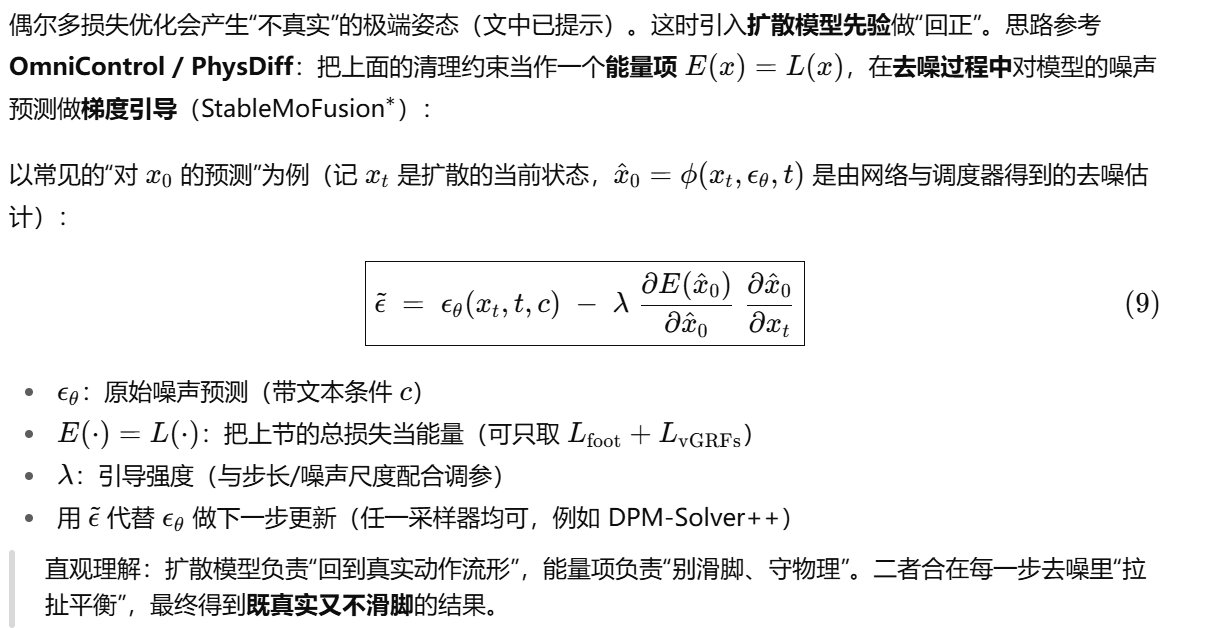
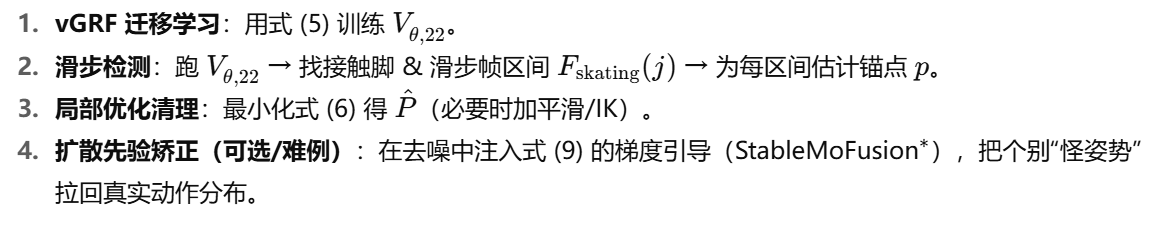
最后,针对“浮冰脚”问题,它提出了一个基于物理约束的后处理优化建模:首先利用一个预训练的地面反作用力(vGRF)模型来自动识别出发生滑动的脚部关节点和时间范围;然后,它将这个问题建模为一个优化任务,定义了一个损失函数(L_foot),通过梯度下降直接在生成的动作数据上进行迭代修正,将滑动的脚部“锚定”回其应在的稳定位置,从而在不破坏整体动作流畅性的前提下,精确地消除了这一顽固的视觉伪影。
、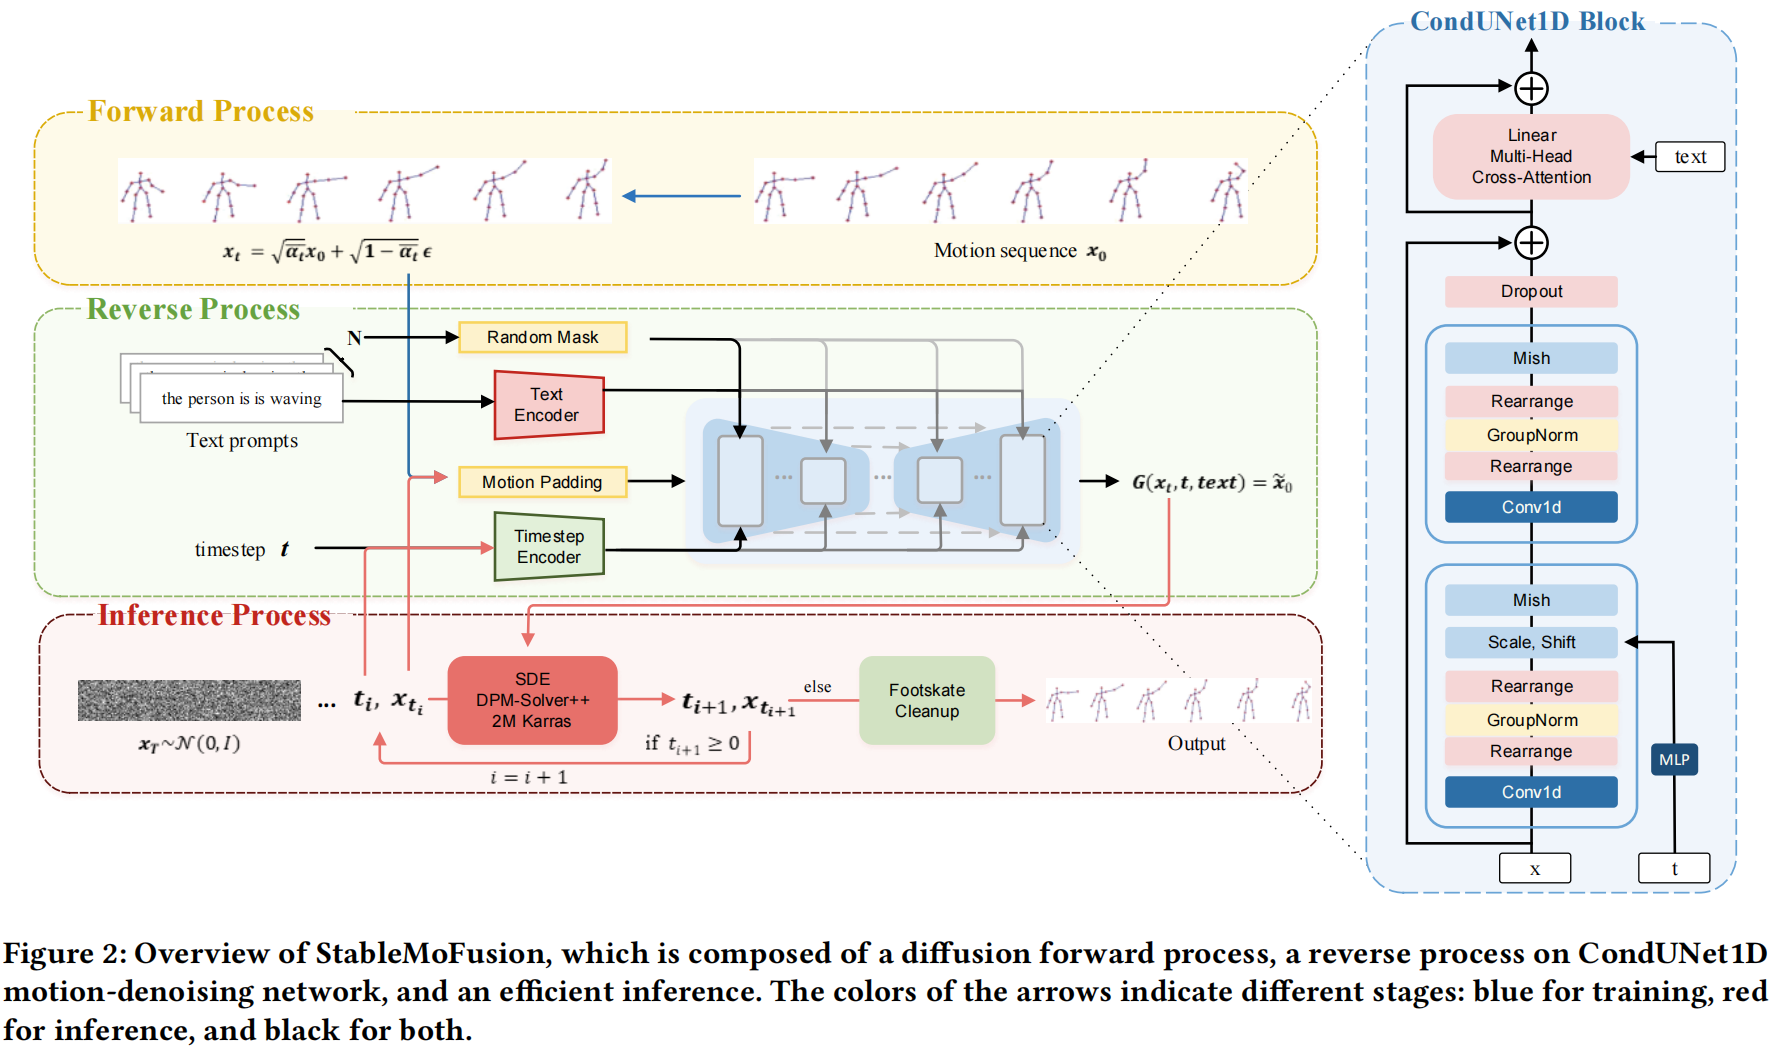
主模块
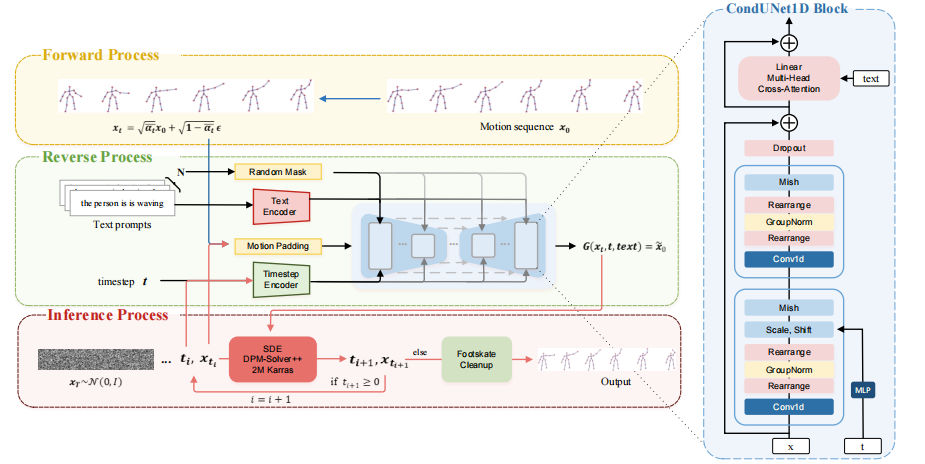
1. 前向过程 (Forward Process) - 负责“加噪”
- 这是什么? 这是一个理论上的过程,是扩散模型的基础。它从一个真实的、干净的动作序列(
x₀,比如一段人走路的骨骼数据)开始,在每个时间步t逐渐向其中添加高斯噪声ε。 - 公式
xt = ...的含义: 这个公式描述了在任意时间步t,加噪后的动作xt是如何由原始动作x₀和纯噪声ε组合而成的。随着t增大,ᾱt变小,意味着原始动作的成分越来越少,噪声的成分越来越多。当t达到最大值T时,xt几乎就变成了纯粹的随机噪声。 - 作用: 这个过程为我们提供了大量的“从有噪声的数据恢复到无噪声数据”的训练样本对 (
xt,x₀),是后续模型学习的“教材”。
2. 反向过程 (Reverse Process) - 负责“学习去噪”
- 这是什么? 这是模型训练的核心阶段,目标是训练一个网络模型
G(图中蓝色的U-Net结构),让它学会如何从一个加了噪声的动作xt中预测出原始的、干净的动作x₀。 - 输入: 模型的输入有三个:
- 加噪的动作序列 (Noisy Motion): 前向过程加噪结束后的xt,模型的主输入。
- 文本提示 (Text Prompts): 例如“the person is waving”(这个人在挥手)。这些文本先通过一个文本编码器 (Text Encoder) 转换成机器能理解的数字向量。同时,为了实现无分类器引导(CFG),这里还有一个随机掩码 (Random Mask) 的步骤,即在训练时以一定概率(比如10%)将文本提示替换为空白,让模型也学习在没有文本指导时如何生成动作。
- 时间步 (timestep t): 当前的噪声水平
t被一个时间步编码器 (Timestep Encoder) 编码,告诉模型现在处理的噪声有多大,以便模型能做出相应的去噪调整。
- 核心模型: 中间的蓝色方框代表CondUNet1D,这是一个专门为一维序列数据(如动作)设计的U-Net网络。它接收加噪的动作、编码后的文本和时间步信息,最终输出对原始动作
x₀的预测。 - 目标: 让模型预测出的
x₀尽可能地接近真实的x₀。
时间步编码器是什么?
相当于transformer中用于区分序列先后的时间嵌入
将一个代表时间步的简单数字(例如,在总共1000步中的第500步)转换成一个神经网络能够理解和处理的高维向量
在扩散模型的反向(去噪)过程中,模型需要在多个步骤中迭代地去除噪声关键在于,在不同步骤需要执行的操作是截然不同的 。在早期阶段(例如第900步,噪声很多),模型需要进行大刀阔斧的、粗略的调整,主要是构建出生成内容(如动作序列)的大致轮廓和结构;在后期阶段(例如第50步,噪声很少),模型则需要进行精细化的微调,添加或修正细节,使内容更加逼真。
如果模型无法区分它正处于哪个阶段,它就可能会在所有步骤中都采用相同的去噪策略,这显然会导致非常糟糕的结果 1。时间步编码器正是为了给模型提供这种至关重要的“时间感”或“进度感”,让它能够根据当前所处的阶段来调整其行为,从而学习到在特定阶段执行特定的操作
Motion Padding是什么?
一种预处理步骤
在训练神经网络时,通常需要将一批(一个batch)数据一起送入模型进行计算,以提高效率。然而,现实中的动作序列长度各不相同,比如“挥手”的动作可能只有30帧,而“走路”的动作可能有120帧 。这些不同长度的序列无法直接组合成一个规整的张量(tensor)供模型处理 。
解决方案:Motion Padding就是解决这个问题的策略 。它通过向较短的动作序列中添加特殊的“填充帧”(通常是全零向量),使得这个batch中所有的动作序列都具有相同的长度。这个统一的长度通常是该批次中最长的序列长度,或者是模型预设的最大长度
为了不让这些无意义的“填充帧”影响模型的学习,通常会配合使用一种叫做注意力掩码 (Attention Mask) 的机制。这个掩码会告诉模型,哪些部分是真实的动作数据,哪些部分是填充数据。在计算时,模型会忽略掉填充部分,使其不对最终结果产生影响
3. 推理过程 (Inference Process) - 负责“从无到有生成”
- 这是什么? 这是模型训练好后,实际用来生成新动作的阶段。
- 流程:
- 从纯噪声开始: 我们从一个完全随机的噪声序列
xT开始,它相当于前向过程的终点。 - 迭代去噪: 我们使用训练好的去噪模型
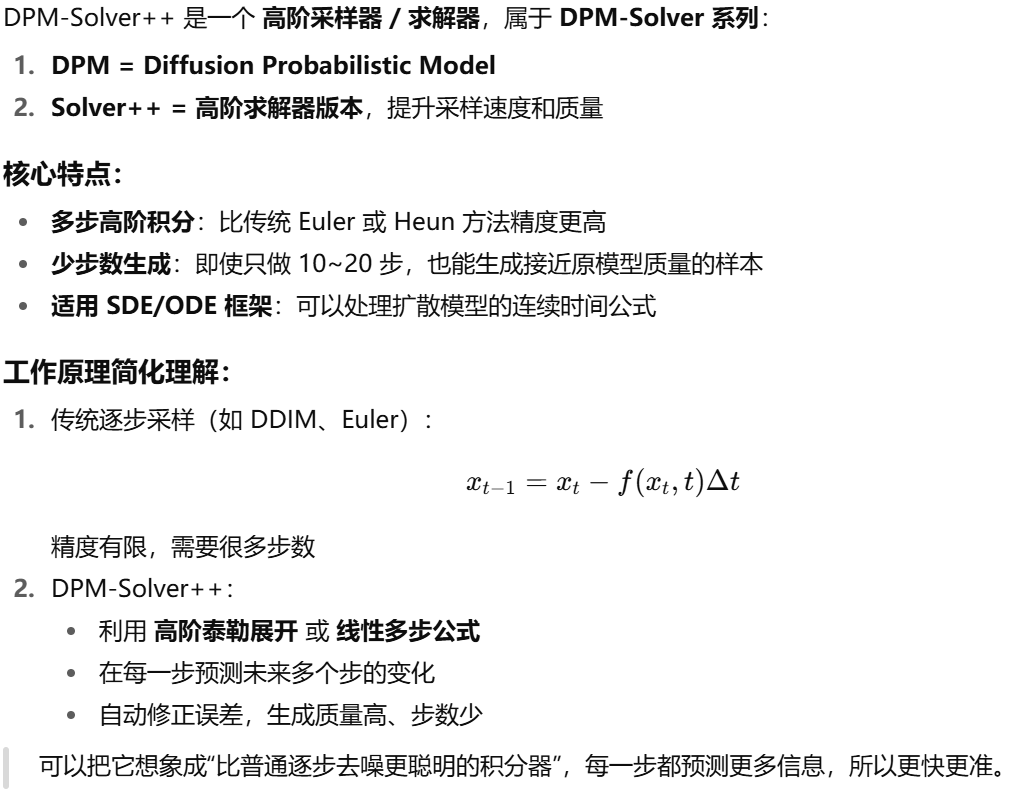
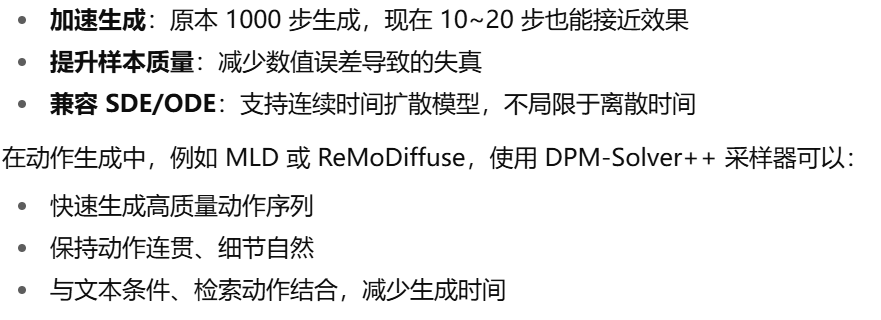
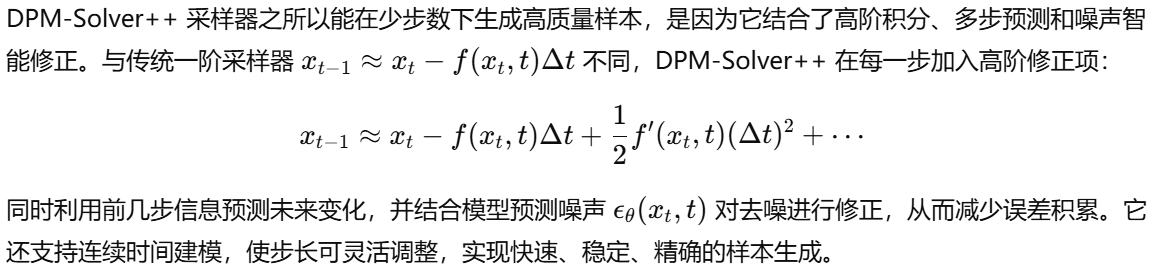
G,在一个循环中逐步地、一点一点地去除噪声。这个过程从t = T开始,一直到t = 0结束。 - 高效采样器: 为了加速这个漫长的去噪过程,这里没有使用传统的DDPM采样器,而是采用了更高效的采样器,如 SDE DPM-Solver++。这能把原本需要上千步的迭代过程,缩减到几十步甚至十步。
- 足部滑冰清理 (Footskate Cleanup): 当去噪过程完成后(即
t降到0),会得到一个初步的动作序列。此时,会启动一个可选的后处理步骤,即“足部滑冰清理”,来修复角色脚部在地面上不自然滑动的问题。 - 最终输出 (Output): 经过清理后,最终得到一个高质量、无明显瑕疵的动作序列。
- 从纯噪声开始: 我们从一个完全随机的噪声序列
采样器是什么?
1.为什么需要采样器
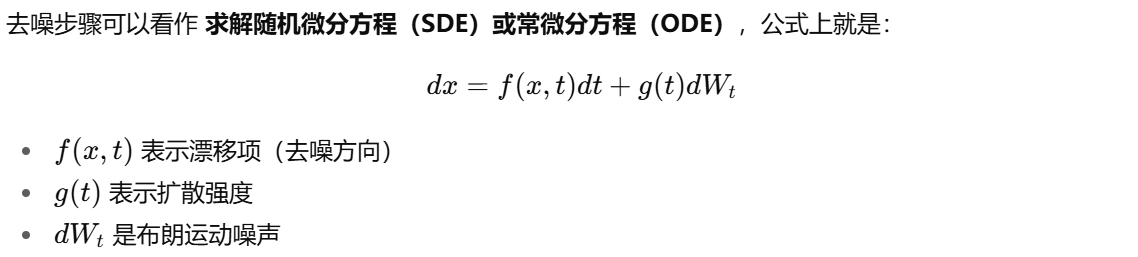
直接模拟这个 SDE 就可以生成样本,但 直接逐步积分效率低、计算量大,尤其是扩散步数很大(比如 1000 步)。
这时候就需要高效采样器,用更少的步骤得到接近原分布的样本
2.SDE 与扩散模型的关系
扩散模型可以用 SDE 表示前向加噪和反向去噪过程
正向 SDE:把干净样本加噪
逆向 SDE:从噪声采样,逐步去噪生成样本
采样器就是高效数值积分器,用来求解逆向 SDE,快速生成样本。
3.DPM-Solver++ 采样器是什么
4.重要性
CondUNet1D Block 详解
右侧的图是核心去噪网络中一个基本构建块 (Block) 的内部结构,揭示了信息是如何在网络中流动的。
- 输入: 这个块的输入是上一层传来的动作特征
x和全局的时间步编码t。 - 时间步嵌入: 全局的时间步编码
t首先通过一个 MLP (多层感知机) 网络进行处理,然后通过 Scale, Shift 的方式注入到主干网络中,这是一种高效的条件注入方法,称为FiLM。 - 主干路径 (左侧): 动作特征
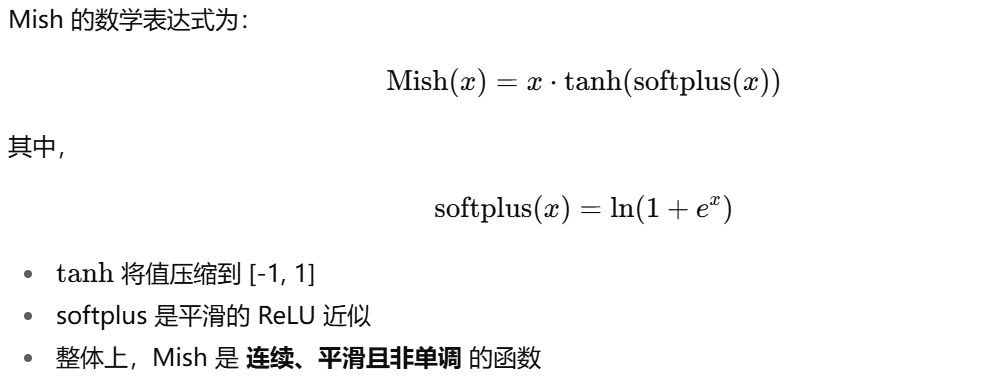
x沿着主干网络向下传递。它会经过一系列的卷积层(Conv1d)、激活函数(Mish)、归一化层(GroupNorm)。其中 Rearrange 操作是为了调整数据维度以适应不同的操作。 - 文本条件注入: 在主干路径上,最关键的一步是线性多头交叉注意力 (Linear Multi-Head Cross-Attention)。它的作用是:
- 将当前处理的动作特征作为查询 (Query)。
- 将从文本编码器传来的文本特征 (
text) 作为键 (Key) 和值 (Value)。 - 通过注意力计算,让模型能够关注到与当前动作帧最相关的文本词汇。例如,当生成“挥动右手”的动作帧时,注意力机制会更关注“挥动”和“右手”这两个词。
- 残差连接: 图中的
+符号代表残差连接。它将交叉注意力融合了文本信息后的结果与原始的动作特征相加,这有助于稳定训练并保留原始信息。
激活函数Mish
总结: 这张图描绘了一个精心设计的系统。它首先通过反向过程教会一个CondUNet1D网络如何根据文本和噪声水平,从噪声中恢复出干净的动作。这个网络的核心是通过交叉注意力机制,将文本语义精准地融合到动作特征中。然后,在推理过程中,该系统从一个随机噪声出发,利用高效的采样器和专门的浮冰脚修复模块,迭代地生成一个高质量、符合文本描述且动作自然的动画序列。
3 方法
这篇论文提出的核心方法是一个名为“StableMoFusion”的综合性框架,其设计动机在于通过对人体动作生成流程的每个环节进行系统性的分析和精细优化,来构建一个既鲁棒又高效的统一解决方案。整个方法的流程可以分解为四个相互关联的关键部分。
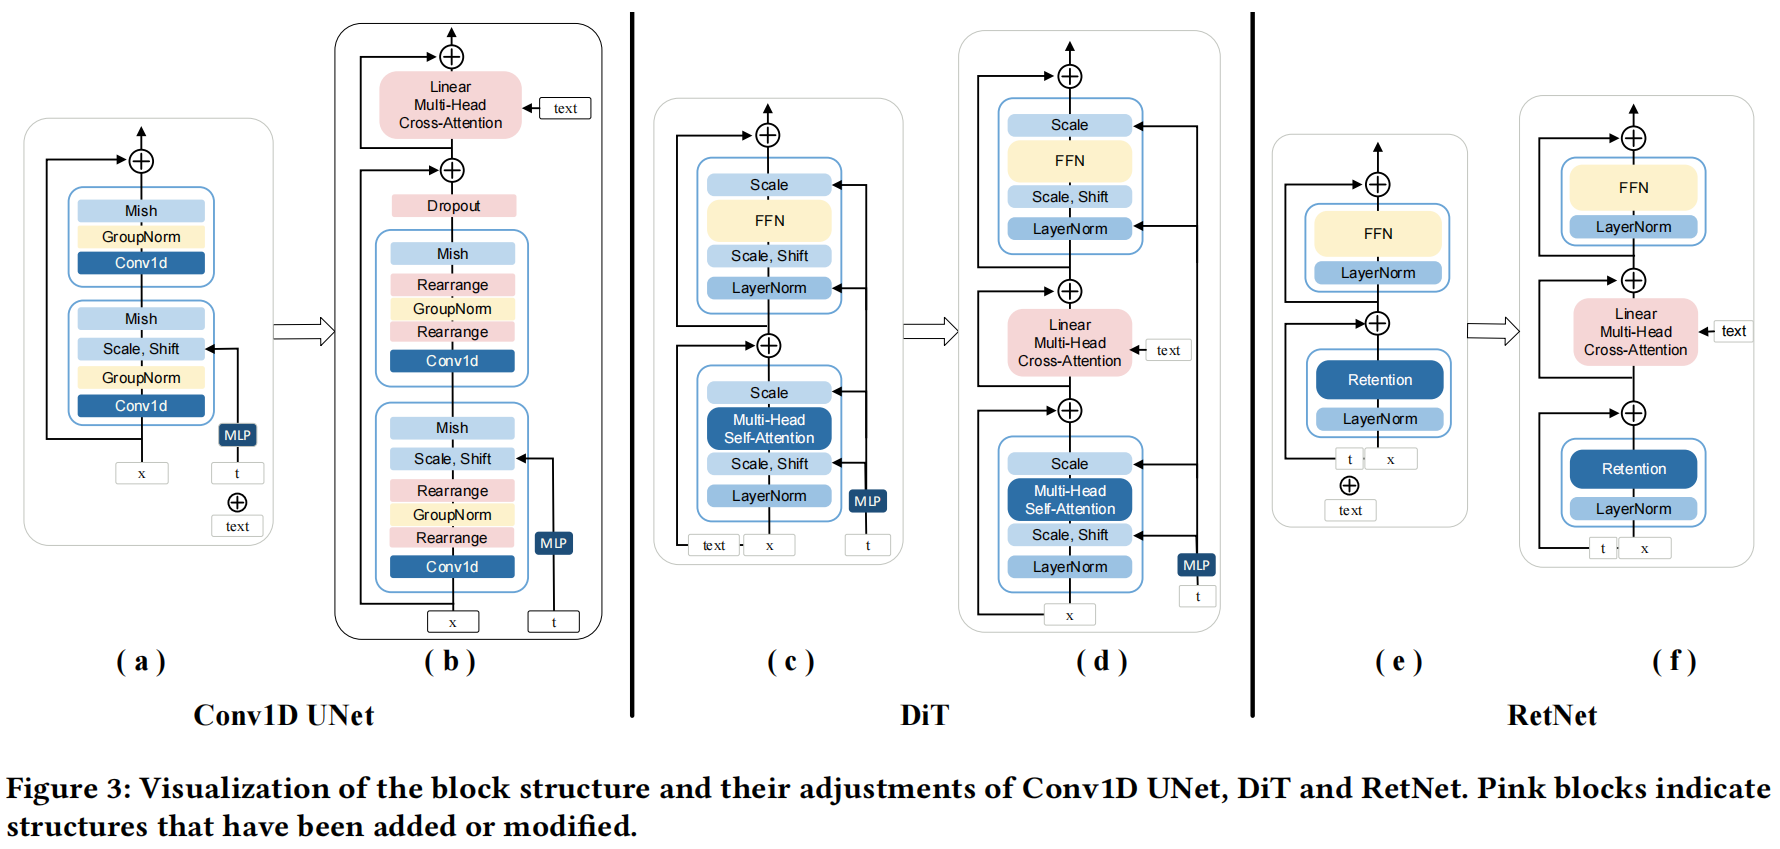
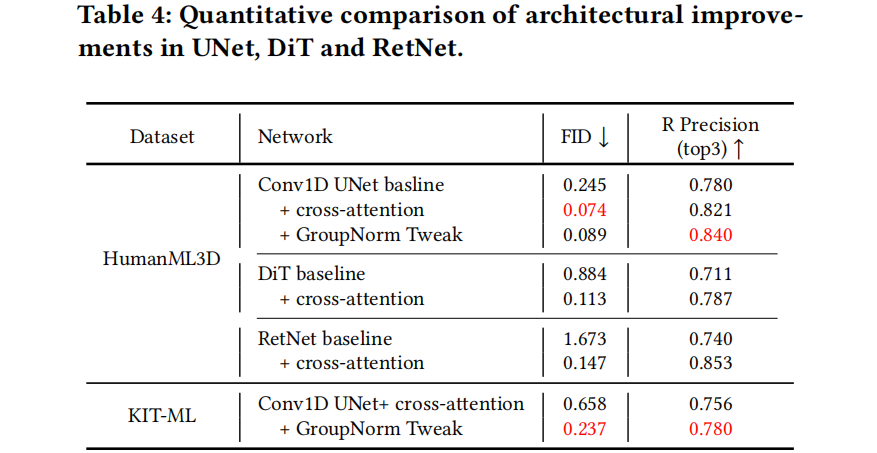
第一部分是模型架构的确定:作者首先对当前流行的Conv1D UNet、Transformer (DiT) 和RetNet三种网络结构进行了对比实验,其动机是为后续所有优化建立一个最坚实、最高效的基准。最终他们选择了Conv1D UNet,因为它在保留时空局部细节和生成平滑帧间过渡方面具有天然优势,并对其进行了两项关键改进:一是引入交叉注意力(Cross-Attention)机制,其动机是解决基线模型将同一个句子级文本信息应用于所有动作帧的粗糙问题,转而实现词元级别的文本语义与特定动作帧的精准对齐;二是进行了组归一化调整(GroupNorm Tweak),其动机是解决模型在处理不同长度的动作序列时性能下降的问题,使其对序列长度和填充(padding)更加鲁棒。
第二部分是训练策略的强化:引入了指数移动平均(EMA)和无分类器指导(Classifier-Free Guidance, CFG)两种策略。其动机是提升模型的训练稳定性和生成质量的可控性,EMA通过平滑模型参数的更新来减少训练震荡,而CFG则通过在有条件和无条件生成之间进行插值,允许在推理时灵活地权衡动作与文本的匹配度和动作本身的逼真度。
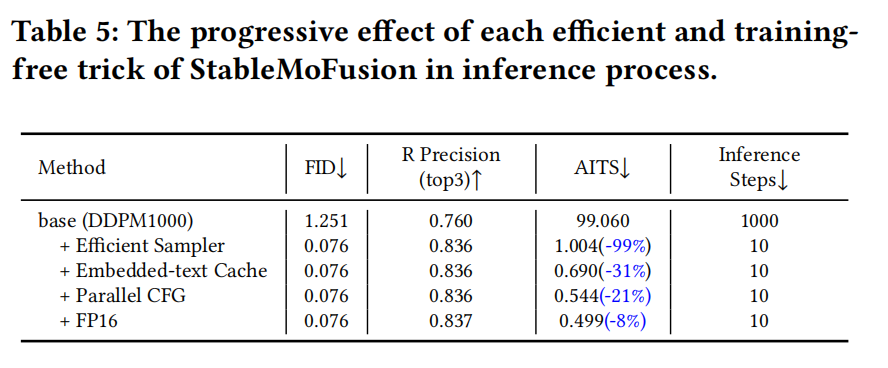
第三部分是推理过程的高效化:作者整合了四种无需重新训练的加速技巧。其动机是从根本上解决扩散模型推理速度慢、不适用于实时场景的痛点。具体流程是:首先,用高效的DPM-Solver++采样器替代传统的DDPM,将采样步数从1000步锐减至10步;其次,使用嵌入式文本缓存,避免在每一步迭代中重复计算文本特征;接着,并行化CFG计算,将原本串行的两次网络前向传播并行处理;最后,采用FP16低精度推理,利用现代硬件加速计算。
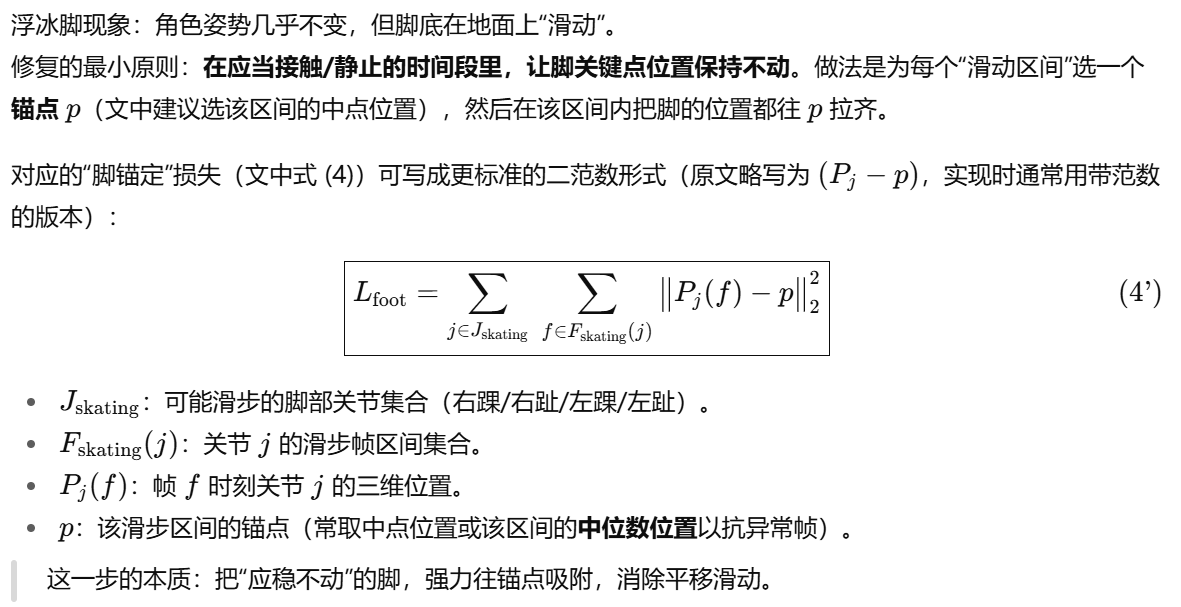
第四部分是针对“浮冰脚”(Footskate)伪影的精确修复:这是一个后处理优化步骤。其算法流程是:当模型生成一个动作后,首先利用一个预训练的地面反作用力(vGRF)预测模型来自动检测出脚部发生不自然滑动的关节点和时间段;然后,将这个问题建模为一个优化任务,定义一个损失函数来惩罚这些关节点与其稳定锚点之间的偏差;最后,通过梯度下降直接修正生成动作的坐标数据,直至伪影被消除。这一设计的动机是提供一个可泛化且效果显著的解决方案,以修复这个长期困扰该领域的顽固问题,从而极大提升生成动作的真实感和实用性。
3.1 GroupNorm Tweak
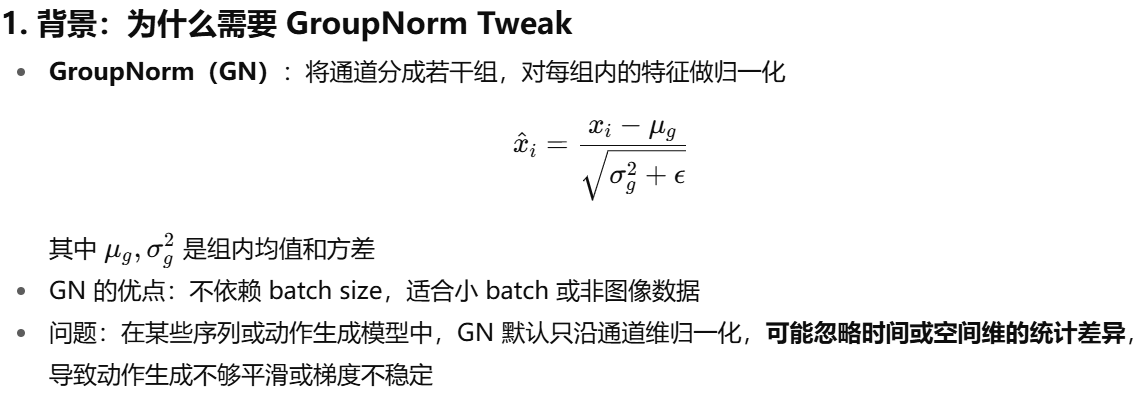
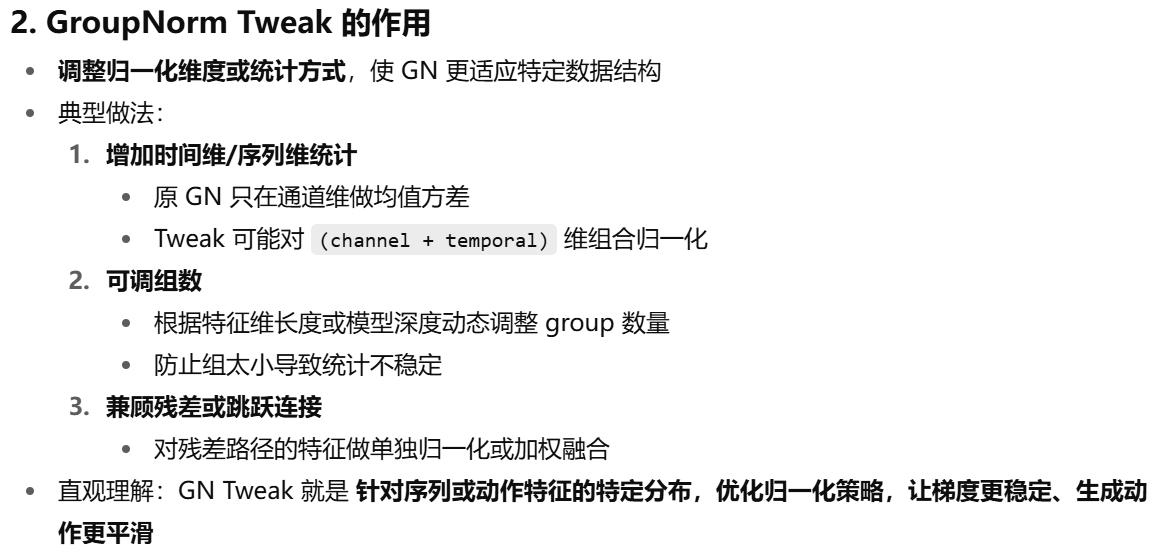
GroupNorm Tweak 是对 GroupNorm 的改进,通过调整归一化维度、组数或统计方式,使归一化更适合序列或多维特征,提升训练稳定性和生成效果。在动作生成或 Transformer 序列建模中,它可以让动作输出更平滑、细节更自然
3.2 指数移动平均(EMA)
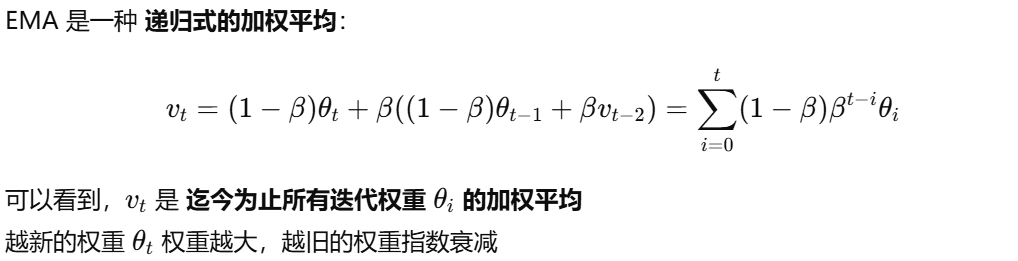
指数移动平均是一种 加权平均方法,用于平滑随时间变化的数据。在模型训练中,它的作用是对模型权重进行平滑:
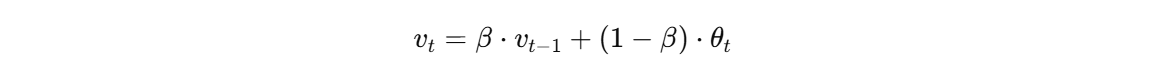
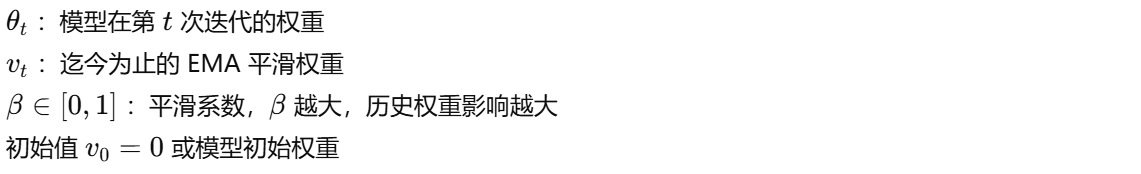
核心特点:最新的权重占比 1−β较大,保证 EMA 对最新模型更新敏感,同时保留历史信息,减少振荡。
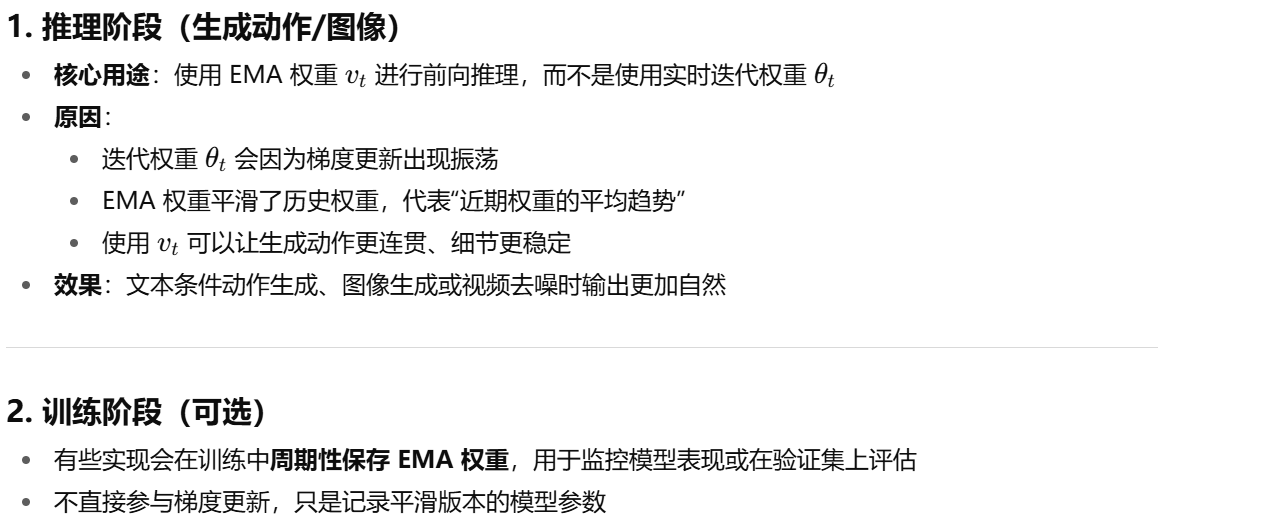
在训练运动去噪网络时,模型参数 θt 会随着每次迭代变化:模型需要同时保持 文本-运动一致性 和 运动质量。训练过程中,参数更新可能出现 振荡或突变,导致生成动作不稳定
使用 EMA:vt对每次更新进行了平滑处理,最新权重仍然占一定比重,但历史权重会缓冲突变,训练过程中,使用 EMA 权重生成动作序列可以更稳定
直观理解:EMA 相当于给模型参数加了“阻尼”,让参数不会因为一次迭代更新过大而导致生成动作抖动或异常。
用途
3.3 无分类器指导(Classifier-Free Guidance, CFG)
1. 背景
在扩散模型或运动去噪生成中,我们希望生成的动作既符合文本描述(text-motion consistency),又保持真实、自然(fidelity)。
传统方法可能会用外部分类器来引导生成(classifier guidance),但这种方法:
-
需要额外训练分类器
-
分类器可能不稳定或引入偏差
Classifier-Free Guidance(CFG) 则通过训练模型同时学习有条件和无条件分布,直接在模型内部实现引导。
2. 核心训练策略
-
对大约 10% 的训练样本,将条件 c 置为空(∅),让模型学习 无条件生成
-
对其他样本,模型学习 有条件生成(例如文本描述 c 对应动作)
-
训练完成后,模型能同时输出:
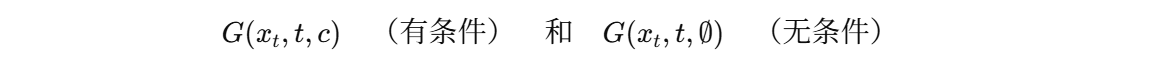
3.推理阶段
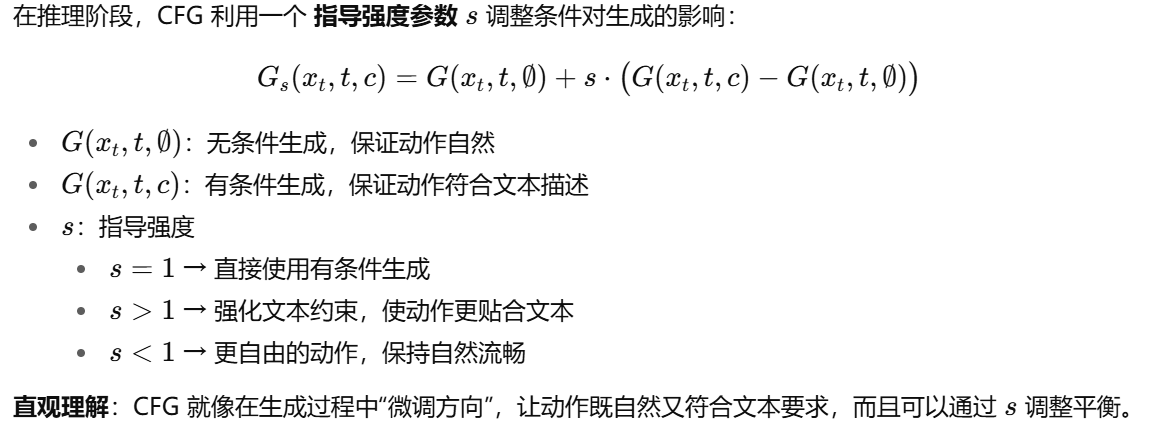
为什么叫无分类器指导呢?参数s是学习的吗?
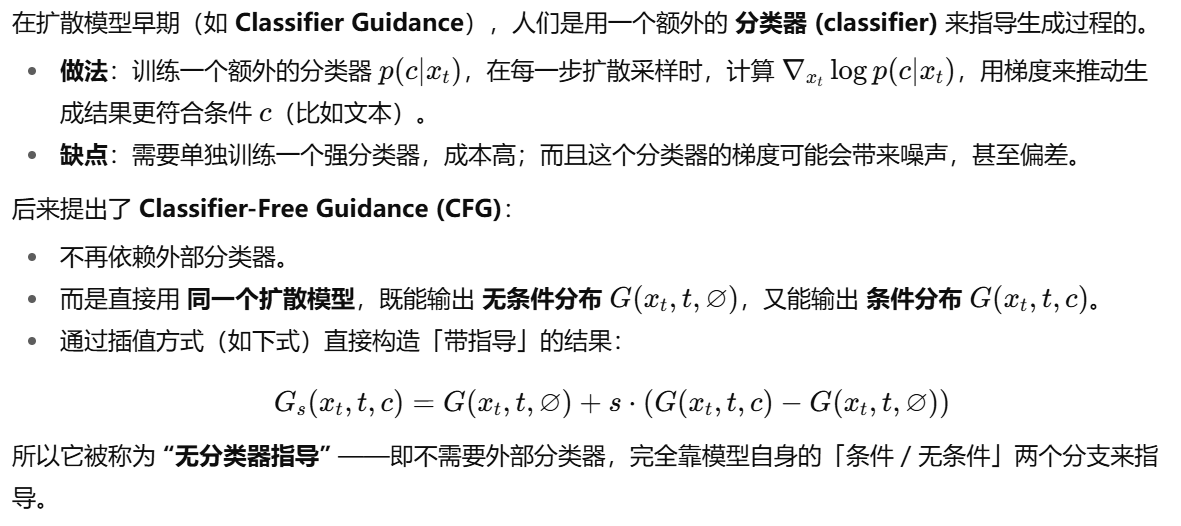
s不是学习到的,而是 人为设置的超参数。
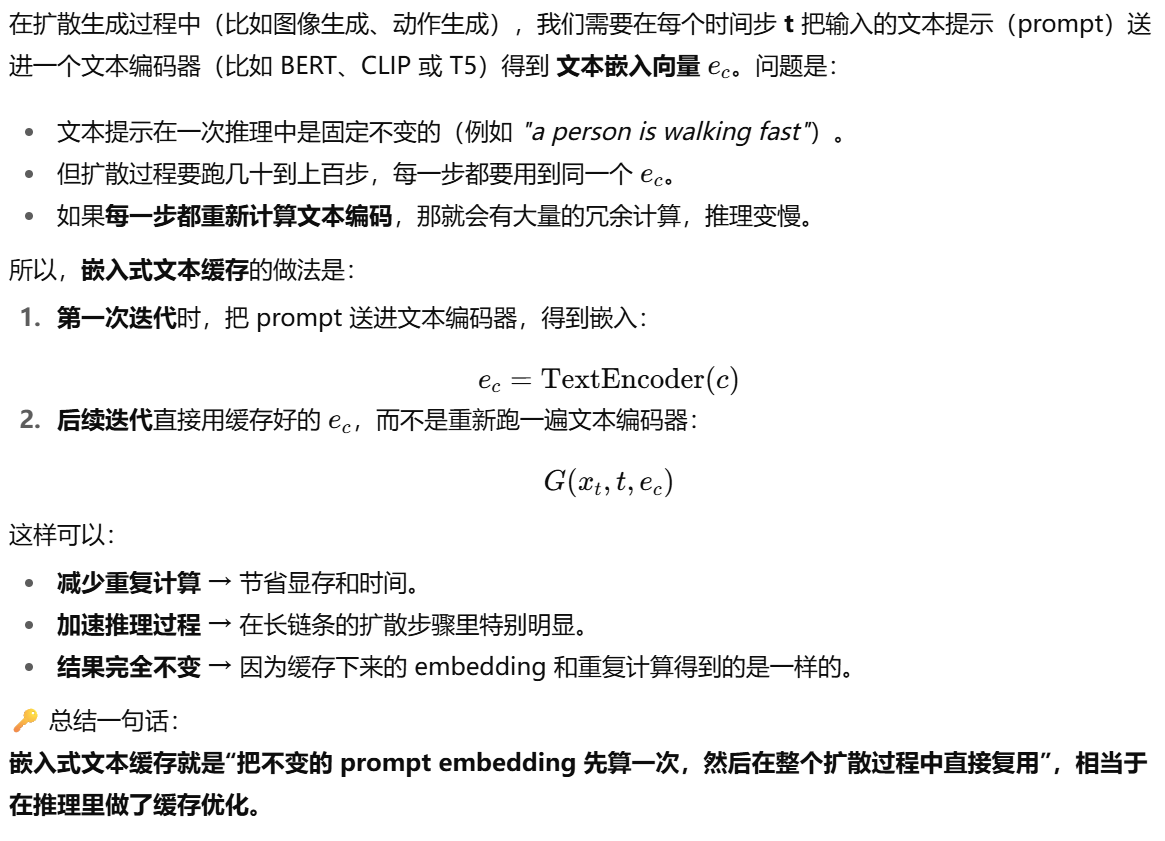
3.4 嵌入式文本缓存
3.5 并行化 CFG计算
在 CFG 推理里,
-
有条件:输入是 (xt,t,c)(x_t, t, c)(xt,t,c),其中 ccc 是文本 embedding;
-
无条件:输入是 (xt,t,∅)(x_t, t, \varnothing)(xt,t,∅),其中条件 embedding 被替换成一个“空 prompt embedding”。
注意:
-
网络结构是完全相同的。
-
唯一的区别就是 条件向量(prompt embedding 不一样而已)。
所以两路输入在数学上只是 数据不同,不是 计算图不同。
当我们把两个输入打包成一个 batch:
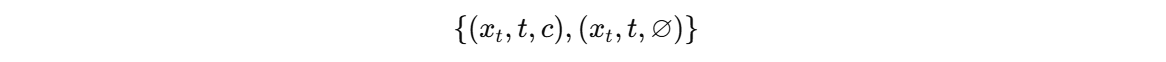
模型会把这两个样本在 batch 维度上同时处理:
-
在卷积/注意力里,运算是对 batch 维度并行的;
-
GPU 的 SIMD(Single Instruction Multiple Data)架构保证了即便输入 embedding 不同,也能一次完成所有矩阵乘法。
有无条件的差异只是数据值不同,不会影响到 GPU 并行化
3.6 FP16低精度推理
FP16 低精度推理(half-precision inference)是指在推理(inference)过程中,把原本需要用 32 位浮点数(FP32) 表示和计算的模型参数、激活值、权重等,改为用 16 位浮点数(FP16) 来表示和运算
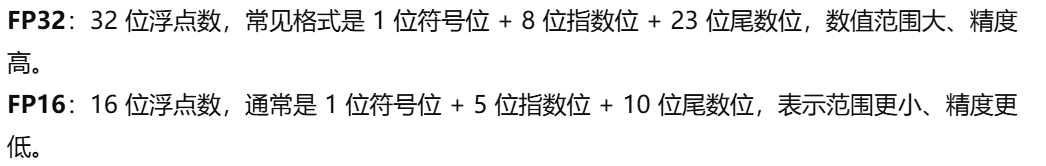
FP16 能更快,但可能有数值精度丢失
第四部分是针对“浮冰脚”(Footskate)伪影的精确修复:这是一个后处理优化步骤。其算法流程是:当模型生成一个动作后,首先利用一个预训练的地面反作用力(vGRF)预测模型来自动检测出脚部发生不自然滑动的关节点和时间段;然后,将这个问题建模为一个优化任务,定义一个损失函数来惩罚这些关节点与其稳定锚点之间的偏差;最后,通过梯度下降直接修正生成动作的坐标数据,直至伪影被消除。这一设计的动机是提供一个可泛化且效果显著的解决方案,以修复这个长期困扰该领域的顽固问题,从而极大提升生成动作的真实感和实用性。
3.7 浮冰脚修复
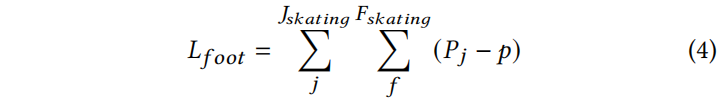
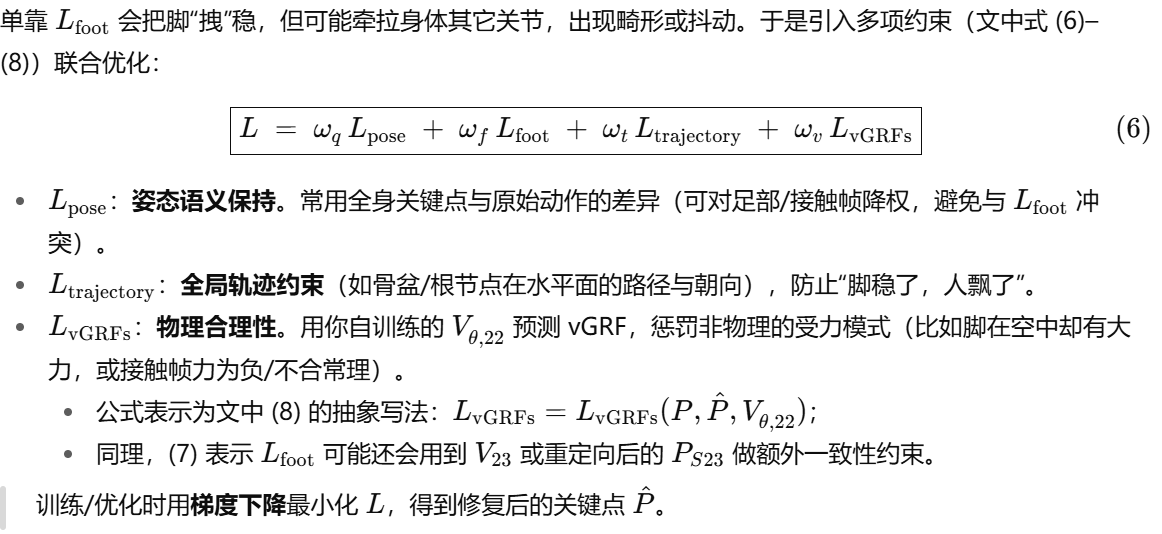
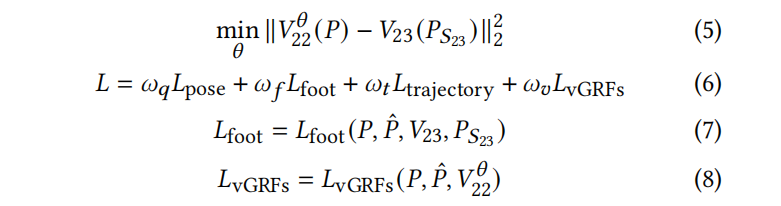
细节
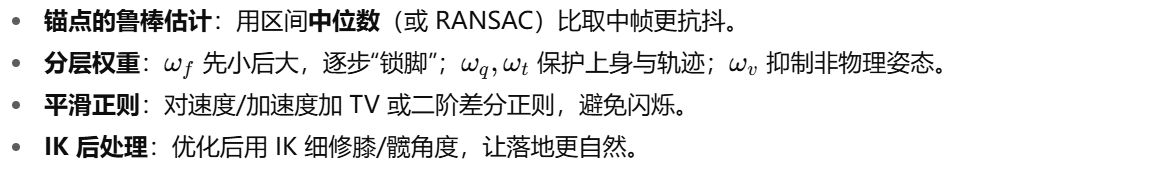
什么是IK后处理?
IK 后处理 = Inverse Kinematics 后处理(逆向运动学后处理)。
在论文(尤其是基于骨架预测、动作生成的工作)里,IK 后处理主要是指:
把预测出来的关节位置(通常是相对粗糙的、可能有物理不一致的骨架点)通过逆向运动学算法重新约束到合理的骨架上,保证动作符合关节旋转约束、接触约束和物理一致性。
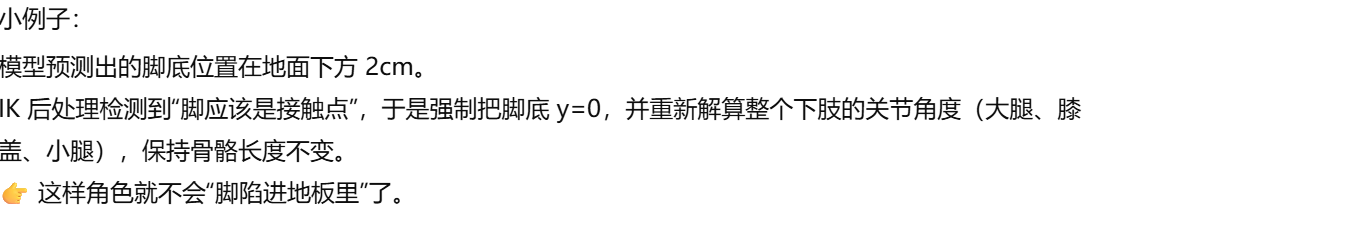
端到端工作流
4 实验
实验主要围绕三大块展开:
第一块是与当前最先进(SOTA)模型的全面性能对比,其目的是证明StableMoFusion在生成质量和文本对齐度上的综合优越性。实验做法是在HumanML3D和KIT-ML两个标准数据集上,将StableMoFusion与MDM、MLD、ReMoDiffuse等一系列顶级模型进行比较,评估指标采用业界公认的FID(衡量生成动作的真实性)和R Precision(衡量动作与文本描述的匹配度)。实验结论非常清晰:StableMoFusion在两项核心指标上均取得了SOTA或接近SOTA的成绩,证明了其生成的动作既真实自然,又与文本指令高度一致,整体性能优于现有方法。
第二块是详尽的消融研究(Ablation Study),其核心目的是逐一验证其方法论中每一项设计决策的必要性和有效性,证明其性能提升并非偶然。实验做法是“控制变量”,例如,在“模型架构”部分,他们展示了基线网络(如Conv1D UNet baseline)的性能,然后逐个加入“交叉注意力”和“GroupNorm调整”,并记录下每次改进带来的性能提升(如Table 4所示);在“高效推理”部分,他们从一个非常慢的基线(DDPM 1000步)开始,依次应用高效采样器、文本缓存等四种加速技巧,并展示了每一步带来的推理时间(AITS)的显著下降(如Table 5所示)。实验结论是:架构上的每一项调整都对最终性能有显著的积极贡献,而推理加速的每一项技巧都大幅压缩了时间成本且不牺牲质量,从而有力地支撑了其方法设计的合理性。
第三块是针对特定问题的有效性验证,即推理效率和浮冰脚修复效果,其目的是直观且定量地展示其如何解决了业界两大痛点。对于效率,实验通过绘制性能-时间图(Figure 1)和直接的AITS数值对比,展示了StableMoFusion在保持高质量的同时,其推理速度远超同类高性能模型。对于浮冰脚问题,实验则通过定性的可视化对比(Figure 5),清晰地展示了“修复前”和“修复后”的效果差异,证明了其后处理方法能够干净利落地消除脚部滑动伪影。实验结论是:StableMoFusion成功地在生成质量和推理速度之间取得了出色的平衡,并且其提出的浮冰脚修复机制切实有效。
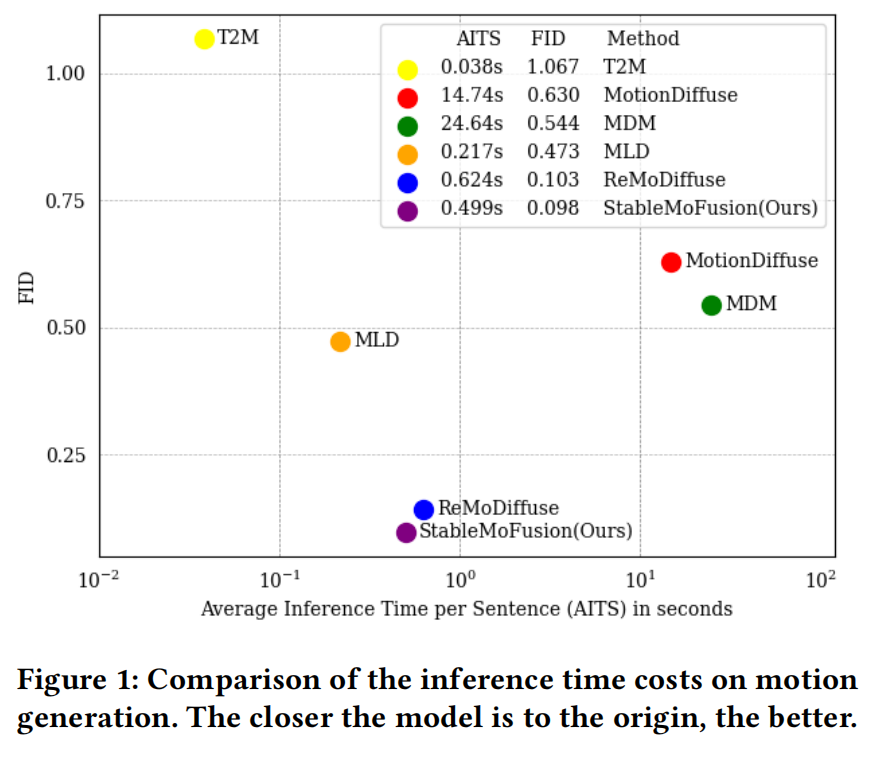
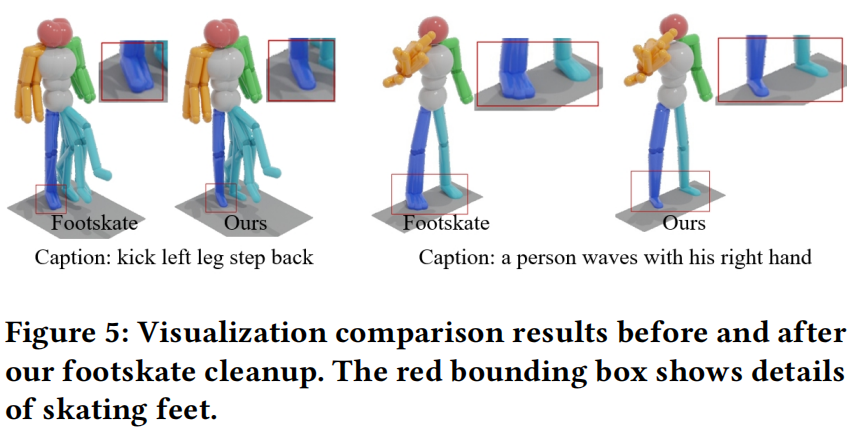
所有实验环环相扣,共同构建了一个强有力的证据链,证明了StableMoFusion是一个在质量、效率和鲁棒性方面都表现卓越的先进框架。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 16
 0
- 0


 已为社区贡献6条内容

所有评论(0)