Python-pix2code:图形用户界面截图到代码的机器学习转换

简介:Python-pix2code是一个利用机器学习技术,将图形用户界面截图自动转换为代码的创新工具。它为开发者节省时间,尤其是面对重复编写相似代码的任务时。本文将介绍pix2code的工作机制、应用方法以及在Python开发中的实际应用,包括机器学习基础、图像处理、深度学习模型的使用、训练与优化过程、以及使用pix2code的具体步骤和潜在的应用领域。同时,也将探讨pix2code面临的挑战和未来发展方向。
1. 机器学习基础和GUI元素识别
1.1 机器学习与深度学习概念
1.1.1 机器学习的基本原理
机器学习是从数据中自动学习并提升性能的科学,它依赖于算法和统计模型来赋予计算机“学习”的能力。在基本原理中,算法通过训练数据集进行学习,识别模式和建立决策规则。然后,这些规则被用来对新的数据进行预测或决策。
1.1.2 深度学习在图像处理中的应用
深度学习是机器学习的一个子集,专注于构建和训练多层神经网络。在图像处理中,深度学习特别受到关注,因为卷积神经网络(CNN)能够自动学习图像的层级特征,从边缘和纹理到更抽象的概念,如形状和对象部分。
1.2 GUI界面设计基础
1.2.1 GUI界面的组成元素
图形用户界面(GUI)由多个组成元素构成,包括窗口、按钮、文本框、图标、菜单等。这些元素通过布局和视觉设计组合在一起,提供用户交互的可视化方式。
1.2.2 常见GUI框架和设计原则
GUI框架如Tkinter、PyQt和WPF等,为开发者提供了创建GUI应用的工具和组件。设计原则包括一致性、反馈、效率和美学,确保用户能轻松理解和使用应用程序。
1.3 GUI元素的机器学习识别
1.3.1 识别技术的演进和应用
随着技术的发展,GUI元素的识别已从传统的模板匹配方法演进为使用深度学习的特征学习方法。这些技术的应用可以自动识别屏幕上的GUI元素,为自动化测试和辅助技术(如屏幕阅读器)提供支持。
1.3.2 深度学习在GUI元素识别中的角色
深度学习方法,尤其是卷积神经网络(CNNs),在GUI元素识别中扮演着核心角色。CNNs可以理解图像的复杂结构,并识别出GUI的不同组成部分,如按钮或菜单项,即使在不同的外观和分辨率下也能保持较高的识别准确性。
2. 图像预处理和特征提取技术
2.1 图像预处理技术
图像预处理是深度学习处理图像数据前的关键步骤,它涉及一系列用于提升数据质量的操作,确保输入到深度学习模型中的图像具有较高的可用性和准确性。
2.1.1 去噪与增强方法
图像噪声是数字图像处理中常见的问题,通常来源于图像的获取、传输或转换过程。它会掩盖图像中的重要细节,并影响深度学习模型的性能。常用的去噪方法包括高斯滤波、双边滤波和小波变换。高斯滤波通过平滑图像减少噪声,但同时也会模糊图像的边缘;双边滤波则保留边缘信息的同时去除噪声;小波变换将图像转换到小波域,在那里噪声可以更轻易地与图像内容分离。
import cv2
import numpy as np

# 读取图像
image = cv2.imread('noisy_image.jpg', 0)

# 高斯去噪
gaussian_blur = cv2.GaussianBlur(image, (5, 5), 0)

# 双边滤波去噪
bilateral_blur = cv2.bilateralFilter(image, 9, 75, 75)

# 显示原始与处理后的图像
cv2.imshow('Original', image)
cv2.imshow('Gaussian Blur', gaussian_blur)
cv2.imshow('Bilateral Filter', bilateral_blur)
cv2.waitKey(0)
cv2.destroyAllWindows()
这段代码展示了如何应用高斯滤波和双边滤波去噪技术处理图像。图像预处理技术的选择取决于特定图像类型和深度学习模型的需求。
2.1.2 图像缩放与归一化
图像缩放用于改变图像的分辨率,而归一化则是将图像的像素值调整到一个标准的范围内,如[0,1]或[-1,1]。这两种预处理方法对于提高深度学习模型的训练效率和收敛速度至关重要。
# 图像缩放
resized_image = cv2.resize(image, (new_width, new_height))

# 归一化
normalized_image = resized_image.astype('float32') / 255.0
上述代码片段中,首先使用OpenCV的resize函数进行图像缩放,然后通过数组除法实现像素值的归一化。
2.2 特征提取的重要性
2.2.1 特征提取的基本原理
特征提取是从原始数据中提取有助于任务性能的特征的过程。在图像识别和GUI元素识别中,特征提取可以降低数据的维度,同时保留对模型最有用的信息。
2.2.2 常见的特征提取方法
SIFT(尺度不变特征变换)、SURF(加速稳健特征)和HOG(方向梯度直方图)是图像处理中常用的特征提取方法。SIFT提取的特征具有尺度不变性,能够检测到图像的关键点和描述符;SURF则在SIFT的基础上进行了优化,提高了特征提取的速度;HOG通过统计图像局部区域梯度的方向信息来描述图像特征。
import cv2
import matplotlib.pyplot as plt

# 读取图像
image = cv2.imread('example_image.jpg')

# 使用SIFT特征提取
sift = cv2.SIFT_create()
keypoints, descriptors = sift.detectAndCompute(image, None)

# 可视化关键点
sift_image = cv2.drawKeypoints(image, keypoints, None)
plt.imshow(cv2.cvtColor(sift_image, cv2.COLOR_BGR2RGB))
plt.show()
在上述代码中,SIFT算法用于检测图像的关键点,并将它们绘制在原始图像上。特征提取使得深度学习模型更专注于处理重要的视觉信息。
2.3 深度学习中的特征学习
2.3.1 卷积神经网络的特征学习过程
卷积神经网络(CNN)是深度学习中处理图像数据的核心结构,它能够自动从输入数据中学习特征。CNN通过一系列卷积层和池化层来提取图像特征,并通过全连接层进行分类或回归分析。
from keras.models import Sequential
from keras.layers import Conv2D, MaxPooling2D, Flatten, Dense

# 定义CNN模型
model = Sequential()
model.add(Conv2D(32, (3, 3), activation='relu', input_shape=(64, 64, 3)))
model.add(MaxPooling2D(pool_size=(2, 2)))
model.add(Flatten())
model.add(Dense(64, activation='relu'))
model.add(Dense(1, activation='sigmoid'))

# 模型编译
model.compile(loss='binary_crossentropy', optimizer='adam', metrics=['accuracy'])
在这段代码中,定义了一个简单的CNN模型,它包含一个卷积层、一个池化层、一个全连接层和输出层。该模型可以用于二分类任务,例如区分不同的GUI元素。
2.3.2 特征学习在GUI元素识别中的应用
深度学习的特征学习过程能够自动识别和学习GUI元素的复杂模式,这在传统的手工特征提取方法中很难实现。通过深度学习模型,可以提高GUI元素识别的准确性,并能更好地泛化到不同的应用场景。
graph LR
A[开始] --> B[收集GUI元素图像数据]
B --> C[图像预处理]
C --> D[深度学习模型训练]
D --> E[GUI元素特征学习]
E --> F[特征向量提取]
F --> G[GUI元素识别与分类]
G --> H[模型优化与迭代]
H --> I[结束]
上述流程图描述了深度学习在GUI元素识别中的应用流程,从数据收集到模型优化和迭代的整个过程。特征学习是流程中的核心环节,直接关系到识别的准确性和效率。
总结
图像预处理和特征提取是深度学习处理图像识别任务前的重要步骤,它们通过提升数据质量来提高模型的性能。传统手工特征提取方法在处理图像时可能需要大量的专业知识和前期处理工作,而深度学习模型则能够自动完成这些任务。在本章节中,我们详细讨论了去噪、缩放、归一化、特征提取等预处理技术,并介绍了SIFT、HOG等传统特征提取方法。此外,我们还分析了卷积神经网络在特征学习中的作用,并探讨了其在GUI元素识别中的应用。通过本章的学习,读者应当对图像预处理和特征提取技术有了深刻的理解,并能够运用这些技术解决实际问题。
3. 深度学习模型和序列到序列模型应用
3.1 深度学习模型概述
3.1.1 神经网络基础结构
神经网络是深度学习的核心组成部分,其基础结构模仿了人脑神经元的工作方式。简单的神经网络由输入层、隐藏层和输出层构成。输入层接收原始数据,隐藏层进行复杂的数据变换和特征提取,输出层提供最终的预测结果。
代码块展示和分析
下面是一个简单的神经网络结构示例,使用Python的TensorFlow框架编写:
import tensorflow as tf

model = tf.keras.models.Sequential([
    # 添加全连接层,激活函数使用relu
    tf.keras.layers.Dense(128, activation='relu', input_shape=(input_size,)),
    # 添加Dropout层,防止过拟合
    tf.keras.layers.Dropout(0.5),
    # 添加第二个全连接层,输出维度为10,对应10类分类问题
    tf.keras.layers.Dense(10, activation='softmax')
])

# 编译模型,设置损失函数、优化器和评估指标
model.compile(
    loss='sparse_categorical_crossentropy',
    optimizer='adam',
    metrics=['accuracy']
)
在这个例子中, Dense 层代表全连接层,输入维度通过 input_shape 指定,这里假设输入数据的维度为 input_size 。第一个全连接层使用 relu 激活函数,第二个全连接层使用 softmax 函数,这是多分类问题常用的输出层激活函数。 Dropout 层用于减少过拟合,通过随机丢弃一定比例的神经元输出来实现。最后,模型使用 sparse_categorical_crossentropy 作为损失函数, adam 作为优化器,评估指标为准确率 accuracy 。
参数说明和扩展性讨论
在实际应用中,网络的复杂性和深度取决于问题的复杂度。深度学习模型通常需要大量的实验和调整来确定最佳的网络结构和参数。例如,模型的层数、每层的神经元数量、激活函数的类型等都可以进行优化。除了上述提到的 relu 和 softmax ,其他常用的激活函数还包括 tanh 、 sigmoid 等。
3.1.2 模型的选择与构建
在构建深度学习模型时,模型的选择至关重要。它需要基于问题的类型和数据的特征来决定。分类问题、回归问题、序列数据处理等不同类型的问题可能会适用不同类型的模型。
模型选择的考量因素
- 问题复杂度 :复杂的问题可能需要更深的网络结构,即更多层的神经网络。
- 数据量 :数据量的大小直接影响模型的设计,大数据量可能需要更复杂的模型以捕捉数据中的细微特征。
- 计算资源 :更复杂的模型需要更强的计算能力,例如更多的GPU资源。
- 时间限制 :训练复杂模型可能需要更长的时间,因此在时间受限的场景下可能需要简化模型。
模型构建的示例
一个典型的构建过程可能包括以下步骤:
- 数据预处理:清洗数据、归一化、划分训练集和测试集。
- 定义模型结构:选择合适的层和神经元数量。
- 编译模型:设置损失函数、优化器和评估指标。
- 训练模型:通过训练集数据训练模型,并在验证集上验证。
- 模型评估:使用测试集数据评估模型性能。
- 参数调优:根据评估结果调整模型参数。
代码块展示和分析
from tensorflow.keras import layers, models

# 假设我们构建一个用于图像识别的卷积神经网络
model = models.Sequential()
model.add(layers.Conv2D(32, (3, 3), activation='relu', input_shape=(28, 28, 1)))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation='relu'))
model.add(layers.MaxPooling2D((2, 2)))
model.add(layers.Conv2D(64, (3, 3), activation='relu'))

# 展平层将三维输出展开为一维
model.add(layers.Flatten())
# 添加一个全连接层
model.add(layers.Dense(64, activation='relu'))
# 最后是输出层,10个类别对应10个神经元
model.add(layers.Dense(10, activation='softmax'))

model.compile(optimizer='adam',
              loss='sparse_categorical_crossentropy',
              metrics=['accuracy'])
在该代码段中,我们使用了 Sequential 模型来堆叠不同的层。卷积层 Conv2D 用于提取图像特征, MaxPooling2D 用于降低特征维度,减少计算量。 Flatten 层将特征图从二维转换为一维,以便后续的全连接层可以处理。最后的 Dense 层输出最终的分类结果。
参数说明和扩展性讨论
该模型是针对图像识别问题构建的,使用了卷积层和池化层来处理图像数据。在实际的深度学习项目中,网络结构的构建和参数的选择通常依赖于多次尝试和调整,例如调整卷积核的数量和大小,或者池化层的步长和大小。
3.2 序列到序列模型(Seq2Seq)
3.2.1 Seq2Seq模型的工作原理
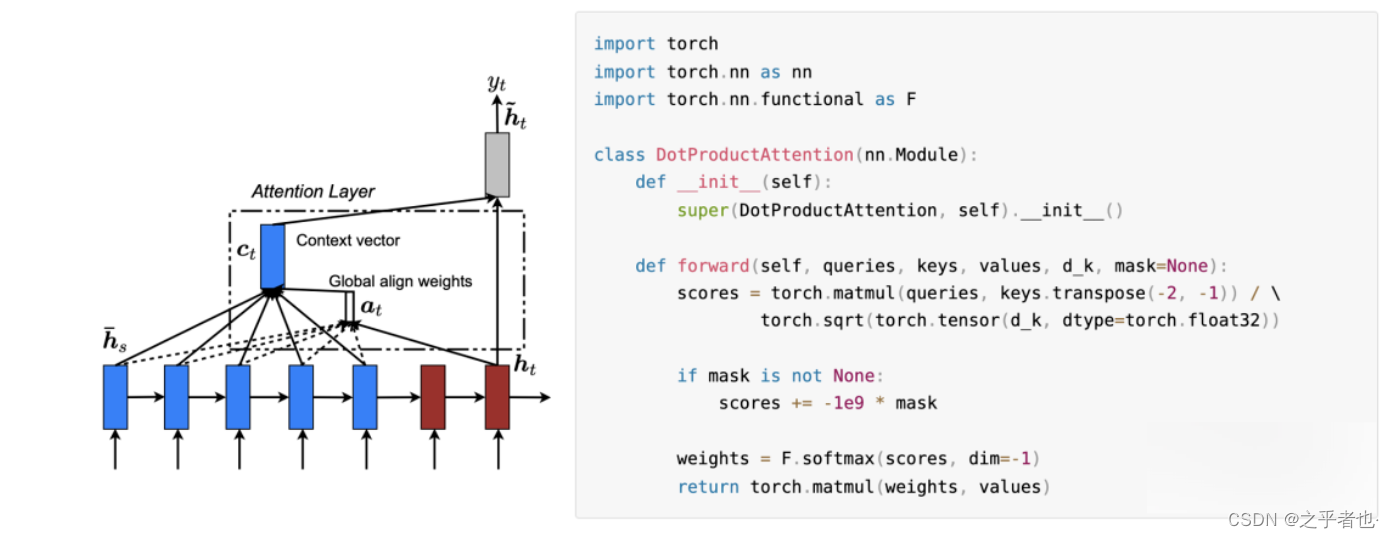
序列到序列(Seq2Seq)模型是一种特殊类型的神经网络结构,广泛应用于自然语言处理(NLP)领域,如机器翻译、文本摘要和问答系统。Seq2Seq 模型由两个核心部分组成:编码器(Encoder)和解码器(Decoder)。编码器负责处理输入序列,然后将编码后的信息传递给解码器。解码器基于接收到的信息生成输出序列。
模型的工作流程
- 输入序列编码 :编码器读取输入序列(例如,一个句子),并将其编码为一个固定大小的向量表示。
- 上下文向量传递 :编码器输出的向量,也就是上下文向量,将作为解码器的初始状态输入。
- 生成输出序列 :解码器根据上下文向量开始生成输出序列,每生成一个元素,它会接收上一步的输出作为输入,直到生成一个结束标记或者达到最大长度。
代码块展示和分析
from tensorflow.keras.layers import Input, LSTM, Dense
from tensorflow.keras.models import Model

# 设定超参数
max_encoder_seq_length = 200
max_decoder_seq_length = 200
latent_dim = 256

# 编码器输入
encoder_inputs = Input(shape=(None, num_encoder_tokens))
# 编码器模型
encoder = LSTM(latent_dim, return_state=True)
encoder_outputs, state_h, state_c = encoder(encoder_inputs)
# 我们只保存状态
encoder_states = [state_h, state_c]

# 解码器输入
decoder_inputs = Input(shape=(None, num_decoder_tokens))
# 解码器模型,使用编码器的状态作为初始状态
decoder_lstm = LSTM(latent_dim, return_sequences=True, return_state=True)
decoder_outputs, _, _ = decoder_lstm(decoder_inputs, initial_state=encoder_states)

# 解码器使用全连接层来输出实际的序列
decoder_dense = Dense(num_decoder_tokens, activation='softmax')
decoder_outputs = decoder_dense(decoder_outputs)

# 定义 Seq2Seq 模型
model = Model([encoder_inputs, decoder_inputs], decoder_outputs)

model.compile(optimizer='rmsprop', loss='categorical_crossentropy', metrics=['accuracy'])
在这个例子中,我们使用了两个LSTM层来构建编码器和解码器。每个LSTM层都会输出三个值:输出序列、隐藏状态和细胞状态。编码器的隐藏状态和细胞状态被保存下来,作为解码器的初始状态。解码器的输出通过一个全连接层(Dense)来生成最终的预测序列。
参数说明和扩展性讨论
Seq2Seq模型的设计和参数选择对于模型的性能至关重要。例如,LSTM的单元数量(在本例中为 latent_dim )会影响到模型的记忆能力和计算复杂度。超参数 max_encoder_seq_length 和 max_decoder_seq_length 定义了序列的最大长度。实际应用中,这些超参数需要根据具体任务进行调整。
3.2.2 应用于GUI元素编码的实例
将Seq2Seq模型应用于GUI元素编码是一种创新的方法,它可以将GUI的视觉元素转换为结构化的代码表示。这个过程通常包括以下步骤:
- 提取GUI元素特征 :首先需要从GUI截图中提取出可视化元素的特征(例如颜色、形状、位置等)。
- 编码元素序列 :将提取的特征序列化,形成编码器的输入。
- 构建Seq2Seq模型 :使用编码后的GUI元素特征训练Seq2Seq模型。
- 生成代码表示 :解码器输出GUI的结构化代码,如HTML或者CSS。
应用示例的代码块和分析
假设我们已经提取了GUI元素的特征序列,接下来使用以下代码创建Seq2Seq模型并训练:
# 假设已经生成了训练数据
encoder_input_data, decoder_input_data, decoder_target_data = ... # 由特征提取脚本生成

# 构建并训练Seq2Seq模型
model.fit([encoder_input_data, decoder_input_data], decoder_target_data,
          batch_size=64,
          epochs=100,
          validation_split=0.2)
在训练过程中,模型学习如何将GUI元素的特征编码转换为对应的代码表示。最终,解码器能够输出相应的结构化代码来重建GUI元素。
参数说明和优化
在实际应用中,代码的生成过程可能需要优化以提高准确性和效率。这可能包括调整LSTM层的数量和大小,优化训练数据的预处理步骤,或者采用注意力机制(Attention Mechanism)来提高模型对长序列的处理能力。
3.3 模型训练与优化
3.3.1 模型训练的基本流程
训练深度学习模型是一个迭代的过程,包括初始化模型、使用训练数据进行前向和反向传播,然后根据损失函数来更新模型参数。
训练流程的详细步骤
- 初始化模型 :构建模型结构并指定损失函数和优化器。
- 前向传播 :使用训练数据通过模型,计算预测结果和实际结果的差异(损失)。
- 反向传播 :根据损失计算梯度,然后使用优化器更新模型参数。
- 迭代过程 :重复上述步骤,直到损失收敛或达到预定的迭代次数。
代码块展示和分析
# 假设已经定义了模型和编译模型
# 使用fit方法训练模型
history = model.fit(x_train, y_train, batch_size=32, epochs=10, validation_data=(x_val, y_val))
在这个简单的例子中, fit 方法负责执行训练循环, batch_size 指定了每个批次的数据数量, epochs 指定了训练的轮数, validation_data 提供了验证数据集。
参数说明和扩展性讨论
在训练过程中,有很多超参数可以调整,例如学习率(learning rate)、批次大小(batch size)、梯度裁剪(gradient clipping)等。这些参数都会影响模型的训练速度和最终性能。
3.3.2 优化算法的选择和效果评估
优化算法是训练深度学习模型的核心部分,负责调整模型的权重以最小化损失函数。选择合适的优化算法对模型的性能有重大影响。
常见优化算法的对比
- SGD (Stochastic Gradient Descent) :是最基本的优化算法,但其收敛速度通常较慢,并且容易陷入局部最小值。
- Adam :是一种自适应学习率的优化算法,它结合了RMSProp和Momentum的优点,通常在多种任务中表现良好。
- RMSProp :调整学习率的梯度下降算法,对非平稳目标函数效果较好。
- Adagrad :为每个参数维护一个学习率,对于稀疏数据效果好。
优化算法的效果评估
评估优化算法效果时,可以关注以下几点:
- 损失值的下降速度 :优化算法应该能够快速降低训练损失。
- 模型泛化能力 :优化算法应该让模型在未见数据上也有好的表现。
- 收敛性 :优化算法应该能够稳定收敛到一个合理的损失值。
代码块展示和分析
# 使用不同的优化算法进行模型训练
optimizers = ['SGD', 'RMSProp', 'Adagrad', 'Adam']
for opt in optimizers:
    model.compile(optimizer=opt, loss='categorical_crossentropy', metrics=['accuracy'])
    model.fit(x_train, y_train, batch_size=32, epochs=10, validation_data=(x_val, y_val))
    score = model.evaluate(x_test, y_test, batch_size=32)
    print(f"{opt} - Test loss: {score[0]}, Test accuracy: {score[1]}")
在这个示例中,我们尝试了四种不同的优化器,并在测试集上评估了它们的性能。
参数说明和扩展性讨论
不同的优化算法有其各自的优缺点,选择时应该根据具体任务和数据集的特性来决定。在实际应用中,优化算法的参数(例如学习率)也可以根据需要进行调整,以获得最佳效果。
以上是针对第三章内容的具体章节和子章节内容,展示了深度学习模型的构建、Seq2Seq模型在GUI元素编码的应用,以及模型训练和优化的过程。
4. 训练过程、损失函数、优化算法
4.1 训练过程详解
4.1.1 数据集准备与划分
数据是机器学习模型的“粮食”,在训练模型之前,首先需要准备好数据集。对于GUI元素识别任务,数据集通常包含了大量带有标签的图像。这些图像需要经过精心选择,以覆盖可能遇到的所有GUI元素类型,并且要保证一定的数量和多样性,以便模型能够学习到足够的信息来识别新图像中的元素。
划分数据集是一个重要的步骤,它涉及将数据分割成训练集、验证集和测试集。训练集用于模型的学习过程,验证集用于模型训练过程中的调参,而测试集则用于最终评估模型的泛化能力。典型的划分比例为训练集占70%,验证集和测试集各占15%。
4.1.2 训练循环和迭代过程
训练循环是机器学习模型训练的核心部分,涉及到权重更新和误差传播的步骤。在深度学习中,一个典型的训练循环包括以下几个步骤:
- 前向传播 :输入数据通过模型进行计算,产生预测结果。
- 计算损失 :使用损失函数计算预测结果与实际标签之间的差异。
- 反向传播 :通过链式法则计算损失函数关于模型参数的梯度。
- 参数更新 :根据反向传播计算出的梯度更新模型的参数。
在实践中,训练循环会通过多个迭代过程(即多个epoch)执行,直到模型的性能不再显著提升或达到预定的停止条件。
4.2 损失函数的作用与选择
4.2.1 损失函数的分类和原理
损失函数衡量的是模型预测值与真实值之间的差异。选择合适的损失函数对于模型的训练至关重要,不同的任务和问题往往需要不同的损失函数。
常见的损失函数包括:
- 均方误差(MSE) :用于回归任务,衡量预测值与真实值差的平方的平均值。
- 交叉熵损失 :用于分类任务,衡量预测分布与真实分布之间的差异。
对于图像识别任务,通常使用交叉熵损失,因为它是比较类别概率分布的常用方法。但在某些特定的情况下,例如对象检测或分割任务中,可能会使用如IoU(交并比)或其他更适合的损失函数。
4.2.2 针对GUI元素识别的损失函数设计
对于GUI元素识别任务,我们通常会设计一个多标签分类问题。在这种情况下,每一个GUI元素被看作一个二分类问题,即元素是否出现在了图像中的某个位置。
一个适用的损失函数可能是 二元交叉熵损失 ,其中每个标签都是独立地计算交叉熵损失。在实际应用中,为了避免类别不平衡的问题,还可能需要引入权重来调整不同类别对损失函数的贡献。
4.3 优化算法的探索
4.3.1 常用的优化算法分析
优化算法在机器学习中用于最小化损失函数,从而找到模型参数的最优解。以下是一些常用的优化算法:
- 随机梯度下降(SGD) :最基本也是最简单的优化算法,通过迭代来更新模型参数,每次更新只考虑一个样本或一个batch的数据。
- 动量(Momentum) :通过考虑之前梯度的方向来加速SGD的收敛,并减少震荡。
- 自适应矩估计(Adam) :一种基于梯度的一阶矩估计和二阶矩估计的优化算法,适用于非平稳目标函数,被广泛应用。
每种优化算法都有其特点和适用的场景,选择合适的优化算法可以大大加速模型的训练过程并提高模型性能。
4.3.2 算法对模型性能的影响
不同的优化算法会对模型的性能产生不同的影响。例如,动量优化算法可以加快模型的收敛速度,并有助于避免陷入局部最小值。而Adam优化算法通常被认为是一种“万金油”选择,它在很多情况下都能获得不错的结果,特别适合处理具有稀疏梯度的数据集。
在实际应用中,除了选择优化算法外,还需要调整学习率和其他超参数。这通常通过交叉验证或网格搜索的方式来完成,以找到最优的超参数配置。
在本章节中,我们深入探讨了训练过程中的关键环节:数据集的准备与划分、训练循环与迭代、损失函数的选择以及优化算法的应用。通过以上详细的分析与解释,读者应该能够对如何构建和优化深度学习模型有一个全面的理解。在下一章中,我们将探讨如何应用pix2code工具来实现代码的自动化生成,这是深度学习在软件开发领域的有趣应用。
5. 使用pix2code的实践应用
在深度学习和自动化测试领域中,将设计元素转换成可执行代码的需求越来越强烈。pix2code作为一个能够实现从图像到代码转换的工具,在这个章节中,我们将详细介绍如何安装、配置pix2code,并探讨如何使用该工具将GUI元素的截图转换为代码,以及其在GUI自动化中的应用。
5.1 pix2code安装与配置
pix2code的安装和配置是将GUI元素可视化到代码转换的第一步。通过一系列的步骤,我们可以将pix2code集成到开发环境中。
5.1.1 环境搭建和依赖安装
pix2code通常依赖于Python环境,并使用TensorFlow或PyTorch作为后端框架。下面是一个简化的安装流程:
- 安装Python环境(推荐使用Python 3.6或更高版本)。
- 使用Python的包管理工具pip安装pix2code的依赖项:
bash pip install tensorflow pip install keras - 下载pix2code的代码库。
- 运行安装脚本,完成所有依赖的安装:
bash cd pix2code ./install.sh - (可选)配置环境变量,确保pix2code可以全局调用。
5.1.2 pix2code工具的配置流程
pix2code的配置包括初始化配置文件以及对训练参数的设定。配置流程如下:
- 创建一个配置文件
config.json,该文件中指定了模型的路径、训练数据的位置、以及模型参数。 - 使用以下命令启动pix2code的配置向导:
bash python pix2code.py --configure - 根据向导提示,选择或创建合适的模型结构、设置训练参数(如学习率、批次大小等)。
完成以上步骤后,pix2code就配置完成了,接下来就可以开始从GUI元素截图到代码的转换过程。
5.2 代码转换和GUI自动化
pix2code的核心功能是将GUI元素的截图转换成代码。这一过程涉及到图像处理、特征提取和模型预测等步骤。
5.2.1 从截图到代码的转换步骤
使用pix2code进行从图像到代码的转换涉及以下步骤:
- 收集或创建GUI元素截图。
- 使用pix2code预处理截图,提取特征。
- 输入特征到训练好的模型中,进行预测。
- 解码模型输出的中间表示,生成代码。
具体操作示例:
from pix2code import Pix2codeConverter

# 初始化转换器
converter = Pix2codeConverter()

# 加载训练好的模型
converter.load_model('trained_model.h5')

# 使用模型进行代码转换
generated_code = converter.convert_image_to_code('screenshot.png')

print(generated_code)
5.2.2 pix2code在GUI自动化中的应用
pix2code不仅是一个简单的转换工具,它在GUI自动化测试和开发中也具有实际应用价值:
- 自动化测试 : 通过自动生成界面代码,pix2code可用于自动化测试框架,快速创建测试用例。
- 界面重构 : 当设计改变时,pix2code能够迅速生成新界面的代码,加速开发流程。
5.3 工具集成与用户反馈
pix2code的集成和用户反馈是提升工具性能和易用性的关键。
5.3.1 与现有开发工具的集成方案
为了充分利用pix2code的转换能力,我们可以考虑以下集成方案:
- IDE插件 : 开发一个集成到集成开发环境(IDE)中的插件,使得开发者可以直接从IDE中调用pix2code。
- CI/CD流程 : 在持续集成/持续部署(CI/CD)流程中加入pix2code,实现代码的自动更新和部署。
5.3.2 用户反馈与模型改进的循环
pix2code的改进离不开用户反馈。以下是一个简单的反馈循环:
- 用户反馈收集 : 提供用户反馈的入口,并收集用户在使用过程中的问题和改进建议。
- 模型迭代更新 : 根据用户反馈对模型进行优化和更新,逐步提升模型的准确性和适用范围。
通过用户反馈与模型改进的循环,pix2code能够不断提升其功能和性能,更好地服务于开发人员和自动化测试人员。
简介:Python-pix2code是一个利用机器学习技术,将图形用户界面截图自动转换为代码的创新工具。它为开发者节省时间,尤其是面对重复编写相似代码的任务时。本文将介绍pix2code的工作机制、应用方法以及在Python开发中的实际应用,包括机器学习基础、图像处理、深度学习模型的使用、训练与优化过程、以及使用pix2code的具体步骤和潜在的应用领域。同时,也将探讨pix2code面临的挑战和未来发展方向。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 21
 0
- 0


 已为社区贡献25条内容

所有评论(0)