【PP-StructureV3】名列前茅的开源PDF解析算法?实测看看
PP-StructureV3 在V1的基础上,强化了版面区域检测、表格识别、公式识别的能力,增加了图表理解和多栏阅读顺序的恢复能力、结果转换 Markdown 文件的能力,在多种文档数据中,表现优异,可以处理较复杂的文档数据。
PP-StructureV3的整体pipeline如下,
涉及的模型较多,有
- 文档图像方向分类模块
- 文本图像矫正模块
- 版面区域检测模块
- 表格结构识别模块
- 文本检测模块
- 文本识别模块
- 文本行方向分类模块
- 公式识别模块
- 印章文本检测模块
- 图表解析模块
项目链接:
https://paddlepaddle.github.io/PaddleOCR/v3.0.1/version3.x/pipeline_usage/PP-StructureV3.html
代码链接:https://github.com/PaddlePaddle/PaddleOCR
PDF解析效果评测
在OmniDocBench评测集上,PP-StructureV3在各个指标下,实现了基于pipeline算法中最好的效果,同时,不难看出,在开源模型中,也是效果最佳。
| Method Type | Methods | OverallEdit↓ | TextEdit↓ | FormulaEdit↓ | TableEdit↓ | Read OrderEdit↓ | |||||
|---|---|---|---|---|---|---|---|---|---|---|---|
| EN | ZH | EN | ZH | EN | ZH | EN | ZH | EN | ZH | ||
| Pipeline Tools | PP-structureV3 | 0.147 | 0.212 | 0.059 | 0.09 | 0.295 | 0.535 | 0.159 | 0.109 | 0.075 | 0.114 |
| MinerU-0.9.3 | 0.15 | 0.357 | 0.061 | 0.215 | 0.278 | 0.577 | 0.18 | 0.344 | 0.079 | 0.292 | |
| MinerU-1.3.11 | 0.166 | 0.310 | 0.0826 | 0.2000 | 0.3368 | 0.6236 | 0.1613 | 0.1833 | 0.0834 | 0.2316 | |
| Marker-1.2.3 | 0.336 | 0.556 | 0.08 | 0.315 | 0.53 | 0.883 | 0.619 | 0.685 | 0.114 | 0.34 | |
| Mathpix | 0.191 | 0.365 | 0.105 | 0.384 | 0.306 | 0.454 | 0.243 | 0.32 | 0.108 | 0.304 | |
| Docling-2.14.0 | 0.589 | 0.909 | 0.416 | 0.987 | 0.999 | 1 | 0.627 | 0.81 | 0.313 | 0.837 | |
| Pix2Text-1.1.2.3 | 0.32 | 0.528 | 0.138 | 0.356 | 0.276 | 0.611 | 0.584 | 0.645 | 0.281 | 0.499 | |
| Unstructured-0.17.2 | 0.586 | 0.716 | 0.198 | 0.481 | 0.999 | 1 | 1 | 0.998 | 0.145 | 0.387 | |
| OpenParse-0.7.0 | 0.646 | 0.814 | 0.681 | 0.974 | 0.996 | 1 | 0.284 | 0.639 | 0.595 | 0.641 | |
| Expert VLMs | GOT-OCR | 0.287 | 0.411 | 0.189 | 0.315 | 0.36 | 0.528 | 0.459 | 0.52 | 0.141 | 0.28 |
| Nougat | 0.452 | 0.973 | 0.365 | 0.998 | 0.488 | 0.941 | 0.572 | 1 | 0.382 | 0.954 | |
| Mistral OCR | 0.268 | 0.439 | 0.072 | 0.325 | 0.318 | 0.495 | 0.6 | 0.65 | 0.083 | 0.284 | |
| OLMOCR-sglang | 0.326 | 0.469 | 0.097 | 0.293 | 0.455 | 0.655 | 0.608 | 0.652 | 0.145 | 0.277 | |
| SmolDocling-256M_transformer | 0.493 | 0.816 | 0.262 | 0.838 | 0.753 | 0.997 | 0.729 | 0.907 | 0.227 | 0.522 | |
| General VLMs | Gemini2.0-flash | 0.191 | 0.264 | 0.091 | 0.139 | 0.389 | 0.584 | 0.193 | 0.206 | 0.092 | 0.128 |
| Gemini2.5-Pro | 0.148 | 0.212 | 0.055 | 0.168 | 0.356 | 0.439 | 0.13 | 0.119 | 0.049 | 0.121 | |
| GPT4o | 0.233 | 0.399 | 0.144 | 0.409 | 0.425 | 0.606 | 0.234 | 0.329 | 0.128 | 0.251 | |
| Qwen2-VL-72B | 0.252 | 0.327 | 0.096 | 0.218 | 0.404 | 0.487 | 0.387 | 0.408 | 0.119 | 0.193 | |
| Qwen2.5-VL-72B | 0.214 | 0.261 | 0.092 | 0.18 | 0.315 | 0.434 | 0.341 | 0.262 | 0.106 | 0.168 | |
| InternVL2-76B | 0.44 | 0.443 | 0.353 | 0.29 | 0.543 | 0.701 | 0.547 | 0.555 | 0.317 | 0.228 | |
安装使用
第一步,安装PaddlePaddle
详见开始使用_飞桨-源于产业实践的开源深度学习平台
笔者是linux环境,CUDA版本是12.6,执行以下命令安装
python -m pip install paddlepaddle-gpu==3.0.0 -i https://www.paddlepaddle.org.cn/packages/stable/cu126/
PaddlePaddle安装的坑比较多,尽量保证环境和安装网页提及的一致,不然,有的受了
第二步,安装PaddleOCR
python -m pip install paddleocr
第三步,体验PP-StructureV3效果
paddleocr pp_structurev3 -i https://paddle-model-ecology.bj.bcebos.com/paddlex/imgs/demo_image/pp_structure_v3_demo.png
会有运行结果输出
第四步,批量处理PDF文件
from pathlib import Path
from paddleocr import PPStructureV3

input_file = "./your_pdf_file.pdf"
output_path = Path("./output")

pipeline = PPStructureV3()
output = pipeline.predict(input=input_file)

markdown_list = []
markdown_images = []

for res in output:
    md_info = res.markdown
    markdown_list.append(md_info)
    markdown_images.append(md_info.get("markdown_images", {}))

markdown_texts = pipeline.concatenate_markdown_pages(markdown_list)

mkd_file_path = output_path / f"{Path(input_file).stem}.md"
mkd_file_path.parent.mkdir(parents=True, exist_ok=True)

with open(mkd_file_path, "w", encoding="utf-8") as f:
    f.write(markdown_texts)

for item in markdown_images:
    if item:
        for path, image in item.items():
            file_path = output_path / path
            file_path.parent.mkdir(parents=True, exist_ok=True)
            image.save(file_path)
效果评测
| 输入PDF 类型 | 输入PDF 图示 | PP-StructureV3 解析结果 | Doc2X 解析结果 |
|---|---|---|---|
| 多栏 |  | 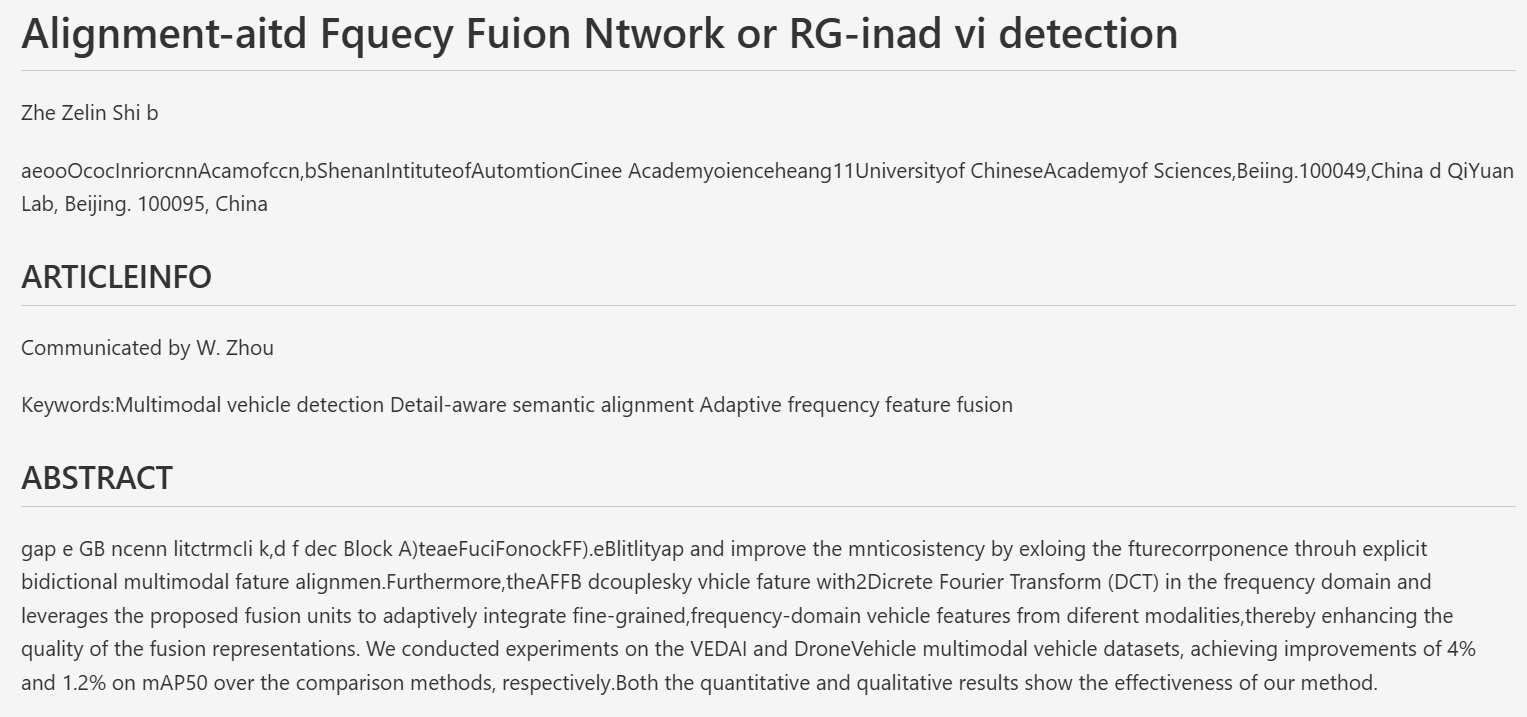 | 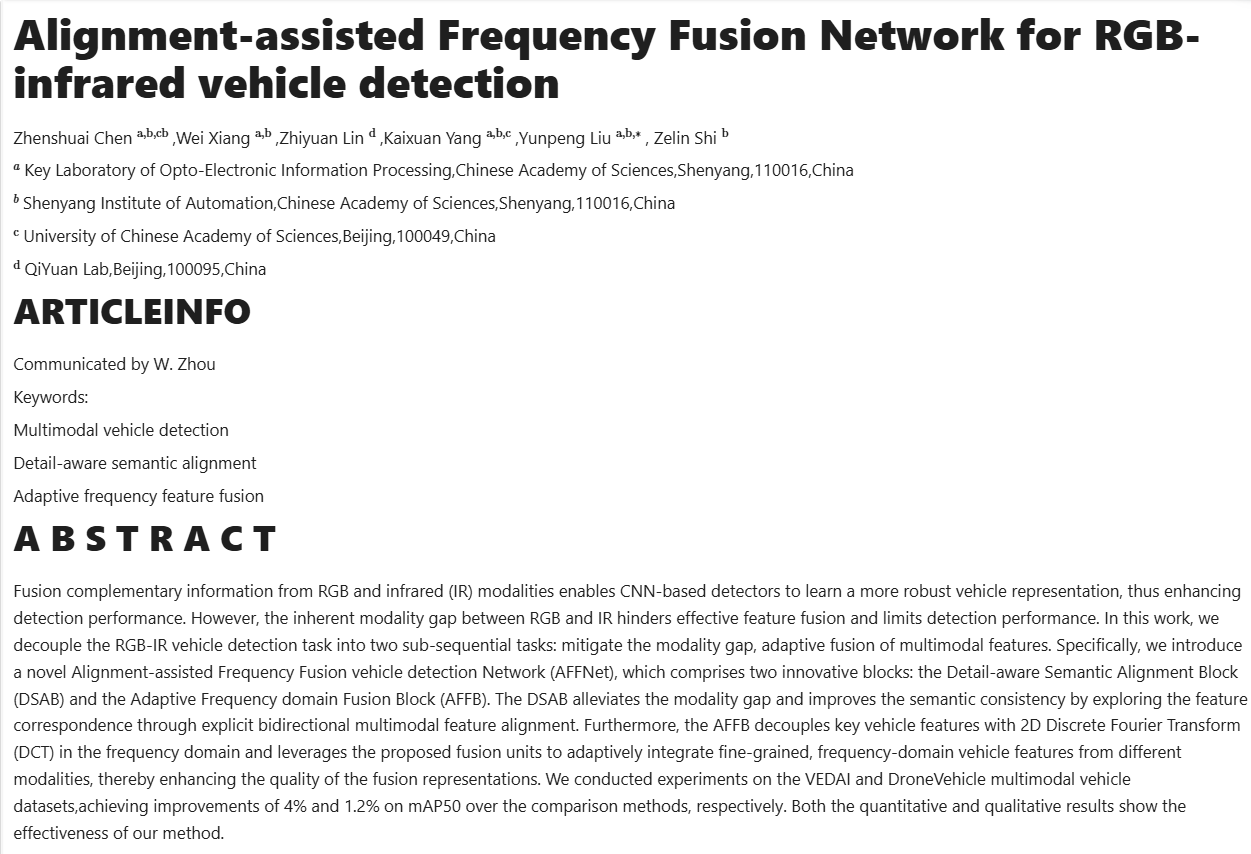 |
| 公式 | 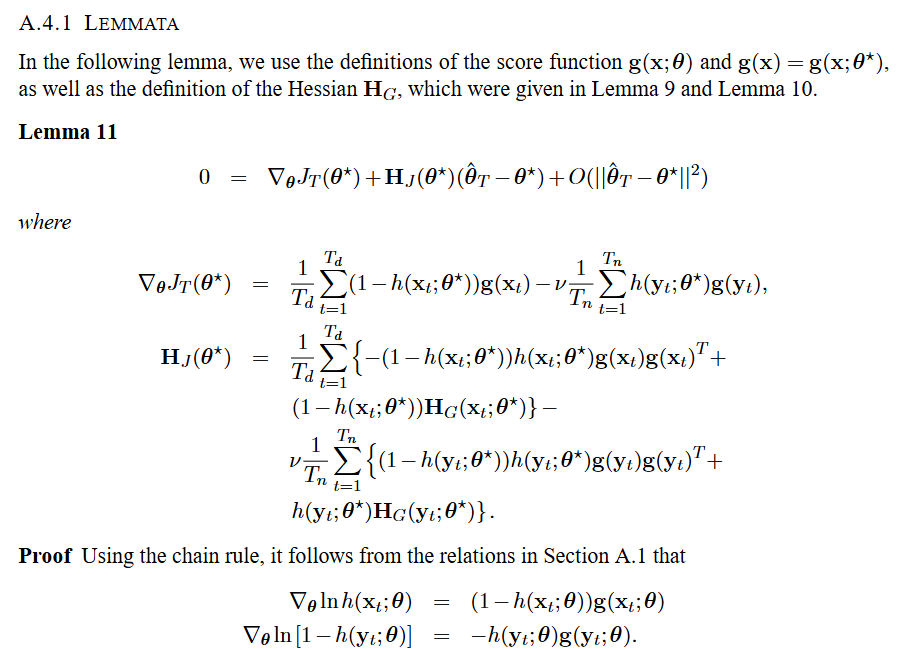 |  | 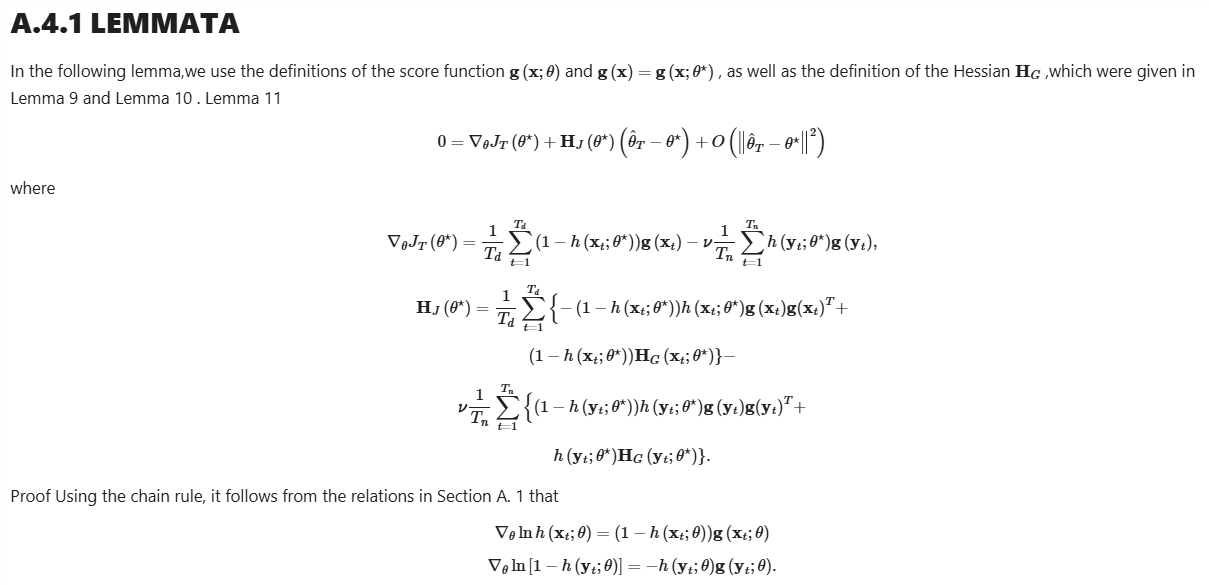 |
| 表格 |  | 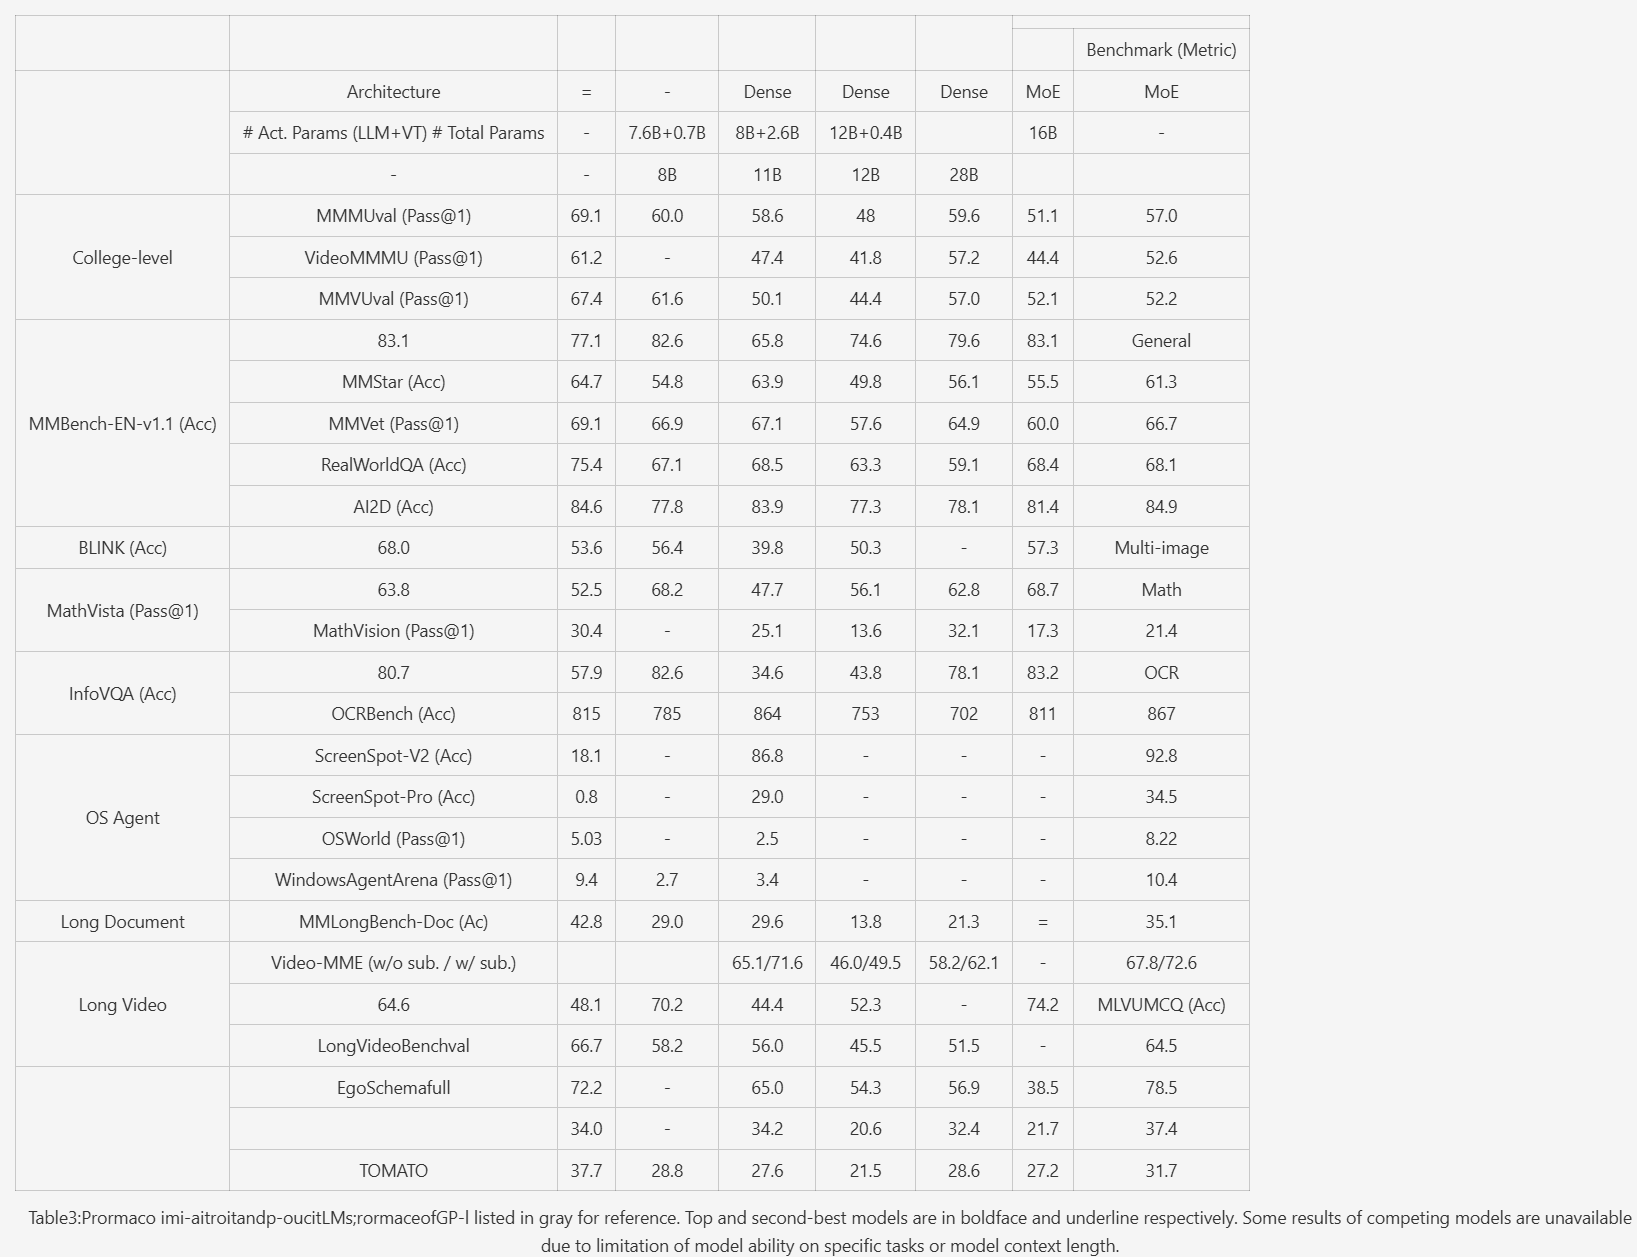 |  |
| 代码 |  |  | 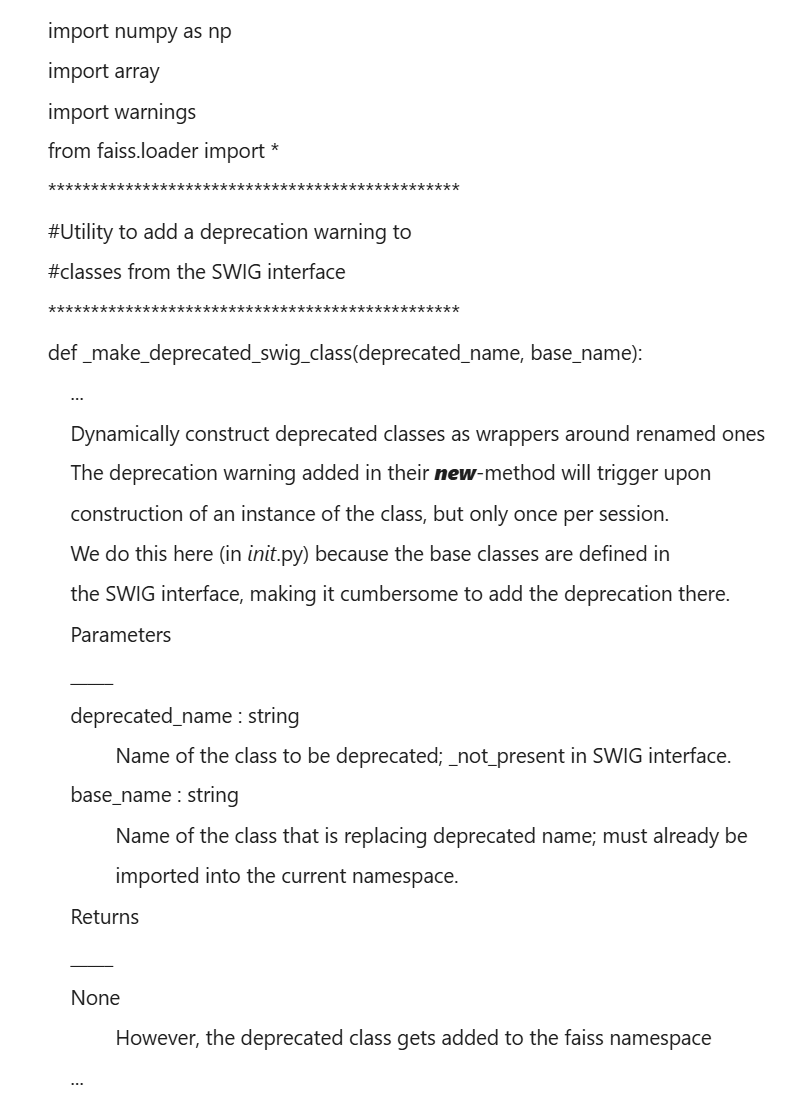 |
对多栏类数据,PP-StructureV3能够解析出版面结构,但OCR能力一般,论文标题、作者识别错误;
对公式类数据,PP-StructureV3和Doc2X解析结果相差不大;
对表格类数据,PP-StructureV3较难处理单元格内有换行的数据,容易识别错误;
对代码类数据,PP-StructureV3基本不能用。
综上,即使最强的PDF开源解析模型——PP-StructureV3,也无法和闭源的Doc2X比较。Doc2X具备很强的技术护城河,想实现PDF解析,无脑接入Doc2X就行了。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 36
 0
- 0


 已为社区贡献15条内容

所有评论(0)