一文搞懂数据集成平台与数据湖:核心概念解析与协同架构
·
一文搞懂数据集成平台与数据湖:核心概念解析与协同架构
零、核心概念全景图(5分钟快速掌握)
比喻理解:
把企业数据体系比作「城市供水系统」
- 数据源 = 河流、湖泊、雨水(分散的水源)
- 数据集成平台 = 输水管网+净水厂(收集和净化)
- 数据湖 = 大型水库(统一存储)
- 数据分析 = 自来水厂(加工成可饮用的水)
✅ 数据集成平台 vs 数据湖 本质区别
| 维度 | 数据集成平台 | 数据湖 |
|---|---|---|
| 核心角色 | 数据的"搬运工+加工厂" | 数据的"仓库" |
| 主要任务 | 采集、清洗、转换、分发数据 | 统一存储原始/加工后的数据 |
| 关键技术 | Flink, SeaTunnel, Kafka | Iceberg, MinIO, Hudi |
| 输出结果 | 规整后的数据流 | 可查询的数据表 |
| 实时性 | 支持实时+批量处理 | 存储层本身无实时概念 |
🔄 协同工作流程图解
一、为什么需要这对黄金组合?(场景化说明)
典型数据困境案例
# 某电商公司数据流程瓶颈
1. 运营需要分析「促销活动转化率」:
   - 用户信息 → MySQL
   - 点击日志 → Kafka
   - 促销数据 → Excel

2. 当前处理方式:
   ╭─ 开发写Python脚本导出MySQL
   ├─ 用Spark消费Kafka日志
   ╰─ 手动整合Excel到本地CSV
   ⇩
   耗时3天|数据不一致|无法复用
解决方案架构
价值对比:
传统方式 平台+数据湖方案 数据孤岛 统一数据资产池 手动拼接 自动管道化流转 T+3分析 分钟级产出
二、数据集成平台:数据的"加工厂"(深度解析)
核心四大功能
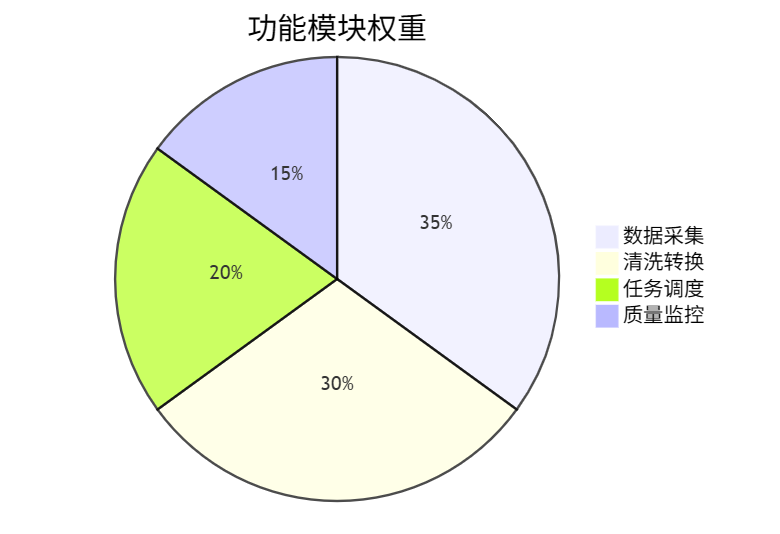
关键技术栈详解
| 能力 | 推荐组件 | 核心价值 | 应用案例 |
|---|---|---|---|
| 实时采集 | Flink CDC + Kafka | 秒级捕获数据库变更 | 订单状态实时更新 |
| 批量同步 | SeaTunnel | 支持200+数据源 | 同步SAP系统历史数据 |
| 流式处理 | Apache Flink | 事件时间处理 | 用户行为会话分析 |
| 任务调度 | Apache Airflow | 可视化工作流编排 | 每日凌晨ETL任务链 |
| 质量监控 | Great Expectations | 数据质量校验 | 防止金额字段为负值 |
典型处理流程:
# 原始数据(MySQL订单表)
order_id:1001, amount:99.9, status:1

# 数据集成平台处理
1. 采集:Flink CDC捕获新增订单
2. 清洗:过滤status!=1的无效订单
3. 转换:amount单位 元→分
4. 丰富:关联用户表添加省份
5. 分发:同时写入Iceberg和StarRocks
三、数据湖:数据的"仓库"(深度解析)
现代数据湖四层架构
核心能力对比
| 能力 | 传统文件存储 | 现代数据湖 |
|---|---|---|
| 数据更新 | 覆盖整个文件 | 增量更新(仅修改部分) |
| 时间旅行 | 不支持 | 查询任意历史版本 |
| Schema演进 | 需重写全部数据 | 动态添加/删除字段 |
| 并发控制 | 文件锁冲突 | ACID事务隔离 |
时间旅行实操示例:
-- 查询昨天的数据状态
SELECT * FROM iceberg.sales.orders
FOR TIMESTAMP '2023-08-01 09:00:00'
WHERE user_id = 1001;
四、具体区分数据集成平台 和 数据湖
数据集成平台是“管道” —— 解决数据怎么流动、怎么清洗、怎么从 A 到 B。
数据湖是“容器” —— 解决数据存储在哪里、怎么统一存、怎么统一管理。
🔍 概念对比详解
| 项目 | 数据集成平台(Data Integration) | 数据湖(Data Lake) |
|---|---|---|
| 🌐 定义 | 多源数据的抽取、转换、加载平台(ETL/ELT) | 原始数据的统一存储与治理平台 |
| 🧠 核心关注 | 数据的流转过程:采集、转换、分发 | 数据的存储和治理:统一存放、统一管理 |
| 🎯 目标 | 解决数据来源异构、结构不一、质量不佳等问题,实现统一“打通” | 解决数据孤岛、格式碎片化等问题,实现统一“存储池” |
| ⚙️ 核心技术/组件 | Flink、SeaTunnel、NiFi、Kafka、Informatica | MinIO、Hudi、Iceberg、Delta Lake、Hive Metastore |
| 📦 数据格式 | JSON、CSV、JDBC、CDC、Kafka 流等 | Parquet、ORC、Avro、Delta、Hudi、Iceberg 等 |
| 🗃️ 数据结构 | 结构化 + 半结构化 + 非结构化 | 结构化 + 半结构化 + 原始格式都支持 |
| ⏱️ 实时性 | 通常支持实时(流处理) + 离线(批处理) | 本身是存储层,不处理实时性,需结合上游 ETL |
| 🧰 示例 | MySQL → SeaTunnel → Kafka → Iceberg | Iceberg 表存于 MinIO/S3,由 ETL 导入维护 |
📌 举个例子说明:
假设你公司有多个业务系统,分别使用 MySQL、Kafka、Redis,你希望将这些数据统一存入 StarRocks 做实时分析,也要沉淀到数据湖中做离线分析,整个过程是这样的:
✅ 数据集成平台做的事:
-
把 MySQL 的数据用 Flink CDC 拉出来
-
用 SeaTunnel 做清洗、字段映射、脱敏
-
把数据同时写到:
- Kafka → 实时处理
- Iceberg → 存入数据湖
- StarRocks → 即席分析
✅ 数据湖做的事:
- 存储清洗后的原始数据
- 支持历史回溯(时间旅行)
- 用于离线训练、BI 报表、数仓建模等
📐 它们的关系
数据集成平台 ≈ 数据管道系统
数据湖 = 数据存储底座(可接收集成平台的结果)
五、黄金组合如何协同工作?
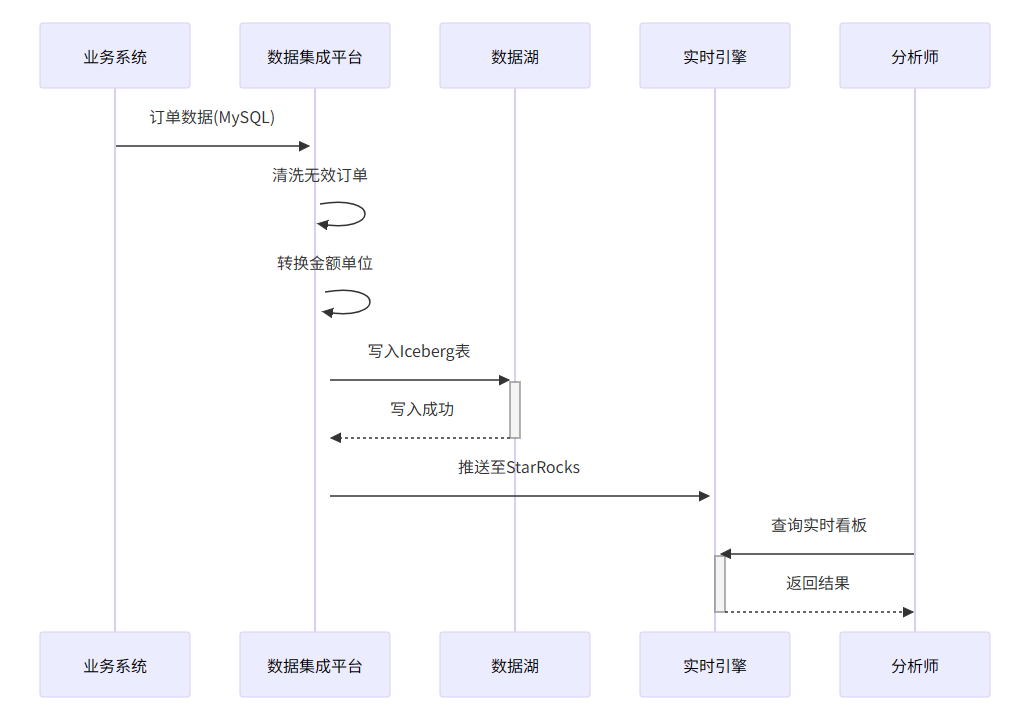
端到端流程示例
sequenceDiagram
  业务系统->>+数据集成平台: 订单数据(MySQL)
  数据集成平台->>+数据集成平台: 清洗无效订单
  数据集成平台->>+数据集成平台: 转换金额单位
  数据集成平台->>+数据湖: 写入Iceberg表
  数据湖-->>-数据集成平台: 写入成功
  数据集成平台->>+实时引擎: 推送至StarRocks
  分析师->>+实时引擎: 查询实时看板
  实时引擎-->>-分析师: 返回结果
组件对接矩阵
| 集成平台组件 | 数据湖对接方式 | 最佳实践案例 |
|---|---|---|
| Flink CDC | 直接写入Iceberg表 | MySQL→Iceberg实时同步 |
| SeaTunnel | 通过S3接口写入MinIO | 每日同步Oracle历史数据 |
| Spark | 使用Hudi DeltaStreamer | 大规模数据批量入湖 |
| Kafka Connect | 配置Iceberg Sink | 日志数据实时入湖 |
六、技术选型指南(含避坑建议)
选型决策树
生产环境推荐栈
| 场景 | 数据集成方案 | 数据湖方案 | 优势 |
|---|---|---|---|
| 实时数仓 | Flink CDC + Kafka | Hudi + HDFS | 分钟级延迟 |
| 离线分析 | SeaTunnel + Airflow | Iceberg + MinIO | 成本优化 |
| 湖仓一体 | Flink + Kafka Connect | Delta Lake + S3 | 流批统一 |
| 多云架构 | Airbyte + dbt | Iceberg + 跨云存储 | 避免厂商锁定 |
新手避坑指南:
- 小文件问题:配置Flink的
write.target-file-size=128MB- Schema变更:启用Iceberg的
schema evolution- 权限控制:提前规划Ranger策略
- 元数据备份:定期导出Hive Metastore
七、总结:核心认知升维
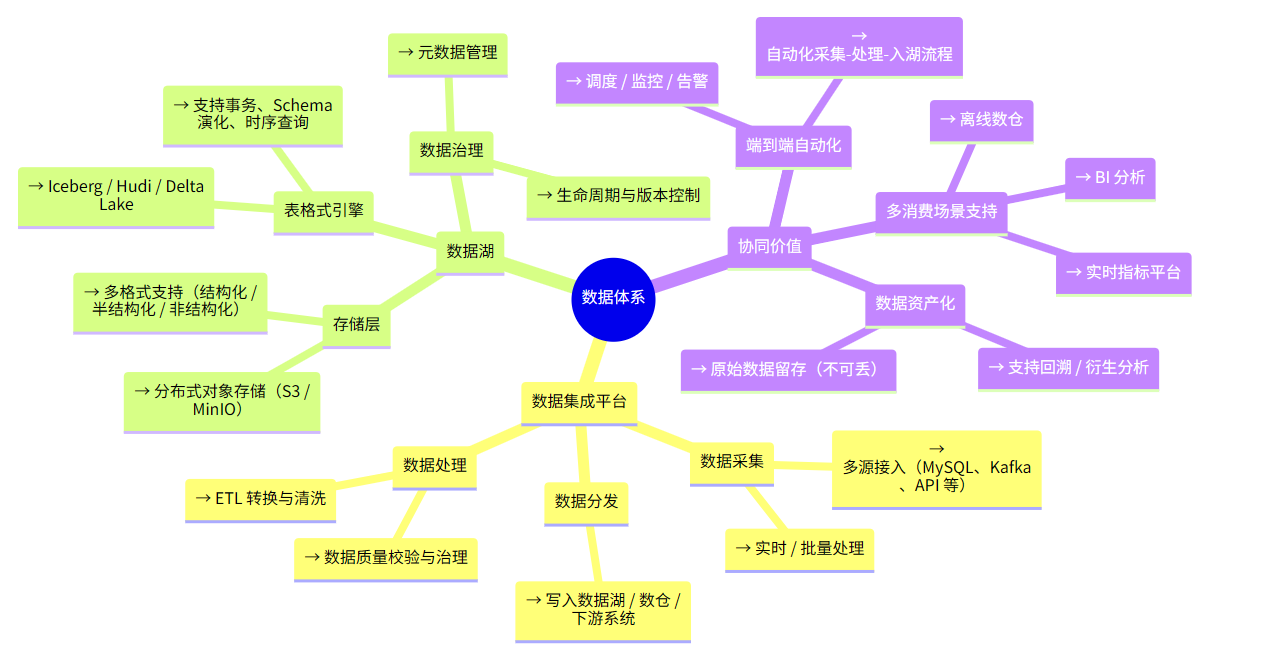
root((数据体系))
  数据集成平台: 数据的“加工流水线”
    数据采集:
      - 多源接入:MySQL、Kafka、API 等
      - 支持实时流 / 批量任务并行处理
    数据处理:
      - ETL 转换与数据清洗
      - 数据质量校验与治理规则
    数据分发:
      - 写入:数据湖 / 数仓 / 下游应用系统
      - 支持消息推送、接口服务等分发模式

  数据湖: 数据的“标准化仓库”
    存储层:
      - 分布式对象存储:S3、MinIO 等
      - 多格式支持:结构化 / 半结构化 / 非结构化
    表格式引擎:
      - 支持 Iceberg、Hudi、Delta Lake
      - 提供事务、Schema 演化、时序版本等能力
    数据治理:
      - 元数据管理:血缘、影响分析
      - 生命周期管理 & 数据版本控制

  协同价值: 数据平台的综合能力输出
    端到端自动化:
      - 自动采集 → 处理 → 入湖 → 分发全链路打通
      - 支持调度编排、任务监控、失败告警
    数据资产化:
      - 原始数据全量留存,保障回溯分析能力
      - 支持指标复用与模型复合
    多消费场景支持:
      - 支持 BI 分析工具(如 Tableau、FineBI)
      - 离线数仓加工与报表支撑
      - 实时指标平台 / 数据服务 API
✅ 数据集成平台 是数据流通的 加工流水线,负责把散落在各处的数据汇聚、处理、整合。
✅ 数据湖 是数据的 标准化归宿,负责统一存储、治理和建模分析。
🧩 两者结合 构建企业级 数据供应链体系,实现数据从“原材料”到“资产”的全流程闭环。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 13
 0
- 0


 已为社区贡献1条内容

所有评论(0)