计算机系统结构知识点讲义习题③(第十一讲到第十五讲)
习题来源:《计算机系统结构(第3版)》——张晨曦 王志英 等编著 部分课后习题
该五讲的题目比较多,习题一共分三次发布,这是13-18题
题目+答案解析
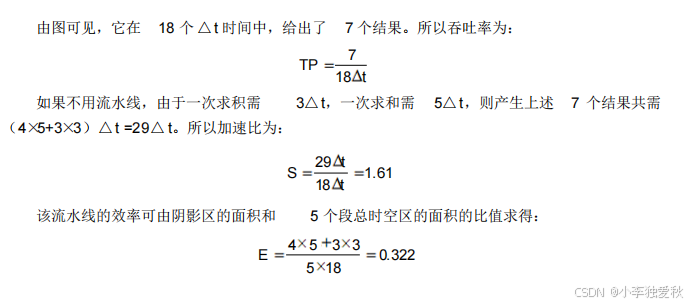
题(13):有一条静态多功能流水线由 5 段组成,加法用 1、3、4、5 段,乘法用 1、2、5 段,第 3 段的时间为 2△t,其余各段的时间均为△t,而且流水线的输出可以直接返回输入端或暂存于相应的流水寄存器中。现要在该流水线上计算画出其时空图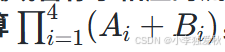 ,并计算其吞吐率、加速比和效率。
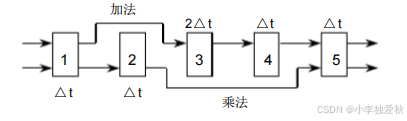
答:
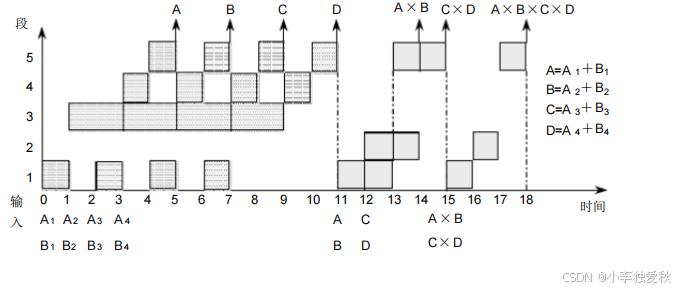
首先,应选择适合于流水线工作的算法。对于本题,应先计算 A1+B1、A2+B2、A3+B3和 A4+B4;再计算 (A1+B1)×(A2+B2) 和(A3+B3)×(A4+B4);然后求总的结果。
其次,画出完成该计算的时空图,如图所示,图中阴影部分表示该段在工作。
题(14):动态多功能流水线由 6 个功能段组成,如下图:
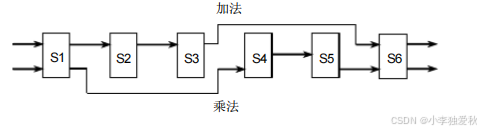
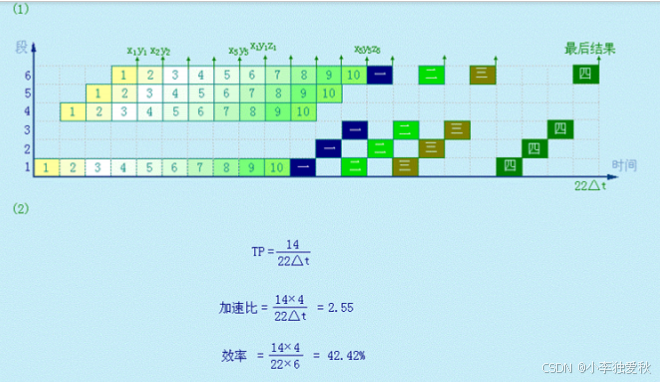
中,S1、S4、S5、S6 组成乘法流水线,S1、S2、S3、S6 组成加法流水线,各个功能段时间均为 50ns,假设该流水线的输出结果可以直接返回输入端,而且设置有足够的缓冲寄存器,若以最快的方式用该流水计算: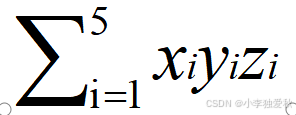
(1)画出时空图;
(2)计算实际的吞吐率、加速比和效率。
解:机器一共要做 10 次乘法,4 次加法。
题(15):在 MIPS 流水线上运行如下代码序列:
LOOP:
    LW    R1, 0(R2)
    DADDIU R1, R1, #1
    SW    R1, 0(R2)
    DADDIU R2, R2, #4
    DSUB  R4, R3, R2
    BNEZ  R4, LOOP
其中:R3 的初值是 R2+396。假设:在整个代码序列的运行过程中,所有的存储器访问都是命中的,并且在一个时钟周期中对同一个寄存器的读操作和写操作可以通过寄存器文件“定向”。
问:
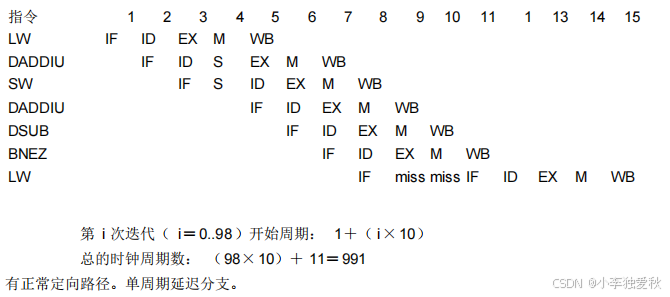
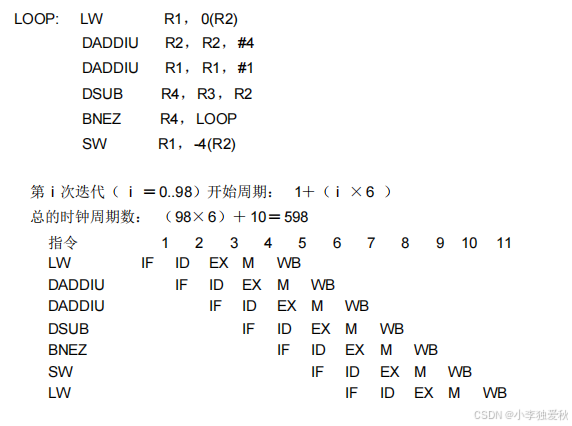
(1)在没有任何其它定向(或旁路)硬件的支持下,请画出该指令序列执行的流水线时空图。假设采用排空流水线的策略处理分支指令,且所有的存储器访问都命中 Cache,那么执行上述循环需要多少个时钟周期?
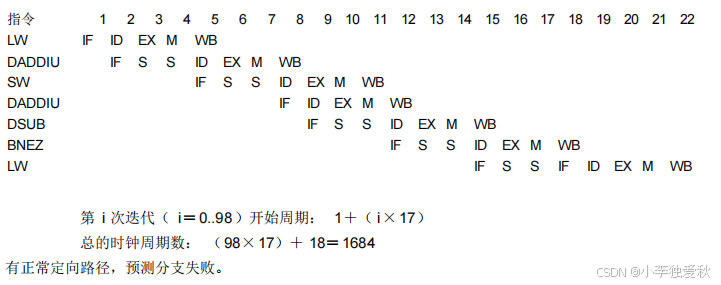
(2)假设该流水线有正常的定向路径,请画出该指令序列执行的流水线时空图。假设采用预测分支失败的策略处理分支指令,且所有的存储器访问都命中 Cache,那么执行上述循环需要多少个时钟周期?
(3)假设该流水线有正常的定向路径和一个单周期延迟分支,请对该循环中的指令进行调度,你可以重新组织指令的顺序,也可以修改指令的操作数,但是注意不能增加指令的条数。请画出该指令序列执行的流水线时空图,并计算执行上述循环所需要的时钟周期数。
解:
寄存器读写可以定向,无其他旁路硬件支持。排空流水线。
题(16):假设各种分支指令数占所有指令数的百分比如下:
| 条件分支 | 20%(其中的 60% 是分支成功的) |
|---|---|
| 跳转和调用 | 5% |
现有一条段数为 4 的流水线,无条件分支在第二个时钟周期结束时就被解析出来,而条件分支要到第三个时钟周期结束时才能够被解析出来。第一个流水段是完全独立于指令类型的,即所有类型的指令都必须经过第一个流水段的处理。请问在没有任何控制相关的情况下,该流水线相对于存在上述控制相关情况下的加速比是多少?
答:
没有控制相关时流水线的平均 CPI = 1
存在控制相关时:由于无条件分支在第二个时钟周期结束时就被解析出来,而条件分支要到第 3 个时钟周期结束时才能被解析出来。所以:
(1)若使用排空流水线的策略,则对于条件分支,有两个额外的 stall,对无条件分支,有一个额外的 stall:
CPI = 1 + 20% * 2 + 5% * 1 = 1.45
加速比 S=CPI/1 = 1.45
(2)若使用预测分支成功策略,则对于不成功的条件分支,有两个额外的 stall,对无条件分支和成功的条件分支,有一个额外的 stall:
CPI = 1 + 20% * (60% * 2 + 40% * 0) + 5% * 1 = 1.33
加速比 S=CPI/1 = 1.33
(3)若使用预测分支失败策略,则对于成功的条件分支,有两个额外的 stall,对无条件分支,有一个额外的 stall;对不成功的条件分支,其目标地址已经由 PC 值给出,不必等待,所以无延迟:
CPI = 1 + 20% * (60% * 2 + 40% * 0) + 5% * 1 = 1.29
加速比 S=CPI/1 = 1.29
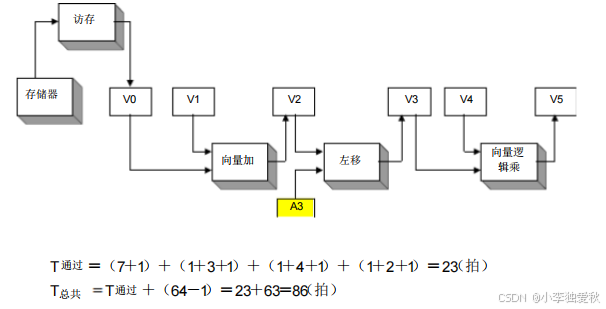
题(17):在 CRAY-1 机器上,按照链接方式执行下述 4 条向量指令(括号中给出了相应功能部件的执行时间),如果向量寄存器和功能部件之间的数据传送需要 1 拍,试求此链接流水线的通过时间是多少拍?如果向量长度为 64,则需多少拍才能得到全部结果?
- V0 ← 存储器 (从存储器中取数:7 拍)
- V2 ← V0 + V1 (向量加:3 拍)
- V3 ← V2 < A3 (按(A3)左移:4 拍)
- V5 ← V3 ∧ V4 (向量逻辑乘:2 拍)
解:
通过时间就是每条向量指令的第一个操作数执行完毕需要的时间,也就是各功能流水线由空到满的时间,具体过程如下图所示。要得到全部结果,在流水线充满之后,向量中后继操作数继续以流水方式执行,直到整组向量执行完毕。
题(18):某向量处理机有 16 个向量寄存器,其中 V0~V5 中分别放有向量 A、B、C、D、E、F,向量长度均为 8,向量各元素均为浮点数;处理部件采用两条单功能流水线,加法功能部件时间为 2 拍,乘法功能部件时间为 3 拍。采用类似于 CARY-1 的链接技术,先计算 (A+B) *C,在流水线不停流的情况下,接着计算 (D+E) *F。
(1)求此链接流水线的通过时间?(设寄存器入、出各需 1 拍)
(2)假如每拍时间为 50ns,完成这些计算并把结果存进相应寄存器,此处理部件的实际吞吐率为多少 MFLOPS?
解:
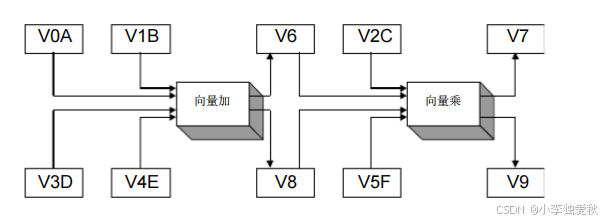
(1)我们在这里假设 A+B 的中间结果放在 V6 中,(A+B)×C 的最后结果放在 V7 中,D+E 的中间结果放在 V8 中,(D+E)×F 的最后结果放在 V9 中。具体实现参考下图:
通过时间应该为前者 (A+B)×C 通过的时间:
T 通过 = (1+2+1)+(1+3+1) = 9(拍)(2)在做完 (A+B)×C 之后,作 (C+D)×E 就不需要通过时间了。
V6 ← A+B
V7 ← V6×C
V8 ← D+E
V9 ← V8×FT = T 通过 + (8-1)+8 = 24(拍)= 1200(ns)
TP = 32/T = 26.67MFLOPS

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 15
 0
- 0


 已为社区贡献53条内容

所有评论(0)