数据库技术提升-MySQL数据库原理、设计与应用【3.8】
11.4 分表技术
通常情况下,项目中数据库的数据随着时间的推移会越来越多,而单张数据表存储的数据又是有限的,当其达到一定的量级(如百万级)时,即使添加了索引,执行查询操作依然会变慢,特别是在并发操作时,会增加单表的访问压力。此时,可以考虑使用分表技术,将单张数据表根据不同的需求进行拆分,从而达到分散单表压力的目的,提升数据库的访问性能。
MySQL, 中常用的分表技术有两种,分别为水平分表和垂直分表。所谓水平分表指的是将一张数据表中的全部记录分别存储到多张数据表中,因此水平分表在创建时,必须保证各数据表涉及的字段全部相同。所谓垂直分表指的是将同一个业务的不同字段分别存储到多张数据表中,因此垂直分表在创建时,各数据表仅通过一个字段进行连接,其他字段都不相同。
为了读者更好地理解,接下来分别讲解水平分表和垂直分表的实现原理以及各自的优缺点。
1.水平分表
水平分表是一种物理创建表的设计,它是用户根据指定的需求将记录分别存储到各个分表中,每张数据表的字段相同,但是名称不同。通常情况下,就是根据表的名称对分表进行增删改查操作,如图 11-1 所示。
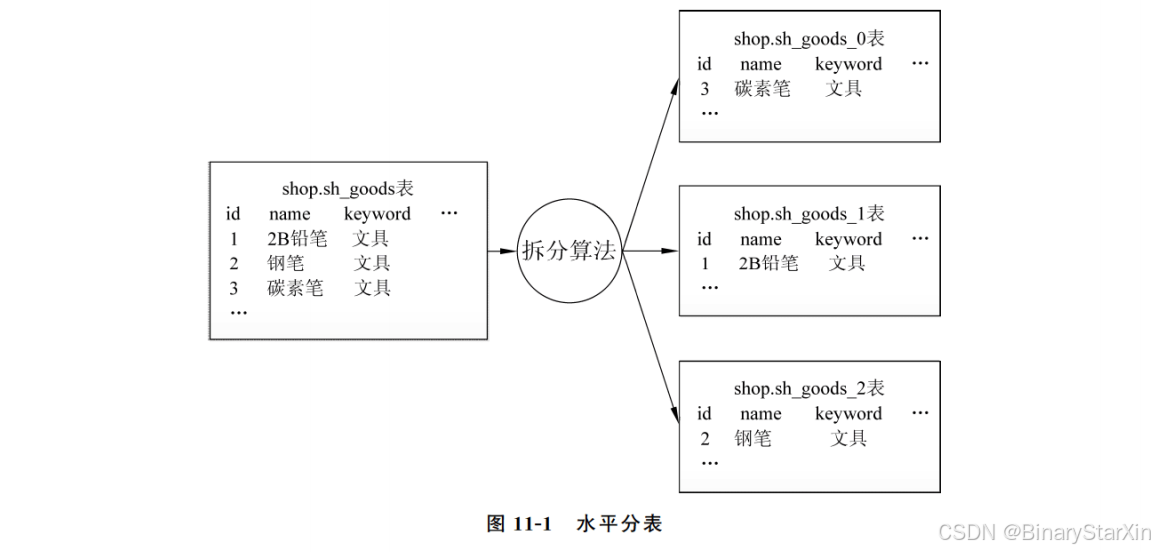
在图 11-1 中,水平分表的拆分方式(算法)可以有多种,根据项目的业务不同可以演化出多种不同的方式。最常使用的方式就是利用记录ID与分表个数取余获取分表的编号,然后再对获取的分表执行指定的操作。
例如,对 sh_goods 表进行水平分表,在图 11-1 中设置了3个分表,因此根据 id%3 获取的余数将对应的记录插入到对应的分表中,同理在对指定记录进行删除、修改、查询时,也是利用以上取余的方式到指定的分表中进行相关的操作。除此之外,水平分表的拆分方式还可以根据商品的创建时间、品牌、店铺、销量等级等的不同将其分别存储到不同的分表中。而分表的数量以及拆分方式还需考虑表的预估容量可扩展性等因素具体去设计。
总结:水平分表使单张表的数据能够保持在一定的量级,在操作时又因其表结构完全相同,只需增加获取对应分表名称的运算,就可以提高系统的稳定性和负载能力。但同时它也有一定的缺点,水平分表使得数据分散存储,加大了数据的维护难度。
2.垂直分表
设计数据表时,若一个表中含有很多字段,其中有一部分字段经常被使用,而有一部分字段不常被使用,那么在对此数据表进行操作时,不常用的字段也会占据一定的资源,会对系统的整体性能造成一定的干扰和影响。
为了减少资源的开销,提升运行效率,可以采用垂直分表的方式,将数据表中的字段根据使用的频率分别存储到不同的表中。假如有一个用户信息表,它含有 12 个字段,分别为用户 ID、用户名、密码、邮箱、手机号、QQ、是否激活、用户级别、性别、注册时间、创建时间和更新时间。其中,只有前7个字段会在用户登录时经常用到,其余字段的使用率则很小,这时就可以利用垂直分表的设计方式将其拆分成一个主表和一个从表,如表 11-7 所示
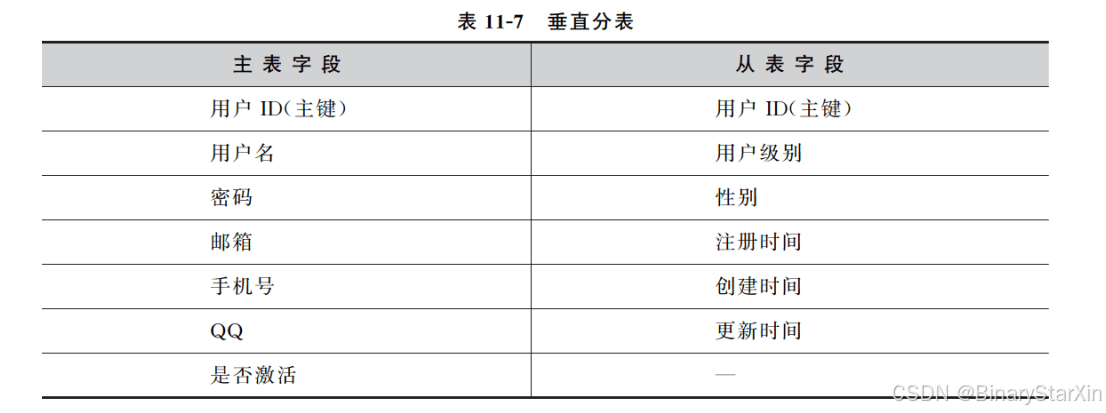
在表 11-7 中,主表和从表利用用户 ID进行连接即可获取一个用户的完整信息。当不需要完整信息时,只需要对相应的表进行操作即可。
总结:垂直分表后业务逻辑更加清晰,方便数据进行整合与扩展,还可以根据实际需求实现动静分离,为各分表选择不同的存储引擎(如查询操作多可以使用 MyISAM 等)。但同时它也有一定的缺点,需要管理冗余字段、查询所有数据需要进行连接。
11.5 分区技术
11.5.1 分区概述
对于单表数据量过大的问题,除了可以使用分表技术,在物理上创建多张数据表解决外,还可以使用 MySQL 本身支持的分区技术提高数据库的整体性能,所谓分区技术,就是在操作数据表时可以根据给定的算法,将数据在逻辑上分到多个区域中存储。此外,在分区中还可以设置子分区,将数据存放到更加具体的区域内。比如大量的水果(数据)可以分别存储在多个仓库(分区)中,在仓库中又可以划分出固定的区域(子分区)用来存放不同种类的水果(数据)。
分区技术可以使一张数据表中的数据存储在不同的物理磁盘中,相比单个磁盘或文件系统能够存储更多的数据,实现更高的査询吞吐量。若在 WHERE 子句中包含分区条件,系统只需扫描相关的一个或多个分区而不用全表扫描,从而提高查询效率。
MySQL, 中分区技术在使用时对存储引擎以及锁有一定的要求,具体内容如下
(1)分区技术不适用于 MERGE、CSV 或 FEDERATED 存储引擎。(2)InnoDB分区表不能设置外键,同样的,与外键相关的主表和从表也不能被分区。(3)MySQL 5.7中 InnoDB 表不支持子分区在多个磁盘中存储,目前仅有 MyISAM 存储引擎支持。
(4)同一个分区表的所有分区必须使用相同存储引警。当建表时未指定存储引擎,在创建分区时必须设置存储引擎。
(5)MySQL 5.6及更早的版本中,对分区的 MyISAM 表进行操作时,会锁定所有的分区,直到操作完成后才会释放锁。而在 MySQL5.7中,仅会锁定与操作相关的分区,不会影响其他分区。
11.5.2 分区管理
在了解了分区的作用以及特点后,本节将对创建分区、增加分区以及删除分区的操作进行详细讲解
1.创建分区
在创建数据表时,可同时完成分区的创建,其基本语法格式如下。
CREATE TABLE 数据表名称
[(字段与索引列表)][表选项]
PARTITION BY 分区算法(分区字段)[PARTITIONS分区数量]
[SUBPARTITION BY 子分区算法(子分区字段)[SUBPARTITIONS 子分区数量]]
PARTITION 分区名[VALUES 值][其他选项][(SUBPARTITION 子分区名[其他选项])],)1
在上述语法中,分区是在表选项后添加 PARTITION BY 实现,一个表最多仅可以创建1024 个分区。其中,分区算法有4种,分别为 LIST、RANGE、HASH 和 KEY,每种算法对应的分区字段不同,具体语法如下。
RANGE/LIST(表达式)或 COLUMNS(字段列表)HASH(表达式)
KEY[ALGORITHM{112}](字段列表)
在上述语法中,KEY 算法的 ALGORITHM 选项用于指定 key-hashing 函数的算法,其值等于 1,适用于 MySQL 5.1:默认值是2,适用于 MySQL 5.5 及以后版本。此外,子分区算法仅支持 HASH 和 KEY。
在指定分区算法和分区字段后,RANGE 和LIST 分区必须用 PARTITION…VALUES具体定义每个分区选项,且只有这两个算法有 VALUES选项。具体语法如下。
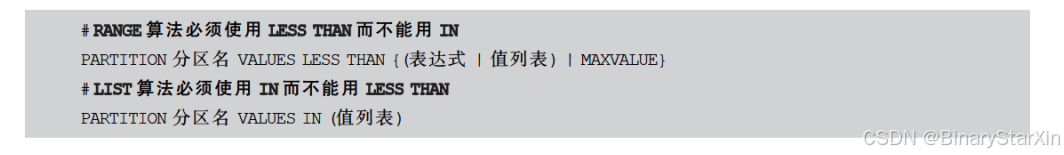
在上述语法中,分区名要符合 MySQL,标识符的规则。但需要注意的是,分区名称不区分大小写。分区的其他选项如表 11-8所示。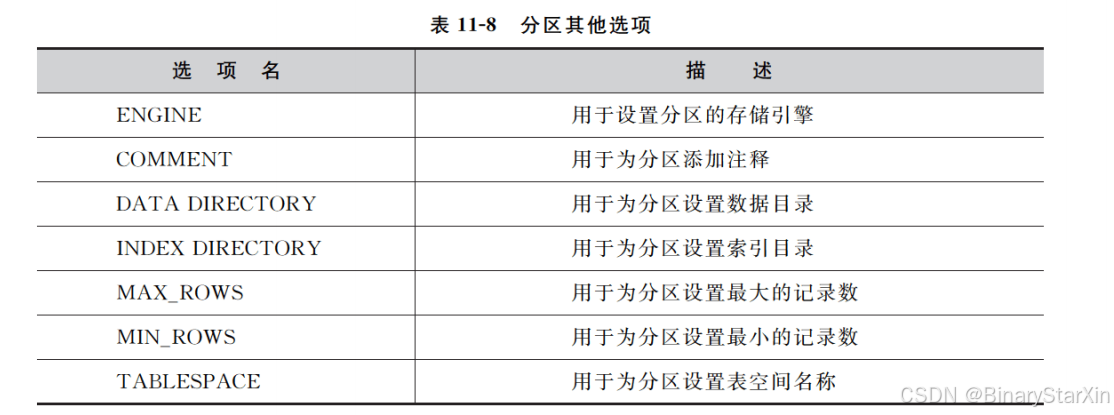
为了读者更好地理解,下面以创建 LIST 和 HASH 分区为例进行演示,具体 SQL 语句及执行结果如下。
(1)创建 LIST 分区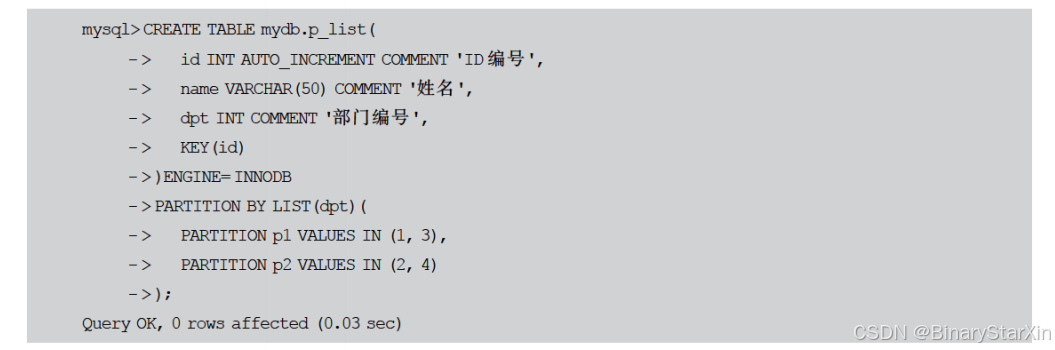
在上述语句中,以 mydb.p list 表中的 dpt 字段进行分区,当该字段的值为1或3时,将对应的记录放在名为p1的分区中;当该字段的值为2或4时,将对应的记录放在名为p2的分区中。分区创建完成后,会在 MySQL,的数据文件 data/mydb 目录下看到对应的分区数粦轢悫棬畵骖狠场疎偃郾文件,如下所示。
p list# p# pl.idb
p list#t pt p2.idb
上述的文件名称中,p_list 是建立分区的数据表名,p1 和p2 表示分区的名称。
此外,读者还可以利用 SHOW CREATE TABLE 查看分区的创建语句,使用 SHOWTABLE STATUS 查看指定数据库下对应数据表是否有创建分区,若有则 Create_options字段的值为 partitioned;在执行 SQL 语句时可以使用 EXPLAIN 进行分析。
需要注意的是,在使用分区时,只有 WHERE 子句后字段是分区字段,SQL, 操作才会用到分区。
(2)创建 HASH 分区
mysql>CREATE TABLE mydb.p hash (
id INT AUTO INCREMENT
name VARCHAR (50)
dpt INT,
KEY (id)、
->)ENGINE-INNODB
>PARTITION BY HASH (dpt)PARTITIONS 3;
Query OK,0 rows affected (0.04 sec)
上述语句中,使用 HASH 算法为p hash 表创建了3个分区,分区文件的序号默认从 0开始,当有多个分区时依次递增加1。例如,以上创建的分区序号依次为0、1和 2。
小提示:
(1)当创建分区的表时,主键必须包含在建立分区的字段中
(2)当创建分区的表仅有一个 AUTO INCREMENT 字段时,该字段必须为索引字段。
2.增加分区
在操作时,若数据表没有创建分区,则可以利用以下的语法为已经创建的数据表添加分区,其基本语法如下。
ALTER TABLE 数据表名称 PARTITION BY 分区算法…:
在上述语法中,PARTITION BY 后可以添加的内容与 CREATE TABLE的相同。此外,对已经含有分区的数据表再添加分区时,则可以使用以下的语法。
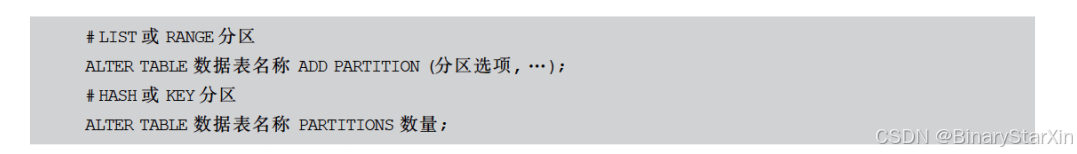
在上述语法中,分区选项与 CREATE TABLE 中创建分区的选项相同。为了读者更好地理解,下面为 mydb 数据库下 p_list 和 p_hast 数据表添加分区。具体 SQL语句及执行结果如下
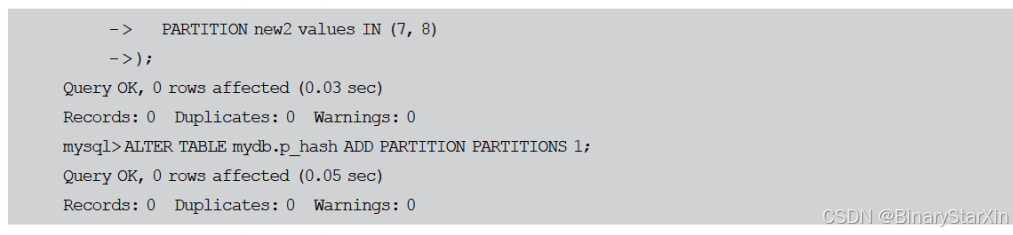
分区添加完成后,读者可按上面讲解的方式查看分区。值得一提的是,当添加分区的数据表已经含有数据时,会按照分区的算法将已有的数据分配到不同的分区中。
3.删除分区
在分区管理过程中,若某个表不再需要设置分区时,可以通过 MySQL, 提供的方式进行删除,但不同算法的分区删除方式不相同。其基本语法格式如下。
#删除 HASH、KEY 分区
ALTER TABLE 数据表名称 COALESCE PARTITION 数量;
#删除 RANGE、LIST 分区
ALTER TABLE 数据表名称 DROP PARTITION 分区名称;
在上述语法中,HASH 与KEY算法的分区在删除时,会将该分区内的数据重新整合到剩余的分区中,而 RANGE 与 LIST 算法的分区在删除时会同时删除分区中保存的数据,此外,当数据表的分区仅剩一个时,不能通过以上的方式删除,只能利用 DROP TABLE 的方式删除表。
为了读者更好地理解,下面以删除 mydb.p list 表中的分区为例进行演示,具体 SQI语句及执行结果如下。
(1)添加测试数据,用于测试删除分区后数据的变化。
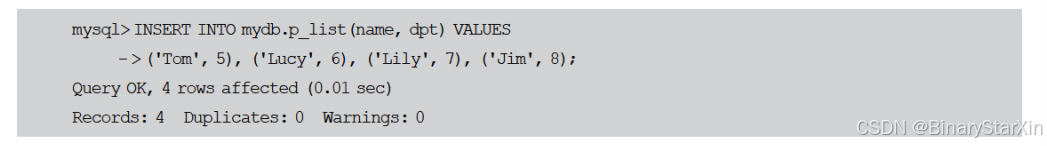
在上述语句中,根据添加分区的设置,dpt为5和6的记录保存在名为 new1的分区中,dpt为7和8的记录保存在名为new2 的分区中:
(2)删除 mydb.p list 表中名为 newl 的分区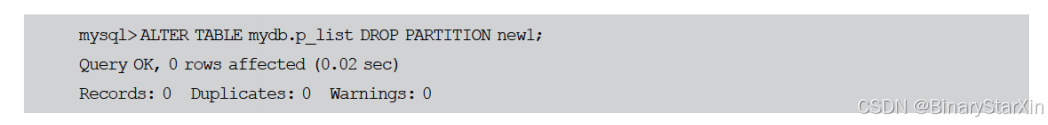
按照以上操作删除分区后,可以到 data/mydb 目录下看到名为p_list#p#newl.ibd 的分区数据文件已被删除,然后利用以下语句可以看出当前 mydb. p_list 表中 new1 分区下保存的数据也被同时删除了,仅剩 new2 分区下的两条记录。如下所示。
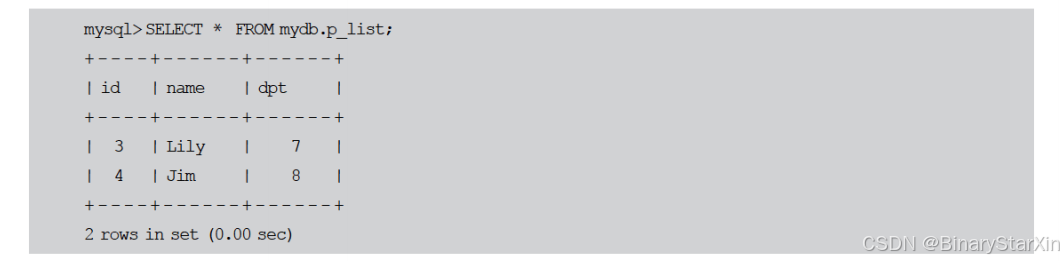
值得一提的是,若在开发中仅要清空各分区表中的数据,不删除对应的分区文件,可以使用以下的语句实现。其基本语法如下。
ALTER TABLE 数据表名称 TRUNCATE PARTITION {分区名称 |ALL)
在上述语法适用于所有算法的分区,当要删除表中所有分区中保存的数据时,使用ALL代替即可:若要删除指定的分区,则需要使用分区名称,多个分区之间使用逗号(,)分隔。
在 MySQL,数据库中,DELETE 删除一条记录时,仅仅删除了数据表中保存的数据,而记录占用的存储空间会被保留。因此,长期删除数据、添加数据的过程中,索引文件和数据文件都将产生“空洞”,形成很多不连续的碎片,造成数据表占用的空间变大,但是表中的记录数却很少的情况发生。
若要解决以上数据碎片造成的影响,可使用 MySQL 提供的方式 OPTIMIZE TABLE(支持 MySQL, 中常见的存储引擎 MyISAM 和 InnoDB)重新组织表中数据和关联索引数据的物理存储,减少存储空间并提高访问表时的 /0 效率。
为了读者更好地理解,下面通过一个案例进行简单的演示。
(1)创建数据表、添加测试数据
要想看出数据碎片整理与未整理,需要在数据表中添加大量的数据,然后直接査看其数据文件大小的变化。下面利用数据复制的方式为新建的数据表 mydb.my_optimize 添加测试数据(如此处添加到 50 万条以上的数据)。具体 SQL 语句及执行结果如下。
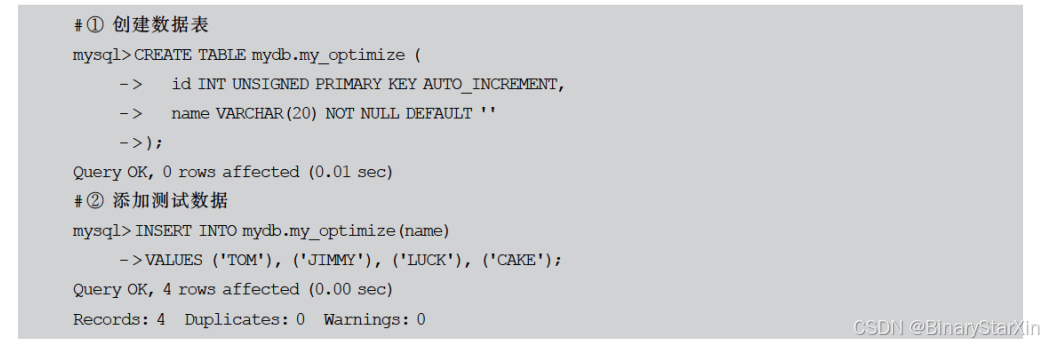
#③ 数据复制添加测试数据
mysql> INSERT INTo mydb.my optimize (name) SELEcT name FRoM mydb.my optimize;Query OK, 4 rows affected (0.00 sec)
Records:4 Duplicates:0Warnings:0
#多次执行③中的语句直到数据达到 50万条以上,此处省略
(2)DELETE数据,查看数据存储文件的大小
在删除数据前,打开数据库 data 日录,查看添加完数据后 my_optimize.idb 的大小,大约为 40MB。然后执行以下的 DELETE 操作,具体 SQL 语句及执行结果如下
mysql>DELETE FROM mydb.my optimize WHERE name = 'LUCK';Query OK,262144 rows affected (2.25 sec)
数据删除后,再次査看 my_optimize.idb 会发现数据索引文件的大小并没有变化,而此时 mydb. my_optimize 表中已经删除了所有名为 LUCK 的记录。
(3)整理数据,查看数据存储文件的大小。
为了整理以上删除操作产生的数据碎片,接下来使用 OPTIMIZE TABLE 进行碎片整理。具体 SQL 语句及执行结果如下。
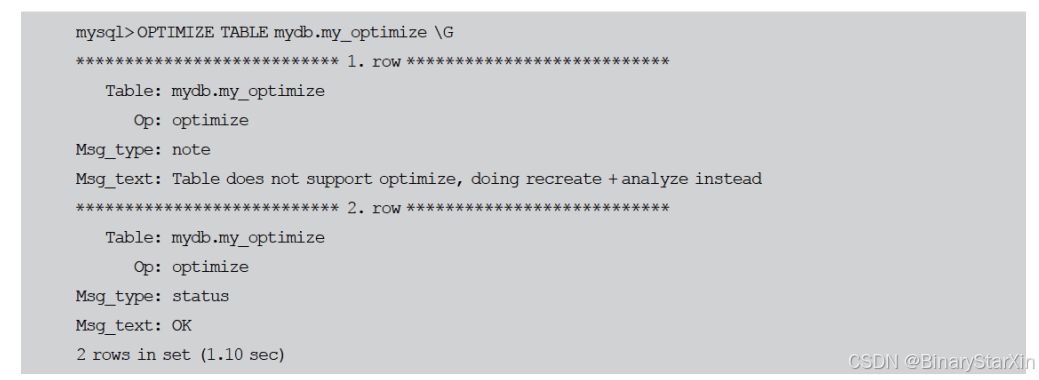
在上述执行结果中,InnoDB 存储引擎的数据表不支持 OPTIMIZE TABLE操作,因此给出第一条记录进行报错。然后系统自动使用 ALTER TABLE…FORCE 语句重新构建表并整理相关的数据碎片,释放未使用的存储空间,返回第2条记录信息。其中,Op 表示行 optimize 操作,Msg_type 表示信息的类型,除此之外还有 error、info 和 warning;Msgtext 表示具体的返回信息内容。
完成上述操作后,再次査看 my_optimize.idb 会发现数据索引文件的大小变为 31MB左右。可以清晰地看出在对数据表进行维护后,解决了因数据碎片产生的空间的浪费以及查询速度慢的问题。
除了以上讲解的 OPTIMIZE 操作外,还可以使用 ALTER TABLE将数据表的存储引警修改为当前数据表的存储引擎,实现对数据碎片的整理。例如,上面的步骤(3)可以使用以下语句代替,
ALTER TABLE mydb.my optimize ENGINE-'InnoDB';
需要注意的是,修复数据表的数据及索引碎片时,会把所有的数据文件重新整理一遍因此,若数据表的记录数比较大,也会消耗一定的资源,所以不能频繁地对数据碎片进行维护,可根据实际的情况按周、月或季度等进行操作。
11.7 动手实践:数据库优化实战
数据库的学习在于多看、多学、多想、多动手,只有将理论与实际相结合,才能够体现出数据开发与管理的重要性,展现知识学习的价值与力量。接下来请结合本章所学的知识完成数据库的优化操作。
【实践目标】
此实践的目标就是能够根据文字提示,完成百万级数据常规的优化操作。
【实践需求】
(1)在 mydb 数据库中创建 my_user 用户表并添加两百万条数据用于测试。my_user数据表的字段有 id、name 和 pid。
(2)开启慢查询日志,获取查询时间超过 0.5 秒的查询语句信息。
(3)开启 profile 机制,获取语句执行的精确时间。
(4)为pid 添加索引,优化查询语句,增强查询效率
(5)优化 LIMIT 分页查询的效率。
(6)启动查询缓存功能,优化查询效率。
【动手实践】
1.创建测试数据
在 mydb 数据库中创建一个用户表 my_user,具体 SQL,语句及执行结果如下。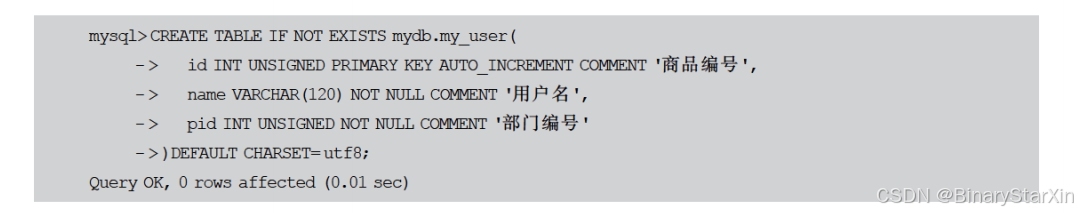
为了便于测试数据库优化的效果,下面通过自定义函数和存储过程的方式为 my_user表添加百万级别的数据,具体 SQL语句及执行结果如下。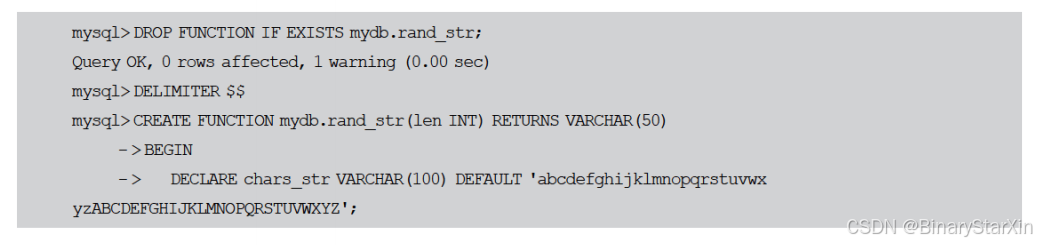
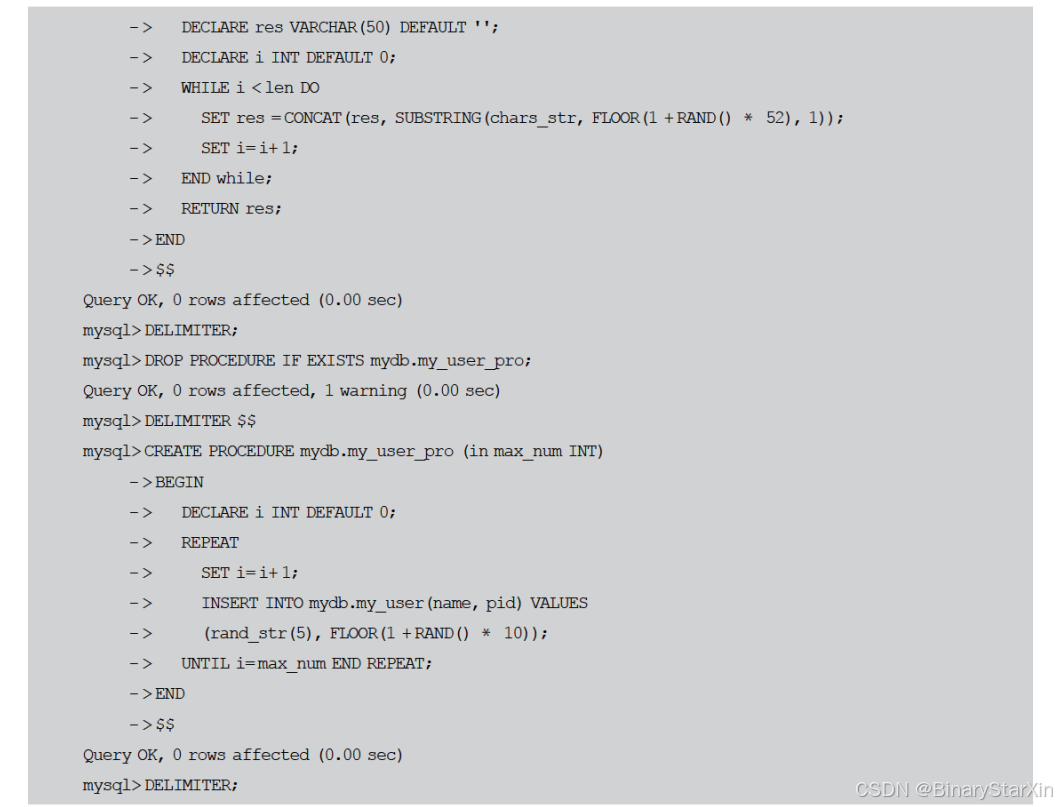
在上述语句中,在创建函数与存储过程前首先执行删除操作,避免 mydb 数据库含有相同的函数与存储过程。自定义的 rand str()函数可以获取指定位数的字符串,my_user_pro()存储过程可以为 my_user 表完成指定数量数据的添加。
下面调用 my_user_pro()存储过程,为 my_user 表添加两百万条数据,具体 SQL 语句及执行结果如下。
2.开启慢查询日志
慢查询日志是 MySQL, 提供的一种记录所有执行时间超过指定时间界限的 SQL, 语句。
然后可以根据写人日志内的语句对 MySQL 进行分析优化。
默认情况下,没有开启慢査询日志,下面打开 MySQL, 的 my.ini 配置文件,开启慢查询日志功能,同时设置慢查询日志文件的路径以及时间界限。具体配置如下。
slow query log=on
slow query log file="C:/slow.log'
long query time =0.5
在上述配置中,slow_query_log 用于开启慢査询日志,slow_query_log_file 用于设置日志文件保存的路径,默认保存到 MySQL 的 data 目录下,这里将其保存到 C盘下 slow.log文件中。long_query_time 表示查询时间超出指定的时间(如0.5秒)就将其当做慢查询,将其保存到 slow.log 文件中,默认的时间为 10 秒
完成设置后,重新启动 MySQL 使配置生效。然后执行以下 SQL, 语句,并打开 C:slow.log 文件,分析慢查询日志中的信息。具体如下
#① 在客户端中执行以下 SL语句
SELECT COUNT (*)FRoM my user WHERE pid=2;
#② 使用文本编辑器 (如记事本、Notepad++)打开 c:\slow.log文件,查看保存的日志信息mysq15.7.22,Version:5.7.22-log (MySQL Community Server (GPL)). started with:TCP Port:3306,Named Pipe:(null)
Time
Id Command
Argument
# Time:2018-07-24T08:30:25.532616Z
#User@Host:root[root]@localhost[::1l Id:2
#Query time:0.783045 ock time:0.000000 Rows sent:1 Rows examined: 2000000SET timestamp 1532421025;
select count(*)from test.my user where pid 2;
以上的日志信息中,Time 表示执行慢查询语句的服务器时间,User@Host 指定执行慢查询语句的用户,Query_time 表示慢査询语句的执行时间,Lock_time 表示锁定的时间。Rows sent 表示发送的记录数,Rows examined 表示检索的记录数,SET timestamp 是将信
息写人日志的时间戳,最后一句是慢査询的 SQL 语句。值得一提的是,虽然慢査询日志是 MySQL,优化及调试的一个重要工具,但是开启后慢查询会占用一定的系统资源与空间。因此,建议在项目开发阶段可以开启用于数据库调试与优化,在项目上线后要将其关闭。
3.开启记录查询的精确时间功能
在优化数据操作时,若仅想获取精确到毫秒查询时间,可以启动 MySQL 提供的 profile机制,它会记录每次操作的具体时间(精度为小数点后8位)。
下面开启记录查询的精确时间功能,査看 SQL语句的执行时间。具体 SQL语句及执行结果如下。
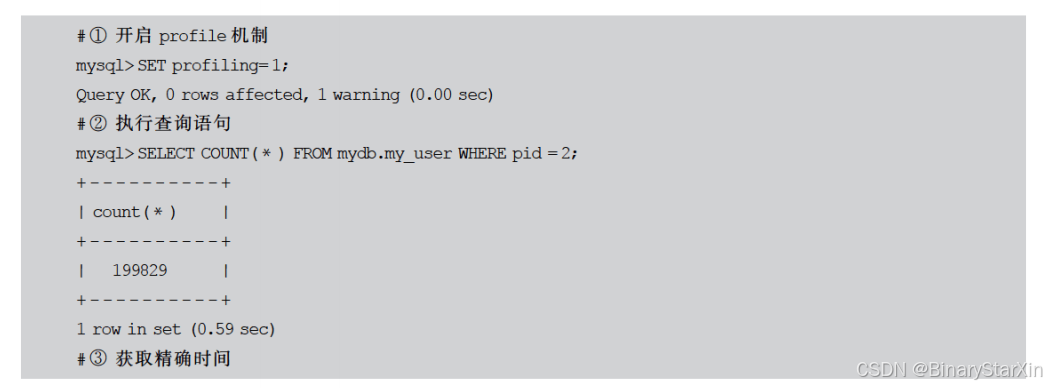
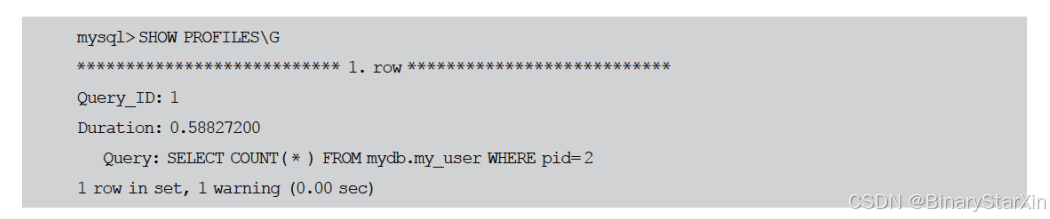
从以上的操作可以看出,执行查询语句时,下面的显示时间 0.59 秒为近似值,而SHOW PROFILES 可以看到它的精确值为 0.58827200。需要注意的是,为了保证数据库更好的性能,在不需要分析 SQL,语句执行时间时,最好利用 SET profiling=0 关闭 profile机制。
4.添加索引
通过步骤2和步骤3的分析可以看出,在 my_user 表百万级数据量时,查询 pid 等于 2的所有员工记录数花费的时间约为0.59秒,此时可以通过为 pid 添加索引来加快查询的速度。具体步骤如下。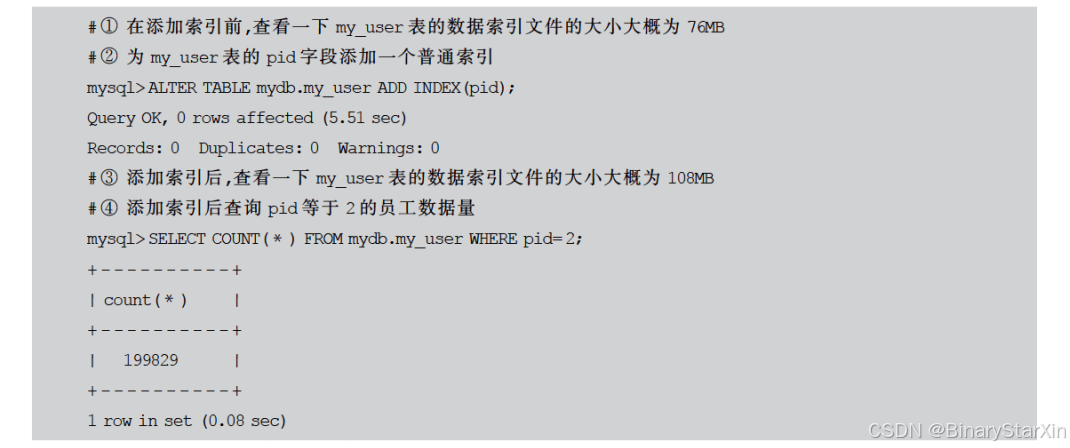
从上述的操作可知,在添加索引前,査询pid等于2的所有员工记录数花费的时间约为0.59 秒,数据索引文件大小大概为 76MB;而添加索引后,相同的 SQL语句查询的时间约为0.08秒,文件大小大概为 108MB。明显可以看出,添加索引后,SQL语句的执行速度提高了7倍多,但是数据索引文件的大小也比未添加索引前增加了大约1.4倍。因此,在实际开发时,要均衡使用索引带来的优势与劣势。
5.LIMIT 分页优化
在实际应用中,影响查询速度的因素除了是否添加索引外,获取记录的页数也会影响查询的效率。例如,若每次获取 my_user 表中 10 条记录,则获取第 8999页、89999 页数据所花费的时间如下所示。
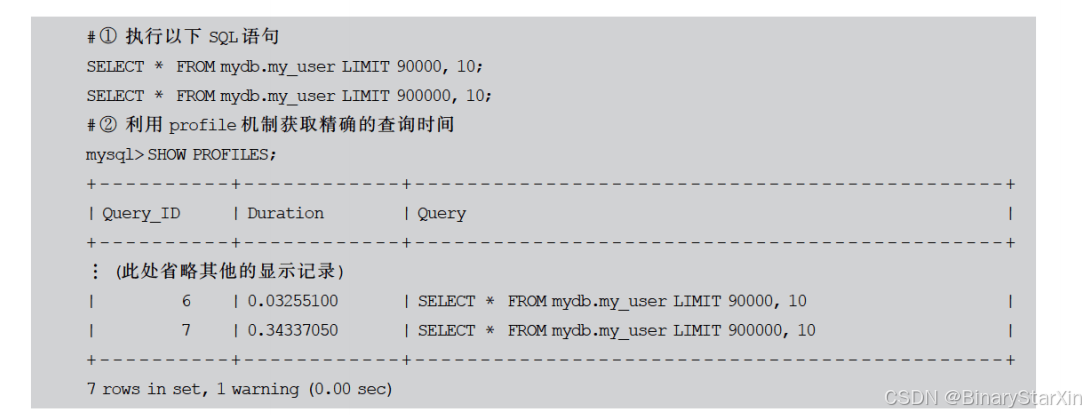
上述操作中,MySQL 在执行 LIMIT 操作时是从第1页(偏离量减 1)获取到指定的页数(如 8999 页),然后再舍弃前面的页中数据,保留指定页数中的数据。因此,当获取的页码越大时,LIMIT 后的偏移量值越大,而偏移量值越大,就会导致查询所花费的时间越长。所以,针对以上的情况,在实际开发中经常会在业务上限制获取数据的页数,如限制获取的页数不能超过 40 页。除此之外,也可以修改査询的语句,使用 WHERE 判断查询的偏移量,让 LIMIT 仅限制获取的数据量。例如,将以上的 SQL语句修改成以下形式,具体如下。
SELECT * FROM mydb.my user WHERE id > 90000 ORDER BY id LIMIT 10;SELECT * FRoM mydb.my user WHERE id > 900000 ORDER BY id LIMIT 10;
然后再利用 SHOW PROFILES 查询执行的精确时间分别为 0.00139575 秒和0.00065400 秒,可以 明显地看出执行时间加快了很多。需要注意的是,通过修改 SQL 语句的方式优化 LIMIT 分页,排序字段最好从1开始,并且能够连续自增,这样才能方便获取数据的信息。因此,在实际中很少使用这种方式,通常会利用在业务上限制页数的方式优化LIMIT 分页。
6.查询缓存
对于数据库优化来说,要想使每次用户请求的数据都能够快速响应,对于数据更新不频繁、数据结构不经常变化的情况可以考虑采用查询缓存。查询缓存指的是 MySQL,服务器提供的一种对 SELECT语句查询结果的缓存机制。下面通过以下语句查看当前 MySQL中缓存的相关设置。
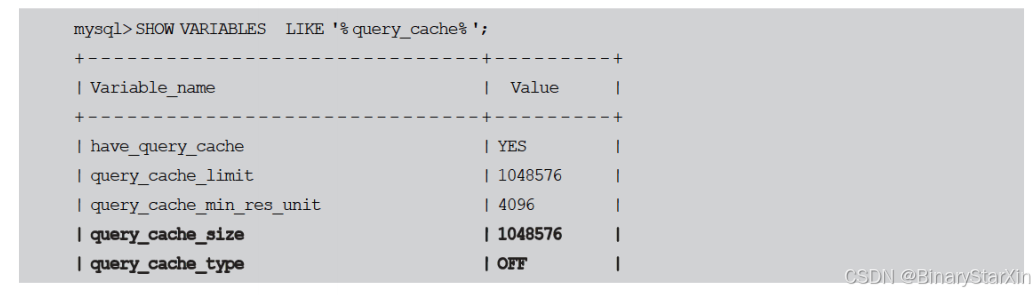
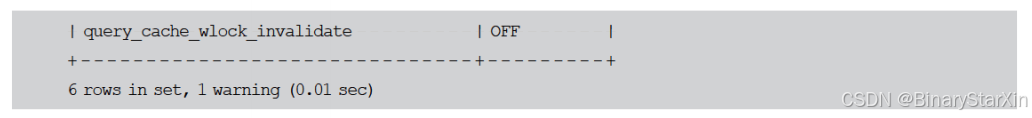
在上述结果中,query_cache_size用于设置査询缓存的内存大小,默认为 1048576 字节(1MB),query_cache_type用于开启査询缓存功能,0(OFF)表示关闭,1(ON)表示开启,2(DEMAN)表示只有 SELECT选项设置为 SQL CACHE才会缓存查询结果,其他变量的含义如表 11-9 所示。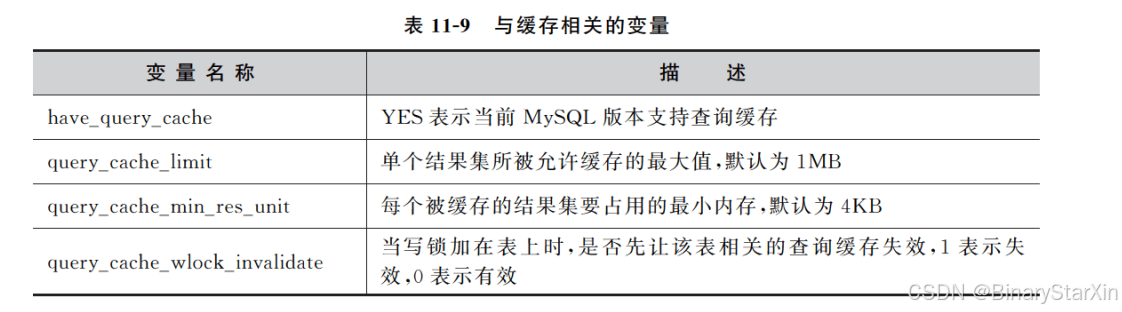
下面以缓存 pid 为3且编号最靠前的两位员工信息为例进行演示,具体步骤如下(1)开启查询缓存。打开 MySQL,的配置文件 my.ini,开启查询缓存,设置缓存大小为64MB。具体如下
query cache type=1
query cache size=67108864
在上述配置中,缓存的大小在设置时需要将 64MB 换算为 67108864 字节。保存后,重启 MySQL 服务器使配置生效。
(2)对比缓存查询结果。按要求执行查询语句,对比前后两次的查询结果。具体如下。
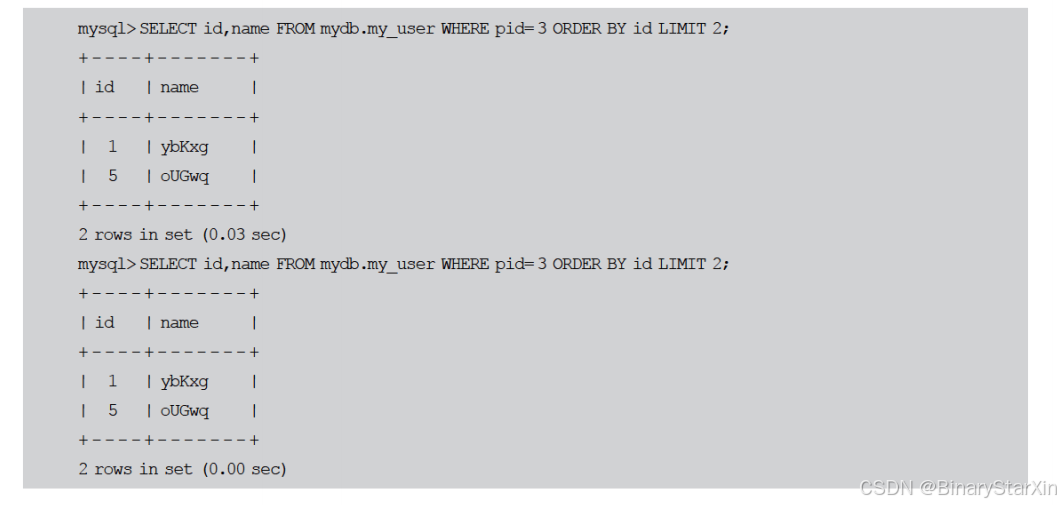
上述操作中,开启查询缓存后,会缓存第1次的查询结果,再次使用相同的 SELECT 语句时,则直接从缓存中返回结果。从以上对比可以看出,第1次查询的时间大约为 0.03 秒。第2次查询的时间大约为0秒,查询速度明显变快。读者也可以开启 profile 机制获取更加精确的时间。
另外,在使用查询缓存时还需要注意以下几点,以免出现与预期不一样的效果,
缓存的数据有变化或数据表的结构有变化时,服务器会自动清空全部缓存数据,使缓存失效。
查询的语句中获取或使用了动态变化的数据则不会生成缓存,如使用now()获取时间,rand()获取随机数等。
select 选项使用了 SQL NO CACHE,对查询的数据不进行缓存。其中,select 选项值 SQL CACHE 和 SQL NO CACHE 在 MySQL 5.7.20 开始已不推荐使用,并将在 MySQL 8.0 中删除,请读者慎重使用。
相同的查询语句,会因语句中多一个或少一个空格,以及大小写问题而分别生成多个缓存,从而造成缓存空间的浪费。
(3)查看缓存使用情况。在开启查询缓存后,可以利用 MySQL 提供的 SHOWSTATUS 监视查询缓存的性能,具体 SQL语句及执行结果如下。
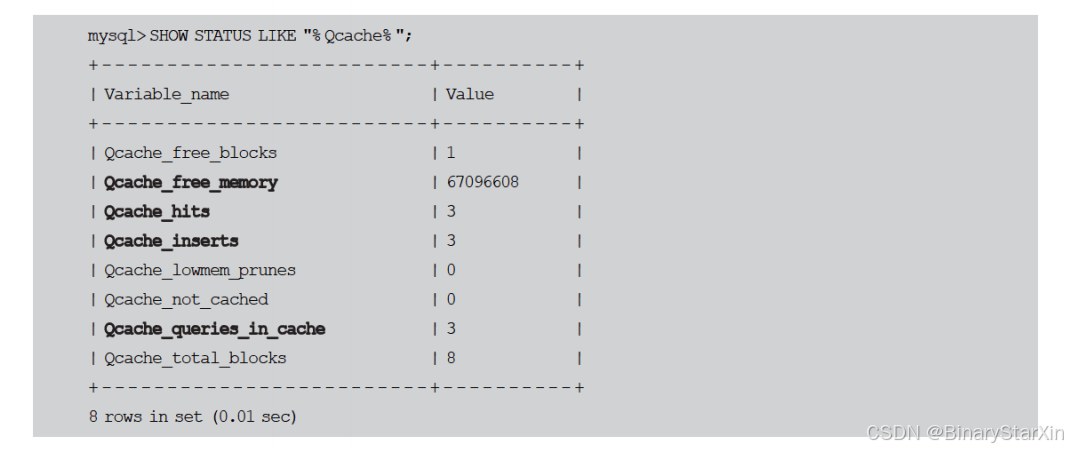
在上述查询结果中,Qchache_free_memory 表示剩余的查询缓存空间大小,Qcachehits 表示缓存的命中次数,Qcache_inserts 表示缓存的插入次数,Qcache_queries_in_cache表示当前缓存的数量。
至此,一个常见的数据库优化已全部完成,在开发中读者还需根据实际的需求均衡、性能的提升和系统资源开销等情况后再确定数据库的优化方案。
11.8 本章小结
本章主要讲解了与数据库优化密切相关的常见存储引擎的特性,索引的应用以及使用原则,锁机制的特点及相关操作。另外还包括数据库优化的常见操作,如分表分区技术、数据碎片的整理、慢查询日志、查询缓存、LIMIT分页优化等。希望通过本章的学习,读者能够掌握数据库优化相关的理论与实际操作,具备解决实际问题的能力。

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 24
 0
- 0


 已为社区贡献8条内容

所有评论(0)