深入浅出数据分析CH13-数据整理
前言
本文是本人研读《深入浅出数据分析》一书后,使用不同工具对书中案例的分析,一是为了加强自己对案例的理解,二是希望能将各种主流工具学以致用,三是将个人的学习思考进行总结量化;
本文所使用的案例数据均从《深入浅出数据分析》的官网中下载,根据自己的学习需求对数据进行了一些处理,不代表官方,官方下载地址如下:examples / Head First Data Analysis · GitLab (oreilly.com)
背景
HeadFirst猎头公司刚从一家停业的竞争对手那搞到了一份客户名单,但整份数据看起来乱糟糟的,根本没法用,他们找你帮他们将这份数据整理好。这份数据表结构如下(仅展示前5条):
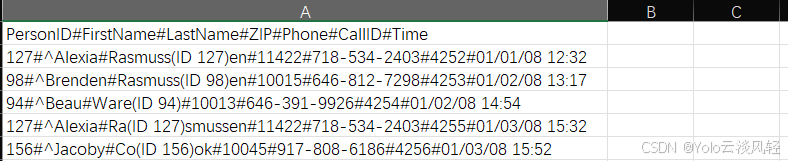
*说明:PersonID是客户编号,FirstName是名字,LastName是姓氏,ZIP是邮编,Phone是手机号,CallID是呼叫编号,Time是呼叫时间,一个手机号可以对应多个呼叫编号。
解决思路
从上图的数据呈现中,我们可以看到所有的文字都挤在一列了,通过观察数据,我们发现以下几条规律:
1.第一行应该是列名,在这一行下面的是客户详细信息记录,每行数据中的属性后都以#结尾,例如PersonID#FitstName# 这明显是两个属性列,应该将其拆分开来,拆分后的数据呈现如下结构:
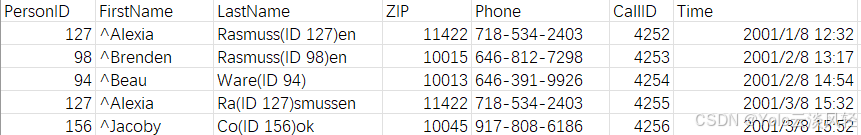
2.观察拆分后的数据特点,我们发现FirstName这一列中每个单元格中名字的开头都有一个^符号,不符合名字的记录习惯,需要将首字符^去除;LastName这一列中不仅包含了姓氏,还包含了他们的ID号,ID号使用括号括起来并且无规律地插入到姓氏中,需要将括号连同里面的ID号去除;其他属性列看起来都没有什么问题了,不需要进行处理。
3.删除不需要的列,查看数据是否有重复值,若有,则去除重复值。
4.数据排序和导出。
工具选择
Excel
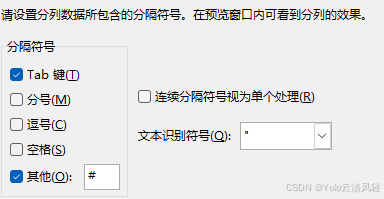
1)使用Excel拆分列。
选中要拆分的列,单击"数据-> 分列"进入分列窗口,使用分隔符进行拆分,设置分隔符为 #,在数据预览部分可以看到最终拆分结果。
2)将FirstName这一列中的^符号去掉。
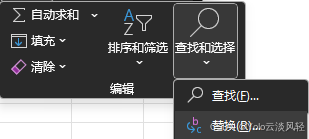
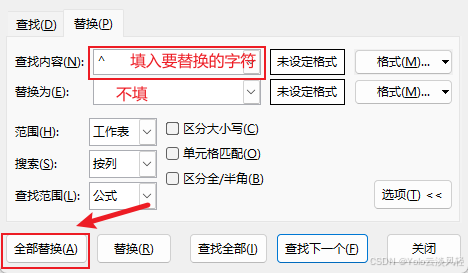
可以使用"开始-> 查找和选择->替换"将 ^替换成没有内容的空字符,点击全部替换即可。也可以创建一个空列后使用公式 =SUBTITUTE(选中单元格,"^",""),先替换掉第一个姓名中的符号,再使用下拉功能将所有姓名中的^符号去除。
3)将LastName这一列中的括号连同里面的ID号去除。
可以使用FIND,LEFT,RIGHT,CONCATE等文本处理公式进行组合嵌套,但太过麻烦,因此本次将采用其他工具处理这一列。
4)删除多于列,查看重复值,去除重复值。
使用其他工具完成。
5)数据排序。
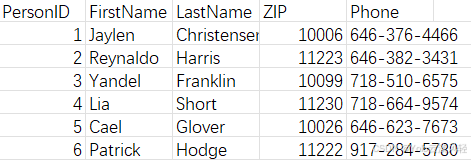
使用其他工具处理好的数据,将数据进行排序,效果如下。
Python
1)导入数据并按照分隔符#拆分数据,代码详见附录。
2)将FirstName这一列中的^符号去掉,代码详见附录。
3)将LastName这一列中的括号连同里面的ID号去除,代码详见附录。
4) 删除多余列,去除重复数据记录,数据排序,查看数据。
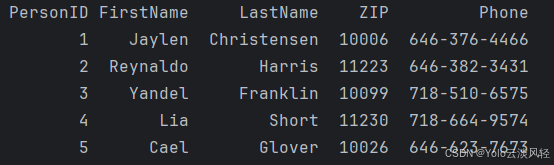
5) 导出数据,效果如下。
R
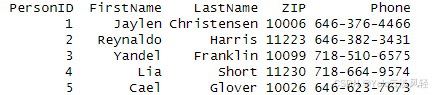
代码详见附录。效果如下:
工具总结
Excel
可以完成分列、简单替换、可以快速查重、也可以使用unique函数对单列去重。
Python
使用pandas库中的DataFrame和Series结构,可以实现大部分的数据处理需求,实例化为一个DataFrame对象为df,可以使用中提供的df['column_name']用于列选择,df[0:5]用于行选择,df.drop_duplicates()进行去重,isnull()、notnull()、dropna()、fillna()可用于处理缺失值,str.contains(),str.extract(),str.replace()等方法可以结合正则表达式处理字符串。
R
使用read.csv()读入的结构为DataFrame,可以对其进行筛选、排序、统计计算。实例化为一个DataFrame对象为df,可以使用R基础包中提供的df$column用于列选择,df[df$column=values]和df[row0:row5,]用于行选择,df$col=NULL删除列,unique(df)进行去重,df$col=sub("\\(.*\\)","",df$col)正则表达式处理字符串。
全文总结
本文使用了三种工具进行数据处理,完成了常见的分列、去除多余字符、去重、排序工作,还有一些常见的缺失值、异常值等处理本文没有进行展示,因为本文使用的数据原始状况不包含异常值和缺失值。具体的数据处理工作应该根据数据原始状况来决定。
附录
Python代码
# 导入必要的库,pandas用于数据读取和常规处理,re用于正则表达式的调用
import pandas as pd
import re

# 导入数据的同时拆分列,读取进来的数据为DataFrame对象df,可以使用此对象的所有方法,如df.dropna(), df.head(5)
df=pd.read_csv("F:/hfda/hfda_ch13_raw_data.csv",sep='#')
print(df.head(5))#查看前五条数据

# 去除FirstName中的^,不需要使用正则表达式
df['FirstName']=df['FirstName'].str.replace('^','')

# -------------------
# 将LastName这一列中的括号连同里面的ID号去除,需要使用正则表达式
# 1.定义一个正则表达式模式函数,使用反斜杠\来转义两个括号字符, .*? 代表任意字符,替换为空字符""
def rm_pattern(text):
    if isinstance(text,str):
        return re.sub(r'\(.*?\)','',text)
    else:
        return text

# 2.调用去除模式函数
df['LastName']=df['LastName'].apply(rm_pattern)

# -----------------
# 删除不需要的列CallID、Time
del df['CallID']
del df['Time']

# ------------------
# 查重,打印查重情况,有重复的返回True,不重复的返回False
print(df.duplicated()) #对所有行进行数据重复检查,只会对比不同行之间的整体重复情况,不会逐个对比单列中的数据重复情况

df=df.drop_duplicates() # 去除重复的数据记录
df=df.sort_values(by='PersonID') # 数据按照PersonID降序
print(df) #查看数据

#导出数据,起一个新文件名,将数据写入,不输出索引号
df.to_csv('F:/hfda/hfda_ch13_new_data.csv',index=False)
R代码
#导入必要的包,tidyr用于数据常规处理
library(tidyr)

# 导入数据并设置分隔符为#拆分列
df=read.csv("F:/hfda/hfda_ch13_raw_data.csv",sep="#")

# 去除FirstName中的^
#  需要使用反斜杠\\来转义字符^,替换为空字符""
df$FirstName=sub("\\^","",df$FirstName)
head(df$FirstName) # 查看前五条数据

# 将LastName这一列中的括号连同里面的ID号去除
# 需要使用反斜杠\\来转义两个括号字符, .* 表示任意字符,替换为空字符""
df$LastName=sub("\\(.*\\)","",df$LastName)

#删除不需要的列CallID、Time
df$CallID=NULL
df$Time=NULL

#将数据记录进行去重,提取唯一值
df=unique(df)
df=df[order(df$PersonID),] # 数据按照PersonID排序
head(df) # 查看前五条数据,确认数据正确性

# 导出数据,起一个新文件名,将数据写入,不输出索引号
write.csv(df,"F:/hfda/hfda_ch13_new_data.csv",row.names = FALSE)

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 38
 0
- 0


 已为社区贡献3条内容

所有评论(0)