2021年华为杯数学建模竞赛A题论文和代码
相关矩阵组的低复杂度计算和存储建模
摘要
相关矩阵组在无线通信、雷达、图像/视频处理等领域都有广泛的应用,其特点在于数据之间具有较强的相关性。数据维数的不断增长,使得充分挖掘矩阵间关联性以实现低复杂度的计算和存储具有十分重要的价值和意义。
对于问题一,本文从每个子矩阵的自相关性出发,基于随机SVD分解方法对目标矩阵降维,并使用基于双对角化和QR分解的SVD 分解计算V。之后本文基于AOR迭代算法,从子矩阵自身的相关性出发,训练出合适的迭代因子,使得计算W时矩阵求逆的迭代次数大大减少。基于 Strassen算法,对算法中涉及的矩阵运算进行分治计算,从而进一步降低计算复杂度。最后,本文从矩阵行块间的相关性出发,构建相邻子矩阵的互相关函数模型,建立互相关函数与插值算法的关系,给出最优插值系数。在矩阵V和矩阵W的计算中,理论上可以减少约40%的计算量。
对于问题二,本文提出一种基于SVD 分解的相关矩阵组压缩算法,通过对矩阵重新排列、合并、SVD分解并提取最大奇异值对应的列向量,可以实现对矩阵组数据的有效压缩。本文基于SVD分解对矩阵间相关性进行分析,验证了该压缩/解压缩算法的可行性。本文进一步推导对这种方法的存储复杂度、压缩复杂度以及解压复杂度,并建立多目标优化模型,求解最优的压缩参数。最优解的压缩率可达0.3867,且具有较低的压缩、解压复杂度。
对于问题三,本文提出了一种联合优化策略,将问题一的中间变量存储复杂度和插值存储复杂度纳入到优化方案当中进行讨论。同时我们将迭代算法的结构调整为逐元素运算的形式,避免了部分矩阵存储的复杂度。
关键字:相关矩阵组 SVD分解 AOR 迭代 QR分解
1. 问题重述
1.1 引言
计算机视觉、相控阵雷达、声呐、射电天文、无线通信等领域的信号通常呈现为矩阵的形式,这一系列的矩阵间通常在某些维度存在一定的关联性,因此数学上可用相关矩阵组表示。例如,视频信号中的单帧图像可视为一个矩阵,连续的多帧图像组成了相关矩阵组,而相邻图像帧或图像帧内像素间的关联性则反映在矩阵间的相关性上。随着成像传感器数量/雷达阵列/通信阵列的持续扩大,常规处理算法对计算和存储的需求成倍增长,从而对处理器件或算法的实现成本和功耗提出了巨大的挑战。因此,充分挖掘矩阵间关联性,以实现低复杂度的计算和存储,具有十分重要的价值和意义。
1.2问题的提出
1.2.1问题一:相关矩阵组的低复杂度计算
本问题明确提到利用矩阵相关性在满足建模精度的前提下,尽可能减少计算复杂度。因此在建模 v=f₁(H)和 W=f2V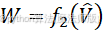 时首先应当考虑的时建模精度的问题,也就是SVD 分解的精度和矩阵求逆运算的精度。目前有许多数学上的方法提供了迭代求解 SVD算法和矩阵求逆的可能性,这些算法往往采用迭代的形式,可以根据精度要求调节迭代次数。题目要求的建模精度为0.99,并不是很高,迭代算法的应用能够大大减少运算的复杂度。
此外,可以从矩阵相关性的角度考虑减少运算,尽量避免遍历计算每个矩阵。因为同一个行块的矩阵具有较高的相关性,可以通过模式识别或者插值的算法根据已经计算的矩阵估计出剩余部分矩阵,但是这样的估计显然是误差较大的,因为矩阵间除了有相关性还包括了随机性,我们只能估计出目标子矩阵和其他子矩阵相关的成分,但是无法估计出目标子矩阵的随机特性,这样的随机特性满足一个特定的分布,如果矩阵间的相关性较高,仍然可以在满足精度的前提下进行插值,而判断哪些矩阵满足插值的条件,以及选择合适的插值方式成为本小题的难点。
本题还给出了一种思路:从模式识别的角度,出发拟合 V=f₁H 和 w=
 f₂(V)的关系,但是对6组数据进行分析,我们发现行块与行块之间是相互独立的,并且由于数据量不足,我们很难建立一个合适的模型来拟合矩阵的之间的相关性。
从矩阵相关性的角度,我们发现相邻子矩阵之间的相关性最强,因此我们考虑从建立子矩阵互相关函数的角度出发,找到 Vj,k 和 wⱼk
 与 Hⱼk
 互相关矩阵
R,k 之间的关系,从而减少 V加水
 和 w₃,k
 的计算数量。
1.2.2问题二:相关矩阵组的低复杂度存储
本题要求基于给定的所有矩阵数据H和W,分析各自数据间的关联性,分别设计相应的压缩模型. P₁,P₂⋅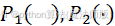 和解压缩模型。 G₁⋅,G₂⋅,
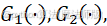 在满足误差条件 Errf≤-30dB,Errw≤-30dB
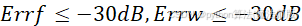 的情况下,使得存储复杂度、压缩与解压缩的计算复杂度最低。
题目中所给的矩阵阵列可以与视频流进行类比。每一个矩阵都相当于视频中的一帧图像,每帧内部存在一定的相关性,而相同j下标、不同k下标的矩阵之间的相关性则可以理解为帧之间的相关性。因此,可以从已有图像、视频压缩算法中得到一定的启发。但在考察各种变换域算法后,我们发现传统的FFT、DCT 变换等方法对处理本题的数据并不具有优越性。因此,如何利用相关特性,选择合适的方式去除数据中的冗余信息是本题的难点。此外,很容易想到,问题一中分析得到的相关性,也可以应用于问题二中,即低复杂度计算的方法同样可以应用于低复杂度存储。通过将行块中的矩阵合并并进行SVD分解,我们发现构造的新矩阵具有较高的条件数,即矩阵的信息主要集中在最前面的几个奇异值中。通过舍弃对结果恢复影响不大的奇异值,我们可以实现对相关矩阵组的有效压缩。
在完成压缩方法的框架搭建后,本题转化为一个多目标优化问题。由于题目要求两个建模优化目标(存储复杂度,压缩与解压缩的计算复杂度)的优先级相同,这就是希望我们使用对多目标加权的方法,将多目标优化转化为单目标优化。
1.2.3问题三:相关矩阵组的低复杂度计算和存储
利用问题一中的方案计算V矩阵时,很多内部变量需要进行存储,比如SVD 分解中的QR迭代过程需要为迭代中的中间变量开辟存储空间,SVD 分解中求Q矩阵也需要存储复杂度,但是由于每次迭代的结果会覆盖上次迭代的结果,所以消耗的存储复杂度不会随着迭代次数的增加而增加,因此很多中间变量存储简单的传统算法将重新进行考虑,这意味着我们需要考虑算法的存储复杂度,结合计算复杂度进行联合优化。
W矩阵之前也需要对J个V矩阵进行合并求逆,需要的存储复杂度为64NLJ,AOR 迭代中,每次迭代的结果也要进行存储。但是由于AOR的中间变量的维度只有64NL,因此将W矩阵的计算拆分成维度 N×L的子矩阵运算具有较少的存储复杂度。
问题三最终可以转换成存储复杂度和计算复杂度联合优化的问题,甚至需
要重新考虑一些存储复杂度低的算法,也可以从算法结构的角度进行优化,将迭代算法写成逐个元素优化的算法结构,尽可能在计算复杂度不变的而基础上减少存储复杂度。
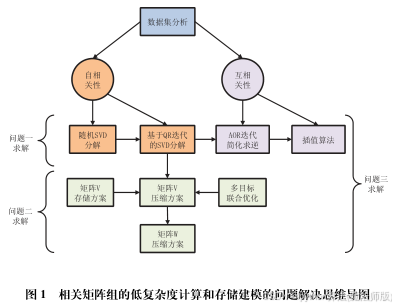
1.3 思维导图
2. 模型假设
·对于同一数据集的同一行块中的矩阵满足相同分布,具有相同的统计特性:
·不同数据集之间、同一数据集不同行块之间的分布彼此独立;
·同一个行块内的矩阵之间具有相关性,且矩阵间的距离越近,其相关性越强。
3. 符号说明
|
符号 |
意义 |
|
H |
相关矩阵组 |
|
Hj. k |
相关矩阵组中第j行k列的矩阵 |
|
M |
相关矩阵组中每个矩阵的行数 |
|
N |
相关矩阵组中每个矩阵的列数 |
|
J |
相关矩阵组的行数 |
|
K |
相关矩阵组的列数 |
|
pmin |
W的最低建模精度 |
|
ert |
H的压缩误差 |
|
errw |
W的压缩误差 |
|
v |
右奇异矩阵 |
|
SVD |
奇异值分解 |
|
SOR |
超松弛 |
|
AOR |
加速超松弛 |
4. 问题一求解
4.1 子问题1——矩阵V 的近似低复杂度计算
4.1.1 基于随机SVD算法的目标矩阵降维
我们首先考虑对某个一般的复数矩阵A∈Cⁿˣᵐ'进行SVD分解,其中n≥m,目前采用较多的算法有基于 Household 变换的 SVD 分解、基于 Givens变换和 Jacobi旋转的SVD算法以及基于 Golub- Kahan双对角化的SVD算法。通过考察这一系列算法,我们得出以下结论:
· Household变换的矩阵维度取决于n,但是本题数据集中的n =64较大,乘法运算次数过多。
· Givens变换每次相乘的是一个近似对角阵,乘法复杂度较小,但是 Givens变换的角度θ求解需要消耗大量计算复杂度,特别地,对于复数矩阵的 Givens 变换,需要在实数变换的 Givens矩阵基础上补偿辅角α,复杂度也较高。
·如果精度要求过高或者矩阵维度过大,Golub-Kahan算法则无法满足要求,无法达到题目要求的 ρmin=minρl,jkV≥0.99,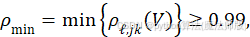 故无法采用。
ρl,j,kV=|Vl,jμ,Vi,k|2|Vi,3⋆|2||T(,j∉||2,l=1,,L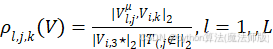 (1)
因此我们最终考虑先通过降维的算法,在不改变奇异值的前提下,将复数矩阵A∈Cⁿˣᵐ降维得到B∈Cᵐˣᵐ。之后,采用基于双对角化和QR 分解的迭代算法求解B的SVD分解,通过控制迭代结束的误差条件,可以有效控制计算复杂度。由于求解Wₖ的过程中会引入一定的误差,因此该问题可以转化为多目标规划问题。具体的优化方案,我们会在问题一求解的最后进行说明。
B 矩阵的构建主要通过基于随机SVD的SVD 分解算法实现,对于本题的任一矩阵 Hjk<CM对N,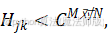 令 A=HjxH⊂CN×M。
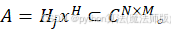 该算法主要分为两步:第一步构造 m 个标准正交列向量矩阵 Q⊂CN×17;
 第二步计算维度为 mxm的矩阵 B=Q''A=Q''Hⱼₖ
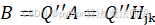 的SVD 分解:
B=USVi/ (2)
对B求共轭转置,并右乘QH可得:
BiiQII=HjkQQI=YSUμQ'II=VSQUH≈Hjk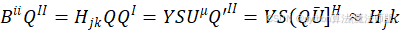 (3)
因此当 |H1k-HjkQQI|<c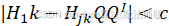 时,其中e为满足条件的某一小量,可以认为 QU≈V,
 其中V表示矩阵H的右奇异向量。如果对每一个矩阵 Hjk.j=
 1,……,J,k=1,……,K 取右奇异向量的前L列, 可得 Vj,k。

8
上述正交矩阵Q可以使用以下迭代算法构造。对于实际数据,由于 M=4, 实际计算得到迭代4次时得到的Q最能满足需求。
Algorithm1基于随机SVD的矩阵降维Q=randSVD(A,c)
1: 输入: A∈Cmx⋅mn),c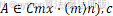
2: 初始化:
3:Q'=[1
4: i=0
5:迭代过程:
6:whlϵ|A-λQQᵘcd。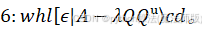
7: i=i+1
8:抽取1个维度为n的高斯随机矢量ω³
9:y⁴=4△
10;qⁱ=I-Q⁻¹Q⁻¹ⁿyˡ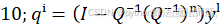
I1:q1=q/|q|2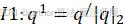
12;Q=Q⁻¹q¹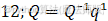
13: end while
14: 输出:Q s. t. A≈QQ"A
4.1.2 基于双对角化和QR分解的SVD分解算法
对于公式2中的奇异值分解,采用基于双对角化和QR分解的SVD分解来实现。通过控制误差e,可以尽可能地减小迭代次数。SVD分解算法如下。
Algorithm2 SVD 分解(U,S,V)=svd(B,ε)
1: 输入: B∈CM/-NIIN),c.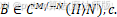
2: 初始化:
1:S=B''
4: U=IMxM
5: V=INxN
6:迭代过程:
7: while cart<c do
B:Q.S=qʳSⁱ,v=v⋅Q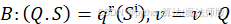
9;Q.S=qrS'ᵘ,V=V⋅Q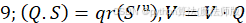
10: 取S对角线上方的所有元素: e= tria(S,1)

12: end while
13: 修复S的符号:
14: for n=1: Ndo
15: snn=S(n,n), S(n,n)= abs(snn)
16: if snn<0
17: U(:,n)= -U(:,n)
18: endif
19: endfor
20: 输出:U. S,V s. f. B =USVE
注意到X中包含一次加法运算,所以需要4次加法运算。
使用I(n),M(n)和A(n)分别表示n×n矩阵求逆,乘法和加法需要的次数。由式(11)可以得到
I(2n)=2I(n)+6M(n)+4A(n) (13)
n=2ᵏ 时,上式可以转化为
I2ᵏ=2I2ᵏ⁻¹+6M2ᵏ⁻¹+4A2ᵏ⁻¹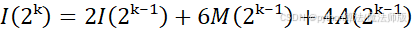
=2²I2ᵏ⁻²+6M2ᵏ⁻¹+2M2ᵏ⁻²+4(A2ᵏ⁻¹+2A2ᵏ⁻²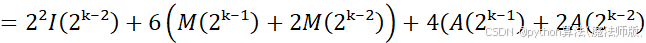
日
(14)
通过对矩阵乘法的复杂度分析可知,Strassen 算法下 IIπ=nbex27,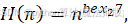 则需要 674-217-2
 次复数乘法, k2ᵏ⁺¹
 次复数加法,此时矩阵求逆的计算复杂度可以表示为
I2k=2ϵI1+67k-2k7-2×14+k2k+1×2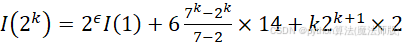
=2t×33+67k-2k7-2×14+k2k+1×2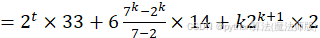 (15)
=33n+815nlog27-n+4nlog2n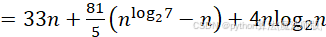
特别的,对于n=4和n=8时的矩阵乘法和矩阵求逆,使用 Strassen算法和传统算法下的矩阵运算计算复杂度比较如表1所示。
事实上,当阶数n较小时,Strassen算法的计算复杂度已经与传统算法相差不大,而Strassen算法由于使用了迭代,所以时间复杂度很高,因此可以设置迭代停止条件提前终止迭代从而得到更小的时间复杂度。到2020年12月为止,拥有最低逼近计算复杂度 On²³⁷²⁵⁵⁸ 的矩阵乘法算法由 Josh Alman 和 Virginia Vassilevska Williams 提出[9],然而这种方法以及其他基于 Strassen的相似优化仅在极大规模数据下具有优势,并没有被实际应用。对于本题中的数据集大小,使用 Strassen算法已经完全足够。
12
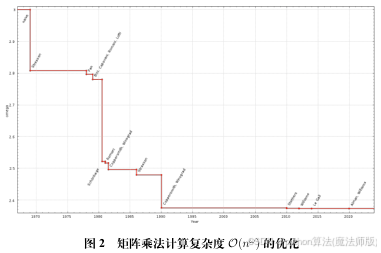
表1 n=4,8,Strassen 算法与传统算法下矩阵乘法和求逆的计算复杂度比较
|
矩阵的阶数n |
4 |
8 | |||
|
矩阵乘法 |
算法 |
Strassen |
Simple |
Strassen |
Simple |
|
复数加法 |
144 |
48 |
864 |
448 | |
|
复数乘法 |
49 |
64 |
343 |
512 | |
|
计算复杂度 |
974 |
992 |
6530 |
8064 | |
|
矩阵求逆 |
算法 |
Strassen | |||
|
复数加法 |
16 |
48 | |||
|
复数乘法 |
54 |
402 | |||
|
求逆 |
4 |
8 | |||
|
计算复杂度 |
920 |
5988 | |||
4.1.5右奇异向量相关性分析
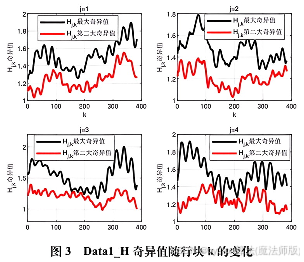
通过对数据集中的子矩阵进行简单分析,我们可以发现,这些子矩阵的奇异值随着行块数周期性波动,因此我们推测,行子矩阵之间的相关性可以用奇异值或者特征值之间的函数关系加以刻画,矩阵的 SVD 分解将矩阵的相关信息集中到对角线上的奇异值上,右奇异向量中继承了矩阵H的部分相关性和随
机性。事实上,根据我们对子矩阵 H₂. 自相关性的分析,所有的自相关子矩阵 Rj,k=H,kHjkJI
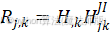 相同位置的元素具有相同的均值和方差,并且距离对角线越远的元素越小,说明 Hⱼk
 行与行之间的自相关性随着行与行距离的增大而减小,而且自相关性衰减的速度近似为指数衰减。 Hⱼc
 的性质比较像如下的相关信道矩阵的性质,因此我们采用该相关信道模型对子矩阵 H₂x
 进行建模。
相关信道模型中,相关矩阵中的元素表示为:
R,ik=ζcc92-t,i≤k,Rrki,i>k,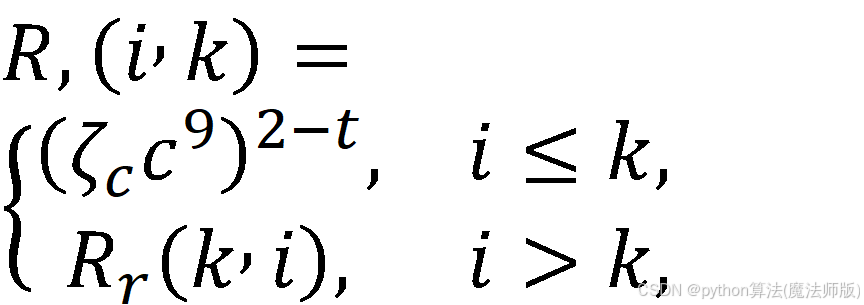
Rιik=ζtc3θl-t,i≤k,Ricki,i>k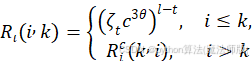 (16)
其中R(i,k)是矩阵R 中的第i行,第k列的元素,ζ表示天线间的相关程度。θ是相位常数,仿真时设定为 π2。
相关信道矩阵可以表示为:
I,cdative=Rr12HrtwplcgiRi12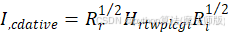 (17)
假设瑞利信道矩阵元素用h₂ⱼ表示,相关信道的 Gram矩阵用( Gr1atrrc 表示,其中每个元素 Gᵢⱼ
 可以表示为:
|
|
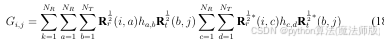
当且仅当a=c且b=d时,瑞利信道元素才满足相关性,因此:
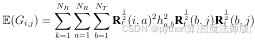
=∑t=1Nn∑b=1Nnka,l2Rr12bjRl12bj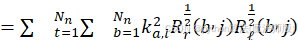 (19)
=NHσ2ζt1-3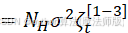
观察到相关信道矩阵元素的期望于接收端相关系数无关,只与发射端相关系数有关,并且,随着元素的位置远离对角线,元素的均值会随着指数衰减,符合数据集中子矩阵 Hⱼ 的性质,因此可以用相关信道模型描述。
下面考虑左奇异向量和右奇异向量之间的相关性,但是从我们对数据集的测试结果看,右奇异向量包含不可预测的随机性,即使可以通过插值实现估计,插值的算法如下:
Nl,jk=λi,jtVl3k-1+(1-λ1j,k)V1jλ+1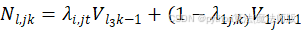 (20)
一般来说λtdx的最优值收敛到0.5,但是即使可以调节线性插值的系数,还是会存在部分预测结果与标准数据集之间的差距小于0.995,因此,我们提出如下方法,用于识别不同的H矩阵数据集中可插值的右奇异向量,其他的右奇异向量只能通过直接求解的方式计算。
|
假设子矩阵HJ,A的SVD分解对应的右奇异向量的前两列为1 V1-L,kx,1d, |

|
|
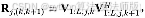
Aj,k=Uj,k⋅Sjk0⋅x1,jkHv2,jkH⋯⋅v1,k+1v2,jk+1⋯H,Sj,k+1HI0μβ,Tj'4异值。
|
可以看到公式21描述右奇异向量相关性的变量集中分布在对角线上,因此我们提取对角线上的元素分析相邻右奇异向量之间的相关性,由于只需要前两列的右奇异向量,因此我们只截取相邻互相关矩阵对角线上的前两个元素。由于子矩阵的奇异值可以通过拟合得到,因此很容易可以得到相邻右奇异向量的相关系数 也就是后文子矩阵的自相关性的定量化数值。得到估计的相邻右奇异向量的相关系数后,我们绘制数据集 V₁₃A的互相关系数与估计值进行对比,拟合出两者的关系,这样我们就得到了推断右奇异向量互相关性的依据,借助右奇异向量互相关性我们就可以判断出可以进行插值的向量 |
|
|
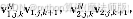
以及相关性较差的向量,调整我们之前的算法。
通过对数据集的观察,我们发现不同的数据集呈现不同的特征,其中数据互相关性最好的是 Data3 H数据集和Data3 H,基本上所有的子矩阵互相关性都达到了0.995 以上,这说明用相邻相邻插值的方式完全可以保证估计精度在0.995以上,这样的数据集理论上最大可以减少一般的计算量。而数据相关性最差的数据集是Data3 H数据集,子矩阵的随机性较大,计算量减少的比例较少。
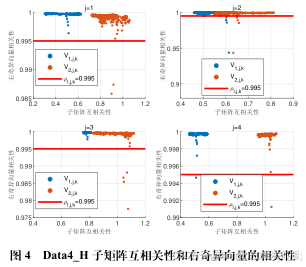
由于数据集的数目不足,想要通过模型训练实现精确地找到所有弱相关性的矩阵几乎是不可能的。因此我们采用的策略是划定一个子矩阵互相关性变化的区间,在这个区间内,右奇异向量必然可以用相邻位置的右奇异向量插值得到。子矩阵互相关性在这个区间外的向量则有一定的概率是相关性弱的矩阵,为了让最小建模估计精度大于0.99,这些矩阵只能全部计算。如图4,Data4 H数据集中相关性较小的点基本都分布在子矩阵互相关性为0.5和1附近,可以通过计算子矩阵互相关性,推测右奇异向量的相关性。
因此每个数据集计算右奇异向量的次数取决于数据集本身的互相关性。假设一个数据集“好的”子矩阵数目为P,“坏的”子矩阵数目为1-P,由于好的矩阵可以通过插值的方式减少一半的计算量,那么一共需要计算的 SVD 分解的次数为 1-P2, 下面给出6个数据集计算SVD分解的次数:
|
不同数据集 SVD 分解次数 计算量减少比例 | ||
|
Datal _H |
795 |
48.29% |
|
Data2_H |
824 |
46.37% |
|
Data3_H |
896 |
41.72% |
|
Data4_H |
769 |
49.93% |
|
Data5_H |
771 |
49.82% |
|
Data6_H |
781 |
49.19% |
|
不考虑插值 |
1536 |
0% |
表2 不同算法的迭代式半径
由于右奇异向量引入的误差也会影响到之后矩阵求逆部分的误差,因此是否将误差阈值设置为0.995还有待研究,但是可以肯定的是插值的方式可以一定程度上减少SVD的计算次数。
代码
function [V, rho V err,Q,V real,B, loopcount] = random svd(A, iter)
%% calculate Q
[m,n]- size(A);
Q=[];
L=2;
for t=1: iter
w-( randin(n,1)+1j* randn(n,1))* sqrt(0.5)*0.01;
y=A*w;
if t==1
q= eye(m)*y;
else
q-( eye(m)-Q*Q')*y;
end
q norm= norm(q,2);
qn=q./q norm;
Q-[Q qn];
end
%% B=QA SVD
B=Q'*A;
[U,~,~, loopcount] - svdsim(B,0.001);
[~,~,v real]- svds(A',2);
QU=Q*U;
v= qu(:,1:2);
rho V err= zeros(L,1);
for l=1:L
Vl=v(:,l);
V reall=v real(:,l);
rho V err(l)= norm( Vl'*V reall)/ norm( Vl)/ norm(V reall);
end
end
1.2 基于 QR 分解和双对角化的 SVD分解
function [u,s,v, loopcount] - svdsim(a, tol)
if ~ exist(' tol',' var')
tol= eps*1024;
end
% reserve space in advance
sizea= size(a);
loopmax=100* max( sizea);
loopcount=0;
% or use Bidiag(A) to initialize U, S, and V u= eye( sizea(1)};
s=a';
v= eye( sizea(2)};
Err= realmax;
while Err> tol && loopcount< loopmax
% log10([ Err tol loopcount loopmax]); pause
[q,s]= qr(s'); u-u*q;
[q,s]= qr(s'); v-v*q;
% exit when we get " close"
e= triu(s,1);
E= norm(e(:));
F= norm( diag(s));
if F==0, F=1; end
Err=E/F;
loopcount= loopcount+1;
end
% [ Err/ tol loopcount/ loopmax]
% fix the signs in S
ss= diag(s);
s= zeros( sizea);
for n=1: length( ss)
88n= ss(n);
s(n,n)- abs( ssn);
if ssn<0
u(:,n)--u(:,n);
end
end
if nargout<=1
u- diag(s);
end
return
1.3 AOR迭代算法
function x = AOR(A,y,k,w,r)
E== tril(A,-1);
F== triu(A,1);
D= diag( diag(A)};
U= inv(D=r*E);
N2=(1-w)*D+(w-r)*E+w*F;
x=1/1.01*y;
for i=1: size(y,2)
for j=1:k
x(:,i)-U*N2*x(:,i)+w*U*y(:,i);
end
end
end
1.4 基于SVD分解的压缩和解压缩
function [ comp, loopcount, err H] = HC(H,M,N,J,K, snap, cut, thre)% compression
comp - cell(J, ceil(K/ snap));
loopcount - zeros(J, ceil(K/ snap));
for j = 1:J
x - zeros(M*N, snap);
count - 0; kk- 0;
for k = 1:K
HH = H(:,:,j,k);
kk- kk+ 1;
X(:, kk) = reshape(HH,[M*N 1] );
if kk-- snap|| k -- K
count = count + 1;
[U,S,V, Ic] = svdsim(X, thre);
%[U,S,V] = svd(X);
comp{j, count}. u - u(:,1: cut);
comp{j, count}. S - diag(S(1: cut,1: cut)};
comp{j, count}. v = v(:,1: cut);
loopcount(j, count) = lc;%|F|瑞| vd.冯·琥浜||酒|灏|
kk- 0;
end
end
end
% decompression
H hat = zeros( size(H));
for j - 1:J
for count - 1: size( comp,2)
X re - comp{j, count}. U * diag( comp{j, count}. S) *
comp{j, count}. v';
for kk - 1: snap
H hat(:,:,j,( count-1)* snap+ kk) = reshape(X re(:, kk),[M N]);
end
end
end
% entropy calculation
E = zeros(J,K);
F = zeros(J,K);
for j = 1:J
for k = 1:K
HH = H(:,:,j,k);
H re - H hat(:,:,j,k);
E(j,k) - norm(H re=HH,' fro')^2;
F(j,k) - norm(HH,' fro')^2;
end
end
err H = 10*log10( mean(E,' all')/ mean(F,' all'));

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 15
 0
- 0


 已为社区贡献17条内容

所有评论(0)