iMeta | 吴松锋/李京丽/朱云平-联合开发在线蛋白质组数据分析平台
点击蓝字 关注我们
BioLadder:专注于蛋白质组学数据分析的生物信息学平台
iMeta主页:http://www.imeta.science
方法论文
● 期刊:iMeta [IF 23.7]
● 原文链接DOI: https://doi.org/10.1002/imt2.215
● 2024年6月20日,北京青莲百奥生物科技有限公司和国家蛋白质科学中心(北京)团队在iMeta在线联合发表了题为 “BioLadder: A bioinformatic platform primarily focused on proteomic data analysis” 的文章。
● 本研究开发了一个在线蛋白质组数据分析平台BioLadder(https://www.bioladder.cn/),包括3类实验数据分析模块和4类常规数据分析模块。它允许用户轻松高效地进行各种蛋白质组学数据分析。
● 第一作者:张宇鹏、杨春媛
● 通讯作者:朱云平(zhuyunping@gmail.com)、李京丽(lijingli@qinglianbio.com)、吴松锋(wusf897@gmail.com)
● 合作作者:王锦昊、王立新、赵焱、孙龙钦、孙薇
● 主要单位:北京青莲百奥生物科技有限公司;国家蛋白质科学中心(北京),北京蛋白质组学研究中心,北京生命组学研究所
亮 点
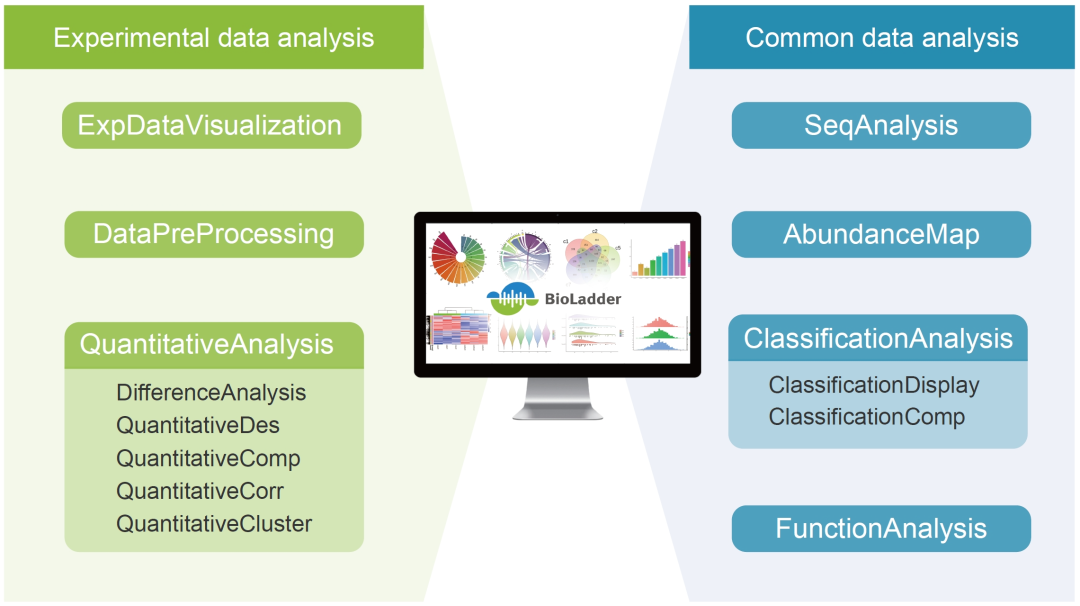
● BioLadder包括3类实验数据分析模块和4类常规数据分析模块;
● BioLadder允许轻松高效地进行各种蛋白质组学数据分析;
● BioLadder提供了4种辅助方式,帮助用户快速准确地使用相关分析模块。
摘 要
BioLadder(https://www.bioladder.cn/)是一个为蛋白质组学研究设计的在线数据分析平台,包括3类实验数据分析模块和4类常规数据分析模块。它允许用户轻松高效地进行各种蛋白质组学数据分析。此外,大多数模块也可以用于其他组学数据的分析。为了便于用户体验,我们精心设计了4种辅助方式,帮助用户快速准确地使用相关分析模块。
视频解读
Bilibili:https://www.bilibili.com/video/BV1xy411q7Ci/
Youtube:https://youtu.be/VciXv84LjHc
中文翻译、PPT、中/英文视频解读等扩展资料下载
请访问期刊官网:http://www.imeta.science/
全文解读
引 言
近年来,多组学研究的蓬勃发展产生了大量的数据,深入的数据分析和挖掘已成为生命科学研究的重要特征。生物信息学已成为最常用的研究工具之一,在生命科学研究中发挥着关键作用。
然而,生物信息学研究需要编程培训,这可能不是那些专注于科学问题的研究人员的强项。此外,即使一些研究人员具备编码技能,他们仍需要投入大量的时间和精力进行编码以完成分析,这无疑会导致相关工作的延误。
在线分析平台无疑是研究人员的首选,因为它们不需要额外的安装和准备工作。只需打开一个网页并上传数据进行分析,就可以大大加快生命科学研究的步伐。目前,有许多类似的在线数据分析平台,包括一些专门用于组学数据分析的平台,如ImageGP、Sangerbox、Majorbio Cloud、OmicStudio、OmicsSuite、OmicsAnalyst等。然而,这些分析平台大多是基于基因组学和转录组学的需求开发的,几乎没有专门为蛋白质组学设计的。
蛋白质组是从转录组翻译而来的,不仅具有转录组的表达特征,还包括修饰和相互作用等额外的特征。在定性和定量实验技术方面,蛋白质组学比基因组学和转录组学要复杂得多,这给数据分析带来了额外的要求。近年来,随着技术的进步,蛋白质组学在医学研究中逐渐发挥着越来越重要的作用,导致对蛋白质数据分析的需求日益增长和多样化。
在这里,我们提供了BioLadder生物信息学平台(https://www.bioladder.cn/),它不仅提供了一些传统的分析工具,还提供了常用的蛋白质组学分析工具,包括实验结果可视化、序列级分析、表达数据分析和功能分析。
结 果
蛋白质组数据分析的模块设计
蛋白质组数据分析可以分为两大类(图1):(1)实验数据分析:涉及蛋白质组学实验数据的分析,包括实验数据分析、表达矩阵数据分析等(类别1-3);(2)常规数据分析:不依赖于蛋白质组学实验数据的分析,包括蛋白质序列分析以及一些通用的分类和功能分析等(类别4-7)。
这七个类别概述如下:
类别1. ExpDataVisualization
实验数据可视化目前包括两个模块(CoverageBar 和 Pep2ProMap),这些模块显示蛋白质组学鉴定肽段对蛋白质的覆盖率,以及蛋白质酶切位点的信息。
类别2. DataPreProcessing
数据预处理包括数据格式转换、标准化、插补等。它是后续分析的重要部分。
类别3. QuantitativeAnalysis
定量比较涉及分析每种蛋白质的定量结果,是最常见的分析模块类型,可以细分为五个小类:(1)DifferenceAnalysis:差异分析包括差异计算、假发现率(FDR)校正和差异结果的可视化,如火山图、接收者操作特征(ROC)曲线等。这些模块能够同时进行差异计算和结果展示;(2)QuantitativeDes:定量数据描述包括创建散点图、密度图、分布条形图或折线图,以及变异系数(CV)。这些模块旨在描述定量数据的分布、密度和其他特征;(3)QuantitativeComp:定量数据比较包括条形图、热图、箱线图等。这些模块主要用于比较不同样本或基因之间的定量差异或变化;(4)QuantitativeCorr:定量数据相关性包括相关热图、相关矩阵图等。这些模块计算样本或基因之间的定量相关性,以揭示样本或基因之间的关系;(5)QuantitativeCluster:相关性聚类包括主成分分析(PCA)、T-SNE、UMAP、多数据集的趋势分析、树状图等。这些模块通常使用降维算法或其他距离计算方法来聚类和分析样本或基因。
类别4. SeqAnalysis
序列分析指的是基于蛋白质序列可以完成的分析,包括多序列比对、序列基序分析、蛋白质物理化学性质计算等。
类别5. AbundanceMap
丰度图提供了一种方便的方式来查询和显示体液(目前包括血液和尿液)的参考定量数据。
类别6. ClassificationAnalysis
分类分析由两个小类组成:(1)分类展示涉及使用散点图、饼图、面积图等在分类后展示不同类型结果的差异;(2)分类比较涉及使用Venn图、桑基图、雷达图等可视化工具比较不同类型结果。
类别7. FunctionAnalysis
功能分析专注于基于基因本体论(GO)的富集结果可视化,以及绘制交互网络图。
因此,BioLadder中包含的分析模块涵盖了蛋白质组学研究中的实验数据分析,以及多个公共序列数据分析模块。这些分析模块可以满足蛋白质组学领域研究人员的大部分数据分析需求。
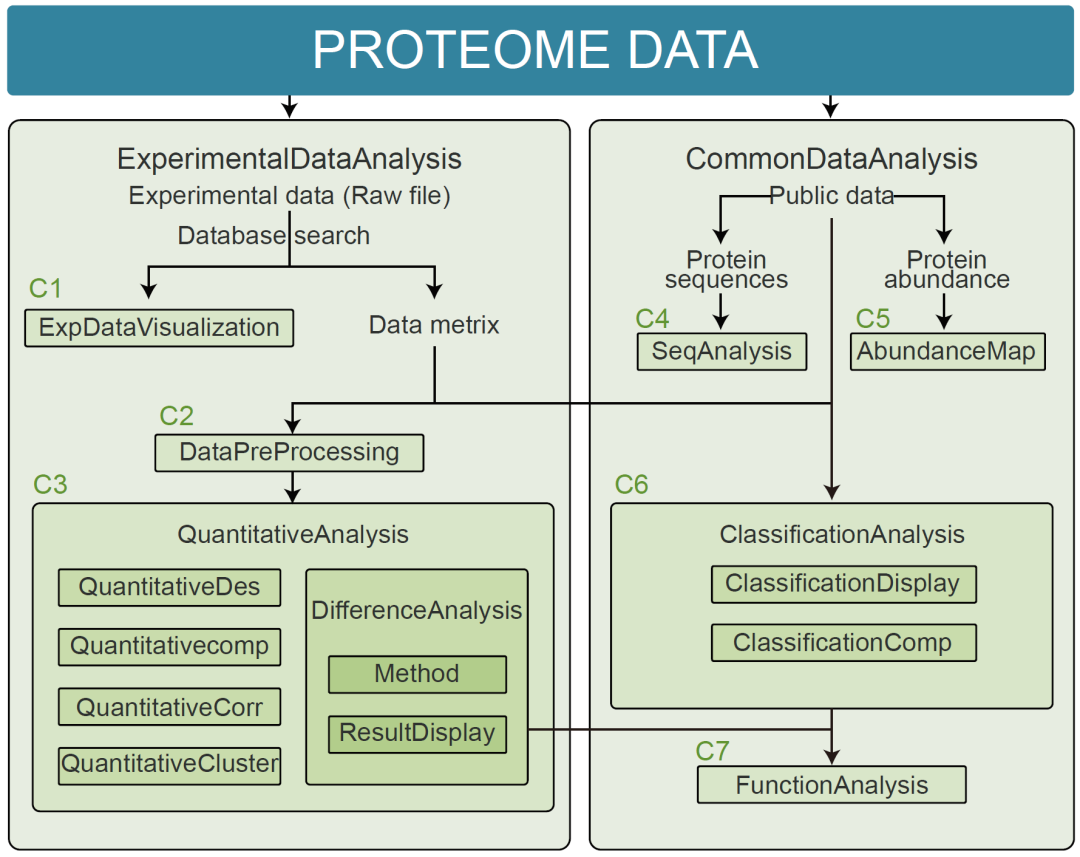
图1. BioLadder在蛋白质组数据分析框架中的模块类别
BioLadder由50多个分析模块组成,这些模块属于两个主要类别(实验数据分析和常规数据分析)以及7个类别(图中的C1-C7)。
特定蛋白质组学数据分析模块
为了满足蛋白质组学研究的需求,我们开发了几种蛋白质组数据可视化模块,例如:(1)蛋白质序列中肽段的覆盖度分析,包括CoverageBar和Pep2ProMap模块。这些模块主要设计用于展示Lip-MS实验结果,但也可用于显示任何蛋白质组学实验的鉴定数据;(2)定量数据分布的分析和可视化,包括CV曲线和SumCurve模块。用户可以利用这些模块检查定量数据的变异性和丰度曲线;(3)定量数据和标记蛋白,包括AbundancePoint和BodyFluidMap模块。前者允许用户输入自己的定量数据并指定蛋白质,而后者使用户能够查询体液数据库中特定蛋白质的定量信息(目前包括血液和尿液)。
我们相信这些蛋白质组数据可视化模块将满足蛋白质组学研究的需求,并为研究人员提供有价值的见解。
方便且用户友好的设计
为了使组学研究用户能够以最方便和高效的方式使用我们的在线分析平台,我们在多个方面进行了精心设计,包括输入文件格式(图2A)、参数设置(图2B)、配色方案(图2C)等。我们提供帮助文档、微信客服和实时工具提示,使用户能够轻松获取相关帮助信息(图2D)。目前现有在线云平台只能部分实现这些功能(表S3)。
简化输入格式
许多数据分析方法是通用的,具有自己的输入数据格式,这些格式在蛋白质组学领域可能并不常用。蛋白质组学数据可能需要一些转换以便于相应的分析。因此,在我们的设计中,我们为不同类型的数据提供了转换模块(例如,长格式和宽格式之间的转换),并设计了一些模块直接支持常见的蛋白质组学格式。例如,在Venn图模块中,用户不仅可以输入常用的Venn格式数据,还可以直接输入定量矩阵数据表(通常在蛋白质组学中使用)进行分析。此外,它还可以过滤掉某些最小定量值以下的数据,这有助于消除可能由噪声引起的结果。
针对蛋白质组学的专门默认参数,多样化和广泛的调整方法
为了满足蛋白质组学数据分析的特定要求,我们为一些模块建立了合适的默认参数,以尽可能减少参数调整的需求。
首先,在算法方面,我们根据蛋白质组数据的特点调整了默认参数。例如,在相关性计算中,由于表达数据的特性,一些高度丰富的蛋白质可能会显著影响默认的Person相关性计算。因此,在涉及相关性计算的模块中,我们默认使用Spearman秩相关性进行计算,这在许多与蛋白质组学相关的研究中也被采用。此外,考虑到不同样本中鉴定出的蛋白质数量通常存在显著变化,传统的标准化方法可能会不可避免地引入偏差。为了解决这个问题,我们在标准化模块中引入了一种称为共有蛋白质中位数标准化的方法。
其次,在数据预处理方面,我们根据蛋白质组数据的特点进行了一些调整。例如,由于大多数基因表达量相对较低,直接绘制定量分布通常会导致大多数蛋白质集中在低丰度,这使得样本之间的差异难以辨别。因此,在箱线图、小提琴图和核密度图等模块中,我们直接将默认设置为需要对数转换,允许在不进行任何参数修改的情况下清晰地可视化不同样本间定量数据的变化。
此外,我们还在数据展示中制定了一些特别的默认参数。例如,在热图分析中,基因通常在y轴上数量众多,显示基因名称常常难以辨认。因此,我们默认只显示样本名称并省略基因名称,以便更清晰。
另外,为了满足用户偏好,我们在几个模块中加入了易于调整的参数,使用户能够自定义他们的展示结果。例如,在火山图分析中,我们包括了两种蛋白质标记方法:1. 根据上传文件中指定的标记列自定义蛋白质标记;2. 基于p值和差异倍数变化阈值的批量标记。类似地,在箱线图分析中,用户可以选择是否在不同组之间添加假设测试标签。我们还设计了自定义选项,允许用户选择性地添加特定组比较的假设测试标签(例如,仅注释显著结果或特别感兴趣的比较)。
强大的配色方案
配色方案是数据可视化的一个关键方面,不当的颜色组合可能会显著降低可视化的有效性。
为了解决这个问题,我们在所有模块中配置了默认配色方案,包括一些来自R包或ggplot2(https://github.com/tidyverse/ggplot2)的默认配色方案,确保用户可以立即创建清晰的图形,无需额外步骤。
此外,超过一半的模块还融入了来自Nature、Science和Lancet等文献或期刊中常用的优秀配色方案(ggsci: https://github.com/nanxstats/ggsci)。
对于有特定要求的用户,我们提供自定义颜色的选项。用户可以直接使用调色板选择颜色,或通过调整颜色代码精确修改颜色配置,使他们能够根据个人需求和审美为每个样本或组自定义颜色。
这三个功能为我们的模块提供了强大的颜色自定义能力,满足各种用户需求,并允许用户根据他们的偏好快速完成颜色自定义。
另外,某些具有独特特性的模块使用特殊的配色方案。例如,火山图模块通常只需要三种颜色用于上调、下调和无显著性,因此使用颜色选择器设置三色方案。
全面的帮助信息,便捷的实时帮助
为了确保用户能够顺利地使用我们的模块进行数据分析,我们在“用户指南”中从多个角度提供了帮助信息。首先,我们提供了一个介绍,以概述网站结构和功能。其次,我们有一个“常见问题解答”页面,汇总了大多数常见问题。第三,我们为每个模块提供了详细的文档。此外,我们还提供了一个微信交流群,用户可以直接咨询我们的工作人员遇到的问题。
此外,除了常用的参数设置外,我们还添加了工具提示,以提供即时帮助,使用户可以随时访问有关参数设置的帮助信息,以帮助准确配置相应的参数。例如,在热图模块中,提供了四种类型工具提示:(1)输入文件详细信息的工具提示,包括文件内容解释、最大文件限制和文件格式;(2)下拉选择框的工具提示,解释每个选项的含义;(3)下载格式的工具提示,提供下载说明和下载设置的图形解释;(4)在大多数模块的结果图中的左上角,提供了一个“文本教程”链接,以及解释图表的工具提示,使用户能够快速理解图表的重要性。这些工具提示使用户能够轻松获取帮助信息,并无缝地继续配置和数据分析。
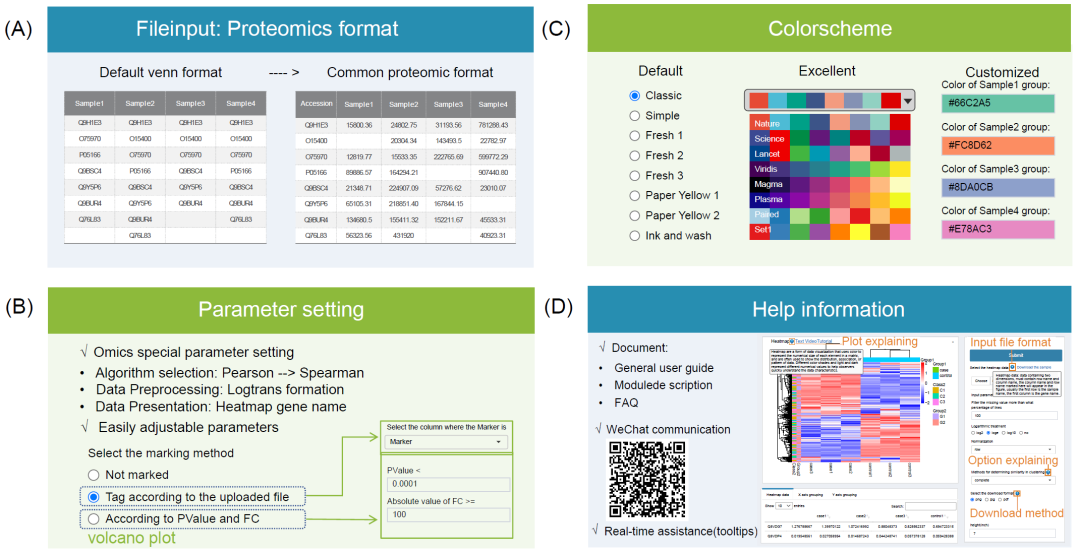
图2. BioLadder中的四种便利且用户友好的设计
(A) 一个常用的蛋白质组文件格式作为默认输入格式的例子(Venn图)。(B) 针对蛋白质组学的专门默认参数,包括算法选择、数据预处理和展示。多样化和广泛的调整方法(以火山图为示例)。(C) 三种不同的配色方法。(D) 全面的帮助信息(三种文档和微信通讯),以及方便的实时协助(以热图为例)。
引文格式:
Yupeng Zhang, Chunyuan Yang, Jinhao Wang, Lixin Wang, Yan Zhao, Longqing Sun, Wei Sun, Yunping Zhu, Jingli Li, Songfeng Wu. 2024. BioLadder: A bioinformatic platform primarily focused on proteomic data analysis. iMeta 3: e215. https://doi.org/10.1002/imt2.215
作者单位简介
北京青莲百奥生物科技有限公司
北京青莲百奥生物科技有限公司是一家专注于蛋白质组学检测和分析的创新性平台企业,公司以临床需求为导向、以源头创新为核心驱动力,为蛋白质组检测以及蛋白质诊疗标志物的临床转化提供一站式的完整解决方案。公司围绕血液、外泌体、组织切片、单细胞等领域,成功打造新一代蛋白质组学技术和生信平台,平台具有全自动、微量检测、高深度覆盖、定量准确等特点,为蛋白质组学的临床应用提供切实、落地的解决方案。
国家蛋白质科学中心(北京基地)
国家蛋白质科学中心(北京基地)位于中关村生命科学园内,由军事医学科学院、清华大学、北京大学、中科院生物物理研究所等单位共同建设。其重点建设蛋白质组分析系统和功能蛋白质组研究系统,同时建设以生物信息学、蛋白质/抗体制备、生物资源库、模式动物等为核心的支撑系统。该中心还承担了国家科技部“中国人类蛋白质组计划(CNHPP)”研究工作。中心大楼面积近4万平米,拥有高通量、高精度的蛋白质组研究平台、蛋白质功能分析平台、生物信息学平台、转化医学平台以及实验动物中心、生物样本库等系列配套设施,形成系统完善的蛋白质研究体系,主要开展蛋白质组学、代谢组学、蛋白质功能等创新研究,已经具备世界领先的蛋白质组大数据产出能力,将为全世界提供高水平和一站式的蛋白质组分析服务。其研究成果将广泛应用和服务于疾病诊断标志物、新药创制、传染病防治、农作物改良、生物能源转化等多个领域发展。
更多推荐
(▼ 点击跳转)
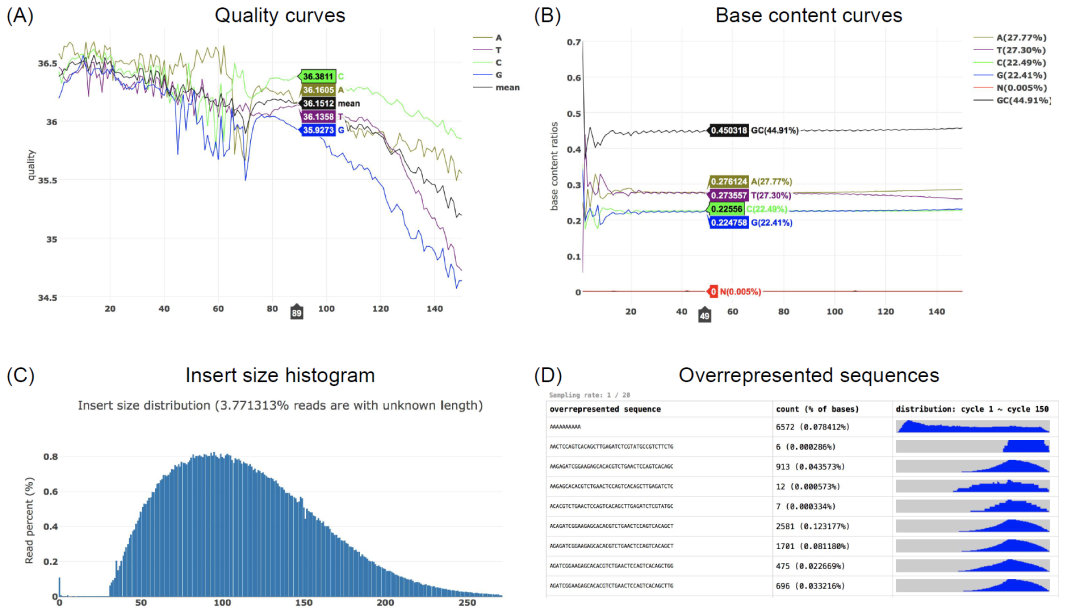
iMeta | 引用7000+,海普洛斯陈实富发布新版fastp,更快更好地处理FASTQ数据
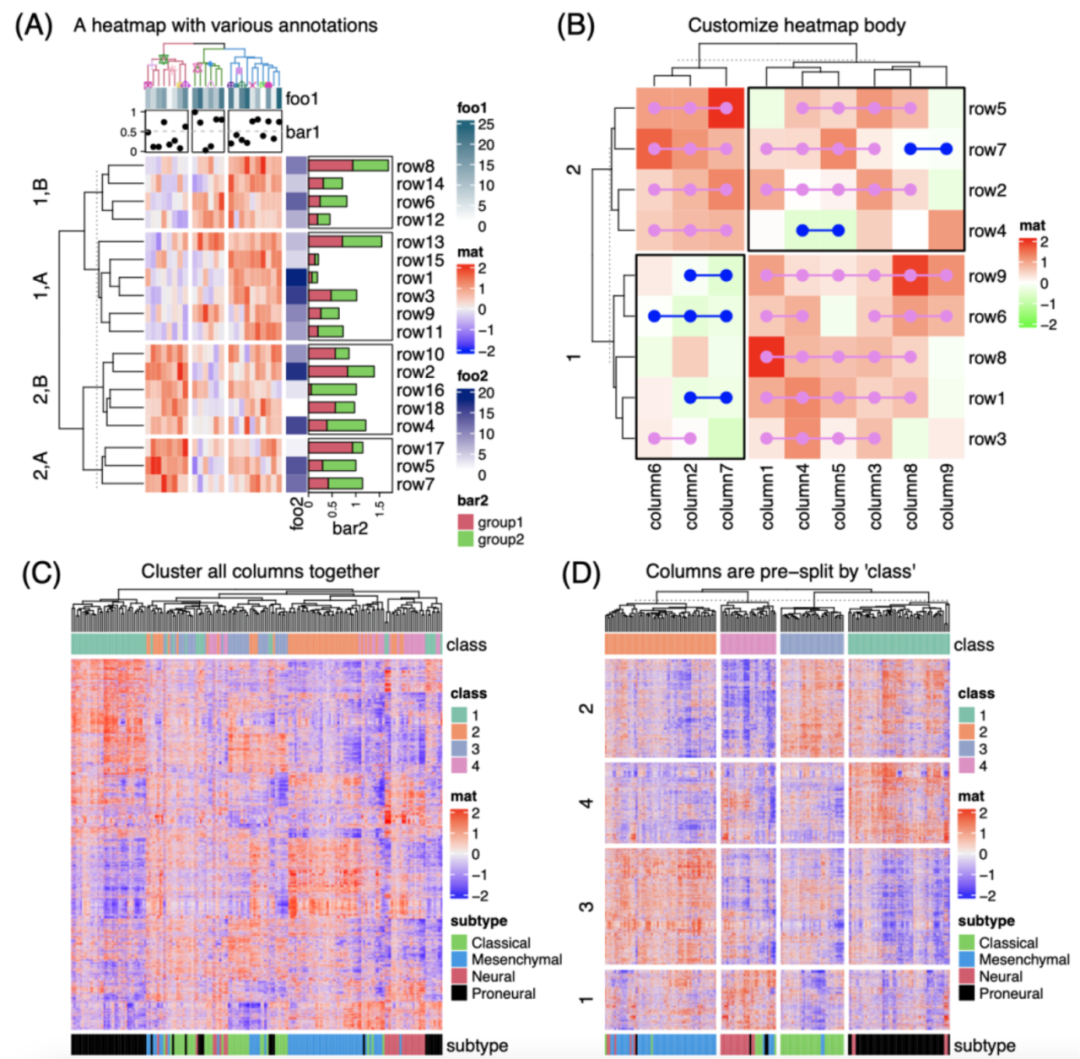
iMeta | 德国国家肿瘤中心顾祖光发表复杂热图(ComplexHeatmap)可视化方法
1卷1期
1卷2期
1卷3期
1卷4期
2卷1期
2卷2期
2卷3期
2卷4期
3卷1期
2卷2期封底
2卷4期封底
3卷2期
期刊简介
“iMeta” 是由威立、肠菌分会和本领域数百位华人科学家合作出版的开放获取期刊,主编由中科院微生物所刘双江研究员和荷兰格罗宁根大学傅静远教授担任。目的是发表原创研究、方法和综述以促进宏基因组学、微生物组和生物信息学发展。目标是发表前10%(2023 IF 23.7)的高影响力论文。期刊特色包括视频投稿、可重复分析、图片打磨、青年编委、50万用户的社交媒体宣传等。2022年2月正式创刊发行!目前期刊已经被ESCI、PubMed、Scopus等数据库收录。
联系我们
iMeta主页:
http://www.imeta.science
姊妹刊iMetaOmics主页:
http://www.imeta.science/imetaomics/
出版社iMeta主页:
https://onlinelibrary.wiley.com/journal/2770596x
出版社iMetaOmics主页:
https://onlinelibrary.wiley.com/journal/29969514
iMeta投稿:
https://wiley.atyponrex.com/journal/IMT2
iMetaOmics投稿:
https://wiley.atyponrex.com/journal/IMO2
邮箱:
office@imeta.science
高颜值免费 SCI 在线绘图(点击图片直达)
最全植物基因组数据库IMP (点击图片直达)
往期精品(点击图片直达文字对应教程)
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|
|

DAMO开发者矩阵,由阿里巴巴达摩院和中国互联网协会联合发起,致力于探讨最前沿的技术趋势与应用成果,搭建高质量的交流与分享平台,推动技术创新与产业应用链接,围绕“人工智能与新型计算”构建开放共享的开发者生态。
更多推荐
 0
 0
- 0


 已为社区贡献127条内容

所有评论(0)